
backup_and_restore.sh mailcow вернул код 0, хотя диск был полон, а архив — обрезан
Cron с backup_and_restore.sh каждую ночь писал в лог «успех», echo $? показывал 0 — а диск под бэкапы тем временем был заполнен под завязку, и архив с почтой обрывался на середине записи. Это не гипотеза, а зафиксированный в issue-трекере mailcow баг: скрипт не проверяет код возврата контейнера, в котором tar вместе с zstd упал на записи, и не работает в режиме «остановиться при первой ошибке», поэтому фатальная ошибка не мешает ему бодро отрапортовать о завершении. Разбираю, что происходит внутри, почему issue закрыт без исправления и как проверять бэкап по факту, а не по коду возврата cron-задания.
Кейс: бэкап «успешный» три недели подряд, а восстанавливать нечего
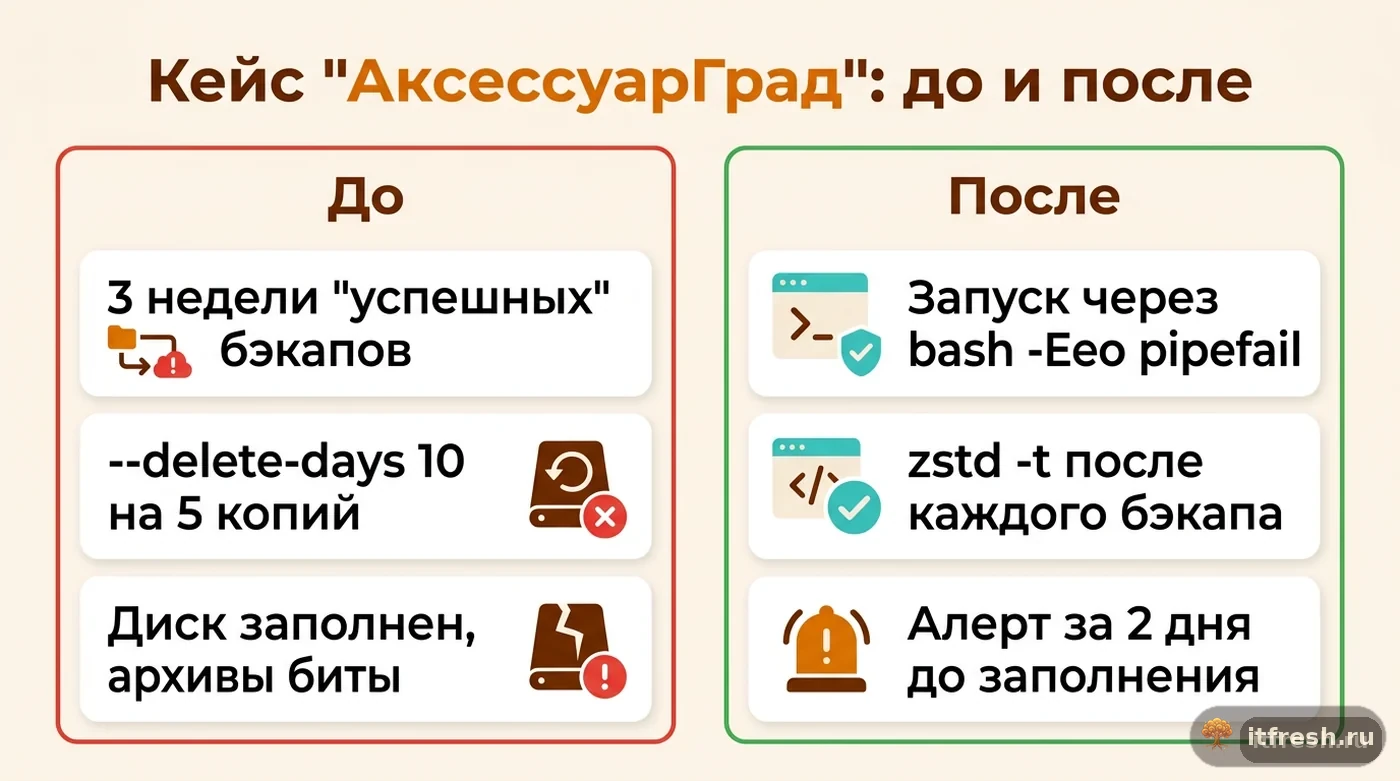
Магазин аксессуаров «АксессуарГрад» (19 рабочих мест) держит на mailcow всю переписку с поставщиками и маркетплейсами — заказы, накладные, подтверждения отгрузок. Мы обслуживаем их почту и настраивали для них ежедневный backup_and_restore.sh backup all по cron с сохранением на отдельный диск, смонтированный именно под бэкапы. Cron слал администратору короткий отчёт с кодом завершения — и три недели подряд отчёт был безукоризненным: echo $? после запуска возвращал 0, что на языке любого скрипта означает «всё прошло штатно».
Повод усомниться появился не из мониторинга, а случайно: перед плановым обновлением сервера решили на всякий случай проверить архивы восстановлением на тестовый стенд — и обнаружили, что несколько .tar.zst-файлов из недавних бэкапов не распаковываются, обрываясь посередине с ошибкой целостности потока zstd. При этом код завершения самого backup-задания в логах cron всё это время был нулевым.
Диск, на который писались бэкапы, оказался заполнен почти полностью — за счёт накопившихся старых копий, ротация которых была настроена с задержкой. Именно в момент нехватки места и создавались повреждённые архивы, но ни разу за три недели это не привело к ненулевому коду возврата, на который была настроена алертинг-логика.
Самое неприятное в этой ситуации — не сам факт битых архивов, а то, что она вскрылась случайно, а не в момент реальной аварии. Если бы диагностику перед обновлением сервера не делали, а сервер после обновления столкнулся бы с реальной поломкой, восстанавливать почту 19 сотрудников пришлось бы с архива трёхнедельной давности в лучшем случае — того единственного, который, по счастью, успел записаться до того, как диск заполнился окончательно. Заказ, подтверждённый поставщиком по почте на прошлой неделе, при таком восстановлении просто исчез бы без следа, и никто не узнал бы об этом, пока сам поставщик не напомнил бы о нём.
Что происходит внутри: zstd падает, а backup_and_restore.sh этого не видит
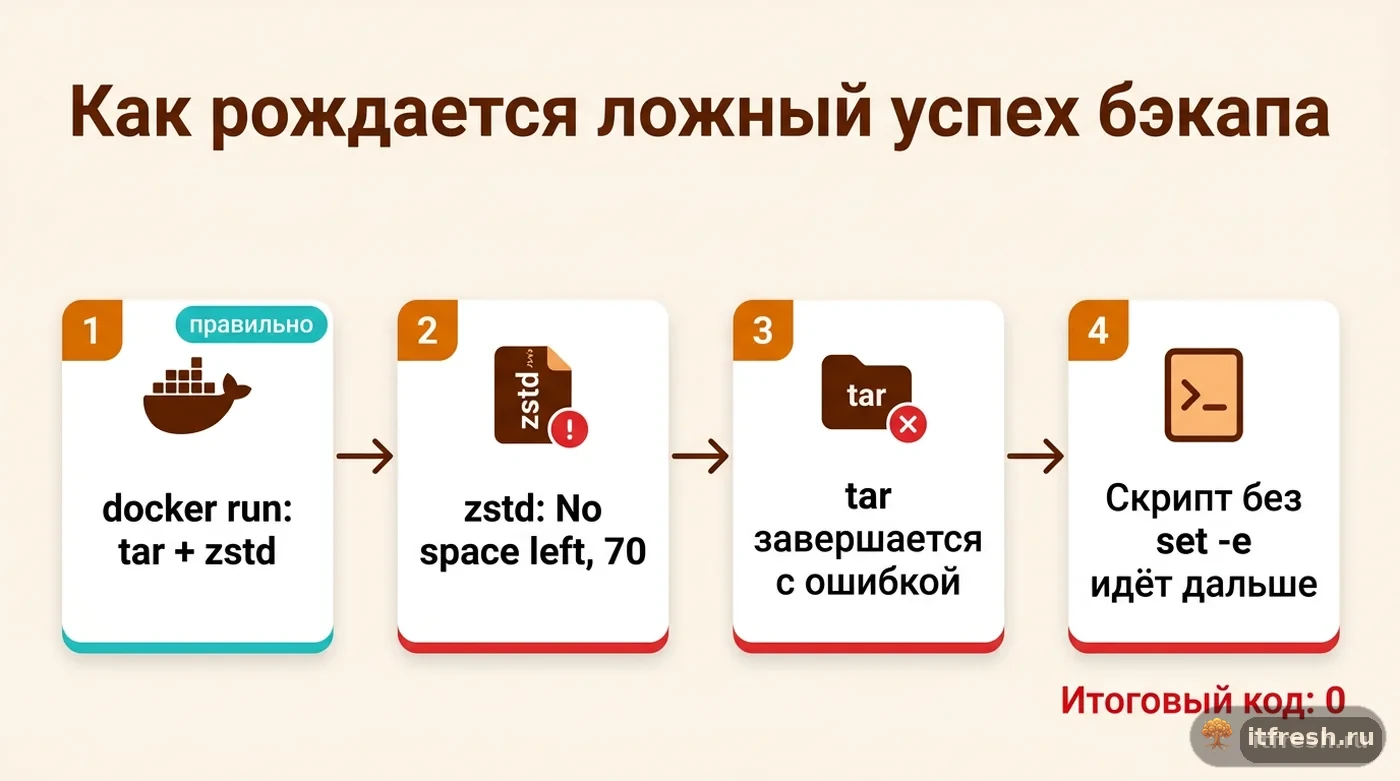
Проблема зафиксирована в официальном трекере mailcow-dockerized как Issue #7038, поданный 30 января 2026 года на версии mailcow 2025-12a. Автор issue воспроизвёл ситуацию буквально: заполнил хранилище под бэкапы до отказа и запустил штатный backup_and_restore.sh backup all — в журнале появились строки zstd: error 70 : Write error : cannot write block : No space left on device, следом tar: Wrote only 4096 of 10240 bytes, tar: Child returned status 70 и tar: Error is not recoverable: exiting now. Это классическая цепочка отказа: tar запускает zstd дочерним процессом (в скрипте это --use-compress-program="zstd --rsyncable -T${THREADS}"), zstd не может записать блок на переполненный диск и возвращает код 70, tar фиксирует «Child returned status 70» и завершается аварийно.
Несмотря на всю эту цепочку фатальных ошибок в логе, сам скрипт backup_and_restore.sh в конце завершился с кодом 0. Причина — в устройстве самого скрипта. Каждый компонент (vmail, crypt, redis, rspamd, postfix, mysql) архивируется отдельным docker run с образом ghcr.io/mailcow/backup, и ненулевой код tar честно возвращается из docker run. Но скрипт не включает set -e и нигде не проверяет $? после этих вызовов: он просто переходит к следующему компоненту, а в конце отдаёт код последней выполненной команды. В логе из issue это видно буквально: после аварии vmail скрипт пошёл архивировать crypt и redis на тот же переполненный диск. Для внешнего наблюдателя — cron и администратора, читающего только итоговый echo $?, — всё это остаётся незамеченным.
Важная деталь по версиям: именно в релизе 2025-12 mailcow перевёл сжатие бэкапов с pigz на zstd — в официальном анонсе это подано как улучшение производительности («Backup performance boosted: Switched from pigz to zstd for faster, more efficient compression»). В 2025-12a отдельно добавили автоматическую предзагрузку образа для бэкапа перед запуском, что решило другую, не связанную с этой, проблему — устаревший закешированный образ без zstd и нулевые архивы. Но именно вопрос обработки кода возврата при переполнении диска эти изменения не затронули.
Стоит понимать, что дело не только в диске под бэкапы. Тот же механизм без проверки кода возврата сработает одинаково тихо на любой другой причине аварийного завершения zstd или tar — повреждённый том Docker, ошибка прав доступа на целевой директории после её пересоздания вручную, обрыв сетевого хранилища, если бэкапы пишутся не на локальный диск, а на смонтированный по NFS или SMB раздел. Нехватка места — самый частый в нашей практике сценарий именно потому, что диски заполняются постепенно и предсказуемо, но не единственный: любая ошибка записи внутри конвейера будет замаскирована тем же способом.
- tar запускает zstd дочерним процессом внутри docker run
- zstd не может писать на переполненный диск → error 70, No space left on device
- tar фиксирует обрыв дочернего процесса и завершается аварийно
- backup_and_restore.sh без set -e не проверяет код docker run → идёт дальше и возвращает 0
- cron и мониторинг по коду возврата видят «успех» там, где архив на самом деле битый
Почему issue закрыт как «not planned», а не исправлен
Автор issue предложил конкретный и минимальный обходной путь — запускать скрипт не напрямую, а через bash -Eeo pipefail, явно включив для интерпретатора строгий режим: -e останавливает выполнение при первой же ошибке — здесь именно он делает основную работу, потому что упавший docker run сразу прерывает скрипт с ненулевым кодом; -E сохраняет обработку ошибок внутри функций, а -o pipefail страхует конвейеры, где bash иначе смотрел бы только на последнюю команду. Флаг -u автор в обходной путь не включил, хотя в предложении для самого скрипта он есть: при запуске чужого скрипта «снаружи» обращение к любой незаданной переменной оборвало бы работу там, где ошибки нет. Практическая команда выглядит так:
bash -Eeo pipefail "$backup_script" backup all --delete-days 1Это рабочий обходной путь, но не встроенное исправление: он требует, чтобы администратор сам изменил способ вызова скрипта в своём cron-задании, а не полагался на поведение по умолчанию из документации mailcow.
На момент публикации issue #7038 закрыт с пометкой «not planned» и меткой stale, что в терминологии GitHub означает автоматическое устаревание тикета без активности, а не подтверждение исправления. Это важно понимать буквально: закрытие issue не означает, что баг починен в актуальной версии mailcow — оно означает, что команда разработки не взяла его в работу в обозримой перспективе. Закрыт он 7 апреля 2026 года. Для эксплуатации это значит, что полагаться нужно не на то, что «когда-нибудь это починят», а на собственный обходной путь и, что важнее, на независимую проверку результата бэкапа.
Мы не считаем такое решение мейнтейнеров mailcow странным или пренебрежительным — обработка ошибок в скриптах-обёртках вокруг внешних утилит действительно не самая благодарная задача для приоритизации, когда в очереди стоят более заметные фичи и баги, влияющие на ежедневную работу почты у тысяч инсталляций. Ирония в том, что пример cron-обёртки в самой документации mailcow шлёт письмо только при ненулевом коде возврата — то есть при переполненном диске он промолчит. Для администратора конкретного сервера это означает одно: рассчитывать на то, что фреймворк сам подскажет о проблеме с бэкапом, нельзя — контроль нужно строить поверх штатного механизма, а не полагаться на него целиком.
Как проверять бэкап по факту, а не по коду возврата
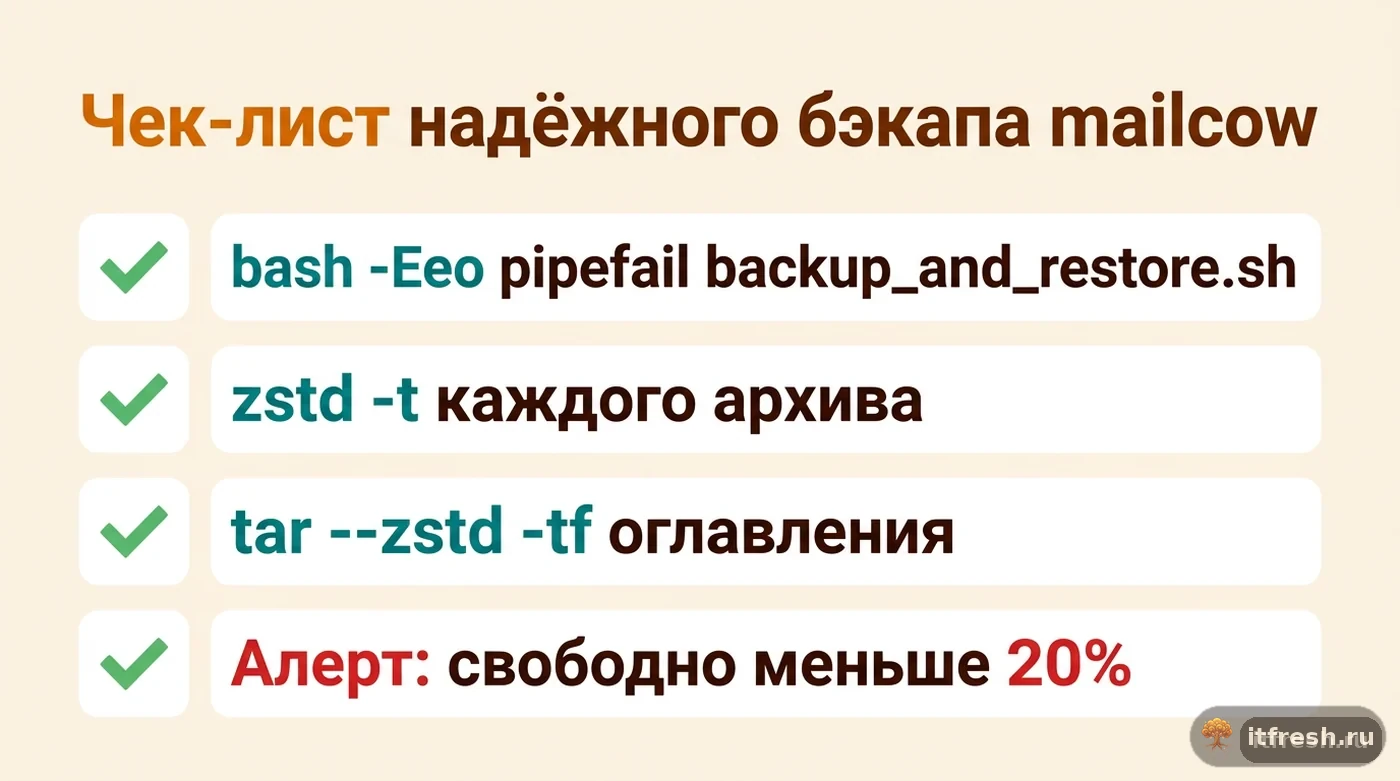
Первый и самый простой шаг — запускать скрипт в строгом режиме, не дожидаясь официального исправления. Здесь есть ловушка, на которую я сам когда-то наступил: set -Eeuo pipefail в собственной обёртке не спасает. Опции set действуют только на текущий процесс bash и не наследуются дочерним скриптом, поэтому обёртка увидит тот же самый 0. Строгий режим нужно передать интерпретатору, который исполняет сам backup_and_restore.sh: bash -Eeo pipefail /opt/mailcow-dockerized/helper-scripts/backup_and_restore.sh backup all --delete-days N. Копировать скрипт в другое место и править его документация прямо запрещает, а правка на месте слетит при обновлении.
Второй шаг, который мы считаем обязательным независимо от исправления первого — проверка не кода возврата, а самого файла результата. Минимальная проверка целостности архива без полной распаковки: zstd -t backup_vmail.tar.zst для проверки целостности потока сжатия (в каталоге mailcow-<дата> внутри MAILCOW_BACKUP_LOCATION), и отдельно tar --zstd -tf backup_vmail.tar.zst > /dev/null для проверки, что оглавление архива читается целиком без обрывов. Обе команды возвращают ненулевой код, если архив повреждён, — и это надёжнее, чем код возврата самого backup-скрипта, который, как показал issue #7038, может лгать.
Третий шаг — контроль свободного места на разделе с бэкапами как отдельная метрика мониторинга, не завязанная на итог backup-задания. У «АксессуарГрада» корневая причина была именно в этом: диск заполнялся из-за задержанной ротации старых копий, и алерт на уровень свободного места (например, порог в 20 % свободных) поймал бы проблему за несколько дней до того, как она привела бы к битым архивам — вне зависимости от того, исправлен баг с exit-кодом или нет.
Что мы поменяли у «АксессуарГрада»
Мы перевели cron-задание на запуск bash -Eeo pipefail /opt/mailcow-dockerized/helper-scripts/backup_and_restore.sh backup all --delete-days 4, обернули его скриптом, который шлёт алерт при ненулевом коде, добавили постпроверку каждого созданного .tar.zst-архива через zstd -t, и отдельно — мониторинг свободного места на разделе бэкапов с алертом при снижении ниже 20 %. Ротацию старых копий пересчитали так, чтобы гарантированно оставался запас в 3–4 полных цикла бэкапа даже при временном росте объёма почты.
Отдельно пересмотрели саму задержку ротации, которая и стала первопричиной: раньше стояло --delete-days 10, при том что диск был рассчитан на 5–6 полных копий. Есть и тонкость порядка: в backup all --delete-days N старые каталоги удаляются только после того, как новые архивы записаны, поэтому в момент бэкапа на диске должно хватать места на N+1 копию при обычном темпе роста почты — простое несоответствие ёмкости диска и глубины хранения, которое годами оставалось незамеченным, потому что до сих пор ничего не подсказывало администратору, что место когда-нибудь закончится в реальности, а не в теории.
Заодно добавили ежемесячное тестовое восстановление одного случайного архива на изолированный стенд — не полную процедуру disaster recovery, а быструю проверку: на тестовой машине с развёрнутым mailcow запускаем MAILCOW_BACKUP_LOCATION=/mnt/backup ./helper-scripts/backup_and_restore.sh restore, в интерактивном меню выбираем свежую копию и компоненты и беглый просмотр, что почтовые ящики и база данных действительно читаются. Это отдельная практика от постпроверки zstd -t, потому что технически целый файл архива ещё не гарантирует, что данные внутри него логически консистентны — а для клиента, для которого переписка с поставщиками фактически заменяет часть бумажного документооборота, разница между «архив цел» и «архив реально восстанавливается» существенна.
Итог: код 0 — не доказательство рабочего бэкапа
Главный практический вывод из этого кейса не про zstd и не про конкретный issue — issue могут исправить в следующей версии mailcow, а могут и не исправить, статус «not planned» намекает скорее на второе. Вывод в том, что код возврата backup-скрипта в принципе не стоит считать единственным критерием успеха резервного копирования — ни в mailcow, ни в любой другой системе, где бэкап — это конвейер из нескольких внешних утилит. Похожие истории я собирал в разборе провалов резервного копирования — почти везде «зелёный» отчёт жил дольше, чем реальный бэкап.
После наших правок у «АксессуарГрада» отдельный алерт на нехватку места сработал уже один раз, спустя примерно месяц после внедрения — рост объёма вложений в переписке с новым поставщиком быстрее вычерпал свободное место, чем ожидалось по прежним расчётам. В этот раз проблему поймали за два дня до того, как диск заполнился бы полностью, и ротацию скорректировали заново — то есть именно та цепочка мониторинга, которую не даёт сам факт «зелёного» cron-отчёта, сработала так, как должна была.
Частые вопросы
Почему backup_and_restore.sh в mailcow возвращает код 0, даже если бэкап реально сломался?
Это зафиксированный в issue #7038 баг: каждый компонент архивируется отдельным docker run с tar и zstd, но скрипт работает без set -e и не проверяет код возврата этих вызовов. Если tar падает (например, zstd не может писать на заполненный диск), скрипт переходит к следующему компоненту и в конце возвращает код последней команды — 0.
Как понять, что причина битого бэкапа mailcow — именно нехватка места на диске?
В журнале выполнения backup_and_restore.sh при этой проблеме появляются характерные строки: zstd: error 70 : Write error : cannot write block : No space left on device, а следом tar: Wrote only N of M bytes и tar: Child returned status 70. Это прямое указание на то, что раздел, куда пишется архив, заполнен.
Как обойти баг с exit-кодом до официального исправления в mailcow?
Автор issue #7038 предложил запускать backup_and_restore.sh через bash -Eeo pipefail: bash -Eeo pipefail "$backup_script" backup all --delete-days 1. Ключевой здесь флаг -e: упавший docker run сразу прерывает скрипт с ненулевым кодом. Важно передавать флаги именно интерпретатору скрипта — set -e в собственной обёртке на дочерний скрипт не действует.
Значит ли статус issue «not planned», что баг уже исправлен в новой версии mailcow?
Нет. Статус not planned с меткой stale означает, что тикет автоматически закрыт GitHub из-за отсутствия активности, а не что разработчики подтвердили исправление. Полагаться на то, что проблема решена сама собой, не стоит — нужен собственный обходной путь и независимая проверка результата бэкапа.
Как проверить, что созданный архив бэкапа mailcow реально пригоден для восстановления?
Отдельным шагом после backup-задания, не полагаясь на его код возврата: командой zstd -t backup_vmail.tar.zst проверяется целостность потока сжатия, а командой tar --zstd -tf backup_vmail.tar.zst > /dev/null — что оглавление архива читается без обрывов. Обе команды возвращают ненулевой код при повреждённом архиве.
Источники
- GitHub mailcow-dockerized: Issue #7038 — backup_and_restore silently suppresses errors — Дословные строки ошибки (zstd: error 70, No space left on device, tar: Wrote only 4096 of 10240 bytes, tar: Child returned status 70), версия mailcow 2025-12a, код возврата 0 несмотря на ошибку, предложенный обходной путь bash -Eeo pipefail, финальный статус closed as not planned со stale-меткой. https://github.com/mailcow/mailcow-dockerized/issues/7038
- mailcow docs: Backup — backup_and_restore.sh — Синтаксис команды backup_and_restore.sh backup all, переменная MAILCOW_BACKUP_LOCATION для указания места сохранения без интерактивных запросов, параметр --delete-days для автоматической ротации, переменная THREADS. https://docs.mailcow.email/backup_restore/b_n_r-backup/
- mailcow release notes: Moocember 2025 (2025-12 / 2025-12a) — Официальное подтверждение перехода сжатия бэкапов с pigz на zstd в 2025-12 («Switched from pigz to zstd for faster, more efficient compression») и добавления предзагрузки образа бэкапа в 2025-12a как отдельного улучшения надёжности. https://mailcow.email/posts/2025/release-2025-12/
- mailcow-dockerized на GitHub: helper-scripts/backup_and_restore.sh — Проверено: каждый компонент архивируется отдельным docker run с tar --use-compress-program="zstd --rsyncable -T${THREADS}", в скрипте нет set -e и проверок $? после docker run; --delete-days удаляет каталоги mailcow-* после записи новых архивов. https://github.com/mailcow/mailcow-dockerized/blob/master/helper-scripts/backup_and_restore.sh