
Кластер 1С без гадания по числу сотрудников
Сервер 1С подбирают по нагрузке, а не по числу сотрудников или лицензий. Я начинаю с пиковых сеансов, фоновых заданий, конфигурации и поведения рабочих процессов, затем проверяю гипотезу измерениями. Ниже — понятная схема, которая помогает не купить лишние ресурсы и не оставить систему без запаса.
Почему число сотрудников не задаёт размер сервера
Формула «один человек — одно ядро» удобна только тем, кто продаёт формулы. Она не описывает работу 1С. Один сотрудник может большую часть дня читать карточки, а другой одновременно строить отчёт, проводить документы и запускать обмен. Даже один и тот же пользователь меняет нагрузку в течение дня. Поэтому штатное расписание и число лицензий не показывают, сколько вычислений система выполняет в конкретный момент.
Считать нужно сценарии работы: какие операции выполняются, сколько длится пик, какие задания идут в фоне, как устроены конфигурация и база данных. Важно различать открытые сеансы и реально тяжёлые операции: наличие сеанса само по себе не означает постоянную загрузку процессора. И наоборот, короткая пакетная операция может дать заметный пик CPU, памяти или дискового ввода-вывода. Средняя загрузка за сутки сглаживает именно те минуты, ради которых обычно и покупают сервер.
Клиентское приложение тоже влияет на распределение работы, но не даёт универсального коэффициента. В клиент-серверном варианте рабочий процесс кластера обслуживает соединение и взаимодействует с сервером базы данных. Тонкий клиент передаёт на сервер выполнение запросов к базе и работу с объектными данными; веб-клиент подключается через веб-сервер. Из этого не следует, что любая смена типа клиента «увеличит нагрузку в разы»: результат зависит от операций, конфигурации и инфраструктуры. Такой прогноз проверяют тестом, а не интонацией.
Есть ещё сервер базы данных. Если он размещён отдельно, его CPU, память и хранилище оценивают отдельно от узлов 1С; если вместе — ресурсы конкурируют. Медленный запрос может выглядеть как «тормозит кластер», хотя узкое место находится в СУБД, блокировках или диске. Перед закупкой я выясняю, где именно теряется время: на клиенте, в рабочем процессе, при обращении к базе или на уровне хранилища. Иначе можно добавить процессор туда, где проблема вообще не живёт.
Из чего состоит кластер и что можно разделять
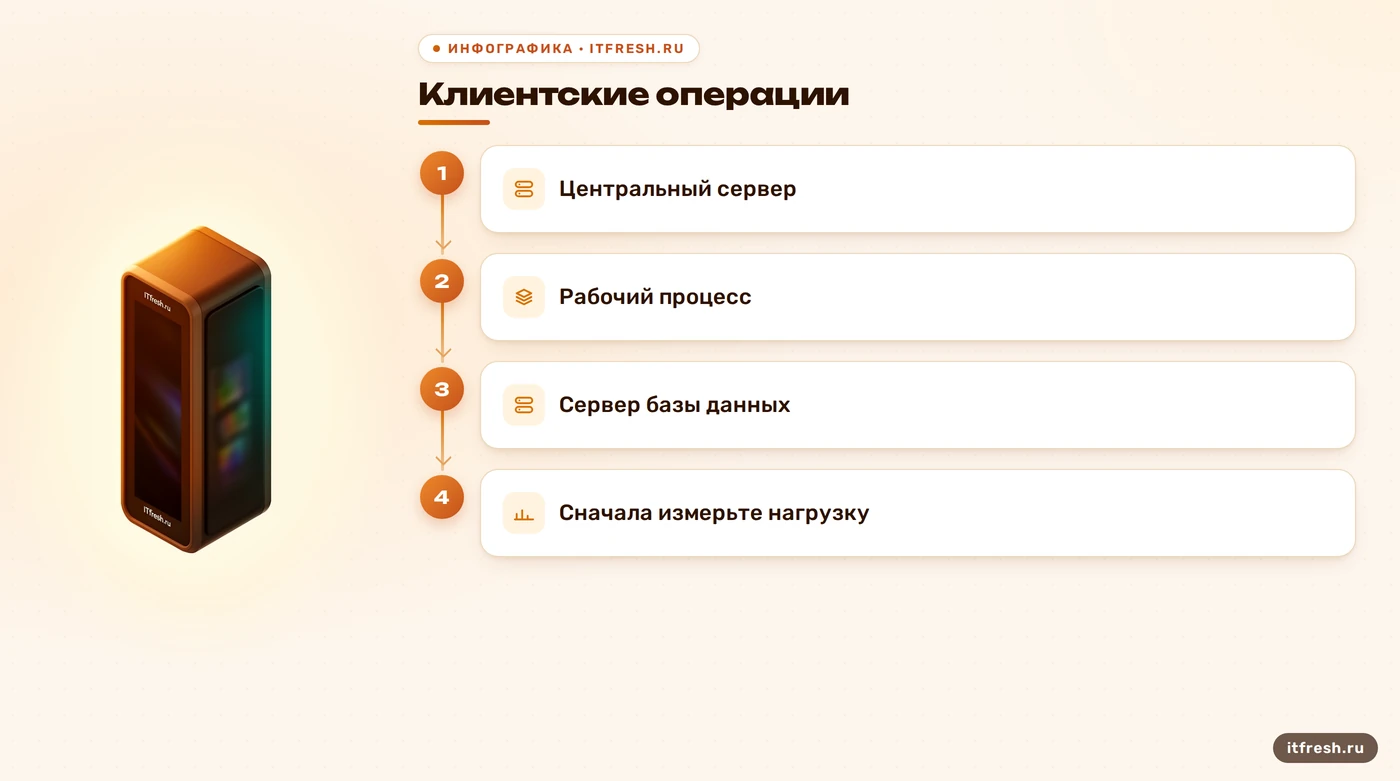
В клиент-серверной архитектуре центральный сервер управляет кластером и его реестром, а рабочие процессы обслуживают клиентские соединения и обращаются к серверу базы данных. Центральный сервер направляет новое подключение к рабочему процессу с учётом статистики его загрузки. Это не отдельный «диспетчерский компьютер», обязательный для каждой установки: простейший кластер 1С может работать на одном компьютере и содержать один рабочий процесс. Разделение по машинам — вариант масштабирования, а не закон природы.
На рабочем сервере может выполняться один или несколько процессов rphost. Число процессов само по себе не равно производительности: каждый процесс требует памяти, а увеличение их количества повышает конкуренцию за CPU и ресурсы базы. Настраивать несколько узлов имеет смысл, когда измерения показывают, что один сервер упирается в ресурсы или требуется распределить конкретные роли. Если причина в неоптимальном запросе, копирование того же запроса на ещё один сервер не исправит его магическим образом.
База данных — отдельная часть схемы, но обязательного правила «всегда выносить её на другой сервер» нет. Решение зависит от размеров базы, интенсивности операций, требований к доступности и доступных ресурсов. Совместное размещение может быть разумным для небольшой нагрузки; разнесение упрощает независимое масштабирование, но добавляет сетевой обмен и требует отдельного расчёта. На схеме полезно показать не только узлы 1С, но и СУБД, хранилище и сетевые связи между ними.
Отказоустойчивость также не появляется от самого слова «кластер». Несколько рабочих серверов позволяют наращивать возможности и проектировать резервирование, но доступность зависит от конфигурации ролей, лицензирования, СУБД, сети и сценария отказа. Надо заранее определить, что именно система обязана пережить и за какое время восстановиться. Без этого «кластер из двух серверов» может оказаться просто двумя машинами, которые одинаково не готовы к отказу базы данных.
- Центральный сервер управляет кластером и направляет подключения.
- Рабочие процессы обслуживают соединения и исполняют серверный код.
- Сервер базы данных оценивают отдельно или как общий ресурс.
Условный пример: лаборатория «ПлёнкаТест»
Для примера оставлю лабораторию контроля покрытий «ПлёнкаТест» с 25 рабочими местами. Это модель для расчёта, а не подтверждённый замер внедрения. В ней часть сотрудников работает с обычными документами, а инженеры периодически строят тяжёлые отчёты и запускают обработку результатов. Такое описание уже говорит больше, чем число «25»: есть разные сценарии, фоновые операции и периоды, когда они накладываются друг на друга.
Сначала я фиксирую, когда начинается пик, какие операции его создают и сколько длится каждая. Затем смотрю на загрузку CPU, доступную и занятую память, дисковые задержки, активность СУБД и длительность ключевых действий пользователя. Если измерения показывают, что процессор простаивает, а память или диск перегружены, покупать дополнительные ядра бессмысленно. Если же очередь операций растёт вместе с загрузкой CPU, проверяю профиль процессора, параллельность сценариев и запросы конфигурации.
Здесь нельзя заранее объявить, что активны ровно 18–20 сеансов, что отчёт съедает определённый объём RAM или что после разделения узлов отклик обязательно станет вдвое быстрее. Таких данных у нас нет. Подмена отсутствующих замеров красивой цифрой не делает расчёт точнее. Для «ПлёнкаТест» я бы сначала собрал базовую линию в обычный день и отдельно замерил вечернюю пакетную обработку, затем сравнил результаты после каждого изменения.
Если лаборатории нужно проверить сценарий до покупки железа, можно воспроизвести типовую работу на тестовом стенде. У 1С есть Корпоративный инструментальный пакет с инструментами многопользовательского нагрузочного тестирования; он помогает оценить систему в заданных условиях и сравнить конфигурации оборудования и программ. Это не заменяет сценарии конкретной организации: тестовый результат полезен настолько, насколько тест похож на реальную работу. Набор цифр без описания сценария — отчёт, который умеет производить бумагу.
Какие метрики собирать перед расчётом
Начните с интервала, в котором пользователи действительно замечают замедление. Запишите число сеансов и важных операций, расписание фоновых и регламентных заданий, длительность отчётов и обменов. Отдельно отметьте закрытие периода и другие редкие, но тяжёлые сценарии. Для сравнения полезны и спокойный интервал, и пик: тогда видно, какая нагрузка постоянная, а какая появляется только при совпадении нескольких процессов.
На узлах 1С сопоставляйте загрузку CPU с потреблением памяти рабочими процессами, количеством процессов и временем выполнения операций. На сервере базы данных проверяйте собственные метрики СУБД, ожидания, блокировки и дисковую подсистему. На клиенте смотрите задержки сети и ресурсы рабочей станции. Один счётчик не объяснит причину: например, свободный CPU не исключает ожидание диска или блокировку в базе, а высокое потребление памяти не доказывает утечку.
Для администрирования кластера доступны консоль администрирования и средства платформы. Утилита rac работает совместно с сервером администрирования RAS; не следует обещать, что произвольная команда rac покажет «всю нагрузку» или готовое число активных пользователей. Сначала определите, какие сущности и показатели нужны, затем выбирайте способ сбора. Технологический журнал и мониторинг производительности помогают разбирать конкретные события и длительные операции, но их надо включать и настраивать под задачу.
Если система уже работает, снимайте показатели регулярно и сравнивайте одинаковые периоды. Зафиксируйте версию платформы, конфигурацию, параметры виртуальной машины, СУБД и изменения в расписании. После оптимизации повторите тот же сценарий, иначе сравниваются разные условия. Для нового проекта полезнее провести нагрузочный тест на близкой к целевой конфигурации, чем экстраполировать чужой результат на свою базу. В документации 1С описан КИП для многопользовательских испытаний и оценки серверного оборудования; его стандартный тест — ориентир, а не обещание производительности вашей конфигурации.
- Пиковые сеансы и операции, а не только штат.
- CPU, память, диск и задержки СУБД.
- Расписание фоновых заданий и длительность пиков.
- Версии, настройки и повторяемый сценарий измерения.
Память и настройки: не ставьте лимиты наугад
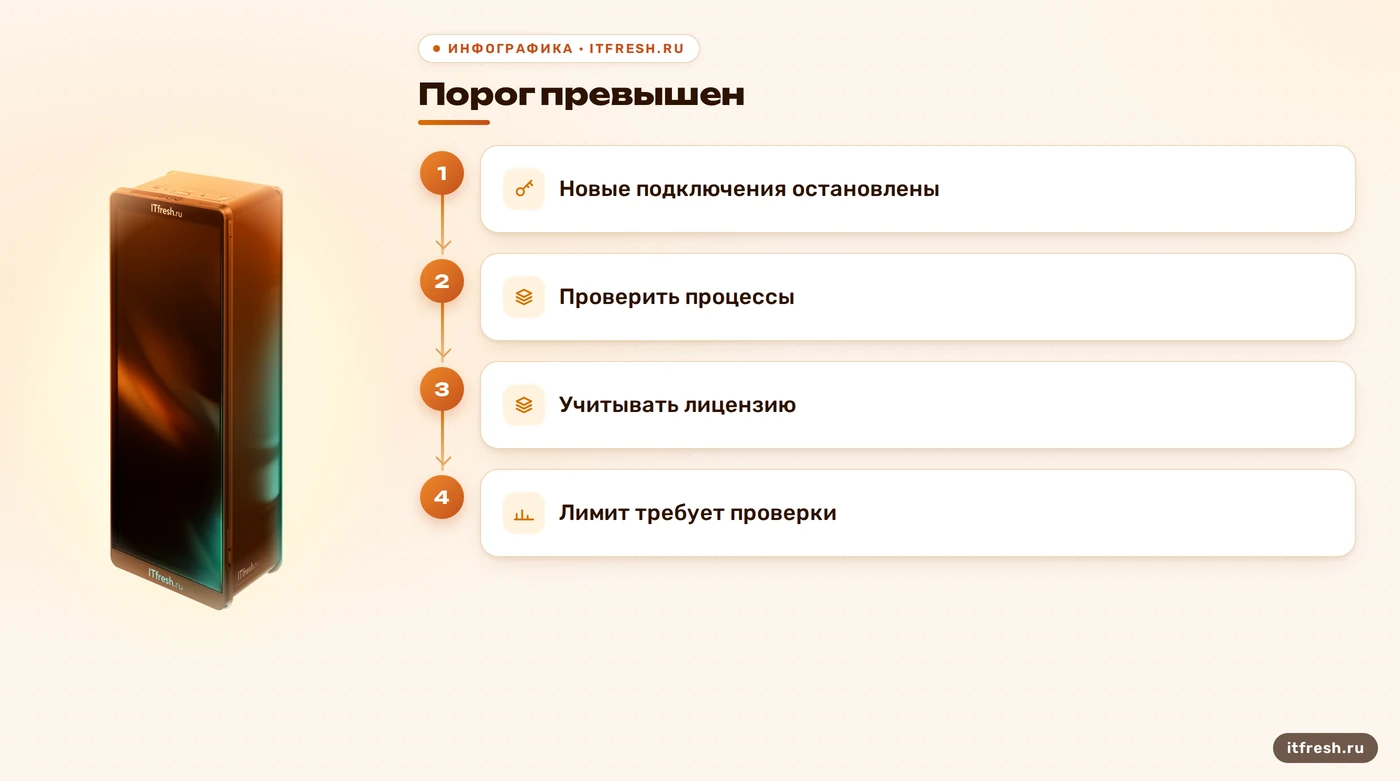
В платформе есть настройки, ограничивающие потребление памяти процессами на рабочем сервере. Их смысл не в том, чтобы объявить всем процессам одинаковую «норму», а в контролируемом поведении при превышении порогов. По описанию 1С, при превышении временно допустимого объёма сервер перестаёт назначать новые соединения; если превышение сохраняется заданный период, перезапускаются наиболее прожорливые рабочие процессы. При превышении критического объёма процессы могут быть остановлены и запущены заново немедленно. Это защитный механизм с последствиями для сеансов, а не бесплатное ускорение.
Следовательно, лимиты нельзя включать по совету «поставьте побольше». Сначала выясните доступную память с учётом операционной системы, СУБД и соседних служб, оцените число rphost и характер нагрузки. Затем проверьте, какие параметры доступны вашей версии и уровню лицензии. В официальной документации 1С отмечено, что ряд функций управления потреблением памяти и распределением нагрузки относится к возможностям CORP; доступность конкретной настройки надо сверить с вашей лицензией и релизом. Иначе можно спроектировать настройку, которую нельзя легально или технически применить.
Недостаток памяти иногда приводит к интенсивной подкачке и замедлению, но не всякий медленный сервер «упёрся в RAM». И наоборот, большой объём свободной памяти в момент снимка не гарантирует, что её хватит на вечернее совпадение отчётов и фоновых заданий. Смотрите на динамику и пиковые значения, а также на поведение процессов после завершения операций. Универсальный запас в процентах без базового измерения — такое же гадание, только с процентным знаком.
При превышении порога часть процессов может перезапуститься, поэтому до включения защитных настроек оцените, как приложение переносит повторное подключение и что увидит пользователь. Проверьте работу на стенде или в согласованное окно, сохраните исходные значения и план возврата. Настройка должна удержать кластер в управляемом состоянии и дать данные для расследования, а не маскировать неверный размер сервера. Если лимит срабатывает регулярно, надо разбираться с причиной и проектной ёмкостью, а не просто двигать границу всё выше.
Как принять решение о составе сервера
Соберите исходные сценарии, проведите замеры в пике и найдите самое узкое место. Рассчитайте ресурсы рабочей части, базы данных и операционной системы отдельно, даже если на первом этапе они будут размещены на одной машине. Проверьте, где достаточно вертикального увеличения ресурсов, а где нужен дополнительный рабочий сервер или отдельный узел для СУБД. Для каждого варианта оцените не только производительность, но и лицензии, резервирование, поддержку и последствия отказа.
Затем проверьте расчёт нагрузочным тестом либо контролируемым пилотом на целевых сценариях. Условия теста нужно зафиксировать: версия платформы, состав оборудования, параметры виртуализации, конфигурация и набор операций. Начинайте с реалистичного числа параллельных пользователей, постепенно поднимайте нагрузку и наблюдайте за всеми слоями системы. Цель — найти приемлемое время выполнения ключевых операций с запасом под ваш ожидаемый рост, а не получить один высокий результат в рекламном прогоне.
Не закладывайте в план конкретное число ядер на сеанс, проценты запаса или обязательные два сервера, если их не подтверждают замеры и требования к доступности. Не обещайте, что толстый, тонкий или веб-клиент автоматически изменит нагрузку в известное число раз. Не объявляйте раздельные узлы обязательными для всех. Эти короткие «правила» живут дольше, чем реальные причины тормозов, потому что их удобно повторять. Для покупки оборудования нужна спецификация с исходными данными, пиковым сценарием, узкими местами и критериями приёмки.
Итоговый документ должен отвечать на практические вопросы: какие ресурсы нужны сейчас, что ограничивает систему, какой запас предусмотрен и при каком росте потребуется следующий шаг. Отдельно укажите зависимости от лицензий платформы и СУБД, резервные копии и ожидаемое время восстановления. Если цифр пока недостаточно, честный результат аудита — план измерений, а не уверенная конфигурация наугад. Серверная закупка не терпит пророчеств: у неё слишком дорогой способ проверить, кто был прав.
- Снимите нагрузку в спокойный период и в пик.
- Найдите ограничивающий ресурс по слоям.
- Проверьте целевые сценарии нагрузочным тестом.
- Зафиксируйте критерии приёмки и план роста.
Частые вопросы
Сколько ядер нужно на одного пользователя 1С?
Универсального коэффициента нет. Число ядер определяют по параллельным операциям, конфигурации и измерениям в пиковом сценарии.
Обязательно ли ставить центральный и рабочий серверы на разные машины?
Нет. Простейший кластер может работать на одном компьютере с одним рабочим процессом. Разделение выбирают по нагрузке и требованиям к доступности.
Как измерить нагрузку кластера?
Сопоставьте показатели рабочих процессов, CPU и памяти с метриками СУБД, диска, сети и временем ключевых операций. Для тестирования используйте сценарий, похожий на рабочий.
Нужно ли сразу задавать лимиты памяти rphost?
Сначала измерьте потребление и проверьте доступные параметры для вашей версии и лицензии. Пороговые настройки могут остановить или перезапустить рабочие процессы.
Можно ли считать активные сеансы равными активной нагрузке?
Нет. Сеанс не означает постоянную работу процессора, а фоновые задания и пакетные операции могут создавать нагрузку независимо от числа сотрудников.
Источники
- Архитектура кластера — 1С:Предприятие — Состав кластера, роли центрального сервера и рабочих процессов, распределение подключений и пример простого кластера.
- Ограничение объема памяти рабочих процессов — 1С:Предприятие — Описание порогов памяти рабочего сервера и поведения кластера при их превышении.
- Корпоративный инструментальный пакет — 1С:Предприятие — Возможности многопользовательского нагрузочного тестирования и оценки серверного оборудования.
- 1C:Enterprise CORP level functionality — 1C:Enterprise Knowledge Base — Функции управления распределением нагрузки и потреблением памяти, доступные для уровня лицензии CORP.
- Тонкий клиент — 1С:Предприятие — Распределение функциональности тонкого клиента и серверной части в клиент-серверном варианте.
- Server cluster administration server — 1C:Enterprise Knowledge Base — Подтверждает назначение связки утилит rac и сервера администрирования ras.