
Как контролировать память rphost и работу кластера 1С
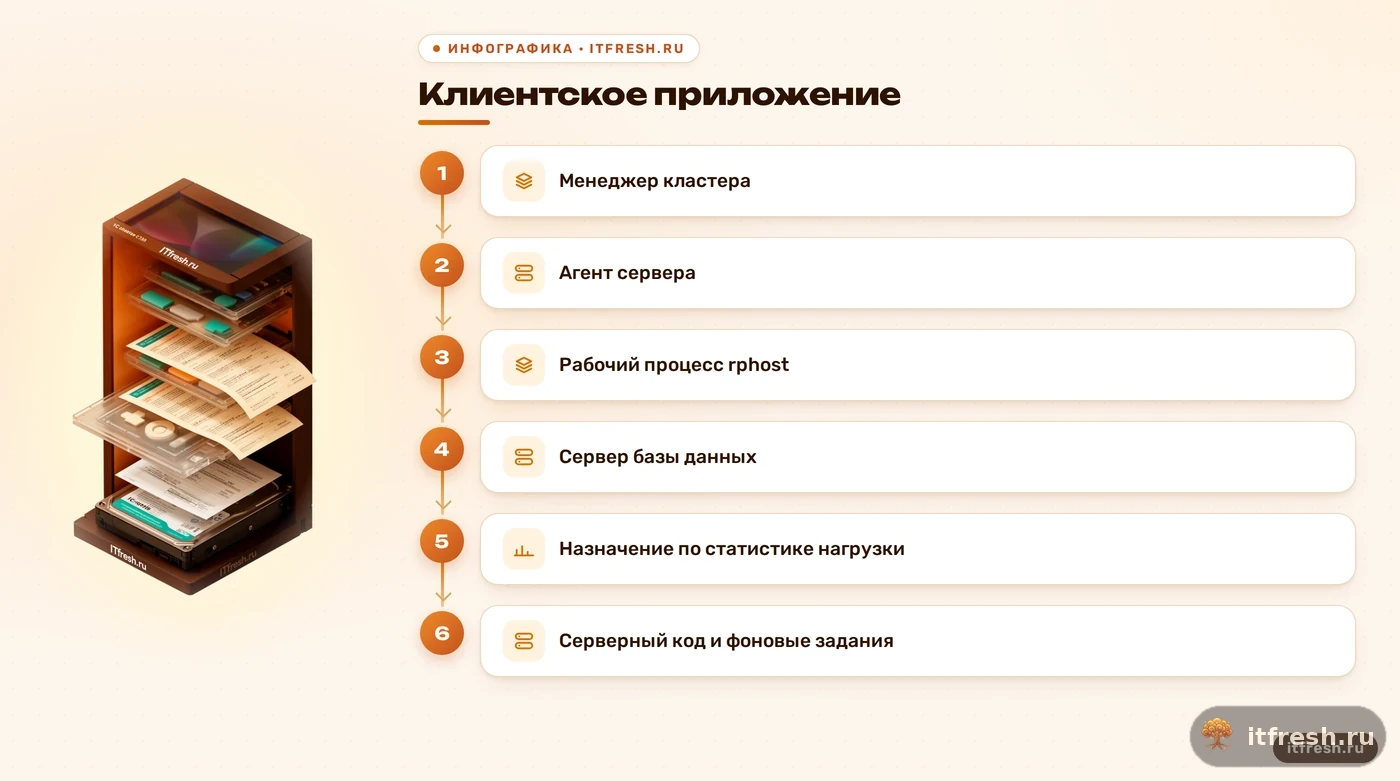
rphost — рабочий процесс кластера 1С: он обслуживает клиентские приложения, выполняет серверный код и обращается к серверу баз данных. Чтобы понять рост памяти, я сравниваю показатели процесса и всего сервера, проверяю настройки кластера и динамику нагрузки. Ни один процент ОЗУ сам по себе не доказывает утечку.
Что делает rphost и чем отличаются процессы кластера
rphost.exe — рабочий процесс кластера «1С:Предприятия». Он обслуживает клиентские приложения, выполняет серверный код конфигурации и обращается к серверу баз данных. Рабочий процесс может также выполнять фоновые задания. Поэтому rphost — не «программа базы» и не прокси между пользователем и SQL: это часть серверной логики платформы. Если нужен регулярный контроль инфраструктуры, можно подключить мониторинг Zabbix, но сначала следует определить, какие именно показатели объясняют сбой.
В кластере есть и другие процессы с другими задачами. ragent — агент сервера, который участвует в работе узла; rmngr — менеджер кластера, управляющий его функционированием и реестром. Подменять их роли нельзя: особенно вредно считать ragent «агентом обмена данными» и пытаться искать в нём причины роста памяти rphost. Для первичной диагностики я записываю имя процесса, его идентификатор и сервер, на котором он работает.
На рабочем сервере может работать один или несколько процессов rphost. Центральный менеджер назначает новые клиентские соединения на основе долгосрочной статистики загрузки рабочих процессов. Это не обещание идеально равномерной нагрузки в каждый момент: уже открытые сеансы и длительные операции могут распределяться иначе, чем хотелось бы администратору. В общем разборе мониторинга сервера 1С важны те же правила: сначала наблюдать нагрузку, потом менять архитектуру.
- rphost.exe — рабочий процесс
- ragent — агент сервера
- rmngr — менеджер кластера
Почему растёт память и что показывают счётчики
У rphost нет универсальной нормы в гигабайтах, которая подходит каждой базе. Расход зависит от прикладного кода, состава сеансов, фоновых заданий и текущей нагрузки. Один высокий замер не доказывает утечку, как и короткое снижение после перезапуска не доказывает, что причина устранена. Я смотрю на динамику процесса вместе с доступной памятью сервера и пользовательскими симптомами.
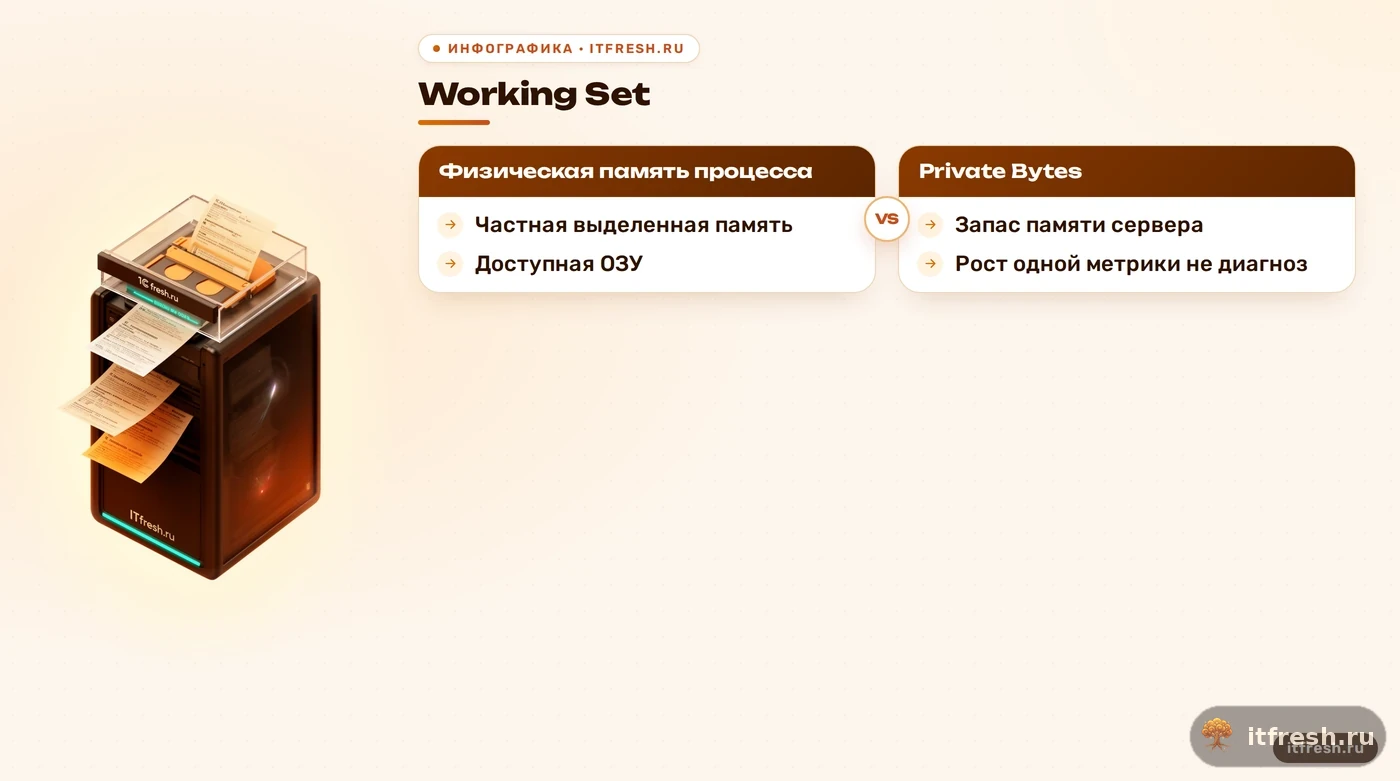
В Windows полезно различать Working Set и Private Bytes. Working Set показывает объём страниц процесса, находящихся в физической памяти; в него могут входить общие страницы. Private Bytes отражает частную выделенную память процесса, а не только оперативную память, которая прямо сейчас занята в физическом ОЗУ. Эти показатели отвечают на разные вопросы, поэтому подменять один другим и делать вывод по одному числу нельзя. Я сохраняю оба счётчика по отдельным экземплярам и сопоставляю их с нагрузкой. Когда Working Set падает, а Private Bytes остаётся высоким, это может означать, что часть выделенной памяти перестала быть резидентной; по этой картине одной нельзя отличить нормальное поведение от утечки. Сравниваю повторные периоды одинаковых заданий и проверяю, возвращаются ли показатели к привычному уровню после завершения нагрузки.
В платформе 1С предусмотрены ограничения памяти на уровне рабочего сервера кластера. При превышении временно допустимого объёма новые соединения на этот сервер больше не назначаются. Если превышение сохраняется заданный интервал, платформа перезапускает рабочие процессы с наибольшим потреблением памяти; критический порог запускает освобождение памяти немедленно. Это штатная защита кластера. Ищите эти параметры в административных настройках рабочего сервера, а не в случайных инструкциях с несуществующими ключами.
Порог нельзя вычислить по правилу «оставить процессу 80 процентов ОЗУ». На узле могут одновременно работать Windows, сервер 1С, СУБД, резервное копирование и другие службы. Их доли памяти зависят от реальной конфигурации. Лимит, который существует только в советах из интернета, сервер не спасает. Я задаю его после наблюдения за нормальной нагрузкой и проверяю, как платформа ведёт себя при превышении.
- Working Set процесса
- Private Bytes процесса
- Доступная память сервера
- Сеансы и нагрузка пользователей
Какие метрики собирать в Zabbix
Для Windows я собираю память каждого экземпляра rphost и всего сервера, загрузку процессора, а также доступную ОЗУ. По возможности добавляю показатели кластера 1С: активные сеансы, состояние рабочих процессов и время ответа на типовые действия. Метрики только одного процесса не отвечают на главный вопрос — отбирает ли он память у операционной системы и заметили ли это пользователи.
Windows Performance Monitor предоставляет счётчики процессов и памяти. Zabbix умеет получать их через ключ perf_counter[]; для систем с разными языками Windows есть вариант perf_counter_en. Названия объектов и экземпляров могут отличаться между локализациями, а несколько rphost требуют различать экземпляры. Поэтому перед массовой настройкой я проверяю доступные счётчики на самом сервере и включаю обнаружение экземпляров, если их состав меняется.
Интервал сбора и пороги тревог не должны появляться из случайного примера. Сначала собираю историю обычного рабочего дня и сравниваю периоды нагрузки, резервного копирования и выполнения регламентных заданий. После этого задаю тревогу на устойчивый рост Private Bytes вместе с падением доступной памяти, а не на абстрактное «занято больше 75 процентов». Слишком частый опрос тоже требует ресурсов, поэтому частоту выбираю с учётом задержки реакции и нагрузки на агент.
В Zabbix я разделяю предупреждение и действие. Предупреждение сообщает, что процесс или весь сервер отклоняется от своей обычной картины; оно не должно само завершать rphost. Для реакции нужен следующий шаг: проверить сеансы, журнал ошибок, нагрузку СУБД и изменения конфигурации. Иначе автоматизация быстро превращает один тревожный график в несколько отключённых пользователей.
- Память каждого экземпляра rphost
- Доступная память всего сервера
- Процессор и активные сеансы
- Ошибки и время ответа
Условный разбор: студия «Еврострой-М»
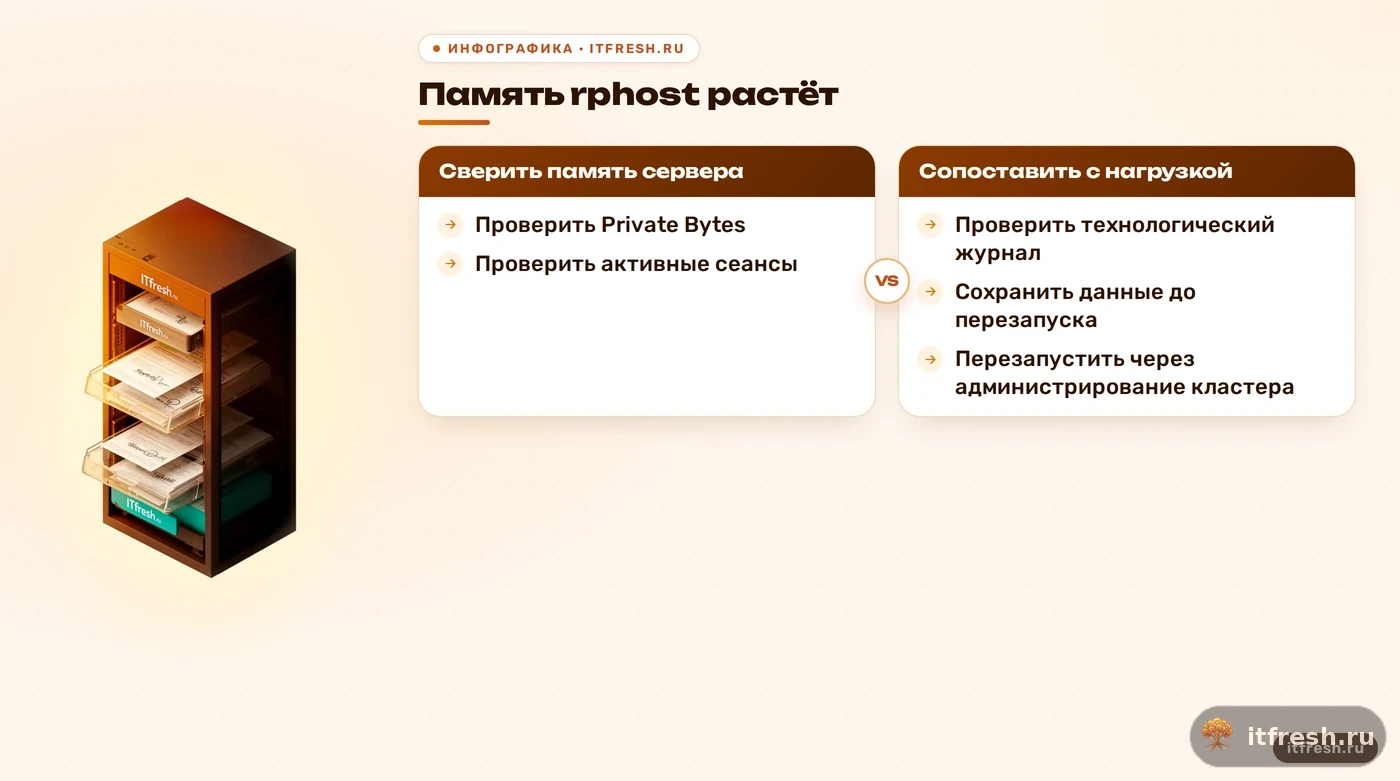
Представим условную ситуацию студии «Еврострой-М»: после обновления конфигурации в графике один rphost продолжает набирать Private Bytes, хотя число активных сеансов уже не растёт. Я не называю конкретные гигабайты и не объявляю это утечкой по одному графику. Сначала сравниваю показатели этого процесса с Working Set, доступной памятью сервера и временем появления пользовательских жалоб.
Если рост повторяется после снижения нагрузки и связан с конкретными действиями, проверяю, какие сеансы и фоновые задания попали на этот процесс, какие ошибки появились в технологическом журнале и совпадает ли начало с изменением конфигурации или релиза платформы. Если растёт только Working Set во время нагрузки, но Private Bytes и доступная память стабилизируются, это другой сигнал, чем продолжающийся рост частной памяти при свободных сеансах.
Перезапуск может вернуть память операционной системе, но он не объясняет, почему она росла. После него полезно сохранить графики до и после, проверить повторяемость сценария и только затем решать, нужен ли анализ кода, настройка памяти кластера или изменение ресурсов. Перезапуск — это аварийный сброс, а не план мониторинга.
- Сравнить показатели одного процесса
- Сверить динамику сеансов и памяти
- Проверить ошибки и изменения конфигурации
Где искать причину после тревоги
Начинаю с временной шкалы: когда выросла память, что происходило с сеансами, загрузкой процессора и доступной ОЗУ, какие задания запускались. Важно смотреть отдельные экземпляры rphost, а не только общий итог по серверу. Если один процесс отличается от остальных, это сужает поиск; если растут все, проверяю общую нагрузку, сервер базы данных и фоновые операции. Сравниваю события в контексте всего узла: совпадение с резервным копированием или обновлением может объяснить пик, а постепенный рост при спокойной нагрузке требует отдельно проверить задания и код. Так я не ищу утечку там, где нагрузка просто переместилась.
Для платформенных ошибок проверяю технологический журнал и журнал событий Windows. Технологический журнал настраивается конфигурацией logcfg.xml; конкретные расположение и состав записей зависят от настроек. Встроенный мониторинг кластера проверяет рабочие процессы и может завершить проблемный процесс, предварительно создав дамп памяти. Это полезная возможность для расследования, но её поведение и сбор дампов нужно учитывать при настройке эксплуатации.
Не следует считать, что в любом логе rphost лежат все SQL-запросы с точным временем выполнения. Диагностика может потребовать сопоставить технологический журнал 1С, журнал регистрации и отдельные средства СУБД. Когда проблема похожа на нехватку лицензий или ограничение сеансов, полезно также смотреть мониторинг SQL Server для 1С: он показывает другую часть цепочки, не заменяя анализ рабочих процессов.
- Графики по каждому rphost
- Активные сеансы и фоновые задания
- Технологический журнал 1С
- Журналы СУБД и Windows
Как перезапускать и когда менять конфигурацию
Перезапускать весь сервер 1С ради одного рабочего процесса — грубый первый шаг. Для кластера предусмотрено управляемое завершение и повторный запуск рабочих процессов, а также периодический перезапуск по заданию администратора. Настройки ограничений памяти позволяют платформе выбрать процессы с самым большим потреблением. При ручном вмешательстве я сначала проверяю активные сеансы и предупреждаю пользователей о возможном переподключении.
Не останавливайте всю службу ради одного рабочего процесса и не запускайте автоперезапуск по произвольному числу сеансов. Число открытых сеансов не измеряет потребление памяти. Если процесс нужно завершить, используйте штатные средства администрирования кластера и заранее предусмотрите сбор данных для разбора причины.
Добавлять рабочие процессы или отдельный сервер имеет смысл после измерений. Документация 1С указывает, что несколько рабочих процессов могут снизить нагрузку на каждый из них, а дополнительные рабочие серверы позволяют увеличить число процессов и клиентских соединений без роста нагрузки на каждый конкретный процесс. Я всё равно проверяю результат по графикам: новый процесс расходует ресурсы, а перегруженная СУБД от такого изменения быстрее не становится.
- Проверить настройки кластера
- Сохранить данные до перезапуска
- Проверить эффект по тем же метрикам
Частые вопросы
Что такое rphost в 1С?
Это рабочий процесс кластера: он обслуживает клиентские приложения, выполняет серверный код и взаимодействует с сервером баз данных.
Сколько памяти должен потреблять rphost?
Универсальной нормы нет. Оценивайте динамику Working Set и Private Bytes вместе с доступной памятью сервера и нагрузкой.
Где задаются ограничения памяти 1С?
На уровне рабочего сервера кластера, через средства администрирования 1С. Параметры задавайте по фактической нагрузке и с учётом служб, работающих на узле.
Что собирать в Zabbix?
Память отдельных экземпляров rphost, доступную ОЗУ сервера, загрузку процессора и показатели нагрузки кластера, включая сеансы и ошибки.
Нужно ли перезапускать всю службу 1С?
Обычно начинать с остановки всей службы не следует. Используйте администрирование кластера и планируйте переподключение пользователей.
Где смотреть ошибки rphost?
Проверяйте технологический журнал 1С и журнал событий Windows. Технологический журнал настраивается через logcfg.xml; его состав зависит от конфигурации.
Источники
- 1С: Архитектура кластера — Роли rphost и rmngr, назначение клиентских соединений по статистике загрузки рабочих процессов — https://v8.1c.ru/platforma/arkhitektura-klastera/
- 1С: Ограничение объёма памяти рабочих процессов — Временно допустимый и критический объёмы памяти, прекращение назначения соединений и перезапуск наиболее потребляющих процессов — https://v8.1c.ru/platforma/ogranichenie-obema-pamyati-rashoduemoy-rabochimi-protsessami/
- 1С: Мониторинг состояния кластера — Проверки рабочих процессов, запись результатов в технологический журнал и создание дампа перед завершением проблемного процесса — https://v8.1c.ru/platforma/monitoring-sostoyaniya-klastera/
- 1С: Технологический журнал — Назначение технологического журнала, его настройка через logcfg.xml и сведения об аварийном завершении — https://v8.1c.ru/platforma/tehnologicheskiy-zhurnal/
- Zabbix: Windows performance counters — Ключ perf_counter[], английские имена счётчиков и обнаружение нескольких экземпляров объектов — https://www.zabbix.com/documentation/current/en/manual/config/items/perfcounters
- Microsoft: Memory Performance Information — Значения счётчиков Working Set и Private Bytes для процесса Windows — https://learn.microsoft.com/en-us/windows/win32/memory/memory-performance-information