База Zabbix душит сервер: TimescaleDB, сжатие и расчёт места для 50 хостов
Через полгода ваши графики грузятся вечность, а housekeeper ест весь CPU? Проблема не в железе, а в глупых настройках. Я покажу, как связать Zabbix 7.0 с TimescaleDB, включить сжатие и настроить housekeeper, чтобы история не убивала базу. Разберу расчёт объёма для сети аптек и дам рабочие команды без воды.
Почему база Zabbix раздувается быстрее, чем вы думаете
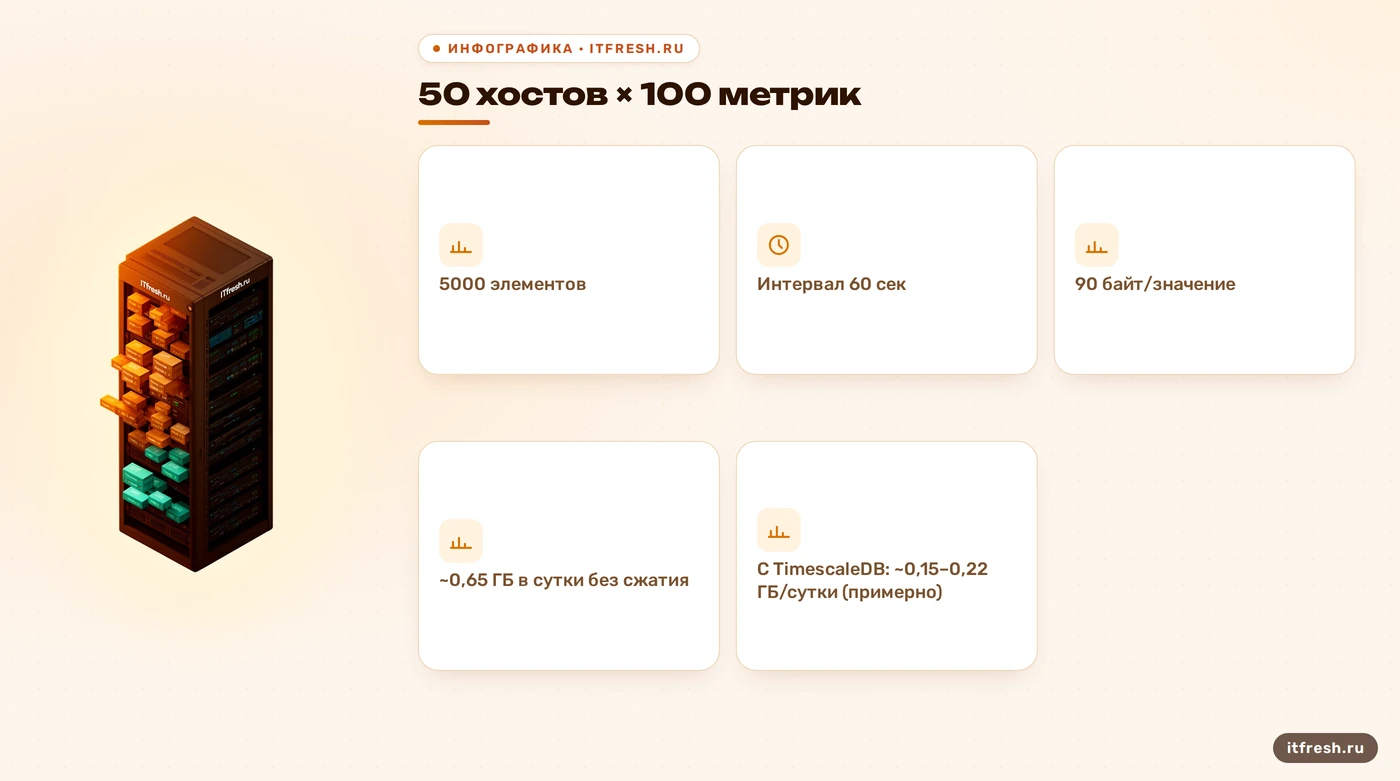
Многие считают, что мониторинг — это просто сбор метрик. Но когда у вас 50 хостов и по 100 метрик на каждом, вы получаете 5 000 элементов сбора. Согласно документации Zabbix 7.0, для числовых значений один пункт истории весит около 90 байт. Если собирать их каждую минуту, то за одни сутки вы генерируете примерно 650 мегабайт сырых данных. Без сжатия и очистки через год на диске окажется более 200 гигабайт, а база PostgreSQL превратится в каменную глыбу. Это математика, а не фантастика: если не вмешаться, диск заполнится неизбежно.
В сети аптек «Витамин-Плюс» у нас было 41 рабочее место и 12 точек продаж. Мы мониторили всё: от нагрузки на кассы до температуры в холодильниках. Через полгода графики стали грузиться по 20 секунд, а процесс housekeeper в top занимал 80 % процессорного времени. Администратор пытался добавить оперативки, но проблема была в архитектуре хранения. Обычный PostgreSQL без TimescaleDB плохо справляется с временными рядами такого объёма, особенно при частых запросах к истории за полгода. Добавление памяти тут не поможет, если структура данных неэффективна.
Главная ошибка — надежда на «стандартные» настройки. По умолчанию Zabbix сохраняет историю и тренды, но если вы не настроили сжатие и партиционирование, удаление старых данных становится тяжелейшей операцией для СУБД. Housekeeper начинает удалять миллионы строк, блокируя таблицы и вызывая таймауты в веб-интерфейсе. Это классическая ловушка: чем больше данных, тем медленнее они удаляются, и тем больше нагрузка на систему. Я лично видел, как админы пытались «починить» это перезагрузкой сервера, пока база не умирала окончательно. Перезагрузка не лечит архитектуру, она лишь временно откладывает катастрофу.
- Расчёт: 5000 элементов × 60 сек интервал × 86400 сек/сутки × 90 байт ≈ 0,65 ГБ в сутки без сжатия.
- При отсутствии сжатия база растёт линейно, а производительность падает экспоненциально.
- При корректных параметрах длительность цикла housekeeper ограничена и не приводит к часам простоя.
TimescaleDB в связке с Zabbix 7.0: установка и расширение
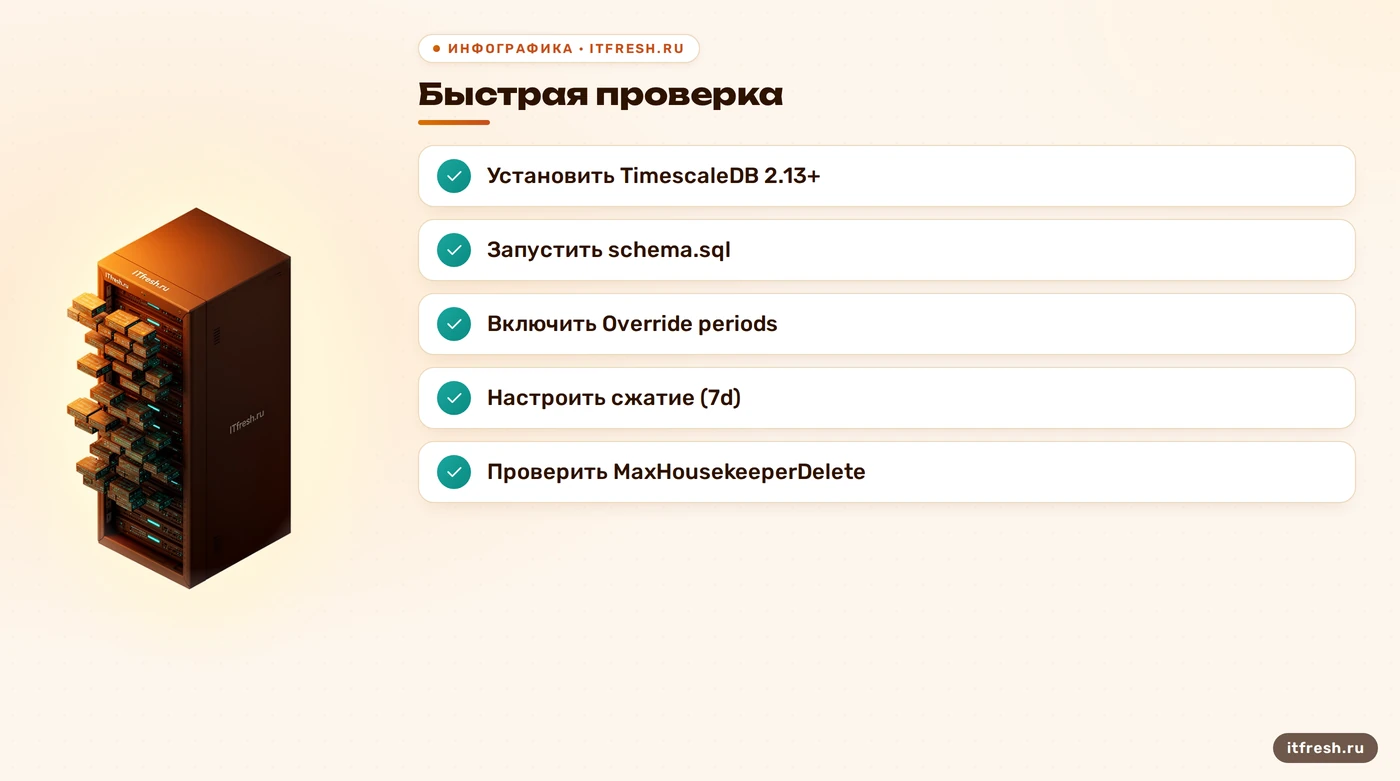
Для работы с большими объёмами истории Zabbix 7.0 рекомендует использовать TimescaleDB Community Edition. Это расширение для PostgreSQL, которое превращает обычные таблицы в гипертблицы (hypertables) с автоматическим партиционированием по времени. Важно: версия TimescaleDB должна быть в диапазоне 2.13.0 – 2.30.X для совместимости с Zabbix 7.0. Установка начинается с создания обычной базы данных PostgreSQL, после чего мы добавляем расширение. Команда для активации выглядит так: echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix. Никаких танцев с бубном, просто стандартная команда.
После установки расширения нужно применить специализированную схему Zabbix. В версии 7.0 путь к скрипту изменился и теперь находится в /usr/share/zabbix-sql-scripts/postgresql/timescaledb/schema.sql. Запуск этого скрипта преобразует таблицы history и trends в гипертблицы, настраивает сжатие и включает механизмы автоматического удаления старых данных. Выполнять это нужно командой: cat /usr/share/zabbix-sql-scripts/postgresql/timescaledb/schema.sql | sudo -u zabbix psql zabbix. Важно помнить, что при миграции существующих данных сервер Zabbix и веб-фронтенд должны быть остановлены. Иначе получите кашу вместо базы, которую потом придётся восстанавливать из бэкапа.
Особое внимание уделите параметрам чанков (chunks). Документация советует для таблиц трендов устанавливать chunk_time_interval в 30 дней, но при большом количестве элементов лучше снизить это значение до 7 дней. Это ускорит операции сжатия и удаления. Скрипт schema.sql по умолчанию включает сжатие и настраивает сжатие записей старше 7 дней. Без этого механизма ваша база будет расти бесконтрольно, даже если вы настроили housekeeper. Я не раз видел, как админы ставили Enterprise-версию и удивлялись, почему сжатие не работает — там другая лицензия, и функционал отличается.
Настройка сжатия и параметров хранения в Zabbix
Сжатие в TimescaleDB — это не просто экономия места, это способ сохранить производительность. По умолчанию в схеме Zabbix включено сжатие (Enable compression), а сжимать начинают записи старше 7 дней. Изменение этих параметров вступает в силу в течение 2 * HousekeepingFrequency часов. Важно: уже сжатые данные нельзя изменить, удалить или обновить напрямую. Они становятся рид-онли до момента, пока не будут удалены housekeeper'ом. Поэтому критично правильно задать периоды хранения. Я всегда говорю клиентам: если вам не нужны данные старше недели, не храните их в сыром виде, это пустая трата ресурсов.
В веб-интерфейсе Zabbix в разделе Administration > Housekeeping есть два важных переключателя: Override item history period и Override item trend period. Они позволяют задать глобальные сроки хранения, которые перекроют настройки в каждом отдельном элементе. При использовании TimescaleDB эти опции крайне полезны для автоматического удаления старых чанков. Без них данные партиционируются, но старые партиции не удаляются, и вы увидите предупреждения в разделе System information. Рекомендуется хранить сырую историю 7–14 дней, а тренды — 5 лет, как советует документация. Это золотой стандарт, от которого не стоит отклоняться без веской причины, иначе вы снова упрётесь в потолок диска.
Для сетевой аптеки «Витамин-Плюс» мы выбрали стратегию: история 10 дней, тренды 3 года. Это позволило сохранить детализацию для оперативного реагирования на инциденты, но освободило место для долгосрочной аналитики. Элементы с настройкой «Do not store» не затрагиваются этими глобальными правилами, что удобно для логов и текстовых данных. Помните, что тренды недоступны для типов Character, Log и Text, поэтому для них настройка периода трендов бессмысленна. Не тратьте время на попытки настроить тренды для логов — это технически невозможно, и Zabbix об этом честно сообщит.
- Включите `Override item history period` и `Override item trend period` в настройках Housekeeping для корректной работы с TimescaleDB.
- Установите срок сжатия (Compress records older than) не менее 7 дней: данные старше этого периода сжимаются, а не удаляются.
- Проверьте, что лицензия TimescaleDB (Community Edition) позволяет использование сжатия.
Housekeeper: как не убить сервер при очистке
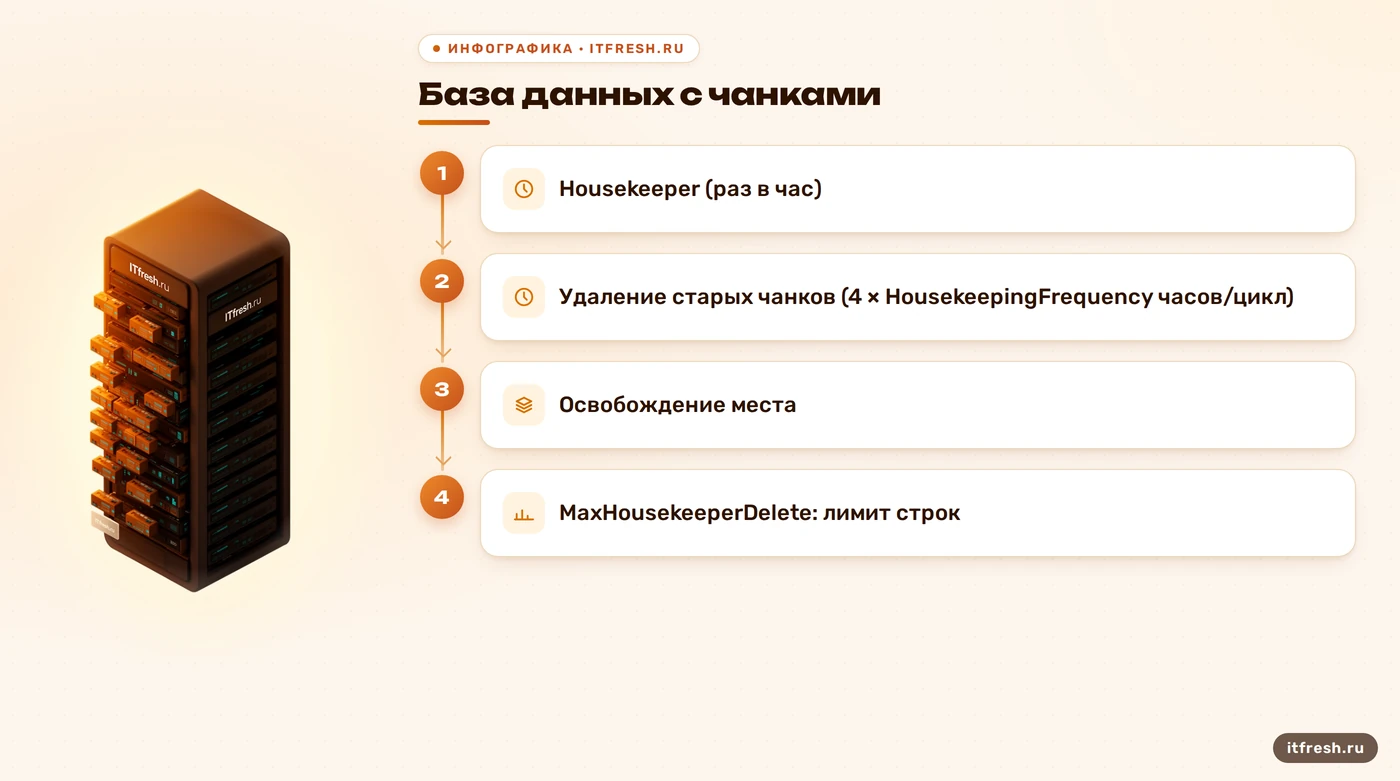
Сердце очистки данных — это housekeeper. Его поведение регулируется параметром HousekeepingFrequency в файле zabbix_server.conf. По умолчанию он равен 1 часу. Это означает, что очистка запускается раз в час. За один цикл удаляется не более 4 × HousekeepingFrequency часов устаревших данных на каждый элемент. Эта защита предотвращает перегрузку базы при резком сокращении периодов хранения. Однако, если вы уменьшили период хранения с года до недели, housekeeper будет работать очень долго, пытаясь удалить месяцы накопившихся данных. Я видел, как админы ставили HousekeepingFrequency=0 и забывали запускать очистку вручную, пока диск не заполнялся полностью, парализуя систему.
Параметр MaxHousekeeperDelete ограничивает количество строк, удаляемых за одну задачу в цикле. По умолчанию это 5000 строк. Диапазон значений — от 0 до 1 000 000. Для больших баз значение 5000 может быть малым, и очистка затянется. В наших проектах для средних нагрузок (до 10 000 метрик) мы ставим 50 000. Также обратите внимание на StartDBSyncers (по умолчанию 4) — документация предупреждает, что увеличение этого числа часто приносит больше вреда, чем пользы, создавая лишнюю конкуренцию за ресурсы БД. Не верьте мифам о том, что больше синхронизаторов — значит быстрее. Часто бывает наоборот.
Если вы отключите автоматический housekeeper (HousekeepingFrequency=0), он будет запускаться только по команде housekeeper_execute. В этом режиме период удаления рассчитывается как 4 * время с прошлого цикла, но не менее 4 часов и не более 4 суток. Это полезно для ручного контроля, но требует дисциплины. Первый запуск housekeeper после рестарта сервера всегда откладывается на 30 минут, чтобы дать системе стабилизироваться. Игнорирование этого факта часто приводит к панике админов, которые видят задержку в очистке сразу после перезагрузки и начинают паниковать, хотя это нормальное поведение системы.
Мониторинг самой базы данных и производительности
Мониторить мониторинг — это золотое правило. Zabbix предоставляет внутренние элементы данных для контроля состояния базы. Следите за zabbix[wcache,history,pfree] — это процент свободного места в history cache. Низкое значение (менее 10 %) говорит о том, что база не успевает кэшировать данные, и производительность резко упадет. Также полезны метрики zabbix[process,housekeeper,busy] и zabbix[process,history syncer,busy], которые показывают загруженность процессов очистки и синхронизации. Я всегда ставлю алерты на эти метрики, потому что они кричат о проблеме задолго до того, как пользователи начнут жаловаться на тормоза.
Важно отслеживать очередь задач с помощью zabbix[queue,6,]. Если очередь растет, значит, сервер не успевает писать данные в базу, и это часто предшествует падению производительности. Для TimescaleDB также полезно следить за размером чанков и временем их сжатия. Если сжатие идет слишком долго, возможно, стоит пересмотреть размер чанков или увеличить ресурсы базы. В «Витамин-Плюс» мы настроили триггер на падение свободного места в кэше истории ниже 15 %, что дало нам запас времени для реакции до того, как графики начнут тормозить. Превентивные меры всегда дешевле, чем восстановление после аварии.
Не забывайте про логирование медленных запросов. Параметр LogSlowQueries в zabbix_server.conf по умолчанию выключен (0). Включите его, установив порог в 5000 мс, чтобы видеть, какие запросы тормозят базу. Это поможет найти проблемные графики или триггеры, которые генерируют тяжелые запросы. Иногда достаточно просто удалить старый неактивный шаблон, чтобы база «выдохнула». Мониторинг БД — это не роскошь, а необходимость для любой системы, которая собирает более 5000 метрик. Игнорировать это — значит ждать падения, и ждать его придется недолго.
- Настройте триггер на `zabbix[wcache,history,pfree] < 15 %`.
- Включите `LogSlowQueries=5000` для выявления тяжелых запросов.
- Следите за длиной очереди `zabbix[queue]` для предотвращения потерь данных.
Практический расчёт: сколько места нужно для 50 хостов
Давайте посчитаем конкретно для случая «Витамин-Плюс»: 41 рабочее место, 12 точек продаж, итого около 50 хостов. Допустим, на каждом хосте мы собираем 100 метрик (CPU, RAM, диск, сеть, сервисы). Это 5 000 элементов. Интервал сбора — 60 секунд. Формула из документации Zabbix для истории: days * (items / refresh_rate) * 24 * 3600 * bytes. Подставляем: 30 дней * (5000 / 60) * 86400 * 90 байт. Получается около 19,5 ГБ сырых данных за 30 дней без сжатия. Это только история! Тренды занимают меньше, но их тоже много, и их нельзя игнорировать при планировании дискового пространства.
С TimescaleDB и включенным сжатием коэффициент сжатия обычно составляет от 3 до 5 раз для числовых данных. То есть 19,5 ГБ превращаются в 4–6 ГБ на диске. Но это при условии, что вы вовремя настроили сжатие и чанки. Если вы ждали полгода, то база могла вырасти до 100 ГБ, и сжатие старых данных займет много времени и ресурсов. Для трендов формула проще: одна запись в час на элемент. За год это 5000 * 365 * 24 записи, что тоже требует места, но тренды сжимаются еще эффективнее, чем сырая история, поэтому они менее опасны для диска.
Для безопасной эксплуатации рекомендую выделять под базу 20–30 ГБ свободного места сверх расчетного объема, чтобы buffer для операций сжатия и удаления не исчерпывался. В нашем случае мы выделили 50 ГБ SSD-диска под базу Zabbix, и этого хватило с запасом на год работы с историей 10 дней и трендами 3 года. Главное — не экономить на дисках: медленный HDD убьет производительность housekeeper быстрее, чем нехватка RAM. Я видел, как админы ставили дешевые SATA-диски и удивлялись, почему база тормозит. Скорость диска здесь критична, особенно для операций записи и сжатия.
Частые вопросы
Можно ли использовать TimescaleDB с MySQL?
Нет, TimescaleDB работает только с PostgreSQL. Для MySQL используйте штатные возможности Zabbix или мигрируйте на PostgreSQL.
Как часто запускается housekeeper?
По умолчанию раз в час (HousekeepingFrequency=1). Можно настроить от 0 (ручной запуск) до 24 часов.
Что делать, если housekeeper висит?
Проверьте параметр MaxHousekeeperDelete, возможно, он слишком мал. Увеличьте его аккуратно, но следите за нагрузкой на БД.
Нужно ли останавливать Zabbix при установке TimescaleDB?
Да, при миграции существующих данных сервер и веб-интерфейс должны быть остановлены на время выполнения скрипта schema.sql.
Можно ли изменить период хранения для отдельных элементов?
Да, в настройках элемента можно задать свой период, но глобальные настройки Housekeeping могут его переопределить.
Сколько места экономит сжатие TimescaleDB?
Обычно от 3 до 5 раз для числовых данных, но точный коэффициент зависит от типа метрик и паттерна изменения значений.
Источники
- Zabbix Documentation 7.0 - Requirements — Проверены требования к версиям PostgreSQL, MySQL и TimescaleDB, а также формулы расчета объема данных. URL: https://www.zabbix.com/documentation/7.0/en/manual/installation/requirements
- Zabbix Documentation 7.0 - Housekeeping — Проверены параметры HousekeepingFrequency, MaxHousekeeperDelete и логика работы housekeeper. URL: https://www.zabbix.com/documentation/7.0/en/manual/config/items/history_and_trends
- Zabbix Documentation 7.0 - TimescaleDB — Проверены пути к скриптам, настройки сжатия, chunk_time_interval и лицензионные требования. URL: https://www.zabbix.com/documentation/7.0/en/manual/appendix/install/timescaledb
- Zabbix Life Cycle Policy — Проверены даты выпуска и поддержки версий Zabbix 7.0 и 8.0. URL: https://www.zabbix.com/life_cycle_and_release_policy