
Удалили старые бэкапы PostgreSQL — и последний incremental превратился в мусор
Последний incremental не восстановить потому, что он хранит только изменённые блоки и ссылается на все предыдущие копии цепочки вплоть до полной. Удалили любое звено, например старый full по возрасту каталога, и вся цепочка за ним мертва. Ниже: как устроена цепочка, как её не порвать и как проверить, что бэкап жив.
Почему последний incremental не восстанавливается после удаления старых бэкапов
Начну с неприятного: в инкрементальной копии PostgreSQL нет самой базы. Начиная с 17-й версии pg_basebackup умеет снимать копию, в которой для части файлов лежат не страницы целиком, а только блоки, изменившиеся с прошлой копии, и метаданные, чтобы собрать из них актуальную версию файла. Остальное, то есть всё, что не менялось, лежит в предыдущих копиях. Поэтому удалить «старый, уже ненужный» бэкап и оставить свежий incremental значит оставить файл-обещание без того, чем это обещание исполняется. Если вы ведёте 1С на PostgreSQL под Linux, то такая база обычно и есть главный актив компании, а бэкап к ней настроили один раз и забыли.
Документация PostgreSQL говорит об этом прямо: при восстановлении нужна не только сама инкрементальная копия, но и все более ранние копии, от которых она прямо или косвенно зависит. И следом идёт фраза, которую я бы вешал над столом каждого, кто пишет скрипт ротации: в PostgreSQL нет встроенного механизма, определяющего, какие копии ещё нужны как основа для более поздних инкрементальных. Связи между полными и инкрементальными копиями вы отслеживаете сами. Сервер за вас этого не сделает, и утилита тоже.
Отсюда и симптом из заголовка. Вы запускаете pg_combinebackup, перечисляете каталоги, и он либо не находит звено цепочки, либо отказывается считать набор законной цепочкой. Точный текст ошибки зависит от версии, поэтому я не буду его цитировать по памяти. Важна суть: данных нет, и никакой ключ командной строки их не вернёт. Бэкап в этот момент не повреждён, он просто неполон, и разница для вашего директора нулевая.
Меня до сих пор веселит, как это называют в отчётах: «бэкапы настроены, хранится 14 копий». Хранится четырнадцать каталогов. Сколько из них можно восстановить, никто не считал.
Как устроена цепочка: full, incremental и что от чего зависит
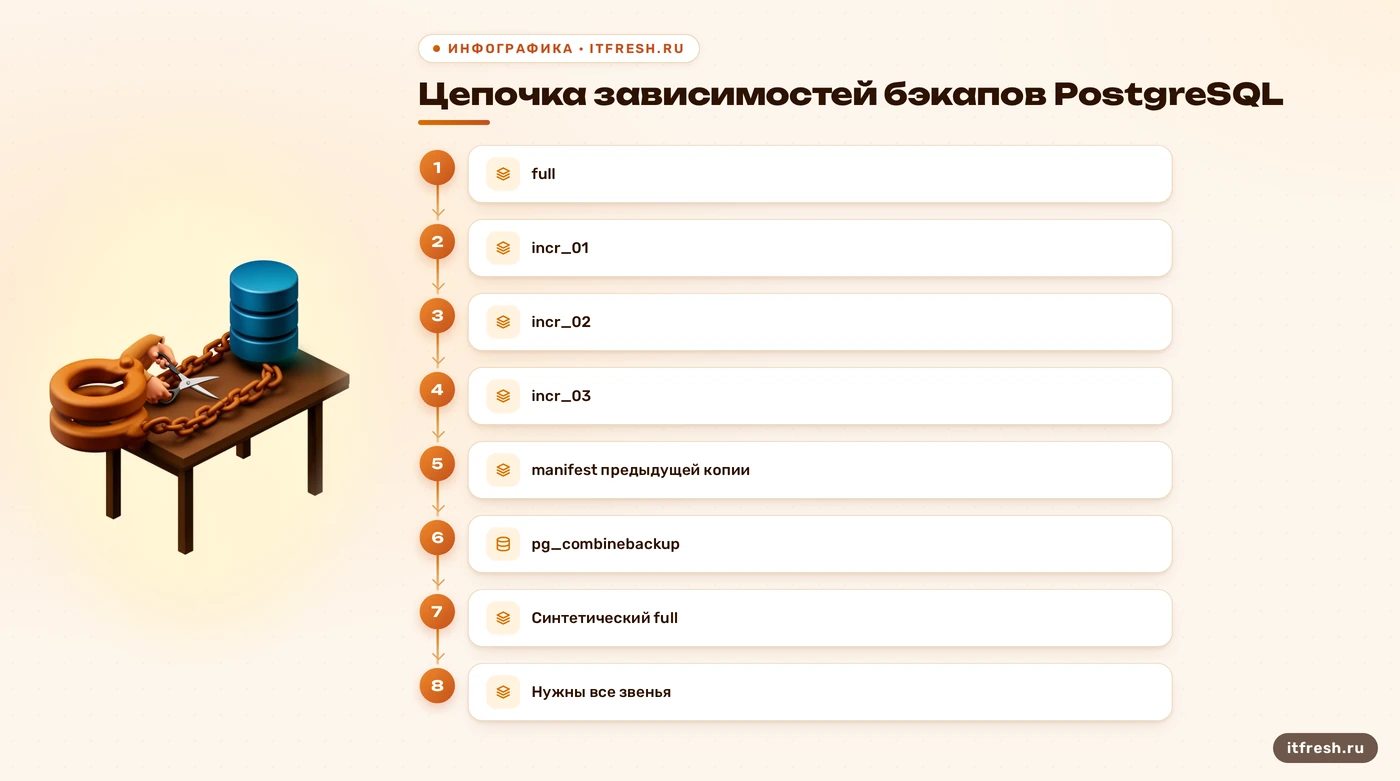
Схема простая. Полная копия снимается обычным pg_basebackup. Первая инкрементальная получает путь к backup_manifest полной и сохраняет только изменения с её момента. Вторая инкрементальная может ссылаться на манифест первой, и тогда зависимость цепочечная: чтобы собрать вторую, нужны полная и первая, а для третьей ещё и вторая. Документация формулирует это как «прямая или косвенная» зависимость, и косвенная как раз и убивает ротацию по возрасту: каждый каталог по отдельности выглядит самостоятельным, но самостоятельным он не является.
Команды выглядят так. Пути и пользователь условные, подставьте свои.
# полная копия
pg_basebackup -h 192.0.2.10 -U backup -D /backup/pg/set_20260927/full -X stream -P

# первая инкрементальная: на входе manifest полной
pg_basebackup -h 192.0.2.10 -U backup -D /backup/pg/set_20260927/incr_01 \
  --incremental=/backup/pg/set_20260927/full/backup_manifest

# вторая: на входе manifest первой инкрементальной
pg_basebackup -h 192.0.2.10 -U backup -D /backup/pg/set_20260927/incr_02 \
  --incremental=/backup/pg/set_20260927/incr_01/backup_manifest
Формат по умолчанию у pg_basebackup plain, WAL по умолчанию идёт потоком (-X stream), манифест создаётся, если не указать --no-manifest. Без манифеста инкрементальную копию вы не снимете вообще, потому что --incremental требует манифест эталонной копии, а позже он понадобится и pg_verifybackup. Алгоритм контрольных сумм в манифесте по умолчанию CRC32C, при желании можно задать SHA256 через --manifest-checksums.
Второе условие на стороне сервера, о котором забывают. Чтобы понять, какие блоки менялись, сервер использует WAL-сводки (WAL summaries) в каталоге pg_wal/summaries. Их включает параметр summarize_wal, по умолчанию он выключен, и менять его можно только в postgresql.conf или в командной строке сервера. Сводки должны покрывать весь диапазон LSN от начала предыдущей копии до начала текущей. Если нужных файлов нет, инкрементальная копия просто не снимется.
# postgresql.conf
summarize_wal = on
wal_summary_keep_time = '14d'
Параметр wal_summary_keep_time задаёт, через какое время сводки удаляются автоматически. Значение по умолчанию 10 дней, без единиц измерения число читается как минуты, ноль отключает автоудаление. Ставить его надо с запасом больше, чем интервал между копией и следующей инкрементальной, которая от неё зависит. Если каждая инкрементальная ссылается на предыдущую ночную, десяти дней хватает с запасом. А вот если вы снимаете инкременты прямо от полной копии раз в две недели (по сути дифференциальная схема), а ключ стоит по умолчанию, сюрприз приедет в день, когда инкрементальная копия откажется стартовать. Это, к слову, неприятность мягкая: копия не снялась, и вы это увидите. Куда хуже копия, которая снялась, а потом осиротела.
Почему ротация по возрасту каталогов ломает цепочку
Типовой скрипт очистки выглядит так: найти каталоги старше N дней и удалить. Он работает безупречно, пока каждая копия независима. Стоит добавить инкременты, и логика хранения по возрасту становится ловушкой. Полная копия по определению старше всех своих инкрементов, поэтому под правило «старше десяти дней» она попадает первой, а её последние инкременты живут ещё несколько дней и выглядят как нормальные свежие бэкапы. Вы открываете каталог, видите вчерашнюю дату, размер, манифест, всё в порядке. Не в порядке только то, что восстановить это нельзя.
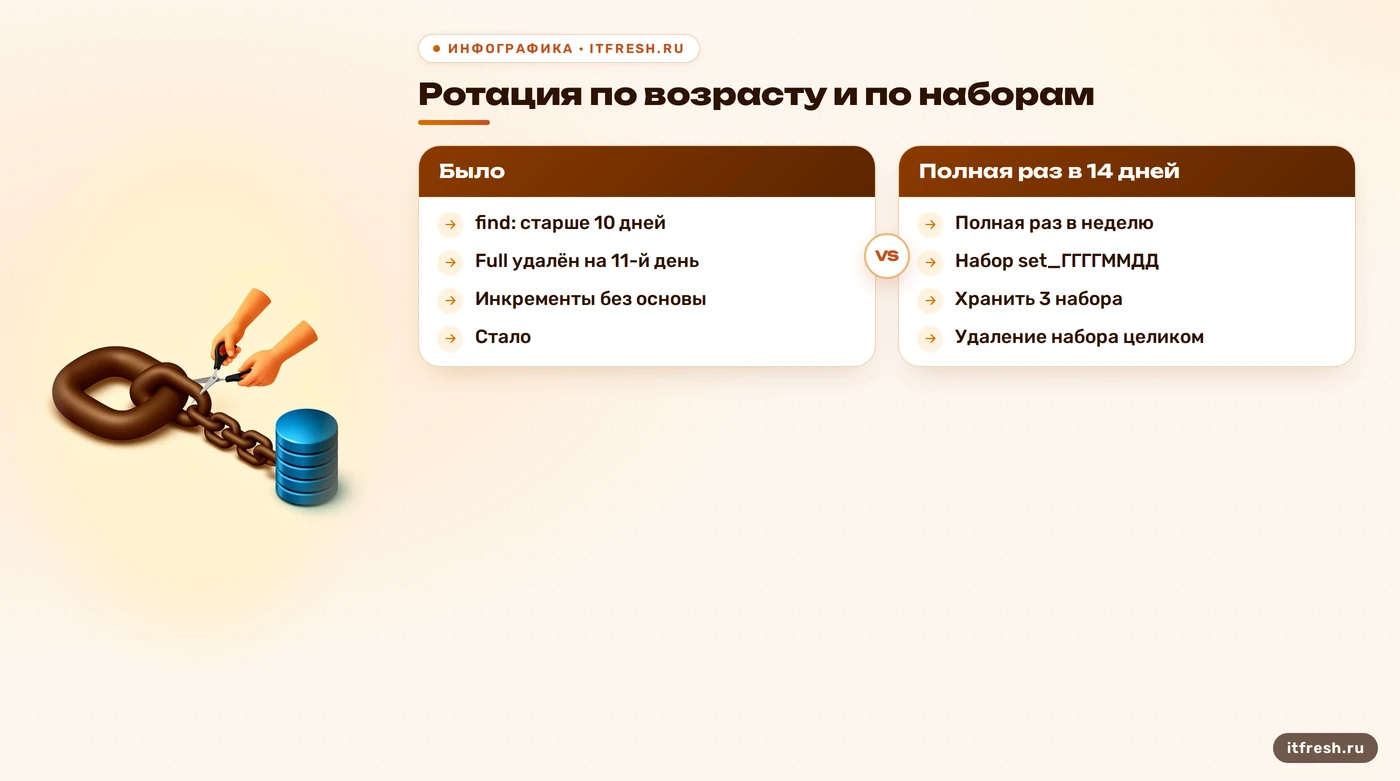
Разберу на случае, который мы нашли у клиента, условного фитнес-центра «Форма тела», 23 рабочих места. Там 1С работала на PostgreSQL 17 на одном сервере, база около 41 ГБ. Предыдущий подрядчик, чтобы сэкономить место на сетевом хранилище, перевёл копии со схемы «полная раз в неделю» на «полная раз в 14 дней, инкременты каждую ночь». Скрипт ротации при этом остался прежним: find по каталогам с условием «старше 10 дней». Инкременты в среднем весили 2–4 ГБ, то есть место экономилось честно.
Что получилось на практике. На 11-й день после полной копии скрипт её удалил, а заодно и самые ранние инкременты. До следующей полной оставалось ещё три ночи, и все эти дни в хранилище лежали десять инкрементов, у каждого из которых не было основы. И так в каждом двухнедельном цикле: три дня подряд ни одной восстановимой копии. При осмотре хранилища выглядело это как «лежит 10 свежих папок, всё снимается каждую ночь, мониторинг зелёный». Мониторинг при этом проверял только факт появления нового каталога и его размер. Полной копии рядом не было ни одной.
Хуже всего, что никто не ошибался в каждом отдельном шаге. Cron работал, pg_basebackup отдавал нулевой код, место на диске было. Виновата конструкция: правило хранения не знало, что копии связаны. Вот из-за таких историй я не люблю фразу «у нас настроено хранение 10 дней». Это правило про каталоги, а не про данные.
- Хранение по возрасту удаляет полную копию раньше её же инкрементов.
- Оставшиеся инкременты выглядят живыми: свежая дата, нормальный размер, есть манифест.
- Мониторинг «каталог появился и не пустой» не отличает цепочку от обломка цепочки.
- Узнают об этом в момент восстановления, то есть когда поздно.
Как правильно хранить: удалять набор целиком, а не отдельные каталоги
Мой рецепт неромантичный. Вся цепочка живёт в одном каталоге-наборе: внутри full и incr_01, incr_02 и так далее. Удалять разрешено только набор целиком и только когда существует хотя бы N более новых наборов, каждый из которых завершён и проверен. Тогда вопрос «что от чего зависит» решается структурой каталогов, а не памятью администратора. Документация PostgreSQL прямо предупреждает, что отслеживание зависимостей ваша задача, и самый дешёвый способ его реализовать это положить зависимые копии в одну папку.
Скрипт очистки получается коротким. Он удаляет самые старые наборы, но всегда оставляет минимум три, независимо от возраста.
#!/bin/bash
set -euo pipefail
ROOT=/backup/pg
KEEP_SETS=3

mapfile -t sets < <(ls -1d "$ROOT"/set_* | sort)
count=${#sets[@]}

if (( count > KEEP_SETS )); then
  for s in "${sets[@]:0:count-KEEP_SETS}"; do
    echo "removing $s"
    rm -rf -- "$s"
  done
fi
Обратите внимание на то, чего в нём нет: проверки по времени. Если ночные копии вдруг перестали снимать, возрастная очистка радостно удалила бы всё, что осталось, и оставила вас с пустой папкой. Счётчик наборов так не сделает: пока новых наборов нет, старые не трогаются. Я называю это «страховка от собственной автоматизации». Дополню: в набор стоит класть и копию WAL-архива, если вы используете восстановление на момент времени, а удалять архив только до сегментов, нужных самой старой из оставшихся копий. Про это подробнее в нашем разборе восстановления PITR и целевой точки.
Срок и размер считайте заранее. Для базы в 41 ГБ набор с полной копией и шестью инкрементами занимает порядка 55–65 ГБ, три набора это около 190 ГБ. Для хранилища на 500 ГБ запас большой, и никакой экономии на полных копиях, ради которой всё и ломалось, не требуется. Если полные копии раз в неделю не влезают, значит база растёт, и разговор нужен про диск, а не про ротацию. Для небольших баз документация и вовсе советует не связываться с инкрементами: для малой базы проще делать полные копии, ими проще управлять. Для базы в десятки гигабайт, где меняется малая часть данных, инкременты оправданы, а для базы, где перезаписывается всё подряд, выигрыш мал.
Как проверить, что цепочка жива: pg_verifybackup и пробное восстановление
Здесь есть тонкость, которую часто путают. pg_combinebackup проверяет только то, что копии, которые вы ему передали, образуют законную цепочку, то есть правильно относятся друг к другу. Целостность каждой копии он не проверяет, для этого есть pg_verifybackup. А тот проверяет копию по backup_manifest: сначала сам манифест, потом наличие и размеры файлов, потом контрольные суммы, потом через pg_waldump читаемость WAL, нужного для восстановления. Эти две проверки не взаимозаменяемы, и ни одна не заменяет пробного запуска сервера. Сама документация pg_verifybackup оговаривается, что он не выполняет всех проверок работающего сервера.
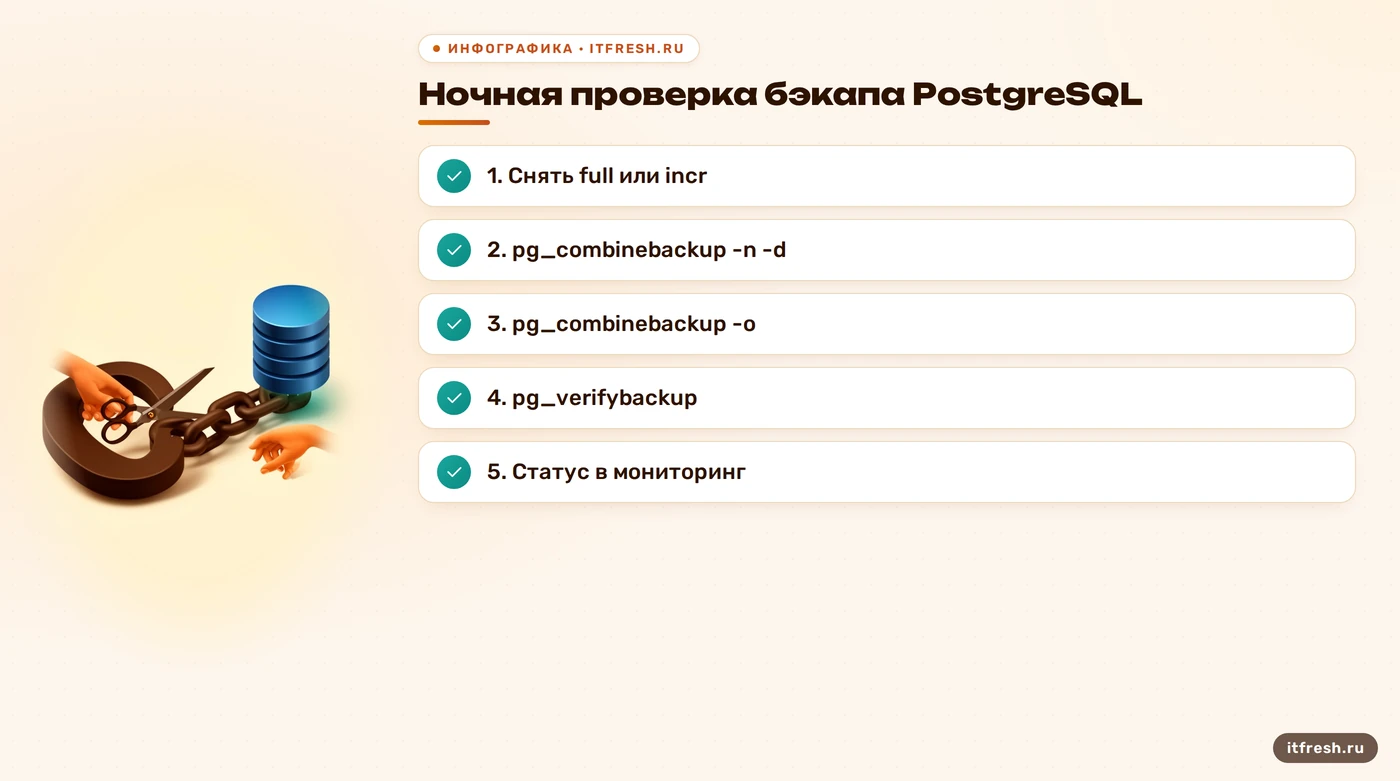
Мой рабочий порядок такой. После снятия набора собираю синтетическую полную копию во временный каталог и проверяю уже её. Цепочка проверяется самим фактом успешной сборки, целостность файлов проверяется по манифесту результата. Ключ -n (--dry-run) вместе с -d показывает, что утилита собирается сделать, без записи файлов, и это хороший способ быстро найти пропавшее звено.
# быстрая проверка цепочки без записи
pg_combinebackup -n -d -o /restore/check \
  /backup/pg/set_20260927/full \
  /backup/pg/set_20260927/incr_01 \
  /backup/pg/set_20260927/incr_02

# реальная сборка и проверка результата
pg_combinebackup -o /restore/pgdata \
  /backup/pg/set_20260927/full \
  /backup/pg/set_20260927/incr_01 \
  /backup/pg/set_20260927/incr_02
pg_verifybackup -n /restore/pgdata
Каталоги передаются от старейшей полной копии к новейшей инкрементальной, порядок важен. Ключ -n у pg_verifybackup отключает разбор WAL, а -w позволяет указать каталог, где лежит архив WAL, если он хранится отдельно от копии. Обычный для меня вариант: сначала прогнать без -n, чтобы убедиться, что WAL читается. А теперь самая важная часть, которую пропускают: после сборки запускаем PostgreSQL на результате, создаём recovery.signal и доводим восстановление до конца. Инкрементальная копия требует того же, что и обычная: все WAL-сегменты, созданные во время копирования и после него.
Всё это мы подробно описывали в материале про тест восстановления бэкапа, и повторяться не буду. Скажу про одну привычку: проверка раз в квартал по календарю не работает, она должна быть частью ночного задания. Бэкап делают все, проверяет его почти никто.
Ловушки pg_combinebackup: --link, контрольные суммы и standby
Ключ --link соблазнителен: вместо копирования файлов создаются жёсткие ссылки, сборка идёт быстрее и занимает меньше места. Но документация предупреждает: любые изменения выходного каталога, например запуск сервера, могут затронуть и исходные каталоги, и наоборот. Поэтому ключ годится, когда входные каталоги это копии, которые вы удалите после сборки. Кроме того, входные копии и выходной каталог должны быть на одной файловой системе. Собирать через --link прямо из рабочего хранилища бэкапов и запускать на результате PostgreSQL, значит рисковать самими бэкапами. Для проверки и для боевого восстановления я использую обычное копирование, которое включено по умолчанию. Если файловая система XFS с поддержкой reflink или Btrfs, есть --clone, он быстрый и не связывает файлы так же опасно.
Вторая ловушка про контрольные суммы страниц. pg_combinebackup их не пересчитывает. Если одна из копий снималась при выключенных контрольных суммах, а последняя при включённых, результат может содержать страницы с неверными суммами. Документация рекомендует после изменения состояния контрольных сумм кластера утилитой pg_checksums снять новую полную копию. Если вы мигрировали версию и включали суммы, как в нашем разборе про контрольные суммы при pg_upgrade, новая полная копия идёт сразу после, а не по расписанию.
Третье: копии со standby. Инкрементальная копия возможна, только если воспроизведение начнётся с более позднего контрольного пункта, чем у предыдущей. На основном сервере это выполняется всегда, потому что каждая копия запускает checkpoint. На standby воспроизведение идёт от последней точки рестарта, и при малой активности инкрементальная копия может не получиться. Снимать копии с реплики разумно, но к этому надо быть готовым.
И ещё один нюанс, который я вижу в чужих политиках хранения. Синтетическую полную копию, собранную pg_combinebackup, можно использовать как вход для следующей сборки вместо исходной цепочки. Это удобно, но это же означает, что исходные каталоги можно удалить, если результат проверен и лежит в надёжном месте. Только делайте это осознанно и записывайте в журнал, а не по сроку давности.
Что мы поменяли у «Формы тела» и сколько это заняло
Вернусь к фитнес-центру. Аудит занял полдня: мы осмотрели хранилище, увидели десять каталогов инкрементов без полной копии и сразу попробовали собрать цепочку. Не собралась, как и ожидалось. Хорошая новость: рабочая база была жива и восстанавливать ничего не требовалось, мы нашли дыру до аварии, а не после. Мы немедленно сняли новую полную копию, и с этого момента цепочка снова была здоровой.
Исправление уложилось в два рабочих дня. Первый день: перевели хранение на наборы (set_ГГГГММДД/full, incr_NN), заменили скрипт очистки на счётчик наборов (три набора, около 190 ГБ при хранилище 500 ГБ), проверили, что summarize_wal включён в postgresql.conf, а не через временный параметр запуска, и подняли wal_summary_keep_time с 10 дней до 14. Второй день: добавили в ночное задание сборку pg_combinebackup во временный каталог, pg_verifybackup на результате и отправку статуса в мониторинг. Теперь тревога приходит не когда пропал каталог, а когда пробная сборка не удалась.
Итог для заказчика: восстановимость базы 1С мы теперь проверяем каждую ночь, а не в день аварии. Полная копия раз в неделю вместо раз в 14 дней, на хранилище около 190 ГБ вместо прежних 70 с небольшим, зато без обмана: место на NAS было, экономили его на том, что нельзя было восстановить. Заодно директор перестал спрашивать «а у нас бэкапы точно есть», потому что получает короткое утреннее письмо с результатом проверки.
Если хотите увидеть, как у вас устроено хранение, и не хотите разбираться в манифестах самостоятельно, это как раз та работа, которую мы делаем за пару дней. А если вы уже на стороне Barman или pgBackRest, сравнение подходов есть в статье про Barman и pgBackRest для PostgreSQL: там зависимости копий учитывает сам инструмент, и это серьёзный аргумент в их пользу.
Частые вопросы
Можно ли восстановить incremental, если удалена полная копия?
Нет. Инкрементальная копия содержит только изменённые блоки, остальные берутся из более ранних копий, от которых она прямо или косвенно зависит. Без них pg_combinebackup цепочку не соберёт.
Проверяет ли pg_combinebackup целостность бэкапов?
Нет. Он проверяет только, что копии образуют допустимую цепочку. Целостность каждой копии проверяет pg_verifybackup по backup_manifest.
Что нужно включить на сервере для инкрементальных копий?
Параметр summarize_wal (по умолчанию off) в postgresql.conf и wal_level не ниже replica. Срок хранения сводок задаёт wal_summary_keep_time, по умолчанию 10 дней.
Безопасно ли использовать pg_combinebackup --link?
Только если входные каталоги это копии, которые будут удалены после сборки. Запуск сервера на результате может изменить файлы исходных бэкапов, потому что файлы связаны жёсткими ссылками.
Нужны ли инкрементальные копии небольшой базе?
Обычно нет. Документация PostgreSQL советует для небольших баз делать только полные копии: ими проще управлять. Инкременты оправданы для крупных баз, где меняется малая часть данных.
Источники
- PostgreSQL 18: pg_combinebackup — Порядок каталогов, зависимость от предыдущих копий, ключи --link, --clone, -n, -d, ограничения по контрольным суммам. https://www.postgresql.org/docs/18/app-pgcombinebackup.html
- PostgreSQL 18: Continuous Archiving and PITR — Раздел 25.3.3 Making an Incremental Backup: WAL-сводки, recovery.signal, ответственность за отслеживание цепочки. https://www.postgresql.org/docs/18/continuous-archiving.html
- PostgreSQL 18: параметры WAL — summarize_wal и wal_summary_keep_time: значения по умолчанию и единицы измерения. https://www.postgresql.org/docs/18/runtime-config-wal.html
- PostgreSQL 18: pg_basebackup — Ключи --incremental, -X, -F, --manifest-checksums, --no-manifest. https://www.postgresql.org/docs/18/app-pgbasebackup.html
- PostgreSQL 18: pg_verifybackup — Этапы проверки по backup_manifest, ключи -n, -w, -s, ограничения. https://www.postgresql.org/docs/18/app-pgverifybackup.html