
Уменьшил tcp_keepalive_time, а сокеты после обрыва сети всё равно висят ESTABLISHED
Sysctl tcp_keepalive_time не включает keepalive — он лишь задаёт умолчание для сокетов, где приложение само включило SO_KEEPALIVE. Поэтому мёртвые соединения висят часами. Разбираю, как за минуту понять по ss, какой таймер у сокета, и какие четыре параметра закрывают такие соединения за две минуты.
Почему sysctl tcp_keepalive_time не действует на ваши соединения
Начну с главного недоразумения, на котором я сам когда-то потерял вечер. Строка net.ipv4.tcp_keepalive_time = 60 не включает проверку TCP-соединений на сервере. Она меняет значение по умолчанию только для тех сокетов, где приложение уже вызвало setsockopt(SO_KEEPALIVE). В tcp(7) это сказано прямо в описании TCP_KEEPIDLE: время простоя до первой пробы учитывается, «if the socket option SO_KEEPALIVE has been set on this socket». Если приложение опцию не включало, у его сокетов нет keepalive-таймера, и ваш sysctl для них не существует. Когда ко мне в сопровождение серверов приходит жалоба «поставили keepalive, а соединения висят», в девяти случаях из десяти дело именно в этом.
Второе, что ломает интуицию: у простаивающего TCP-соединения в Linux по умолчанию нет ни одного работающего таймера. Это не недоработка ядра, а устройство протокола. Соединение — это запись в памяти двух машин, а не непрерывный поток. Пока никто не пишет в сокет, машине неоткуда узнать, что соседа выключили из розетки или что NAT по дороге забыл трансляцию. Она узнает об этом, только когда попробует что-то отправить и не дождётся подтверждения. Если приложение держит пул и не трогает соединения часами, оно не узнает никогда.
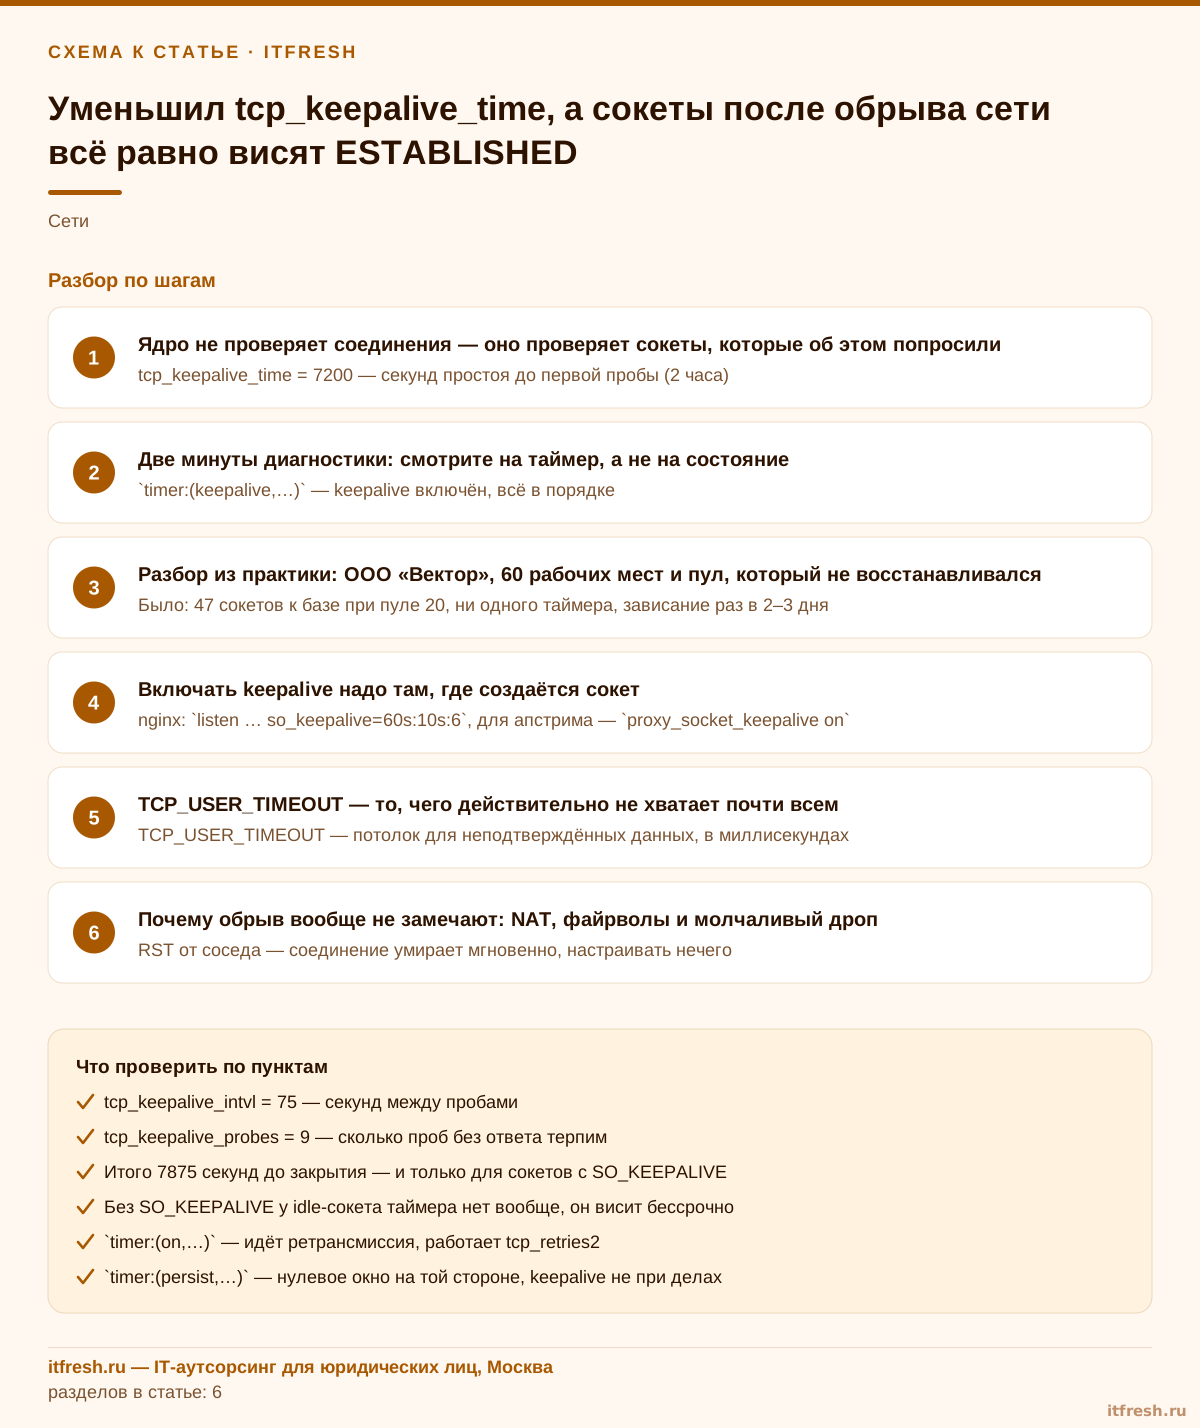
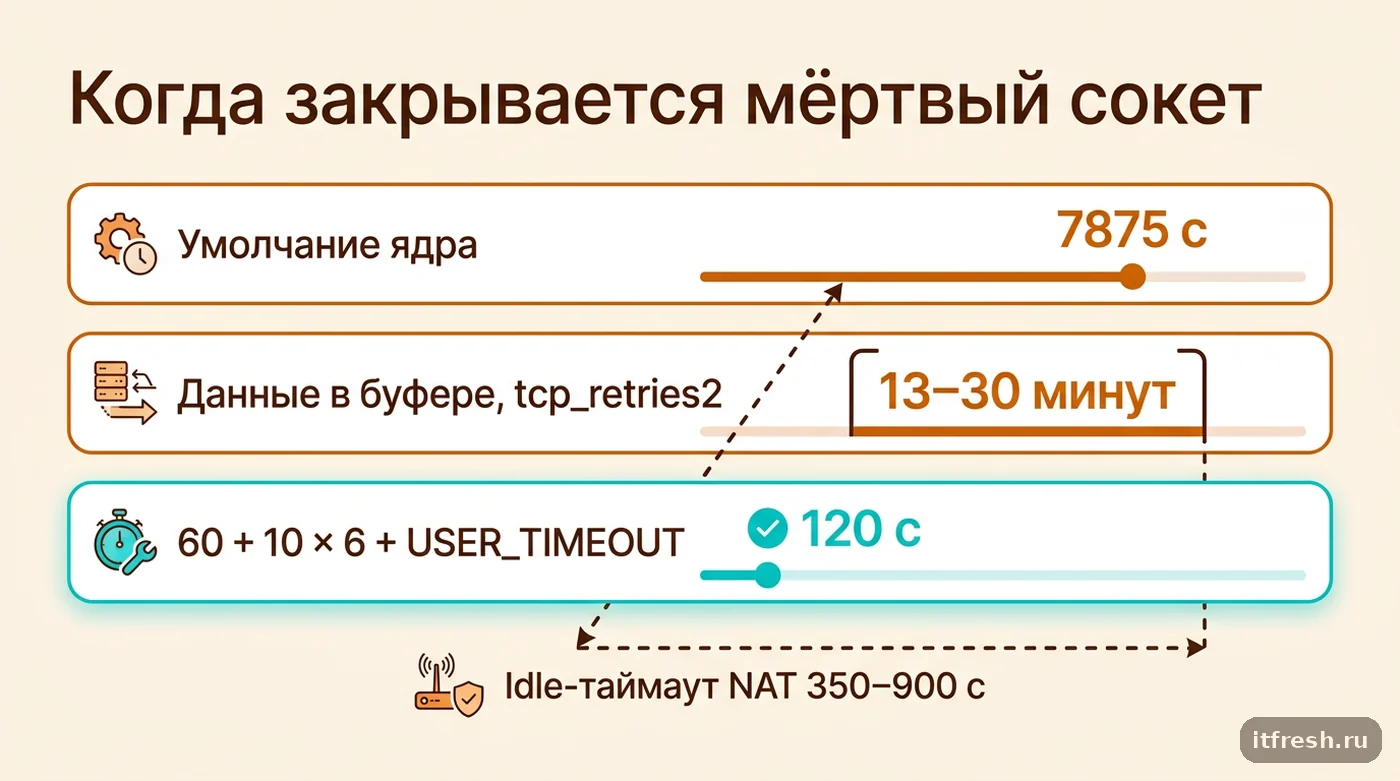
Теперь про умолчания, потому что арифметика показательная. tcp_keepalive_time = 7200 секунд, то есть два часа простоя до первой пробы. tcp_keepalive_intvl = 75 секунд между пробами, tcp_keepalive_probes = 9. Итого 7200 + 75 × 9 = 7875 секунд — больше двух часов, и это в лучшем случае, когда SO_KEEPALIVE действительно включён. Отсюда и мой скепсис к рецептам «ускорьте сервер десятком строк в sysctl.conf»: про это я подробно писал в статье про тюнинг ядра через sysctl — половина популярных ручек либо не делает того, что от неё ждут, либо действует не на то.
Типовой финал я вижу регулярно: пользователи получают «сервис недоступен», в логах приложения таймауты пула, а на сервере ни нагрузки, ни ошибок, ни повода для алерта. Мониторинг зелёный, потому что смотрит на процессор и диск, а не на число сокетов, которые ядро само уже никогда не закроет.
- tcp_keepalive_time = 7200 — секунд простоя до первой пробы
- tcp_keepalive_intvl = 75 — секунд между пробами
- tcp_keepalive_probes = 9 — сколько проб без ответа терпим
- Итого 7875 секунд — и только для сокетов с SO_KEEPALIVE
- Без SO_KEEPALIVE у тихого сокета таймера нет вообще
Как проверить keepalive на сокете: ss -o и колонка таймера
Состояние ESTABLISHED само по себе не говорит ничего: живое соединение и труп в выводе ss -tan выглядят одинаково. Вся информация — в колонке таймера, а её без ключа -o не видно. Поэтому первая команда у меня всегда одна и та же:
# ESTABLISHED с таймерами и процессами (без строки заголовка)
ss -Htnop state established

# только сокеты без таймера — кандидаты на вечное зависание
ss -Htnop state established | grep -v 'timer:'

# сколько соединений к PostgreSQL прямо сейчас
ss -Htn state established '( dport = :5432 )' | wc -l
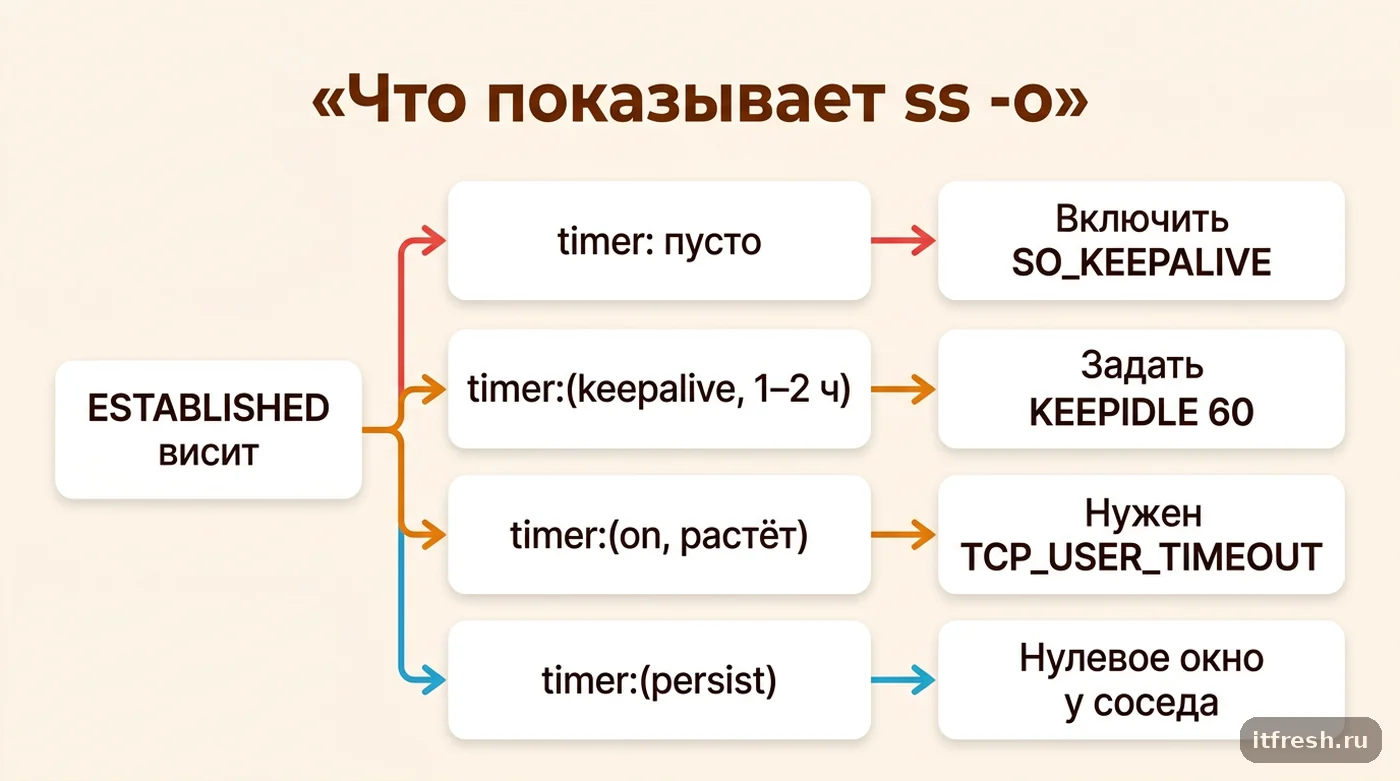
Что читать в выводе. timer:(keepalive,1min52sec,0) — keepalive работает, до следующей пробы 1 минута 52 секунды, неотвеченных проб ноль. timer:(on,…,4) — идёт ретрансмиссия, четвёртая попытка: в буфере отправки лежат неподтверждённые данные, и судьбу сокета решает уже не keepalive, а tcp_retries2. timer:(persist,…) — сосед закрыл окно, и мы шлём зонды. А пустая колонка у ESTABLISHED-сокета — это и есть тот самый вечный сокет.
Разница между «тихим» и «пишущим» сокетом принципиальна, и лучше всех её разобрали инженеры Cloudflare: простаивающие соединения живут по keepalive и не зависят от tcp_retries2, а соединения с данными в буфере отправки, наоборот, живут по tcp_retries2 и keepalive их не спасёт. По умолчанию tcp_retries2 = 15; tcp(7) оценивает это как «примерно от 13 до 30 минут в зависимости от тайм-аута ретрансмиссии». На практике запрос, отправленный в мёртвое соединение, висит около четверти часа.
Практический вывод простой. Если висят соединения, по которым приложение что-то отправило и ждёт ответа, keepalive тут бесполезен — нужен TCP_USER_TIMEOUT. Если висят тихие, простаивающие — нужен SO_KEEPALIVE с вменяемым временем простоя. Понять, какой у вас случай, — тридцать секунд работы ss. Крутить ручки до этого бессмысленно.
- `timer:(keepalive,…)` — keepalive включён, смотрите на оставшееся время
- `timer:(on,…)` — идёт ретрансмиссия, работает tcp_retries2
- `timer:(persist,…)` — нулевое окно на той стороне
- Пусто — таймера нет, сокет доживёт до перезапуска процесса
Разбор из практики: «Финансовый компас» и портал, который висел по утрам
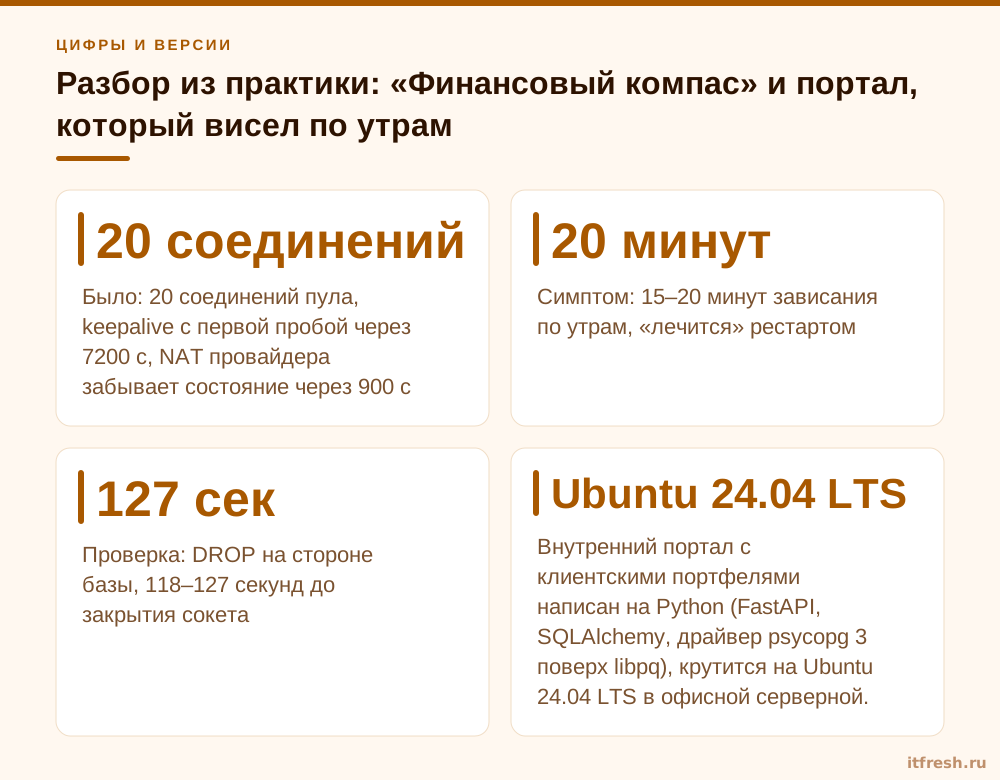
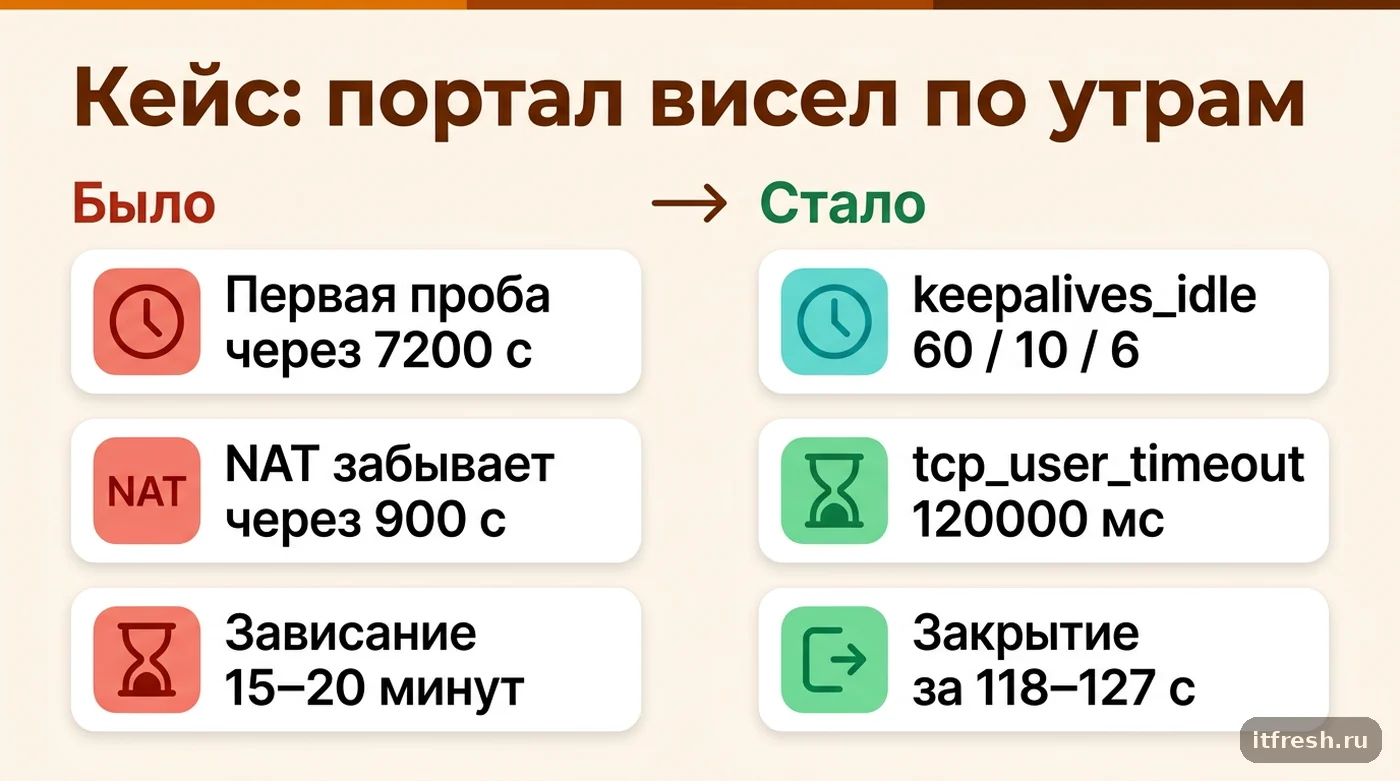
Финансовое консультирование «Финансовый компас», 29 рабочих мест. Внутренний портал с клиентскими портфелями написан на Python (FastAPI, SQLAlchemy, драйвер psycopg 3 поверх libpq), крутится на Ubuntu 24.04 LTS в офисной серверной. База — PostgreSQL 16 на виртуальной машине у облачного провайдера, между офисом и облаком IPsec-туннель, а перед ВМ базы стоит виртуальный маршрутизатор провайдера со stateful-фильтрацией. Жалоба звучала так: «почти каждое утро первые 15–20 минут портал не открывает карточки, потом оживает сам, быстрее помогает рестарт». Разработчик, как водится, разводил руками.
Первые полчаса на месте дали картину. ss -Htnop state established '( dport = :5432 )' показал 20 соединений пула (4 воркера по 5). У четырнадцати таймер был keepalive с остатком около полутора часов, у шести — on с растущим счётчиком ретрансмиссий. То есть keepalive формально был включён: libpq делает это по умолчанию. Но keepalives_idle никто не задавал, значит бралось системное значение — 7200 секунд. Дальше выяснилось, что маршрутизатор провайдера держит состояние простаивающего TCP 900 секунд. Ночью пул простаивал, состояния вычищались, а утренние запросы уходили в соединения, пакеты которых молча дропались: ни RST, ни ICMP. Каждый такой запрос висел по tcp_retries2 свои четверть часа.
Что сделали. Sysctl не трогали ни на одном хосте. Параметры задали там, где создаётся соединение, — в строке подключения приложения (SQLAlchemy передаёт их в libpq как есть), и симметрично на сервере PostgreSQL:
# DSN приложения
postgresql+psycopg://portal@10.20.0.5/portfolio?keepalives=1&keepalives_idle=60&keepalives_interval=10&keepalives_count=6&tcp_user_timeout=120000

# postgresql.conf на стороне базы
tcp_keepalives_idle = 60
tcp_keepalives_interval = 10
tcp_keepalives_count = 6
tcp_user_timeout = 120000   # миллисекунды
Расчёт не с потолка: 60 + 10 × 6 = 120 секунд, и то же число в миллисекундах ушло в tcp_user_timeout. Проба раз в минуту заодно держит живым состояние на маршрутизаторе провайдера — 60 заметно меньше его 900 секунд. Сверху включили pool_pre_ping=True в SQLAlchemy, чтобы пул проверял соединение перед выдачей. Проверку сделали руками: на ВМ базы iptables -I INPUT -s 10.10.0.15 -j DROP, секундомер. В пяти прогонах мёртвые сокеты исчезали из ESTABLISHED за 118–127 секунд, пул сам открывал новые. Работа заняла один вечер, за следующие шесть недель утренних зависаний не было ни одного.
- Было: 20 соединений пула, keepalive с первой пробой через 7200 с, NAT провайдера забывает состояние через 900 с
- Симптом: 15–20 минут зависания по утрам, «лечится» рестартом
- Стало: keepalives_idle 60 / interval 10 / count 6 / tcp_user_timeout 120000 мс с обеих сторон
- Проверка: DROP на стороне базы, 118–127 секунд до закрытия сокета
- Sysctl не трогали ни на одном хосте
Где включать SO_KEEPALIVE: nginx, systemd, libpq, Go, Java
Общее правило, которое я отстаиваю: keepalive настраивается на уровне сокета, а не хоста. Sysctl — это запасной вариант для тех, кто ничего не задал явно, и полагаться на него плохо по двум причинам. Во-первых, глобальные значения приходится делать агрессивными ради одного проблемного пула, а платят за это все соединения хоста. Во-вторых, конфиг приложения переезжает вместе с приложением, а строчка в /etc/sysctl.d остаётся на старой машине и теряется при первом же переносе.
В nginx параметры задаются прямо в listen (с версии 1.1.11) в формате so_keepalive=on|off|[keepidle]:[keepintvl]:[keepcnt], пропущенные позиции берутся из системных умолчаний. Для соединений к бэкенду есть отдельная директива proxy_socket_keepalive (с 1.15.6):
server {
    listen 443 ssl so_keepalive=60s:10s:6;
    server_name app.example.com;
    location / {
        proxy_socket_keepalive on;   # SO_KEEPALIVE на сокетах к апстриму
        proxy_pass http://backend;
    }
}
Для сервисов, которые получают слушающий сокет от systemd, всё делается в socket-юните — приложение трогать не нужно. Это, пожалуй, самый чистый способ для самописных демонов:
[Socket]
ListenStream=0.0.0.0:8080
KeepAlive=yes
KeepAliveTimeSec=60
KeepAliveIntervalSec=10
KeepAliveProbes=6
Отдельно про libpq, потому что здесь спрятана та самая ловушка из кейса. keepalives по умолчанию равен 1, SO_KEEPALIVE включён, таймер в ss виден. Но keepalives_idle, keepalives_interval и keepalives_count по умолчанию нулевые, а ноль по документации означает «системное значение», то есть те же 7200 секунд. Важно и другое: всё это относится к драйверам поверх libpq (psql, psycopg, большинство C-клиентов). Java-драйвер pgJDBC libpq не использует и умеет только tcpKeepAlive=true без тонких параметров. В Go с версии 1.23 есть net.KeepAliveConfig с полями Enable/Idle/Interval/Count для Dialer и ListenConfig; старое поле Dialer.KeepAlive при нуле включает пробы со встроенным в Go значением 15 секунд, а не системным. В Java начиная с 11-й версии тонкие параметры доступны через jdk.net.ExtendedSocketOptions.TCP_KEEPIDLE, TCP_KEEPINTERVAL и TCP_KEEPCOUNT.
- nginx: `listen … so_keepalive=60s:10s:6`, к апстриму — `proxy_socket_keepalive on`
- systemd: `KeepAlive=yes` и `KeepAliveTimeSec/IntervalSec/Probes` в [Socket]
- libpq и psycopg: `keepalives_idle`, `keepalives_interval`, `keepalives_count`, `tcp_user_timeout`
- pgJDBC: только `tcpKeepAlive=true`, тонкие значения — через sysctl или валидатор пула
- Go 1.23+: `net.KeepAliveConfig{Enable, Idle, Interval, Count}`
- Java 11+: `jdk.net.ExtendedSocketOptions.TCP_KEEPIDLE` и соседние константы
TCP_USER_TIMEOUT: чего не хватает почти всем
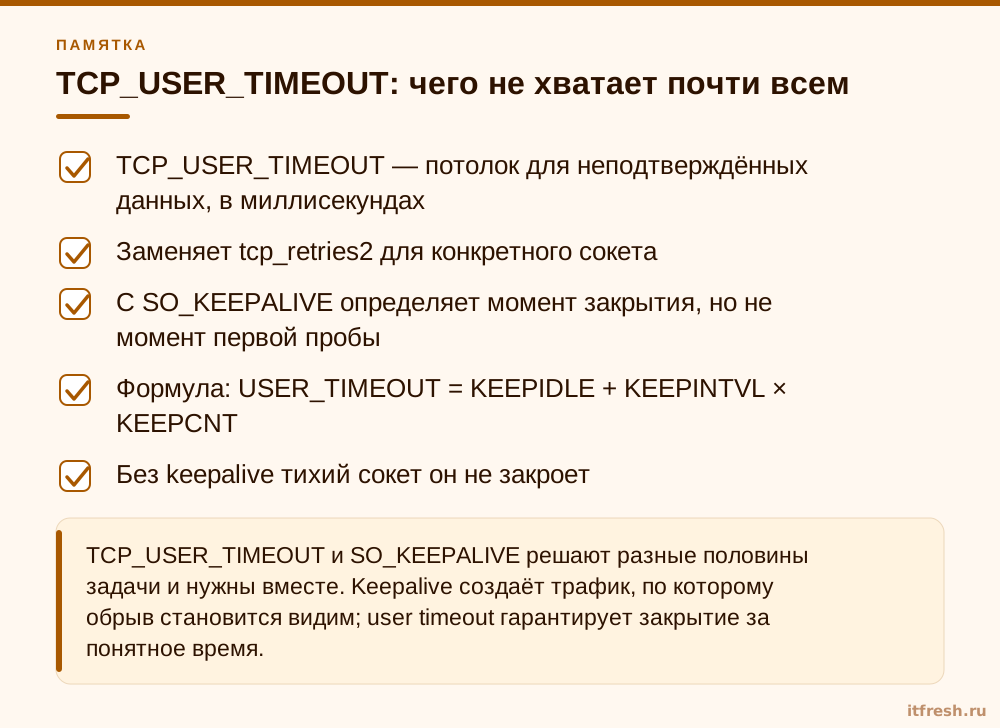
Если из статьи запомнить один параметр, пусть это будет он. TCP_USER_TIMEOUT задаёт максимальное время в миллисекундах, в течение которого переданные данные могут оставаться неподтверждёнными, прежде чем ядро принудительно закроет соединение. Это ортогонально keepalive: речь не о пробах, а о ваших собственных данных. По сути это персональная замена tcp_retries2 для конкретного сокета: вместо «от 13 до 30 минут» вы получаете число, которое написали сами.
Дальше нюанс, который отвечает ровно на вопрос из заголовка. В tcp(7) сказано: при совместном использовании с SO_KEEPALIVE «TCP_USER_TIMEOUT will override keepalive to determine when to close a connection due to keepalive failure». То есть он не меняет момент первой пробы — за это отвечает TCP_KEEPIDLE, — но решает, когда сокет закроется после того, как пробы пошли без ответа. Cloudflare в своём разборе добавляет деталь реализации: для тихого сокета эффект включается только после отправки первой пробы. Поставить один TCP_USER_TIMEOUT без keepalive и ждать, что простаивающее соединение закроется, бесполезно: неподтверждённых данных нет, таймеру не за что зацепиться.
Рабочая формула, которую я использую и которую рекомендует та же Cloudflare: TCP_USER_TIMEOUT = TCP_KEEPIDLE + TCP_KEEPINTVL × TCP_KEEPCNT. Меньше ставить опасно: соединение закроется раньше, чем keepalive отработает положенные пробы, и вы начнёте рвать сессии на коротких сетевых провалах, которых раньше не замечали. Сильно больше — бессмысленно: закрывать будет keepalive, а потолок ни на что не повлияет. Похожая многоуровневая история с тайм-аутами бывает и выше по стеку — я разбирал её на примере того, какой тайм-аут на самом деле управляет PHP-FPM за nginx.
Спорное место скажу честно: единого правильного значения нет, оно зависит от того, какую сетевую паузу вы готовы пережить без разрыва. Мой практический диапазон — 20–30 секунд для сервисов внутри одной площадки, 60–120 секунд для связей через интернет и VPN, и никогда не меньше самой длинной штатной паузы в вашей сети: пересогласования IPsec, переключения резервного канала, перезагрузки маршрутизатора по расписанию. Не знаете это число — измерьте, прежде чем ставить.
- TCP_USER_TIMEOUT — потолок для неподтверждённых данных, в миллисекундах
- Заменяет tcp_retries2 для конкретного сокета
- С SO_KEEPALIVE определяет момент закрытия, но не момент первой пробы
- Формула: USER_TIMEOUT = KEEPIDLE + KEEPINTVL × KEEPCNT
- Без keepalive тихий сокет он не закроет
Почему обрыв не замечают: NAT, файрволы и молчаливый дроп
Полезно понимать, почему одно мёртвое соединение схлопывается мгновенно, а другое висит часами. Сценариев три. Первый: на той стороне кто-то есть и отвечает RST — соединение закрывается за миллисекунды, настраивать ничего не нужно. Второй: маршрута нет и по пути кто-то шлёт ICMP unreachable — обычно тоже отработает. Третий, самый частый и самый гадкий: пакеты молча дропаются. Stateful-файрвол выбросил состояние по тайм-ауту простоя, NAT-трансляция протухла, туннель переустановился. Никто никому ничего не сообщает, и обе стороны считают соединение живым.
Отсюда второе правило: время простоя до первой пробы должно быть заметно меньше самого короткого idle-таймаута на пути. У pfSense и OPNsense состояние установленного TCP в обычном режиме держится сутки, и это не проблема. А у операторского CGNAT, облачных маршрутизаторов и балансировщиков тайм-ауты от минуты до получаса: у AWS Network Load Balancer, например, по умолчанию 350 секунд простоя. Если первая проба уходит через 7200 секунд, никакой промежуточный узел этого не простит — состояние умрёт задолго до пробы, и вы получите ту же картину, только с «включённым» keepalive.
Мой дефолт — 60 секунд для TCP_KEEPIDLE. Это меньше почти любого встречающегося idle-таймаута, а трафика почти нет: одна проба в минуту на простаивающее соединение, несколько десятков байт. Даже тысяча соединений даёт около 17 проб в секунду плюс столько же ответов. Аргумент «keepalive нагрузит сеть» я считаю надуманным: нагружает не keepalive, а агрессивный глобальный sysctl на хосте с сотней тысяч сокетов, и это совсем другая история.
И последнее: не чините сетью то, что чинится приложением. У нормального пула есть свой валидатор соединений: в SQLAlchemy это pool_pre_ping и pool_recycle, в HikariCP — keepaliveTime и maxLifetime, в pgbouncer — server_check_query и server_lifetime. Прикладная проверка ловит не только оборванный TCP, но и живой сокет к зависшему бэкенду. Правильная конструкция — оба уровня: TCP-keepalive снизу закрывает сокеты, прикладной валидатор сверху выбрасывает их из пула.
- RST от соседа — соединение умирает сразу
- ICMP unreachable — обычно тоже закрывается быстро
- Молчаливый дроп на файрволе или NAT — вечный ESTABLISHED
- KEEPIDLE должен быть меньше самого короткого idle-таймаута на пути
- Прикладной валидатор пула сверху, TCP-keepalive снизу
Чек-лист: с чего начать и на что не тратить время
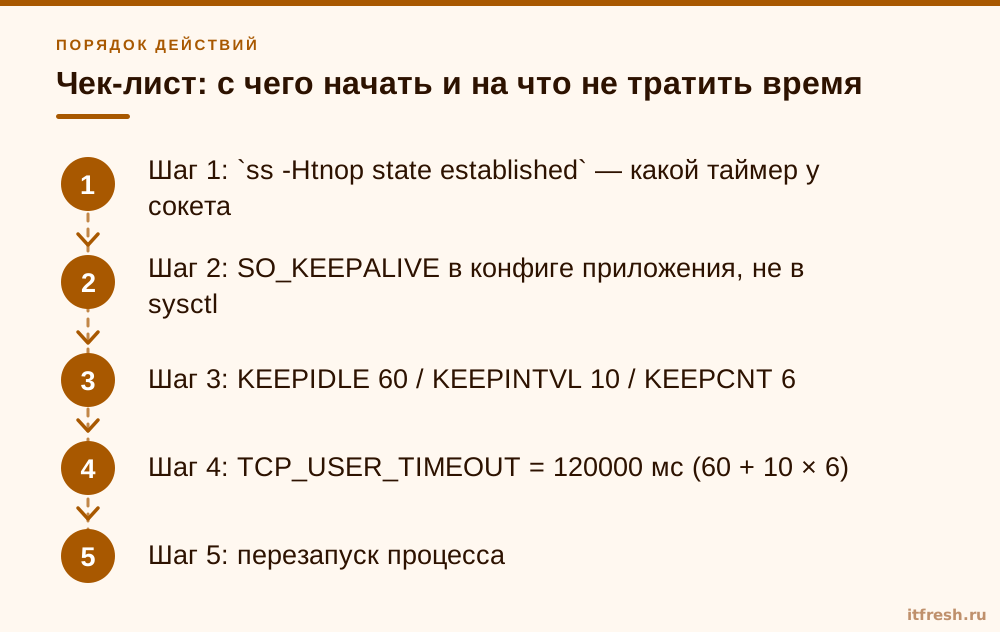
Порядок действий, который экономит больше всего времени. Сначала диагностика: ss -Htnop state established и взгляд на колонку таймера. Таймера нет — нужен SO_KEEPALIVE. Таймер keepalive с остатком в час-два — нужно задать время простоя явно. Таймер on с растущим счётчиком — нужен TCP_USER_TIMEOUT. Это разделение стоит сделать до любых правок конфигов, иначе будете лечить не то.
Дальше включаете keepalive в конфигурации приложения или пула, а не в sysctl: KEEPIDLE 60, KEEPINTVL 10, KEEPCNT 6 и TCP_USER_TIMEOUT 120000 миллисекунд. Это разумный универсальный дефолт для связей через VPN и интернет; внутри одной площадки можно сжать втрое. Перезапускаете приложение — старые сокеты новых настроек не подхватят. И обязательно проверяете руками: DROP на одной из сторон и секундомер. Без этой проверки вы не знаете, работает ли конфигурация, — вы только надеетесь.
На что можно не тратить время. Не крутите tcp_retries2 глобально: инструмент грубый и влияет на все соединения хоста, включая те, где длинные ретрансмиссии уместны. Не ставьте tcp_keepalive_time = 30 на весь сервер «на всякий случай»: это лишние пробуждения ядра ради проблемы, которая живёт в одном пуле. Не бойтесь, что keepalive «съест канал». И не городите самодельный heartbeat поверх протокола, пока не настроили то, что есть в ядре бесплатно.
Один раз и навсегда стоит сделать мониторинг: счётчик ESTABLISHED-сокетов без таймера и с keepalive-остатком больше часа. Это одна пользовательская метрика в Zabbix через ss и скрипт. Главное — завести триггер так, чтобы при массовом обрыве канала не прилетела лавина писем; как выстраивать зависимости триггеров в Zabbix, я разбирал отдельно. У нас такая метрика стоит на всех хостах с пулами соединений к базам и не раз срабатывала раньше звонка клиента.
- Шаг 1: `ss -Htnop state established` — какой таймер у сокета
- Шаг 2: SO_KEEPALIVE в конфиге приложения, не в sysctl
- Шаг 3: KEEPIDLE 60 / KEEPINTVL 10 / KEEPCNT 6
- Шаг 4: TCP_USER_TIMEOUT = 120000 мс (60 + 10 × 6)
- Шаг 5: перезапуск процесса
- Шаг 6: проверка DROP и секундомером
- Не тратить время: глобальный tcp_retries2, агрессивный общесистемный keepalive, самодельный heartbeat
Частые вопросы
Я поставил net.ipv4.tcp_keepalive_time = 60 и перезагрузил сервер — почему сокеты всё равно висят?
Sysctl действует только на сокеты, где приложение включило SO_KEEPALIVE. Если приложение этого не делает, keepalive-таймера у сокета нет. Проверьте `ss -Htnop state established`: пустая колонка таймера означает, что править надо конфиг приложения, а не sysctl.
Как понять, включён ли SO_KEEPALIVE на конкретном соединении?
Командой `ss -tno state established`. При включённом keepalive в выводе будет `timer:(keepalive,<время до пробы>,<неотвеченные пробы>)`. Нет таймера у ESTABLISHED-сокета — опция выключена.
Достаточно ли одного TCP_USER_TIMEOUT без keepalive?
Для простаивающих соединений нет. TCP_USER_TIMEOUT ограничивает время жизни неподтверждённых данных, а у тихого сокета их нет. Нужны оба: SO_KEEPALIVE создаёт трафик, TCP_USER_TIMEOUT задаёт потолок на закрытие.
Почему libpq держит мёртвое соединение два часа, хотя keepalive включён по умолчанию?
Потому что keepalives_idle, keepalives_interval и keepalives_count по умолчанию равны нулю, а ноль означает системное значение — 7200 секунд до первой пробы. Задайте их явно в строке подключения, например 60/10/6, и добавьте tcp_user_timeout=120000.
Какие значения ставить: 60/10/6 подойдут всем?
Это разумный дефолт для связей через интернет и VPN: обрыв обнаруживается примерно за две минуты. Внутри одной площадки можно 20/5/4. Снизу ограничивает самая длинная штатная пауза в сети, сверху — самый короткий idle-таймаут NAT или балансировщика на пути.
Не создаст ли keepalive лишнюю нагрузку на сеть?
Практически нет. При KEEPIDLE 60 это одна проба в минуту на простаивающее соединение. Тысяча соединений даёт около 17 проб в секунду и столько же ответов — статистическая погрешность для любого офисного канала.
Источники
- tcp(7) — Linux manual page — Умолчания tcp_keepalive_time (7200), tcp_keepalive_intvl (75), tcp_keepalive_probes (9), tcp_retries2 (15, «примерно 13–30 минут»), семантика TCP_KEEPIDLE и TCP_USER_TIMEOUT (миллисекунды, переопределяет keepalive при закрытии). https://man7.org/linux/man-pages/man7/tcp.7.html
- Cloudflare Blog — When TCP sockets refuse to die — Поведение простаивающих сокетов и сокетов с данными в буфере отправки, роль tcp_retries2, формула TCP_USER_TIMEOUT = KEEPIDLE + KEEPINTVL × KEEPCNT. https://blog.cloudflare.com/when-tcp-sockets-refuse-to-die/
- PostgreSQL 18 — libpq Connection Parameters — keepalives (по умолчанию 1), keepalives_idle/interval/count (ноль = системное значение), tcp_user_timeout в миллисекундах. https://www.postgresql.org/docs/current/libpq-connect.html
- nginx — ngx_http_core_module, директива listen — Параметр so_keepalive=on|off|[keepidle]:[keepintvl]:[keepcnt], доступен с 1.1.11. https://nginx.org/en/docs/http/ngx_http_core_module.html#listen
- Go standard library — package net — Dialer.KeepAlive (при нуле — встроенное значение 15 секунд) и тип KeepAliveConfig, добавленный в Go 1.23. https://pkg.go.dev/net#Dialer
- pgJDBC — Connecting to the Database — Параметр tcpKeepAlive (по умолчанию false); параметров keepalives_idle и tcp_user_timeout у драйвера нет. https://jdbc.postgresql.org/documentation/use/