
Сравнение ИИ-моделей: факты, а не мифы
Сравнение ИИ-моделей — не маркетинговый ход, а необходимость для бизнеса. Многие думают, что GPT-5 — это просто «лучше», но на деле результаты могут быть непредсказуемыми. Надо сравнивать по конкретным задачам, а не по репутации. Я, Евгений Сергеевич Семёнов, руководитель «АйТи Фреш», видел, как компании тратят миллионы на ИИ, не понимая, что модель может генерировать разные ответы на один и тот же запрос. Это не ошибка, это закономерность. В статье — как проводить объективное сравнение, какие инструменты использовать и какие ошибки избегать.
Почему сравнение ИИ — не выбор по имени бренда
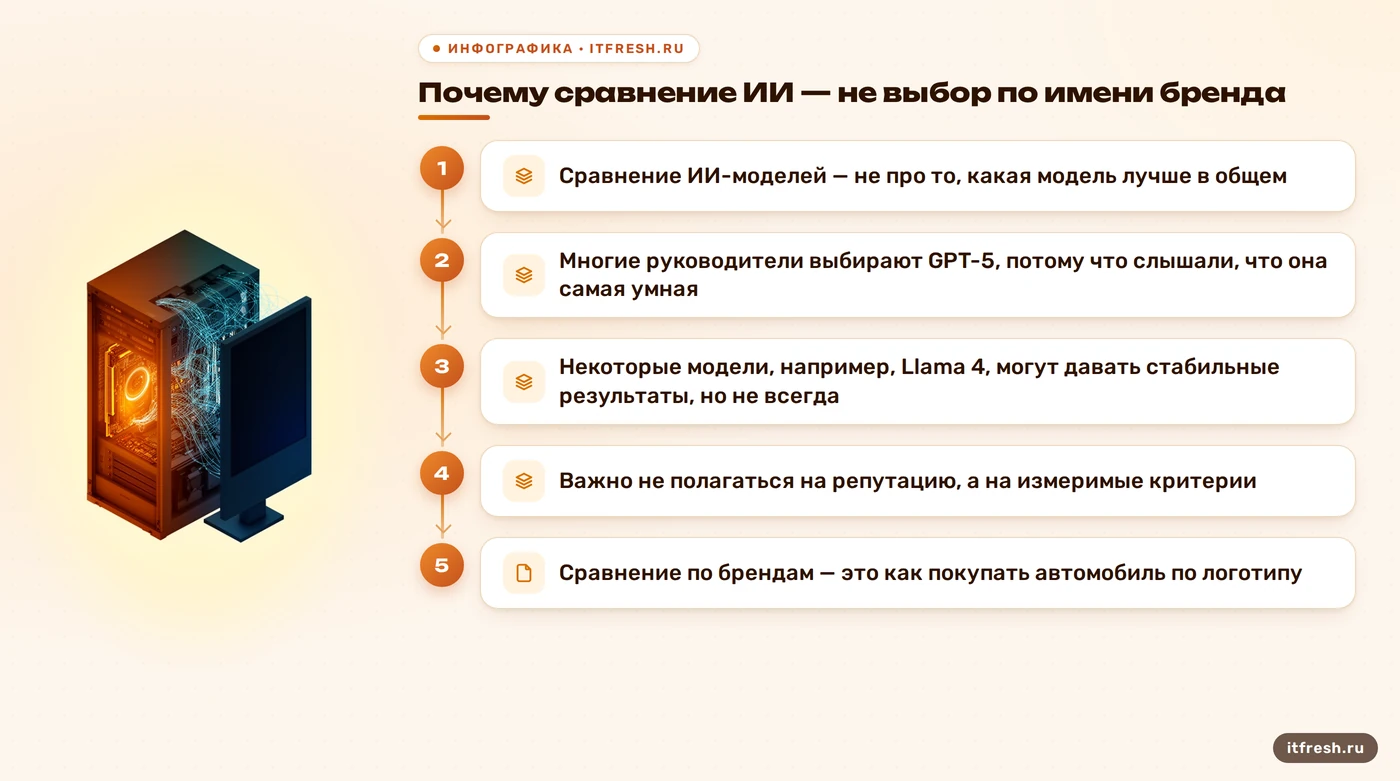
Сравнение ИИ-моделей — не про то, какая модель «лучше» в общем. Это про то, какая подходит для конкретной задачи. Многие руководители выбирают GPT-5, потому что слышали, что она «самая умная». Но у нее есть один недостаток: она может генерировать разные ответы на один и тот же запрос. Это не ошибка, это особенность архитектуры. Некоторые модели, например, Llama 4, могут давать стабильные результаты, но не всегда. Важно не полагаться на репутацию, а на измеримые критерии. Если модель не дает одинакового результата при одинаковых входных данных, она непригодна для бизнес-процессов, где требуется предсказуемость.
Сравнение по брендам — это как покупать автомобиль по логотипу. Каждый бренд имеет свои сильные и слабые стороны. GPT-5 может быть сильнее в генерации текста, но если ваша задача — анализ договоров или сравнение поставщиков, то иные модели, например, те, что оптимизированы под юридические или финансовые тексты, могут оказаться эффективнее. Настоящее сравнение — это не «кто круче», а «кто работает для вас». Без этого — риски, ошибки и трата ресурсов. Никакие «лучшие» модели не заменят проверку на реальных задачах.
Вот что происходит, когда сравнивают по брендам. Компания внедряет GPT-5, потому что «все используют». Модель генерирует отчеты, но каждый раз — разные. Однажды в отчете о продажах написано: «Выручка выросла на 150 %». На следующий день — «выросла на 20 %». На третий — «снизилась на 10 %». Никто не знает, что именно произошло. Это не ошибка, это норма. И если вы не проверяете стабильность, вы просто играете в рулетку с бизнесом. В 1С, где важно, чтобы отчеты были одинаковыми, это катастрофа. Потому что каждый раз, когда ИИ выдает разный ответ, вы не можете быть уверены, что он не «выдумал» данные.
Конечно, можно сказать: «Ну, это же ИИ, он не всегда точен». Но если вы используете ИИ для принятия решений, точность — не вопрос. Это или работает, или не работает. И если он генерирует разные ответы на один и тот же запрос, он не работает. Это не «недостаток», это «не работает». И если вы не проверяете, вы просто играете в игру, где проигрываете. В этом мире, где бизнес-процессы должны быть предсказуемыми, ИИ, который не стабилен, — это не инструмент, это рискованный акт.
Как проводить объективное сравнение
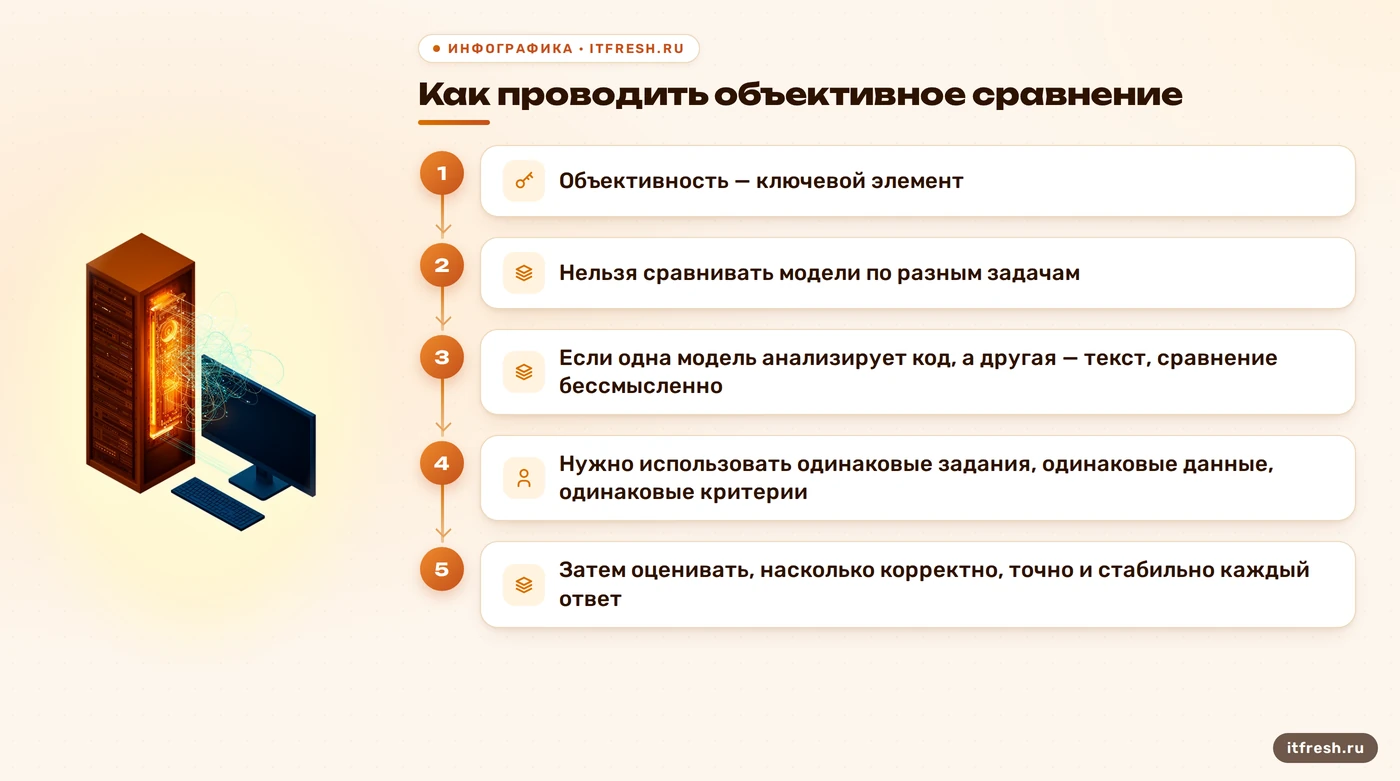
Объективность — ключевой элемент. Нельзя сравнивать модели по разным задачам. Если одна модель анализирует код, а другая — текст, сравнение бессмысленно. Нужно использовать одинаковые задания, одинаковые данные, одинаковые критерии. Например, можно взять 8 популярных моделей и попросить их решить одну и ту же задачу по генерации отчета по 1С. Затем оценивать, насколько корректно, точно и стабильно каждый ответ. Это и есть объективность. Без нее — мифы, маркетинг, и, в конечном итоге, провал проекта.
Для объективности используются специальные сервисы. LMArena, например, позволяет людям сравнивать пары ответов на один запрос. Это не автоматизированная оценка, а голосование пользователей. Такой подход дает объективную оценку качества. Также можно использовать open-source проекты, где сравнивают модели на реальных задачах. Например, в одном из проектов сравнивали версии GPT 4.5, 5, 5 Pro и 5.1 Pro. Результаты показали, что даже между версиями одного бренда разница может быть значительной. Это подтверждает: сравнение — не выбор по имени, а проверка по результатам.
Но даже с инструментами есть нюансы. Например, визуальное тестирование. ИИ может сравнивать скриншоты, находить изменения. Это работает, но требует настройки. Если не проверить, насколько точно ИИ определяет изменения, можно получить ложные срабатывания. Также есть модели, которые сравнивают условия поставщиков по критериям: цена, сроки, условия оплаты. Это полезно, но только если модель понимает, что именно важно. Всё зависит от того, как вы настроили критерии. Без них — просто «вот ответ, выберите». Это не сравнение, это выбор по настроению.
Кроме того, важно, чтобы сравнение проводилось на реальных данных. Если вы сравниваете модели по тестовым задачам, но в реальности у вас иные данные, результаты будут искажены. Например, модель может хорошо работать с текстами на русском, но плохо — с техническими документами. И если вы не проверяете на ваших данных, вы просто играете в «кто лучше», а не в «кто работает». Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Вот что происходит, когда сравнивают по тестовым данным. Компания выбирает модель, которая «выиграла» в бенчмарке. Внедряют. И через месяц обнаруживают, что ИИ не понимает термины из их отрасли. Потому что бенчмарк был на общих данных. А у них — специфика. И если вы не проверяете на ваших данных, вы просто покупаете «модель для всех», а не «модель для вас». Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Критерии, по которым оценивают ИИ-модели
Оценка должна быть измеримой. Нельзя сказать «модель лучше», если не определить, что значит «лучше». Критерии могут быть разными: точность, стабильность, скорость, количество галлюцинаций. Например, GPT-5.4 показала на 33 % меньше галлюцинаций по сравнению с GPT-5.2. Это важный показатель, особенно если модель используется для анализа финансовых данных или поставок. Галлюцинации — это когда ИИ «выдумывает» информацию. В бизнесе это может привести к ошибкам в отчетах, неверным решениям, потере доверия.
Другие критерии — это скорость, стабильность, совместимость с существующими системами. Например, если ваша задача — интеграция с 1С, нужно проверить, насколько хорошо ИИ понимает структуру данных в 1С. Некоторые модели лучше справляются с логикой бизнес-процессов, другие — с текстами. Также важно, как ИИ работает с документами. Он может сравнивать версии документов и выделять изменения цветом. Это полезно для юристов, бухгалтеров, менеджеров. Но только если модель понимает, что именно изменилось и почему. Всё зависит от критериев, которые вы выберете.
Еще один критерий — это совместимость с вашей инфраструктурой. Если вы используете свои серверы, а модель требует облачные ресурсы, это проблема. Некоторые модели работают только в облаке. Другие — на локальных серверах. И если вы не проверяете совместимость, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Также важно, как ИИ работает с вашими данными. Например, если вы используете ИИ для прогнозирования продаж, нужно проверить, насколько хорошо он понимает ваши исторические данные. Некоторые модели могут давать точные прогнозы, но только если обучены на данных, близких к вашим. В противном случае — ошибки. Точность ИИ-моделей прогнозирования может быть сопоставима с традиционными методами, но это не всегда так. Важно не полагаться на «уверенность» ИИ, а проверять его на реальных данных. Если ИИ говорит, что продажи вырастут на 20 %, но на самом деле упали — это не ошибка, это галлюцинация. И она может стоить компании.
Вот что происходит, когда не проверяют совместимость. Компания внедряет ИИ, который работает только в облаке. У них — свои серверы. И ИИ не запускается. Они тратят миллионы на интеграцию, но не могут использовать. Это не ошибка, это неумение. И если вы не проверяете совместимость, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Инструменты для сравнения: что работает на практике
Есть инструменты, которые помогают сравнивать ИИ. Например, LMArena — сервис, где пользователи сравнивают пары ответов на один запрос. Это не автоматизированная оценка, но дает объективную картину. Люди оценивают, какой ответ лучше, и по итогам формируется рейтинг. Такой подход дает объективную оценку качества. Также существуют локальные бенчмарки, например, local-llm-benchmark, где можно сравнить производительность моделей на своих данных. Это важно, потому что модель может хорошо работать в общем контексте, но плохо — в вашем.
Однако даже с инструментами есть нюансы. Например, визуальное тестирование. ИИ может сравнивать скриншоты, находить изменения. Это работает, но требует настройки. Если не проверить, насколько точно ИИ определяет изменения, можно получить ложные срабатывания. Также есть модели, которые сравнивают условия поставщиков по критериям: цена, сроки, условия оплаты. Это полезно, но только если модель понимает, что именно важно. Всё зависит от того, как вы настроили критерии. Без них — просто «вот ответ, выберите». Это не сравнение, это выбор по настроению.
Другой инструмент — это open-source проекты, где сравнивают модели на реальных задачах. Например, в одном из проектов сравнивали версии GPT 4.5, 5, 5 Pro и 5.1 Pro. Результаты показали, что даже между версиями одного бренда разница может быть значительной. Это подтверждает: сравнение — не выбор по имени, а проверка по результатам. Но важно, чтобы задача была реальной. Если вы сравниваете модели по тестовым задачам, но в реальности у вас иные данные, результаты будут искажены.
Также можно использовать инструменты для сравнения по версиям. Например, GPT-5.4 показала на 33 % меньше галлюцинаций по сравнению с GPT-5.2. Это важно, потому что галлюцинации могут привести к ошибкам в отчетах. Если вы не проверяете, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Вот что происходит, когда не проверяют инструменты. Компания выбирает LMArena, потому что «все используют». Используют. И через месяц обнаруживают, что люди голосуют не по качеству, а по внешнему виду ответа. Один ответ — короткий, другой — длинный. Люди выбирают длинный, потому что он «выглядит умнее». Это не сравнение, это маркетинг. И если вы не проверяете, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Порядок действий: как провести сравнение
Первый шаг — определить задачу. Что вы хотите, чтобы ИИ делал? Генерировать отчеты, анализировать договоры, прогнозировать продажи? Без четкой задачи сравнение бессмысленно. Второй шаг — выбрать критерии. Точность, стабильность, скорость, количество галлюцинаций. Третий шаг — выбрать модели. 8 популярных, как в одном из проектов. Четвертый шаг — подготовить данные. Должны быть те же, что и в реальности. Пятый шаг — запустить модели на одинаковых задачах. Шестой шаг — оценить результаты. Сравнить ответы. Оценить, насколько они корректны, стабильны, точны. Седьмой шаг — выбрать модель. И только потом внедрять.
Важно, чтобы каждый шаг был проверен. Например, если вы используете ИИ для анализа договоров, нужно проверить, как он понимает термины. Если он не понимает, что «срок оплаты» — это 30 дней, а не 60, это проблема. Нужно проверить, как он работает с вашими данными. Если он не понимает, что «срок поставки» — это 14 дней, а не 7, это проблема. Нужно проверить, как он работает с вашими данными. Без этого — просто трата времени и денег.
Еще один важный шаг — проверка на стабильность. Модель может дать хороший ответ один раз, но другой раз — «выдумает» данные. Это не ошибка, это особенность. Нужно проверить, насколько стабилен результат. Если результаты разные, модель непригодна. Нужно проверить, насколько стабилен результат. Если результаты разные, модель непригодна. Нужно проверить, насколько стабилен результат. Если результаты разные, модель непригодна.
Также важно, чтобы сравнение проводилось на одинаковых задачах. Если одна модель анализирует код, а другая — текст, сравнение бессмысленно. Нужно использовать одинаковые задания, одинаковые данные, одинаковые критерии. Например, можно взять 8 популярных моделей и попросить их решить одну и ту же задачу по генерации отчета по 1С. Затем оценивать, насколько корректно, точно и стабильно каждый ответ. Это и есть объективность. Без нее — мифы, маркетинг, и, в конечном итоге, провал проекта.
Вот что происходит, когда не проверяют порядок действий. Компания выбирает модель, которая «выиграла» в бенчмарке. Внедряют. И через месяц обнаруживают, что ИИ не понимает термины из их отрасли. Потому что бенчмарк был на общих данных. А у них — специфика. И если вы не проверяете на ваших данных, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Типовые ошибки при сравнении ИИ-моделей
Одна из самых больших ошибок — считать, что ИИ всегда дает одинаковый результат. Это не так. Модели могут генерировать разные ответы на один и тот же запрос. Это называется «непредсказуемость». Если ваша задача — автоматизация отчетности, а модель каждый раз выдает разный результат, это проблема. Это не ошибка, это особенность. Поэтому важно проверять стабильность. Если модель не дает одинаковых ответов при одинаковых входных данных, она непригодна для бизнес-процессов, где требуется предсказуемость.
Другая ошибка — использовать ИИ для задач, где он не предназначен. Например, для прогнозирования продаж. Некоторые модели могут давать точные прогнозы, но только если обучены на данных, близких к вашим. В противном случае — ошибки. Точность ИИ-моделей прогнозирования может быть сопоставима с традиционными методами, но это не всегда так. Важно не полагаться на «уверенность» ИИ, а проверять его на реальных данных. Если ИИ говорит, что продажи вырастут на 20 %, но на самом деле упали — это не ошибка, это галлюцинация. И она может стоить компании.
Еще одна ошибка — не проверять совместимость. Если вы используете ИИ для анализа договоров, но модель не понимает, что «срок оплаты» — это 30 дней, а не 60, это проблема. Нужно проверить, как ИИ работает с вашими данными. Если он не понимает, что «срок поставки» — это 14 дней, а не 7, это проблема. Нужно проверить, как ИИ работает с вашими данными. Без этого — просто трата времени и денег.
Также важна проверка на реальных данных. Если вы сравниваете модели по тестовым задачам, но в реальности у вас иные данные, результаты будут искажены. Например, модель может хорошо работать с текстами на русском, но плохо — с техническими документами. И если вы не проверяете на ваших данных, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Как проверить результат
Проверка результата — это не «посмотрел, понравилось». Это измерение. Нужно проверить, насколько корректно, точно, стабильно. Например, если ИИ генерирует отчет, нужно проверить, насколько он соответствует данным в 1С. Если он не соответствует, это ошибка. Нужно проверить, насколько он соответствует данным в 1С. Если он не соответствует, это ошибка. Нужно проверить, насколько он соответствует данным в 1С. Если он не соответствует, это ошибка.
Также важно проверить, насколько стабилен результат. Модель может дать хороший ответ один раз, но другой раз — «выдумает» данные. Это не ошибка, это особенность. Нужно проверить, насколько стабилен результат. Если результаты разные, модель непригодна. Нужно проверить, насколько стабилен результат. Если результаты разные, модель непригодна. Нужно проверить, насколько стабилен результат. Если результаты разные, модель непригодна.
Другой способ проверки — сравнение по версиям. Например, GPT-5.4 показала на 33 % меньше галлюцинаций по сравнению с GPT-5.2. Это важно, потому что галлюцинации могут привести к ошибкам в отчетах. Если вы не проверяете, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Также можно использовать инструменты для сравнения. Например, LMArena — сервис, где пользователи сравнивают пары ответов на один запрос. Это не автоматизированная оценка, но дает объективную картину. Люди оценивают, какой ответ лучше, и по итогам формируется рейтинг. Такой подход дает объективную оценку качества. Также существуют локальные бенчмарки, например, local-llm-benchmark, где можно сравнить производительность моделей на своих данных. Это важно, потому что модель может хорошо работать в общем контексте, но плохо — в вашем.
Вот что происходит, когда не проверяют результат. Компания выбирает модель, которая «выиграла» в бенчмарке. Внедряют. И через месяц обнаруживают, что ИИ не понимает термины из их отрасли. Потому что бенчмарк был на общих данных. А у них — специфика. И если вы не проверяете на ваших данных, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Что делать, если уже сломалось
Если вы уже внедрили ИИ, но он не работает, не паникуйте. Проблема не в модели, а в процессе. Нужно вернуться к началу. Определить, что не работает. Проверить, насколько стабилен результат. Проверить, насколько он соответствует данным. Проверить, насколько он совместим с вашими системами. Проверить, насколько он понимает ваши данные. Проверить, насколько он работает с вашими задачами.
Если ИИ не стабилен, значит, он не подходит. Нужно выбрать другую модель. Если он не понимает ваши данные, значит, он не обучен на них. Нужно переобучить или выбрать другую модель. Если он не совместим с вашими системами, значит, он не подходит. Нужно выбрать модель, которая работает с вашей инфраструктурой. Если он не понимает ваши термины, значит, он не обучен на них. Нужно переобучить или выбрать другую модель.
Важно, чтобы вы не боялись начинать с нуля. Если вы уже тратите деньги на то, что не работает, лучше начать сначала. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Также важно, чтобы вы не боялись менять. Если модель не работает, значит, она не подходит. Нужно выбрать другую. Нужно проверить, насколько она работает. Нужно проверить, насколько она стабильна. Нужно проверить, насколько она точна. Нужно проверить, насколько она совместима с вашими системами. Нужно проверить, насколько она понимает ваши данные. Нужно проверить, насколько она работает с вашими задачами.
Вот что происходит, когда не проверяют. Компания внедряет ИИ, который работает только в облаке. У них — свои серверы. И ИИ не запускается. Они тратят миллионы на интеграцию, но не могут использовать. Это не ошибка, это неумение. И если вы не проверяете совместимость, вы просто тратите деньги на то, что не работает. Это не ошибка, это неумение. И если вы не проверяете, вы просто тратите деньги на то, что не работает.
Частые вопросы
Можно ли использовать инструмент для сравнения производительности разных моделей?
Да, существуют инструменты, такие как local-llm-benchmark, которые позволяют сравнивать модели по производительности. Однако важно, чтобы сравнение проводилось на одинаковых задачах и данных. Без этого результаты будут некорректными.
Какова точность ИИ-моделей прогнозирования по сравнению с традиционными методами?
Точность ИИ-моделей прогнозирования может быть сопоставима с традиционными методами, но это зависит от данных и задачи. Некоторые модели показывают высокую точность, но только при условии, что они обучены на данных, близких к вашим. Без проверки на реальных данных — это маркетинг, а не реальность.
Сравнение ИИ помогает выбрать модель под конкретную задачу, а не полагаться на репутацию бренда?
Да, сравнение по конкретным задачам позволяет выбрать модель, которая действительно работает для вас. Репутация бренда не гарантирует эффективности. Только проверка на реальных данных и задачах дает объективную оценку.
Как оценить качество ИИ-модели?
Качество оценивается по измеримым критериям: точность, стабильность, скорость, количество галлюцинаций. Также важно, насколько хорошо модель понимает контекст и работает с вашими данными. Например, если модель не может корректно сверяться с данными в 1С, она непригодна для бизнеса.
Какие критерии использовать для оценки ИИ-моделей?
Критерии могут быть: точность, стабильность, скорость, количество галлюцинаций, совместимость с вашими системами, понимание ваших данных и терминов. Все критерии должны быть измеримыми и объективными.
Что делать, если ИИ не работает?
Нужно вернуться к началу. Определить, что не работает. Проверить стабильность, точность, совместимость. Если модель не подходит, выбрать другую. Проверить, насколько она работает с вашими данными. Проверить, насколько она понимает ваши задачи. Проверить, насколько она совместима с вашими системами.
Источники
- LMArena — Сервис для сравнения ИИ-моделей по голосам пользователей. Позволяет сравнивать пары ответов на один запрос.
- local-llm-benchmark — Инструмент для локального сравнения производительности ИИ-моделей. Позволяет оценить разницу между версиями и моделями.
- Habr — Статьи о сравнении ИИ-моделей, включая сравнение версий GPT и Llama, а также использование ИИ в реальных проектах.
- Shtab.app — Определение RLHF и методов сравнения ИИ-моделей, включая сравнение пар ответов.
- Aineuro-tools.ru — Статьи о сравнении ИИ-моделей, где подчеркивается необходимость объективной оценки по конкретным задачам.
- BrowserStack — Статья о том, что ИИ-модели могут генерировать непредсказуемые результаты при одинаковых входных данных.