
Служба пишет на системный диск, а не на отдельный том: ищем скрытые данные и привязываем её к mount
Служба пишет на системный диск, потому что пустая точка монтирования — обычный каталог на корне. Чтобы это прекратить, привяжите службу к mount-unit через RequiresMountsFor= и BindsTo=, а уже записанное достаньте через bind-монтирование корня. Внутри: поиск скрытых данных, перенос без потерь, готовый drop-in и то, чего systemd не ловит.
Почему служба пишет на системный диск, если том «есть»
Потому что каталог /srv/scans существует и без тома. Для ядра это просто папка на корневой файловой системе, и служба, которая открыла путь и записала файл, не сделала ничего неправильного. Неправильное сделали раньше: никто не объяснил ей, что путь имеет смысл только вместе с примонтированным диском. Я обслуживаю серверы малого бизнеса больше пятнадцати лет, и эта история повторяется с пугающей регулярностью: диск не подключился, служба спокойно заполнила системный раздел, а потом кто-то удивляется, почему сервер встал.
Сценариев три. Первый: том не успел появиться при загрузке, а запись в fstab помечена nofail, чтобы сервер вообще загрузился. По документации systemd.mount(5), с nofail монтирование становится только желательным, а не обязательным для local-fs.target, и загрузка не ждёт этот том. Второй: том был, но устройство пропало, mount-unit остановился, а служба продолжила жить и писать в голый каталог. Третий: сервер перенесли или восстановили из копии, а про второй виртуальный диск забыли. Во всех трёх случаях служба стартует «успешно», и это самое обидное.
Дальше начинается второй акт. Когда том всё-таки подключают, он накрывает каталог, и всё, что служба успела записать на корень, пропадает из виду. Man-страница mount(8) называет это прямо: прежнее содержимое каталога, его владелец и права становятся невидимыми. Файлы никуда не делись, они лежат на корневом разделе под точкой монтирования и занимают место. Сотрудники при этом уверены, что данные за последние дни потеряны, а корень продолжает расти у вас на глазах. «Диск у нас отдельный, всё под контролем» — красивая фраза, пока кто-то не посмотрит на df.
Как понять, что данные уже лежат под точкой монтирования
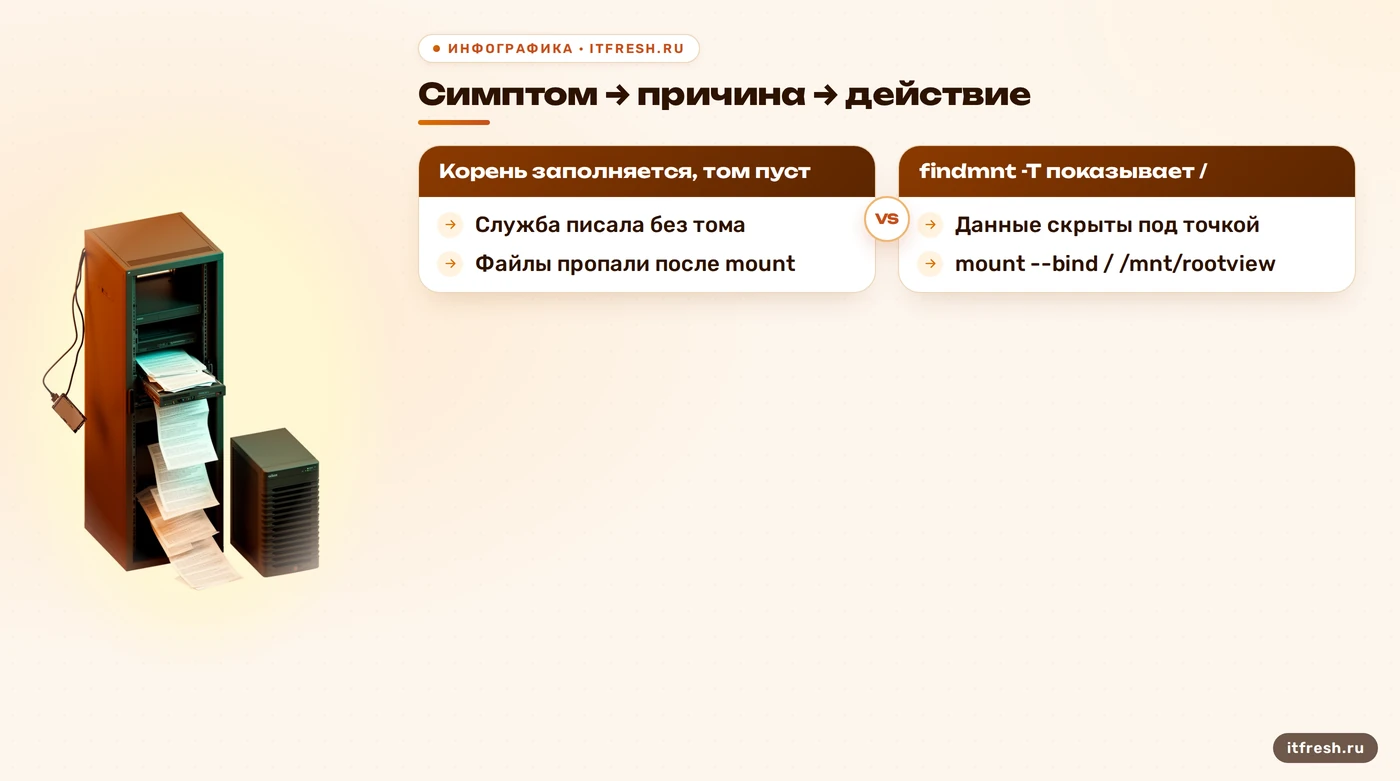
Признаки почти всегда одни и те же. Корневой раздел занят сильнее, чем должен, а на отдельном томе места полно. Или наоборот: после перезагрузки пользователи жалуются, что файлы за несколько дней «пропали», хотя служба работала и ошибок не писала. Если вы видите хотя бы один из этих симптомов, не начинайте с перезагрузок и не запускайте очистку. Сначала выясните, какая файловая система реально стоит под нужным путём.
Для этого есть findmnt. Ключ -T (--target) выводит файловую систему, в которой лежит путь: если сам путь не точка монтирования, утилита идёт вверх по элементам пути и находит ближайшую. Поэтому ответ «/» для вашего каталога означает, что тома под ним нет, и всё, что туда пишется, уходит на системный диск. Колонки лучше задавать явно через -o: в документации прямо сказано, что вывод по умолчанию может меняться, и в скриптах на него полагаться нельзя.
findmnt -T /srv/scans -o TARGET,SOURCE,FSTYPE
df -h / /srv/scans
systemctl status srv-scans.mount
Если том сейчас смонтирован, а подозрение остаётся, смотреть нужно под него. Обычный du по /srv/scans покажет содержимое тома и ничего больше. Выход — смонтировать корень в соседний каталог. По mount(8), bind-монтирование подключает только часть одной файловой системы без вложенных монтирований, а значит, в таком «зеркале» корня том на /srv/scans не виден, и под ним открывается то, что на самом деле лежит на системном диске. На практике это самый быстрый способ увидеть «призраков» под точкой, не размонтируя том и не останавливая всё подряд.
install -d /mnt/rootview
mount --bind / /mnt/rootview
du -sh /mnt/rootview/srv/scans
ls -la /mnt/rootview/srv/scans | head
Если du показывает гигабайты там, где должен быть пустой каталог, вы нашли то, что искали. Прикиньте объём и сравните со свободным местом на целевом томе: переносить придётся именно туда. И остановите службу до всякого копирования, иначе она продолжит писать, пока вы сверяете списки. Если нужна помощь, чтобы разобрать такой инцидент на боевом сервере без лишних рисков, мы делаем это за один визит: находим, переносим, закрываем причину.
Как перенести данные на нужный том и не потерять ни файла
Порядок действий я держу жёстким. Сначала останавливаем службу, потом убеждаемся, что том смонтирован, потом копируем, потом проверяем, и только в самом конце чистим корень. Каждый шаг — отдельная команда, а не одна строка с точкой с запятой. Для остановки хватает systemctl stop, для монтирования — запуска mount-unit: его имя собирается из пути, и для /srv/scans это srv-scans.mount.
systemctl stop scan-intake.service
systemctl start srv-scans.mount
findmnt -T /srv/scans -o TARGET,SOURCE,FSTYPE
Копировать я предпочитаю rsync. Важная деталь, на которой спотыкаются: ключ -a равен -rlptgoD и не включает ни жёсткие ссылки (-H), ни ACL (-A), ни расширенные атрибуты (-X). Если на каталоге есть ACL для отдела продаж, без -A они потеряются при переносе. Первый запуск делаем пробным, с -n: rsync покажет, что собирается передать, и ничего не изменит. Слэш после исходного каталога обязателен, иначе вы получите вложенный каталог scans внутри scans.
rsync -aHAXn --info=progress2 /mnt/rootview/srv/scans/ /srv/scans/
rsync -aHAX --info=progress2 /mnt/rootview/srv/scans/ /srv/scans/
Ключ --remove-source-files в rsync существует, он удаляет синхронизированные файлы на стороне источника (каталоги не трогает). Я им не пользуюсь именно в этой ситуации. Удаление должно быть отдельным осознанным шагом после проверки, а не побочным эффектом копирования. Проверка простая: повторите rsync в пробном режиме с ключом -i, который выводит список изменений. Пустой вывод означает, что на томе уже есть всё, что лежало под точкой. Заодно посмотрите на количество файлов с обеих сторон через find и wc.
Бывает и неприятный вариант: служба какое-то время успела поработать и на томе, и на корне, и теперь на обеих сторонах есть файлы с одинаковыми именами. Пробный запуск покажет такие пересечения. Решать их автоматически я не советую: сравните размеры и даты, а для документов с разными версиями оставьте обе под разными именами. Когда пробный запуск пуст, удаляйте содержимое под точкой, размонтируйте зеркало и сразу сверьте использование корня. Если место не освободилось, значит, удалили не то или служба ещё жива и держит открытые файлы — это отдельная история про удалённые, но открытые файлы, и lsof +L1 её быстро подтвердит.
rsync -aHAXni /mnt/rootview/srv/scans/ /srv/scans/
find /mnt/rootview/srv/scans -type f | wc -l
find /srv/scans -type f | wc -l
Как связать службу с монтированием через systemd
Перенос лечит последствия, причину он не трогает. Причину лечит связка трёх вещей: запись в fstab, защита пустой точки и drop-in для службы. Профилактику с нуля, на чистом сервере, я подробно разбирал в статье о том, как запускать службу только после монтирования тома; здесь — то же, но после инцидента, когда данные уже разъехались. Начнём с fstab. Я оставляю nofail, чтобы сервер всегда загружался и до него можно было достучаться по сети, и добавляю x-systemd.device-timeout, чтобы не ждать отсутствующее устройство дольше нужного: по документации, это время ожидания устройства перед тем, как отказаться от записи. Безопасность при этом обеспечивает не fstab, а зависимость службы.
blkid /dev/vg0/scans
# строка в /etc/fstab:
UUID=<UUID из blkid> /srv/scans ext4 defaults,nofail,x-systemd.device-timeout=30s 0 2
Теперь защита пустой точки. Пока том не смонтирован, закройте запись на каталог для обычных пользователей и для пользователя службы. Mount(8) здесь на нашей стороне: когда том смонтирован, права и владелец каталога под ним невидимы, так что режим 000 на пустой точке не мешает работе тома. Но выполнять chmod нужно строго при размонтированном томе, иначе вы поменяете права корня самого тома. Служба должна работать не от root, потому что root игнорирует такие права.
umount /srv/scans
chmod 000 /srv/scans
systemctl start srv-scans.mount
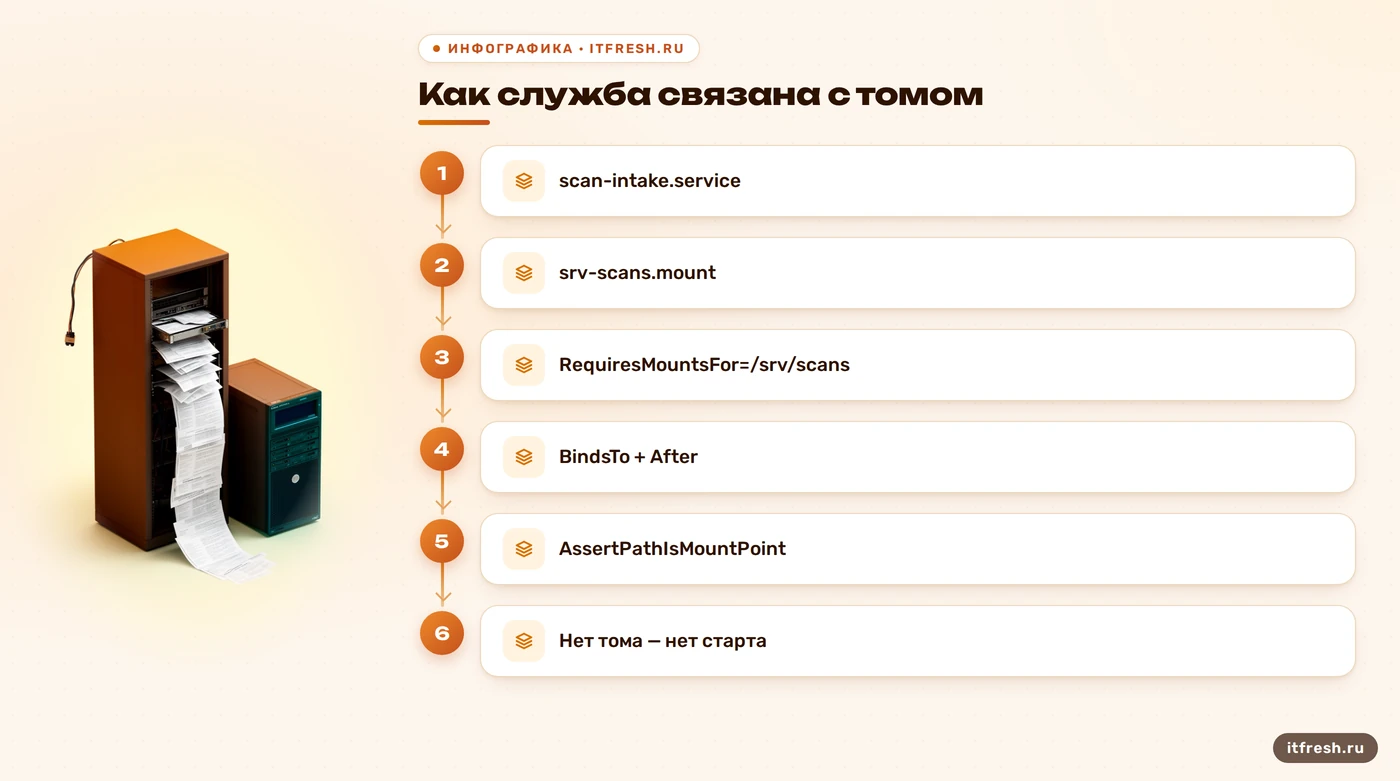
Сама связка живёт в drop-in. Его удобно создавать командой systemctl edit scan-intake.service. RequiresMountsFor= появилась в systemd 201 и автоматически добавляет зависимости Requires= и After= на все mount-юниты, нужные для доступа к пути, включая точки с noauto. BindsTo= строже обычного Requires=: служба останавливается и тогда, когда mount-юнит неожиданно переходит в неактивное состояние, а с After= поведение ещё жёстче. Assert-проверка нужна как ремень к подтяжкам: Condition-вариант тихо пропускает запуск, а Assert-вариант завершает его ошибкой, и вы это увидите.
[Unit]
RequiresMountsFor=/srv/scans
BindsTo=srv-scans.mount
After=srv-scans.mount
AssertPathIsMountPoint=/srv/scans
Откуда systemd знать, что приложению нужен /srv/scans? Только от вас. Если путь прописан в WorkingDirectory=, RootDirectory= или StateDirectory=, зависимости от mount-юнитов добавляются автоматически (в документации systemd.exec(5) это эквивалент RequiresMountsFor=). Но если путь живёт в конфиге самого приложения, а в юните его нет, systemd о нём не знает, и тут без явной директивы никак. Версию директив Condition и Assert проверьте в своей системе через man systemd.unit: ConditionPathIsMountPoint= в документации помечена версией 244.
После правки выполните systemctl daemon-reload и посмотрите, что systemd реально поймёт из вашего юнита: systemctl show -p Requires -p BindsTo -p After scan-intake.service. Затем на тестовой копии сервера отмонтируйте том и попробуйте запустить службу: старт должен завершиться отказом, а не молчаливым успехом. Если запись выполняется по расписанию, посмотрите мой разбор того, как заменить cron на systemd-таймеры: таймер просто запускает службу, и её зависимости работают так же, а упавший запуск виден в статусе, а не прячется в пустом каталоге.
Что эти зависимости не ловят: проверка при старте — не постоянный контроль
Главная иллюзия, которую я встречаю: «поставил ConditionPathIsMountPoint — и теперь служба следит за диском». Нет. Это проверка в момент запуска, и после старта юнит о ней не вспоминает. Постоянно за состоянием тома следит связка BindsTo=: если mount-юнит остановился или упал, остановится и служба. Но и она реагирует на состояние mount-юнита, а не на здоровье диска. Если файловая система остаётся смонтированной, systemd считает, что всё в порядке, даже когда носитель уже неисправен.
Типичные «смонтирован, но плохо» случаи: файловая система перемонтировалась в режим только для чтения после ошибок, том заполнился до отказа, сетевой том завис. Для первого есть ConditionPathIsReadWrite=, который проверяет, что файловая система доступна для чтения и записи, но снова при старте. В fstab можно добавить x-systemd.rw-only: если том не удалось смонтировать на запись, он не будет подниматься только на чтение, а завершится ошибкой. Важно: это срабатывает только в момент монтирования; если ext4 уже работает и по errors=remount-ro ушла в «только чтение» на ходу, ни эта опция, ни зависимости юнита этого не заметят. Для сетевых томов отдельная история: опция _netdev помечает монтирование как сетевое и упорядочивает его после сети. Это про порядок загрузки, а не про контроль работоспособности.
Поэтому третий рубеж я всегда ставлю вне systemd: мониторинг. Нужны три вещи: заполнение корня с порогом пониже, чем вы привыкли, заполнение самого тома и свежесть данных, например время последнего файла в каталоге. Если корень вырос за ночь на десяток гигабайт, а том не изменился, вы узнаете об этом утром, а не через три дня. «Мы же настроили зависимости» — отличная фраза для отчёта и плохая замена графику.
Разбор из практики: сканы договоров в «Жилом фонде»
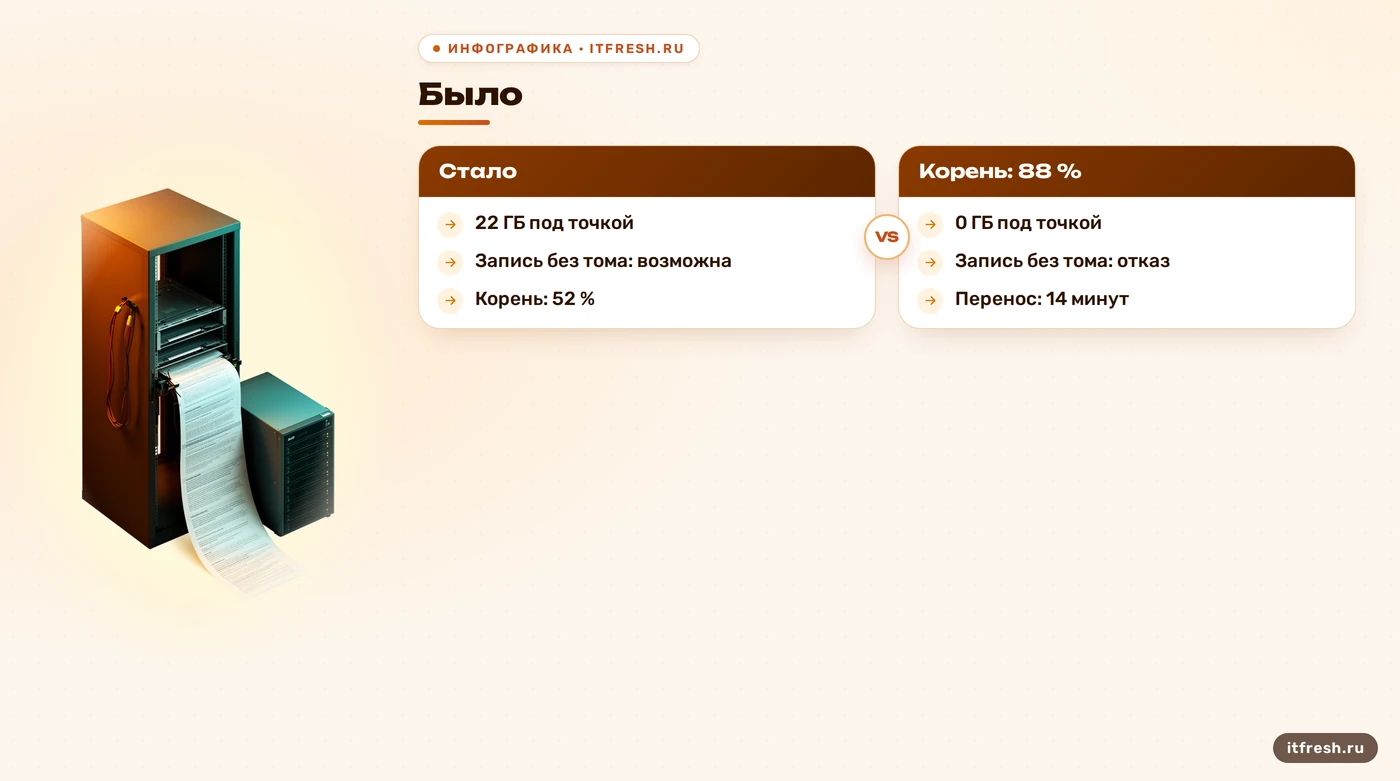
Клиент — риэлторская компания «Жилой фонд», 18 рабочих мест, один сервер на Ubuntu Server 24.04. Служба scan-intake принимает с сетевых сканеров PDF договоров и раскладывает их в /srv/scans. Корневой раздел — 60 ГБ, под сканы отдельный LVM-том на 500 ГБ с ext4. После планового обновления гостевая машина стартовала без второго виртуального диска, и три дня служба писала в пустой каталог на корне. Корень вырос с 52 % до 88 %, это порядка 22 ГБ. Серверу ничего не сообщило, служба работала без ошибок.
Когда диск вернули и сервер перезагрузили, том накрыл каталог, и менеджеры пришли с жалобой: сканы за три дня пропали. Я зашёл на сервер, увидел, что findmnt -T /srv/scans показывал том нормально, а корень по df оставался заполненным на 88 %. Это расхождение и навело на мысль заглянуть под точку. Зеркало корня через mount --bind показало в каталоге около двух тысяч файлов общим объёмом 22 ГБ. Копирование rsync с ключами -aHAX заняло 14 минут, повторный пробный запуск вернул пустой вывод, после чего мы очистили каталог под точкой, и корень вернулся к 52 %.
Причину закрыли в тот же день. В fstab оставили nofail с x-systemd.device-timeout=30s, служба переехала на отдельного пользователя, на пустую точку поставили режим 000, а в drop-in добавили RequiresMountsFor=, BindsTo=, After= и AssertPathIsMountPoint=. Проверили на копии виртуальной машины: без диска служба отказалась запускаться, с диском стартовала. В мониторинг добавили заполнение корня и тома. Виноват тут не администратор и не клиент, а обычная схема «так исторически сложилось»: служба доверяет пути, а путь не доверяет никому. За следующие два месяца записей мимо тома больше не было.
Частые вопросы
Почему данные не видны после монтирования тома, хотя место на корне занято?
Смонтированная файловая система накрывает каталог-точку, и прежнее содержимое становится невидимым, но остаётся на корневом разделе. Увидеть его можно через mount --bind / /mnt/rootview.
Достаточно ли ConditionPathIsMountPoint, чтобы служба не писала мимо тома?
Нет. Это проверка только в момент запуска, и при невыполнении условия юнит тихо пропускается. Для остановки службы вместе с томом добавьте BindsTo= и After= на mount-юнит.
Чем RequiresMountsFor= отличается от BindsTo=?
RequiresMountsFor= добавляет Requires= и After= на mount-юниты, нужные для пути, и работает при старте. BindsTo= дополнительно останавливает службу, когда связанный юнит неожиданно перестал быть активным.
Что делать, если на корне и на томе есть файлы с одинаковыми именами?
Сначала сделайте пробный запуск rsync с -n и -i и изучите пересечения. Автоматически перезаписывать не стоит: сравните размеры и даты, при необходимости сохраните обе версии.
Ловит ли systemd неисправный диск, если том остаётся смонтированным?
Нет. Зависимости привязаны к состоянию mount-юнита, а не к здоровью носителя. Нужен отдельный мониторинг заполнения корня и тома и свежести данных.
Источники
- systemd.unit(5): RequiresMountsFor=, BindsTo=, Condition и Assert — Проверены поведение RequiresMountsFor= (Requires= и After=, noauto), BindsTo=, ConditionPathIsMountPoint=, ConditionPathIsReadWrite=, различие Condition и Assert. https://man7.org/linux/man-pages/man5/systemd.unit.5.html
- systemd.mount(5): опции fstab — Проверены nofail, noauto, x-systemd.device-timeout, x-systemd.rw-only, _netdev. https://man7.org/linux/man-pages/man5/systemd.mount.5.html
- systemd.exec(5): автоматические зависимости и ProtectSystem — Проверены автоматические Requires= и After= для WorkingDirectory=, RootDirectory=, StateDirectory=. https://man7.org/linux/man-pages/man5/systemd.exec.5.html
- mount(8): bind-монтирование — Проверены --bind, скрытие прежнего содержимого каталога, отсутствие вложенных монтирований при обычном bind. https://man7.org/linux/man-pages/man8/mount.8.html
- findmnt(8) — Проверены опции -T (--target), -o, предупреждение о нестабильном выводе по умолчанию. https://man7.org/linux/man-pages/man8/findmnt.8.html
- rsync(1) — Проверены состав -a, а также -H, -A, -X, -n, -i, --info=progress2, --remove-source-files. https://man7.org/linux/man-pages/man1/rsync.1.html