
Канал свободен, а синхронизация PBS между площадками ползёт: как работает worker-threads в Proxmox Backup Server 4.2
Sync job в Proxmox Backup Server до 4.2 обрабатывал группы бэкапов по одной, и на канале с задержкой 30 мс один поток не заполняет полосу. Параметр worker-threads в 4.2 синхронизирует группы параллельно. Ниже — как доказать, что проблема именно в этом, как подобрать число потоков, чем оно ограничено и как не задушить офисный канал.
Почему sync PBS между площадками медленный, хотя канал свободен
Типичная жалоба: «Поставили второй PBS на удалённой площадке, настроили синхронизацию, ночью она не успевает». Дальше по классике: админ проверяет канал через iperf3, получает честную полосу, идёт крутить MTU, включает BBR, меняет шифр в IPsec, переносит туннель на WireGuard. Скорость sync при этом не меняется. Я видел это не раз, и чаще всего проблема была не в транспорте, а в том, как устроено само резервное копирование на удалённую площадку.
Sync job в PBS — это не rsync и не scp. Это клиент, который ходит к удалённому датастору по HTTP/2 поверх TLS: запрашивает список групп, снимки в группе, индексные файлы и по ним вытягивает недостающие chunks. До версии 4.2 группы обрабатывались строго по очереди. Официальная документация прямо называет узкое место: на соединениях с высокой задержкой одно HTTP/2-соединение к источнику упирается в head-of-line blocking, а параллельная обработка групп может заметно поднять пропускную способность.
Интуиция тут простая. Чем больше RTT, тем больше данных должно одновременно находиться «в полёте», чтобы заполнить канал, и тем сильнее один логический поток страдает от каждой паузы на запрос индекса или ожидание ответа. На локалке с RTT меньше миллисекунды вы этого не увидите — один поток спокойно выбирает гигабит. А через VPN между городами с RTT 30–40 мс потолок одного потока оказывается в разы ниже потолка канала.
Среднюю скорость sync я беру не «на глаз» из графика интерфейса, а из журнала задачи: в конце лога PBS пишет, сколько данных передано и за какое время. Делю одно на другое и перевожу в мегабиты — это число и сравниваю с iperf3. Для первого замера достаточно открыть последнюю успешную задачу во вкладке Tasks или вызвать proxmox-backup-manager task log <upid>. Если задач несколько, берите ночь с типичной дельтой, а не первый полный перенос — первичная заливка ведёт себя иначе.
Отсюда практический вывод одной фразой: если sync идёт между двумя зданиями по своей оптике, тюнить нечего. Если между городами или через VPN с RTT больше 10–15 мс — читайте дальше.
- iperf3 в несколько потоков даёт полную скорость, в один поток — примерно столько же, сколько sync
- скорость sync стоит ровно и почти не зависит от объёма дельты
- на приёмнике во время sync процессор и диски скучают, iowait околонулевой
Что именно распараллеливает worker-threads в PBS 4.2
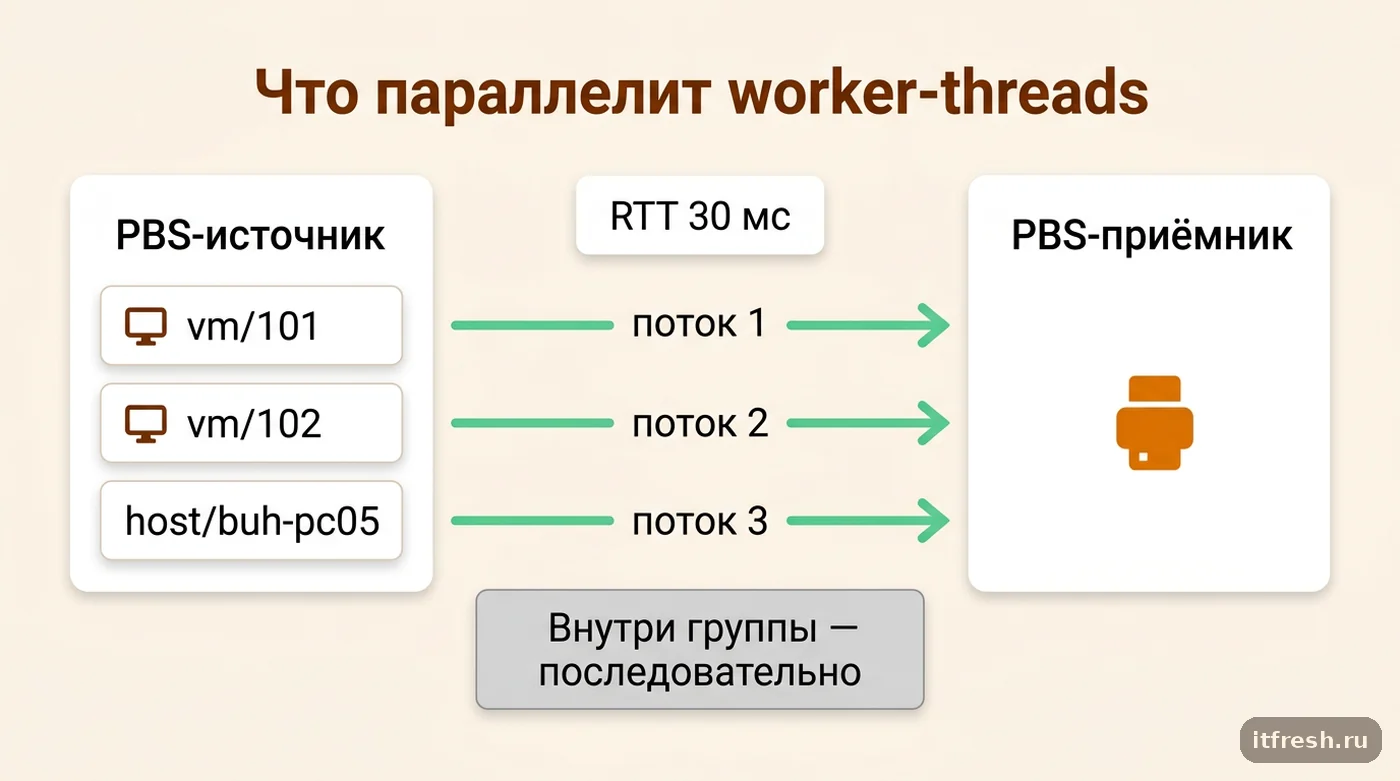
В Proxmox Backup Server 4.2 (релиз 29 апреля 2026) у задачи синхронизации появился параметр worker-threads. По документации: значения от 1 до 32, по умолчанию 1, значение больше единицы синхронизирует несколько backup groups параллельно. Ключевое слово — groups. Параллелизм идёт по группам резервных копий, то есть по сущностям вида vm/101, ct/204, host/buh-pc05.
Из этого следует несколько вещей, которые доходят не сразу. Первое: внутри одной группы ничего не ускоряется. Снимки в группе идут по очереди, chunks внутри снимка — тоже. Если на площадке одна-единственная большая виртуальная машина, worker-threads не даст ничего. Я однажды поставил восемь потоков для площадки, где почти весь объём давал один файловый сервер, ждал чуда и получил ноль. Пришлось разбирать сам бэкап: выносить данные на отдельные диски и в отдельные группы.
Второе: потолок ускорения — число групп, которые реально изменились за интервал. В датасторе может быть 60 групп, но если за сутки поменялись пять, работать будут максимум пять потоков. Третье: одна большая группа среди мелких превращается в хвост — все потоки отработали, а один продолжает тянуть. Общее время задачи не может быть меньше времени самой тяжёлой группы. Бороться с этим надо не потоками, а разбиением бэкапа.
Опция работает в обе стороны: и для pull (направление по умолчанию), и для push. В 4.2 push к тому же научился шифровать нешифрованные снимки активным ключом при отправке на менее доверенный удалённый PBS. Ограничители трафика различаются: rate-in для pull и rate-out для push.
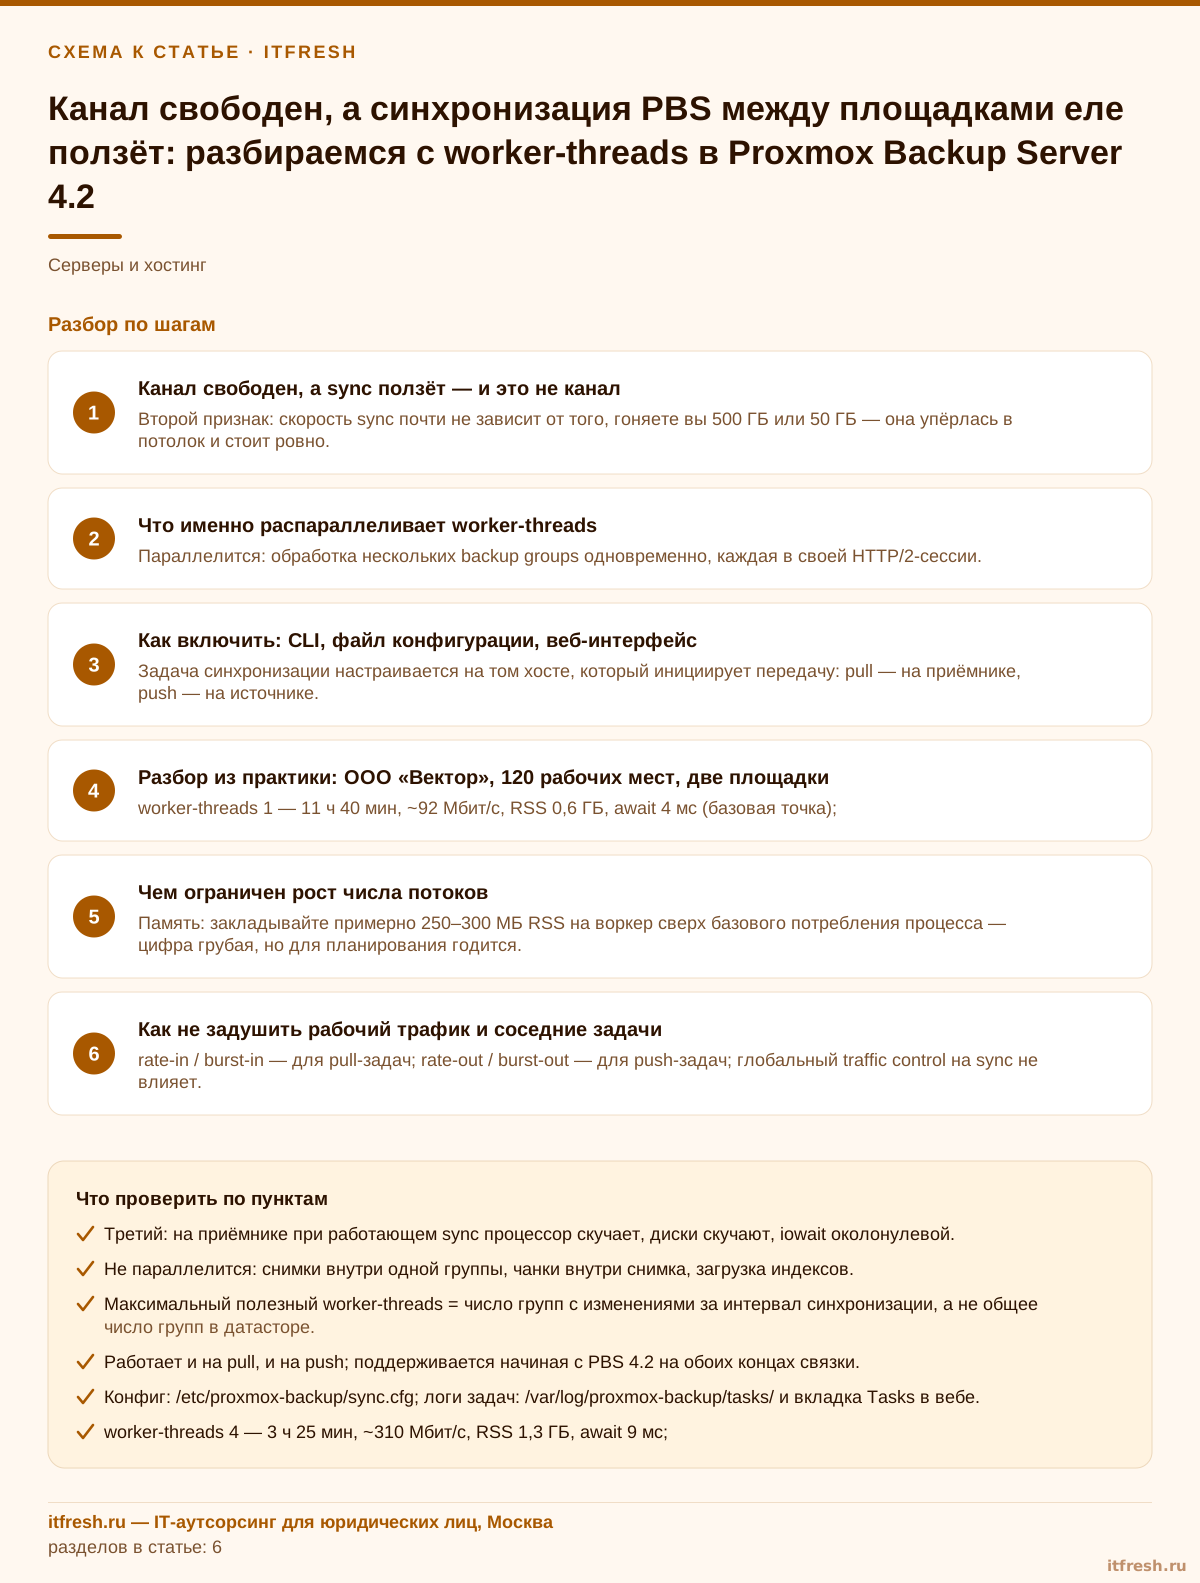
- Параллелится: обработка нескольких backup groups одновременно
- Не параллелится: снимки внутри группы, chunks внутри снимка
- Полезный максимум worker-threads = число групп с изменениями за интервал, а не общее число групп
- Работает и для pull, и для push; задача должна жить на PBS 4.2
Как включить worker-threads: CLI, sync.cfg, веб-интерфейс
Быстрее и надёжнее всего — через proxmox-backup-manager на том сервере, где живёт задача (для pull это приёмник, для push — источник). Создание и правка выглядят так:
# создать задачу pull-синхронизации
proxmox-backup-manager sync-job create pbs2-local \
  --remote pbs2 --remote-store local --store local \
  --schedule 'Wed 02:30'

# включить параллельную обработку групп
proxmox-backup-manager sync-job update pbs2-local --worker-threads 4

# проверить и прогнать вручную
proxmox-backup-manager sync-job list
proxmox-backup-manager sync-job run pbs2-local
Настройки задач лежат в /etc/proxmox-backup/sync.cfg — текстовом файле в формате секций. Я смотрю его напрямую, когда надо быстро понять, что наворотил предыдущий админ, и держу копию в git вместе с datastore.cfg и remote.cfg. Секция выглядит примерно так (сверяйте с proxmox-backup-manager sync-job show <id> в своей версии):
sync: pbs2-local
	store local
	remote pbs2
	remote-store local
	schedule Wed 02:30
	worker-threads 4
	rate-in 20MiB
	comment offsite
В веб-интерфейсе параметр в настройках задачи синхронизации датастора, но я предпочитаю CLI: воспроизводимо и сразу видно все параметры. Права для pull по документации: Remote.Read на /remote/{remote}/{remote-store} и Datastore.Backup на локальный датастор (плюс Datastore.Prune, если включён remove-vanished). Для push — Remote.Audit и Remote.DatastoreBackup на удалённой стороне. Если приёмник не видит датастор источника, вероятно, дело в правах самого пользователя, а не токена, — эту ловушку я разбирал в статье про API-токен PBS с правами на datastore.
Полезный приём для площадок с неоднородными группами — разнести синхронизацию на две задачи через --group-filter. Например, одна задача берёт только виртуальные машины (--group-filter type:vm), другая — только бэкапы рабочих станций (--group-filter type:host). Тогда тяжёлые группы серверов не блокируют мелкие группы компьютеров, и вы можете задать им разное расписание и разный лимит. Главное — не забыть, что потоки двух одновременно работающих задач складываются.
И сразу совет: не меняйте worker-threads вместе с чем-то ещё. Один прогон — одно изменение. Иначе вы не поймёте, что дало прирост: потоки, новый лимит скорости или то, что заодно передвинули verify.
- pull настраивается на приёмнике, push — на источнике
- конфиг: /etc/proxmox-backup/sync.cfg; журналы — вкладка Tasks и `proxmox-backup-manager task log <upid>`
- соседние опции: --group-filter, --ns / --remote-ns / --max-depth для пространств имён, --transfer-last N для переноса только последних снимков
Разбор из практики: «Дебет-Кредит», 19 рабочих мест и offsite за 30 мс
Бухгалтерская консультация «Дебет-Кредит», 19 рабочих мест. В офисе — один хост Proxmox VE с шестью виртуальными машинами (контроллер домена, сервер 1С с PostgreSQL, терминальный сервер, файловый сервер, пара служебных) и локальный PBS 4.2 на отдельном сервере. Кроме виртуальных машин, через proxmox-backup-client бэкапятся профили и рабочие папки 19 компьютеров сотрудников — каждый своей группой host/. Итого в датасторе 27 групп. Вторая копия — PBS 4.2 на удалённой площадке, pull через IPsec, офисный канал 200 Мбит/с на отдачу, RTT 30–33 мс. Окно для синхронизации — с 22:00 до 07:00.
Пришли ко мне в конце квартала: «синхронизация не успевает, утром тормозит интернет в офисе». Замерили: суточная дельта в отчётный период выросла до 110 ГБ, задача шла 5 часов 25 минут при нормальных днях, а в пиковые ночи — дольше девяти и вылезала в рабочее время. Средняя скорость по логу — около 45 Мбит/с. iperf3 в один поток давал 48 Мбит/с, в восемь — 190. Диагноз поставили этими двумя цифрами за десять минут: приложение упирается в один поток, а не в канал.
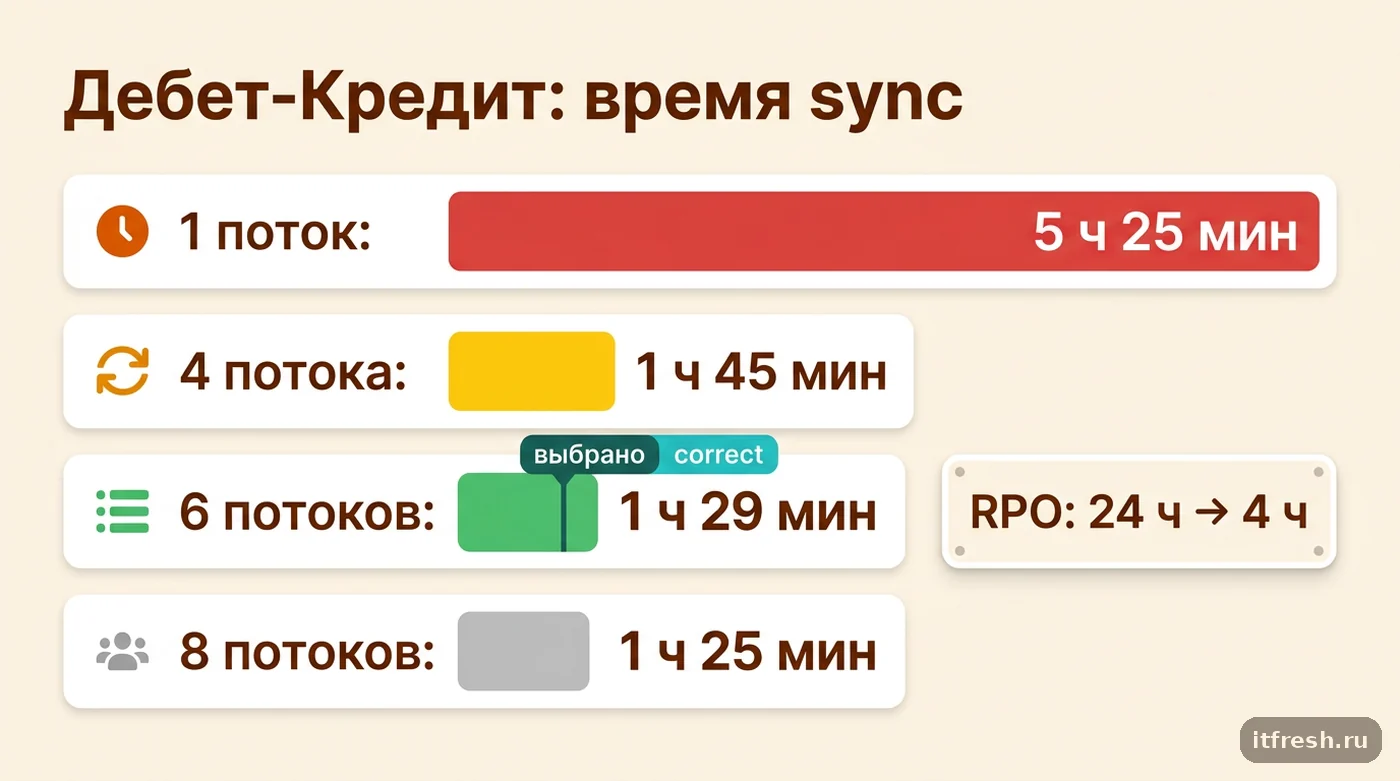
Дальше перебор с шагом, каждое значение — отдельная ночь с сопоставимой дельтой. Снимал время выполнения, среднюю скорость из лога, пик RSS процесса proxmox-backup-proxy на приёмнике и await дисков. Результаты — в списке ниже. Остановились на шести потоках: 5 часов 25 минут превратились примерно в полтора часа. Восемь потоков дали плюс 4 % к шести при заметном росте await — в пределах шума, не стоит того. Меняющихся групп в обычную ночь около двадцати, так что запас по параллелизму был.
Отдельно пришлось разобраться с первичной заливкой на новый приёмник, которую делали за месяц до меня: она шла почти четверо суток, и её тоже списали на канал. Для первичного переноса большого объёма я сейчас предпочитаю один раз привезти данные физически или ограничить перенос последними снимками через --transfer-last, а историю догонять постепенно. После тюнинга в «Дебет-Кредите» повторную заливку делать не пришлось, но для следующего приёмника в регламенте теперь этот пункт есть.
Хвост тоже проявился честно: последние 50 минут любой задачи тянулась одна группа — сервер 1С с ежедневной дельтой около 18 ГБ. Быстрее этого времени задача не станет при любом числе потоков. Но главный выигрыш даже не в скорости: синхронизацию перевели с ночного расписания на запуск каждые четыре часа, и RPO по offsite-копии сократился с суток до четырёх часов. Ради этого всё и затевалось. Чтобы днём sync не мешал людям, задали rate-in 20MiB — около 168 Мбит/с, оставив офису запас канала.
- worker-threads 1 — 5 ч 25 мин, ~45 Мбит/с, RSS 0,4 ГБ (базовая точка)
- worker-threads 4 — 1 ч 45 мин, ~140 Мбит/с, RSS 0,8 ГБ
- worker-threads 6 — 1 ч 29 мин, ~165 Мбит/с, RSS 1,1 ГБ (выбрано)
- worker-threads 8 — 1 ч 25 мин, ~172 Мбит/с, RSS 1,4 ГБ, await вырос почти вдвое
Сколько потоков ставить и чем ограничен их рост
Документация предупреждает прямо: память и число соединений на обоих концах растут примерно линейно с числом воркеров, поэтому большие значения не всегда лучше. На стенде это подтверждается почти буквально: каждый воркер держит своё соединение к удалённому серверу, свои буферы и свою TLS-обвязку. Сколько памяти уходит на воркер в вашей связке, проще всего измерить: RSS proxmox-backup-proxy до и во время задачи.
Второе ограничение — диск приёмника. Sync пишет chunks в .chunks, а это случайная запись по 65 536 подкаталогам. На NVMe вы этого не заметите, на RAIDZ2 из SATA-дисков заметите очень хорошо, особенно если параллельно идёт verify или GC. Проверьте tuning датастора: при sync-level=file fsync вызывается на каждую вставку chunk, и параллельные потоки упрутся в диск. Значение по умолчанию — filesystem, оно делает syncfs после завершения задачи и является разумным компромиссом.
# текущие tuning-опции датастора
proxmox-backup-manager datastore show local

# вернуть умолчание, если кто-то поставил sync-level=file
# (--tuning перезаписывает строку целиком — перечислите и остальные ваши опции)
proxmox-backup-manager datastore update local --tuning 'sync-level=filesystem'
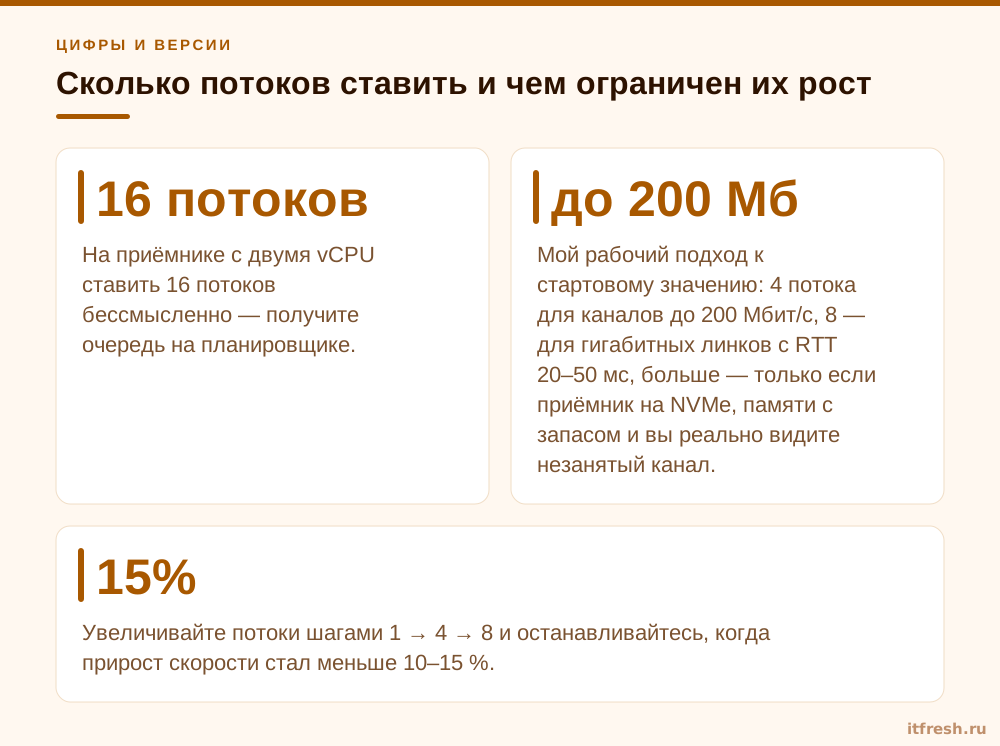
Третье — процессор: TLS, распаковка, проверка контрольных сумм chunks. На приёмнике с двумя vCPU ставить 16 потоков бессмысленно — получите очередь на планировщике. Четвёртое, самое приятное ограничение — канал: когда суммарная скорость потоков упёрлась в линию, дальнейшее увеличение только расходует память и IOPS. Именно это произошло в «Дебет-Кредите» между шестью и восемью потоками.
Про сеть между площадками одно уточнение, которое регулярно всплывает. Если туннель идёт через NAT на офисном маршрутизаторе, проверьте лимиты таблицы соединений и тайм-ауты для долгих TCP-сессий. Шесть-восемь долгих TLS-соединений сами по себе ничтожная нагрузка, но на бытовом роутере с агрессивным тайм-аутом простаивающая сессия может обрываться посреди ожидания индекса, и в журнале задачи вы увидите ошибки соединения, которые легко принять за проблему PBS.
Мой рабочий подход к стартовому значению: 4 потока для каналов до 200 Мбит/с, 8 — для гигабитных линков с RTT 20–50 мс, больше — только если приёмник на NVMe, памяти с запасом и вы реально видите незанятый канал. Значения ближе к 32 я на практике не применял и сценария, где они оправданы, не встречал.
- Память: измерьте RSS proxmox-backup-proxy во время задачи, рост примерно линейный по числу воркеров
- Соединения: N воркеров — примерно N соединений на обоих концах; проверьте лимиты файрвола и conntrack, если между площадками NAT
- Диск: смотрите await на приёмнике; рост в 3–4 раза к однопоточному прогону — красная зона
- CPU: ориентир — не больше одного воркера на доступное ядро приёмника
- Tuning по умолчанию: chunk-order=inode, sync-level=filesystem; менять осознанно и по одному
Как ограничить скорость sync и не задушить рабочий трафик
Как только sync начинает выбирать канал целиком, появляется вторая проблема: если задача выехала за ночное окно или вы перевели её на дневной запуск, она конкурирует с рабочим трафиком. Подвох, на котором спотыкаются почти все: в PBS есть глобальный traffic control — правила с сетями, лимитами и таймфреймами. Но документация прямо предупреждает: sync job на сервере этими правилами не ограничиваются. Для них нужен собственный лимит задачи.
Ограничивать sync нужно параметрами самой задачи: rate-in для pull и rate-out для push, плюс burst-in / burst-out — размер корзины токенов для коротких всплесков. Единицы можно задавать в десятичных (MB, GB) или двоичных (MiB, GiB) — разница почти 5 %, не перепутайте. И помните, что это байты в секунду, а не биты.
# pull: ограничить входящий трафик ~168 Мбит/с с корзиной на всплески
proxmox-backup-manager sync-job update pbs2-local --rate-in 20MiB --burst-in 40MiB

# push: ограничивается исходящий
proxmox-backup-manager sync-job update pbs2-push --rate-out 20MiB --burst-out 40MiB
Второй источник конкуренции — соседние задачи самого PBS. GC и verify на приёмнике бьются с sync за одни и те же диски. Я развожу так: sync — раз в 4–6 часов, verify — раз в неделю ночью, GC — раз в неделю в другой день. Если verify на приёмнике находит повреждённые снимки, обычный sync их не перекачает — для этого есть отдельный режим, про resync-corrupt в PBS я писал подробно.
Третье: если у вас две задачи синхронизации в одну сторону и обе с восемью потоками, суммарно это шестнадцать. Считайте бюджет по всем одновременно работающим задачам, а не по каждой отдельно, либо разведите их по расписанию.
- rate-in / burst-in — для pull, rate-out / burst-out — для push; глобальный traffic control на sync не влияет
- MB и MiB различаются почти на 5 %; лимит задаётся в байтах в секунду
- sync, verify и GC конкурируют за IOPS приёмника — разводите по расписанию
- бюджет потоков считается суммарно по всем одновременным задачам
Порядок действий: что делать в первую очередь, а на что не тратить время
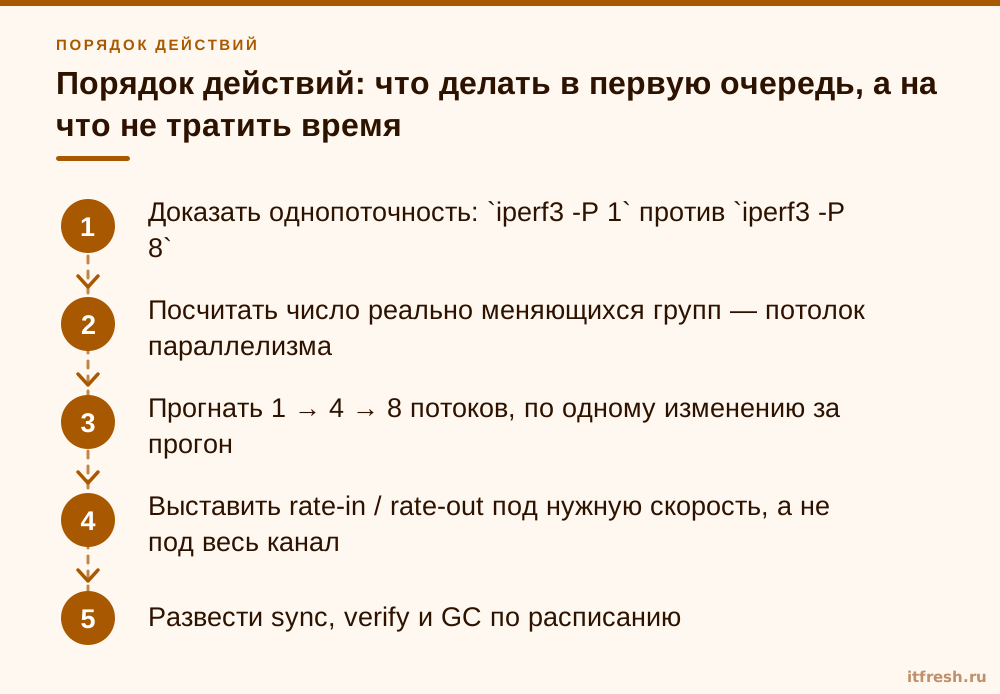
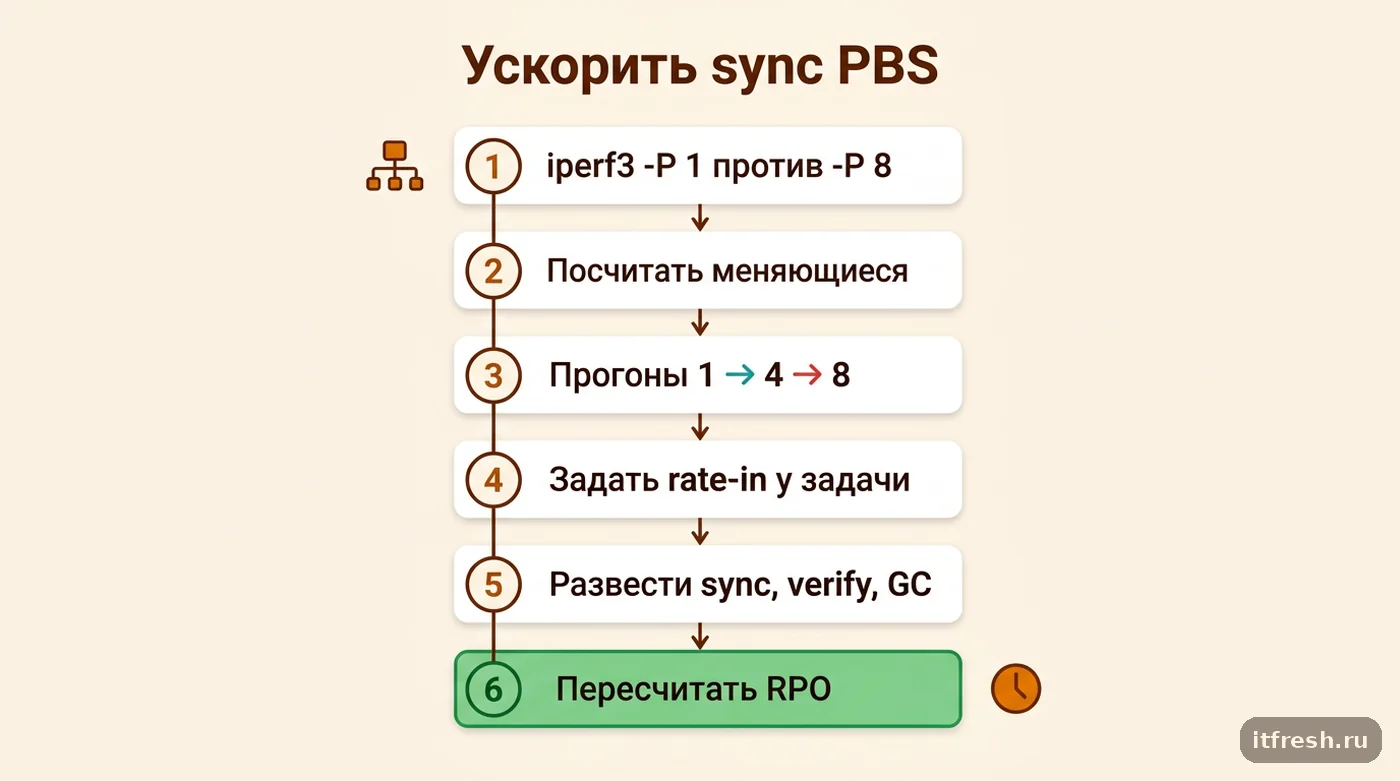
Сначала — доказать, что проблема в параллелизме: iperf3 в один поток и в восемь, сравнить однопоточный результат со средней скоростью sync из лога. Совпали — диагноз подтверждён. Если однопоточный iperf3 сильно выше скорости sync, дело не в head-of-line: смотрите диски приёмника, параллельный verify, память. Потом посчитать группы, которые реально меняются между запусками: это ваш потолок параллелизма. Затем три прогона — базовый, 4 и 8 потоков, каждый отдельной ночью с фиксацией времени, скорости, RSS и await. И только после этого — пересчитать расписание под новый RPO.
На что можно не тратить время. Тюнинг сети: MTU, congestion control, смена шифра IPsec при этой проблеме дают единицы процентов и стоят часов работы. Погоня за максимальным worker-threads: разница между 8 и 16 — проценты, а память отличается вдвое. Переход с pull на push ради скорости: push решает другую задачу — когда приёмник не должен иметь доступа к источнику, — а worker-threads работает одинаково в обе стороны. Отдельно про поведение приёмника при удалении снимков на источнике: без remove-vanished история на приёмнике копится, с ним — зеркалится; почему синхронизация PBS — это зеркало, а не второй архив, стоит понять до того, как поднимать частоту sync.
Не забивать нельзя на мониторинг возраста последней успешной синхронизации. Заведите проверку «последняя успешная задача завершилась не позже N часов назад» и уведомление. Дельта растёт вместе с бизнесом, и настройка, которая сегодня укладывается в окно с запасом, через год начнёт в него упираться. Узнать об этом лучше из графика, а не в момент аварии, когда offsite отстал на трое суток.
И вопрос, по которому единого мнения нет: держать ли промежуточный локальный PBS или бэкапить сразу в удалённый. Я за схему «локальный PBS плюс sync на удалённую площадку»: восстановление с локального идёт по локальной сети, виртуальные машины не ждут сетевых задержек во время бэкапа, а канал грузится асинхронно и предсказуемо. У коллег с хорошей оптикой между площадками прямой бэкап в удалённый датастор тоже работает. Решает конкретика вашего канала.
- Доказать однопоточность: `iperf3 -P 1` против `iperf3 -P 8`
- Посчитать число реально меняющихся групп — потолок параллелизма
- Прогнать 1 → 4 → 8 потоков, по одному изменению за прогон
- Выставить rate-in / rate-out под нужную скорость, а не под весь канал
- Развести sync, verify и GC по расписанию
- Пересчитать расписание под новый RPO и мониторить возраст последней успешной задачи
Частые вопросы
С какой версии PBS появился worker-threads у sync job?
С Proxmox Backup Server 4.2 (апрель 2026). Значения от 1 до 32, по умолчанию 1. Параметр задаётся в задаче синхронизации: `proxmox-backup-manager sync-job update <id> --worker-threads 4`.
Ускорит ли worker-threads синхронизацию одной большой виртуальной машины?
Нет. Параллелизм идёт по backup groups, а снимки и chunks внутри одной группы обрабатываются последовательно. Одна большая ВМ — одна группа и один поток.
Почему глобальный traffic control не ограничивает sync?
Так задумано: по документации sync job не подчиняются глобальным правилам. Для pull задайте rate-in у задачи, для push — rate-out, при необходимости с burst-in / burst-out.
Сколько потоков ставить?
Начните с 4, затем попробуйте 8, каждый раз отдельным прогоном с замером времени, памяти и задержки дисков. Остановитесь, когда прирост меньше 10–15 %. Больше числа меняющихся групп ставить бессмысленно.
Работает ли worker-threads для push-синхронизации?
Да, параметр одинаково работает для pull и push. Для push скорость ограничивается rate-out, а в 4.2 push умеет шифровать нешифрованные снимки активным ключом при отправке на менее доверенный сервер.
Источники
- Proxmox Backup Server 4.2 — Managing Remotes & Sync — worker-threads (1–32, по умолчанию 1, параллелизм по backup groups, head-of-line blocking, линейный рост памяти и соединений), rate-in/rate-out/burst, права для pull и push, шифрование при push, пример sync-job create. https://pbs.proxmox.com/docs/managing-remotes.html
- Proxmox Backup Server — Network Management, Traffic Control — Примечание: sync job не подчиняются глобальным ограничениям трафика, нужен лимит задачи. https://pbs.proxmox.com/docs/network-management.html
- Proxmox Backup Server — Command Syntax — sync-job create/update/run/show, --worker-threads (1–32, default 1), --rate-in, --burst-in, --transfer-last, единицы KB/MB и KiB/MiB. https://pbs.proxmox.com/docs/command-syntax.html
- Proxmox Backup Server — Backup Storage, Tuning — sync-level (none / filesystem по умолчанию / file — fsync на каждую вставку chunk), chunk-order, синтаксис --tuning. https://pbs.proxmox.com/docs/storage.html
- Proxmox — Proxmox Backup Server 4.2 released — Дата релиза 29.04.2026, параллельная обработка групп в sync job через worker-threads. https://www.proxmox.com/en/about/company-details/press-releases/proxmox-backup-server-4-2