
Включил proxy_cache_lock, а бэкенд всё равно получает пачку одинаковых запросов: разбираю lock_age и lock_timeout
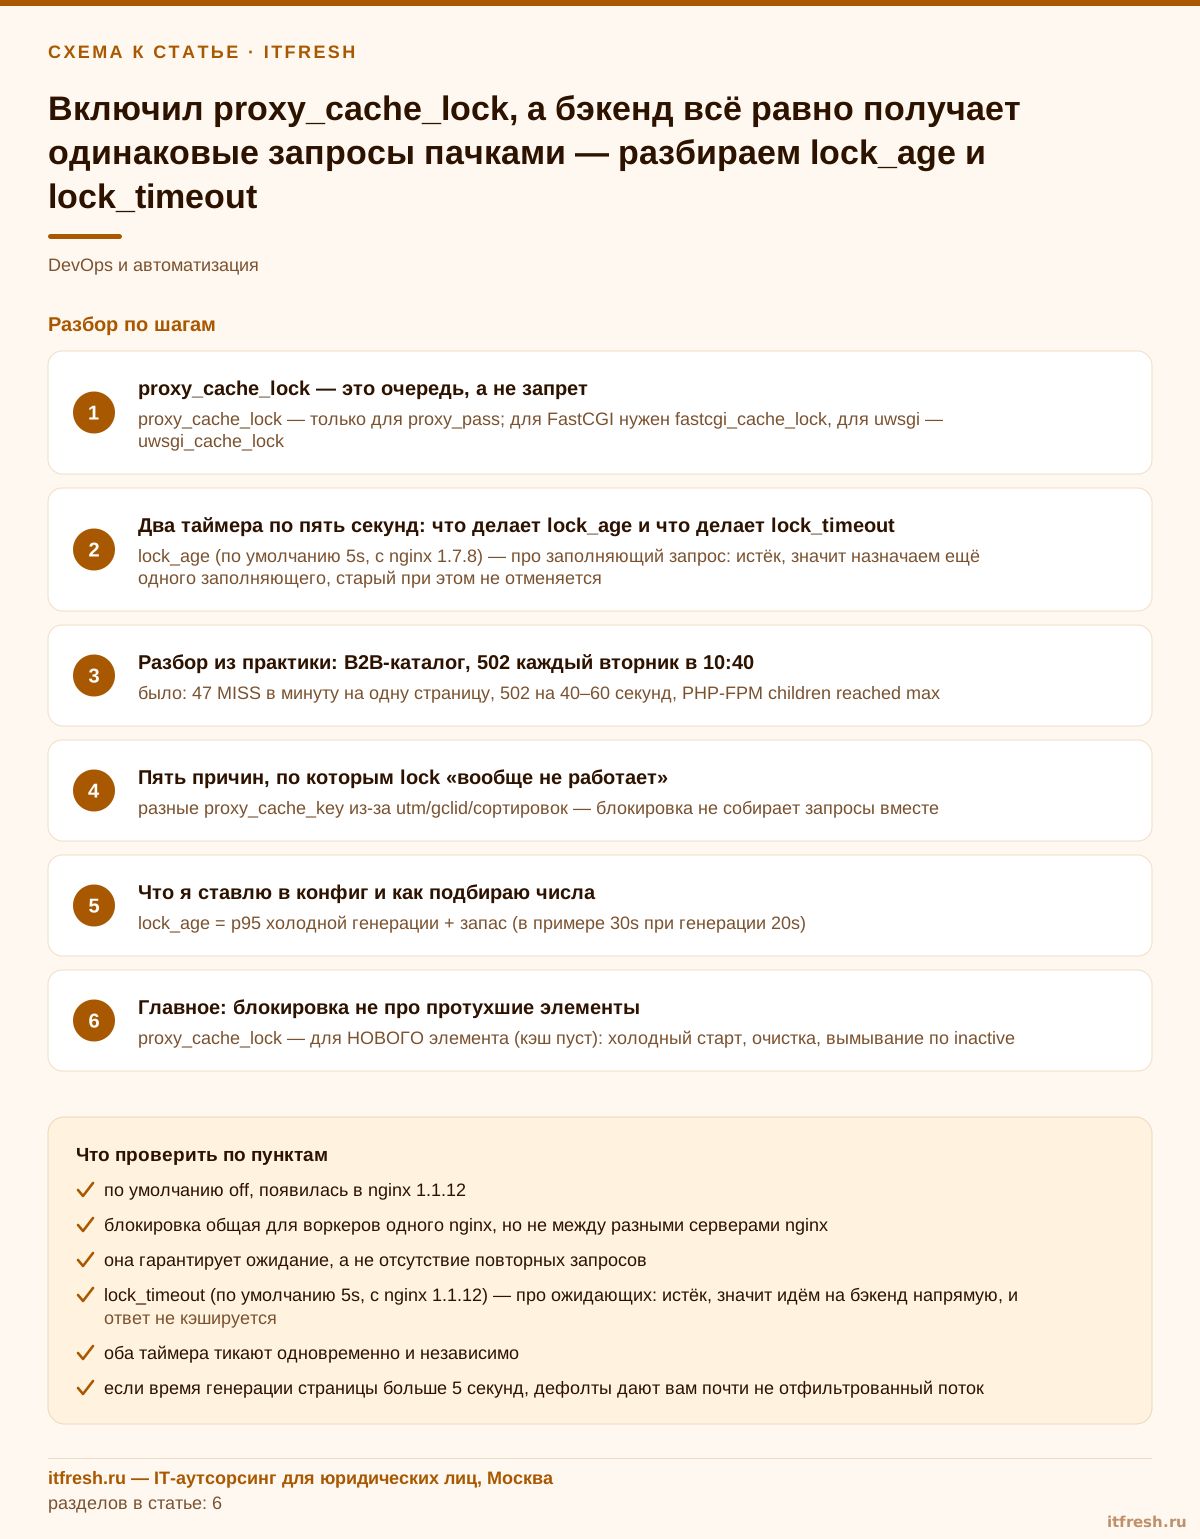
proxy_cache_lock не гарантирует, что до бэкенда дойдёт один запрос. Он только заставляет остальных подождать, причём по умолчанию всего 5 секунд, и работает лишь для нового элемента кэша. Если страница генерируется дольше, а кэш протухает по расписанию, приложение всё равно получает пачку. Ниже разбираю оба таймера, кейс школы и конфиг, который я ставлю.
Что на самом деле делает proxy_cache_lock в nginx
Начну с формулировки, которая снимает большую часть недопонимания. По документации ngx_http_proxy_module при включённой директиве только одному запросу за раз разрешено заполнять новый элемент кэша, определяемый proxy_cache_key. Остальные запросы к тому же элементу ждут, пока ответ появится в кэше или блокировку снимут, но не дольше proxy_cache_lock_timeout. Когда мы в АйТи-Фреш берём на обслуживание сайт, где уже есть настройка кэша и фронтов nginx, я первым делом проверяю, понимает ли команда именно это «не дольше».
Потому что в этом «не дольше» вся суть. proxy_cache_lock не обещает, что бэкенд получит ровно один запрос. Он обещает, что остальные подождут, причём ограниченное время. Когда время вышло, они всё равно пойдут на бэкенд. Это очередь с тайм-аутом, а не запрет. Директива по умолчанию выключена (proxy_cache_lock off) и существует с nginx 1.1.12, вместе с proxy_cache_lock_timeout.
Второе, что я проверяю, — префикс директивы. У каждого проксирующего модуля свой набор: fastcgi_cache_lock, uwsgi_cache_lock, scgi_cache_lock. Если PHP подключён через fastcgi_pass, строчка proxy_cache_lock on в конфиге ни на что не влияет. На такую путаницу я натыкаюсь регулярно: человек добавил директиву из статьи про proxy_pass, перезагрузил nginx и честно не понимает, почему ничего не поменялось. Про соседний случай, когда тайм-аут выставлен не в том модуле, я писал в разборе какой тайм-аут на самом деле управляет PHP-FPM.
Третье ограничение — область действия. Блокировка хранится в разделяемой памяти зоны кэша (keys_zone), поэтому общая для всех воркеров одного nginx. Но между разными серверами nginx она не действует. Если за балансировщиком три фронта и у каждого свой proxy_cache_path, на холодном старте бэкенд получит минимум три запроса. Это нормальное поведение, и лечится оно общим кэширующим слоем или прогревом, а не таймерами.
- proxy_cache_lock относится только к proxy_pass; для FastCGI нужен fastcgi_cache_lock, для uwsgi — uwsgi_cache_lock
- по умолчанию off, директива появилась в nginx 1.1.12
- блокировка общая для воркеров одного nginx, но не для нескольких серверов
- гарантируется ожидание, а не единственный запрос к бэкенду
lock_age и lock_timeout: два таймера по 5 секунд, и оба про разное
Здесь ошибаются почти все. Таймеров два, у обоих дефолт 5 секунд, но действуют они на разные запросы. proxy_cache_lock_age (появилась в 1.7.8) касается того запроса, который держит блокировку и заполняет кэш. Документация: если последний запрос, переданный на проксируемый сервер для заполнения нового элемента, не завершился за указанное время, на сервер может быть передан ещё один запрос. Обратите внимание: про отмену первого не сказано ни слова. Старый запрос продолжает выполняться на бэкенде, а nginx назначает ещё одного заполняющего. Каждые lock_age секунд — плюс один, пока кто-нибудь не ответит.
proxy_cache_lock_timeout касается тех, кто стоит в очереди. По истечении времени запрос передаётся на проксируемый сервер, но ответ не кэшируется. В документации отдельно оговорено: до версии 1.7.8 такой ответ мог попасть в кэш. Если вы читали старые статьи, где написано иначе, — они описывают поведение десятилетней давности. Сейчас весь трафик, вылетевший по lock_timeout, для кэша бесполезен: он только нагружает приложение.
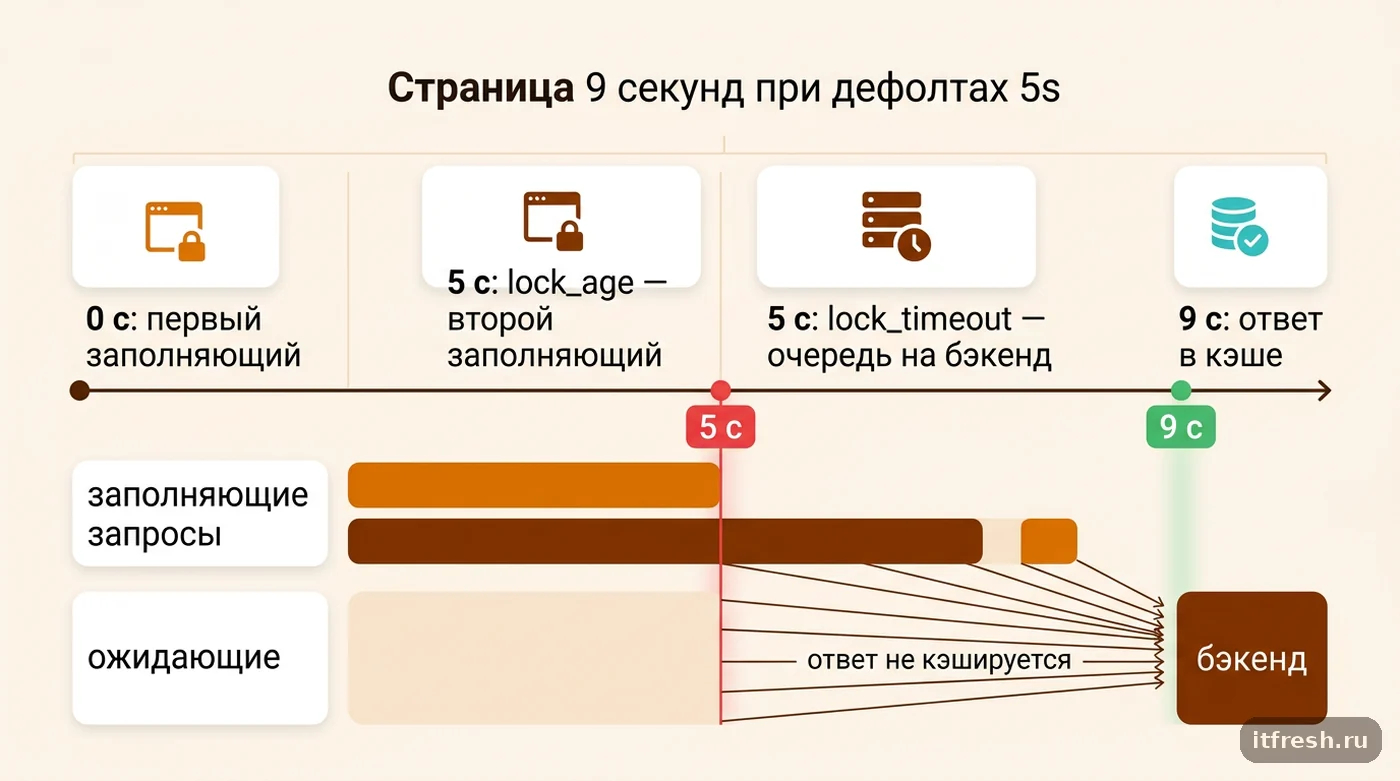
Теперь сложите оба дефолта и представьте страницу, которая генерируется 9 секунд. На пятой секунде nginx выпускает на бэкенд всю накопившуюся очередь (lock_timeout) и одновременно назначает второго заполняющего (lock_age). Очередь, пришедшая после этого, снова ждёт 5 секунд и снова вылетает. К моменту, когда первый ответ ляжет в кэш, на бэкенде уже висят два заполняющих и все, кто пришёл за эти секунды. При медленном бэкенде дефолтные значения дают почти нефильтрованный поток. Это не баг: дефолты просто рассчитаны на быстрые ответы, и подгонять их под свой бэкенд — задача администратора.
- lock_age (5s, с 1.7.8) — про заполняющий запрос: время вышло — назначается ещё один заполняющий, прежний не отменяется
- lock_timeout (5s, с 1.1.12) — про ожидающих: время вышло — идут на бэкенд напрямую, ответ не кэшируется
- оба таймера идут одновременно и независимо
- если холодная генерация страницы дольше 5 секунд, дефолты почти ничего не фильтруют
Разбор из практики: расписание музыкальной школы и 504 после рассылки
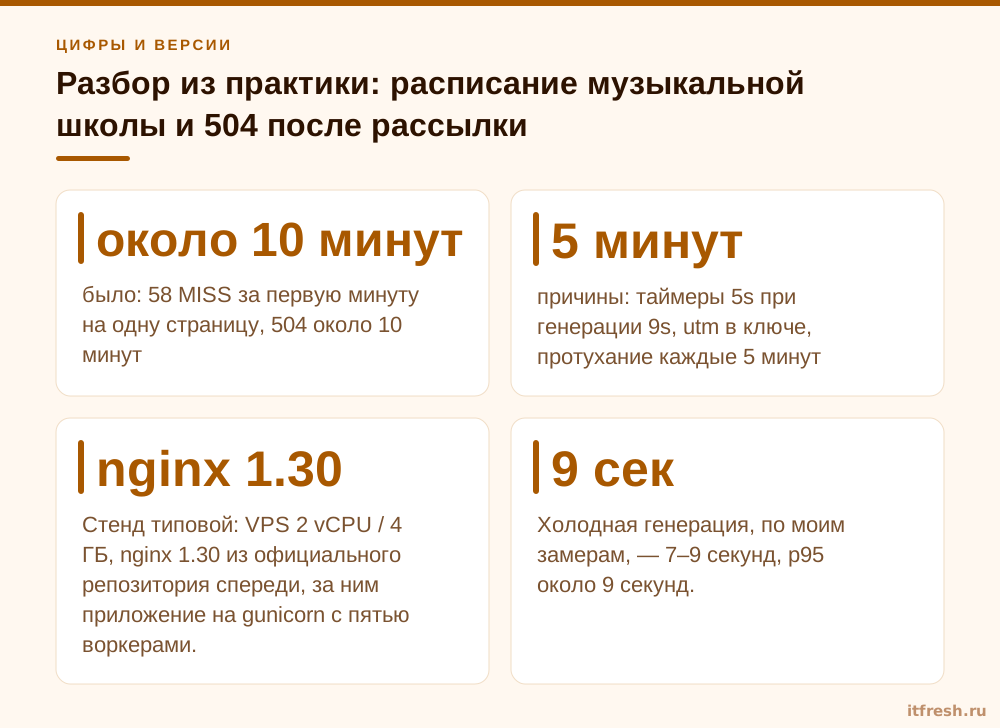
Музыкальная школа «Юный музыкант», 10 рабочих мест в администрации и сайт, через который родители смотрят расписание и записываются на прослушивания. Стенд типовой: VPS 2 vCPU / 4 ГБ, nginx 1.30 из официального репозитория спереди, за ним приложение на gunicorn с пятью воркерами. Страница расписания собирается из внешнего сервиса электронного журнала: приложение делает несколько запросов к его API и склеивает таблицу. Холодная генерация, по моим замерам, — 7–9 секунд, p95 около 9 секунд.
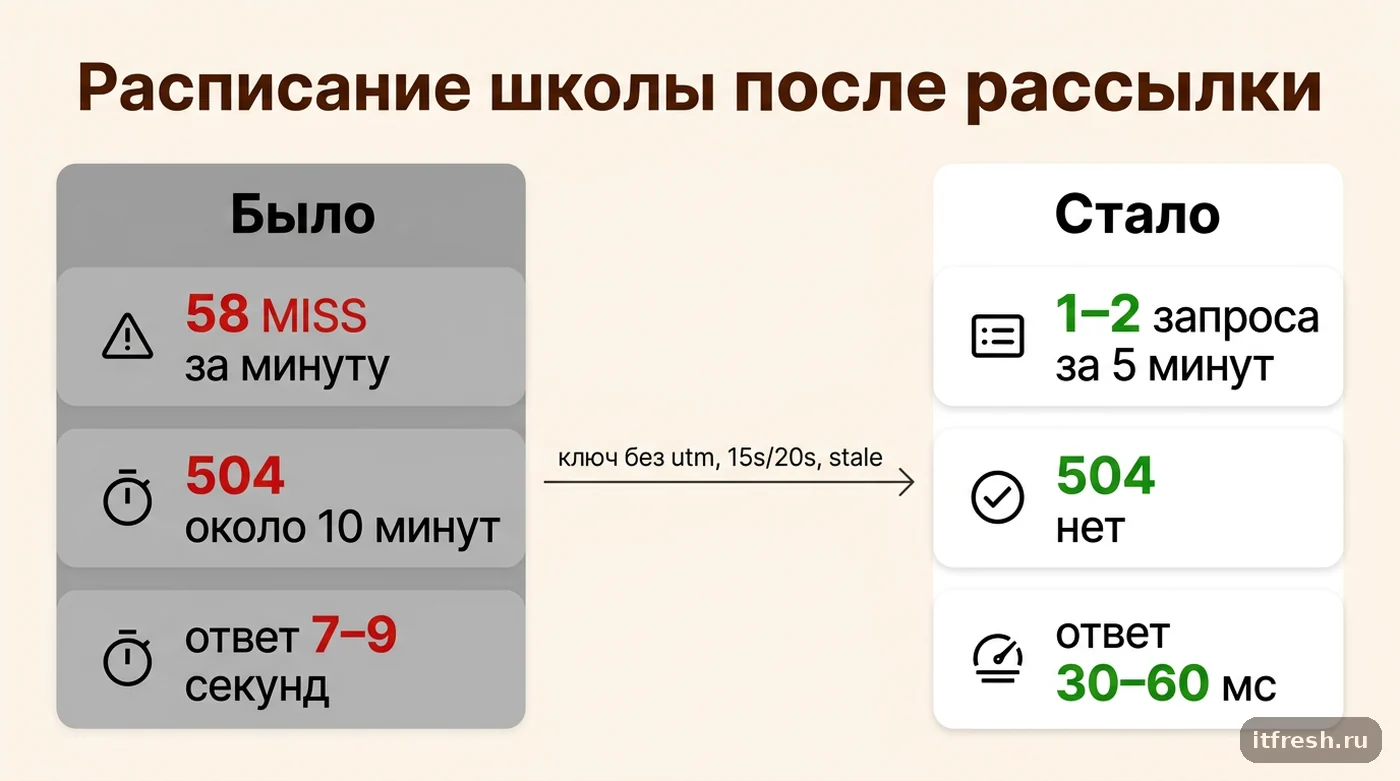
Жалоба была конкретной: в последнюю неделю августа, сразу после рассылки родителям (около 380 семей), страница расписания минут на десять превращается в 504. В access-логе за первую минуту после рассылки — 212 запросов на /raspisanie/, из них 58 с $upstream_cache_status = MISS. proxy_cache_valid стоял 5m, proxy_cache_lock on уже был включён прежним подрядчиком с дефолтными таймерами. Пять воркеров gunicorn забивались одинаковыми запросами за считанные секунды, остальные ловили тайм-аут.
Разбор показал три причины сразу. Первая — таймеры: генерация 9 секунд против lock_age и lock_timeout по 5 секунд, то есть ровно механика из прошлого раздела. Вторая — ключ кэша: ссылки в рассылке шли с utm-метками, и ключ по умолчанию $scheme$proxy_host$request_uri делал из одной страницы десятки разных элементов. Третья и главная — кэш протухал каждые 5 минут, а для протухшего элемента блокировка вообще не работает (об этом ниже отдельный раздел).
Что я сделал за один вечер. Нормализовал ключ через map, выбросив utm-параметры. Растянул lock_age до 15s и lock_timeout до 20s под реальное время генерации, proxy_read_timeout поставил 30s. Включил отдачу устаревшей копии с фоновым обновлением. Поднял inactive в proxy_cache_path до суток. Итог через две недели, на следующей рассылке про сентябрьские концерты: 504 не было ни одного, на /raspisanie/ бэкенд получал 1–2 запроса за пятиминутное окно, время ответа родителям — 30–60 мс вместо 7–9 секунд. Сервер докупать не пришлось.
- было: 58 MISS за первую минуту на одну страницу, 504 около 10 минут
- причины: таймеры 5s при генерации 9s, utm в ключе, протухание каждые 5 минут
- стало: 1–2 обращения к бэкенду за 5 минут, 504 нет
- ответ родителям: 30–60 мс вместо 7–9 секунд
Почему proxy_cache_lock «вообще не работает»: пять причин
Если после включения блокировки картина в логах не изменилась совсем, дело обычно не в таймерах. Вот что я проверяю по порядку. Первое и самое частое — разные ключи. Блокировка привязана к элементу по proxy_cache_key. Ключ по умолчанию включает $request_uri с аргументами, поэтому /raspisanie/ и /raspisanie/?utm_source=mail — два разных элемента и две независимые блокировки. Добавьте метки рассылок, gclid, yclid, сортировку — и одинаковых запросов у вас нет вообще. Лечится нормализацией ключа через map или явным перечнем значимых аргументов.
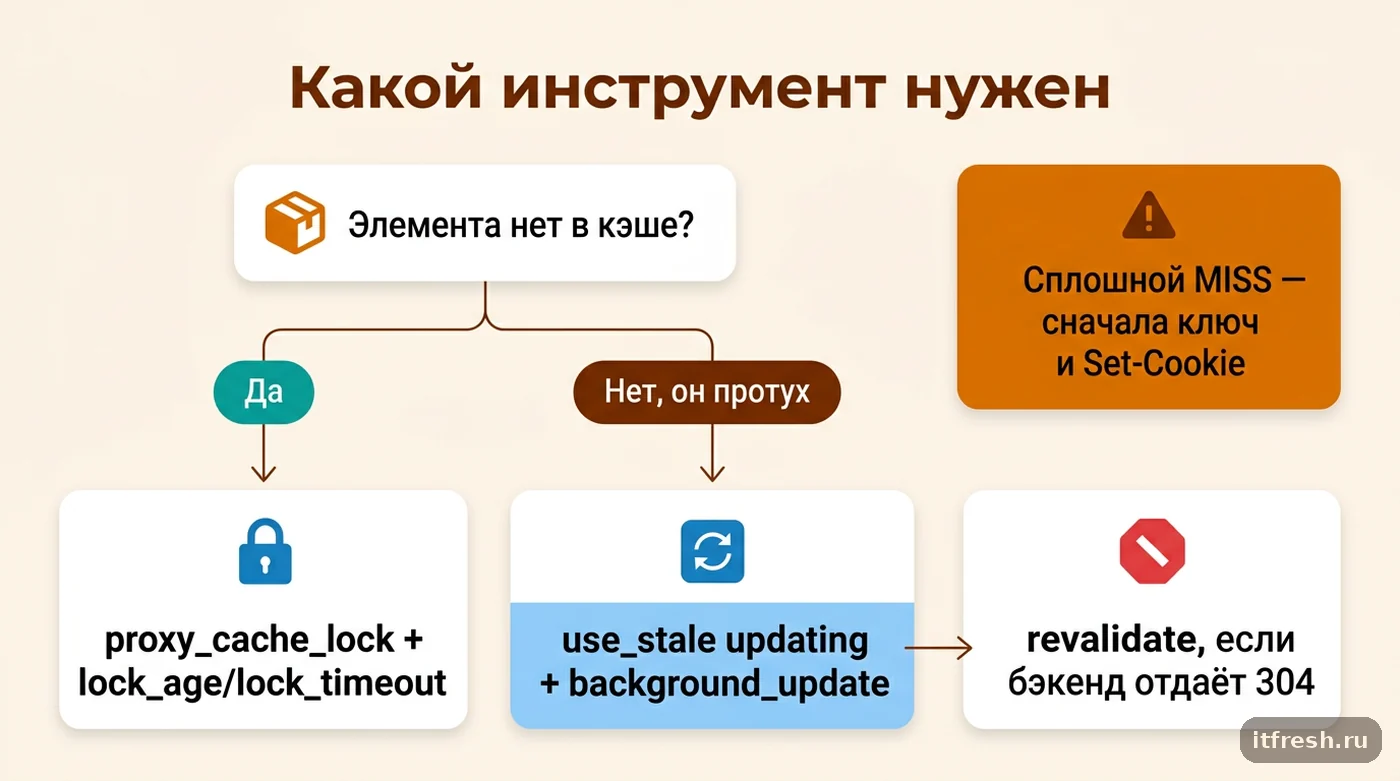
Второе — ответ вообще не кэшируется. Если бэкенд отдаёт Set-Cookie или Cache-Control: no-store, nginx его не сохранит, и блокировать нечего: в логе сплошной MISS без единого HIT. С Set-Cookie на публичных страницах я сталкиваюсь постоянно, это отдельная тема, и начинать надо с неё. Proxy_cache_lock имеет смысл, только когда кэш в принципе наполняется.
Третье — inactive в proxy_cache_path, по умолчанию 10 минут. Данные, к которым не обращались это время, удаляются независимо от свежести. Если proxy_cache_valid 30m, а inactive дефолтный, редкие страницы вылетают раньше, чем протухнут, и каждый раз снова становятся новым элементом. Я ставлю inactive заметно больше самого длинного proxy_cache_valid, а размер ограничиваю через max_size. Четвёртое — proxy_cache_min_uses больше 1: первые обращения по определению не кэшируются. Пятое — несколько фронтов с независимыми кэшами, про это я писал выше.
- разные ключи из-за utm, gclid, сортировок
- ответ не кэшируется из-за Set-Cookie или no-store
- inactive меньше proxy_cache_valid — элементы вымываются
- proxy_cache_min_uses больше 1
- несколько фронтов nginx со своими кэшами
Протухший кэш: proxy_cache_use_stale updating вместо блокировки
Это главный пункт статьи. В документации сказано «populate a new cache element» — заполнить новый элемент. Слово «новый» там не для красоты. Блокировка работает, когда элемента в кэше нет: первый заход после старта, после очистки, после вымывания по inactive. А болит обычно другое: популярная страница протухает по proxy_cache_valid каждые несколько минут, и вся волна уходит на бэкенд. Элемент существует, он просто устарел, и логика блокировки нового элемента к нему не применяется. Люди включили лекарство от другой болезни.
Правильный инструмент для протухших — связка двух директив. proxy_cache_use_stale updating разрешает отдавать устаревший ответ, пока элемент обновляется; документация прямо говорит, что это минимизирует число обращений к проксируемым серверам при обновлении. proxy_cache_background_update on (с 1.11.10) разрешает запустить фоновый подзапрос на обновление, пока клиенту отдаётся устаревшая копия. Важная оговорка из документации: без use_stale updating фоновое обновление не работает. В логе такие ответы видны как UPDATING.
Полезное дополнение — proxy_cache_revalidate on (с 1.5.7): просроченные элементы проверяются условными запросами с If-Modified-Since и If-None-Match. Если приложение умеет отвечать 304, обновление стоит пустого ответа вместо полной перегенерации. Многие фреймворки условные заголовки игнорируют, но проверить стоит — это одна строка. Моя позиция: если выбирать что-то одно, я беру use_stale updating с фоновым обновлением, а блокировку оставляю для холодного старта.
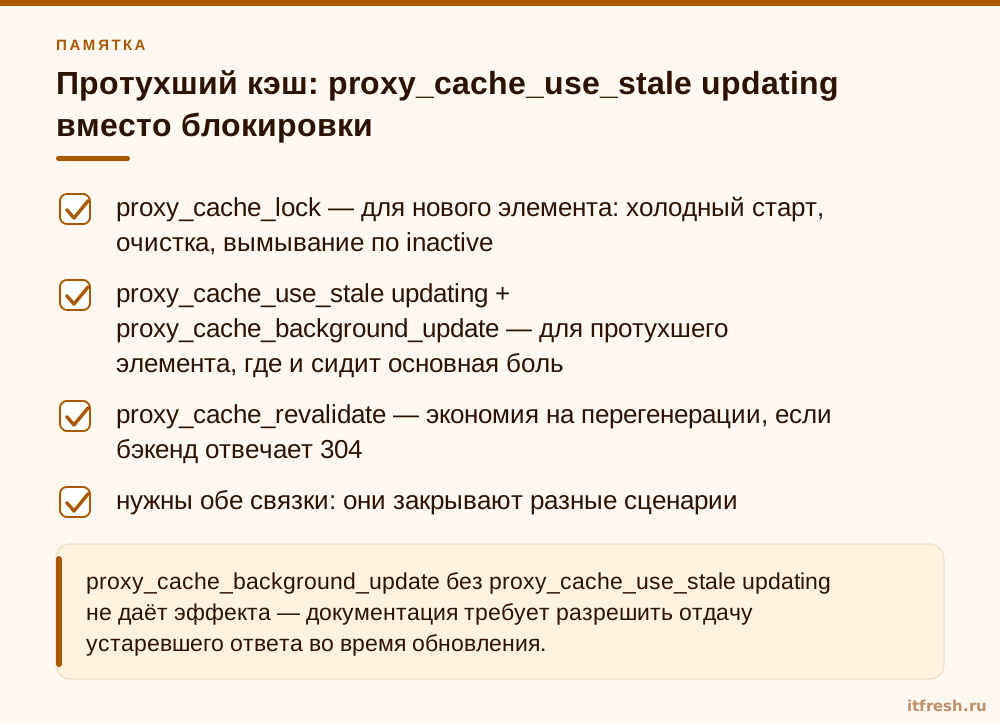
- proxy_cache_lock — для нового элемента: холодный старт, очистка, вымывание по inactive
- proxy_cache_use_stale updating + proxy_cache_background_update — для протухшего элемента, где и сидит основная боль
- proxy_cache_revalidate — экономия на перегенерации, если бэкенд отвечает 304
- нужны обе связки: они закрывают разные сценарии
Какие значения lock_age и lock_timeout ставить: мой конфиг
Базовый блок, с которого я начинаю на фронте перед медленным приложением. Числа взяты из кейса школы, ниже объясняю, как их подбирать под себя. Базовую схему фронта я подробно разбирал в статье про nginx как reverse proxy, здесь только кэш.
map $args $clean_args {
    default $args;
    "~*(^|&)utm_" "";
}

proxy_cache_path /var/cache/nginx/site levels=1:2 keys_zone=site:32m
                 max_size=5g inactive=1d use_temp_path=off;

server {
    location / {
        proxy_pass http://app;
        proxy_cache site;
        proxy_cache_key "$scheme$host$uri$is_args$clean_args";

        proxy_cache_valid 200 5m;
        proxy_cache_valid 404 1m;

        proxy_cache_lock on;
        proxy_cache_lock_age 15s;
        proxy_cache_lock_timeout 20s;
        proxy_read_timeout 30s;

        proxy_cache_use_stale updating error timeout http_500 http_502 http_503 http_504;
        proxy_cache_background_update on;
        proxy_cache_revalidate on;

        add_header X-Cache-Status $upstream_cache_status always;
    }
}
Как подбирать. Берёте p95 холодной генерации самой тяжёлой кэшируемой страницы — у школы это 9 секунд. lock_age ставите заметно выше, у меня 15s: за нормальную генерацию nginx не должен успеть назначить второго заполняющего, но зависший запрос не должен держать элемент вечно. lock_timeout — ещё выше, 20s: ожидающие должны дождаться ответа, а не вылететь на бэкенд за секунду до него. proxy_read_timeout — больше времени генерации с запасом, иначе заполняющий запрос будет обрываться 504-й и страница никогда не попадёт в кэш. map в примере грубый: он выкидывает все аргументы, если среди них есть utm; для страниц с осмысленными параметрами делайте белый список.
Честно про компромисс. Большой lock_timeout — не бесплатное благо. Если бэкенд завис намертво, очередь держит соединения nginx все двадцать секунд, и при большом потоке вы упрётесь в worker_connections. Поэтому большой lock_timeout я ставлю только в паре с proxy_cache_use_stale на ошибки и 5xx: при падении приложения клиент мгновенно получает вчерашнюю страницу, а не ждёт, чтобы увидеть 502. Для совсем тяжёлых страниц есть ещё вариант — прогревать их по cron с самой машины, чтобы новый элемент всегда создавал служебный запрос. И не путайте отдачу stale при ошибке с повторной отправкой запроса на другой сервер группы: это делает proxy_next_upstream, и для неидемпотентных методов там своя ловушка — разбор в статье может ли nginx повторно отправить POST.
- lock_age = p95 холодной генерации + запас (15s при 9s)
- lock_timeout больше lock_age (20s)
- proxy_read_timeout больше времени генерации (30s)
- большой lock_timeout — только вместе с proxy_cache_use_stale на 5xx
- inactive заметно больше самого длинного proxy_cache_valid
Как проверить, что блокировка и кэш работают
На глаз проверять бессмысленно. Сначала добавляю статус кэша в формат лога — без него не отличить MISS от EXPIRED и не понять, какой из двух сценариев у вас работает. Значения $upstream_cache_status по документации ngx_http_upstream_module: MISS, BYPASS, EXPIRED, STALE, UPDATING, REVALIDATED, HIT. После правильной настройки на горячей странице должно быть много HIT, редкие UPDATING и почти нулевой MISS.
log_format cachelog '$remote_addr $status $upstream_cache_status '
                    'rt=$request_time urt=$upstream_response_time "$request"';
access_log /var/log/nginx/cache.log cachelog;
Воспроизвести пачку руками просто. Удаляете элемент из кэша — в открытой версии nginx это удаление файла, имя которого равно MD5 от ключа, разложенного по levels, — и одновременно бьёте по URL пачкой запросов, параллельно считая обращения на бэкенде:
seq 50 | xargs -P 50 -I{} curl -s -o /dev/null \
  -w '%{http_code} %{time_total}\n' https://example.com/raspisanie/

awk '{print $3}' /var/log/nginx/cache.log | tail -n 60 | sort | uniq -c
Ориентир: на пятьдесят параллельных клиентов бэкенд должен получить один запрос при холодном заполнении и один фоновый при обновлении. Если получает два-три — lock_age меньше времени генерации. Если почти пятьдесят — ответ не кэшируется или у запросов разные ключи. Оба случая разбираются по логу за десять минут. Снимайте метрику до и после на одном URL и в одном окне времени, иначе через месяц не докажете ни себе, ни заказчику, что правка что-то дала.
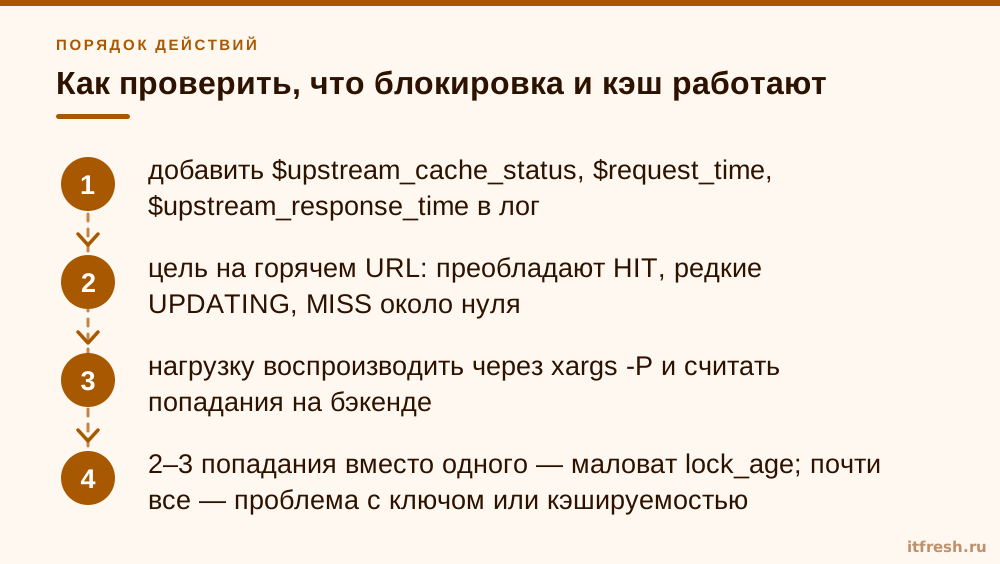
- добавить $upstream_cache_status, $request_time, $upstream_response_time в лог
- цель на горячем URL: преобладают HIT, редкие UPDATING, MISS около нуля
- нагрузку воспроизводить через xargs -P и считать попадания на бэкенде
- 2–3 попадания вместо одного — маловат lock_age; почти все — проблема с ключом или кэшируемостью
Частые вопросы
Отменяет ли nginx предыдущий запрос к бэкенду, когда истекает proxy_cache_lock_age?
Нет. Документация говорит только, что на проксируемый сервер может быть передан ещё один запрос. Первый продолжает выполняться, поэтому при медленной генерации и lock_age 5s на бэкенде оказывается несколько заполняющих запросов.
Попадёт ли в кэш ответ на запрос, выпущенный по proxy_cache_lock_timeout?
Начиная с nginx 1.7.8 — нет: запрос уходит на бэкенд, но ответ не кэшируется. До 1.7.8 такой ответ мог кэшироваться, поэтому старые статьи описывают другое поведение.
Почему proxy_cache_lock не помогает, когда страница протухает каждые несколько минут?
Блокировка относится к заполнению нового элемента кэша, а протухший элемент уже существует. Для него нужны proxy_cache_use_stale updating и proxy_cache_background_update on: клиенту отдаётся устаревшая копия, обновление идёт одним фоновым подзапросом.
Какие значения lock_age и lock_timeout ставить?
От p95 времени холодной генерации самой тяжёлой страницы: lock_age выше этого времени, lock_timeout выше lock_age, proxy_read_timeout больше времени генерации. При генерации около 9 секунд я ставлю 15s, 20s и 30s. Дефолтные 5s подходят только быстрым бэкендам.
Работает ли proxy_cache_lock для PHP-FPM?
Если PHP-FPM подключён через fastcgi_pass — нет. Нужны fastcgi_cache_lock, fastcgi_cache_lock_age и fastcgi_cache_lock_timeout с теми же дефолтами.
Помогает ли блокировка при нескольких серверах nginx?
Только внутри каждого сервера: блокировка живёт в разделяемой памяти зоны кэша конкретного nginx. Три фронта дадут минимум три заполняющих запроса на холодном старте.
Источники
- nginx.org: ngx_http_proxy_module — proxy_cache_lock (off, с 1.1.12, «new cache element»), proxy_cache_lock_age (5s, с 1.7.8), proxy_cache_lock_timeout (5s, «Before 1.7.8, the response could be cached»), proxy_cache_use_stale updating, proxy_cache_background_update (1.11.10), proxy_cache_revalidate (1.5.7), proxy_cache_path inactive: https://nginx.org/en/docs/http/ngx_http_proxy_module.html#proxy_cache_lock
- nginx.org: ngx_http_fastcgi_module — Аналогичные директивы fastcgi_cache_lock, fastcgi_cache_lock_age, fastcgi_cache_lock_timeout: https://nginx.org/en/docs/http/ngx_http_fastcgi_module.html#fastcgi_cache_lock
- nginx.org: ngx_http_upstream_module — Переменная $upstream_cache_status и её значения MISS, BYPASS, EXPIRED, STALE, UPDATING, REVALIDATED, HIT: https://nginx.org/en/docs/http/ngx_http_upstream_module.html#var_upstream_cache_status
- nginx.org: главная страница и новости — Актуальные версии на 23.09.2026: stable 1.30.5 и mainline 1.31.6 от 15.09.2026: https://nginx.org/