
Может ли nginx повторно отправить POST и создать второй заказ
Звонок от клиента: «оплатили один раз, а заказа в базе два». В access.log nginx при этом одна строка и код 200, а в логе приложения — два одинаковых POST с разницей в минуту. Разбираю механику proxy_next_upstream: в каких случаях nginx действительно отправляет уже ушедший на бэкенд POST следующему серверу, что поменялось в версии 1.9.13, зачем люди сами включают non_idempotent и почему настройками фронта проблема дублей не закрывается — закрывается она в приложении.
Заказ задвоился, а в access.log одна строка
Типовая картина, с которой ко мне приходят. Интернет-магазин или личный кабинет, оформление заказа через POST. Пользователь нажал кнопку один раз, у него на экране крутился спиннер, потом всё прошло. А в базе два заказа с разницей в 60–70 секунд, оба с одинаковым составом корзины. Разработчик открывает access.log nginx и не находит там второго запроса: одна строка, статус 200, время обработки 62 секунды. Логично делается вывод «это фронт двойной клик пропустил» или «пользователь F5 нажал». А потом выясняется, что пользователь ничего не нажимал.
Второй запрос сделал сам nginx. И это не баг, а документированное поведение балансировки. Когда вы пишете proxy_pass на upstream-группу, nginx получает право при неудаче с одним сервером повторить запрос на следующем. В документации ngx_http_upstream_module это сформулировано прямо: «If an error occurs during communication with a server, the request will be passed to the next server, and so on until all of the functioning servers will be tried». Управляет этим директива proxy_next_upstream, и её значение по умолчанию — не «off».
Значение по умолчанию: proxy_next_upstream error timeout;. То есть у всех, кто вообще не трогал эту директиву, повторы включены на ошибку соединения и на тайм-аут. При этом в access.log остаётся одна строка на клиентский запрос — nginx пишет лог по факту завершения обработки запроса клиента, а не по числу походов на бэкенд. Именно поэтому проблему так тяжело поймать: следов в дефолтном log_format нет.
Что нужно держать в голове с самого начала — ограничение из той же документации: «passing a request to the next server is only possible if nothing has been sent to a client yet». Если nginx уже начал отдавать клиенту тело ответа и в середине передачи упал бэкенд, никакого повтора не будет, клиент получит обрыв. Повторы живут только в фазе «соединились с бэкендом и ждём заголовки ответа».
- error — ошибка при установке соединения, отправке запроса или чтении заголовка ответа;
- timeout — тайм-аут на тех же трёх стадиях (proxy_connect_timeout / proxy_send_timeout / proxy_read_timeout, все по 60s по умолчанию);
- invalid_header — бэкенд вернул пустой или битый ответ;
- http_500, http_502, http_503, http_504, http_403, http_404, http_429 (последний с 1.11.13) — повторять на конкретных кодах;
- denied — сервер отклонил соединение (появился в 1.29.3, доступен только в коммерческой подписке);
- non_idempotent — разрешить повтор уже отправленных POST, LOCK и PATCH;
- off — полностью запретить переход на следующий сервер.
Что поменялось в 1.9.13 и почему это защита не от всего
До марта 2016 года nginx повторял всё подряд. В релизе 1.9.13 от 29 марта 2016 появилась запись, которую стоит процитировать дословно, потому что вокруг неё много путаницы: «Change: non-idempotent requests (POST, LOCK, PATCH) are no longer passed to the next server by default if a request has been sent to a backend; the "non_idempotent" parameter of the "proxy_next_upstream" directive explicitly allows retrying such requests».
Ключевые слова тут — «if a request has been sent to a backend». Защита срабатывает не по методу как таковому, а по факту отправки. Разложим по стадиям. Соединение не установилось (connection refused, connect timeout, бэкенд перезапускается) — тело ещё никуда не ушло, nginx спокойно уходит на второй сервер, и это абсолютно безопасно, даже для POST. Соединение установилось, запрос ушёл, а заголовков ответа нет дольше proxy_read_timeout — вот тут по умолчанию, начиная с 1.9.13, повтора для POST не будет: nginx отдаст клиенту 504.
Теперь ловушка, о которой почти никто не помнит. В списке защищённых методов ровно три: POST, LOCK, PATCH. PUT и DELETE туда не входят, потому что RFC 9110 (раздел 9.2.2, «Idempotent Methods») относит их к идемпотентным. Формально всё верно. Практически — если у вас REST-API, где PUT /api/v1/invoices создаёт новый документ с автоинкрементным номером, а DELETE /api/v1/holds/{id} снимает резерв склада и пишет движение, то nginx повторит их без всяких non_idempotent и без предупреждений. Идемпотентность метода — это ваше обещание, а не свойство протокола, и nginx верит вам на слово.
И третье: параметр non_idempotent возвращает старое поведение целиком. Его массово растаскивают по конфигам из старых howto в духе «как убрать 502 при деплое» — строка выглядит безобидно, стоит в одном ряду с http_502 и http_504, и на код-ревью её пропускают. Вот такой конфиг я вижу у клиентов регулярно:
- нет соединения с бэкендом → повтор POST происходит и он безопасен;
- запрос ушёл, ответа нет → повтора POST по умолчанию нет (с 1.9.13);
- PUT и DELETE повторяются и после отправки на бэкенд, если сработало условие из proxy_next_upstream;
- non_idempotent явно разрешает повторять уже отправленные POST, LOCK, PATCH;
- если nginx начал отдавать ответ клиенту — повтор невозможен в любом случае.
Разбор: «Ягдташ и ружьё», дубли заказов раз в две недели
Охотничий магазин «Ягдташ и ружьё»: 21 рабочее место, розница плюс интернет-витрина снаряжения, одежды и оптики на PHP 8.3. Схема — два сервера приложения (на каждом свой nginx с php-fpm, слушают HTTP на 8080) за общим фронтом nginx 1.31.4. Жалоба: примерно раз в две-три недели в CRM прилетает задвоенный заказ, всегда в вечернее окно, когда идёт выгрузка прайсов поставщиков. Внутренний разработчик к этому моменту уже полгода — в свободное от 1С время — искал двойной submit в JavaScript и даже навесил блокировку кнопки — не помогло, что логично.
Конфиг фронта на момент разбора выглядел так (сокращаю до сути):
upstream app {
    server 10.20.0.11:8080 max_fails=2 fail_timeout=15s;
    server 10.20.0.12:8080 max_fails=2 fail_timeout=15s;
}

location / {
    proxy_pass http://app;
    proxy_next_upstream error timeout http_502 http_504 non_idempotent;
    proxy_connect_timeout 60s;
    proxy_read_timeout 60s;
}
non_idempotent приехал сюда в 2021 году вместе с чужим сниппетом «нулевой даунтайм при деплое». Автора конфига в компании давно нет.
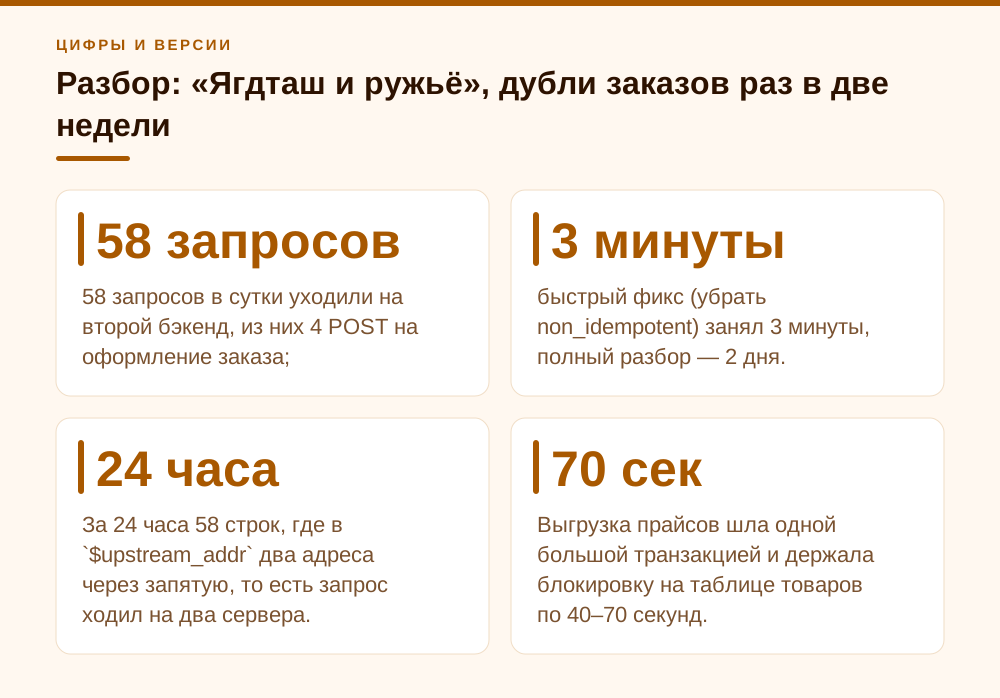
Первым делом я переписал log_format и добавил в него $upstream_addr, $upstream_status и $upstream_response_time — три переменные, одна перезагрузка, ноль риска. Через сутки картина стала видна. За 24 часа 58 строк, где в $upstream_addr два адреса через запятую, то есть запрос ходил на два сервера. Из них 4 — метод POST на /checkout/confirm. Ещё 3 — PUT на внутренний API остатков. Сверка с логом приложения по времени и телу запроса: из этих четырёх POST три создали по два заказа, а один упал на уникальном индексе, который разработчик поставил год назад «на всякий случай» и уже забыл про него. Тот индекс всё это время был единственной защитой.
Дальше — почему вообще возникал тайм-аут. Бэкенд не падал. Выгрузка прайсов шла одной большой транзакцией и держала блокировку на таблице товаров по 40–70 секунд. Оформление заказа упиралось в эту блокировку, вылезало за proxy_read_timeout 60s, nginx фиксировал timeout и — благодаря non_idempotent — уходил с тем же POST на второй сервер приложения. Второй ждал ту же блокировку, но она к тому моменту уже снималась, и он отрабатывал за пару секунд. При этом первый бэкенд никто не останавливал: он дожидался блокировки, спокойно дописывал заказ в базу и отдавал ответ в сокет, который nginx уже не слушал. Отсюда и характерная сигнатура в логе: urt="60.003, 2.187" и ust="504, 200".
Что сделали и в каком порядке. Первым же reload убрали non_idempotent — три минуты работы, дубли прекратились в тот же вечер. Затем для /checkout/ и /api/payments/ выставили proxy_next_upstream off;, чтобы туда не залезли ни PUT, ни будущие правки. Третьим шагом разбили выгрузку прайсов на батчи по 500 строк — блокировки упали с 40–70 секунд до 1–3, то есть исчезла первопричина, а не только симптом. И последним, уже спокойно, добавили в приложение обработку заголовка Idempotency-Key поверх существующего уникального индекса. Четыре месяца наблюдения: дублей ноль. Строки с двумя адресами в $upstream_addr остались — 5–15 в сутки, но это GET и HEAD во время ночных релизов, ровно то, ради чего механизм и придуман.
- 58 запросов в сутки уходили на второй бэкенд, из них 4 POST на оформление заказа;
- 3 из 4 создали дубль, 1 спас случайный уникальный индекс в базе;
- корень проблемы — не nginx, а блокировка в СУБД на 40–70 секунд при импорте прайсов;
- быстрый фикс (убрать non_idempotent) занял 3 минуты, полный разбор — 2 дня.
Как за десять минут доказать, что повтор был
Пока в логе нет $upstream_addr, любой разговор о повторах — гадание. Добавляется одной строкой, применяется через nginx -t && nginx -s reload, ничего не ломает, объём лога растёт процентов на пятнадцать. Мой рабочий формат:
log_format ups '$time_iso8601 $remote_addr "$request" $status '
               'ups="$upstream_addr" ust="$upstream_status" '
               'urt="$upstream_response_time" uct="$upstream_connect_time" '
               'rt=$request_time bs=$body_bytes_sent';

access_log /var/log/nginx/access.log ups;
Правило чтения простое, и оно прямо описано в документации переменных. Если в $upstream_addr несколько адресов через запятую — nginx обращался к нескольким серверам в рамках одной группы, то есть был переход на следующий сервер. Если адреса разделены двоеточием — это внутренний редирект между разными группами, инициированный X-Accel-Redirect или error_page, и это совсем другая история. Переменные $upstream_status, $upstream_response_time, $upstream_connect_time и $upstream_bytes_sent разделяются точно так же и читаются попарно с адресами.
Дальше вычленяем интересное. Меня интересуют только небезопасные методы с несколькими адресами:
# сколько всего запросов ушло больше чем на один бэкенд
grep -cE 'ups="[^"]+,' /var/log/nginx/access.log

# из них — только изменяющие данные методы
grep -E 'ups="[^"]+,' /var/log/nginx/access.log \
  | grep -E '"(POST|PUT|PATCH|DELETE|LOCK) ' \
  | awk '{print $2, $3, $4}' | sort | uniq -c | sort -rn | head -20
Что считать доказательством. Сигнатура ust="504, 200" вместе с urt="60.001, 1.9" означает: первый бэкенд не ответил ровно за тайм-аут, второй ответил успешно. Это худший случай — первый почти наверняка операцию выполнил, просто его ответ уже некому было принять. Сигнатура uct="0.001, 0.001" при ust="502, 200" чаще всего безобидна: 502 на мгновенном коннекте — это обычно бэкенд, который перезапускается, и запрос до него не дошёл. Окончательный вердикт всё равно даёт сверка с логом приложения: берёте метку времени из nginx и ищете в приложении два вызова обработчика с одинаковым телом внутри окна тайм-аута.
- запятая в $upstream_addr = переход на следующий сервер группы;
- двоеточие = внутренний редирект в другую группу (X-Accel-Redirect / error_page), не повтор;
- ust="504, 200" на POST — считайте, что операция выполнилась дважды, пока не доказали обратное;
- ust="502, 200" при почти нулевом uct — обычно перезапуск бэкенда, запрос не дошёл;
- если $upstream_addr в логе нет вообще — вы слепые, начните с этого.
Как я настраиваю фронт перед приложением, где есть деньги
Сразу обозначу позицию, потому что советы «выключите ретраи везде» встречаются часто и они плохие. Повторы — полезный механизм. Именно они дают выкатывать релиз без 502 в лицо пользователю: пока один сервер приложения перезапускается, запросы уходят на второй. Выключать их глобально означает менять редкую проблему дублей на ежедневную проблему ошибок при деплое. Я разделяю поведение по локейшенам: там, где читают, — повторы разрешены; там, где меняют состояние и деньги, — запрещены.
Базовый скелет, который я раскатываю:
upstream app {
    server 10.20.0.11:8080 max_fails=2 fail_timeout=15s;
    server 10.20.0.12:8080 max_fails=2 fail_timeout=15s;
    keepalive 32;
}

# общий дефолт: повторяем только на error и timeout, без non_idempotent
proxy_next_upstream         error timeout;
proxy_next_upstream_tries   2;
proxy_next_upstream_timeout 10s;
proxy_connect_timeout       3s;
proxy_read_timeout          60s;

location /api/payments/ {
    proxy_pass http://app;
    proxy_next_upstream off;
    proxy_read_timeout  120s;
}

location /checkout/ {
    proxy_pass http://app;
    proxy_next_upstream off;
}
Почему proxy_connect_timeout 3s, а не дефолтные 60. Установка соединения — единственная стадия, на которой повтор гарантированно безопасен: запрос ещё не ушёл. Значит, я хочу узнавать о неудаче на этой стадии быстро, за секунды, а не через минуту. Во внутренней сети три секунды на TCP-коннект — это очень много, и если не уложились, сервер точно нездоров. А proxy_next_upstream_tries 2 (директива есть с 1.7.5) ограничивает общее число попыток. Без неё nginx честно обойдёт всю группу: при восьми бэкендах один клиентский запрос превращается в восемь запросов к приложению, и во время массовой деградации это добивает то, что ещё живо. Дефолт 0 означает «без ограничения».
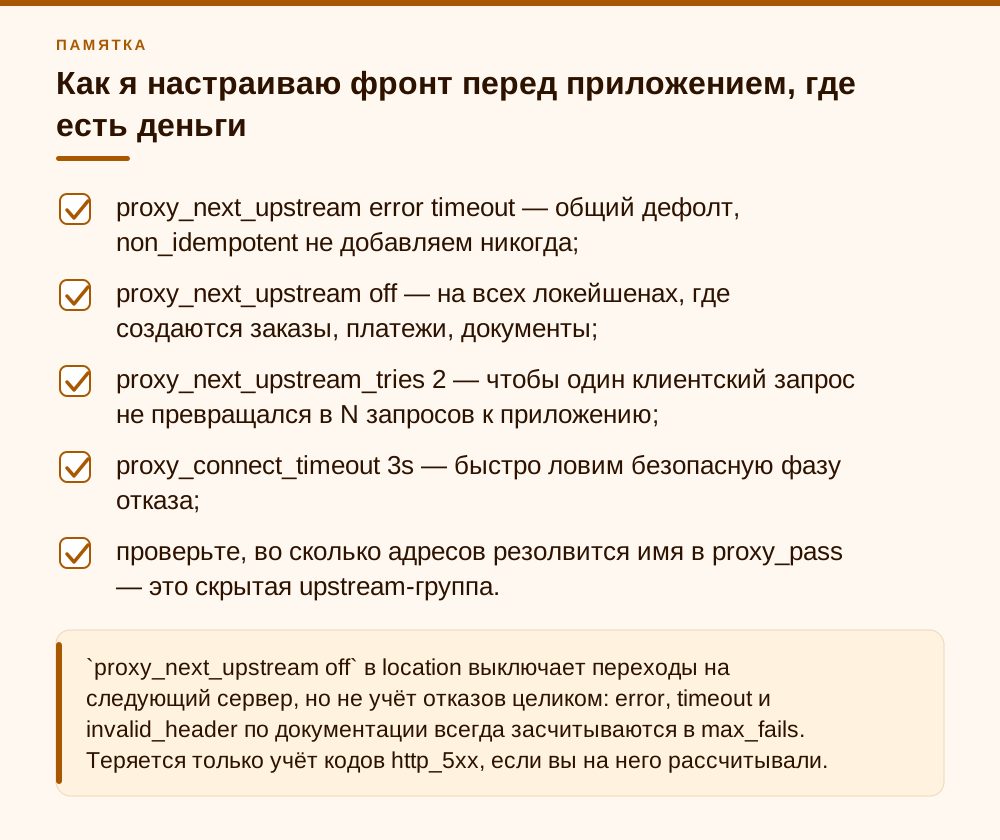
Два нюанса, на которых спотыкаются. Первый: что считается неуспешной попыткой для max_fails, определяется той же директивой proxy_next_upstream, но с оговоркой из документации: случаи error, timeout, denied и invalid_header считаются неудачными попытками всегда, даже если в директиве не указаны, а http_500, http_502, http_503, http_504 и http_429 — только если перечислены. Поэтому off в платёжном локейшене не ломает пассивную проверку здоровья по обрывам и тайм-аутам: сервер, который перестал отвечать, всё равно выпадет из ротации. Перестанут учитываться только ответы 5xx, если раньше они были в списке. Второй нюанс свежий: начиная с версии 1.29.7 кэш keepalive-соединений к бэкендам включён по умолчанию (keepalive 32 local;), ngx_http_proxy_module по умолчанию работает по HTTP/1.1 (proxy_http_version 1.1) и не отправляет заголовок Connection; в документации отдельно сказано, что закэшированные по умолчанию соединения не используются совместно разными location. После обновления с более старых веток поведение конфига меняется само собой — стоит перечитать раздел про keepalive перед апгрейдом, а не после.
И ловушка, которая ломает логику «у меня один бэкенд, ретраев быть не может». Если в proxy_pass указано доменное имя, документация говорит: «If a domain name resolves to several addresses, all of them will be used in a round-robin fashion». Две A-записи на внутреннем DNS или на сервисе в Kubernetes — и у вас появилась upstream-группа, которую вы не описывали, со всеми вытекающими повторами.
- proxy_next_upstream error timeout — общий дефолт, non_idempotent не добавляем никогда;
- proxy_next_upstream off — на всех локейшенах, где создаются заказы, платежи, документы;
- proxy_next_upstream_tries 2 — чтобы один клиентский запрос не превращался в N запросов к приложению;
- proxy_connect_timeout 3s — быстро ловим безопасную фазу отказа;
- проверьте, во сколько адресов резолвится имя в proxy_pass — это скрытая upstream-группа.
Конфиг nginx — это страховка, а защита живёт в приложении
Даже если вы выключите повторы полностью, второй одинаковый POST всё равно прилетит — просто из другого источника. Пользователь нажмёт F5 на зависшей странице. Мобильное приложение с политикой ретраев по умолчанию перепошлёт запрос при обрыве сети. Ваш собственный фронтенд с axios-retry сделает то же самое. CDN или WAF перед nginx повторит по своим правилам. Платёжный шлюз будет долбить вебхук, пока не получит 200, — это вообще норма индустрии. RFC 9110 в разделе 9.2.2 прямо описывает автоматический повтор при обрыве соединения до получения ответа как штатное поведение клиента. Спорить с этим бессмысленно, надо просто быть к этому готовым.
Правильный ответ — сделать обработчик идемпотентным. Практическая схема, которую я советую и которая нигде не требует героизма: клиент генерирует UUID в момент открытия формы (не в момент отправки!), кладёт его в заголовок Idempotency-Key, сервер в той же транзакции, что и сам заказ, вставляет ключ в отдельную таблицу с UNIQUE-индексом. Пришёл повтор с тем же ключом — отдаём сохранённый ответ первой попытки и не создаём ничего нового. Хранить ключи вечно не нужно, 24 часа с запасом перекрывают любые ретраи.
Здесь надо быть честным: единого стандарта на это до сих пор нет. Черновик IETF draft-ietf-httpapi-idempotency-key-header дошёл до седьмой версии (октябрь 2025), в RFC на сентябрь 2026 не превратился, срок действия черновика истёк. Заголовок называется одинаково у Stripe, PayPal и десятка других платёжных провайдеров, но детали — время жизни ключа, что возвращать при конфликте, что делать, если пришёл тот же ключ с другим телом, — каждый решает сам. Это не повод не делать. Это повод описать поведение в собственном API-контракте и не рассчитывать, что чужой клиент угадает вашу семантику.
Если до полноценных ключей идемпотентности руки не дойдут в ближайший квартал — сделайте дешёвый вариант прямо сегодня. Уникальный индекс на естественный бизнес-ключ: пользователь плюс хэш состава корзины плюс округлённая до минуты метка времени. Ловите ошибку нарушения уникальности и возвращайте существующий заказ вместо ошибки. Полчаса работы, закрывает подавляющее большинство реальных случаев. Ровно эта конструкция в «Ягдташе и ружье» гасила четверть дублей ещё до того, как кто-то вообще заподозрил nginx. А вот на чём экономить точно можно: не надо строить распределённую дедупликацию с блокировками в Redis и хитрым TTL, если у вас триста заказов в сутки. Уникальный индекс в вашей же СУБД надёжнее и понятнее.
- минимум за полчаса: UNIQUE-индекс на бизнес-ключ + обработка нарушения уникальности;
- правильно: заголовок Idempotency-Key, ключ пишется в одной транзакции с операцией, TTL 24 часа;
- UUID генерируется при открытии формы, а не при отправке — иначе ретрай принесёт новый ключ;
- для входящих вебхуков платёжных систем идемпотентность обязательна: они повторяют по своим правилам;
- избыточно для малого потока: распределённые локи, отдельное хранилище дедупликации.
Порядок действий: что сделать сегодня, а что можно отложить
Порядок важен, потому что три первых пункта дают почти весь эффект и занимают меньше часа, а остальное — нормальная плановая работа. Не начинайте с переписывания приложения: сначала уберите то, что явно стреляет, потом получите данные, и только потом чините архитектуру.
Отдельно про то, чего делать не надо. Не выключайте повторы глобально одной строкой proxy_next_upstream off; в http-секции — потеряете бесшовный деплой и получите 502 на каждом релизе. Не накручивайте proxy_read_timeout до 300–600 секунд в надежде, что тайм-аут перестанет наступать: вы просто удлините окно, в котором висят соединения, и в час пик упрётесь в worker_connections. Тайм-аут — это симптом; если бэкенд отвечает дольше минуты, чинить надо бэкенд.
И последнее наблюдение из практики, которое экономит много времени. Почти во всех разобранных мной случаях дублей корень был не в nginx: длинная блокировка в СУБД, синхронный поход во внешний API без тайм-аута, отчёт, который строится в том же процессе, что и оформление заказа. nginx лишь превращал редкую медленную операцию в удвоенную. Убрав non_idempotent, вы перестанете плодить дубли — но исходная проблема «оформление заказа иногда занимает больше минуты» останется, и её тоже надо закрывать.
- 1. `grep -rn non_idempotent /etc/nginx/` — найти и убрать, если никто не может объяснить, зачем оно там;
- 2. добавить $upstream_addr, $upstream_status, $upstream_response_time в log_format и сделать reload;
- 3. через сутки посчитать, сколько небезопасных методов реально ушло на второй бэкенд;
- 4. закрыть `proxy_next_upstream off` локейшены с заказами, платежами и документами;
- 5. выставить proxy_next_upstream_tries и снизить proxy_connect_timeout;
- 6. проверить, не резолвится ли имя в proxy_pass в несколько адресов;
- 7. добавить уникальный индекс на бизнес-ключ в приложении;
- 8. разобраться, почему бэкенд вообще отвечает дольше тайм-аута — это и есть настоящая задача.
Частые вопросы
Может ли nginx с настройками по умолчанию выполнить мой POST дважды?
Может, но не в том сценарии, о котором обычно думают. С версии 1.9.13 уже отправленный на бэкенд POST по умолчанию следующему серверу не передаётся. Остаются три пути: запрос не успел уйти (не установилось соединение) — тогда повтор безопасен; в конфиге явно стоит non_idempotent; метод не POST/LOCK/PATCH, а PUT или DELETE — их nginx считает идемпотентными и повторяет даже после отправки, если сработало условие из proxy_next_upstream.
Как по логу понять, что запрос уходил на два бэкенда?
Добавьте в log_format переменную $upstream_addr. Если в ней несколько адресов через запятую — nginx обращался к нескольким серверам одной группы, то есть был переход на следующий сервер. Двоеточие вместо запятой означает другое: внутренний редирект между разными upstream-группами через X-Accel-Redirect или error_page. Одновременно смотрите $upstream_status и $upstream_response_time — они разбиваются теми же разделителями.
Не проще ли выключить повторы глобально через proxy_next_upstream off?
Не проще. Вы потеряете бесшовный деплой: пока один бэкенд перезапускается, клиенты будут получать 502 вместо тихого ухода на второй сервер. Учёт отказов для max_fails при этом не пропадает: error, timeout и invalid_header засчитываются всегда, а вот коды 5xx — только если перечислены в директиве. Правильнее выключать точечно — на локейшенах с заказами, платежами и созданием документов.
Что делает proxy_next_upstream_tries 1?
Ограничивает общее число попыток одной, то есть повторов не будет вовсе. Директива появилась в 1.7.5, значение по умолчанию 0 — без ограничения, и тогда nginx обойдёт все живые серверы группы. Я обычно ставлю 2: этого достаточно, чтобы пережить перезапуск одного бэкенда, и при этом один клиентский запрос не превращается в восемь запросов к приложению во время массовой деградации.
Влияет ли proxy_request_buffering off на повторы?
Влияет, и в безопасную сторону. В документации сказано прямо: при выключенной буферизации тела запрос нельзя передать следующему серверу, если nginx уже начал отправлять тело бэкенду. То есть отключение буферизации само по себе гасит часть повторов — но полагаться на это как на защиту не стоит, у этого режима свои последствия для загрузок и тайм-аутов.
У меня один бэкенд в proxy_pass, повторы мне не грозят?
Грозят, если в proxy_pass указано доменное имя. Документация nginx говорит: если имя резолвится в несколько адресов, все они используются по кругу. Две A-записи во внутреннем DNS или сервис в Kubernetes с несколькими подами — и у вас фактически есть upstream-группа, которую вы не описывали, со всеми правилами перехода на следующий сервер.
Источники
- nginx: ngx_http_proxy_module — proxy_next_upstream — Официальная документация nginx, модуль ngx_http_proxy_module, директивы proxy_next_upstream (default: error timeout; параметр non_idempotent — с 1.9.13, denied — с 1.29.3, коммерческая подписка, http_429 — с 1.11.13), proxy_next_upstream_tries и proxy_next_upstream_timeout (обе с 1.7.5), proxy_request_buffering (с 1.7.11). https://nginx.org/ru/docs/http/ngx_http_proxy_module.html#proxy_next_upstream Там же: error, timeout, denied и invalid_header всегда считаются неудачными попытками.
- nginx CHANGES — запись о версии 1.9.13 от 29.03.2016 — Файл изменений nginx: «Change: non-idempotent requests (POST, LOCK, PATCH) are no longer passed to the next server by default if a request has been sent to a backend; the "non_idempotent" parameter of the "proxy_next_upstream" directive explicitly allows retrying such requests». Там же — Bugfix: при ошибке в закэшированном соединении с бэкендом запрос передавался следующему серверу независимо от proxy_next_upstream. Запись 1.29.7: keepalive в upstream включён по умолчанию, proxy_http_version по умолчанию 1.1. https://nginx.org/en/CHANGES
- nginx: ngx_http_upstream_module — Документация модуля балансировки: параметры server (max_fails=1, fail_timeout=10s), определение неуспешной попытки через *_next_upstream, директива keepalive (с 1.29.7 значение по умолчанию — keepalive 32 local), встроенные переменные $upstream_addr, $upstream_status, $upstream_response_time, $upstream_connect_time и правило разделения значений запятыми и двоеточиями. https://nginx.org/ru/docs/http/ngx_http_upstream_module.html
- RFC 9110 «HTTP Semantics», раздел 9.2.2 Idempotent Methods — Определение идемпотентных методов (PUT, DELETE и безопасные методы) и допустимость автоматического повтора запроса клиентом при обрыве соединения до получения ответа. https://www.rfc-editor.org/rfc/rfc9110.html#name-idempotent-methods
- IETF draft-ietf-httpapi-idempotency-key-header — Черновик заголовка Idempotency-Key для придания отказоустойчивости неидемпотентным методам. Версия 07 от 15.10.2025, статус на сентябрь 2026 — истёкший Internet-Draft, в RFC не опубликован. https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/
- nginx: ngx_http_log_module — log_format и access_log — Официальная документация модуля журналирования: синтаксис log_format, формат combined по умолчанию, использование переменных в формате и перезапись access_log. https://nginx.org/ru/docs/http/ngx_http_log_module.html