
Почему limit_req замедлил страницу и начал отдавать 503
После включения `limit_req` сайт может выглядеть так, будто не справляется приложение: страница открывается рывками, API отвечает через секунду-другую, в журнале появляются 503. Но процессор свободен, база не перегружена, а upstream работает как раньше. Я, Семёнов Евгений Сергеевич, обычно начинаю проверку не с PHP или базы, а с математики самого ограничителя. В этой статье покажу, почему средняя частота запросов — не то же самое, что допустимый всплеск, как `burst` превращается в очередь и почему для интерактивного веб-интерфейса я почти всегда выбираю `nodelay`.
Откуда берётся медленная загрузка при свободном сервере
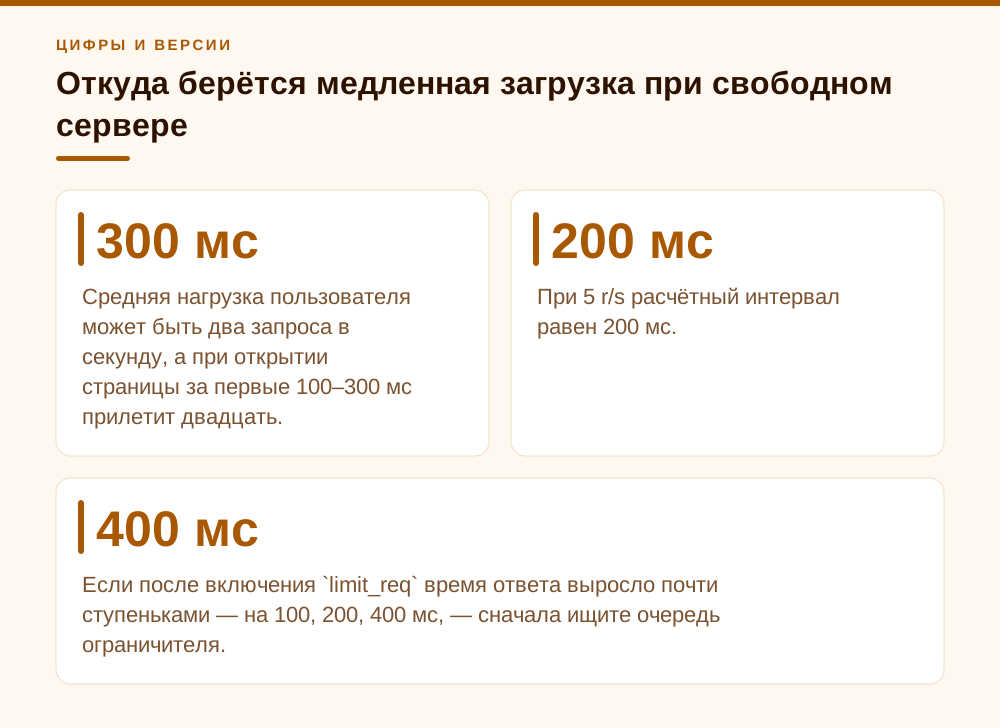
Браузер не загружает страницу одним запросом. Даже сравнительно простой интерфейс получает HTML, стили, JavaScript, шрифты, изображения, данные пользователя, уведомления и справочники. HTTP/2 позволяет отправить эти запросы параллельно, но для limit_req они всё равно остаются отдельными запросами. Если ограничитель установлен в общем location /, под него попадает весь веер. Средняя нагрузка пользователя может быть два запроса в секунду, а при открытии страницы за первые 100–300 мс прилетит двадцать.
Самая частая ошибка, которую я вижу: администратор смотрит на среднее значение в мониторинге, видит 3 r/s с одного адреса и задаёт rate=5r/s. Кажется, что запас есть. На самом деле rate задаёт скорость, с которой nginx будет освобождать накопившийся избыток. При 5 r/s расчётный интервал равен 200 мс. Несколько запросов, пришедших почти одновременно, сразу становятся избыточными, хотя минутное среднее осталось низким.
Без параметра nodelay nginx задерживает избыточные запросы внутри допустимого burst. При rate=5r/s и burst=10 крайний запрос в заполненной очереди может ждать около двух секунд. Когда очередь уже занята, следующий избыток отклоняется. По умолчанию limit_req_status равен 503 — отсюда совершенно правдоподобная картина «медленный сервер иногда падает», хотя upstream этих запросов даже не видел.
- `rate` — скорость восстановления лимита, а не разрешение отправить столько запросов одновременно.
- `burst` — вместимость допустимого краткого избытка, а не дополнительное количество запросов в секунду.
- Без `nodelay` избыток внутри `burst` задерживается; сверх `burst` — отклоняется.
- HTTP/2 не объединяет обращения к разным ресурсам в один запрос для ограничителя.
Как я читаю rate, burst, nodelay и delay
Я мысленно представляю не счётчик «запросов за секунду», а протекающее ведро. rate=10r/s означает, что накопленный избыток убывает примерно со скоростью десять запросов в секунду. burst=20 разрешает временно накопить до двадцати избыточных запросов. Если nodelay не указан, nginx растянет их обработку по времени. Если указан, допустимый всплеск пройдёт сразу, но занятое место в ведре не исчезнет: оно будет освобождаться с заданным rate, а новый ранний всплеск может получить отказ.
Именно здесь nodelay часто понимают неверно. Он не выключает ограничение и не превращает rate=10r/s burst=20 в постоянные 30 r/s. Он убирает искусственное ожидание для запросов, которые ещё помещаются в burst. Для пользовательского интерфейса я считаю это правильным поведением: нормальный короткий веер пропускаем быстро, а действительно лишнее отклоняем явно. Медленно выполнять легитимный запрос обычно хуже, чем быстро вернуть управляемый 429 клиенту, умеющему повторить операцию.
Параметр delay=N появился в nginx 1.15.7 и взаимоисключающе заменяет nodelay. По документации значение по умолчанию равно нулю, то есть задерживаются все избыточные запросы. Он даёт промежуточный режим: первые N избыточных запросов не задерживаются, последующие внутри burst ставятся на расписание. Режим полезен для фоновой выгрузки или интеграции, которой допустимо подождать. В браузерном API я его применяю редко. Скрытая очередь увеличивает время жизни соединений, портит пользовательские таймауты и маскирует недостаточную пропускную способность upstream.
- Для медленного действия можно задать `10r/m`: значения ниже одного запроса в секунду официально выражаются через `r/m`.
- По документации максимальный размер всплеска по умолчанию равен нулю: без `burst` любой запрос, пришедший раньше расчётного интервала (при `5r/s` — раньше 200 мс после предыдущего), сразу завершается кодом из `limit_req_status`, по умолчанию 503.
- При нескольких директивах `limit_req` запрос должен пройти каждый применённый ограничитель.
- Директивы наследуются с верхнего уровня только тогда, когда на текущем уровне нет собственных `limit_req`.
- `delay=N` и `nodelay` в одной директиве не сочетаются: синтаксис допускает `[nodelay | delay=число]`.
Что случилось в «ТрастЛайн»
«ТрастЛайн» — трастовая компания на 43 рабочих места; название условное, данные обезличены. Сотрудники центрального офиса (29 мест) и отдела доверительного управления в соседнем здании (14 мест) работали с внутренним порталом клиентских договоров и отчётности, выходя в него через два публичных NAT-адреса — по одному на площадку. На входе стоял nginx 1.30.4 stable из репозитория nginx.org на Ubuntu Server 24.04 LTS, виртуальная машина с 2 vCPU и 4 ГБ RAM. За ним работали два экземпляра приложения на PHP 8.3. Пиковая входящая нагрузка была около 60 r/s, загрузка CPU nginx не превышала 15 %. Для такого потока железо здесь вообще не было проблемой.
Стартовая страница делала 23 обращения: HTML, восемь статических ресурсов и четырнадцать запросов API. В понедельник утром управляющие портфелями и операционисты почти одновременно открывали рабочий день: сверка остатков, очередь поручений клиентов, уведомления. До ограничения p95 времени запроса составлял 310 мс. После изменения p95 вырос до 2,1 секунды, а 5,8 % запросов получили 503. При этом p95 $upstream_response_time для дошедших запросов остался около 240 мс. Это был сильный признак того, что задержку создаёт nginx до обращения к приложению.
Проблемный фрагмент выглядел безобидно, поэтому его сначала и не заподозрили:
http {
    limit_req_zone $binary_remote_addr zone=per_ip:10m rate=5r/s;

    server {
        listen 443 ssl;
        server_name portal.trustline.example;

        location / {
            limit_req zone=per_ip burst=10;
            proxy_pass http://app_backend;
        }
    }
}
Лимит применили ко всему порталу, nodelay не указали, а ключом сделали внешний адрес. Получилось сразу три наложившихся дефекта: один человек создавал короткий веер, все 29 сотрудников офиса делили одно ведро, а разрешённый избыток nginx выдавал порциями по одному запросу каждые 200 мс.
- 23 запроса на первое открытие страницы.
- До изменения: p95 — 310 мс.
- После включения лимита: p95 — 2,1 с; 503 — 5,8 %.
- Upstream не замедлился, CPU и память оставались с запасом.
Как отличить limit_req от тормозящего upstream
Первым делом я добавляю $limit_req_status в отдельный формат access log. Переменная появилась в nginx 1.17.6 и принимает значения PASSED, DELAYED, REJECTED, а в режиме наблюдения — DELAYED_DRY_RUN и REJECTED_DRY_RUN. Одновременно пишу $request_time и $upstream_response_time. Если запрос отклонён до проксирования, upstream-время обычно будет -. Если он задержан ограничителем, общее время вырастет, хотя время upstream останется нормальным.
Конфигурация диагностики у нас была такой:
log_format limits escape=json
    '{"time":"$time_iso8601","ip":"$remote_addr",'
    '"request":"$request","status":$status,'
    '"rt":$request_time,"urt":"$upstream_response_time",'
    '"limit":"$limit_req_status"}';

access_log /var/log/nginx/portal_limit.log limits;
limit_req_log_level notice;
После изменения я обязательно выполняю nginx -t, затем штатную перезагрузку systemctl reload nginx. В error log сообщения о задержке имеют уровень на одну ступень ниже настроенного уровня отказов, поэтому слепо искать только строки уровня error недостаточно.
Для первого включения есть безопасный режим limit_req_dry_run on, присутствующий с nginx 1.17.1. Он ведёт состояние зоны и отмечает запросы, которые были бы задержаны или отклонены, но скорость запросов фактически не ограничивает. Я держу его хотя бы один полный рабочий цикл, включая утренний вход и закрытие операционного дня. Затем сравниваю распределение по URI, ключам и времени. Среднесуточный график здесь бесполезен: интересуют интервалы в секунды и доли секунды.
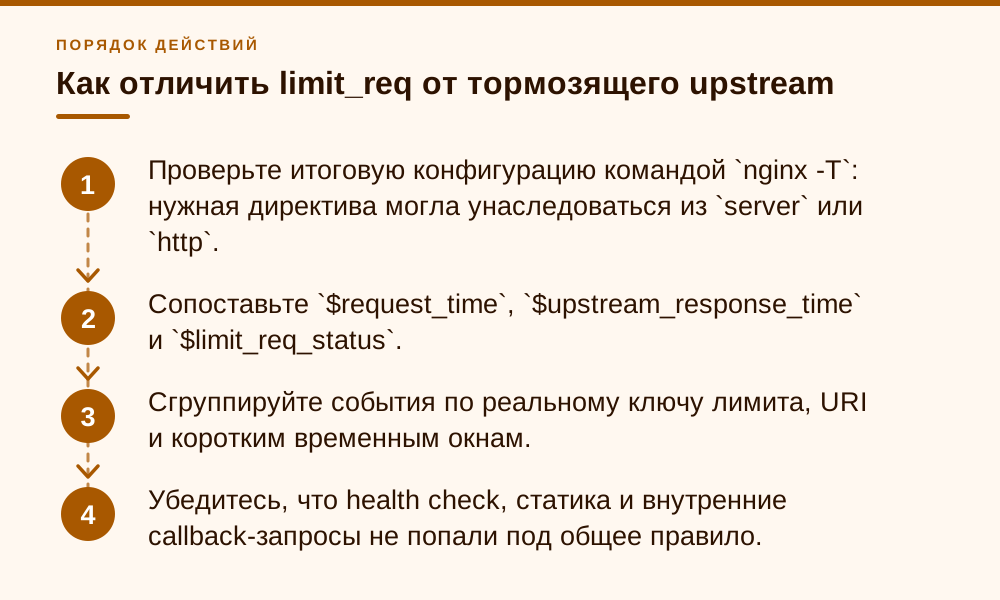
- Проверьте итоговую конфигурацию командой `nginx -T`: нужная директива могла унаследоваться из `server` или `http`.
- Сопоставьте `$request_time`, `$upstream_response_time` и `$limit_req_status`.
- Сгруппируйте события по реальному ключу лимита, URI и коротким временным окнам.
- Убедитесь, что health check, статика и внутренние callback-запросы не попали под общее правило.
Конфигурация, которую я выбираю для интерактивного портала
Я не ограничиваю весь location /. Статику и обычный HTML оставляю в покое, а правила ставлю на дорогие или атакуемые маршруты. Для входа нужен строгий лимит, для API — достаточно широкий легитимный всплеск, плюс общий предохранитель на виртуальный сервер. В пользовательском трафике использую nodelay и меняю код отказа на 429. Это не делает систему неуязвимой для DDoS, но защищает приложение от грубых всплесков без искусственного замедления штатной страницы.
Итоговый сокращённый конфиг для проекта выглядел так:
http {
    log_format limits escape=json
        '{"time":"$time_iso8601","ip":"$remote_addr",'
        '"request":"$request","status":$status,'
        '"rt":$request_time,"urt":"$upstream_response_time",'
        '"limit":"$limit_req_status"}';

    limit_req_zone $binary_remote_addr zone=auth_per_ip:10m rate=10r/m;
    limit_req_zone $binary_remote_addr zone=api_per_ip:20m rate=30r/s;
    limit_req_zone $server_name zone=api_total:10m rate=300r/s;

    upstream app_backend {
        server 10.20.0.21:8080;
        server 10.20.0.22:8080;
    }

    server {
        listen 443 ssl;
        server_name portal.trustline.example;
        access_log /var/log/nginx/portal_limit.log limits;
        limit_req_status 429;
        limit_req_log_level notice;

        location = /api/auth/login {
            limit_req zone=auth_per_ip burst=5 nodelay;
            proxy_pass http://app_backend;
        }

        location /api/ {
            limit_req zone=api_per_ip burst=60 nodelay;
            limit_req zone=api_total burst=120 nodelay;
            proxy_pass http://app_backend;
        }

        location / {
            proxy_pass http://app_backend;
        }
    }
}
При rate=30r/s burst=60 мы разрешаем короткий запас примерно на две секунды расчётной скорости, но не заставляем браузер ждать его выдачи. Общая зона не даёт одному или нескольким адресам бесконтрольно занять весь backend.
Зоны разделены намеренно: вход нельзя оценивать по той же шкале, что загрузку справочника. Размер зоны я считаю по документации: состояние занимает 64 байта на 32-битных платформах и 128 байт на 64-битных, поэтому зона 1 МБ вмещает около 16 тысяч 64-байтных или около 8 тысяч 128-байтных состояний. Для 20 МБ на 64-битном сервере это порядка 160 тысяч ключей — для портала на 43 рабочих места с огромным запасом. Переполнение тоже стоит держать в голове: nginx удаляет наименее востребованное состояние, а если и это не помогает, завершает запрос с ошибкой — тем же кодом из limit_req_status. Ключ $binary_remote_addr выбран не случайно: он занимает 4 байта для IPv4 и 16 байт для IPv6, тогда как текстовый $remote_addr длиннее.
Отдельная тема — балансировщик перед nginx. $binary_remote_addr берётся из адреса TCP-соединения, поэтому без восстановления реального IP все запросы получают ключ балансировщика. Модуль ngx_http_realip_module по умолчанию не собирается (нужен --with-http_realip_module); в пакетах nginx.org он есть, проверить можно по выводу nginx -V. Доверять X-Forwarded-For от всего интернета нельзя: клиент сможет подменять ключ и обходить лимит. Поэтому доверенные адреса перечисляю явно:
set_real_ip_from 10.20.0.5;          # внутренний балансировщик
real_ip_header X-Forwarded-For;
real_ip_recursive on;
По умолчанию real_ip_header равен X-Real-IP, а real_ip_recursive выключен: тогда берётся последний адрес из заголовка. С on nginx возьмёт последний адрес, не входящий в доверенные. Исходный адрес соединения остаётся в $realip_remote_addr — его полезно писать в тот же JSON-лог, чтобы видеть, откуда пришёл запрос на самом деле.
- 429 точнее сообщает клиенту, что запрос отклонён из-за частоты, чем стандартный для модуля 503.
- Для браузерного API я выбираю `nodelay`: либо быстро обслужить запрос, либо быстро отказать.
- Глобальный лимит защищает ёмкость backend, а лимит на IP не позволяет одному источнику забрать весь запас.
- Лимит входа замедляет перебор, но не заменяет MFA, блокировку учётной записи и защиту на внешнем периметре.
- За балансировщиком ключ лимита корректен только после `set_real_ip_from` + `real_ip_header`; проверяйте по логу, что `$remote_addr` показывает клиентов, а не балансировщик.
Чем закончилась настройка и что делать в первую очередь
После разделения маршрутов и включения nodelay p95 вернулся к 340 мс. На обычной навигации 429 не появлялись, а синтетический параллельный поток сверх запаса быстро получал 429 и не занимал PHP-процессы. Утренние одновременные входы обеих площадок прошли без очереди в nginx. Небольшая разница с исходными 310 мс укладывалась в обычное колебание приложения; я не стал «дотюнивать» её ради красивого отчёта.
Приоритет действий у меня жёсткий. Сначала определить, что именно защищаем: логин, тяжёлый поиск, формирование отчёта или весь backend от аварийного пика. Затем найти правильный ключ и измерить легитимный всплеск. После этого включить dry run, добавить наблюдаемость и только потом переводить правило в боевой режим. Изменение burst наугад — последняя вещь, которую стоит делать. Так можно убрать симптом и одновременно открыть приложению слишком широкий удар.
На что можно временно забить? На попытку подобрать математически идеальный лимит с первого раза. Трафик меняется, фронтенд получает новые API-вызовы, отдел переезжает за другой NAT. Нужен не вечный коэффициент, а понятная политика пересмотра и алерт по REJECTED. И ещё: единичные 429 при реальном превышении — нормальная работа защиты. А вот регулярные DELAYED на штатной странице я считаю дефектом конфигурации, даже если формально ошибок нет.
- Снять фактический профиль запросов по URI и ключу.
- Проверить NAT, reverse proxy и реальный адрес клиента.
- Включить `$limit_req_status` и `limit_req_dry_run on`.
- Разнести логин, API и общий предохранитель по разным зонам.
- Проверить короткий всплеск, повторный всплеск и восстановление после него.
- Настроить алерт отдельно на `REJECTED` и рост `$request_time`.
Частые вопросы
Почему nginx возвращает именно 503?
Это стандартное значение директивы `limit_req_status`. Оно не доказывает перегрузку upstream. Я обычно задаю `limit_req_status 429`, чтобы причина отказа была понятнее клиенту и мониторингу.
Отключает ли nodelay ограничение частоты?
Нет. `nodelay` немедленно пропускает избыток, пока он помещается в `burst`, но состояние зоны продолжает восстанавливаться с заданным `rate`. Слишком ранний следующий всплеск будет отклонён.
Можно ли считать rate числом разрешённых запросов за календарную секунду?
Нет. Это скорость обработки накопленного избытка в алгоритме leaky bucket. Запросы оцениваются по моментам поступления, поэтому низкое минутное среднее не гарантирует прохождение параллельного веера.
Как подобрать burst для страницы?
Сначала измерить максимальное число запросов одного штатного действия в коротком окне, учесть NAT и параллельных пользователей, затем проверить значение в dry run. Запас должен пропускать легитимный веер, но оставаться меньше всплеска, опасного для upstream.
Почему лимит «на IP» режет всех сразу, если nginx стоит за балансировщиком?
Потому что `$binary_remote_addr` — это адрес соединения, то есть балансировщика. Нужно восстановить реальный адрес клиента модулем realip: `set_real_ip_from` с адресом балансировщика, `real_ip_header X-Forwarded-For` и при цепочке прокси `real_ip_recursive on`. Доверять заголовку от любых адресов нельзя.
Какой размер зоны limit_req_zone задавать?
По документации состояние занимает 128 байт на 64-битной платформе, 1 МБ вмещает около 8 тысяч таких состояний (около 16 тысяч 64-байтных на 32-битной). Для небольшой компании 10 МБ хватает с запасом; при переполнении nginx вытесняет наименее востребованные состояния, а если места всё равно нет — отклоняет запрос.
Защитит ли limit_req от полноценной DDoS-атаки?
Только частично. Он полезен как предохранитель приложения, но крупную атаку лучше отсекать раньше: на внешнем балансировщике, WAF, CDN или у оператора связи.
Источники
- nginx.org: модуль ngx_http_limit_req_module — Официальная документация на русском: limit_req (burst, nodelay, delay с 1.15.7, наследование), limit_req_dry_run (с 1.17.1), limit_req_log_level, limit_req_status (по умолчанию 503), limit_req_zone (64/128 байт на состояние, ~16/8 тысяч состояний на 1 МБ, r/m), переменная $limit_req_status (с 1.17.6). URL: https://nginx.org/ru/docs/http/ngx_http_limit_req_module.html
- nginx.org: модуль ngx_http_log_module — Официальная документация: log_format с escape=json (с 1.11.8), access_log, переменная $request_time. URL: https://nginx.org/ru/docs/http/ngx_http_log_module.html
- nginx.org: модуль ngx_http_realip_module — Официальная документация: сборка с --with-http_realip_module, set_real_ip_from, real_ip_header (по умолчанию X-Real-IP), real_ip_recursive, переменная $realip_remote_addr. URL: https://nginx.org/ru/docs/http/ngx_http_realip_module.html
- nginx.org: модуль ngx_http_upstream_module, встроенные переменные — Описание $upstream_response_time — время получения ответа от сервера группы в секундах с точностью до миллисекунд. URL: https://nginx.org/ru/docs/http/ngx_http_upstream_module.html#variables
- nginx.org: загрузка — Официальная страница выпусков; на сентябрь 2026 года stable — nginx 1.30.4, mainline — nginx 1.31.5. URL: https://nginx.org/ru/download.html