
Зависло чтение с NFS при automount: три таймера, которые путают, и почему soft — не лечение
x-systemd.mount-timeout ограничивает только выполнение команды mount, а чтение и запись на уже подключённой шаре подчиняются другим правилам: у NFS по умолчанию режим hard, и запросы повторяются бесконечно. Замена на soft обрывает ожидание, но может молча испортить данные. Ниже — три таймера по порядку, конфиги и кейс.
Что на самом деле ограничивает x-systemd.mount-timeout
Вопрос я слышу регулярно: в fstab стоит x-systemd.automount и x-systemd.mount-timeout=10s, NAS перезагрузили, а приложение на Linux-сервере всё равно застыло на минуты. Админ уверен, что десять секунд обещаны, и искренне удивляется. Удивляться тут нечему: параметр делает ровно то, что написано в документации systemd, и ничего больше. Он задаёт, сколько systemd ждёт завершения команды mount, прежде чем признать попытку подключения проваленной. Про чтение и запись после подключения там нет ни слова. Если вы настраиваете общие каталоги на серверах и хотите, чтобы это было сделано один раз и без сюрпризов, это как раз та рутина, которую мы берём в обслуживание серверов и инфраструктуры.
Механика такая. Опция x-systemd.automount заставляет systemd создать automount-юнит: точка монтирования существует всегда, а реальное подключение происходит при первом обращении. Опция x-systemd.mount-timeout= из fstab превращается в таймаут созданного mount-юнита. Если время не задано, берётся значение из DefaultTimeoutStartSec=, а по умолчанию это 90 секунд (так написано в systemd-system.conf(5)). Отдельная ловушка: по документации systemd.mount эта опция работает только в fstab и игнорируется, если вы напишете её в строке Options= ручного unit-файла. Меня до сих пор веселит, как люди переносят правильную настройку в unit, и она тихо перестаёт работать, не сказав об этом ни слова.
Теперь главное. Таймер сработал или не сработал — это история про один момент: подключение шары. Когда шара уже смонтирована, mount-юнит находится в состоянии active, команда mount давно завершилась, и таймеру нечего контролировать. Любой read() или write() на этой точке идёт напрямую в NFS-клиент ядра, а ядру безразлично, что написано в fstab про systemd. Путают это два совершенно разных события: «NAS недоступен в момент подключения» и «NAS пропал, пока мы с ним работали».
- mount-timeout: сколько systemd ждёт завершения команды mount при подключении
- idle-timeout: через какое время простаивающий automount будет отмонтирован (по умолчанию выключен)
- оба параметра не влияют на запросы к уже смонтированной файловой системе
- x-systemd.mount-timeout в Options= ручного unit-файла игнорируется: пишите его в fstab, а в unit используйте TimeoutSec=
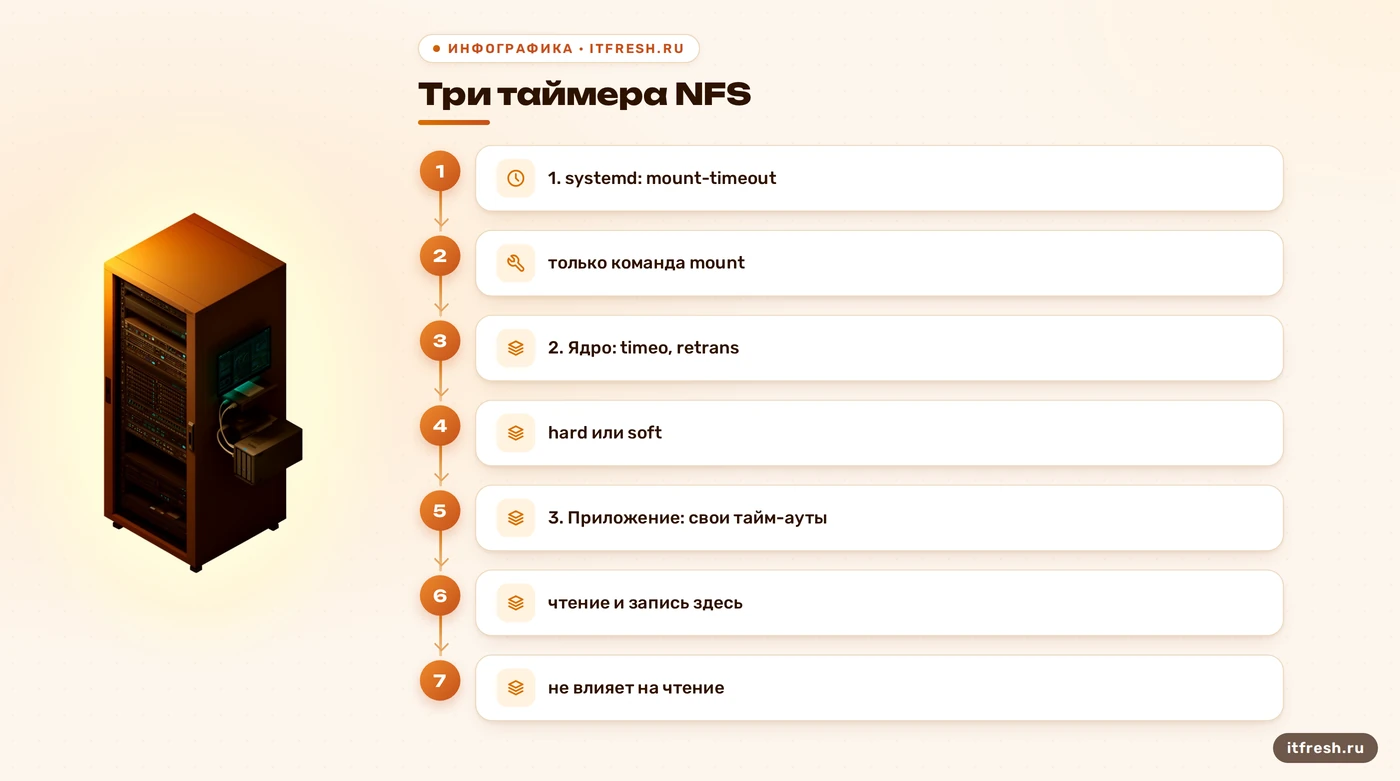
Три таймера: подключение, запросы ядра и приложение
Чтобы перестать путаться, я рисую клиентам три слоя. Первый — systemd и команда mount: он отвечает за то, чтобы подключение вообще произошло. Здесь же работает параметр retry= из nfs(5): сколько минут команда mount повторяет попытки подключения. По документации, для foreground-монтирования по умолчанию это 2 минуты, для background — 10000 минут, а при нуле mount завершается после первой же неудачи. Второй слой — NFS-клиент в ядре, который отправляет запросы к серверу и решает, что делать, если ответа нет. Третий — само приложение, у которого может быть свой тайм-аут или не быть никакого.
Второй слой управляется параметрами timeo и retrans. По nfs(5), timeo — время в десятых долях секунды, которое клиент ждёт ответа перед повтором. Для NFS поверх TCP значение по умолчанию 600, то есть 60 секунд, и при повторах тайм-аут растёт линейно на величину timeo, вплоть до 600 секунд. Параметр retrans — число повторов до дальнейших действий по восстановлению; по умолчанию клиент пробует каждый UDP-запрос три раза, а TCP-запрос два. Заметьте, что значение timeo выше умолчания клиент всё равно сбрасывает до умолчания. А что будет после повторов, определяет как раз hard или soft. Подробно про устройство самого механизма автомонтирования я писал в статье про тайм-аут automount в 10 секунд: она об архитектурном решении, а здесь я копаю именно в арифметику ожидания и в риски замены режима.
Вот сводная таблица, которую я показываю на планёрках. Она короткая, но снимает 80 % споров.
| Слой | Кто управляет | Что ограничивает | Что НЕ ограничивает |
|---|---|---|---|
| Подключение | systemd, команда mount | x-systemd.mount-timeout, retry= | чтение и запись после mount |
| Запросы ядра | NFS-клиент | timeo, retrans, hard/soft | время работы приложения вокруг ошибки |
| Приложение | разработчик | свои тайм-ауты, очереди | поведение ядра при зависании |
Если в этой таблице пустая строка про приложение, то у вас тайм-аута нет вообще. Тогда зависание NAS превращается в зависание сервиса, и никакая настройка fstab его не отменит.
Почему чтение зависает: hard, бесконечные повторы и процессы в состоянии D
Режим по умолчанию — hard. Документация nfs(5) формулирует прямо: если опция не указана или указана hard, запросы NFS повторяются бесконечно. Это сделано специально: для приложения сетевая файловая система должна выглядеть как обычный диск, который может быть медленным, но не возвращает «потерял». Клиент пишет сообщение «server not responding» после исчерпания повторов и продолжает ждать. Поэтому в журнале ядра вы видите не обрыв, а жалобу и тишину. Каждый поток, который полез на шару, замирает в ожидании ввода-вывода, и именно так выглядит «завис весь сервис»: пул воркеров веб-приложения кончается за считанные минуты, потому что каждый воркер залип на своём файле.
Как это увидеть руками, без догадок. Сначала посмотрите, что смонтировано и с какими опциями, потом найдите процессы, которые застряли в состоянии D (непрерываемое ожидание), и проверьте шару с жёстким ограничением по времени:
findmnt -t nfs4
nfsstat -m
ps -eo pid,stat,wchan:32,cmd | awk '$2 ~ /^D/'
journalctl -k | grep -i nfs
timeout -k 2 10 stat /mnt/archive; echo $?
Последняя команда стоит отдельного внимания. Она показывает, есть ли доступ к точке в пределах десяти секунд, и её код возврата подходит для проверки в мониторинге. Не используйте для проверки обычный ls или df на шару без timeout: у зависшего NFS они сами повиснут, и вместе с ними повиснет ваш скрипт проверки. Ловушку я видел в чужих мониторингах не раз: проверка доступности NAS ложится первой, а потом отчёт приходит от самого мониторинга.
Отдельная боль — попытка «срочно всё починить» в момент аварии. Если процессы уже застряли, umount -f сам по себе тоже не гарантия: в man-странице umount написано, что принудительное отключение предназначено для недоступной NFS-системы, но при этом не гарантирует, что команда не зависнет. Ленивое отключение umount -l отсоединяет файловую систему от дерева каталогов сразу, а ссылки чистит, когда она перестанет быть занятой. Это не лечит залипшие процессы, а только прячет точку монтирования. Рассчитывайте, что после тяжёлого зависания сервис придётся перезапускать, а иногда и сервер. Лучше заранее выбрать, что на шаре хранить, чем потом выбирать способ реанимации.
Чем опасна замена hard на soft и softerr
Самая популярная реакция на зависший NAS — вписать soft в опции и считать вопрос закрытым. Выглядит логично: ожидание кончилось, приложение получило ошибку, сервис живёт. По документации nfs(5), при soft клиент прекращает запрос после retrans повторов и возвращает приложению ошибку EIO, при softerr — ETIMEDOUT. Но в том же разделе мануала сказано: так называемый soft-тайм-аут может вызвать скрытое повреждение данных в некоторых случаях, а soft/softerr стоит использовать, только если отзывчивость клиента важнее целостности данных. Я не знаю формулировки честнее. Автор документации прямо пишет, что вы меняете гарантию на скорость.
Теперь переведём это на язык офиса. Приложение записывает в файл на шаре договор, фотографию или выгрузку. Запись у NFS-клиента по умолчанию отложенная: данные копятся в кэше и уходят на сервер позже, а об ошибке клиент сообщает через код возврата close(2), как сказано в разделе про когерентность nfs(5). Если в этот момент сработал soft-тайм-аут и приложение не проверило результат закрытия файла, оно считает файл сохранённым, а на NAS лежит обрезанный или пустой файл. Хуже всего перезапись: старый корректный файл заменён частью нового. В итоге получаем отчёт, который «успешно сформировался», и скан договора, который открывается как пустой лист. Разумеется, всегда есть вариант «приложение само проверяет все коды возврата» — на практике так пишут единицы.
Поэтому у меня правило: soft допустим только там, где содержимое можно пересоздать и где потерянная запись не ломает бизнес-процесс. Кэш миниатюр, временные выгрузки, каталог для распаковки дистрибутивов — пожалуйста. Базы данных, файлы с блокировками, архив документов, сессии, очереди — нет. Про блокировки отдельно: в nfs(5) сказано, что NLM поддерживает только рекомендательные (advisory) блокировки, то есть они защищают лишь от тех программ, которые сами их проверяют. Добавьте к этому soft, при котором оборванный по тайм-ауту запрос возвращается приложению ошибкой, и согласованность файла начинает держаться на честном слове разработчика. Если у вас файловый сервер сделан по принципу «всё в одну шару, лишь бы работало», то его надо переделывать, а не подпирать опцией — статья про NAS для небольшой компании помогает расставить приоритеты при выборе хранилища.
Если вы после этого раздела подумали «у нас так и есть», не надо в панике править fstab в пятницу вечером. Напишите нам — мы разберём, что лежит на вашей шаре, и разнесём по режимам за один визит, без простоя.
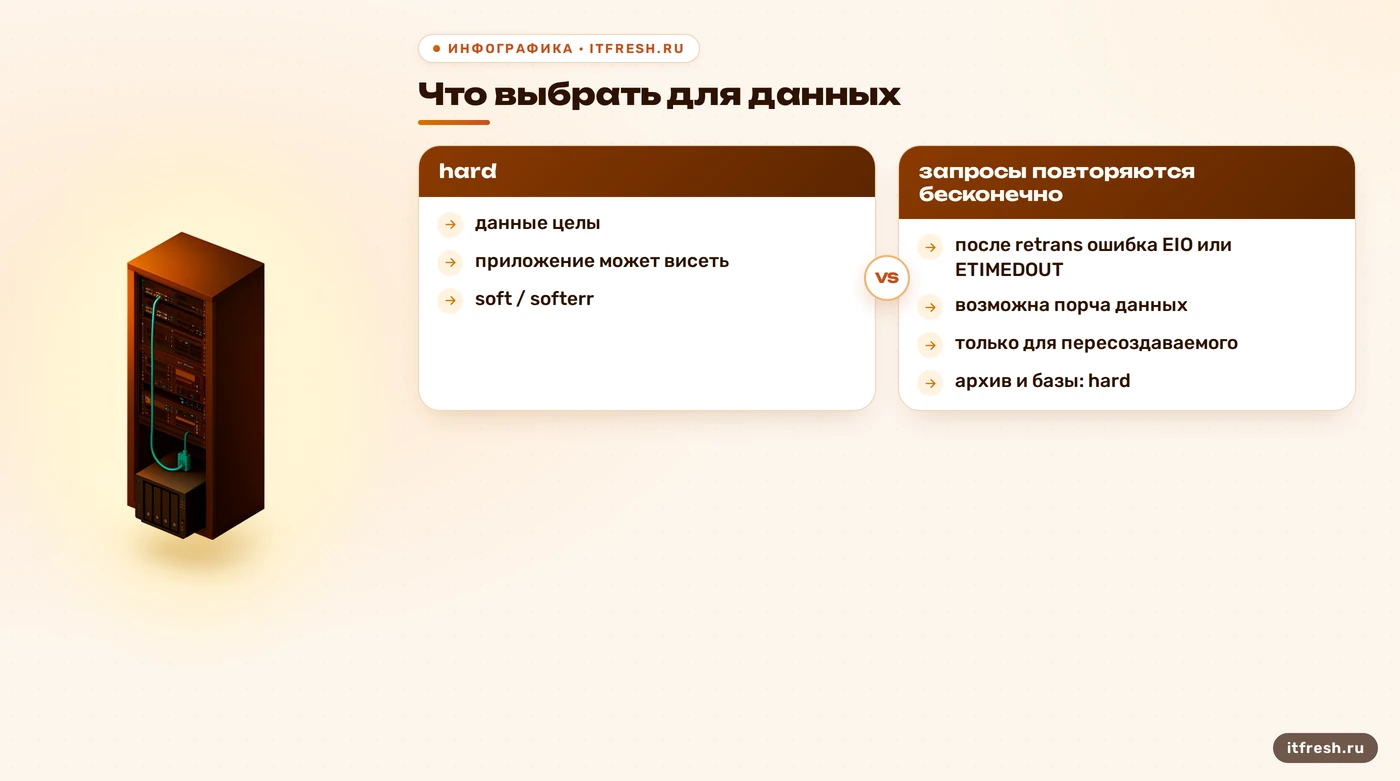
- hard (по умолчанию): запросы повторяются бесконечно, данные целы, приложение может висеть
- soft: после retrans повторов приложение получает EIO, возможна скрытая порча данных
- softerr: то же, но ошибка ETIMEDOUT, риски те же
- для архива, баз и сессий оставляйте hard, soft пускайте только на пересоздаваемое
Что делать вместо soft: схема, которая переживает отключение NAS
Я решаю задачу разделением обязанностей. Всё, без чего приложение не может обслужить пользователя прямо сейчас, живёт на локальном диске сервера: сессии, кэш, временные файлы, логи. На шару уходит то, что можно подождать: архив, сканы, фото, выгрузки. Критичный архив остаётся на hard, потому что целостность важнее. А чтобы приложение не лежало вместе с NAS, ему даются свои тайм-ауты и очередь: запись на шару идёт фоновым заданием, пользователь видит «поставлено в очередь». Это хуже по красоте и лучше по результату. Для описанных настроек подходит такая строка fstab (адреса условные, подставьте свои):
nas.example.com:/export/archive /mnt/archive nfs4 _netdev,nofail,x-systemd.automount,x-systemd.mount-timeout=10s,x-systemd.idle-timeout=10min,hard 0 0Здесь nofail делает шару желательной, а не обязательной для remote-fs.target, поэтому при недоступном NAS сервер загрузится. Автомонтирование не заставляет загрузку ждать. Это та часть истории, где mount-timeout как раз работает, и работает хорошо.
После правки fstab проверьте, что systemd увидел параметры, и перезапустите automount. Имя юнита получается из пути, поэтому проще не угадывать, а спросить systemd:
systemctl daemon-reload
systemd-escape -p --suffix=automount /mnt/archive
systemctl restart mnt-archive.automount
systemctl status mnt-archive.automount
systemctl cat mnt-archive.mount
Команда systemctl cat покажет сгенерированный mount-юнит, и вы увидите, что таймаут из fstab действительно попал в него. Если вы сомневаетесь, как поведёт себя ваша версия ядра и дистрибутива, проверьте на тестовой машине с отключением сетевого кабеля у NAS, а не на боевой. С Windows-клиентами схема отличается, об этом отдельно — в материале про подключение NFS-клиента в Windows.
Есть и промежуточный вариант для тех, кому нужна ошибка раньше, чем через минуты, но не нужен риск для данных: оставить hard и ограничивать время на уровне приложения или оболочки, например запускать операции с шарой через timeout, а в сервисе держать отдельный поток под файловые операции с собственным дедлайном. Приложение сдаётся за вас, но запрос в ядре остаётся честным. Если же вы всё-таки решили ставить soft на каталог с пересоздаваемыми данными, подбирайте timeo и retrans под себя и измеряйте реальное время до ошибки на стенде: я не буду называть готовые числа, потому что они зависят от версии ядра, протокола и сети, и вам стоит свериться с nfs(5) вашего дистрибутива. Заодно добавьте проверку шары в регламент эксплуатации мониторинга: алерт «NAS не отвечает за 10 секунд» должен прийти раньше, чем позвонят из приёмной.
Разбор из практики: фитнес-центр на 50 рабочих мест
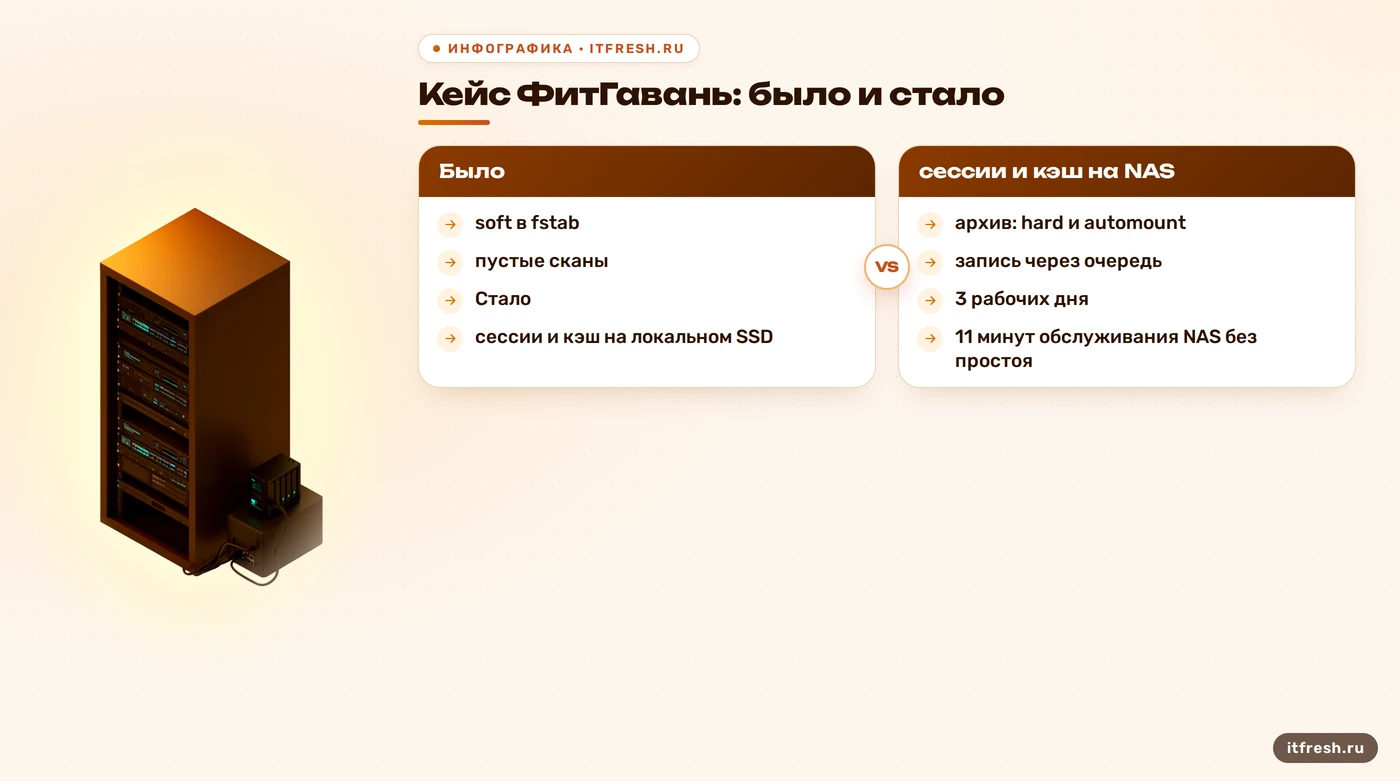
Условный клиент — фитнес-центр «ФитГавань», 50 рабочих мест. Веб-приложение учёта абонементов крутится на Linux-сервере, а сканы договоров и фото клиентов лежат на NAS по NFS. Пришли они с историей: однажды NAS ушёл на обновление прошивки, приём на ресепшене встал, и прежний подрядчик решил вопрос одной строкой — заменил hard на soft. Через пару недель администратор заметил, что часть сканов открывается пустыми. Классика: отказ NAS не прекратился, он стал тихим.
Мы сделали по шагам. Первое: инвентаризация — что именно приложение пишет на шару. Оказалось, что вместе с архивом там лежали сессии, кэш отчётов и временные файлы выгрузки. Второе: сессии, кэш и временные файлы перенесли на локальный SSD сервера. Третье: для каталога архива вернули hard и поставили x-systemd.automount с x-systemd.mount-timeout=10s, nofail и x-systemd.idle-timeout=10min. Четвёртое: запись сканов сделали через очередь с фоновым копированием на шару, а проверку доступности NAS повесили на timeout -k 2 10 stat в Zabbix с алертом. Работа заняла три рабочих дня, из них день ушёл на разбор повреждённых файлов.
Проверили на деле. Во время запланированного обслуживания NAS на 11 минут ресепшен работал: выдача абонементов, продажи, расписание шли с локального диска. Недоступными оказались только архив сканов и фото, а новые файлы дожидались в очереди и ушли на шару после возвращения NAS. Без простоя, без пустых файлов. Цифры условные, но порядок такой же, как в моих проектах: проблема решается не одной опцией, а раскладкой данных по назначению.
С чего начать и что можно не делать
Приоритеты у меня такие. Первое — выписать, что приложение хранит на шаре, и вынести оттуда всё, что нужно для немедленной работы. Второе — убедиться, что в fstab есть nofail и x-systemd.automount, чтобы загрузка сервера не зависела от NAS. Третье — настроить мониторинг доступности шары с жёстким тайм-аутом. И только потом думать о тонкой настройке timeo и retrans. Большинство инцидентов, которые я разбирал, закрывались первым пунктом.
Что можно не делать. Не гонитесь за идеально коротким mount-timeout: он решает вопрос загрузки и первого обращения, а не работы. Не вписывайте soft в общий fstab «на всякий случай». Не рассчитывайте на intr: в nfs(5) указано, что опция оставлена для обратной совместимости и после ядра 2.6.25 игнорируется. И не принимайте за стратегию надежду, что NAS «никогда не падает». Он падает ровно тогда, когда без него нельзя, а бэкап шары делают все, проверяет его почти никто.
Частые вопросы
Ограничивает ли x-systemd.mount-timeout зависшее чтение с NFS?
Нет. Он ограничивает только время выполнения команды mount при подключении. После подключения запросы идут через NFS-клиент ядра, и их поведение определяют hard или soft, timeo и retrans.
Можно ли просто заменить hard на soft?
Только для данных, которые можно пересоздать. В nfs(5) прямо сказано, что soft-тайм-аут может вызвать скрытое повреждение данных. Для архива, баз данных и сессий оставляйте hard.
Чем soft отличается от softerr?
После retrans повторов soft возвращает приложению ошибку EIO, а softerr — ETIMEDOUT. Риск для целостности данных у обоих режимов одинаковый.
Что делать, если процессы уже зависли на недоступной шаре?
Восстановите доступ к NAS. Принудительный umount -f не гарантирует, что команда не зависнет, а umount -l лишь отсоединяет точку от дерева каталогов. Часто остаётся перезапуск сервиса.
Как проверить шару в мониторинге, чтобы проверка сама не зависла?
Запускайте проверку с жёстким ограничением, например timeout -k 2 10 stat /mnt/archive, и смотрите код возврата. Простой ls или df на зависшей шаре зависнет сам.
Источники
- nfs(5) — man-страница NFS-клиента — Проверены hard, soft, softerr, retrans, timeo, retry, intr и предупреждение о скрытом повреждении данных: https://man7.org/linux/man-pages/man5/nfs.5.html
- systemd.mount — документация systemd — Проверены x-systemd.mount-timeout, x-systemd.automount, x-systemd.idle-timeout, nofail, noauto и TimeoutSec: https://www.freedesktop.org/software/systemd/man/latest/systemd.mount.html
- systemd.automount — документация systemd — Проверен TimeoutIdleSec (по умолчанию отключён): https://www.freedesktop.org/software/systemd/man/latest/systemd.automount.html
- systemd-system.conf — документация systemd — Проверено значение DefaultTimeoutStartSec по умолчанию (90 секунд): https://man7.org/linux/man-pages/man5/systemd-system.conf.5.html
- umount(8) — man-страница util-linux — Проверены ключи -f и -l для недоступной NFS: https://man7.org/linux/man-pages/man8/umount.8.html