
Watchdog перезапускает unbound-mailcow с DNSSEC failure, хотя docker ps пишет healthy
Если watchdog каждые несколько минут перезапускает unbound-mailcow с DNSSEC failure, а docker ps честно показывает healthy — это не баг мониторинга. Watchdog и docker healthcheck проверяют разные вещи. Ниже — что на самом деле тестирует UNBOUND_THRESHOLD, как найти настоящую причину и почему замена резолвера почти всегда усугубляет ситуацию.
Почему healthy в docker ps ничего не доказывает про DNS
История из практики. «БрендПуть» — маркетинговое агентство на 49 рабочих мест, у них свой mailcow на выделенном сервере: 32 домена клиентов, рассылки, почта отдела продаж. Мы ведём его на обслуживании корпоративной почты с прошлого года. В марте пришло уведомление watchdog: unbound-mailcow перезапущен по превышению порога, DNSSEC failure. Через двадцать минут — снова. За час — шесть перезапусков. Захожу на сервер, смотрю docker ps — unbound-mailcow в статусе healthy, как ни в чём не бывало.
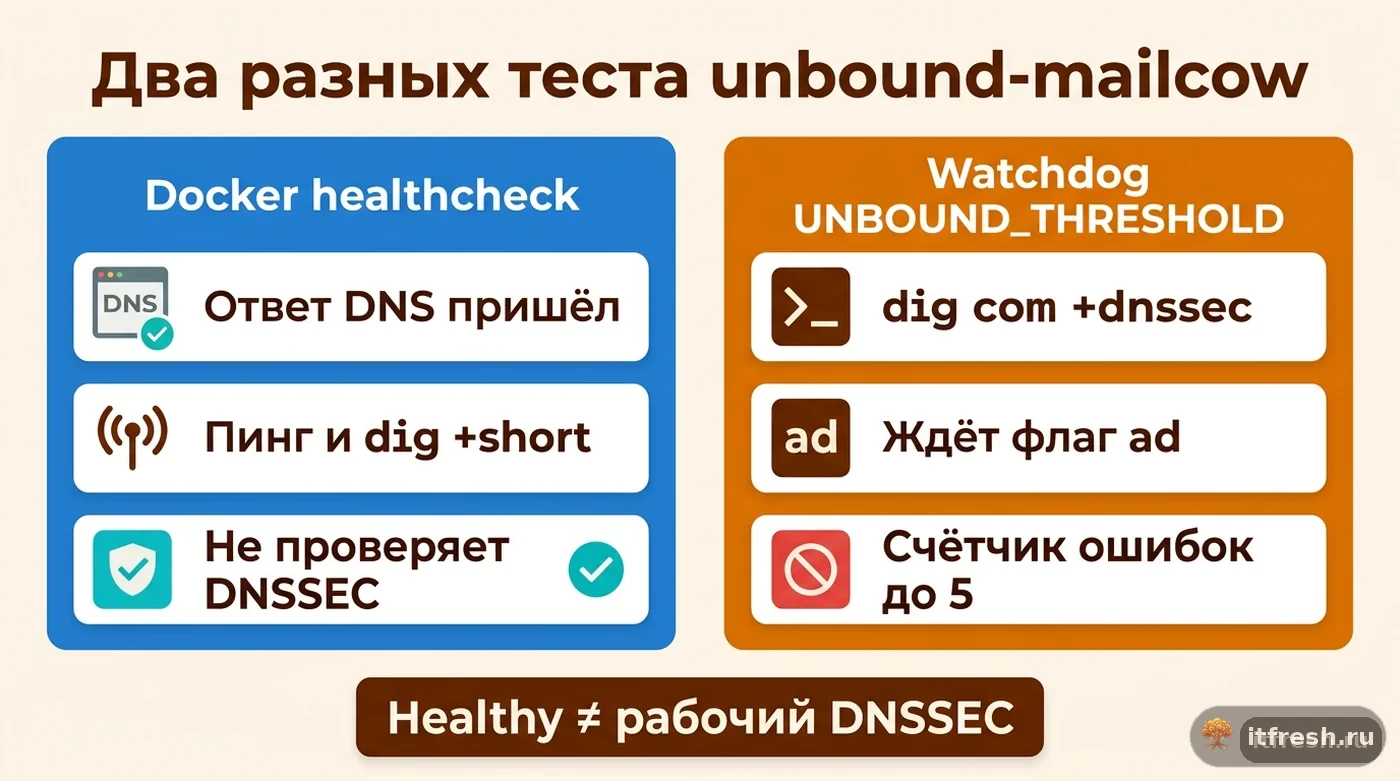
Первая реакция почти у любого админа — решить, что это ложное срабатывание watchdog, и либо поднять порог в mailcow.conf, либо вообще выключить проверку. Это ошибка, и вот почему. Docker healthcheck у unbound-mailcow (скрипт healthcheck.sh внутри образа) пингует несколько внешних адресов и резолвит три домена через сам Unbound командой dig +short — он проверяет «есть сеть и ответ приходит», но на флаг DNSSEC-валидации не смотрит вообще. Watchdog делает другое: в функции unbound_checks он резолвит stackoverflow.com через unbound-mailcow и отдельно выполняет dig com +dnssec, ожидая в ответе флаг ad. Нет флага — в журнал проверки пишется ровно та строка «DNSSEC failure», которую вы видите в уведомлении. Это два независимых теста, и они закономерно могут расходиться: ответ есть, а подпись не провалидирована.
Официальная документация описывает это буквально: UNBOUND_THRESHOLD отвечает за уведомление администраторов, если Unbound не может резолвить или валидировать внешние домены/DNSSEC, и автоматически перезапускает контейнер при достижении порога. То есть шесть перезапусков за час — это шесть раз, когда функциональная DNS-проверка провалилась, а не шесть случайных совпадений. Разбираться нужно не с watchdog, а с тем, почему валидация подписи рвётся.
- docker healthcheck unbound-mailcow — ping наружу и `dig +short` трёх доменов, без проверки флага `ad`
- watchdog UNBOUND_THRESHOLD — резолвинг stackoverflow.com + `dig com +dnssec` с проверкой флага `ad`
- healthy в docker ps не гарантирует рабочий DNSSEC
- серия перезапусков — сигнал разбираться в причине, а не поднимать порог
Как устроен порог и что реально считает watchdog
У watchdog в mailcow пятнадцать с лишним отдельных порогов для разных сервисов — NGINX_THRESHOLD, REDIS_THRESHOLD, MYSQL_THRESHOLD, DOVECOT_THRESHOLD и так далее, все они заданы в docker-compose.yml со значениями по умолчанию. UNBOUND_THRESHOLD в этом списке равен пяти. Работает он как счётчик, а не как «пять провалов подряд»: каждая неудачная проверка прибавляет единицу, каждая успешная — отнимает, проверки идут с паузой 20–80 секунд, и когда счётчик доходит до порога, watchdog перезапускает контейнер и шлёт уведомление. Поэтому «плавающий» DNSSEC, который то проходит, то нет, может копиться долго, а устойчивый сбой доводит до рестарта за несколько минут. Документация прямо говорит, что дефолтные значения подходят для большинства инсталляций, и трогать их стоит только по конкретной причине, а не «чтобы не мешало».
Важный момент, который упускают: изменить порог легко — правите UNBOUND_THRESHOLD= в mailcow.conf и накатываете docker compose up -d — но это лечит симптом, а не причину. Если DNSSEC реально не проходит валидацию, поднятый порог просто увеличивает время, за которое почта копится в очереди с недоступным DNS, прежде чем сработает автоматический перезапуск. Для агентства рассылок вроде «БрендПути», где по будням уходит несколько тысяч писем в день, лишние 20–30 минут простоя DNS — это отложенная доставка и жалобы клиентов.
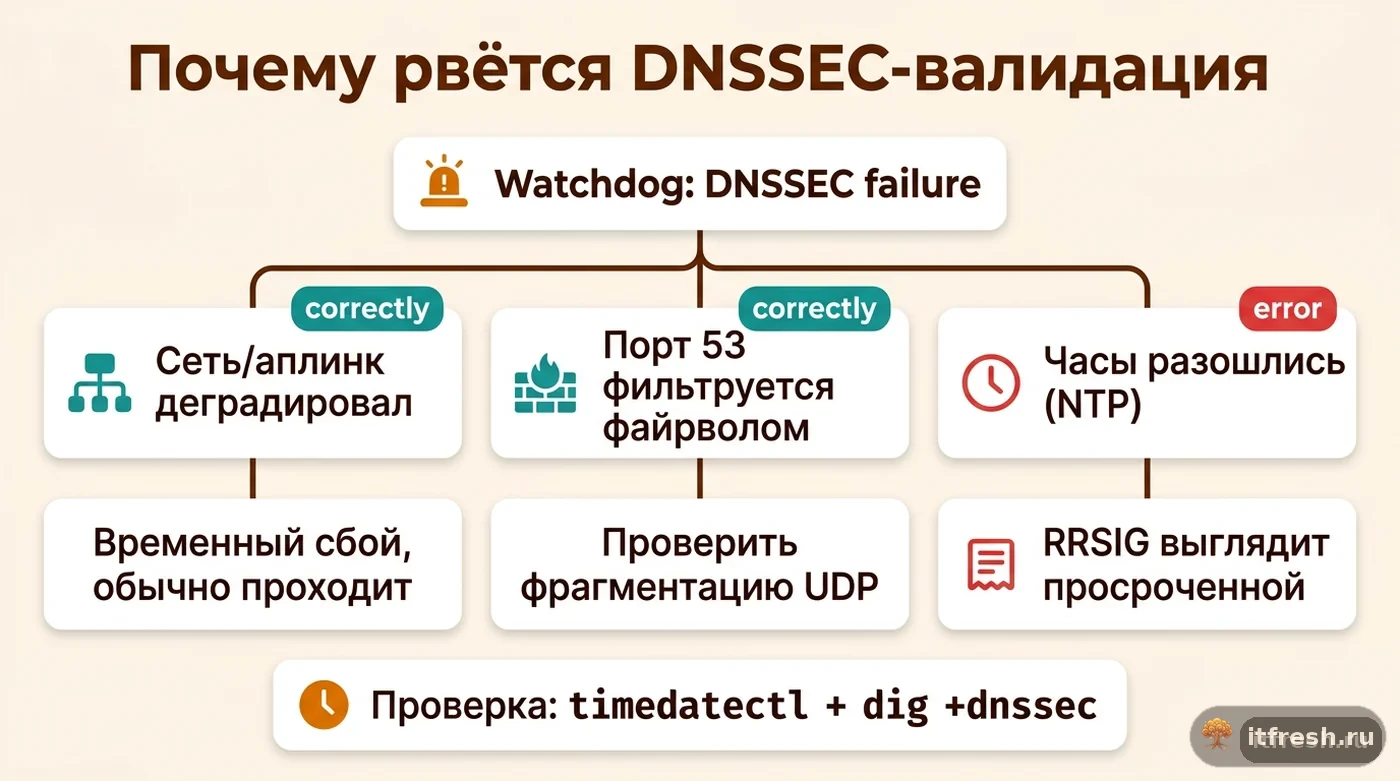
Второй момент — что вообще может ронять DNSSEC-валидацию, если сам unbound не менялся и конфиг не трогали. Тут три обычных подозреваемых: временная деградация аплинка или маршрута до корневых/TLD-серверов, фильтрация UDP/TCP порта 53 файрволом хостера (в том числе фрагментированных ответов при больших DNSSEC-пакетах), и системное время. Третье звучит неожиданно, но DNSSEC-подписи (RRSIG) имеют срок действия, и валидация опирается на системные часы: если время на сервере уехало на несколько минут вперёд или назад — из-за сбоя NTP, восстановления из снапшота или ручного вмешательства — часть подписей начинает выглядеть просроченными или ещё не вступившими в силу, и валидация проваливается ровно так же, как при реальной проблеме с DNS. Похожий эффект «всё работает, а проверка красная» я разбирал и на стороне антиспама — в разборе антиспама Zimbra причиной тоже оказался не сам движок, а забытая обвязка вокруг него.
- UNBOUND_THRESHOLD по умолчанию — 5: счётчик +1 за провал, −1 за успех, проверка раз в 20–80 с
- поднятие порога лечит уведомления, а не причину сбоя
- частые подозреваемые: деградация аплинка, фильтрация порта 53/фрагментация UDP, расхождение системного времени
- DNSSEC-подписи имеют срок действия — рассинхронизация часов ломает валидацию без всякого сбоя сети
Диагностика: что смотреть внутри unbound-mailcow
В кейсе «БрендПути» я не гадал, а сразу зашёл в контейнер и прогнал резолвинг с явной проверкой DNSSEC на заведомо подписанном домене:
docker compose exec unbound-mailcow dig +dnssec cloudflare.com @127.0.0.1Ровно ту же проверку, что делает watchdog, можно повторить командой dig com +dnssec, а собственный журнал проверок watchdog хранит последние 50 строк в файле /tmp/unbound-mailcow внутри контейнера: docker compose exec watchdog-mailcow cat /tmp/unbound-mailcow — там видно, чередуются ли «DNSSEC failure» и «DNSSEC check succeeded» или идёт сплошная серия провалов. Ответ dig должен содержать флаг ad (authenticated data) в секции flags — это признак того, что unbound не просто получил ответ, а провалидировал подпись. В момент, когда unbound-mailcow был healthy по докеру, но watchdog писал DNSSEC failure, флага ad в ответе не было, а часть запросов вообще уходила в SERVFAIL — типичный признак того, что резолвер не может достроить цепочку доверия либо получить полный DNSSEC-ответ.
Дальше — логи самого unbound. docker compose logs unbound-mailcow --since 1h | grep -i -E "dnssec|servfail|validat" быстро показывает, ругается ли резолвер на конкретные RRSIG-записи или на сеть в целом. У «БрендПути» в логах шли сообщения о просроченной валидации именно в те минуты, когда время на гипервизоре, на котором крутится ВМ, разошлось с реальным на 4 минуты — хостер откатил снапшот при плановом обслуживании соседней ноды, и время подхватилось со сдвигом. chronyc sources -v на хосте подтвердил: синхронизация потеряна, локальные часы дрейфовали без коррекции почти час.
Итог разбора: DNS и сеть были ни при чём. Мы поправили chrony на хосте (добавили резервный NTP-пул, сократили maxpoll для более частой синхронизации), а на самой ВМ включили мониторинг дрейфа времени через Zabbix-агент. Watchdog за следующие три месяца не сработал ни разу по UNBOUND_THRESHOLD. Тот же принцип — не чинить видимый сбой, а искать, что стоит за ним — я использую и при разборе других watchdog-подобных перезапусков; в регламенте эксплуатации mailcow есть чек-лист по всем порогам watchdog, не только по Unbound.
- `dig +dnssec домен @127.0.0.1` внутри unbound-mailcow — ищите флаг `ad`
- SERVFAIL на подписанных доменах — признак разрыва цепочки доверия DNSSEC
- `docker compose logs unbound-mailcow --since 1h` — грепать по dnssec/servfail/validat
- `chrony sources -v` / `timedatectl` на хосте — рассинхронизация времени ломает проверку подписей
Когда действительно нужен внешний резолвер — и как это сделать правильно
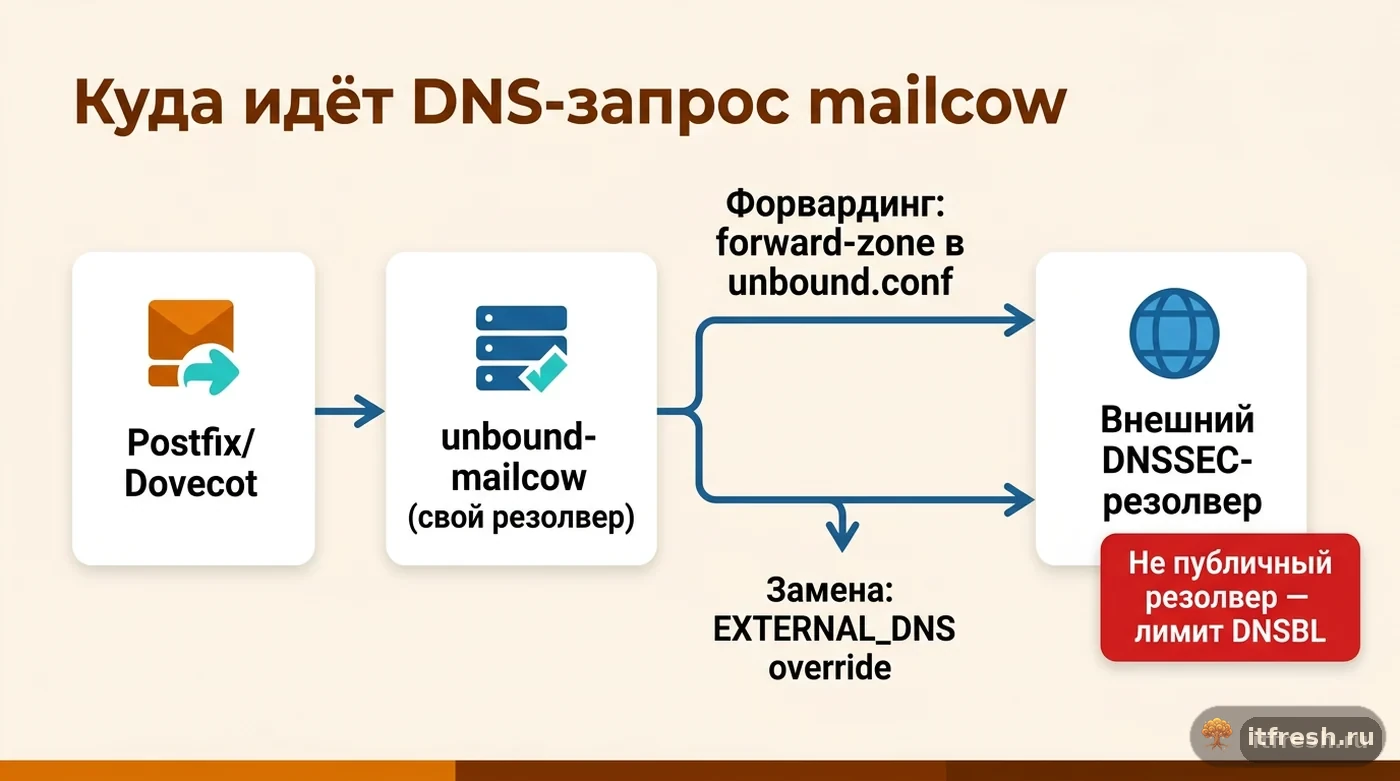
Бывает и обратная ситуация: сеть хостера действительно режет исходящий DNS или блокирует нужные порты, и штатный Unbound физически не может достучаться до корневых серверов. Тогда официальная документация предлагает два способа перенаправить запросы на внешний резолвер. Первый — форвардинг прямо в Unbound: добавляете в data/conf/unbound/unbound.conf блок forward-zone, где name: "." означает «все запросы», и один или два forward-addr с IP внешнего резолвера, затем docker compose restart unbound-mailcow.
# data/conf/unbound/unbound.conf
forward-zone:
    name: "."
    forward-addr: 192.0.2.53   # ваш DNSSEC-валидирующий резолвер
    forward-addr: 192.0.2.54
Второй способ — полная замена контейнера Unbound через готовый оверрайд: cp helper-scripts/docker-compose.override.yml.d/EXTERNAL_DNS/docker-compose.override.yml ., затем правите IP в файле и пересоздаёте стек через docker compose down и docker compose up -d. Оба метода официально задокументированы и рабочие, но у обоих есть одно жёсткое требование из документации: резолвер обязан валидировать DNSSEC сам, иначе вы просто перенесёте проблему на уровень ниже, и mailcow перестанет доверять любым подписям вообще.
И вот тут ключевая оговорка, которую документация выделяет отдельным предупреждением: не используйте публичные резолверы вроде общедоступных сервисов крупных провайдеров. Причина не в DNSSEC как таковом — публичные резолверы его как раз поддерживают, — а в том, что чёрные списки (DNSBL), на которые опирается Rspamd для антиспама, лимитируют число запросов с одного IP. Когда за публичным резолвером сидят тысячи почтовых серверов одновременно, лимит выбирается моментально, и DNSBL-проверки у вас начинают массово фейлиться — то есть вы чините одну проблему и тут же создаёте вторую, менее заметную, но более вредную для доставляемости почты.
- форвардинг: `forward-zone` в unbound.conf + `docker compose restart unbound-mailcow`
- полная замена: `docker-compose.override.yml.d/EXTERNAL_DNS/` + `down` и `up -d`
- обязательное условие — резолвер должен сам валидировать DNSSEC
- публичный резолвер = общий IP на тысячи серверов = мгновенно выбранный лимит DNSBL
Что я делаю в похожих кейсах: приоритеты и на что не стоит тратить время
Моя последовательность действий при жалобе «watchdog долбит DNSSEC failure» всегда одна и та же, и дальше я перечислю её по шагам, потому что порядок здесь важнее набора команд. Сначала — время. Это самая частая причина, которую не проверяют вообще, а она лечится за пять минут и не требует трогать сеть или почтовый стек. Дальше — прямая проверка dig +dnssec изнутри контейнера на нескольких доменах, не на одном: если валится всё подряд — это сеть, если один конкретный домен — это может быть проблема на стороне владельца того домена, а не у вас.
Дальше смотрю на частоту. Один перезапуск за сутки в 3–4 часа ночи почти всегда совпадает с плановым обслуживанием у аплинка или у корневых серверов — тратить время на расследование одиночного случая нерационально, документация недаром описывает пороги как допуск на кратковременные сбои. А вот серия за короткий промежуток, как у «БрендПути», — уже статистика, и её нужно объяснить, а не заглушить повышением порога.
Отдельно — что я никогда не делаю первым шагом: не меняю резолвер и не отключаю DNSSEC-проверку целиком. Отключение UNBOUND_THRESHOLD убирает не проблему, а видимость проблемы — DNS может продолжать сбоить, просто вы больше не узнаете об этом от watchdog, узнаете от пользователей, когда письма перестанут отправляться или входящая почта начнёт откладываться в очереди Postfix. Порог — это сигнальная система, а не источник неполадок, и лечить нужно то, о чём он сигнализирует. Тот же соблазн «выключить неудобную проверку вместо разбора причины» я регулярно вижу и на первичной установке mailcow — расписал, почему так делать не стоит даже на старте, в пошаговом регламенте развёртывания.
- шаг 1 — сверить системное время (host + контейнер)
- шаг 2 — `dig +dnssec` на 2–3 разных доменах изнутри unbound-mailcow
- шаг 3 — оценить частоту: одиночный ночной случай vs серия за час
- никогда не первым шагом: смена резолвера, отключение UNBOUND_THRESHOLD
Как узнать о проблеме раньше watchdog: мониторинг времени и DNSSEC
После разбора с «БрендПутём» я перестал полагаться на то, что watchdog и его уведомление на email — единственная линия обороны. Проблема с уведомлением от самого watchdog в том, что оно приходит уже постфактум, после того как порог из пяти неудачных проверок исчерпан и контейнер перезапущен — часть входящей и исходящей почты в этот момент уже постояла в очереди. Для агентства, которое живёт рассылками, эти минуты складываются в задержки доставки, которые клиенты замечают быстрее, чем мы успеваем среагировать на alert.
Поэтому на серверах mailcow, которые мы ведём, я добавляю два независимых чек-айтема в Zabbix, оба не завязаны на сам mailcow и поэтому не зависят от его внутренней логики. Первый — дрейф системного времени: chronyc tracking парсится на поле System time, и алерт срабатывает при расхождении больше 200 мс, задолго до того, как это способно повлиять на валидацию DNSSEC-подписи. Второй — прямая проверка DNSSEC снаружи контейнера, тем же dig +dnssec на пару контрольных доменов с разбором флага ad в выводе; она дублирует то, что делает watchdog, но пишет историю в метрики, а не только шлёт письмо при уже случившемся сбое.
Третий пункт касается уже не мониторинга, а процесса: если сервер mailcow живёт на виртуализации, я прошу заказчика или самого хостера подтвердить, что у гипервизора включена синхронизация времени для гостевых ВМ (QEMU Guest Agent и NTP внутри гостя, VMware Tools, Hyper-V Integration Services — у каждой платформы свой механизм), и что плановые операции со снапшотами не превращаются в скрытый источник рассинхронизации. Это дешевле лечить один раз на уровне инфраструктуры, чем разбирать повторяющиеся DNSSEC failure на уровне контейнера каждые несколько месяцев.
- чек-айтем Zabbix на дрейф времени: `chronyc tracking`, порог 200 мс, срабатывает раньше DNSSEC failure
- дублирующая проверка DNSSEC снаружи watchdog: `dig +dnssec` по расписанию + разбор флага `ad`
- подтвердить у хостера синхронизацию времени гостевой ВМ через гипервизор
- снапшоты и восстановление ВМ — частый источник скрытого сдвига часов
Частые вопросы
Почему watchdog пишет DNSSEC failure, если docker ps показывает unbound-mailcow healthy?
Это два разных теста. Docker healthcheck пингует внешние адреса и резолвит несколько доменов через `dig +short`, не проверяя DNSSEC. Watchdog по UNBOUND_THRESHOLD дополнительно выполняет `dig com +dnssec` и ждёт флаг `ad` — это проверка именно валидации подписи. Процесс может быть жив, а валидация подписи при этом падать из-за сети или рассинхронизации времени.
Может ли сбой системного времени вызвать DNSSEC failure?
Да. DNSSEC-подписи (RRSIG) имеют срок действия, и проверка опирается на системные часы. Расхождение в несколько минут из-за сбоя NTP или отката снапшота делает часть подписей «просроченными» или «ещё не вступившими в силу» для резолвера, хотя реальной проблемы с DNS нет. Проверяется `timedatectl status` на хосте и `date -u` внутри контейнера unbound-mailcow.
Стоит ли просто поднять UNBOUND_THRESHOLD, чтобы watchdog не перезапускал контейнер?
Это лечит симптом, а не причину. Порог — это допуск на кратковременные сбои, а не переключатель для «неудобных» уведомлений. Если DNSSEC реально не проходит валидацию, увеличенный порог просто отодвигает автоматический перезапуск, а письма тем временем копятся в очереди.
Можно ли направить mailcow на публичный DNS-резолвер вместо своего Unbound?
Технически да, документация описывает форвардинг через forward-zone или override-файл. Но публичный резолвер обслуживает тысячи серверов с одного IP, и лимиты чёрных списков (DNSBL), которые использует Rspamd, выбираются почти мгновенно — вы почините DNSSEC-предупреждение и получите проблемы с антиспамом взамен.
Как проверить, реально ли валидируется DNSSEC внутри unbound-mailcow?
Выполните `docker compose exec unbound-mailcow dig +dnssec cloudflare.com @127.0.0.1` и посмотрите на флаги ответа: наличие `ad` (authenticated data) означает, что подпись успешно провалидирована. SERVFAIL или отсутствие `ad` на заведомо подписанных доменах — признак реальной проблемы с DNSSEC.
Источники
- mailcow docs: Watchdog Thresholds — Таблица порогов watchdog, значение UNBOUND_THRESHOLD по умолчанию (5) и описание проверки: резолвинг/валидация DNSSEC внешних доменов. https://docs.mailcow.email/manual-guides/Watchdog/u_e-watchdog-thresholds/
- mailcow docs: Using an external DNS service — Два метода форвардинга DNS — forward-zone в unbound.conf и docker-compose.override.yml.d/EXTERNAL_DNS/; требование к DNSSEC-валидации у внешнего резолвера. https://docs.mailcow.email/manual-guides/Unbound/u_e-unbound-fwd/
- mailcow docs: Why unbound? — Обоснование собственного резолвера: лимиты DNSBL на публичных резолверах ломают антиспам-проверки. https://docs.mailcow.email/manual-guides/u_e-why_unbound/
- mailcow community: Issue with watchdog-mailcow whereas unbound-mailcow is healthy — Обсуждение расхождения между docker healthcheck (healthy) и функциональной DNSSEC-проверкой watchdog. https://community.mailcow.email/d/3641-issue-with-watchdog-mailcow-whereas-unbound-mailcow-is-healthy