
После ротации в логах пропадают строки: разбираю, что на самом деле делает copytruncate
Если после ночной ротации в журнале дыра в несколько секунд, а logrotate отработал без ошибок, почти наверняка виноват copytruncate: между копированием и обнулением файла всё записанное пропадает. Ниже — замер потерь на стенде, вторая беда с нулевыми байтами, безопасная схема create с сигналом и аудит за четверть часа.
Почему «ротация прошла без ошибок» ничего не доказывает
История из практики. «Клумба и газон» — компания по озеленению на 35 рабочих мест, у неё свой сервер заказов на Ubuntu 24.04: приём заявок с сайта, обмен с 1С, расписание доставки саженцев и рулонного газона. Мы взяли его на обслуживание Linux-серверов весной, а в мае случился спор с крупным клиентом: тот утверждал, что отменил заказ ночью, а система заказ провела и машина уехала. Открываю архив журнала приложения: строки идут ровно до 03:12:07, следующая — 03:12:11. Четырёх секунд нет ни в архиве, ни в текущем файле. Именно в эти секунды и пришёл запрос на отмену — или не пришёл, доказать теперь нельзя ничего.
Что обычно проверяет администратор, когда его спрашивают про целостность журналов? Смотрит systemctl status logrotate.service — exit 0. Смотрит /var/lib/logrotate/status — даты свежие. Гоняет logrotate -d — ошибок нет. И успокаивается. Но ни одна из этих проверок не отвечает на вопрос «все ли записи дошли до архива». logrotate не считает строки и не сверяет объёмы. Он выполняет операции с файлами и сообщает, что операции выполнены. Потеря данных внутри штатной операции для него не ошибка, а документированное поведение.
Ключ нашёлся в одной строке конфигурации. В /etc/logrotate.d/ лежал файл, доставшийся от подрядчика, который когда-то писал модуль обмена, и в нём была директива copytruncate. Она стоит во множестве вендорских конфигов и в большинстве ответов на форумах, потому что «ничего не надо перезапускать, и всё просто работает». Работает — до момента, когда нужно восстановить хронологию по секундам. Сам по себе copytruncate не баг, а компромисс со своей законной областью применения. Беда в том, что его ставят везде подряд и никто не считает цену. Дальше — цена в цифрах.
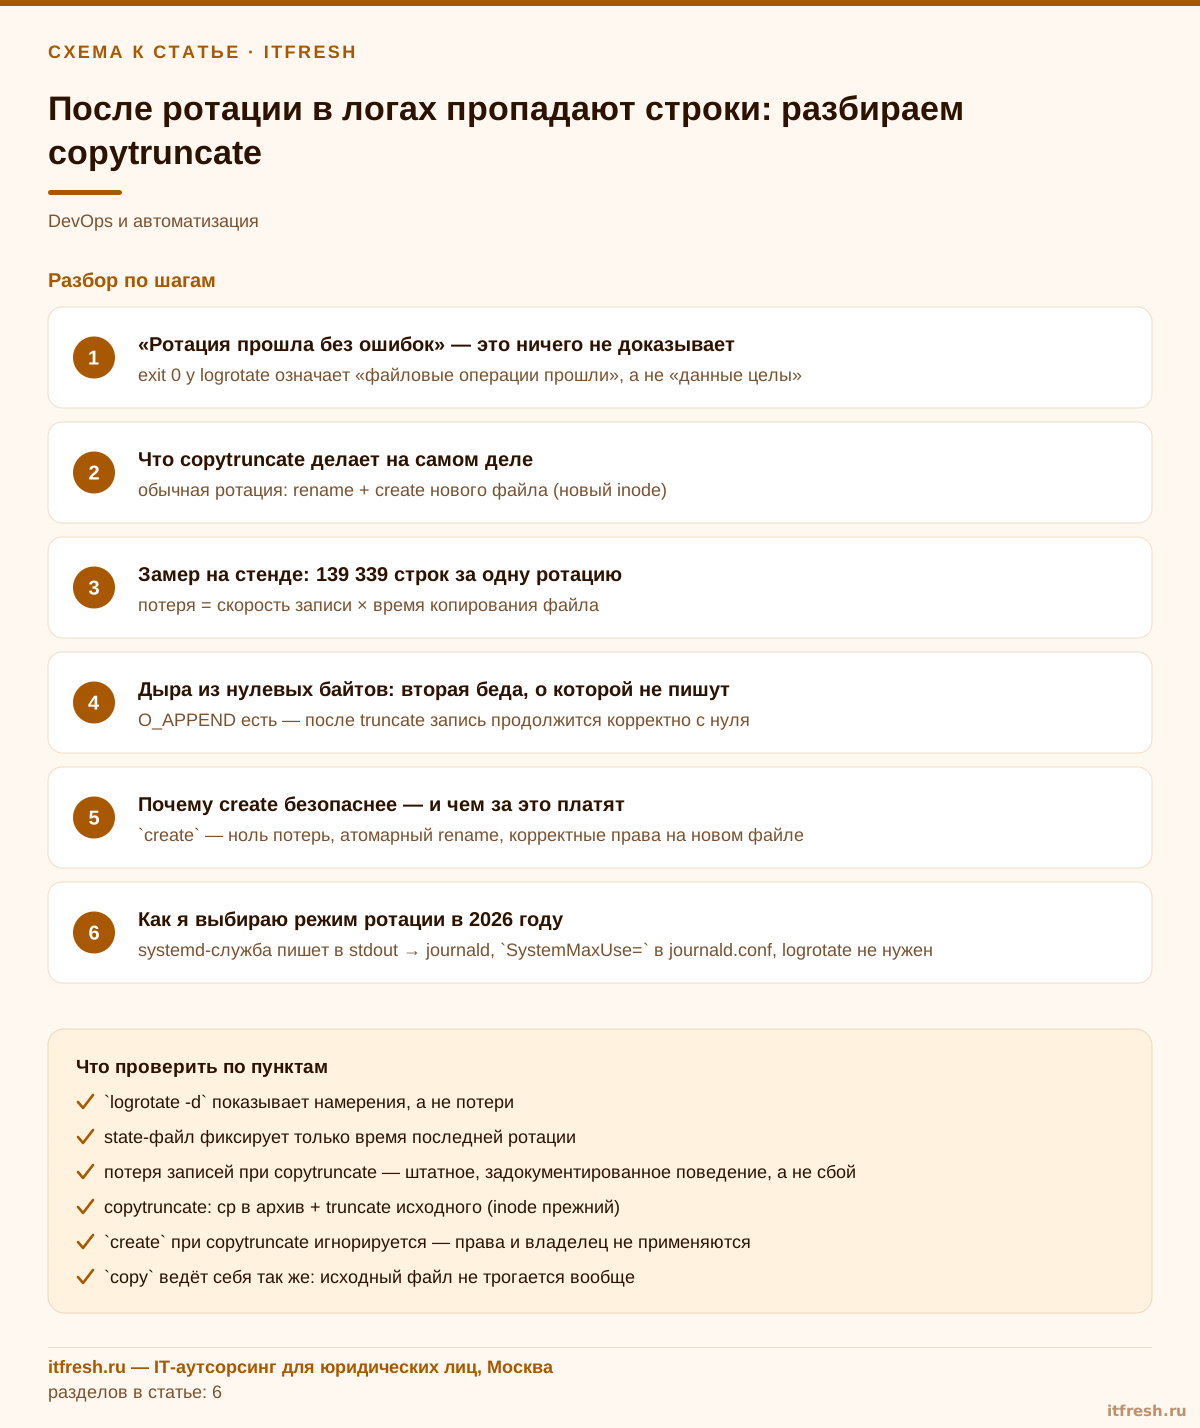
- exit 0 у logrotate означает «файловые операции прошли», а не «данные целы»
- `logrotate -d` показывает намерения, а не потери
- state-файл фиксирует только время последней ротации
- потеря записей при copytruncate — штатное, задокументированное поведение, а не сбой
Что copytruncate делает на самом деле
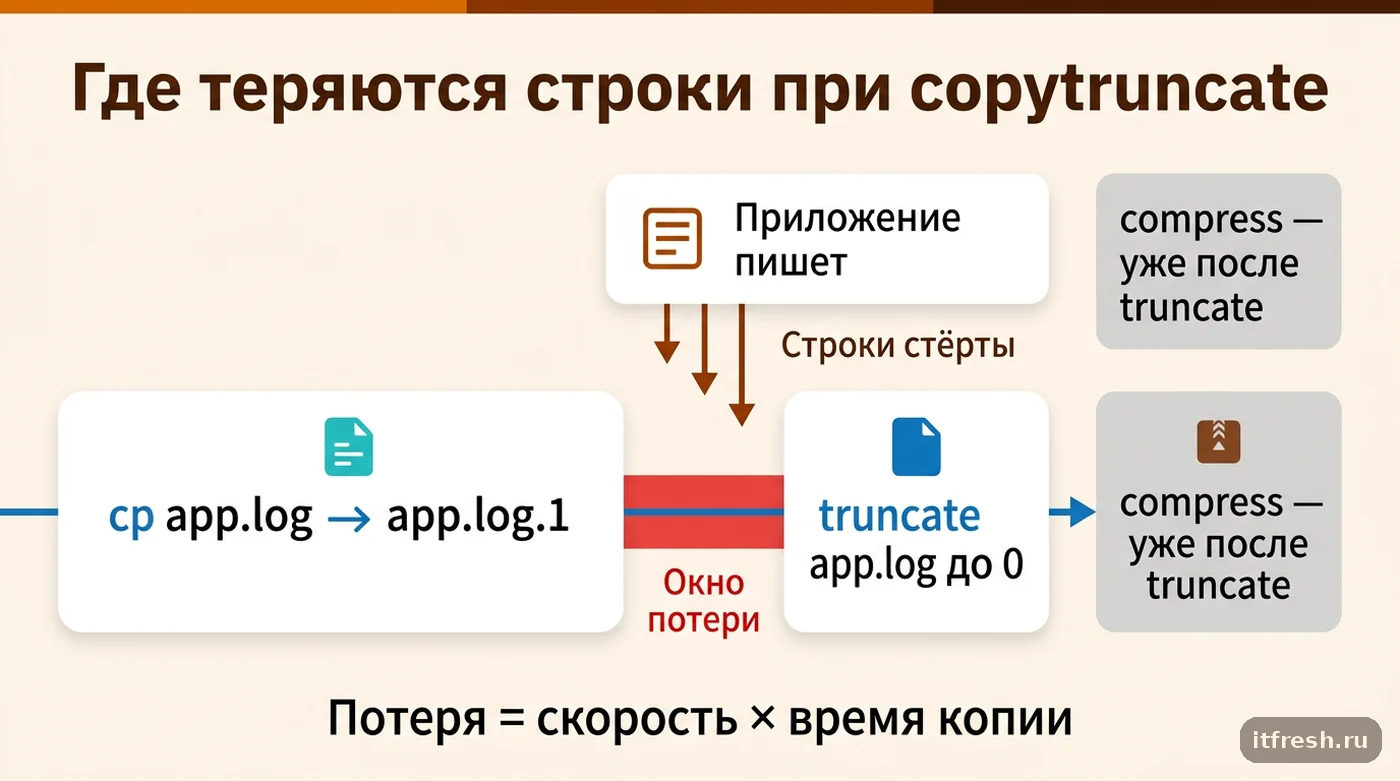
Механика простая и в мануале описана честно, без эвфемизмов. Обычная ротация — это переименование: app.log становится app.log.1, на его месте создаётся новый пустой файл. При copytruncate имя и inode остаются на месте: logrotate копирует содержимое в архивный файл, а затем обнуляет исходный вызовом truncate. В мануале logrotate(8) сказано буквально: «Truncate the original log file to zero size in place after creating a copy» и следом предупреждение — «Note that there is a very small time slice between copying the file and truncating it, so some logging data might be lost».
Между копированием и обнулением есть окно. Всё, что процесс успел записать в это окно, попадает в исходный файл после того, как копия уже снята, — и стирается вызовом truncate. Без ошибки, без записи в журнал самого logrotate, без единого признака. Посмотрите на подробный вывод — там прямым текстом видны два отдельных шага:
$ logrotate -f -v -s lr.state lr.conf
rotating log /srv/app/app.log, log->rotateCount is 3
copying /srv/app/app.log to /srv/app/app.log.1
truncating /srv/app/app.log
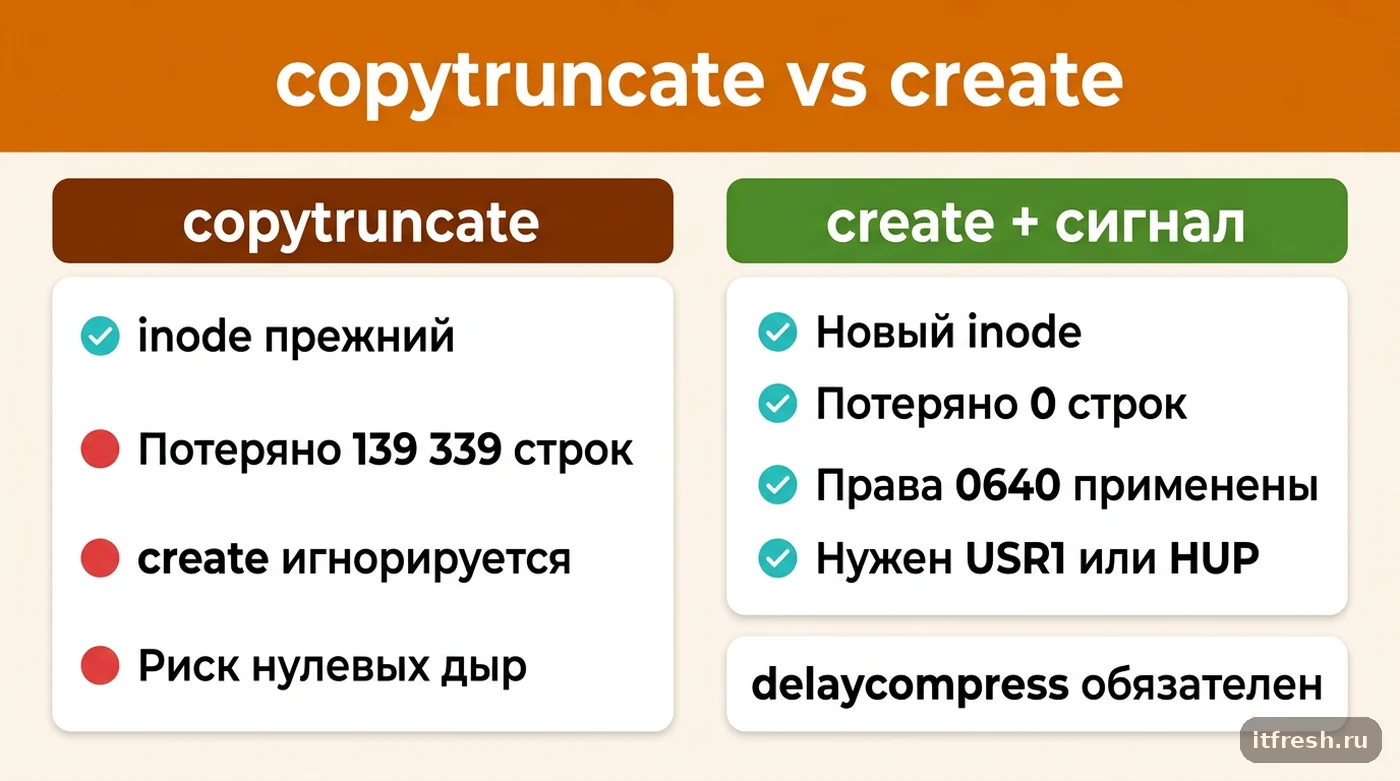
И вторая деталь, про которую забывают почти все. При copytruncate директива create перестаёт действовать — в мануале это сказано отдельной фразой: «When this option is used, the create option will have no effect, as the old log file stays in place». То есть если вы прописали create 0640 app app, рассчитывая на правильные права и владельца, — этого не произойдёт. Я проверил это на стенде с logrotate 3.21.0 — именно эта версия стоит в Ubuntu 24.04 и Debian 12: inode до ротации 315934, после ротации 315934, права остались 0644 вместо заказанных 0640. Файл тот же самый, просто пустой.
- обычная ротация: rename + create нового файла (новый inode)
- copytruncate: cp в архив + truncate исходного (inode прежний)
- `create` при copytruncate игнорируется — права и владелец не применяются
- `copy` ведёт себя так же: исходный файл не трогается вообще
Сколько строк теряет copytruncate: замер на стенде
Мне надоело спорить с подрядчиками формулировкой из мануала про «very small time slice», поэтому я собрал стенд и померил. Писатель открывает файл с флагом O_APPEND и льёт пронумерованные строки по 72 байта. Через три секунды по нему прогоняется logrotate с copytruncate. Потом простой скрипт сверяет номера строк в архиве и в новом файле с общим счётчиком писателя.
# писатель: os.open(p, O_WRONLY|O_CREAT|O_APPEND) и цикл os.write()
python3 writer.py &
sleep 3
logrotate -f -s lr.state lr.conf
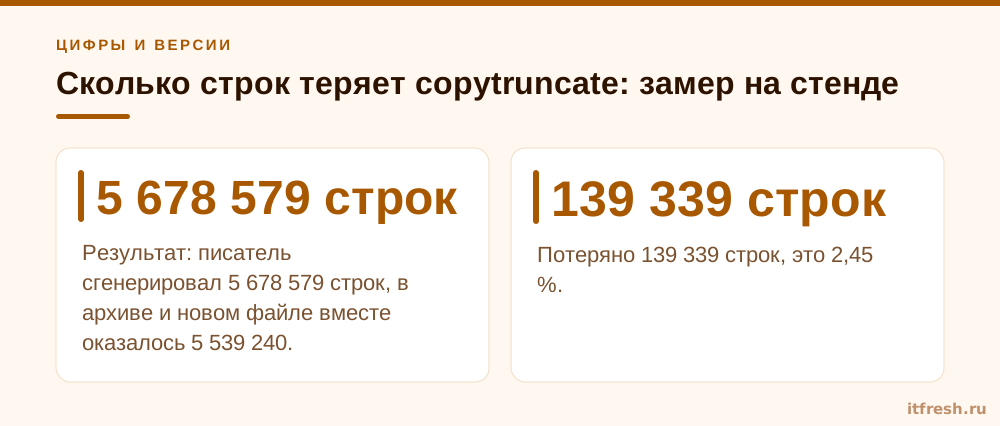
Результат: писатель сгенерировал 5 678 579 строк, в архиве и новом файле вместе оказалось 5 539 240. Потеряно 139 339 строк, это 2,45 %. И потеря не размазана — это сплошной провал: последняя строка в app.log.1 имеет номер 2880584, первая строка в новом app.log — 3019924. Ровно тот диапазон, который писался, пока шло копирование 200-мегабайтного файла. Никаких предупреждений ни в выводе logrotate, ни в syslog.
Честная оговорка, без неё цифра выглядит страшнее, чем есть. Стенд синтетический: почти миллион строк в секунду — на порядки больше, чем пишет реальное бизнес-приложение. Размер потери пропорционален произведению «скорость записи × длительность копирования». На сервере заказов «Клумбы и газона» приложение писало до 200 строк в секунду, журнал к моменту ротации дорастал до 300 МБ, а его копирование на нагруженной ВМ занимало около четырёх секунд — ровно те четыре секунды, которых не хватило в споре с клиентом. Это порядка восьмисот строк. Мало по проценту, но это сплошной кусок ровно в момент ротации, а ротацию подрядчик поставил в cron на 03:10 — как раз когда клиенты оформляют и отменяют ночные заявки.
И ещё нюанс, который часто трактуют неверно: сжатие в это окно не входит. compress отрабатывает уже после truncate, поэтому gzip на 100 МБ (около секунды на прогретом кэше) окно не расширяет. Расширяет его именно копирование — а значит, чем больше файл, тем шире дыра. Ротация раз в сутки при большом объёме журналов — худший из возможных сценариев.
- потеря = скорость записи × время копирования файла
- провал сплошной, а не выборочный: теряется непрерывный диапазон записей
- чем реже ротация и больше файл — тем шире окно потери
- `compress` окно не расширяет, он работает после truncate
Почему grep пишет «binary file matches»: дыра из нулевых байтов
Есть у copytruncate эффект пострашнее гонки, и он проявляется не всегда, а только с определённым классом программ. Всё зависит от того, как процесс открыл файл. Если он использовал флаг O_APPEND — ядро перед каждой записью само переставляет позицию в конец файла, и после обнуления процесс аккуратно продолжит писать с нулевого смещения. Если O_APPEND нет и процесс пишет по собственному счётчику позиции — после truncate он продолжит писать туда, где остановился. То есть на смещение 34 000, хотя длина файла теперь ноль.
Файловая система такое разрешает: между началом и точкой записи образуется дыра, которая при чтении отдаёт нулевые байты. Замер на моём стенде, два одинаковых писателя, разница только во флаге:
# до truncate:   noappend.log 34000   append.log 34000
# после truncate: noappend.log 34340   append.log 340
$ du -h --apparent-size noappend.log   # 34K  «логический» размер
$ du -h noappend.log                   # 4.0K реально занято на диске
$ head -c 40 noappend.log | od -c
0000000  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0  \0
Последствия неприятные и разнообразные. grep по такому файлу отвечает «binary file matches» и молчит. Парсеры, агенты сбора логов и SIEM-коллекторы либо давятся нулями, либо честно отправляют их дальше и забивают индекс мусором. ls -l показывает огромный файл, а du — крохи, из-за чего мониторинг свободного места на разделе даёт противоречивые цифры и вы теряете время на выяснение, кто врёт. А после следующей ротации весь этот нулевой хвост честно копируется в архив и сжимается, потому что gzip нули жмёт отлично, — и вы даже по объёму архивов ничего не заметите. Если нужно понять, какой файл открыт на каком дескрипторе, ls -l /proc/<pid>/fd покажет это без установки дополнительных утилит.
Кто в группе риска: самописные демоны, скрипты с перенаправлением вывода через > вместо >>, часть Java-обвязок с ручной работой через каналы NIO, старые сборки on-premise ПО. Проверить конкретный процесс просто — заглянуть в /proc/<pid>/fdinfo/<fd> и посмотреть поле flags: наличие бита 02000 (восьмеричное) означает O_APPEND.
- O_APPEND есть — после truncate запись продолжится корректно с нуля
- O_APPEND нет — образуется дыра из нулевых байтов длиной со старый файл
- признаки: `grep` говорит «binary file matches», `ls` и `du` расходятся в разы
- проверка: `cat /proc/<pid>/fdinfo/<номер fd>` — смотреть поле flags на бит 02000
Почему create безопаснее и чем за это платят
Тот же стенд, тот же писатель, конфиг отличается одной строкой: вместо copytruncate стоит create 0640 app app. Результат: сгенерировано 5 843 143 строки, сохранилось 5 843 143. Потеряно ноль. Права на новом файле применились корректно — 0640, новый inode. Никакой гонки нет в принципе, потому что rename — атомарная операция, ни один байт не проходит мимо.
Но есть цена, и о ней надо знать заранее, иначе вы получите проблему хуже исходной. В том же замере новый app.log остался пустым — ноль строк. Писатель продолжил лить данные в старый файловый дескриптор, то есть в файл, который теперь называется app.log.1. Так и должно быть: переименование не затрагивает открытые дескрипторы, процесс пишет в inode, а не в имя. Если бы я не остановил стенд, архив рос бы бесконечно, а «текущий» журнал так и оставался бы пустым — и в мониторинге это выглядит как «приложение перестало логировать».
Отсюда железное правило: create работает только в паре с уведомлением процесса. Приложение должно закрыть старый дескриптор и открыть файл заново. Для nginx документация описывает процедуру буквально: переименовать файлы, отправить мастер-процессу USR1, дождаться, пока рабочие процессы переоткроют файлы. Для большинства демонов подходит SIGHUP, в мануале logrotate это показано классическим примером с killall -HUP syslogd. На сервере «Клумбы и газона» модуль заказов оказался написан на Python с logging.handlers.WatchedFileHandler — он сам замечает, что файл переименован, и открывает новый. То есть сигнал ему даже не нужен, а copytruncate там стоял исключительно по привычке подрядчика.
/var/log/nginx/*.log {
    daily
    rotate 14
    missingok
    notifempty
    compress
    delaycompress
    create 0640 www-data adm
    su root adm
    sharedscripts
    postrotate
        [ -f /run/nginx.pid ] && kill -USR1 $(cat /run/nginx.pid)
    endscript
}
Про delaycompress — это не украшение, а необходимость именно в этой связке. Между отправкой сигнала и фактическим переоткрытием файлов рабочими процессами проходит время; они какое-то время ещё дописывают в старый файл. delaycompress откладывает сжатие предыдущего журнала до следующего цикла, и вы не получите обрезанный .1.gz. Мануал формулирует прямо: «It can be used when some program cannot be told to close its logfile and thus might continue writing to the previous log file for some time». Обязателен везде, где ротация опирается на сигналы.
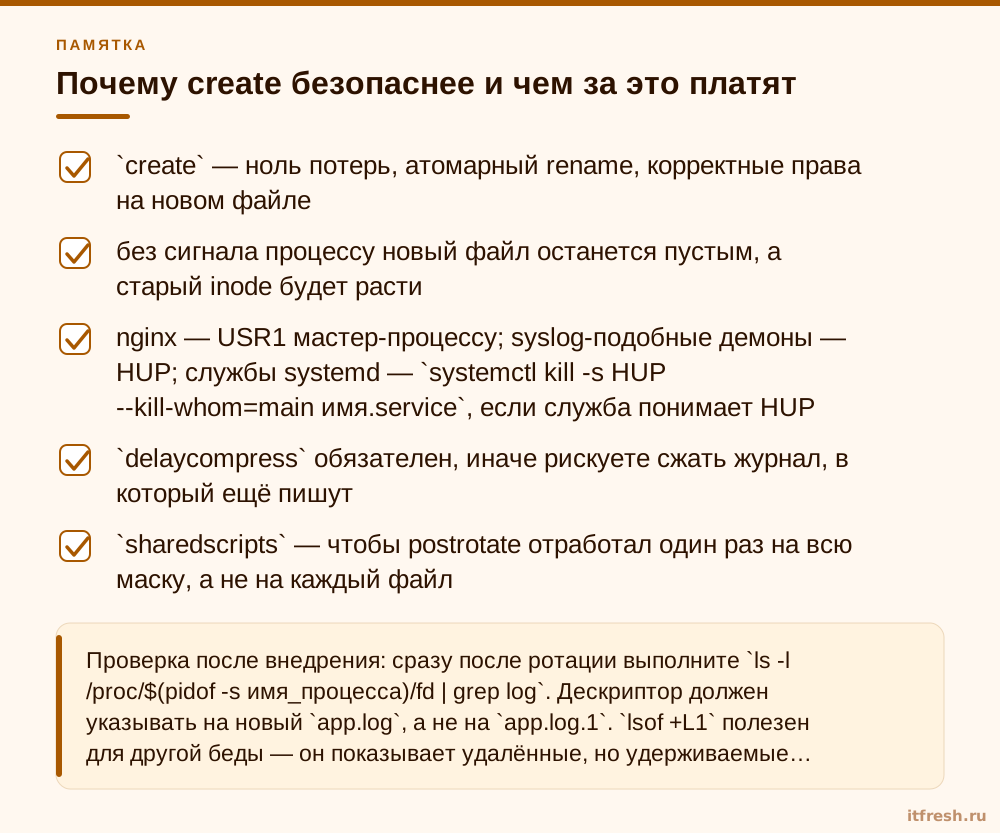
- `create` — ноль потерь, атомарный rename, корректные права на новом файле
- без сигнала процессу новый файл останется пустым, а старый inode будет расти
- nginx — USR1 мастер-процессу; syslog-подобные демоны — HUP; службы systemd — `systemctl kill -s HUP --kill-whom=main имя.service`, если служба понимает HUP
- `delaycompress` обязателен, иначе рискуете сжать журнал, в который ещё пишут
- `sharedscripts` — чтобы postrotate отработал один раз на всю маску, а не на каждый файл
Какой режим ротации выбрать в 2026 году
Свежая версия logrotate — 3.22.0 от 1 июня 2024 года, она же в Debian 13. В Debian 12 и Ubuntu 24.04 стоит 3.21.0, и для наших задач разницы между ними нет. Механика copytruncate за годы не изменилась и не изменится: это не баг, который однажды починят. Поэтому решение принимается один раз, при настройке, и вот моя схема по приоритету.
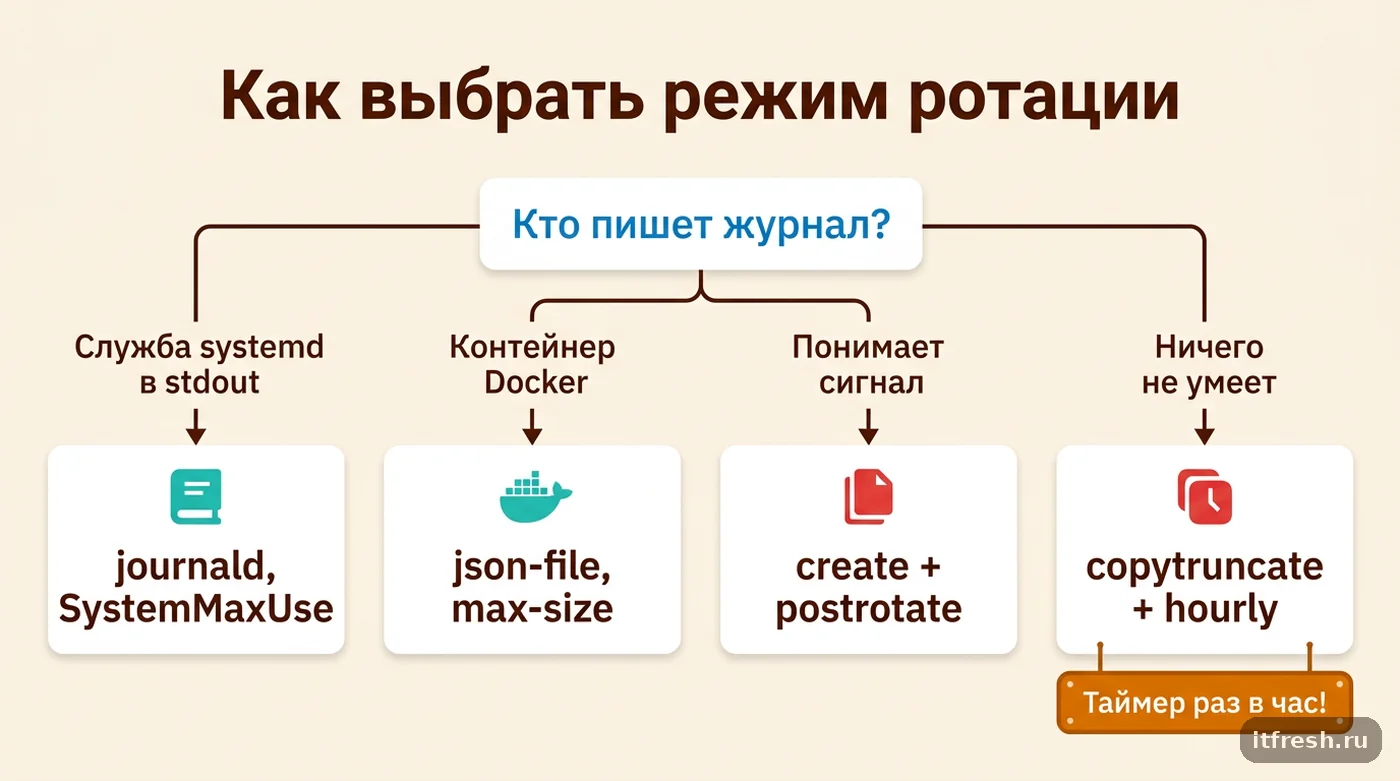
Первое: посмотреть, нужен ли logrotate вообще. Огромную долю случаев он закрывает избыточно. Если служба под systemd и пишет в stdout — журнал ведёт journald, и ротацией управляют SystemMaxUse= и MaxRetentionSec= в journald.conf, а не logrotate. Контейнеры Docker — драйвер json-file с max-size и max-file в блоке log-opts файла /etc/docker/daemon.json (применяется к вновь созданным контейнерам), и никаких сторонних ротаторов. PostgreSQL — встроенный logging_collector с log_rotation_age и log_rotation_size. Apache — rotatelogs в конвейере. Во всех этих случаях ротация делается самим писателем, окна потери нет по построению, и лезть туда с logrotate — только плодить конфликты.
Второе: если logrotate всё же нужен — create плюс postrotate с сигналом. Это рабочая лошадка, и именно так у меня настроено абсолютное большинство клиентских серверов. Проверить, что приложение умеет переоткрывать файлы, стоит одной командой перед внедрением: отправить сигнал вручную и посмотреть в lsof, сменился ли inode.
Третье: renamecopy, если нужен перенос архива на другой раздел через olddir. Директива переименовывает журнал во временный файл с расширением .tmp в той же директории, запускает postrotate и уже потом копирует его в итоговое имя. Гонки как у copytruncate тут нет, но процесс файл тоже не переоткрывает — поэтому как замену сигналу её рассматривать нельзя, в связке с ней сигнал по-прежнему нужен.
И только четвёртым номером — copytruncate, когда программа наглухо не умеет ни переоткрывать журнал, ни ротировать сама, а перезапускать её ради ротации нельзя. Тогда я снижаю ущерб: ротирую по размеру и делаю файлы мелкими, maxsize 50M плюс hourly. Но здесь есть ловушка, которую мануал описывает прямо: logrotate по умолчанию запускается раз в сутки через logrotate.timer или cron, и hourly без изменения расписания ничего не даёт — maxsize тоже проверяется только в момент запуска. Нужно переопределить таймер: systemctl edit logrotate.timer и в секции [Timer] задать пустой OnCalendar=, а следом OnCalendar=hourly. Тогда окно копирования сжимается до долей секунды, и потеря — до десятков строк вместо тысяч.
- systemd-служба пишет в stdout → journald, `SystemMaxUse=` в journald.conf, logrotate не нужен
- Docker → драйвер json-file, `max-size` и `max-file` в daemon.json
- PostgreSQL → `logging_collector`, `log_rotation_age`, `log_rotation_size`
- приложение понимает сигнал → `create` + `postrotate` + `delaycompress`
- перенос архива на другой раздел → `renamecopy` + `olddir`, сигнал всё равно нужен
- ничего не подходит → `copytruncate` + `maxsize 50M` + `hourly` + таймер logrotate раз в час
Как проверить ротацию логов на сервере за 15 минут
Порядок действий, которым я прохожу новый сервер при приёме на обслуживание. Занимает четверть часа, а находит проблемы, которые иначе всплыли бы в самый неудачный момент — как у «Клумбы и газона», где на одном сервере мы нашли четыре конфига с copytruncate, из которых по-настоящему нужен был только один: у старого SMS-шлюза, который не умеет ни сигналов, ни собственной ротации.
# 1. Кто ротируется через copytruncate
grep -RIn --include='*' -e copytruncate /etc/logrotate.conf /etc/logrotate.d/

# 2. Что вообще будет сделано в ближайший прогон
logrotate -d /etc/logrotate.conf 2>&1 | grep -E 'rotating|copying|truncating|renaming'

# 3. Работает ли таймер и когда сработает
systemctl list-timers logrotate.timer --all

# 4. Удалённые, но удерживаемые процессами журналы
lsof +L1 2>/dev/null | grep -E '/var/log|/srv'

# 5. Разреженные журналы (нулевые дыры)
find /var/log -type f -size +1M -printf '%S\t%p\n' | awk '$1 < 0.5'

# 6. Разрывы по времени в самом журнале
tail -n 3 /var/log/app/app.log.1; head -n 3 /var/log/app/app.log
Отдельно проверьте таймер. В современных дистрибутивах ротацию запускает logrotate.timer, а не cron. В апстримовом юните стоят OnCalendar=daily, RandomizedDelaySec=1h и Persistent=true: запуск разбросан в пределах часа, а пропущенный из-за выключения запуск догоняется при следующей загрузке. Дистрибутивы и прошлые администраторы юнит иногда переопределяют — systemctl cat logrotate.timer покажет, что действует на самом деле. Если Persistent отключён, а сервер выключают на ночь, файлы разрастаются, и окно потери при copytruncate растёт вместе с ними. Если хочется разобраться с таймерами глубже, у меня есть отдельный текст про systemd timer вместо cron.
Финальная проверка, ради которой всё затевалось. Прогоните ротацию вручную под нагрузкой и сверьте счётчики: wc -l на архиве плюс wc -l на новом файле должно совпасть с тем, сколько строк приложение записало за интервал. Если у приложения есть счётчик обработанных запросов в метриках — сверяйтесь с ним. На сервере «Клумбы и газона» после перевода модуля заказов на create мы две недели делали такую сверку каждую ночь: расхождение — ноль строк. Кстати, если журналы читает агент мониторинга, проверьте и его: потери бывают и на стороне сборщика, как в случае с maxdelay в logrt Zabbix.
Финальная проверка, ради которой всё затевалось. Прогоните ротацию вручную под нагрузкой и сверьте счётчики: wc -l на архиве плюс wc -l на новом файле должно совпадать с тем, сколько строк приложение записало за интервал. Если у приложения есть счётчик обработанных запросов в метриках — сверяйтесь с ним. Расхождение в тысячу строк на ровном месте — это ваш copytruncate, и теперь вы знаете, что с ним делать.
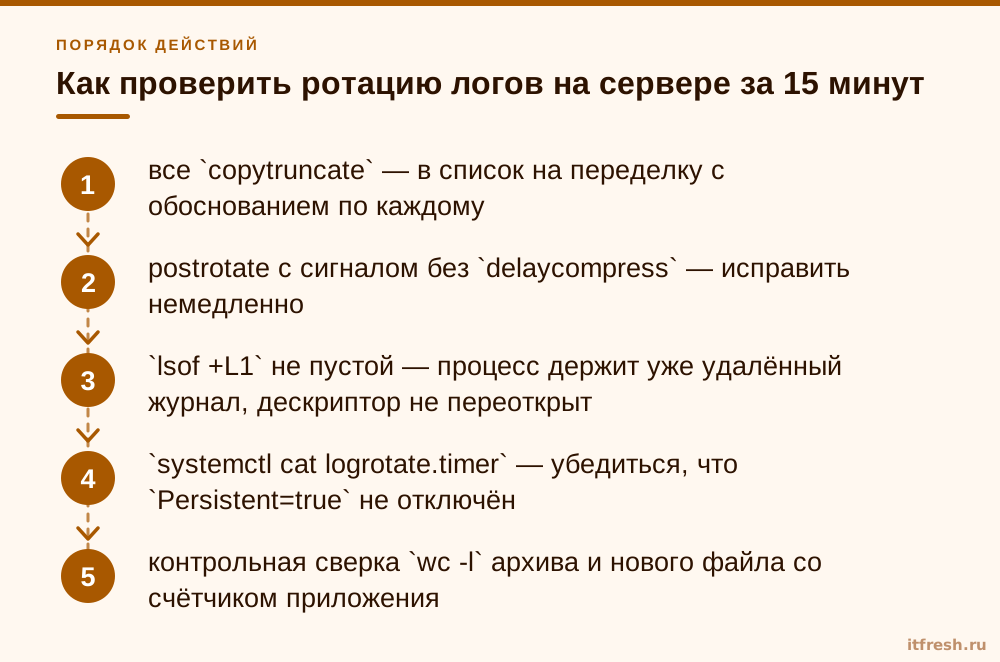
- все `copytruncate` — в список на переделку с обоснованием по каждому
- postrotate с сигналом без `delaycompress` — исправить немедленно
- `lsof +L1` не пустой — процесс держит уже удалённый журнал, дескриптор не переоткрыт
- `systemctl cat logrotate.timer` — убедиться, что `Persistent=true` не отключён
- контрольная сверка `wc -l` архива и нового файла со счётчиком приложения
- `find -printf '%S'` меньше 0,5 — разреженный журнал, ищите copytruncate
Частые вопросы
Насколько велика потеря при copytruncate на реальном сервере?
Считается как «скорость записи × время копирования файла». На моём синтетическом стенде при почти миллионе строк в секунду и файле 200 МБ пропало 139 339 строк, 2,45 %. На типовом бизнес-приложении, которое пишет 200 строк в секунду, и журнале 300 МБ, копируемом 4–6 секунд, потеряется около тысячи строк. Мало по проценту, но это сплошной провал ровно в момент ротации, то есть чаще всего ночью.
Почему у меня после ротации новый лог-файл остаётся пустым?
Классический побочный эффект режима create без уведомления процесса. Переименование файла не затрагивает уже открытый дескриптор: приложение продолжает писать в старый inode, который теперь называется app.log.1. Лечится добавлением postrotate со скриптом отправки сигнала — USR1 для nginx, HUP для большинства демонов — и директивой delaycompress.
Почему grep пишет «binary file matches» по обычному текстовому логу?
Почти наверняка в файле дыра из нулевых байтов. Так бывает, когда процесс открыл журнал без флага O_APPEND и после truncate продолжил писать по старому смещению. Проверьте расхождение: `du --apparent-size -h файл` против `du -h файл`. Если логический размер в разы больше реально занятого — это оно, и причина в copytruncate.
Можно ли оставить copytruncate, если переделывать некогда?
Можно, но осмысленно. Ротируйте по размеру: maxsize 50M плюс hourly, и обязательно переведите logrotate.timer на ежечасный запуск — иначе hourly и maxsize проверяются раз в сутки. Окно копирования сжимается до долей секунды, потеря — до десятков строк. Для журналов, которые служат доказательством в спорах и расследованиях, этого всё равно недостаточно.
Работает ли директива create вместе с copytruncate?
Нет. В мануале сказано отдельной фразой: при copytruncate опция create не имеет эффекта, поскольку исходный файл остаётся на месте. Проверяется за одну команду — сравните `stat -c '%i %a' файл` до и после принудительной ротации: неизменный inode и старые права означают, что вся ваша настройка прав и владельца декоративная.
Чем renamecopy отличается от copytruncate?
renamecopy переименовывает журнал во временный файл с расширением .tmp в той же директории, выполняет postrotate и затем копирует его в итоговое имя. Гонки «скопировали — обнулили» нет, данные не теряются. Но процесс файл не переоткрывает, поэтому сигнал в postrotate всё равно нужен: директива решает задачу переноса архива на другой раздел, а не живучести журнала.
Источники
- logrotate(8), man-страница — Директивы copytruncate (предупреждение о потере данных между копированием и обнулением, create не действует), renamecopy, delaycompress, maxsize, hourly (нужен ежечасный запуск logrotate). https://man7.org/linux/man-pages/man8/logrotate.8.html
- logrotate, релизы на GitHub — 3.22.0 от 01.06.2024, 3.21.0 от 13.12.2023; в 3.22.0 исправлено распределение запусков systemd-таймера. https://github.com/logrotate/logrotate/releases
- logrotate: examples/logrotate.timer — Апстримовый юнит: OnCalendar=daily, RandomizedDelaySec=1h, Persistent=true. https://github.com/logrotate/logrotate/blob/main/examples/logrotate.timer
- nginx: Controlling nginx — Сигнал USR1 — переоткрыть журналы; процедура ротации: переименовать файлы, отправить USR1 мастер-процессу. https://nginx.org/en/docs/control.html
- systemd: journald.conf(5) — SystemMaxUse=, SystemMaxFileSize=, MaxRetentionSec= — управление объёмом журнала без внешней ротации. https://www.freedesktop.org/software/systemd/man/latest/journald.conf.html
- Docker: JSON File logging driver — Параметры max-size и max-file в log-opts daemon.json, действуют для новых контейнеров. https://docs.docker.com/engine/logging/drivers/json-file/