
Разрешил HTTPS и ping по IPv6, а сервер всё равно пропадает из сети: разбор Neighbor Discovery в firewall
Если сервер по IPv6 то доступен, то нет, а HTTPS и ping разрешены, почти наверняка firewall режет Neighbor Discovery — ICMPv6 типов 133–136, которые в IPv6 заменяют ARP. Ниже — как доказать это счётчиками за пять минут, минимальный набор правил для nftables и ip6tables, соседние грабли и разбор B2B-портала швейной фабрики.
Симптом: «иногда не открывается», а у вас всё работает
Такие обращения я не люблю больше всего. Клиент пишет с мобильного: «каталог не грузится». Через минуту грузится. Из офиса по Wi-Fi всё стабильно, с телефона — через раз. Мониторинг молчит, потому что проверяет сервис по IPv4. В журналах nginx ничего аномального: запросы приходят, отвечают за 30–60 мс, ошибок нет — просто в какие-то моменты запросов нет вообще. Такие «дырки» никто не считает аварией, пока не посмотрит на правила межсетевого экрана и информационной безопасности под правильным углом.
Ключ к разгадке — кто жалуется. Если у домена есть AAAA-запись, а у клиента есть IPv6 (у части мобильных операторов и домашних провайдеров он уже включён), клиент пойдёт по IPv6 первым. Браузер с Happy Eyeballs быстро откатится на IPv4 при неудачной попытке нового соединения, и человек заметит лишь задержку. А вот уже установленное соединение или мобильное приложение со своим HTTP-клиентом просто висят до таймаута. Отсюда «долго думает, потом открывается» и «в приложении отваливается, а в браузере нормально».
Дальше начинается набор ложных версий: виноват провайдер, хостер, keepalive в nginx, надо крутить worker_connections. Я через это проходил не раз. Когда сервер по IPv6 «мигает» с периодом в десятки секунд и восстанавливается сам, первым делом я проверяю одно: пропускает ли firewall служебные ICMPv6-сообщения, без которых соседний маршрутизатор не может узнать MAC-адрес сервера.
- AAAA-запись есть, сервис отвечает, но с мобильного интернета — через раз.
- Пропадания короткие, самовосстанавливаются, в журналах приложения пусто.
- Проблема исчезает, пока с сервера идёт постоянный исходящий трафик, и возвращается после паузы.
- ping6 с соседнего хоста проходит — сразу после любого обмена трафиком.
Что такое Neighbor Discovery и почему firewall может его сломать
В IPv4 соответствие «IP-адрес → MAC» ищет ARP — отдельный протокол канального уровня, который IP-фильтр просто не видит. В IPv6 ARP нет. Его работу выполняет Neighbor Discovery Protocol из RFC 4861, и главная ловушка в том, что он ездит внутри обычных IPv6-пакетов поверх ICMPv6. То есть проходит через те же цепочки firewall, что и HTTPS. Заблокировали ICMPv6 «на всякий случай» — заблокировали адресацию.
Пять сообщений, которые стоит знать наизусть: Router Solicitation — 133, Router Advertisement — 134, Neighbor Solicitation — 135, Neighbor Advertisement — 136, Redirect — 137. Neighbor Solicitation — аналог ARP-запроса: «кто держит этот адрес, сообщи канальный адрес». Первичный запрос идёт не широковещательно, а на solicited-node multicast-адрес из ff02::1:ff00:0/104, вычисляемый из последних 24 бит искомого адреса. Neighbor Advertisement — ответ.
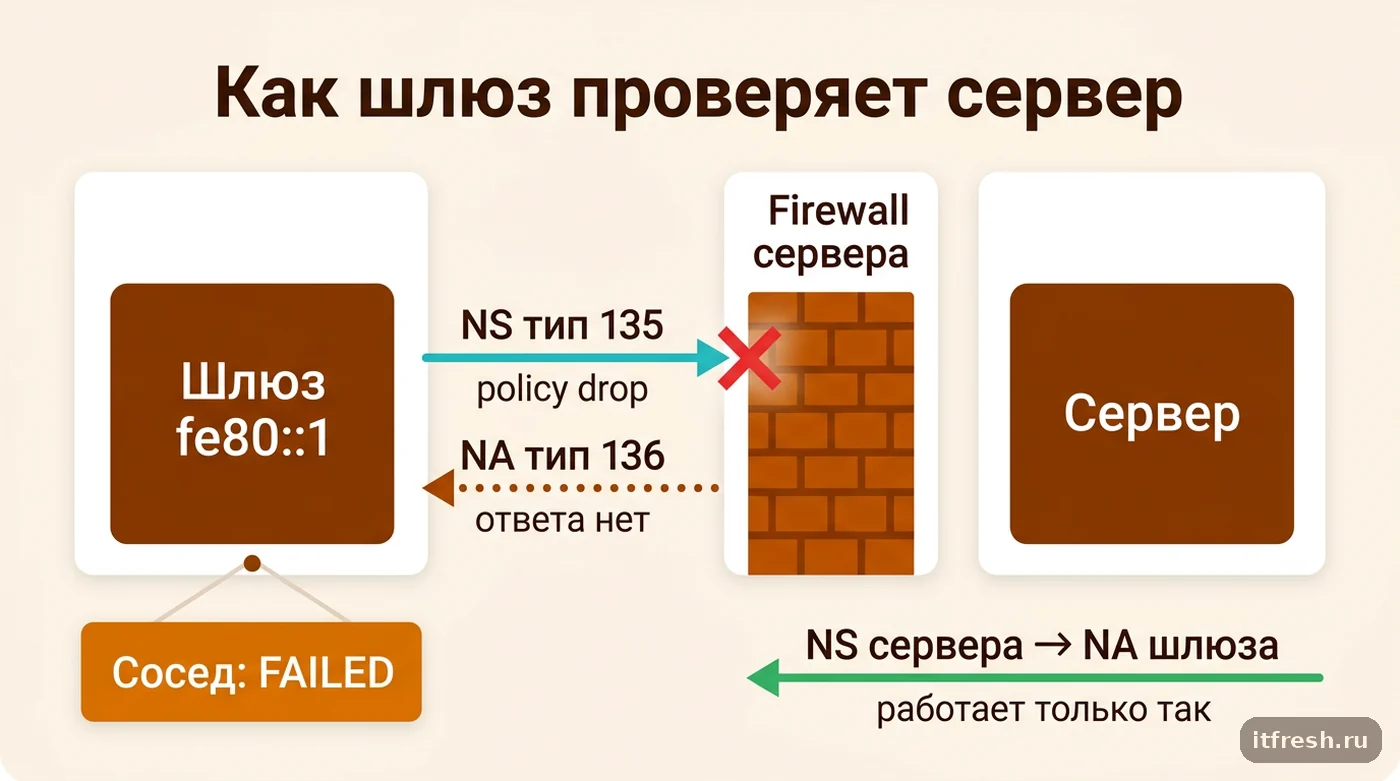
Две функции ND ломаются особенно обидно. Duplicate Address Detection из RFC 4862: перед использованием адреса узел шлёт NS на этот адрес с неопределённым источником ::. Neighbor Unreachability Detection: сосед (чаще всего маршрутизатор хостера) периодически переспрашивает unicast-запросом NS, жив ли ещё ваш MAC. Не ответили — запись у него переходит в FAILED, пакеты к вам он больше не отправляет, пока снова не узнает ваш адрес. Все ND-сообщения отправляются с Hop Limit 255, и получатель обязан это проверить — так гарантируется, что пакет не прошёл через маршрутизатор и пришёл из вашего сегмента.
Почему правило ct state established,related не спасает. Подсистема conntrack в Linux не отслеживает ND-сообщения: начиная с ядра 2.6.29 они помечаются как untracked, а на более старых ядрах попадали в invalid. Поэтому входящий NS не является продолжением какого-то «соединения» и проваливается в policy drop, если для него нет отдельного разрешающего правила.
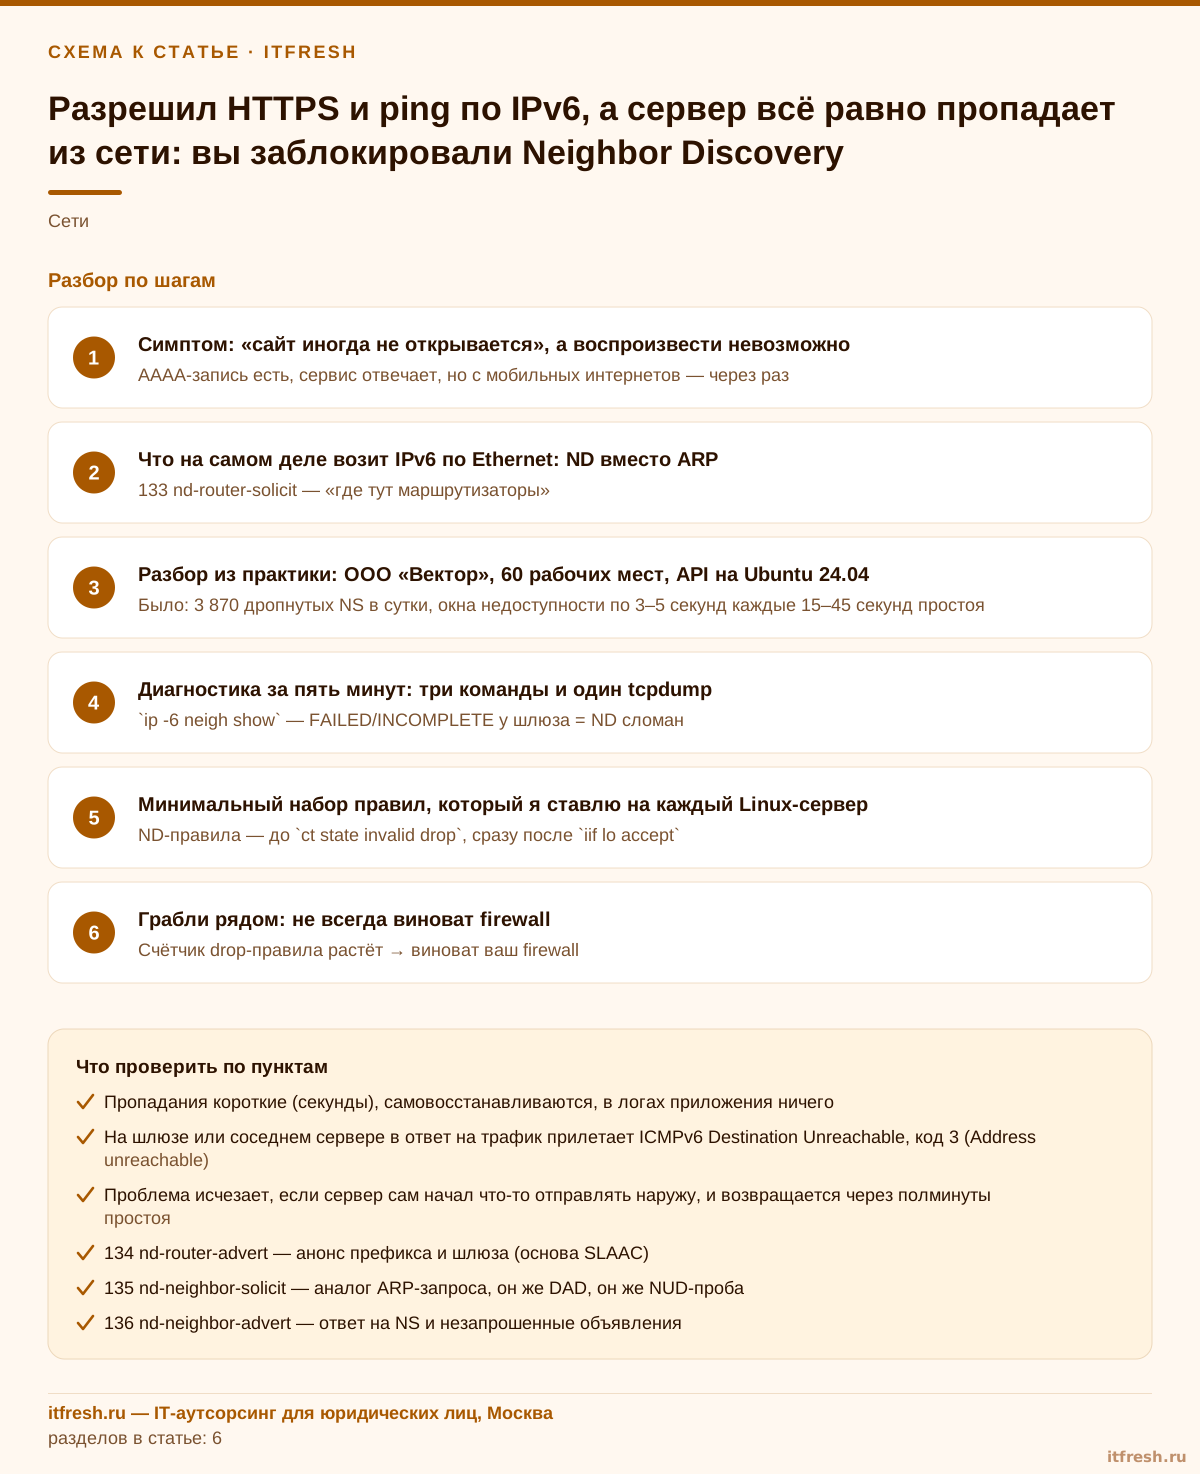
- 133 nd-router-solicit — «где тут маршрутизаторы»;
- 134 nd-router-advert — анонс префикса и шлюза, основа SLAAC;
- 135 nd-neighbor-solicit — аналог ARP-запроса, он же DAD и проба NUD;
- 136 nd-neighbor-advert — ответ на NS и незапрошенные объявления;
- 137 nd-redirect — «ходи к соседу напрямую», на серверах обычно не нужен.
Разбор: B2B-портал фабрики «Игла Мастер» и пропадающий IPv6
Условный клиент — пошивочное предприятие «Игла Мастер», 42 рабочих места. Помимо офиса и цеха у них арендованный выделенный сервер в дата-центре с B2B-порталом: оптовые покупатели и торговые представители заказывают партии с телефонов, заказы падают в 1С. Стек — Ubuntu 24.04 LTS, nginx 1.24 перед PHP-приложением, firewall на nftables. Хостер выдал /64 и шлюз fe80::1, адрес прописан статически в netplan. Жалоба: «у торгпредов приложение отваливается в дороге, а в офисе всё работает».
Правила input прошлый подрядчик написал аккуратно: policy drop, ct state established,related accept, ct state invalid drop, iif lo accept, echo-request с лимитом, tcp dport { 22, 80, 443 } accept. Из ICMPv6 кроме ping были разрешены только nd-neighbor-advert и nd-router-advert — логика «ответы пускаем, запросы нет». Поэтому сервер сам прекрасно узнавал MAC шлюза: его NS уходил, ответный NA проходил. А вот NS от шлюза, которым тот проверял, жив ли сервер, падал в drop. Больше года это не проявлялось: сервер каждые 10 секунд синхронизировал остатки с внешним сервисом, и при таком плотном обмене обе стороны регулярно обновляли записи друг о друге — собственные NS сервера к шлюзу несут его канальный адрес. До неудачной проверки со стороны шлюза дело доходило редко. Как именно маршрутизатор хостера обновляет кэш, снаружи не видно, но счётчики дали однозначную картину.
Сломалось после того, как синхронизацию перенесли на офисный сервер 1С и фоновый исходящий трафик пропал. Механика стала такой: запись о сервере у шлюза устаревала, при очередном входящем пакете шлюз начинал проверку unicast-запросами NS, не получал ответа и помечал сервер недостижимым. Сервер пропадал до момента, когда сам обращался к шлюзу, и всё повторялось. Точные таймеры у маршрутизатора хостера свои; для ориентира: в Linux базовое время достижимости 30 секунд со случайным разбросом от 0,5 до 1,5, а проба NUD — три unicast-запроса с интервалом в секунду.
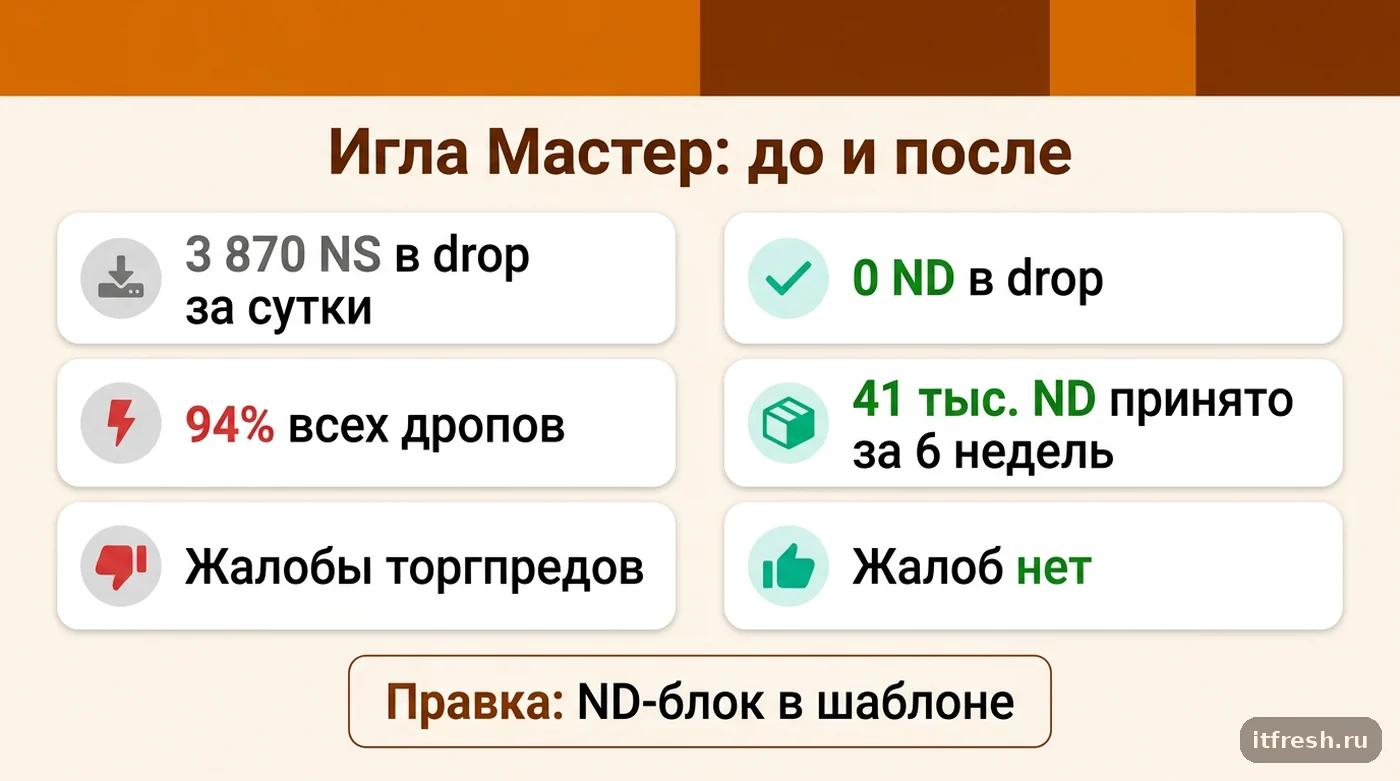
Доказали за сутки: временно поставили отдельный счётчик на NS перед правилами и логирование с лимитом на финальный drop, оставили на сутки. 3 870 отброшенных пакетов типа 135 при 4 100 дропов всего — 94 % того, что резал firewall, были соседи, пытавшиеся проверить сервер. Добавили ND-блок из следующего раздела, применили ruleset атомарно, без разрыва сессий. За шесть недель наблюдения — ни одного пропадания, счётчик ND-правила накрутил 41 тысячу пакетов, жалобы торгпредов прекратились.
- Было: 3 870 отброшенных NS в сутки, окна недоступности после каждой паузы в трафике.
- Стало: 0 отброшенных ND, 41 тысяча принятых ND-пакетов за 6 недель.
- Затраты: около 3 часов на диагностику и правку, без простоя сервиса.
- Побочный эффект: правило на MLD и ошибки ICMPv6 добавили в общий шаблон всех серверов.
Как найти проблему с ND за пять минут: три команды и tcpdump
Начинаю с таблицы соседей — она показывает картину глазами ядра.
ip -6 neigh show dev ens3
# fe80::1 dev ens3 lladdr 00:00:5e:00:53:01 router STALE

ip -6 addr show dev ens3 | grep -E 'tentative|dadfailed'
# пусто — хорошо; tentative/dadfailed — не прошёл DAD

ip -6 route show default
sysctl net.ipv6.conf.all.forwarding net.ipv6.conf.ens3.accept_ra
Если запись о шлюзе висит в INCOMPLETE или FAILED, ваш сервер не получает ответных NA. Если же у вас всё выглядит нормально, а снаружи сервер пропадает, проблема на стороне соседа: это он не может получить ответ от вас. Именно такой случай был в разборе выше.
Второй шаг — посмотреть, что вы на самом деле выбрасываете. В nftables это делается счётчиками, а не догадками.
# временный счётчик ND первым правилом цепочки
nft insert rule inet filter input icmpv6 type { nd-neighbor-solicit, nd-neighbor-advert } counter comment "nd-debug"

# смотреть счётчики и номера правил (handle)
nft -a list chain inet filter input

# ND-сообщения на интерфейсе глазами
tcpdump -ni ens3 'icmp6 and ip6[40] >= 133 and ip6[40] <= 137'
nft insert без указания позиции ставит правило в начало цепочки. Правило без вердикта только считает и пропускает пакет дальше, поэтому поведение firewall не меняется. После диагностики удалите его по handle через nft delete rule.
Про tcpdump честно: фильтр ip6[40] читает байт сразу за 40-байтовым заголовком IPv6 и работает, только если нет заголовков расширения. Для ND в локальном сегменте так почти всегда, но если фильтр молчит, а трафик должен быть, запустите tcpdump -ni ens3 -vv icmp6 — там типы будут расшифрованы словами. И не бойтесь логировать отброшенное, только обязательно с limit rate, иначе на нагруженном хосте утопите journald.
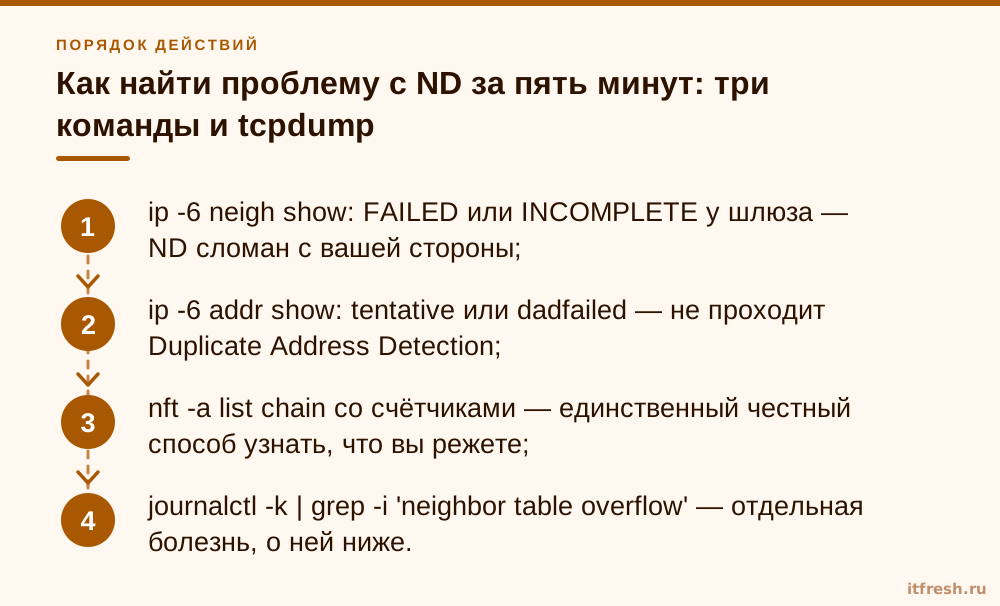
- ip -6 neigh show: FAILED или INCOMPLETE у шлюза — ND сломан с вашей стороны;
- ip -6 addr show: tentative или dadfailed — не проходит Duplicate Address Detection;
- nft -a list chain со счётчиками — единственный честный способ узнать, что вы режете;
- journalctl -k | grep -i 'neighbor table overflow' — отдельная болезнь, о ней ниже.
Какие правила nftables и ip6tables разрешить для ND и ICMPv6
Этот блок у меня в шаблоне любого хоста с IPv6. Перед применением на удалённом сервере обязательно готовлю откат — как это делать, чтобы не потерять SSH, я разбирал в статье nft -c проходит успешно, а после применения пропадает SSH.
#!/usr/sbin/nft -f
flush ruleset

table inet filter {
  chain input {
    type filter hook input priority filter; policy drop;
    iif lo accept

    # ND: только из своего сегмента (hop limit 255)
    icmpv6 type { nd-router-solicit, nd-router-advert, nd-neighbor-solicit, nd-neighbor-advert } ip6 hoplimit 255 counter accept

    # MLD приходит с hop limit 1 — отдельным правилом
    icmpv6 type { mld-listener-query, mld-listener-report, mld-listener-done, mld2-listener-report } counter accept

    ct state established,related accept
    ct state invalid drop

    # ошибки ICMPv6: без packet-too-big сломается PMTUD
    icmpv6 type { destination-unreachable, packet-too-big, time-exceeded, parameter-problem } accept
    icmpv6 type echo-request limit rate 10/second accept
    icmp type echo-request limit rate 10/second accept

    tcp dport { 22, 80, 443 } accept
    limit rate 5/minute log prefix "nft-drop-in: " level info
    counter
  }
  chain forward { type filter hook forward priority filter; policy drop; }
  chain output { type filter hook output priority filter; policy accept; }
}
Первый нюанс — порядок. На современных ядрах ND помечается как untracked и под ct state invalid не попадает, но я всё равно ставлю ND-блок сразу после iif lo: так правило не зависит ни от версии ядра, ни от того, что кто-то позже допишет в шаблон «ct state untracked drop». Второй нюанс — hop limit. Проверка ip6 hoplimit 255 для типов 133–136 полезна: она отсекает поддельные ND извне сегмента, как и предписывает RFC 4861. Но сообщения MLD отправляются с Hop Limit 1, и накрыв их тем же условием, вы выбросите управление multicast-группами, от которого зависит MLD snooping на коммутаторах. Поэтому MLD — отдельным правилом.
Если на хосте всё ещё ip6tables, эквивалент такой:
ip6tables -A INPUT -p icmpv6 --icmpv6-type router-solicitation -m hl --hl-eq 255 -j ACCEPT
ip6tables -A INPUT -p icmpv6 --icmpv6-type router-advertisement -m hl --hl-eq 255 -j ACCEPT
ip6tables -A INPUT -p icmpv6 --icmpv6-type neighbour-solicitation -m hl --hl-eq 255 -j ACCEPT
ip6tables -A INPUT -p icmpv6 --icmpv6-type neighbour-advertisement -m hl --hl-eq 255 -j ACCEPT
ip6tables -A INPUT -p icmpv6 --icmpv6-type packet-too-big -j ACCEPT
ip6tables принимает и британское neighbour, и американское neighbor — это синонимы; полный список имён покажет ip6tables -p icmpv6 -h. Общие принципы построения цепочек для таких хостов я описывал в статье iptables: правила firewall для Linux-сервера.
И третье, о чём забывают почти все: если у вас policy drop не только на input, но и на output (я так делаю на хостах в DMZ), ND-правила нужны и в исходящей цепочке. Иначе сервер не сможет ответить на NS, отправить DAD и спросить MAC шлюза — получится та же авария, только зеркальная. А packet-too-big разрешайте обязательно: в IPv6 фрагментирует только отправитель, и без этих сообщений крупные ответы начнут зависать. Как выглядит такая чёрная дыра со стороны пользователя, я показывал на примере PMTU black hole через VPN.
- ND-правила — сразу после iif lo accept, до правил conntrack;
- hoplimit 255 — только для 133–136, не для MLD;
- packet-too-big разрешён всегда;
- policy drop в output — дублируйте ND-блок и там;
- Redirect (137) на серверах не разрешаю, net.ipv6.conf.all.accept_redirects = 0.
Когда виноват не firewall: таблица соседей, accept_ra и коммутатор
Прежде чем править правила, исключите три соседних диагноза с похожими симптомами. Первый — переполнение таблицы соседей. По умолчанию пороги gc_thresh1, gc_thresh2 и gc_thresh3 равны 128, 512 и 1024. На шлюзе с большим сегментом или хосте с сотнями контейнеров потолок пробивается легко. Симптом тот же — соседи пропадают, но в журнале ядра будет строка neighbor table overflow. Лечится подъёмом порогов, а не правилами firewall.
journalctl -k | grep -i 'neighbor table overflow'

cat > /etc/sysctl.d/60-nd.conf <<'EOF'
net.ipv6.neigh.default.gc_thresh1 = 1024
net.ipv6.neigh.default.gc_thresh2 = 4096
net.ipv6.neigh.default.gc_thresh3 = 8192
EOF
sysctl --system
Второй — accept_ra на машинах, которые маршрутизируют. По документации ядра Router Advertisement по умолчанию принимаются, только если на интерфейсе выключена пересылка. Включили forwarding — а это делает любой шлюз и Docker-хост с включённым IPv6 — приём RA отключается, и сервер теряет маршрут по умолчанию, полученный через SLAAC. Для такого гибрида есть accept_ra = 2: принимать RA даже при включённой пересылке. На шлюзах я предпочитаю статическую адресацию и RA не принимаю вовсе.
Третий — оборудование между вами и соседом. Первичный NS идёт на multicast-адрес, а значит его судьбу решает MLD snooping на коммутаторе. Недорогие управляемые коммутаторы позволяют включить snooping без работающего querier, группы «протухают», и NS перестают доходить. Симптом неотличим от проблемы firewall, но счётчики на сервере будут нулевыми — к вам просто ничего не приходит. Лечение — выключить snooping в этом сегменте или поднять querier. В офисных сетях с VLAN это всплывает регулярно, особенно после сегментации сети на VLAN, когда меняют настройки коммутаторов.
И отдельно о DAD. RFC 4862 рекомендует при обнаружении дубликата link-local адреса, построенного из MAC, отключать IPv6 на интерфейсе целиком. В Linux это поведение включается значением accept_dad = 2; по умолчанию стоит 1, и дублирующийся адрес просто получает флаг dadfailed и не используется. Частая причина дубликатов — клонированные виртуальные машины с одинаковым MAC, так что после клонирования проверяйте ip -6 addr на dadfailed.
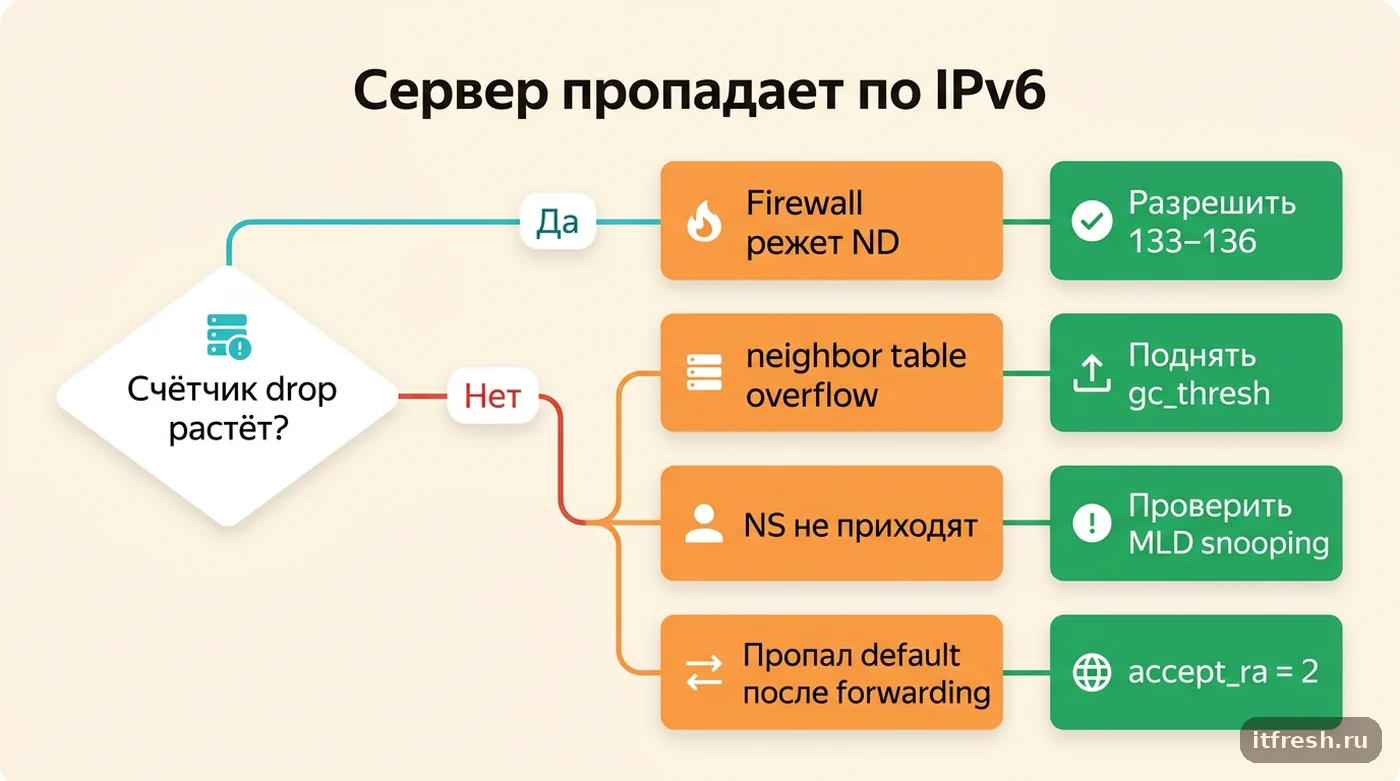
- Счётчик drop-правила растёт — виноват ваш firewall.
- Счётчики по нулям, NS не приходят — смотрите коммутатор, MLD snooping, Wi-Fi-контроллер.
- neighbor table overflow в журнале ядра — правьте gc_thresh.
- Пропал маршрут после включения forwarding — это accept_ra, а не ND.
Что сделать в первую очередь, а на что можно не тратить время
Если у вас парк серверов с IPv6 и вы не уверены в правилах, порядок такой. Сегодня — пройти по всем хостам с AAAA-записями и проверить, что типы 135 и 136 разрешены. На этой неделе — счётчики на финальный drop и сутки наблюдения. Затем — привести шаблон firewall к одному виду, чтобы новые машины не рождались с той же миной.
for h in $(cat hosts.txt); do
  printf '%-24s ' "$h"
  ssh -n -o ConnectTimeout=5 "$h" "nft list ruleset 2>/dev/null | grep -c nd-neighbor-solicit"
done
Ноль в выводе не всегда означает ошибку — правило может быть написано числом 135, — но это список хостов, которые надо открыть руками в первую очередь.
На что можно не тратить время. Не нужно выверять ICMPv6 до последнего типа и кода по таблицам RFC 4890: разница между «разрешил обязательный минимум плюс ошибки» и «выверил всё» на сервере малого бизнеса почти нулевая, а вечер уходит. Не нужно пугаться, что NS и NA видны всем в сегменте — это свойство Ethernet, а не дыра IPv6. И не нужно внедрять SEND (Secure Neighbor Discovery): за годы практики я не встречал его в бою у компаний нашего размера, а проверка hop limit 255 бесплатно закрывает основной класс подделок извне.
Спорный момент — фильтровать ND по источнику, принимая только fe80::/10 и свой префикс. Логика здравая, но DAD приходит с неопределённого адреса ::, и такой фильтр легко сломает подъём адреса после перезагрузки. В сегменте, который вы полностью контролируете, это оправдано. В арендованном /64 у хостера я ограничиваюсь hop limit и на этом останавливаюсь.
И последнее. Если вы решили, что IPv6 вам не нужен, — это рабочий вариант, я сам его иногда предлагаю. Но выключать надо честно: убрать AAAA-записи из DNS, выключить IPv6 на интерфейсах и проверить, что сервисы не слушают ::. Полумера «адрес оставим, ICMPv6 зарежем» даёт ровно ту картину, с которой началась статья: клиенты идут на неработающий адрес и получают таймауты.
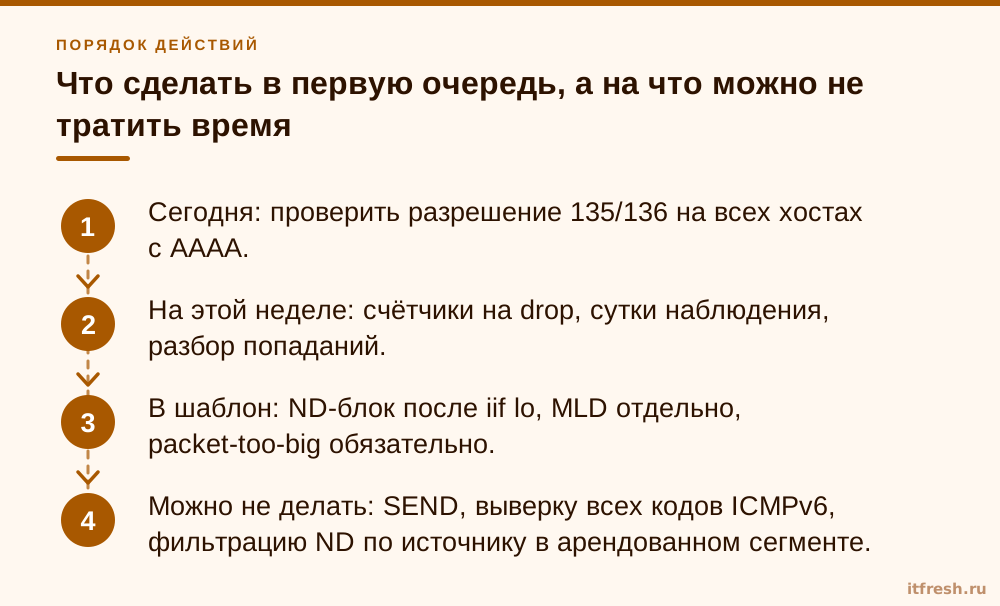
- Сегодня: проверить разрешение 135/136 на всех хостах с AAAA.
- На этой неделе: счётчики на drop, сутки наблюдения, разбор попаданий.
- В шаблон: ND-блок после iif lo, MLD отдельно, packet-too-big обязательно.
- Можно не делать: SEND, выверку всех кодов ICMPv6, фильтрацию ND по источнику в арендованном сегменте.
Частые вопросы
Я разрешил ping по IPv6 — разве этого мало?
Мало. Echo-request и echo-reply (128/129) проверяют связность, когда сосед уже знает ваш MAC. Само сопоставление адреса и MAC делают Neighbor Solicitation (135) и Neighbor Advertisement (136) — их нужно разрешить отдельно.
Почему проблема появилась, если правила никто не менял?
Ошибку маскировал постоянный исходящий трафик сервера: пока сервер сам регулярно обращается к шлюзу, тот получает от него свежие данные о MAC. Убрали фоновую задачу — шлюз начинает проверять сервер своими NS, не получает ответа и перестаёт слать пакеты.
Почему ct state established,related не пропускает Neighbor Solicitation?
Потому что conntrack не отслеживает ND-сообщения: с ядра 2.6.29 они помечаются как untracked и не считаются частью соединения. Для них нужно отдельное разрешающее правило по типу ICMPv6.
Нужно ли в таблице inet писать meta nfproto ipv6 перед icmpv6 type?
Нет. При сопоставлении по icmpv6 type nftables сам добавляет зависимость по протоколу, и правило корректно работает в таблице inet.
Счётчик на drop нулевой, а сервер всё равно пропадает. Что дальше?
Значит, пакеты до вас не доходят. Проверьте MLD snooping на коммутаторе без querier, multicast-to-unicast на Wi-Fi-контроллере и переполнение таблицы соседей (neighbor table overflow в журнале ядра).
Источники
- RFC 4861 — Neighbor Discovery for IPv6 — Типы 133–137, требование Hop Limit 255, solicited-node multicast, Neighbor Unreachability Detection: https://www.rfc-editor.org/rfc/rfc4861.html
- RFC 4862 — IPv6 Stateless Address Autoconfiguration — Раздел 5.4 Duplicate Address Detection: источник :: у NS, рекомендация отключать IPv6 при дубликате MAC-производного link-local: https://www.rfc-editor.org/rfc/rfc4862.html
- RFC 4890 — Recommendations for Filtering ICMPv6 Messages in Firewalls — Раздел 4.4.1 Traffic That Must Not Be Dropped (локальный трафик): 1–4, 128/129, 130–136, 141–143, 148/149, 151–153: https://www.rfc-editor.org/rfc/rfc4890.html
- Linux kernel documentation — IP Sysctl — gc_thresh1/2/3 (128/512/1024), base_reachable_time_ms, accept_ra = 2, accept_dad (0/1/2): https://docs.kernel.org/networking/ip-sysctl.html
- nftables wiki — Matching packet headers — Синтаксис icmpv6 type с именами nd-* и неявная зависимость по протоколу: https://wiki.nftables.org/wiki-nftables/index.php/Matching_packet_headers