
Включили IPv6 forwarding — и сервер остался без маршрута по умолчанию
Ситуация, которую я разбирал у клиентов уже раз десять: на сервере поднимают Docker с IPv6, libvirt-сеть, WireGuard или NAT66 — и через минуту машина перестаёт ходить в интернет по IPv6. Адрес на интерфейсе пока есть, соседи пингуются, маршрута по умолчанию нет — а через какое-то время пропадёт и сам SLAAC-адрес. В sysctl честно стоит accept_ra=1, а RA от роутера ядро молча выбрасывает. Ниже — что именно делает ядро (со ссылками на исходники 6.12), почему единица здесь означает «нет», в каком порядке крутить ручки и как закрепить конфиг так, чтобы его не переписал systemd-networkd или NetworkManager.
Симптом: IPv4 живой, IPv6 отвалился ровно в момент деплоя
Выглядит это всегда одинаково. Вечер, на шлюзе или на хосте с контейнерами что-то включили: "ipv6": true в daemon.json, туннель WireGuard по инструкции из интернета, тестовый NAT66, libvirt-сеть. По SSH машина доступна, по IPv4 всё зелёное. А мониторинг начинает сыпать: не резолвится AAAA, не отвечает apt по v6, не собирается образ, потому что registry разрешается в IPv6 и трафик уходит в никуда. Первое, что говорит админ: «сеть у провайдера моргнула». Не моргнула.
Диагностика занимает тридцать секунд и почти всегда даёт одну и ту же картину: глобальный адрес на интерфейсе на месте, link-local на месте, соседи по /64 пингуются, а ip -6 route show default возвращает пустоту. Отсюда и обманчивое ощущение «адрес же есть, значит IPv6 настроен». Адрес есть, потому что он был получен по SLAAC раньше и живёт по своему valid_lft — сутки, месяц, сколько там прислал роутер. Маршрут по умолчанию живёт по другому таймеру и был удалён из таблицы явно, ядром, в момент вашей команды. А вот адрес доживает своё: обновлять его больше нечем, потому что новые RA ядро не принимает. Когда истечёт preferred_lft, адрес станет deprecated, когда истечёт valid_lft — исчезнет. У провайдеров с короткими lifetime это случается через несколько часов, и тогда авария «второй волны» выглядит уже как полное отсутствие IPv6 на интерфейсе, хотя к этому моменту все давно забыли про вчерашний деплой.
Второй маркер — sysctl. Смотрим два значения на аплинке, и они выглядят абсолютно «правильно»: accept_ra=1 и forwarding=1. Дальше происходит главная ошибка разбора: единицу читают как «RA разрешены, безусловно». Это не так. В IPv6 accept_ra — не булев флаг, а три состояния, и значение 1 означает «принимать RA, только если forwarding выключен». Вы включили forwarding — вы выключили приём RA.
- `ip -6 route show default` — пусто или маршрут исчез из вывода;
- `ip -6 addr show dev eth0` — GUA и fe80:: на месте, поэтому кажется, что «всё настроено»;
- `sysctl net.ipv6.conf.eth0.accept_ra net.ipv6.conf.eth0.forwarding` — 1 и 1;
- `ip -6 neigh` — шлюз виден как REACHABLE, ping6 до его link-local идёт;
- `ip -6 monitor route` — ждём следующий RA и видим, что маршрут не появляется вообще.
Что на самом деле делает ядро: три куска кода из 6.12
Вся логика приёма Router Advertisement в Linux сводится к одной inline-функции. Она читает per-interface значения и решает, разбирать входящий RA или выкинуть. Смотрим include/net/ipv6.h ядра 6.12:
static inline bool ipv6_accept_ra(const struct inet6_dev *idev)
{
	s32 accept_ra = READ_ONCE(idev->cnf.accept_ra);

	/* If forwarding is enabled, RA are not accepted unless the special
	 * hybrid mode (accept_ra=2) is enabled.
	 */
	return READ_ONCE(idev->cnf.forwarding) ? accept_ra == 2 :
		accept_ra;
}
То есть при forwarding=1 функция возвращает истину исключительно при accept_ra==2. Единица превращается в ноль. Эта же функция вызывается в трёх местах: в ndisc_router_discovery() при приёме RA (и в логе с ND_PRINTK можно увидеть «did not accept ra for dev»), в таймере отправки Router Solicitation и при попытке дёрнуть RS через rtnetlink — там ядро прямо отвечает «Router advertisement is disabled on device». Это второй важный момент: RS ядро тоже перестаёт слать. В документации это сказано буквально: «If and only if the functional setting is to accept Router Advertisements, Router Solicitations will be transmitted». Сервер не спросит роутер заново — он будет молча ждать периодического RA и так же молча его выбрасывать. Само не починится никогда.
И третий кусок — почему маршрут исчезает мгновенно, а не «протухает». В addrconf_fixup_forwarding() после записи нового значения стоит if (newf) rt6_purge_dflt_routers(net);, а внутри чистки — вот такое условие (net/ipv6/route.c):
if (rt->fib6_flags & (RTF_DEFAULT | RTF_ADDRCONF) &&
    (!idev || idev->cnf.accept_ra != 2) &&
    fib6_info_hold_safe(rt)) {
	rcu_read_unlock();
	ip6_del_rt(net, rt, false);
Читается однозначно: включение forwarding сносит все маршруты по умолчанию, полученные автоконфигурацией (флаги RTF_DEFAULT|RTF_ADDRCONF, в выводе ip -6 route это proto ra), кроме тех, что живут на интерфейсе с accept_ra==2. Статический дефолт, который вы прописали руками (proto static / proto boot), чистка не трогает — поэтому на серверах со статикой проблемы и не возникает. И отдельный подарок: purge вызывается независимо от того, писали вы в all.forwarding или в eth0.forwarding — чистятся все таблицы маршрутизации в netns, а не только маршруты этого интерфейса.
Отдельно про SLAAC. Параметр autoconf в документации ядра не имеет самостоятельного дефолта: его функциональное значение включено, если включён accept_ra_pinfo, а тот, в свою очередь, включён, только если функционально включён accept_ra. Получается цепочка forwarding=1 → accept_ra=1 фактически выключен → accept_ra_pinfo выключен → autoconf выключен. Поэтому выставлять autoconf=1 вручную бесполезно: Prefix Information из RA до этой проверки не доходит, так как весь RA отброшен раньше. Лечится не autoconf, а accept_ra.
И ещё одна деталь из того же кода, которую полезно помнить: запись в net.ipv6.conf.default.forwarding чистку маршрутов не запускает — функция возвращается раньше. Purge срабатывает при записи единицы в all.forwarding или в forwarding конкретного интерфейса. Поэтому рецепт «поставлю в default, а живые интерфейсы не трону» формально не ломает маршрут прямо сейчас, но первый же новый интерфейс или ребут с этим значением приведут к той же картине.
- `include/net/ipv6.h`, ipv6_accept_ra() — при forwarding=1 RA принимаются только при accept_ra==2;
- `net/ipv6/ndisc.c` — при отказе в приёме RA ядро пишет в debug-лог «did not accept ra for dev»;
- `net/ipv6/addrconf.c`, addrconf_fixup_forwarding() — после записи единицы вызывает rt6_purge_dflt_routers();
- `net/ipv6/route.c`, __rt6_purge_dflt_routers() — удаляет RTF_DEFAULT/RTF_ADDRCONF-маршруты, кроме интерфейсов с accept_ra==2;
- autoconf и accept_ra_pinfo наследуют функциональное значение от accept_ra, поэтому SLAAC-адрес перестаёт обновляться.
accept_ra=2, порядок команд и ловушка с «all»
Лечится это одной строкой, но со строго определённым порядком. Правильно так: сначала accept_ra=2 на аплинке, потом forwarding. Тогда в момент purge условие idev->cnf.accept_ra != 2 не выполнится, и существующий RA-маршрут переживёт включение форвардинга — связность не мигнёт вообще. Если сделать наоборот, маршрут удалится, и вернётся он только со следующим RA: у radvd и большинства провайдерских железок MaxRtrAdvInterval по умолчанию 600 секунд, так что до десяти минут вы сидите без IPv6, даже сделав всё «в итоге правильно».
# порядок важен: сначала разрешаем RA при форвардинге, потом форвардинг
sysctl -w net.ipv6.conf.eth0.accept_ra=2
sysctl -w net.ipv6.conf.all.forwarding=1

# проверяем, что дефолт на месте и пришёл именно из RA
ip -6 route show default
# default via fe80::1 dev eth0 proto ra metric 1024 expires 1797sec pref medium
Теперь ловушка, на которой я лично потерял часа полтора несколько лет назад и с тех пор проверяю первым делом. net.ipv6.conf.all.accept_ra=2 не работает. В таблице sysctl ядра accept_ra объявлен с обычным proc_dointvec — никакой особой обработки «all», в отличие от forwarding или disable_ipv6, у него нет. А ipv6_accept_ra() читает только idev->cnf, то есть значение конкретного интерфейса. Записанная в all двойка не попадает никуда: она меняет псевдоустройство, которое при разборе RA не читается. Ветка default тоже не спасёт на живой машине — она работает как шаблон для интерфейсов, которые появятся позже. Ставить нужно по имени интерфейса. Именно поэтому половина рецептов из интернета «не помогает», хотя в sysctl -a двойка гордо стоит.
Заодно про соседние ручки, чтобы не крутить лишнего. accept_ra_defrtr, accept_ra_pinfo и accept_ra_rtr_pref не имеют собственного дефолта в привычном смысле: их функциональное значение включено, если accept_ra включён, и выключено, если выключен. То есть при accept_ra=1+forwarding=1 они все фактически в нуле, и выставлять accept_ra_defrtr=1 отдельно, не тронув accept_ra, бессмысленно — RA до этой проверки просто не доживает. А вот когда приём RA разрешён, accept_ra_defrtr=0 — законный способ сказать «префиксы бери, дефолт не бери», это иногда нужно на машинах с несколькими аплинками.
Если форвардинг включает libvirt, вы, скорее всего, увидите проблему ещё до аварии. При старте IPv6-сети libvirt сам читает /proc/net/ipv6_route, находит маршруты с флагом RTF_ADDRCONF и проверяет accept_ra их интерфейса. При значении 1 сеть не поднимается с ошибкой «Check the host setup: interface … has kernel autoconfigured IPv6 routes and enabling forwarding without accept_ra set to 2 will cause the kernel to flush them, breaking networking». Это ровно та же логика, что описана выше, только libvirt честно отказывается ломать хост. Docker такой проверки не делает: демон просто включает форвардинг, и маршрут исчезает молча.
Есть и второй путь, без RA вовсе: статический маршрут по умолчанию. Статику purge не трогает, и хост с форвардингом живёт спокойно при accept_ra=0. Адрес в этом случае тоже задаётся статически (или приходит по DHCPv6 в режиме stateful). Важно помнить, что DHCPv6 шлюз не выдаёт: опции default router в протоколе нет, маршрут по умолчанию в IPv6 приходит только из RA или из конфига. Поэтому «переведу аплинк на DHCPv6-клиент и забуду про RA» без статического дефолта не работает.
# вариант со статикой: RA на аплинке не слушаем вообще
sysctl -w net.ipv6.conf.eth0.accept_ra=0
ip -6 addr add 2001:db8:10::2/64 dev eth0
ip -6 route add default via 2001:db8:10::1 dev eth0
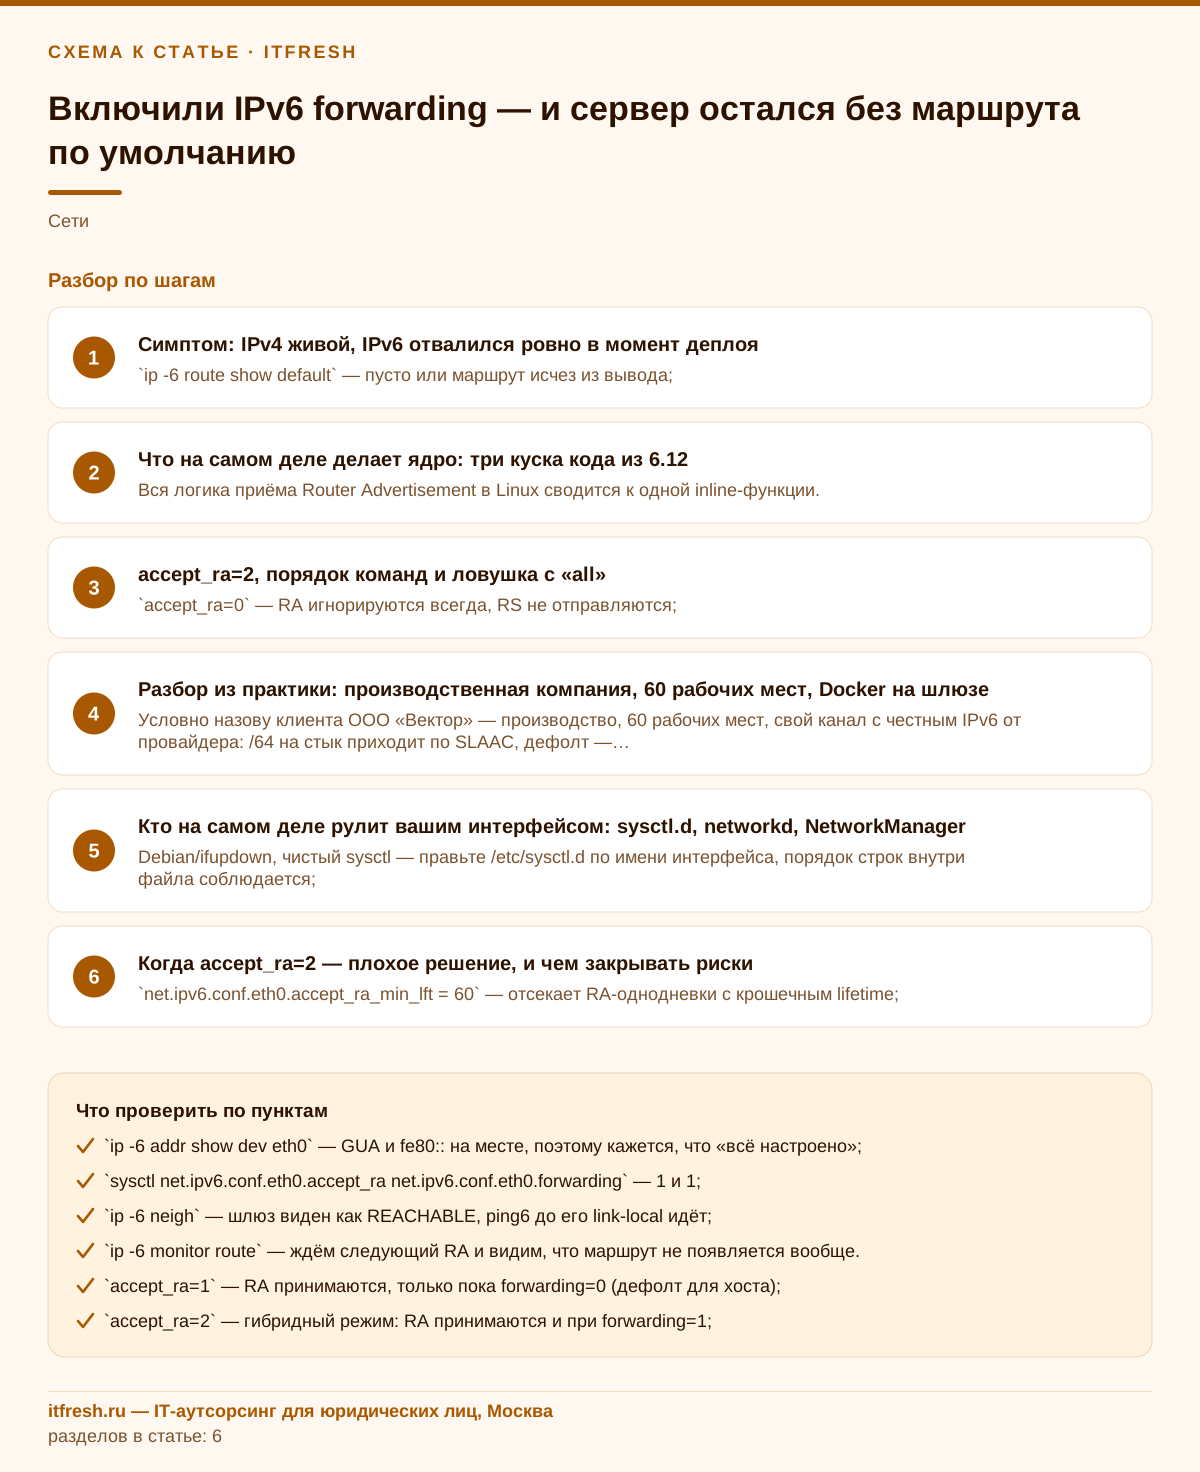
sysctl -w net.ipv6.conf.all.forwarding=1- `accept_ra=0` — RA игнорируются всегда, RS не отправляются;
- `accept_ra=1` — RA принимаются, только пока forwarding=0 (дефолт для хоста);
- `accept_ra=2` — гибридный режим: RA принимаются и при forwarding=1;
- `accept_ra_defrtr` — брать ли из RA маршрут по умолчанию;
- `ra_defrtr_metric` — метрика такого маршрута, по умолчанию 1024;
- `accept_ra_min_lft` — отбрасывать RA с router lifetime меньше указанного.
Разбор из практики: цветочная база, 16 рабочих мест, Docker на шлюзе
Условный клиент — цветочная база «Букет-Опт», 16 рабочих мест: склад-холодильник, отдел продаж, бухгалтерия и курьеры. Канал с честным IPv6 от провайдера: /64 на стык приходит по SLAAC, дефолт — из RA, никакой статики. Периметровый шлюз — небольшой сервер на Debian 12, ядро из bookworm, на нём же живут пара служебных контейнеров: сборщик метрик с датчиков температуры в холодильных камерах и прокси-кэш для обновлений. В четверг вечером подрядчик, настраивавший интеграцию с интернет-витриной (не мы), включил в daemon.json IPv6 для контейнерной сети, перезапустил dockerd и ушёл. Демон при поднятии IPv6-сети выставил net.ipv6.conf.all.forwarding=1 — как и положено роутеру для контейнеров. В этот же миг ядро вычистило default via fe80::… proto ra и перестало принимать RA на аплинке, потому что accept_ra там был штатной единицей.
Утром — обращение: «сайты открываются через раз, заказы от оптовиков в 1С грузятся по минуте, почта то есть, то нет» — а в пятницу утром у цветочной базы пик отгрузок. Классика двойного стека: приложения делают Happy Eyeballs, часть запросов уходит по AAAA, упирается в отсутствующий маршрут, ждёт таймаут и переключается на IPv4. Пользователь видит не «нет интернета», а «всё тормозит». Мониторинг молчал: ICMP-проверки шли по IPv4, а за наличием IPv6-маршрута никто не следил. Шестнадцать человек, из которых половина на телефонах с заказчиками, полдня работали с «тормозящим интернетом». Диагностика заняла минут пять — ip -6 route show default пусто, sysctl net.ipv6.conf.eth0.accept_ra = 1, net.ipv6.conf.all.forwarding = 1, дата изменения — вчера 19:40, в journal рядом рестарт dockerd. Дальше уже дело техники.
Чинили в два шага. Сначала аварийно вернули связность: выставили accept_ra=2 на аплинке и, чтобы не ждать следующего RA, руками прописали временный дефолт через link-local шлюза. Через полторы минуты пришёл очередной RA, маршрут переехал в proto ra с нормальным expires, временный сняли. Потом закрепили: отдельный файл в /etc/sysctl.d с явным именем интерфейса, на внутренних мостах (br0 и docker0) accept_ra=0, чтобы шлюз случайно не начал слушать RA из локалки, и мониторинг на сам факт наличия IPv6-дефолта. С тех пор — тишина, хотя dockerd перезапускался ещё десяток раз.
# /etc/sysctl.d/60-ipv6-router.conf
# аплинк: принимаем RA даже в режиме маршрутизатора
net.ipv6.conf.eth0.accept_ra = 2
net.ipv6.conf.eth0.accept_ra_defrtr = 1
net.ipv6.conf.eth0.accept_ra_min_lft = 60
net.ipv6.conf.eth0.accept_ra_from_local = 0

# внутренние интерфейсы RA не слушают
# (docker0 появляется позже systemd-sysctl — для него дублируем
#  значение в default и проверяем после старта dockerd)
net.ipv6.conf.default.accept_ra = 0
net.ipv6.conf.br0.accept_ra = 0
net.ipv6.conf.docker0.accept_ra = 0

# и только после этого — форвардинг
net.ipv6.conf.all.forwarding = 1
Второй случай — у того же «Букет-Опта», тот же корень, другой повод. Для удалённого склада и ноутбуков торговых представителей админ клиента поднимал WireGuard на арендованном VPS по гайду, где первой строкой стоит net.ipv6.conf.all.forwarding=1. Такие гайды пишут под сценарий «у сервера статический IPv6», а хостер выдавал шлюз только по RA. Итог тот же: туннель поднялся, наружу по IPv6 сервер ходить перестал, две недели никто не замечал, потому что всё нужное резолвилось и в A-записи. Нашли случайно, когда выгрузка бэкапа базы 1С в S3-совместимое хранилище с AAAA-записью начала падать по таймауту.
- время до диагноза — около пяти минут, если сразу смотреть `ip -6 route show default`, а не «пинговать гугл»;
- аварийное восстановление — accept_ra=2 на аплинке плюс временный дефолт через link-local шлюза;
- закрепление — отдельный файл в /etc/sysctl.d с именем интерфейса и порядком «accept_ra до forwarding»;
- на внутренних мостах и docker0 — явный accept_ra=0;
- мониторинг — проверка наличия IPv6-дефолта и сочетания forwarding/accept_ra на аплинке;
- для VPS с WireGuard — тот же accept_ra=2 либо статический дефолт, если хостер его документирует.
Кто на самом деле рулит вашим интерфейсом: sysctl.d, networkd, NetworkManager
Прежде чем править sysctl — определитесь, кто конфигурирует интерфейс. Это самая частая причина «я поставил двойку, а она обратно скидывается». Если интерфейсом управляет ifupdown, netplan-with-networkd, cloud-init или NetworkManager, ваши строки в /etc/sysctl.d могут применяться раньше появления интерфейса или переписываться менеджером после подъёма линка. systemd-sysctl отрабатывает при старте и по udev-событию, но для интерфейса, который появился позже (tun, bond, VLAN), запись по имени просто не найдёт цель и тихо пропустится.
systemd-networkd вообще играет по своим правилам, и это надо знать. В systemd.network(5) сказано прямо: реализация RA в ядре всегда выключена, независимо от настройки IPv6AcceptRA=, а при включённой опции работает userspace-клиент самого networkd. Значит, sysctl accept_ra на таком интерфейсе смотреть бессмысленно — там будет ноль, и это нормально: RA разбирает демон, а не ядро. При этом по умолчанию IPv6AcceptRA= выключается, если на интерфейсе включены IPv6SendRA=, IPv6Forwarding= или IPMasquerade=, и включён в остальных случаях. Логика та же, что у ядра, только ручки другие — крутить надо их: явное IPv6AcceptRA=yes перекрывает этот дефолт.
# /etc/systemd/network/10-uplink.network
[Match]
Name=eth0

[Network]
# systemd >= 256; на более старых (Debian 12 — systemd 252) — IPForward=ipv6
IPv6Forwarding=yes
IPv6AcceptRA=yes

# альтернатива без RA — статический шлюз:
# IPv6AcceptRA=no
# [Address]
# Address=2001:db8:10::2/64
# [Route]
# Gateway=2001:db8:10::1
Обратите внимание на версию. Параметры IPv6Forwarding= и IPv4Forwarding= появились в systemd 256; в более старых версиях форвардинг включался через IPForward=, и в дистрибутивах LTS вы встретите именно его. Кроме того, документация отдельно подчёркивает: включение IPv6Forwarding= на двух интерфейсах само по себе не делает так, чтобы пакеты IPv6 пересылались между ними — для этого нужен глобальный форвардинг. Не стоит ожидать от per-interface ключа того же поведения, что у IPv4.
NetworkManager ведёт себя аналогично, но об этом почти не пишут: на управляемых устройствах он выставляет accept_ra=0 в sysctl (это видно прямо в исходниках nm-device.c) и обрабатывает Router Advertisement сам, через libndp. Поэтому на RHEL-подобных системах с NM попытка «поправить accept_ra через sysctl» ничего не даёт: значение перетирается при активации соединения, а маршрут по умолчанию приезжает от демона. Здесь отправная точка — ipv6.method=auto в профиле соединения и проверка вывода nmcli device show eth0. Поведение NM при включённом форвардинге зависит от версии, поэтому после любого включения форвардинга на NM-хосте первым делом проверяйте, остался ли дефолт, и при необходимости задавайте шлюз в профиле статически (ipv6.gateway).
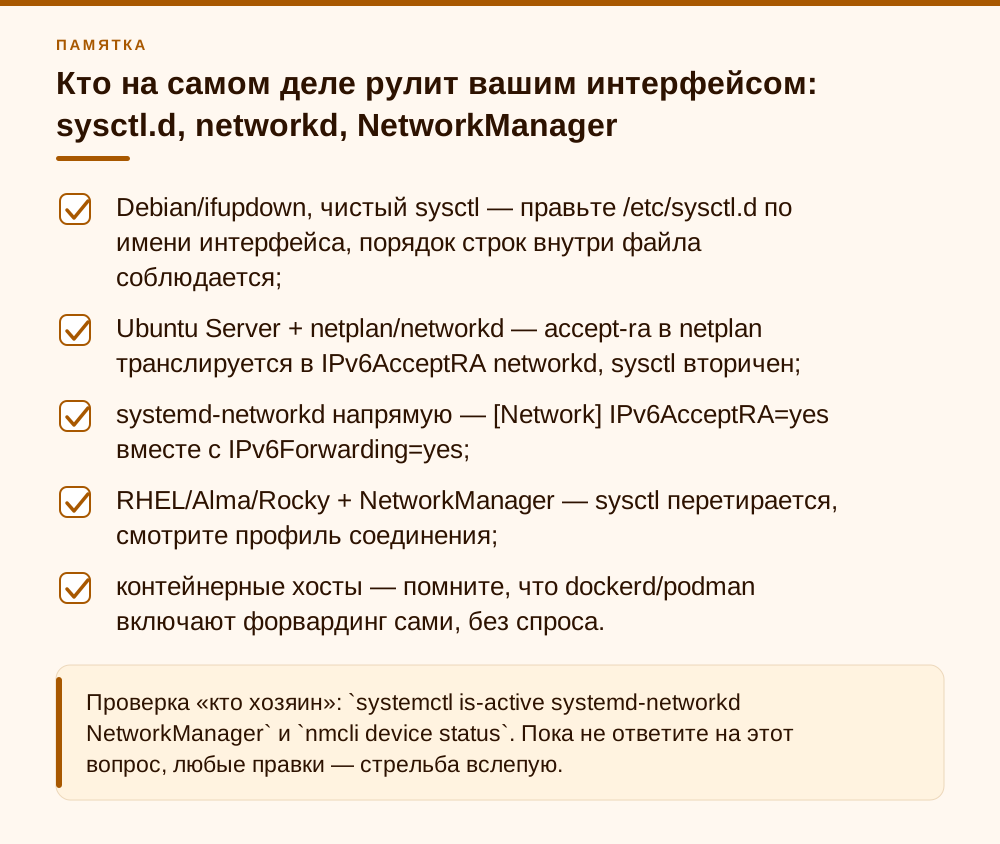
- Debian/ifupdown, чистый sysctl — правьте /etc/sysctl.d по имени интерфейса, порядок строк внутри файла соблюдается;
- Ubuntu Server + netplan/networkd — accept-ra в netplan транслируется в IPv6AcceptRA networkd, sysctl вторичен;
- systemd-networkd напрямую — [Network] IPv6AcceptRA=yes вместе с IPv6Forwarding=yes;
- RHEL/Alma/Rocky + NetworkManager — sysctl перетирается, смотрите профиль соединения;
- контейнерные хосты — помните, что dockerd/podman включают форвардинг сами, без спроса.
Когда accept_ra=2 — плохое решение, и чем закрывать риски
Скажу честно: accept_ra=2 — это компромисс, а не эталон. Для боевого периметрового шлюза с постоянным префиксом я предпочитаю другое: accept_ra=0 на аплинке и статический маршрут по умолчанию. Причина простая — маршрутизатор, который сам себе учит дефолт из широковещательных объявлений соседей, зависим от чужого поведения в канале. Любой мусорный RA (случайно поднятый Windows ICS, ноутбук с включённым sharing, «умный» роутер, воткнутый в свитч) может подсунуть шлюзу маршрут или префикс. RA-guard в дешёвых свитчах, как правило, отсутствует, а в L2-сегменте провайдера вы вообще ни на что не влияете.
А вот где accept_ra=2 — единственно верный вариант: VPS и облака, где дефолтный шлюз выдаётся только по RA и статикой не документируется; каналы с меняющимся link-local шлюза; стенды и офисные шлюзы с динамическим префиксом от провайдера. Тут статика превратится в грабли при первой же смене оборудования у оператора. В этом случае гибридный режим включаем осознанно и обвешиваем ограничителями: минимальный router lifetime, запрет на RA из собственных адресов, ограничение длины префикса в Route Information (RFC 4191), запрет RA на всех интерфейсах, кроме аплинка.
И сразу успокою насчёт страхов, которые мне регулярно транслируют. accept_ra=2 не превращает сервер обратно в хост и не выключает форвардинг — пакеты продолжают маршрутизироваться, флаг forwarding остаётся единицей, влияние строго на обработку входящих RA и отправку RS. Он также не заставляет ядро принимать RA на всех интерфейсах: это per-interface параметр, на br0 и docker0 значение останется своим. Ставить его на всю машину не нужно и вредно — только на тот интерфейс, откуда реально приходит ваш апстрим-роутер.
- `net.ipv6.conf.eth0.accept_ra_min_lft = 60` — отсекает RA-однодневки с крошечным lifetime;
- `net.ipv6.conf.eth0.accept_ra_from_local = 0` — не верить RA с собственных адресов;
- `net.ipv6.conf.eth0.accept_ra_rt_info_max_plen = 0` — принимать из Route Information (RFC 4191) только ::/0; при включённом accept_ra_rtr_pref это и так функциональный дефолт, фиксируем явно;
- `net.ipv6.conf.<downstream>.accept_ra = 0` — на всех внутренних мостах и туннелях;
- `net.ipv6.conf.eth0.ra_defrtr_metric` — если нужен предсказуемый приоритет относительно статики.
Чек-лист на пять минут и что мониторить, чтобы не повторилось
Порядок действий, когда «IPv6 отвалился после чего-то». Шаг первый — ip -6 route show default. Пусто — идём дальше, есть маршрут — проблема не эта. Шаг второй — читаем два числа прямо из procfs для нужного интерфейса: accept_ra и forwarding. Комбинация 1+1 — диагноз поставлен. Шаг третий — смотрим, кто и когда включил форвардинг: journalctl -u docker -u wg-quick@wg0 --since -1d, время изменения файлов в /etc/sysctl.d, история команд. Шаг четвёртый — чиним в правильном порядке и закрепляем в конфиге того менеджера, который реально управляет интерфейсом. Шаг пятый — проверяем, что маршрут вернулся именно как proto ra и с ненулевым expires; если он статический, вы починили симптом, а не причину.
Мониторинг тут стоит копейки и окупается первым же случаем. Мне достаточно двух проверок на хосте: наличие IPv6-маршрута по умолчанию и фактическое значение accept_ra на аплинке. Обе — обычные UserParameter в Zabbix или строчка в любом самописном чекере. Третьей проверкой имеет смысл гонять реальный ICMP-эхо по IPv6 до внешнего адреса, а не только до шлюза: маршрут может присутствовать формально, а связность отсутствовать.
#!/bin/bash
# /usr/local/bin/check_ipv6_default.sh
IF=eth0
ip -6 route show default | grep -q . || { echo "CRIT: no IPv6 default route"; exit 2; }
RA=$(cat /proc/sys/net/ipv6/conf/$IF/accept_ra)
FW=$(cat /proc/sys/net/ipv6/conf/$IF/forwarding)
[ "$FW" = 1 ] && [ "$RA" != 2 ] && { echo "WARN: forwarding=1 accept_ra=$RA on $IF"; exit 1; }
# замените 2001:db8::53 на внешний IPv6-адрес, который вы контролируете
ping -6 -c2 -W2 2001:db8::53 >/dev/null || { echo "WARN: no IPv6 reachability"; exit 1; }
echo "OK"
И про приоритеты, раз уж об этом спрашивают. В первую очередь — правильный порядок применения (accept_ra=2 до forwarding=1) и явный per-interface конфиг там, где его читает ваш сетевой менеджер. Во вторую — accept_ra=0 на внутренних интерфейсах и мониторинг наличия дефолта. На accept_ra_min_hop_limit, приватные адреса, тонкую настройку rtr_solicit_interval и прочую экзотику можно спокойно забить: к этому классу аварий они отношения не имеют, а времени съедают много. Главное — понимать, что единица в accept_ra контекстно зависима, и что включение форвардинга в Linux — это не «плюс одна возможность», а смена роли машины с хоста на маршрутизатор со всеми вытекающими.
- `ip -6 route show default` — есть ли дефолт и какой у него proto;
- `cat /proc/sys/net/ipv6/conf/eth0/{accept_ra,forwarding}` — сочетание 1 и 1 = диагноз;
- `journalctl --since -1d | grep -iE 'docker|wireguard|libvirt|forwarding'` — кто включил форвардинг;
- `ip -6 monitor route` — приходит ли новый маршрут с очередным RA;
- `ip -6 route show table all | grep proto ra` — не остались ли дубли после ручного костыля.
Частые вопросы
Почему accept_ra=1 не работает при включённом форвардинге — это баг?
Нет, это документированное поведение. Значение 1 означает «принимать RA, если форвардинг выключен», а не «принимать RA всегда». Как только машина становится маршрутизатором (forwarding=1), ядро считает, что маршруты ей задаёт администратор или протокол маршрутизации, и перестаёт слушать чужие Router Advertisement. Гибридный режим — это accept_ra=2.
Я выставил net.ipv6.conf.all.accept_ra=2, а маршрут всё равно не приходит. Почему?
Потому что ядро при разборе RA читает значение конкретного интерфейса, а не ветку all: у accept_ra нет специальной обработки «all», в отличие от forwarding. Ставьте по имени интерфейса — net.ipv6.conf.eth0.accept_ra=2 — и проверяйте через /proc/sys/net/ipv6/conf/eth0/accept_ra. Ветка default тоже не поможет: она применяется только к интерфейсам, созданным после её изменения.
Маршрут пропал, я включил accept_ra=2 — почему связность вернулась не сразу?
Потому что удалённый маршрут восстановится только со следующим Router Advertisement, а роутеры шлют их периодически — у radvd MaxRtrAdvInterval по умолчанию 600 секунд. Ускорить можно временным статическим маршрутом через link-local шлюза либо перезапуском интерфейса, чтобы ядро отправило Router Solicitation — при accept_ra=2 оно снова имеет на это право.
Docker/WireGuard сами включают форвардинг. Как защититься заранее?
Пропишите accept_ra=2 на аплинке в конфиге сетевого менеджера или в /etc/sysctl.d так, чтобы значение применялось при подъёме интерфейса, а не только при загрузке. Тогда при любом последующем включении форвардинга чистка маршрутов по умолчанию обойдёт ваш аплинк стороной: ядро явно пропускает интерфейсы с accept_ra равным 2.
У меня systemd-networkd или NetworkManager — sysctl не помогает. Что делать?
Оба менеджера обрабатывают RA в userspace и держат kernel-настройку accept_ra в нуле, поэтому sysctl тут не рычаг. В systemd-networkd пропишите в .network-файле аплинка явное IPv6AcceptRA=yes — оно перекрывает дефолт «выключено при IPv6Forwarding=» (на systemd старше 256 форвардинг включается через IPForward=). В NetworkManager отправная точка — ipv6.method=auto в профиле соединения; если после включения форвардинга дефолт пропадает, проще задать шлюз статически (ipv6.gateway) или перевести аплинк под networkd.
Не безопаснее ли вообще отключить RA и прописать маршрут статикой?
На периметровом шлюзе с постоянным префиксом — да, я так и делаю: accept_ra=0 плюс статический дефолт. Это снимает зависимость от чужих объявлений в канале. Но если провайдер или облако выдают шлюз только по RA и link-local может смениться, статика превратится в мину замедленного действия — тогда честнее accept_ra=2 с ограничителями (accept_ra_min_lft, accept_ra_from_local=0, accept_ra_rt_info_max_plen=0).
Почему libvirt отказывается запускать IPv6-сеть, а Docker запускается и ломает маршрут?
libvirt перед включением форвардинга сам проверяет, есть ли на хосте маршруты, полученные из RA (флаг RTF_ADDRCONF), и какой accept_ra у их интерфейса. При значении 1 он останавливается с ошибкой «Check the host setup… without accept_ra set to 2», чтобы не сломать хост. Docker такой проверки не делает. Решение одинаковое: accept_ra=2 на аплинке до включения форвардинга или статический маршрут по умолчанию с accept_ra=0.
Поможет ли net.ipv6.conf.eth0.autoconf=1, чтобы вернуть SLAAC-адрес?
Нет. По документации ядра функциональное значение autoconf зависит от accept_ra_pinfo, а тот — от accept_ra. При forwarding=1 и accept_ra=1 весь RA отбрасывается до разбора Prefix Information, так что autoconf просто нечего обрабатывать. Существующий адрес доживёт до valid_lft и исчезнет. Возвращает SLAAC только accept_ra=2 на интерфейсе либо переход на статический адрес.
Источники
- Linux kernel 6.12 — IP Sysctl (IPv6) — Разделы conf/all/forwarding, forwarding, accept_ra (0/1/2), accept_ra_defrtr, accept_ra_pinfo, autoconf, accept_ra_min_lft, ra_defrtr_metric: «Functional default: enabled if local forwarding is disabled / disabled if local forwarding is enabled». https://docs.kernel.org/networking/ip-sysctl.html (версия 6.12: https://www.kernel.org/doc/html/v6.12/networking/ip-sysctl.html)
- Исходный код ядра: include/net/ipv6.h, v6.12 — Функция ipv6_accept_ra(): «If forwarding is enabled, RA are not accepted unless the special hybrid mode (accept_ra=2) is enabled». https://github.com/torvalds/linux/blob/v6.12/include/net/ipv6.h
- Исходный код ядра: net/ipv6/addrconf.c и net/ipv6/route.c, v6.12 — addrconf_fixup_forwarding() вызывает rt6_purge_dflt_routers() при включении форвардинга; __rt6_purge_dflt_routers() удаляет маршруты с флагами RTF_DEFAULT|RTF_ADDRCONF, кроме интерфейсов с cnf.accept_ra == 2. https://github.com/torvalds/linux/blob/v6.12/net/ipv6/route.c
- systemd.network(5) — IPv6AcceptRA=, IPv6Forwarding=, IPv6SendRA= — «The kernel's implementation of the IPv6 RA protocol is always disabled, regardless of this setting»; IPv6AcceptRA= по умолчанию выключается при IPv6SendRA=/IPv6Forwarding=/IPMasquerade=; IPv6Forwarding= добавлен в версии 256. https://manpages.debian.org/unstable/systemd/systemd.network.5.en.html , https://www.freedesktop.org/software/systemd/man/latest/systemd.network.html
- moby/moby issue #43466 — Enabling IPv6 immediately breaks some hosts' IPv6 networking — Демон Docker выставляет net.ipv6.conf.all.forwarding=1, хост теряет маршрутизаторы и шлюз по умолчанию; предложенное решение — accept_ra=2 до включения форвардинга. https://github.com/moby/moby/issues/43466
- Matt Brown — Linux ignores IPv6 router advertisements when forwarding is enabled — Классический разбор поведения (2011), с которого начинается большинство обсуждений темы. https://www.mattb.nz/w/2011/05/11/linux-ignores-ipv6-router-advertisements-when-forwarding-is-enabled/
- libvirt: src/util/virnetdevip.c, virNetDevIPCheckIPv6Forwarding() — Проверка RTF_ADDRCONF-маршрутов и accept_ra перед включением форвардинга, ошибка «enabling forwarding without accept_ra set to 2 will cause the kernel to flush them». https://github.com/libvirt/libvirt/blob/master/src/util/virnetdevip.c
- NetworkManager: src/core/devices/nm-device.c — Установка sysctl accept_ra=0 на управляемых устройствах, RA обрабатываются в userspace. https://gitlab.freedesktop.org/NetworkManager/NetworkManager/-/blob/main/src/core/devices/nm-device.c