
nft -c проходит успешно, а после применения правил пропадает SSH: как готовить откат
Знакомая последовательность: правите nftables на удалённом сервере, прогоняете nft -c, получаете тишину и код возврата 0, применяете набор через nft -f. Сессия жива, всё выглядит хорошо. Выходите — и обратно уже не заходите. Разберу, что на самом деле проверяет ключ -c, почему ваша текущая SSH-сессия врёт вам в лицо через conntrack, как снять резервный набор правил, который действительно восстановится, и как я применяю ruleset на боевых шлюзах через таймер отката, чтобы худшее, что случится, — это две минуты недоступности.
Что на самом деле проверяет nft -c и чего он не проверяет никогда
Начну с формулировки из первоисточника, потому что вокруг неё построено всё недоразумение. Руководство nft(8) описывает ключ ровно одной строкой: «-c, --check — Check commands validity without actually applying the changes», то есть «проверить допустимость команд, не применяя изменения». Ключевое слово — commands. Не «проверить, что сервер останется доступен». Не «проверить, что политика корректна». Проверить, что набор команд допустим.
На практике -c ловит три класса ошибок, и это действительно полезно. Первое — грамматика: опечатка в ключевом слове, незакрытая фигурная скобка, dport вместо tcp dport. Второе — типы и семантика внутри файла: попытка сравнить IPv6-адрес в таблице семейства ip, ссылка на неопределённую переменную из define, jump в цепочку, которой в этом же файле нет. Третье — сочетания, которые ядро не поддерживает: тип цепочки nat на хуке, где его быть не может. Всё это -c выловит до того, как вы что-то сломаете, и одна эта проверка экономит массу нервов.
А теперь то, чего он не умеет и не будет уметь никогда. Ключ -c ничего не знает о вашей топологии. Он не проверит, что имя интерфейса в iifname "eth0" совпадает с реальным ens18, потому что iifname сравнивает произвольную строку — синтаксически там допустимо что угодно. Он не проверит, что порт вашего SSH не 22, а 33822. Он не проверит порядок правил: если drop стоит выше accept, файл абсолютно валиден и абсолютно смертелен. Он не увидит, что параллельно с вашей новой таблицей на том же хуке живёт таблица от ufw или Docker, а вердикт drop в любой из базовых цепочек терминален и обрывает пакет, сколько бы accept ни было в соседних. Проверка допустимости команд — это линтер, а не тест доступности сервера.
Есть ещё приятная мелочь, о которой мало кто знает: -c комбинируется с оптимизатором. В руководстве прямо сказано про -o/--optimize: «You can combine this option with -c to inspect the proposed optimizations». То есть nft -c -o -f new.nft покажет, как nft свернул бы ваши правила в наборы и конкатенации, ничего не меняя. Удобно для ревью чужих конфигов, но к безопасности применения отношения по-прежнему не имеет.
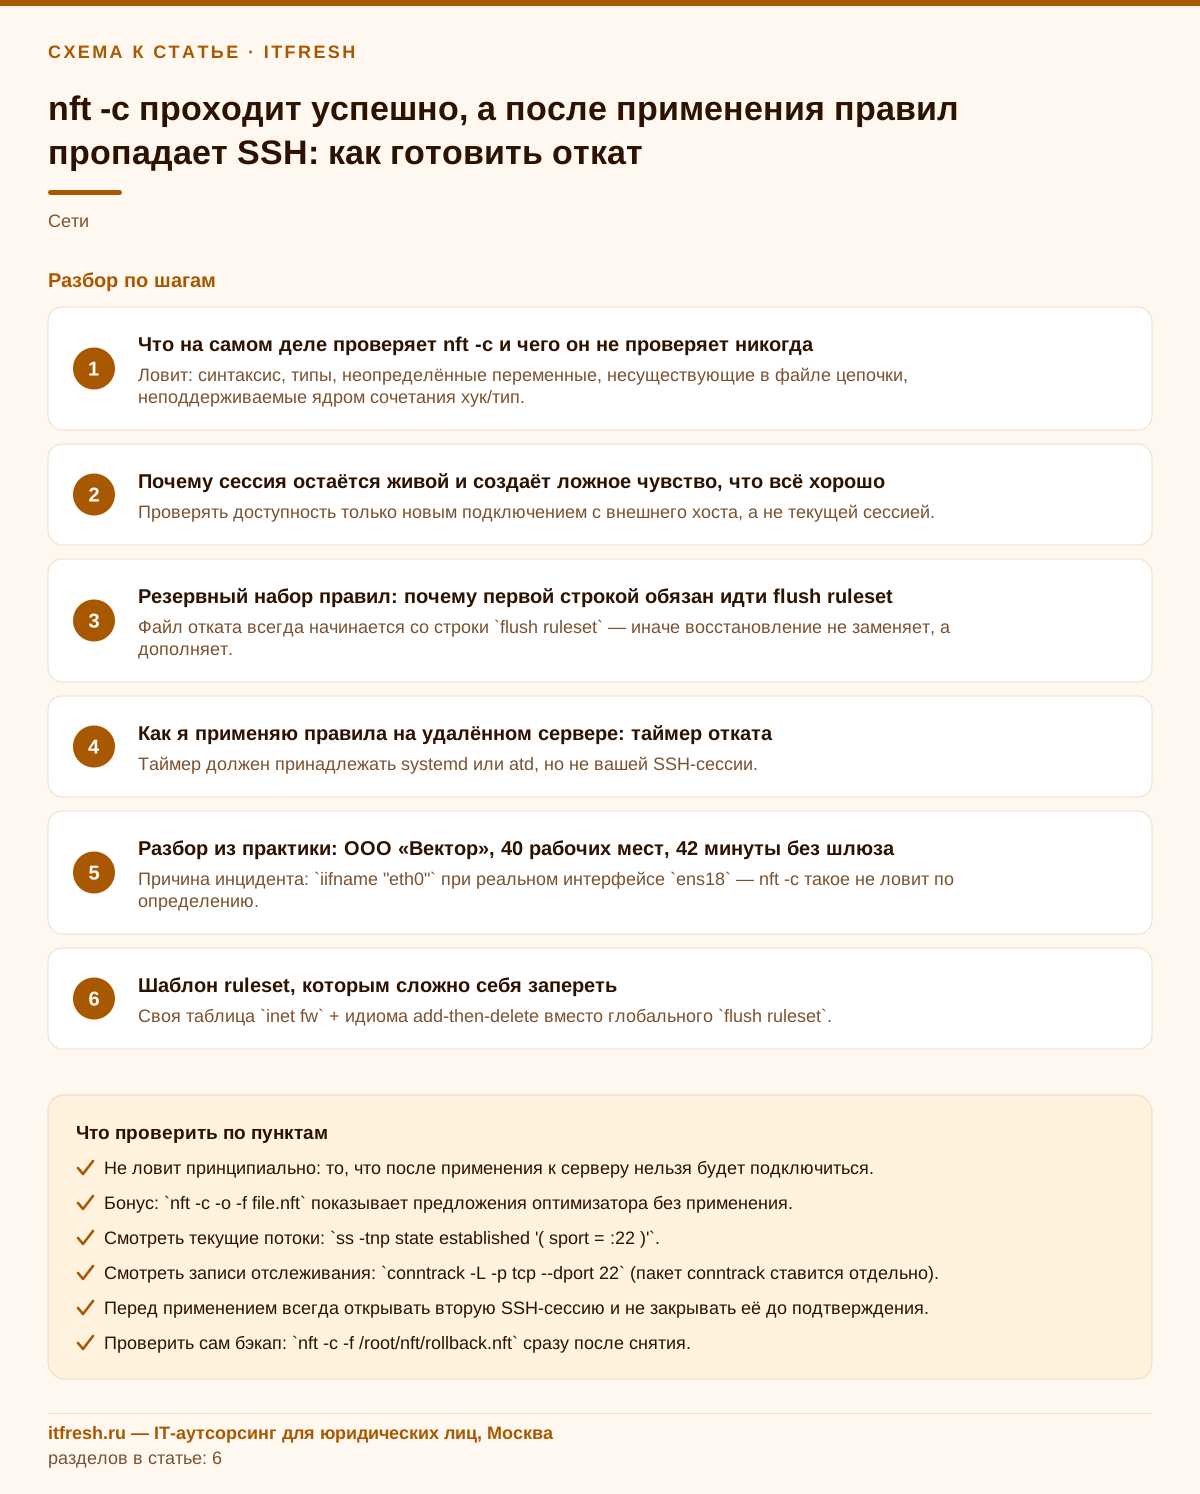
- Ловит: синтаксис, типы, неопределённые переменные, несуществующие в файле цепочки, неподдерживаемые ядром сочетания хук/тип.
- Не ловит: неверное имя интерфейса в iifname, неверный порт, неверный порядок правил, конфликт с чужими таблицами на том же хуке, отсутствие правила для established.
- Не ловит принципиально: то, что после применения к серверу нельзя будет подключиться.
- Бонус: `nft -c -o -f file.nft` показывает предложения оптимизатора без применения.
Почему сессия остаётся живой и создаёт ложное чувство, что всё хорошо
Вот самая коварная часть истории. Вы применили заведомо кривой набор правил, где SSH разрешён на несуществующем интерфейсе, — а терминал не отваливается. Вы жмёте Enter, приглашение отвечает, nft list ruleset печатается. Вывод напрашивается сам собой: всё в порядке, правила легли, можно фиксировать конфиг и идти домой. Через двадцать минут вы выходите из сессии — и всё, дверь захлопнулась.
Механика простая. nft flush ruleset удаляет таблицы, цепочки и правила, но не трогает подсистему отслеживания соединений: записи conntrack о ваших установленных TCP-потоках остаются на месте. Практически в любом вменяемом шаблоне первой строкой цепочки input стоит ct state established,related accept — и ваша текущая SSH-сессия проходит именно по этому правилу, не доходя до строки с портом 22. То есть механизм, который защищает вас от мгновенного обрыва, одновременно скрывает от вас, что новые подключения не проходят.
Отсюда единственный корректный способ проверки: новое соединение с другой машины. Не Enter в текущем окне, не nft list ruleset, а ssh -o ConnectTimeout=5 user@host со своего ноутбука или хотя бы nc -zv host 22 с соседнего сервера. Я держу для этого второе окно с уже открытой сессией — если новая не пойдёт, старая останется живой на conntrack и даст время откатиться руками.
Обратная ситуация — когда в новом наборе вообще нет правила для established — выглядит страшнее, а на деле безопаснее: сессия рвётся мгновенно, вы сразу понимаете, что сломали, и тянетесь за откатом. Хуже всего именно «тихий» отказ, когда обрыв случается не в момент применения, а в момент выхода.
- Проверять доступность только новым подключением с внешнего хоста, а не текущей сессией.
- Смотреть текущие потоки: `ss -tnp state established '( sport = :22 )'`.
- Смотреть записи отслеживания: `conntrack -L -p tcp --dport 22` (пакет conntrack ставится отдельно).
- Перед применением всегда открывать вторую SSH-сессию и не закрывать её до подтверждения.
Резервный набор правил: почему первой строкой обязан идти flush ruleset
Официальный пример снятия копии на wiki nftables состоит ровно из двух команд, и порядок в них не случаен:
echo "flush ruleset" > /root/nft/rollback.nft
nft list ruleset >> /root/nft/rollback.nft
Сначала в файл пишется команда очистки, и только потом — дамп текущего набора. Восстановление выполняется одной командой nft -f /root/nft/rollback.nft, и загрузка происходит атомарно: как формулирует wiki, nftables читает все файлы, собирает конфигурацию в памяти рядом с действующей, а затем одной атомарной операцией подменяет старую новой. Если хоть одна команда в файле не пройдёт, не применится ничего — состояние «полуприменённого» ruleset невозможно.
Теперь про самую частую ошибку, из-за которой откат не спасает. Человек снимает копию так: nft list ruleset > /root/rules.bak. Без первой строки. В спокойной обстановке разница не видна, а в аварийной вылезает боком: при загрузке такого файла блоки table и chain работают по семантике «add», то есть таблица создаётся, если её нет, а правила дописываются в конец существующей цепочки. Если на момент восстановления в системе уже лежит ваш сломанный набор, вы получите не откат, а объединение: сломанные правила останутся сверху, старые добавятся снизу дублями. Первый совпавший drop отработает раньше, чем восстановленный accept, и вы по-прежнему заперты — только теперь ещё и с задвоенным ruleset, в котором невозможно разобраться из аварийной консоли.
И второй момент, который проверяют единицы: сам файл отката тоже надо проверять. Вывод nft list ruleset в подавляющем большинстве случаев загружается обратно без проблем — это прямой аналог пары iptables-save/iptables-restore, — но встречаются конфигурации, где дамп содержит объекты, порядок объявления которых при обратной загрузке важен. Поэтому сразу после снятия копии я прогоняю по ней ту самую проверку: nft -c -f /root/nft/rollback.nft. Если бэкап не проходит проверку — чинить его надо сейчас, а не в момент, когда сервер уже недоступен. Если счётчики в дампе мешают глазам, снимайте копию как nft -s list ruleset >> file — ключ -s/--stateless опускает stateful-информацию правил.
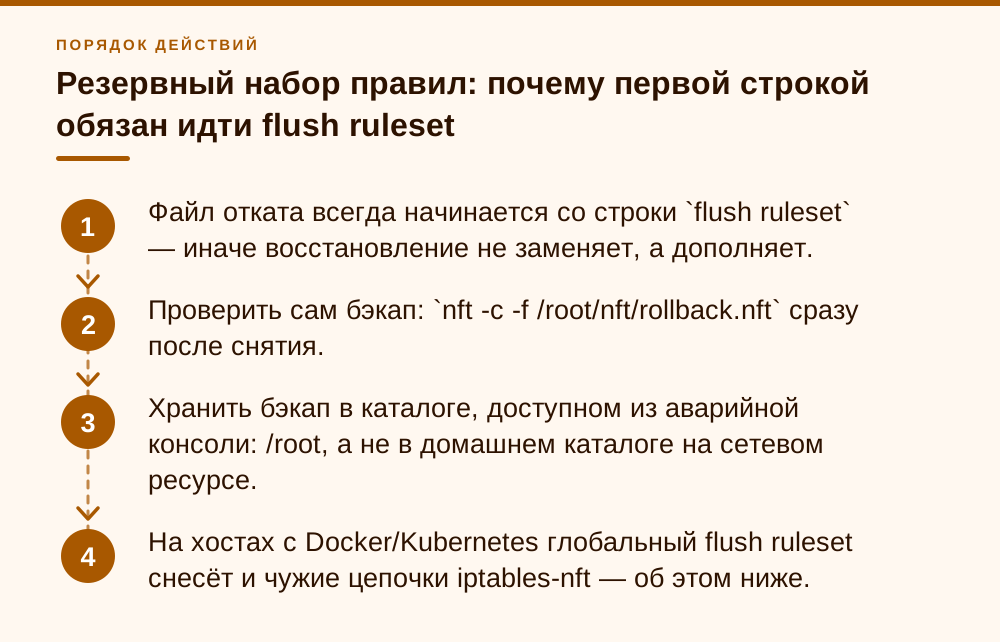
- Файл отката всегда начинается со строки `flush ruleset` — иначе восстановление не заменяет, а дополняет.
- Проверить сам бэкап: `nft -c -f /root/nft/rollback.nft` сразу после снятия.
- Хранить бэкап в каталоге, доступном из аварийной консоли: /root, а не в домашнем каталоге на сетевом ресурсе.
- На хостах с Docker/Kubernetes глобальный flush ruleset снесёт и чужие цепочки iptables-nft — об этом ниже.
Как я применяю правила на удалённом сервере: таймер отката
Идея древняя, из эпохи iptables-apply: перед применением взводится отложенная задача, которая через N секунд вернёт старый набор правил, а если админ успел подтвердить, что доступ жив, — задача снимается. С nftables это делается ровно так же, только чище, потому что откат — одна атомарная команда. Я оформляю это скриптом, который лежит на всех обслуживаемых шлюзах в /usr/local/sbin/nft-apply.
#!/bin/bash
set -euo pipefail

NEW="${1:?укажите файл с новым ruleset}"
BAK=/root/nft/rollback.nft
WAIT="${2:-120}"

mkdir -p /root/nft

# 1. снимаем откат ПРАВИЛЬНО: сначала flush, потом дамп
echo "flush ruleset" > "$BAK"
nft list ruleset >> "$BAK"

# 2. проверяем и новый набор, и сам откат
nft -c -f "$NEW"
nft -c -f "$BAK"

# 3. взводим откат ДО применения
systemd-run --unit=nft-rollback --on-active="$WAIT" \
            --timer-property=AccuracySec=1s \
            /usr/sbin/nft -f "$BAK"

# 4. применяем
nft -f "$NEW"

echo "Правила применены. Откат сработает через ${WAIT} c."
echo "Проверьте НОВОЕ подключение с другой машины, затем выполните:"
echo "  systemctl stop nft-rollback.timer"
Порядок шагов принципиален. Откат взводится до применения, а не после: если nft -f "$NEW" оборвёт вам управление в ту же секунду, задача уже стоит в очереди и отработает без вашего участия. Задача принадлежит systemd, а не вашей сессии, поэтому обрыв SSH её не убивает — это главная причина, по которой я не использую конструкции вида sleep 120 && nft -f backup в фоне текущего шелла: при разрыве соединения такой фон рискует получить SIGHUP и умереть ровно тогда, когда он нужен.
Если systemd на машине нет или атомарность отката хочется отдать отдельному демону, тот же результат даёт классический at: echo "/usr/sbin/nft -f /root/nft/rollback.nft" | at now + 2 minutes, снятие — через atq и atrm <номер>. В обоих случаях после успешной проверки доступа обязательно снимайте задачу: забытый таймер отката, отработавший ночью, — отдельный весёлый инцидент, когда шлюз внезапно откатывается на конфиг недельной давности.
Отдельно про фиксацию. В /etc/nftables.conf новый набор попадает только после того, как я подключился новой сессией и снял таймер. До этого момента файл на диске остаётся последним заведомо рабочим, и перезагрузка сервера сама по себе становится ещё одним путём отката: nftables.service при старте загружает то, что лежит в /etc/nftables.conf. На VPS, где есть кнопка «Reboot» в панели хостера, но нет KVM-консоли, это иногда единственная доступная спасательная верёвка. Проверьте заодно, что сервис вообще включён: systemctl is-enabled nftables.service. Если нет, после перезагрузки поднимется пустой набор правил. Это не локаут, но шлюз при этом открыт настежь. Включается сервис командой systemctl enable nftables.service.
- Снять откат с flush ruleset → проверить оба файла через -c → взвести таймер → применить → проверить новым подключением → снять таймер → зафиксировать в /etc/nftables.conf.
- Таймер должен принадлежать systemd или atd, но не вашей SSH-сессии.
- Окно отката 120 секунд достаточно для проверки; для сложных наборов беру 300.
- Не записывать новый ruleset в /etc/nftables.conf до подтверждения доступа.
Разбор из практики: питомник «Молодая поросль», 23 рабочих места, 42 минуты без шлюза
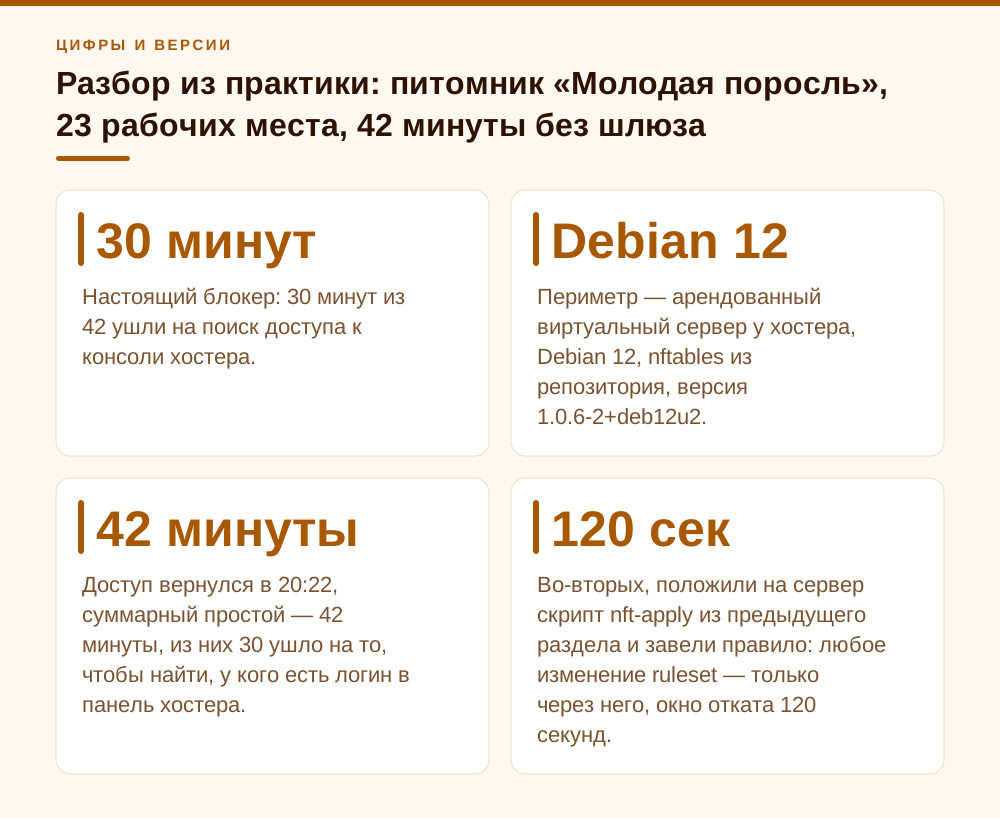
Питомник растений «Молодая поросль»: 23 рабочих места — офис, склад, отгрузка и теплицы, из них 7 человек (менеджеры садовых центров и выездные агрономы) подключаются удалённо. Весной, в сезон продаж саженцев, простой периметра бьёт по отгрузкам сильнее всего, так что шлюз для них — не формальность. Периметр — арендованный виртуальный сервер у хостера, Debian 12, nftables из репозитория, версия 1.0.6-2+deb12u2. На нём же терминируется OpenVPN для удалённых сотрудников и проброс на внутренний сервер 1С. Компания на аутсорсинге у нас, но правила фаервола исторически правил их собственный админ — договорённость была такая, и меня это устраивало ровно до одного четверга.
Задача была штатная: перевести конфиг с давно живущих iptables-правил на нормальный ruleset nftables. Админ собрал файл по статье из интернета, где входной интерфейс был назван eth0. На виртуалке интерфейс назывался ens18 — предсказуемые имена. Ключевое правило выглядело как iifname "eth0" tcp dport 22 accept, политика цепочки — policy drop. Проверка nft -c -f /etc/nftables.conf прошла без единого замечания, что абсолютно логично: iifname сравнивает произвольную строку, и «eth0» для парсера ничем не хуже любой другой. Применение в 19:40, сессия живая, nft list ruleset печатает ровно то, что ожидалось. Админ полюбовался результатом, закоммитил конфиг и в 20:05 закрыл терминал.
Дальше — по учебнику. Обратно не заходит ни он, ни VPN-клиенты, ни мониторинг. Бэкап у него был, файл /root/rules.bak лежал на месте — но снят он был командой nft list ruleset > /root/rules.bak, без первой строки с очисткой. Восстановить его удалённо было невозможно в принципе: чтобы выполнить команду, надо сначала попасть на сервер. Позвонили нам в 20:20. Мы зашли в панель хостера, подняли VNC-консоль, выполнили nft flush ruleset руками, затем nft -f /root/rules.bak — и получили ровно то, что описано выше: старый набор лёг на пустое место нормально, потому что ruleset уже был очищен вручную. Если бы админ попробовал восстановиться «поверх» через ту же консоль, не сделав flush, он получил бы дубли и продолжил бы искать причину. Доступ вернулся в 20:22, суммарный простой — 42 минуты, из них 30 ушло на то, чтобы найти, у кого есть логин в панель хостера.
Что мы сделали после. Во-первых, убрали привязку разрешающего правила SSH к интерфейсу целиком: на этом шлюзе управление ходит только с внешнего адреса, фильтрация по интерфейсу там не давала ничего, кроме риска. Во-вторых, положили на сервер скрипт nft-apply из предыдущего раздела и завели правило: любое изменение ruleset — только через него, окно отката 120 секунд. В-третьих, добавили в чек-лист приёмки клиента строку «есть ли рабочий доступ к аварийной консоли и у кого именно» — оказалось, что на трёх других обслуживаемых площадках пароль от панели хостера знал ровно один уволившийся человек. За последующие полгода через nft-apply прошло больше тридцати применений; таймер реально отработал дважды — оба раза из-за правил, к SSH отношения не имевших, и оба раза никто, кроме админа, этого не заметил.
- Причина инцидента: `iifname "eth0"` при реальном интерфейсе `ens18` — nft -c такое не ловит по определению.
- Усугубляющий фактор: бэкап без строки `flush ruleset`, восстановить который удалённо всё равно было нельзя.
- Настоящий блокер: 30 минут из 42 ушли на поиск доступа к консоли хостера.
- Итог: скрипт применения с таймером отката + проверка доступа к аварийной консоли на всех площадках.
Шаблон ruleset, которым сложно себя запереть
Помимо процедуры применения помогает сама структура набора правил. Я держу правила в своей отдельной таблице и никогда не полагаюсь на глобальный flush в боевом файле. Идиома «add-then-delete» позволяет перезагружать только свою таблицу, не трогая чужие: строка table inet fw создаёт таблицу, если её нет, следующая строка её гарантированно удаляет вместе с содержимым, и дальше идёт полное определение. Всё это внутри одной атомарной транзакции nft -f. В свежих версиях nft и ядра ту же задачу решает команда destroy table inet fw: по nft(8) она удаляет таблицу и не завершается ошибкой, если таблицы нет. Но на Debian 12 с nft 1.0.6 я на неё не рассчитываю и оставляю переносимую пару table + delete table.
#!/usr/sbin/nft -f

# создаём, если нет, затем сносим — так delete не упадёт на чистой системе
table inet fw
delete table inet fw

table inet fw {
    chain input {
        type filter hook input priority filter; policy drop;

        ct state established,related accept
        ct state invalid drop
        iif lo accept

        meta l4proto icmp accept
        meta l4proto ipv6-icmp accept

        # управление — БЕЗ привязки к имени интерфейса
        tcp dport 22 accept

        tcp dport { 80, 443 } accept
        udp dport 1194 accept

        limit rate 5/minute log prefix "nft-drop: " level info
    }

    chain forward { type filter hook forward priority filter; policy drop; }
    chain output  { type filter hook output  priority filter; policy accept; }
}
Три решения здесь спорные, и я скажу об этом прямо. Первое: tcp dport 22 accept без ограничения по источнику — с точки зрения безопасности это хуже, чем разрешение с доверенных подсетей. Но пока вы не отладили процедуру применения и не проверили аварийную консоль, широкое правило для управления безопаснее узкого: попытка сразу сделать «правильно» через ip saddr { ... } tcp dport 22 accept заканчивается локаутом каждый раз, когда админ подключается не с того адреса. Сужайте потом, отдельным изменением, через тот же таймер отката. Второе: policy accept на output — многие считают это дырой; на пограничном шлюзе малого офиса я согласен зажимать output только там, где есть реальное требование комплаенса, в остальных случаях он даёт больше инцидентов, чем защиты. Третье: логирование дропов с limit rate — без ограничения скорости журнал заливает диск за сутки, я видел это не раз.
Отдельная история — хосты с Docker или Kubernetes. Docker на современных Debian/Ubuntu работает через iptables-nft, то есть его цепочки физически живут в nftables и видны в выводе nft list ruleset. Глобальный flush ruleset сносит их вместе с вашими, и контейнерная сеть встаёт до systemctl restart docker. Именно поэтому на таких хостах я не применяю файлы с глобальным flush и не восстанавливаюсь дампом, снятым до старта Docker: только своя таблица, только add-then-delete. Если же вы вынужденно сделали полный откат — сразу перезапускайте docker, не гадая, почему контейнеры потеряли сеть.
- Своя таблица `inet fw` + идиома add-then-delete вместо глобального `flush ruleset`.
- `ct state established,related accept` — первой строкой, иначе рвёт текущую сессию.
- Правило управления без привязки к имени интерфейса, пока процедура применения не отлажена.
- Логирование дропов только с `limit rate`.
- На хостах с контейнерами глобальный flush запрещён: он сносит цепочки iptables-nft от Docker.
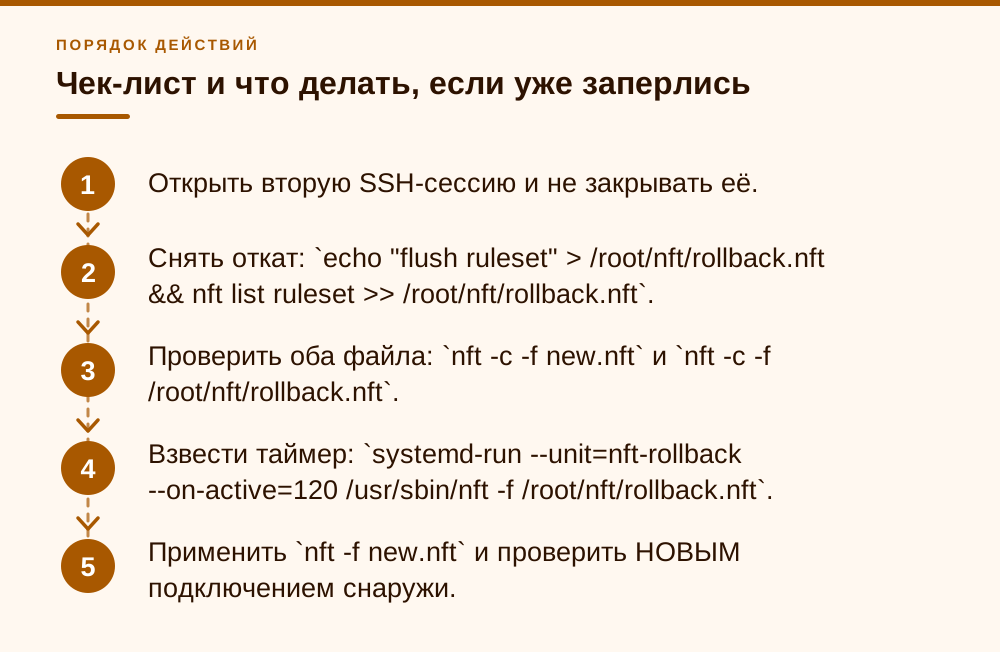
Чек-лист и что делать, если уже заперлись
Сведу всё в короткий порядок действий. Он занимает лишние полторы минуты на каждое изменение и за годы окупился многократно: за последние два года у нас ни одного выезда и ни одного обращения к хостеру за консолью по вине фаервола. Соблюдать его тяжело ровно до первого инцидента — после первого никого уговаривать не приходится.
Если вы читаете это уже из состояния «не захожу», порядок такой. Сначала проверьте, не осталась ли живой какая-нибудь другая сессия — открытая tmux/screen на этом же сервере, соседний контейнер, машина в той же локальной сети, откуда фильтрация может не действовать; из неё всё чинится за десять секунд. Затем — аварийная консоль: у виртуалок это VNC/KVM в панели хостера, у железа — IPMI/iLO/iDRAC или физический серийный порт. Если и этого нет, остаётся перезагрузка через панель: она поможет, если вы не успели записать сломанный набор в /etc/nftables.conf. И только последним номером — режим восстановления (rescue) с монтированием диска и переименованием /etc/nftables.conf, чтобы сервис при старте не поднял поломанные правила.
Что действительно стоит сделать до того, как понадобится: убедиться, что у вас есть логин в аварийную консоль каждого шлюза, что он записан не только в голове одного человека, и что вы им хотя бы раз пользовались. Консоль, к которой вы никогда не подключались, в момент аварии обязательно потребует установить Java-плагин, подтвердить SMS на номер уволившегося сотрудника или пройти капчу, которая не грузится. Это не шутка, это статистика наших ночных вызовов.
И последнее по порядку, но не по важности: nftables быстро развивается, поведение и диагностика в свежих версиях заметно приятнее. В Debian 12 (bookworm) едет 1.0.6, в Debian 13 (trixie) — 1.1.3, в Ubuntu 24.04 — 1.0.9, в Ubuntu 26.04 — 1.1.6, апстрим на начало сентября 2026 года дошёл до 1.1.7. Разница в сообщениях об ошибках между 1.0.x и 1.1.x ощутимая, но ни одна версия не научилась угадывать, что после применения правил вы останетесь без управления. Эту работу по-прежнему делает не парсер, а процедура.
- Открыть вторую SSH-сессию и не закрывать её.
- Снять откат: `echo "flush ruleset" > /root/nft/rollback.nft && nft list ruleset >> /root/nft/rollback.nft`.
- Проверить оба файла: `nft -c -f new.nft` и `nft -c -f /root/nft/rollback.nft`.
- Взвести таймер: `systemd-run --unit=nft-rollback --on-active=120 /usr/sbin/nft -f /root/nft/rollback.nft`.
- Применить `nft -f new.nft` и проверить НОВЫМ подключением снаружи.
- Снять таймер `systemctl stop nft-rollback.timer` и только теперь положить набор в /etc/nftables.conf.
- Убедиться, что доступ к KVM/IPMI-консоли есть минимум у двух человек.
Частые вопросы
Если nft -c -f прошёл без ошибок, можно применять правила на боевом шлюзе?
Можно применять, но не без подстраховки. Ключ -c по документации проверяет только допустимость команд: синтаксис, типы, ссылки на объекты внутри файла. Он не знает имён ваших интерфейсов, порта SSH, порядка правил и того, что рядом живут таблицы ufw или Docker. Успешный -c означает «ядро примет этот набор», а не «после него сервер останется доступен». Перед nft -f всё равно взводите таймер отката.
Почему после nft -f моя SSH-сессия не оборвалась, а зайти заново я не могу?
Потому что flush ruleset не очищает таблицу отслеживания соединений. Ваш поток остался в conntrack и проходит по правилу ct state established,related accept, не доходя до правила с портом 22. Новые подключения при этом отбивает policy drop. Проверять доступность нужно только новым соединением с другой машины — nc -zv host 22 или отдельным ssh, а не нажатием Enter в текущем окне.
Как правильно снять резервную копию набора правил nftables?
Ровно как в официальном примере: сначала записать в файл команду очистки, потом дописать дамп. echo "flush ruleset" > /root/nft/rollback.nft, затем nft list ruleset >> /root/nft/rollback.nft. Восстановление — nft -f /root/nft/rollback.nft, загрузка атомарная. Сразу после снятия прогоните по бэкапу nft -c -f, чтобы убедиться, что он вообще загрузится.
Что будет, если восстановиться из бэкапа, снятого без flush ruleset?
Правила не заменятся, а допишутся. Блоки table и chain при загрузке работают по семантике add: таблица создаётся, если её нет, а правила добавляются в конец существующей цепочки. Поверх сломанного набора вы получите дубли, где первый совпавший drop сработает раньше восстановленного accept, и доступ не вернётся. Перед загрузкой такого файла придётся вручную выполнить nft flush ruleset — а для этого нужно уже быть на сервере.
Как взвести автоматический откат правил, если на сервере нет systemd?
Через демон at: echo "/usr/sbin/nft -f /root/nft/rollback.nft" | at now + 2 minutes, снятие задачи — atq и atrm с её номером. Главное требование — задача должна принадлежать системному демону, а не вашей SSH-сессии. Конструкции вида sleep 120 && nft -f backup в фоне текущего шелла ненадёжны: при обрыве соединения фон может получить SIGHUP и умереть именно тогда, когда он нужен.
Правда ли, что nft flush ruleset ломает Docker?
Да, на современных Debian и Ubuntu Docker работает через iptables-nft, его цепочки физически лежат в nftables и видны в nft list ruleset. Глобальный flush сносит их вместе с вашими, и сеть контейнеров встаёт до systemctl restart docker. На таких хостах держите правила в своей таблице и перезагружайте только её идиомой table inet fw / delete table inet fw, не трогая глобальный набор.
Источники
- nft(8), руководство nftables 1.1.3 — Раздел OPTIONS: -c/--check («Check commands validity without actually applying the changes»), -f/--file, -o/--optimize («You can combine this option with -c to inspect the proposed optimizations»), -s/--stateless; команды flush ruleset, delete/destroy table. https://www.netfilter.org/projects/nftables/manpage.html ; исходный текст: https://sources.debian.org/src/nftables/1.1.3-1/doc/nft.txt/
- nftables wiki — Operations at ruleset level — Разделы «Listing the ruleset», «Flushing the ruleset» и официальный пример резервного копирования и восстановления (echo "flush ruleset" > backup.nft; nft list ruleset >> backup.nft; nft -f backup.nft): https://wiki.nftables.org/wiki-nftables/index.php/Operations_at_ruleset_level
- nftables wiki — Atomic rule replacement — Описание атомарной загрузки набора правил через nft -f: конфигурация собирается в памяти рядом с действующей и подменяется одной атомарной операцией. https://wiki.nftables.org/wiki-nftables/index.php/Atomic_rule_replacement
- netfilter.org — релизы nftables — Актуальные версии проекта: nftables 1.1.7 (1 сентября 2026), 1.1.6 (5 декабря 2025), 1.1.5 (27 августа 2025). https://netfilter.org/projects/nftables/index.html
- Debian и Ubuntu — версии пакета nftables — Debian 12 bookworm 1.0.6-2+deb12u2, Debian 13 trixie 1.1.3-1, Debian forky 1.1.7-1: https://packages.debian.org/search?keywords=nftables ; Ubuntu 22.04 — 1.0.2, 24.04 — 1.0.9, 26.04 — 1.1.6: https://launchpad.net/ubuntu/+source/nftables
- Debian Wiki — nftables — Правила по умолчанию лежат в /etc/nftables.conf и загружаются при старте nftables.service (systemctl enable nftables.service); iptables в Debian с 10 Buster по умолчанию работает через слой iptables-nft. https://wiki.debian.org/nftables
- systemd-run(1) — Ключи --unit, --on-active, --timer-property: при таймерном запуске создаются transient-юниты .timer и .service, сразу стартует только таймер. https://man7.org/linux/man-pages/man1/systemd-run.1.html