
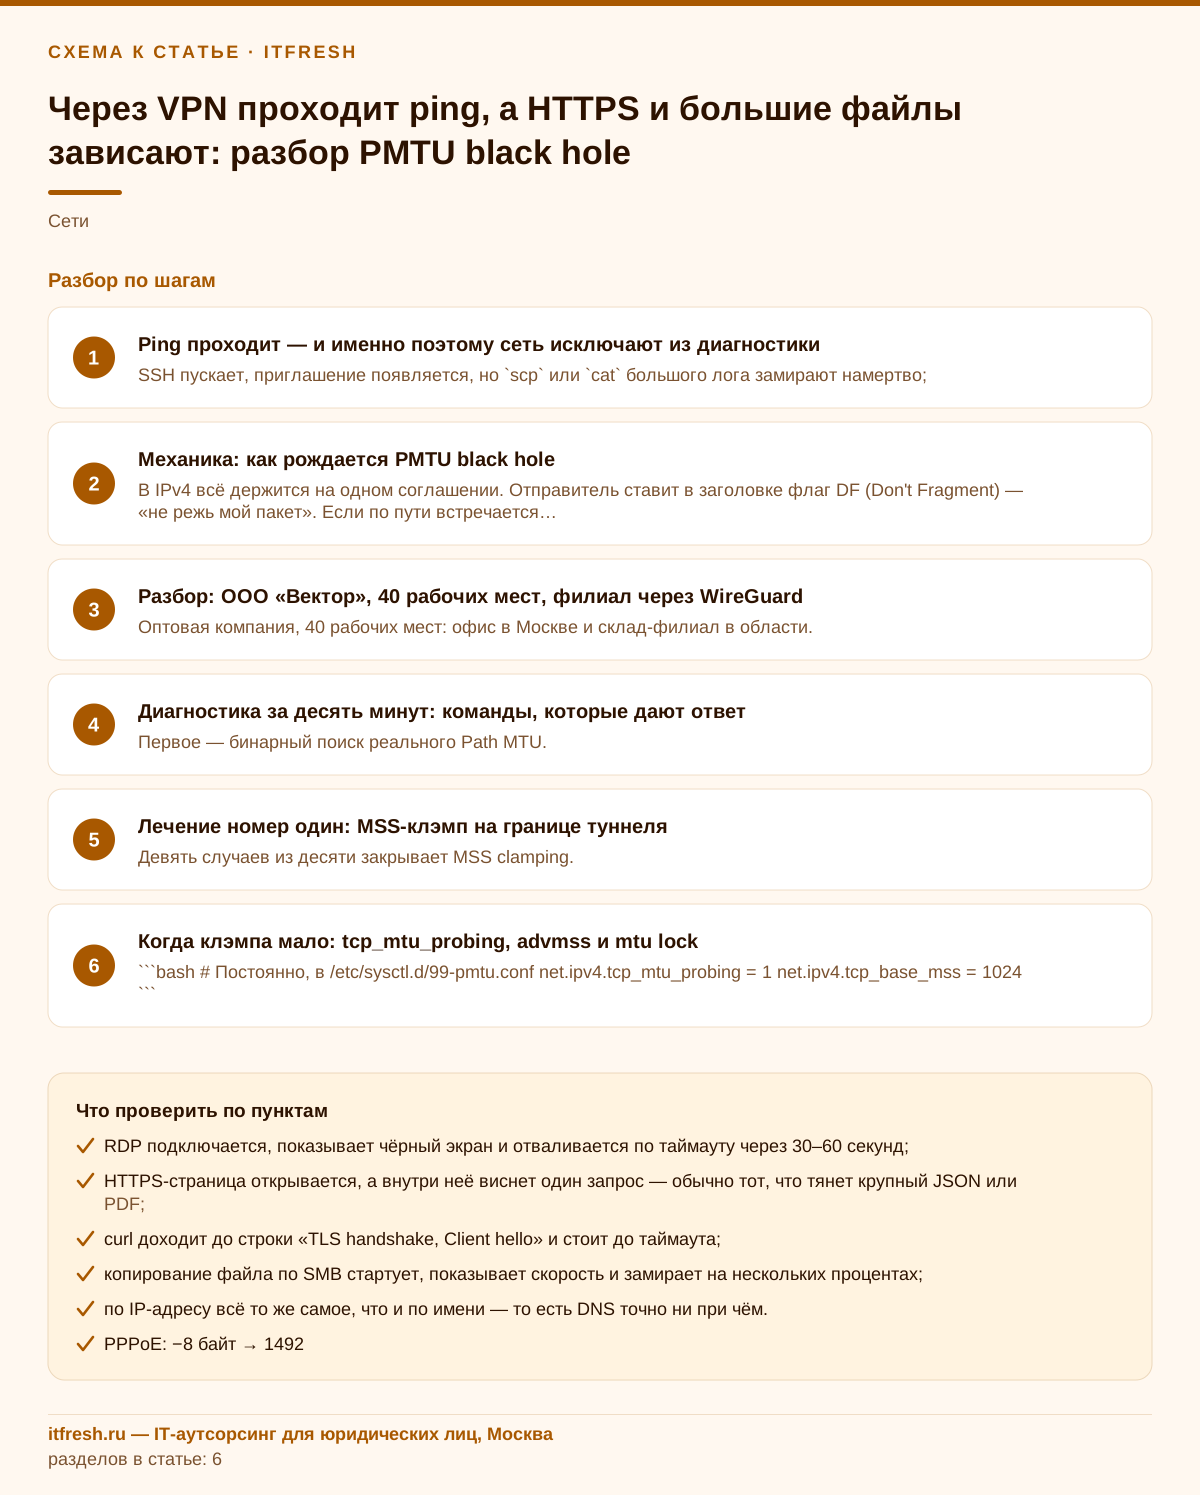
Через VPN проходит ping, а HTTPS и большие файлы зависают: разбор PMTU black hole
Это статья для сисадмина, у которого «сеть в порядке, я пинганул», а пользователи вторую неделю не могут распечатать договор или выгрузить отчёт через VPN. Покажу, почему маленькие пакеты обманывают диагностику, как за десять минут отличить проблему MTU от TLS и DNS, и какие ровно четыре правки я вношу на границе туннеля, чтобы это закрылось навсегда.
Ping проходит — и именно поэтому сеть исключают из диагностики
Звонок в понедельник в 10:15: «Терминалка отваливается, из 1С не выгружается печатная форма, файлы с шары копируются до 30 % и встают». Первый вопрос, который я задаю: «Пинг до сервера идёт?» Ответ всегда один и тот же — идёт, 12 мс, потерь ноль. И дальше две недели меняют сервер приложения, переустанавливают клиента 1С, грешат на антивирус и на «кривой Windows». А проблема всё это время лежит в размере пакетов, которые пропускает путь между площадками, и её отлично видно, если задать ping правильный размер пакета.
Ping в Linux по умолчанию отправляет 56 байт данных — вместе с 8 байтами ICMP и 20 байтами IP это 84-байтный пакет; Windows шлёт и того меньше, 32 байта. Такой пакет пролезет через любой самый ужатый туннель. Вся полезная нагрузка бизнес-трафика — это, наоборот, пакеты в размер MTU: TLS-сертификат сервера, блок SMB, кусок RDP-графики, ответ 1С с печатной формой. Ping отвечает на вопрос «есть ли маршрут», а не на вопрос «какого размера пакет по этому маршруту доедет». Это два разных вопроса, и подмена одного другим стоит компаниям недель простоя.
Узнаваемые симптомы, которые я слышу из раза в раз и которые почти гарантированно означают MTU:
Общее у всех этих случаев одно: соединение УСТАНАВЛИВАЕТСЯ. Трёхстороннее рукопожатие TCP — это три крохотных пакета, они пролезают всегда. Умирает первая же передача данных в полный размер сегмента. Поэтому «подключается, но не работает» — это по умолчанию сетевой диагноз, а не прикладной.
- SSH пускает, приглашение появляется, но `scp` или `cat` большого лога замирают намертво;
- RDP подключается, показывает чёрный экран и отваливается по таймауту через 30–60 секунд;
- HTTPS-страница открывается, а внутри неё виснет один запрос — обычно тот, что тянет крупный JSON или PDF;
- curl доходит до строки «TLS handshake, Client hello» и стоит до таймаута;
- копирование файла по SMB стартует, показывает скорость и замирает на нескольких процентах;
- по IP-адресу всё то же самое, что и по имени — то есть DNS точно ни при чём.
Механика: как рождается PMTU black hole
В IPv4 всё держится на одном соглашении. Отправитель ставит в заголовке флаг DF (Don't Fragment) — «не режь мой пакет». Если по пути встречается интерфейс с меньшим MTU, маршрутизатор обязан выбросить пакет и вернуть отправителю ICMP type 3 code 4 — «fragmentation needed and DF set», причём с указанием, какой MTU он готов пропустить. Отправитель получает это сообщение, запоминает новый Path MTU для этого адреса в кэше маршрутов и начинает слать сегменты поменьше. Схема описана в RFC 1191 ещё в 1990 году и живёт до сих пор; там же сказано, что пробовать снова увеличить PMTU стоит не чаще, чем раз в 10 минут, — в Linux за это отвечает время жизни записи в кэше mtu_expires.
Ломается она в одном месте: когда ICMP-сообщение не доезжает обратно. Причин ровно три, и все три я вижу в реальных сетях еженедельно. Первая — на файрволе кто-то когда-то написал «ICMP наружу запретить» целиком, вместо того чтобы резать только echo. Вторая — тот же запрет стоит у провайдера или у хостера, и вы на него не влияете. Третья, самая коварная и хорошо описанная в разборе Cloudflare: ECMP-балансировка. TCP-пакеты балансировщик раскладывает по хэшу от адресов и портов, а про ICMP ничего не знает и хэширует только пару адресов, причём источник ICMP-ошибки — промежуточный роутер. В итоге сообщение прилетает не на тот сервер, который держит TCP-сессию, и просто выбрасывается.
Дальше начинается то, что называется PMTU black hole. Отправитель не знает, что упёрся. Он честно ретранслирует тот же самый крупный сегмент — раз, два, четыре, восемь секунд, экспоненциальный backoff. Со стороны это выглядит как «зависло». Мелкие сегменты в это время продолжают ходить: ACK, keepalive, ping — всё живо. Пользователь видит, что «интернет есть, а не работает», и вы вместе с ним смотрите в сторону приложения. TCP при этом ведёт себя абсолютно корректно — он просто не получил информации, которую сеть обязана была ему дать.
Отдельно стоит понимать, почему именно TLS страдает так наглядно. ClientHello — это несколько сотен байт, он улетает без проблем. А в ответ прилетает ServerHello вместе с цепочкой сертификатов: три-пять килобайт, то есть три-четыре полноразмерных сегмента подряд. Первый же из них упирается в узкое место и исчезает. Соединение установлено, рукопожатие начато, данных нет. Ровно та картинка, из-за которой люди неделями чинят «сертификаты».
В IPv6 всё ещё жёстче. Маршрутизаторы там не фрагментируют пакеты вообще: по RFC 8200 фрагментировать может только отправитель, а о слишком крупном пакете сообщает ICMPv6 type 2 «Packet Too Big» (механизм описан в RFC 8201). Если этот тип ICMPv6 режется на файрволе, у IPv6 нет даже теоретического запасного пути через фрагментацию по дороге. Поэтому RFC 4890 прямо относит Packet Too Big к сообщениям, которые фильтровать нельзя, а минимальный MTU канала для IPv6 зафиксирован на 1280 байтах.
- Отправитель шлёт полноразмерный сегмент с флагом DF (в IPv6 DF подразумевается всегда).
- Узкий участок, чаще всего вход в туннель или PPPoE-канал, отбрасывает пакет и формирует ICMP type 3 code 4 или ICMPv6 Packet Too Big.
- ICMP теряется на файрволе, у провайдера или уходит по ECMP не на тот узел.
- Отправитель не меняет размер и ретранслирует тот же сегмент с экспоненциально растущей паузой.
- Мелкие пакеты (ACK, keepalive, ping) продолжают ходить, и снаружи всё выглядит как «сеть есть, приложение зависло».
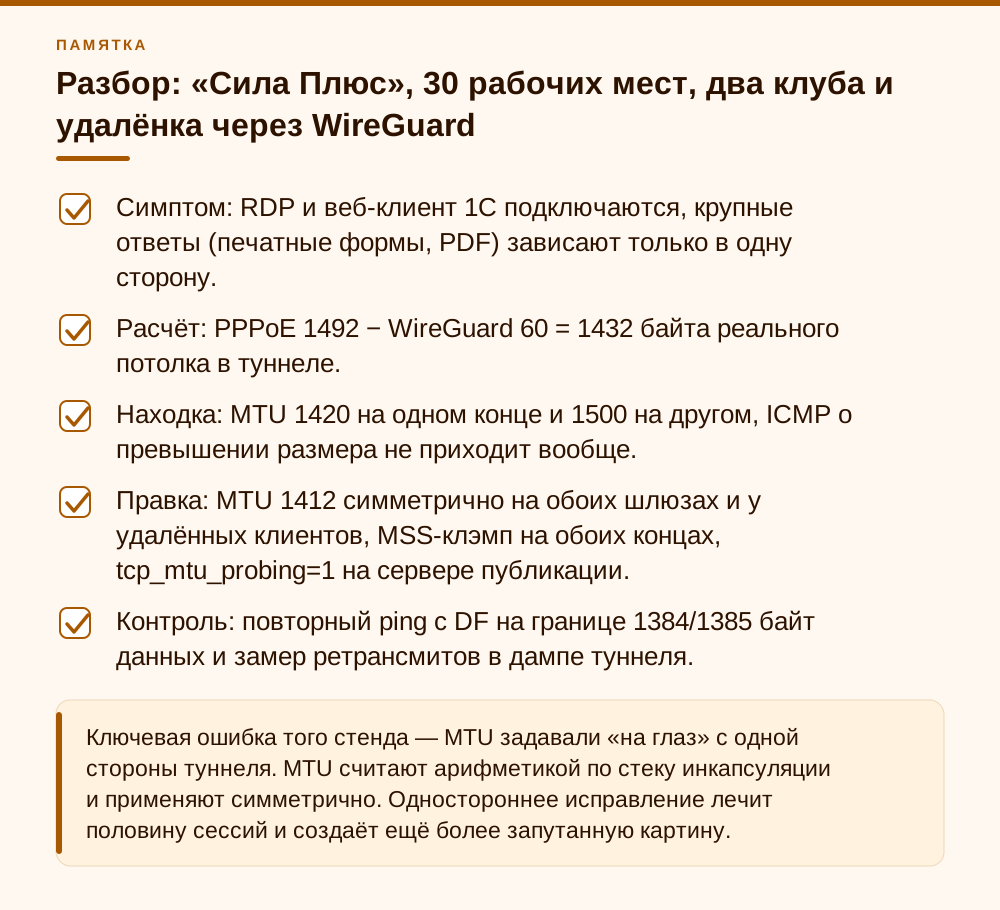
Разбор: «Сила Плюс», 30 рабочих мест, два клуба и удалёнка через WireGuard
Сеть тренажёрных залов «Сила Плюс», 30 рабочих мест: главный клуб с сервером 1С и терминальным сервером, второй клуб на другом конце города (ресепшн, продажи абонементов, фитнес-менеджеры) и трое сотрудников на удалёнке — бухгалтер, маркетолог и управляющий. В главном клубе шлюз на Linux, во втором — Keenetic, между ними WireGuard на udp/51820; удалённые сотрудники подключаются тем же WireGuard с ноутбуков. Заявка звучала так: «RDP-сеанс с 1С работает, но как только администратор ресепшн во втором клубе жмёт печать договора абонемента — сеанс замерзает и через минуту рвётся». Параллельно бухгалтер из дома жаловалась, что выгрузка отчёта в PDF встаёт на середине. До меня две недели чинили сервер 1С, откатывали платформу и добавили терминальному серверу четыре гигабайта памяти. Не помогло, разумеется.
Считаем бюджет байтов, а не гадаем. Провайдер второго клуба отдаёт канал по PPPoE — это минус 8 байт, честный MTU 1492, а не 1500. Сверху WireGuard поверх IPv4: 20 байт внешнего IP + 8 байт UDP + 32 байта собственного заголовка и Poly1305-тега, итого минус 60. Реальный потолок внутри туннеля — 1432 байта. На шлюзе главного клуба интерфейс поднимали через wg-quick без явного MTU: он вычел свои 80 байт из 1500 и выставил 1420. А на Keenetic туннель настраивали руками, и там осталось наследственное 1500. Асимметрия: из главного клуба крупные пакеты уходили в туннель сегментами до 1420 и доезжали, а в обратную сторону Keenetic заворачивал в туннель пакеты до 1500, внешний UDP-пакет перерастал PPPoE-канал, фрагменты по пути терялись — и никакого ICMP отправитель внутри туннеля не получал.
Подтвердил за три минуты бинарным поиском с ПК на ресепшн второго клуба. ping -f -l 1392 до терминального сервера — проходит (1392 + 8 байт ICMP + 20 байт IP = 1420). ping -f -l 1393 — не «Packet needs to be fragmented but DF set», а просто «Превышен интервал ожидания для запроса». Отказ без сообщения об ошибке уже подозрителен. А tcpdump -ni any 'icmp[icmptype] == 3 and icmp[icmpcode] == 4' на шлюзе главного клуба во время зависшей печати не показал НИ ОДНОГО пакета, при том что в дампе туннельного интерфейса один и тот же сегмент ретранслировался с растущими интервалами. Это и есть подпись чёрной дыры: пакеты теряются, а сообщить об этом отправителю некому.
Лечение заняло 20 минут. Выставил MTU туннеля явно, 1412, на обеих сторонах — на Keenetic и строкой MTU = 1412 в конфиге wg-quick, с запасом в 20 байт от расчётных 1432: провайдер имеет право однажды добавить ещё один уровень инкапсуляции, и я не хочу возвращаться к этой задаче. Тот же MTU прописал в клиентских конфигах WireGuard у трёх удалённых сотрудников — домашние роутеры бывают и с PPPoE, и с мобильным модемом. Включил MSS-клэмп по PMTU на обоих шлюзах, не на одном. На Linux-сервере веб-публикации 1С добавил tcp_mtu_probing=1 с tcp_base_mss=1024. Результат: печать договора абонемента перестала рвать сеанс, выгрузка PDF-отчёта на 2 МБ у бухгалтера вместо 40 секунд с обрывом стала занимать 1,6 секунды, доля ретрансмитов в дампе туннеля упала примерно с 12 % до величины ниже 0,1 %. Сервер, который две недели «не тянул», оказался ни при чём.
- Симптом: RDP и веб-клиент 1С подключаются, крупные ответы (печатные формы, PDF) зависают только в одну сторону.
- Расчёт: PPPoE 1492 − WireGuard 60 = 1432 байта реального потолка в туннеле.
- Находка: MTU 1420 на одном конце и 1500 на другом, ICMP о превышении размера не приходит вообще.
- Правка: MTU 1412 симметрично на обоих шлюзах и у удалённых клиентов, MSS-клэмп на обоих концах, tcp_mtu_probing=1 на сервере публикации.
- Контроль: повторный ping с DF на границе 1384/1385 байт данных и замер ретрансмитов в дампе туннеля.
Диагностика за десять минут: команды, которые дают ответ
Первое — бинарный поиск реального Path MTU. В Linux флаг -M do заставляет ставить DF, а -s задаёт полезную нагрузку ICMP: к ней прибавляем 8 байт ICMP-заголовка и 20 байт IP, чтобы получить размер пакета. В Windows то же самое делает ping -f -l <размер> — там -l тоже payload, арифметика та же. Полезно помнить, что означают ответы. «Frag needed and DF set (mtu = N)» в Linux или «Packet needs to be fragmented but DF set» в Windows — это ICMP от роутера, PMTUD работает. «local error: message too long, mtu=N» — пакет не пролез в собственный интерфейс отправителя. А простая тишина на крупном размере при живом мелком ping — первый признак чёрной дыры.
Второе — понять, где именно узкое место, и приходят ли вообще ICMP-ошибки. tracepath для этого удобнее traceroute: он прямо печатает pmtu на том хопе, где размер срезался. А tcpdump с фильтром по ICMP unreachable отвечает на главный вопрос: у вас честное сужение канала (ICMP приходит, PMTUD работает, но кто-то поставил MTU 1400 и забыл) или чёрная дыра (ICMP не приходит вовсе).
Третье и самое важное на практике — отличить MTU от TLS и от DNS, потому что путают эти три диагноза постоянно. Различия жёсткие. При проблеме TLS соединение падает БЫСТРО и с внятным текстом: unknown ca, handshake failure, alert protocol version. При проблеме MTU оно висит молча до таймаута, а curl застревает ровно после строки про Client hello. При проблеме DNS резолв виснет или отдаёт NXDOMAIN, но обращение по IP-адресу работает штатно — а при MTU по IP всё виснет ровно так же, как по имени.
И редкий, но злой частный случай: DNS сам может страдать от MTU. Ответ с DNSSEC-подписями по UDP легко перевалит за полторы тысячи байт, фрагментируется и не доедет. Начиная с BIND 9.16.8 и dig, и сервер по умолчанию используют EDNS-буфер 1232 байта — это решение DNS Flag Day 2020 ровно против фрагментации, но старые резолверы и DNS-форвардеры в роутерах до сих пор анонсируют 4096. Симптом — «часть зон резолвится, часть нет». Проверка простая: запросить крупную запись с +bufsize=4096 и с +bufsize=1232, а затем принудительно по TCP. Если с большим буфером ответ пропадает, а с малым и по TCP приходит — это снова MTU, просто в другом костюме. Тип ANY для таких тестов не берите: по RFC 8482 серверы вправе отвечать на него минимально.
- ```bash # Бинарный поиск: -s это payload, реальный пакет = payload + 8 (ICMP) + 20 (IP) ping -M do -s 1472 172.16.20.10 # соответствует MTU 1500 ping -M do -s 1404 172.16.20.10 # соответствует MTU 1432 — проходит ping -M do -s 1405 172.16.20.10 # уже нет: «Frag needed» от роутера — или тишина, то есть чёрная дыра # Windows-клиент, та же арифметика ping -f -l 1404 172.16.20.10 ```
- ```bash # Где режется путь и какой pmtu видит стек tracepath -n 172.16.20.10 ip route get 172.16.20.10 # покажет закэшированный mtu, если PMTUD сработал # Приходят ли вообще ICMP fragmentation needed tcpdump -ni any 'icmp[icmptype] == 3 and icmp[icmpcode] == 4' # Ретрансмиты и согласованный MSS по живому сокету ss -ti state established '( dport = :443 )' ```
- ```bash # Отделяем MTU от TLS: verbose-вывод замирает после Client hello — это MTU curl -v --max-time 20 https://1c.example.local/ # Отделяем от DNS: если по IP виснет так же — DNS ни при чём curl -v --resolve 1c.example.local:443:172.16.20.10 https://1c.example.local/ # Большие DNS-ответы и фрагментация UDP dig +dnssec +bufsize=4096 @172.16.20.2 example.org DNSKEY dig +dnssec +bufsize=1232 @172.16.20.2 example.org DNSKEY dig +dnssec +tcp @172.16.20.2 example.org DNSKEY ```
Лечение номер один: MSS-клэмп на границе туннеля
Девять случаев из десяти закрывает MSS clamping. Идея простая: раз мы не можем положиться на то, что ICMP дойдёт, мы вмешиваемся в сам момент установки TCP-сессии и подменяем в SYN-пакете опцию Maximum Segment Size на такую, которая гарантированно пролезет. Стороны договариваются о маленьких сегментах ещё до того, как успеют упереться. Ключевое ограничение честно записано в мануале iptables: работает это только на SYN и SYN/ACK, потому что MSS согласуется исключительно при рукопожатии.
Вариант --clamp-mss-to-pmtu (в MikroTik — clamp-to-pmtu) берёт Path MTU маршрута к адресату и вычитает 40 байт для IPv4 или 60 для IPv6 — так это описано в iptables-extensions. Он удобен тем, что не требует магических чисел и переживает смену канала. Фиксированное значение --set-mss я ставлю там, где интерфейс не отражает реальный путь — например, когда за туннелем есть ещё один уровень инкапсуляции, о котором локальный роутер не знает. Тогда 1360 для IPsec и 1380 для WireGuard — рабочие консервативные значения.
Правило ставится на маршрутизаторе, через который трафик проходит транзитом, то есть в цепочку forward, и обязательно с обеих сторон туннеля. Клэмп на одном конце правит только те сессии, чей SYN идёт через него, а SYN/ACK встречного направления уйдёт с исходным MSS. Именно поэтому «я же уже настраивал mss, не помогло» — самая частая фраза при разборе таких инцидентов.
Честно про границы метода. MSS-клэмп не лечит UDP вообще: ни QUIC, ни VoIP, ни DNS, ни IPsec, обёрнутый в UDP при NAT-T. Отсюда классическая жалоба «в Chrome виснет, а в curl нет» — браузер ушёл в HTTP/3 поверх QUIC и ваш клэмп его не касается. Если такое воспроизводится, лечите MTU интерфейса по-настоящему, а не только TCP-подсказкой. Отдельно про OpenVPN: у него mssfix задаёт не MSS, а размер уже зашифрованного UDP-пакета, и в версии 2.6 значение по умолчанию — 1492 с учётом внешних заголовков. Путать его с ip tcp adjust-mss на Cisco — частая ошибка при переносе настроек.
- ```bash # nftables — современный вариант; таблица inet покрывает и IPv4, и IPv6 nft add table inet mangle nft add chain inet mangle forward '{ type filter hook forward priority mangle; policy accept; }' nft add rule inet mangle forward tcp flags syn tcp option maxseg size set rt mtu ```
- ```bash # iptables: универсальный клэмп по PMTU iptables -t mangle -A FORWARD -p tcp --tcp-flags SYN,RST SYN -j TCPMSS --clamp-mss-to-pmtu # iptables: жёсткое значение для конкретного туннеля iptables -t mangle -A FORWARD -o wg0 -p tcp --tcp-flags SYN,RST SYN -j TCPMSS --set-mss 1380 ```
- ``` # MikroTik / RouterOS /ip firewall mangle add chain=forward protocol=tcp tcp-flags=syn action=change-mss new-mss=clamp-to-pmtu out-interface=wg-office # Cisco IOS, на туннельном интерфейсе interface Tunnel0 ip tcp adjust-mss 1360 # OpenVPN 2.6, в конфиге обеих сторон. По умолчанию mssfix 1492 mtu: # итоговый UDP-пакет вместе с IP-заголовком не больше 1492 байт. # Это размер внешнего пакета, а не MSS; для узкого канала уменьшаем mssfix 1400 mtu ```
Когда клэмпа мало: tcp_mtu_probing, advmss и mtu lock
Иногда влезть в промежуточный роутер нельзя — чужой периметр, облачный балансировщик, канал провайдера. Тогда лечим со стороны сервера. В ядре Linux есть механизм RFC 4821 — Packetization Layer Path MTU Discovery, который не полагается на ICMP вообще, а нащупывает рабочий размер сегмента сам, по факту потерь. Документация ip-sysctl описывает tcp_mtu_probing буквально так: 0 — выключено, 1 — «Disabled by default, enabled when an ICMP black hole detected», 2 — «Always enabled, use initial MSS of tcp_base_mss».
Я ставлю единицу, не двойку, и вот почему. При значении 2 каждое соединение стартует с MSS из tcp_base_mss — то есть с сознательно заниженного размера, — и потом растёт вверх. На здоровой сети это лишний прогрев и просевшая пропускная способность на коротких сессиях, а коротких сессий у веб-сервера подавляющее большинство. Единица включает поиск только когда ядро реально распознало чёрную дыру. Cloudflare в разборе «Path MTU discovery in practice» советует именно tcp_mtu_probing=1 в паре с tcp_base_mss=1024 — это поднимает стартовый размер поиска до значения, которое предлагает RFC 4821; в современных ядрах 1024 уже стоит по умолчанию, и явная строка нужна скорее для старых систем. Двойку я включаю точечно — на хостах, которые сами работают через заведомо проблемный путь, где ICMP не приходит никогда.
Второй инструмент — параметры маршрута. Их регулярно путают, а разница принципиальная. advmss меняет только подсказку MSS, которую ядро объявит в SYN: по мануалу ip-route это «the MSS to advertise to these destinations when establishing TCP connections», и на UDP это не влияет никак. mtu в маршруте, наоборот, ограничивает размер любых пакетов в это направление, включая UDP. А модификатор lock полностью отключает Path MTU Discovery к цели: «no path MTU discovery will be tried, all packets will be sent without the DF bit». Последнее — тяжёлая артиллерия, к которой я прибегаю только когда точно знаю, что промежуточная фрагментация допустима.
Чего трогать НЕ надо. ip_no_pmtu_disc — не выключайте PMTUD глобально, это не решение, а способ размазать проблему по всему хосту. min_pmtu со значением по умолчанию 552 менять смысла нет. И не надо крутить tcp_mtu_probe_floor (по умолчанию 48), tcp_probe_threshold (8 байт) и tcp_probe_interval (10 минут по RFC 4821) — дефолты там разумные, а последствия правок вы будете ловить месяцами.
- ```bash # Постоянно, в /etc/sysctl.d/99-pmtu.conf net.ipv4.tcp_mtu_probing = 1 net.ipv4.tcp_base_mss = 1024 # применить без перезагрузки: sysctl --system ```
- ```bash # advmss — только подсказка TCP при рукопожатии, UDP не касается ip route change default via 172.16.20.1 dev wg0 advmss 1380 # mtu — режет ВСЕ пакеты в это направление, включая UDP ip route add 172.16.30.0/24 via 172.16.20.1 mtu 1400 # mtu lock — плюс к этому отключает PMTUD и снимает DF. Крайняя мера ip route add 172.16.30.0/24 via 172.16.20.1 mtu lock 1400 ```
- ``` # Windows-сторона, если проблемный хост — сервер на Windows netsh interface ipv4 show subinterfaces netsh interface ipv4 set subinterface "Ethernet" mtu=1400 store=persistent ```
Порядок действий и бюджет байтов: что делать первым, на что забить
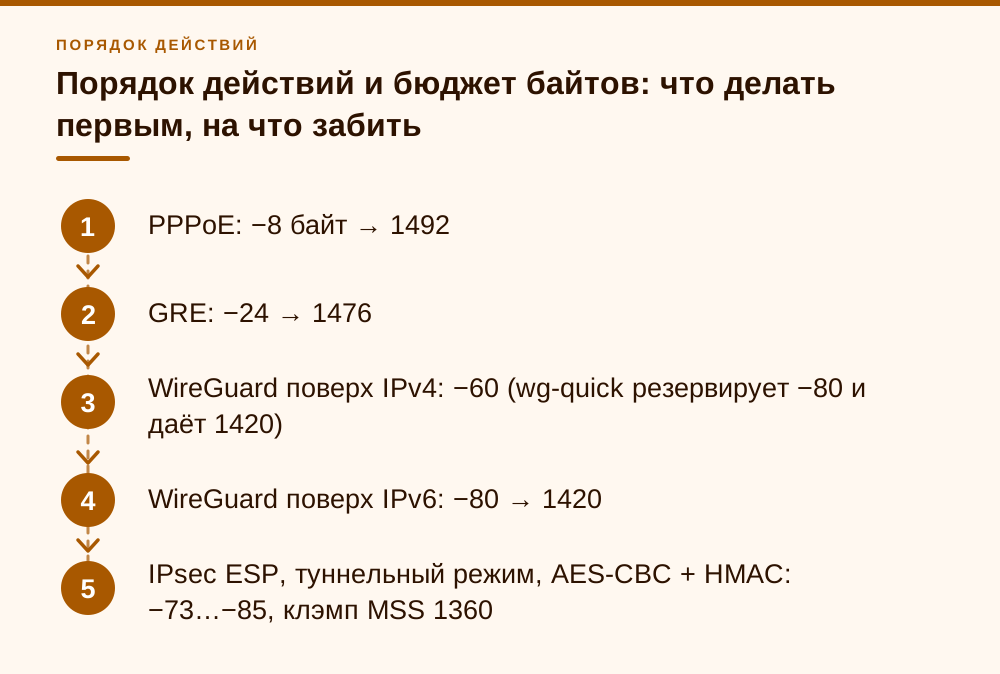
Мой порядок работ на любом стенде с туннелями выглядит так. Первое — MSS-клэмп на границе, симметрично, 20 минут работы, закрывает подавляющее большинство инцидентов. Второе — посчитать реальный MTU туннеля арифметикой по стеку инкапсуляции и выставить его явно, с запасом в 10–20 байт на будущее. Третье — tcp_mtu_probing=1 на серверах, которые отдают большие ответы: веб-публикации 1С, файловые сервисы, почта. Четвёртое, и его пропускают чаще всего, — разрешить входящий ICMP type 3 code 4 на всех файрволах по пути. Это не дыра в безопасности, это условие работоспособности IPv4.
Считать бюджет байтов нужно по стеку, а не по памяти. Ниже накладные расходы, которые я держу в голове и советую выписать на стену серверной. Складывайте их, если инкапсуляций несколько: WireGuard поверх PPPoE — это минус 68 от 1500, и никак иначе.
На что можно спокойно забить. Не гоняйтесь за последними двадцатью байтами MTU — разница между 1412 и 1432 в реальной работе неощутима, а риск словить регрессию при смене провайдера вполне реален. Не включайте jumbo frames «чтобы стало быстрее»: внутри одного коммутатора это работает, а стоит трафику выйти за его пределы — вы получите ровно тот же чёрный ящик, только злее и с гораздо более редким воспроизведением. Не трогайте ip_no_pmtu_disc. И самое главное — не меняйте сервер приложения, пока не выполнили ping с флагом DF.
И последнее наблюдение, чисто практическое. Проблемы MTU почти всегда появляются не сами по себе, а после изменения: подняли новый туннель, переехали на другого провайдера, включили PPPoE вместо IPoE, добавили ещё один слой VPN поверх существующего. Если жалобы на «зависания» стартовали в понедельник, а в пятницу что-то меняли в периметре — смотрите MTU первым делом. У меня это правило не подводило ни разу за пятнадцать лет.
- PPPoE: −8 байт → 1492
- GRE: −24 → 1476
- WireGuard поверх IPv4: −60 (wg-quick резервирует −80 и даёт 1420)
- WireGuard поверх IPv6: −80 → 1420
- IPsec ESP, туннельный режим, AES-CBC + HMAC: −73…−85, клэмп MSS 1360
- IPsec с NAT-T (ESP в UDP): дополнительно −8
- OpenVPN UDP: −40…−69 в зависимости от шифра и сжатия
- VXLAN: −50
- Минимумы: IPv4 — каждый узел обязан принять датаграмму 576 байт (RFC 791), минимальный MTU канала 68; IPv6 — минимальный MTU канала 1280 (RFC 8200)
Частые вопросы
Почему ping проходит, а HTTPS зависает?
Потому что обычный ping отправляет 56 байт данных в Linux и 32 в Windows, а HTTPS сразу после ClientHello получает в ответ цепочку сертификатов на три-пять килобайт — то есть несколько полноразмерных сегментов подряд. Мелкие пакеты пролезают через любое сужение канала, крупные упираются и молча теряются. Проверяйте пингом с флагом DF и заданным размером: `ping -M do -s 1404 адрес` в Linux или `ping -f -l 1404 адрес` в Windows.
Как за минуту отличить проблему MTU от проблемы с TLS или DNS?
Три признака. При проблеме TLS соединение падает быстро и с внятной ошибкой — unknown ca, handshake failure. При MTU оно висит молча до таймаута, а `curl -v` замирает сразу после строки про Client hello. При DNS резолв виснет или отдаёт NXDOMAIN, но обращение по IP работает штатно; при MTU обращение по IP виснет ровно так же, как по имени. Проверяется одной командой `curl -v --resolve имя:443:IP https://имя/`.
Что такое PMTU black hole и чем он опасен?
Это ситуация, когда маршрутизатор отбрасывает слишком крупный пакет с флагом DF, но ICMP type 3 code 4 не доезжает до отправителя — его режет файрвол или уводит не туда ECMP-балансировка. Отправитель не узнаёт о лимите и бесконечно ретранслирует тот же сегмент. Мелкий трафик при этом ходит нормально, поэтому сеть исключают из диагностики и неделями чинят приложение.
Всегда ли достаточно включить MSS clamping?
Нет. Клэмп работает только на SYN и SYN/ACK и только для TCP — так прямо написано в мануале iptables. Он не лечит UDP: ни QUIC, ни VoIP, ни крупные DNS-ответы, ни IPsec поверх UDP при NAT-T. Отсюда типовая жалоба «в Chrome виснет, а в curl нет»: браузер ушёл на HTTP/3 поверх QUIC. Если такое воспроизводится, нужно править MTU интерфейса, а не только подсказку TCP.
tcp_mtu_probing ставить в 1 или в 2?
Я ставлю 1. По документации ядра единица включает поиск MTU только когда обнаружена чёрная дыра, а двойка включает его всегда и стартует с заниженного MSS из tcp_base_mss — это лишний прогрев и просевшая скорость на коротких сессиях, которых у веб-сервера большинство. Рабочая связка, которую рекомендует и Cloudflare: tcp_mtu_probing=1 плюс tcp_base_mss=1024.
Чем advmss отличается от mtu в параметрах маршрута?
advmss меняет только значение MSS, которое ядро объявит при установке TCP-соединения, — на UDP он не влияет вообще. Параметр mtu ограничивает размер любых пакетов в это направление, включая UDP. Модификатор lock дополнительно отключает Path MTU Discovery к цели и снимает флаг DF, то есть разрешает фрагментацию по пути. Это крайняя мера, а не первый шаг.
Какой MTU выставлять для WireGuard?
Считать, а не угадывать. WireGuard поверх IPv4 отнимает 60 байт (20 IP + 8 UDP + 32 собственных), поверх IPv6 — 80. Если снизу ещё PPPoE, вычитайте дополнительные 8 от 1500. wg-quick по умолчанию определяет MTU по маршруту до endpoint и резервирует 80 байт, поэтому на обычном 1500-байтном интерфейсе получается 1420 — консервативное и безопасное значение. Главное — задать MTU симметрично на обеих сторонах туннеля.
Источники
- Linux kernel documentation, IP Sysctl — Раздел «tcp_mtu_probing» (значения 0/1/2), «tcp_base_mss», «tcp_mtu_probe_floor» (default 48), «tcp_probe_threshold» (8 байт), «tcp_probe_interval» (10 минут, RFC 4821), «ip_no_pmtu_disc», «min_pmtu» (552), «mtu_expires» — https://docs.kernel.org/networking/ip-sysctl.html
- man 8 ip-route, iproute2 — Опции маршрута «mtu MTU» и «mtu lock MTU» (при lock PMTUD не выполняется, пакеты идут без DF), «advmss NUMBER» — MSS, объявляемый при установке TCP-соединения — https://man7.org/linux/man-pages/man8/ip-route.8.html
- man 8 iptables-extensions, target TCPMSS — Опции «--set-mss value» и «--clamp-mss-to-pmtu», ограничение «You can only use this on TCP SYN or SYN/ACK packets», предупреждение о блокировке ICMP и PMTU black hole — https://man7.org/linux/man-pages/man8/iptables-extensions.8.html
- Cloudflare Blog — Path MTU discovery in practice — ICMP type 3 code 4, потеря ICMP из-за файрволов и ECMP-хэширования, рекомендации «ip route change default via <> advmss 1400», tcp_mtu_probing=1 совместно с tcp_base_mss=1024 — https://blog.cloudflare.com/path-mtu-discovery-in-practice/
- man 8 wg-quick, WireGuard — Опция MTU: «if not specified, the MTU is automatically determined from the endpoint addresses or the system default route» — основание для типичного значения 1420 на 1500-байтном интерфейсе — https://man7.org/linux/man-pages/man8/wg-quick.8.html
- RFC 1191 — Path MTU Discovery — IETF, 1990: флаг DF, сообщение ICMP Destination Unreachable «fragmentation needed and DF set» с полем Next-Hop MTU, периодичность попыток увеличить PMTU (10 минут) — https://www.rfc-editor.org/rfc/rfc1191
- RFC 4821 — Packetization Layer Path MTU Discovery — IETF, 2007: поиск PMTU без опоры на ICMP, рекомендация стартового MSS 1024 — основа net.ipv4.tcp_mtu_probing — https://www.rfc-editor.org/rfc/rfc4821
- RFC 8201 и RFC 4890 — Path MTU Discovery для IPv6 и фильтрация ICMPv6 — ICMPv6 Packet Too Big (type 2) и требование не блокировать его на файрволах — https://www.rfc-editor.org/rfc/rfc8201 ; https://www.rfc-editor.org/rfc/rfc4890
- nftables wiki — Mangling packet headers — Пример MSS-клэмпа «tcp flags syn tcp option maxseg size set rt mtu» — https://wiki.nftables.org/wiki-nftables/index.php/Mangling_packet_headers
- OpenVPN 2.6 manual — link options, --mssfix — Синтаксис «mssfix max [mtu|fixed]», значение по умолчанию 1492 mtu — https://github.com/OpenVPN/openvpn/blob/master/doc/man-sections/link-options.rst
- ISC Knowledgebase — dig versions and default EDNS UDP buffer size changes — Дефолтный EDNS-буфер dig/BIND 1232 байта начиная с 9.16.8 (DNS Flag Day 2020) — https://kb.isc.org/docs/behavior-dig-versions-edns-bufsize