
Как проверить, что модель не раскрывает базу сотрудников
Локальный запуск сам по себе не доказывает, что данные защищены: запросы могут попасть в приложение, журналы, резервные копии или внешние интеграции. Я начинаю с карты потоков, затем проверяю ответы на синтетических данных, права доступа и журналы. Совпадение в ответе — повод расследовать, а не готовый диагноз.
Сначала найдите все входы и потоки данных
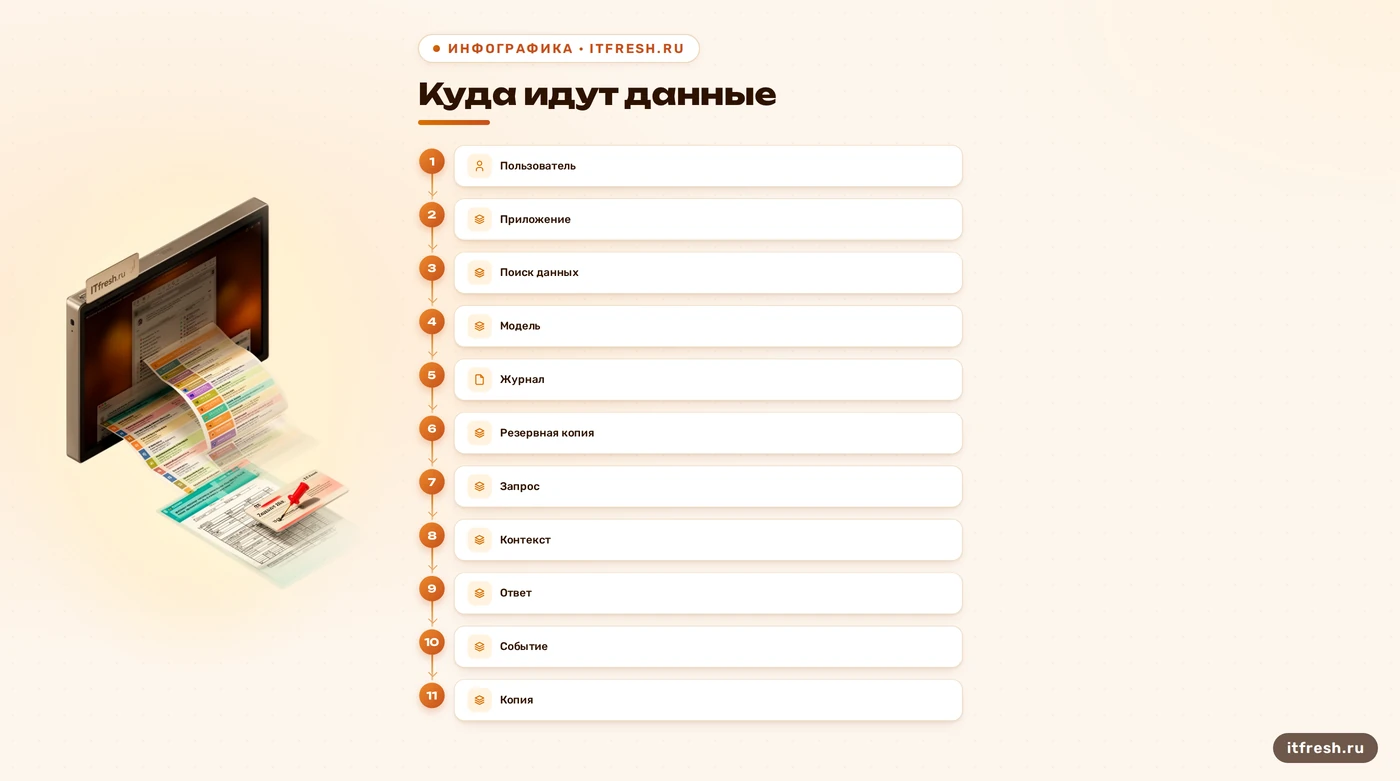
Я начинаю не с допроса модели, а с инвентаризации приложения вокруг неё. Отмечаю, где принимается пользовательский запрос, кто добавляет к нему контекст, откуда берутся документы и куда уходят ответ и ошибки. Отдельно записываю, работает ли компонент в контейнере, как называется процесс, кто его запускает и какие каталоги ему доступны. Для контейнеров подойдут docker ps и docker inspect <имя_или_ID>: вторая команда показывает сведения об объекте Docker, включая настройки и публикацию портов. Перед передачей вывода в тикет удалите секреты и персональные данные: конфигурация тоже бывает чувствительной.
Затем я прослеживаю маршрут каждого поля. Фамилия может попасть в запрос из веб-формы, добавиться при поиске в базе, сохраниться в журнале приложения, а после попасть в резервную копию или систему сбора ошибок. Это уже разные места хранения с разными правами и сроками жизни. Для каждого шага фиксирую владельца, цель обработки, список читателей и то, сохраняется ли исходное содержание. В условном кейсе из этой статьи, ООО «Домино Групп», я бы отдельно проверил фоновые задачи и интеграции: забытый скрипт часто живёт дольше документации. Карта должна описывать фактический маршрут, а не схему из презентации.
Для небольшой команды карта может быть простой таблицей, но в ней должны быть конкретные границы: исходная система, преобразование, получатель, учётная запись, место хранения и срок удаления. Я прошу администратора показать поток на работающем стенде, а не только прочитать описание интеграции. Сверяю список с установленными пакетами, контейнерами, планировщиками и кодом приложения. Если одна строка таблицы заканчивается на словах «дальше обрабатывает сервис», это не ответ: нужно узнать имя сервиса и проверить следующий шаг. Так становится видно, где заканчивается доступ модели и начинается ответственность приложения.
- Составьте перечень приложений и контейнеров
- Запишите источник, получателя и владельца каждого поля
- Проверьте фоновые задачи и интеграции
- Отметьте журналы, кэш, временные файлы и резервные копии
Проверьте ответы на синтетических данных
Для проверки я создаю отдельный набор вымышленных записей с уникальными маркерами, которые не похожи на реальные данные сотрудников. Тест провожу на копии конфигурации или выделенном контуре, с теми же путями обработки и правами, что у приложения. Проверяю обычные запросы, ошибочные входные данные и сценарии, где пользователь пытается получить чужую запись. Если приложение подмешивает документы или результаты поиска, проверяю и эту часть: модель может не знать секрет сама, но приложение способно передать ей чужой фрагмент.
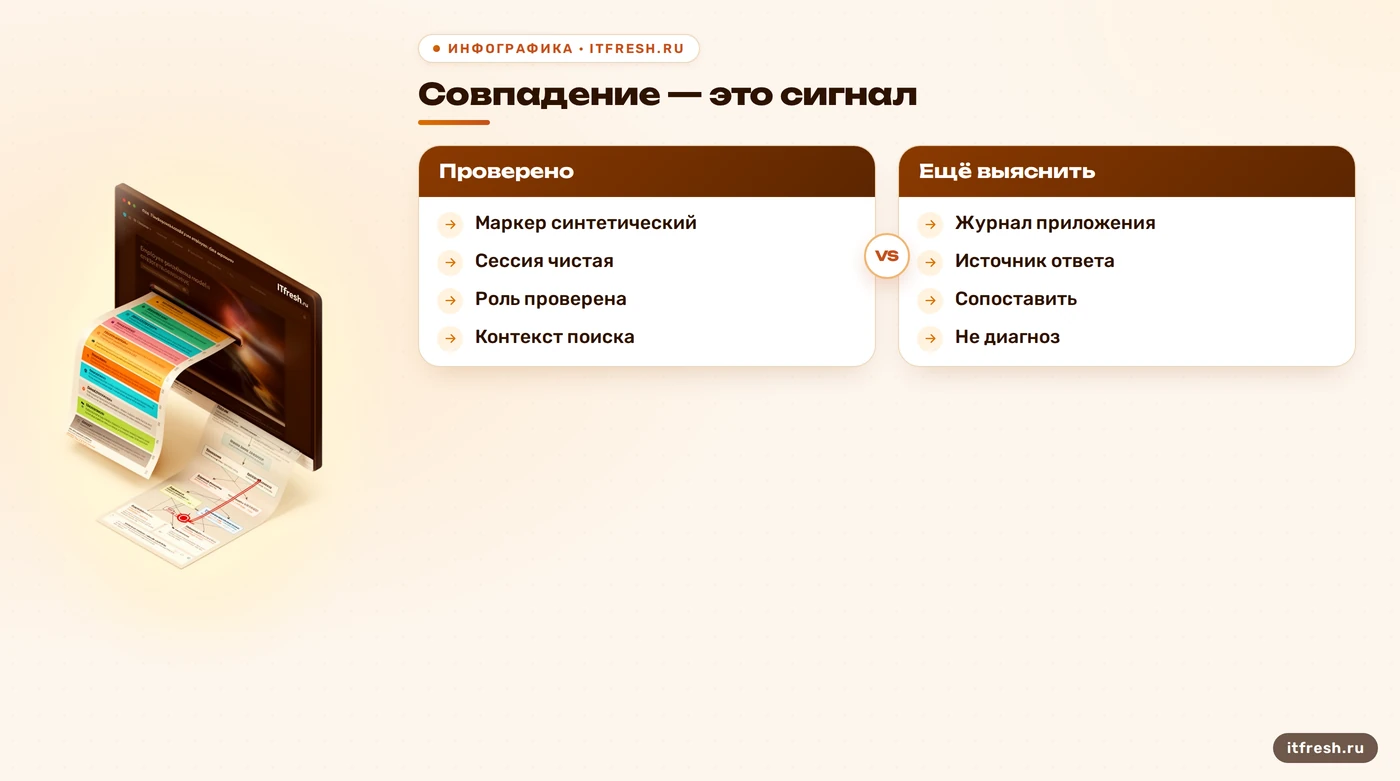
Точное совпадение с маркером — полезный сигнал, но оно не доказывает, что модель обучалась на записи или кэширует её. Маркер мог передать сам тестовый запрос, добавить поиск, вернуть шаблон ответа или сохранить промежуточный слой приложения. Я повторяю тест с чистой сессией, проверяю историю запросов, контекст поиска и журнал приложения, затем меняю пользователя и права. Для серьёзного вывода нужна воспроизводимая цепочка: какой запрос отправили, какие данные приложены и какой компонент вернул совпадение. Иначе легко лечить модель за ошибку доступа в коде.
Отдельно проверяю прямые и косвенные инструкции, которые пытаются заставить приложение показать закрытые сведения или выполнить действие от чужого имени. Это тест безопасности всей связки, а не только генератора текста. OWASP выделяет раскрытие чувствительной информации и prompt injection как риски LLM-приложений; поэтому я проверяю, какие данные приложение передаёт и какие действия разрешает ответу инициировать. Маркеры не должны содержать настоящие ФИО, зарплаты или контакты: аудит не обязан сам создавать копию утечки.
- Используйте только вымышленные записи с маркерами
- Проверяйте чистую сессию и разные роли
- Сопоставляйте ответ с контекстом, поиском и логами
- Записывайте шаги, чтобы тест можно было повторить
Разберите журналы и вторичные копии
Журналы нужны для расследования, но полный текст каждого запроса там обычно не нужен. Я проверяю вывод приложения, контейнера, веб-сервера, системы сбора ошибок и централизованного хранилища. Для контейнера команда docker logs <имя_или_ID> показывает доступные журнальные записи; наличие записей зависит от того, как настроено логирование. На хосте сначала выясняю реальное имя systemd-службы, затем читаю её журнал, например journalctl -u <имя-службы>. ai-service — не стандартное имя, а лишь условный пример, поэтому команда с ним без проверки может просто искать несуществующую службу.
Вместо тела запроса журналу часто достаточно идентификатора обращения, времени, пользователя или сервисной учётной записи, результата проверки доступа, кода ошибки и длительности. Если содержание действительно нужно для разбора, маскируйте чувствительные поля до записи и ограничьте круг тех, кто может читать журнал. OWASP отдельно рекомендует не записывать напрямую пароли, токены и чувствительные персональные данные, а также контролировать защиту, срок хранения и доступ к логам. Хеширование текста не всегда решает задачу: короткие или предсказуемые значения можно перебрать, а восстановить исходный контекст по хешу нельзя.
Проверяю и конфигурацию сбора метрик: значения меток, имена пользовательских полей и частоту отправки. В метриках уместны агрегаты вроде числа обращений или доли отказов, но не содержимое запроса. Отдельно проверяю трассировку, дампы ошибок и снимки состояния: их часто собирают другим механизмом, поэтому очистка основного журнала на них не влияет. После настройки делаю контрольный запрос с тестовым маркером и проверяю, не появился ли он в каждом из хранилищ. Если сервис принимает решение по тексту, журналируйте код правила и результат проверки, а не сам текст.
- Проверьте журналы приложения, контейнера и хоста
- Ищите содержимое запросов, секреты и персональные поля
- Сверьте доступ, срок хранения и передачу в сторонние системы
- Оставляйте метаданные, нужные для расследования
Ограничьте права приложения и модели
Я выдаю каждому компоненту только те права, которые нужны для его конкретной задачи. У пользователя процесса не должно быть доступа ко всей базе сотрудников, если его функции хватает на ограниченную выборку. На уровне приложения сервер проверяет личность и роль пользователя до обращения к данным; модель не должна самостоятельно решать, кому разрешено видеть запись. Для разных пользователей важно проверять не только формулировки запроса, но и то, какие документы приложение положило в контекст. Фильтр вывода может помочь, но он не заменяет проверку прав перед чтением данных.
Сетевой доступ я также сверяю с фактической схемой: какие процессы могут обращаться к API, опубликован ли порт наружу, нужны ли исходящие соединения и какие секреты получает процесс. Если используется шлюз или прокси, проверяю, что он действительно проверяет аутентификацию, ограничивает доступ и не пишет исходные тела запросов в собственные журналы. Не существует общего параметра sandbox: true или max_cache_time, который можно безопасно вставить в конфигурацию любой модели: названия и смысл настроек зависят от конкретного продукта. Изоляцию настраивают средствами платформы, ОС и самого приложения, а каждую опцию сверяют с документацией установленной версии.
Проверьте и доступ к исходным документам, если приложение использует поиск по файлам или базе: именно на этом этапе часто решается, какой фрагмент получит модель. Пользовательская роль должна применяться до поиска или к каждому найденному объекту, а не после того, как полный набор уже попал в контекст. Для сервисной учётной записи я отдельно проверяю чтение секретов, доступ к файловой системе и исходящую сеть. Временные разрешения и тестовые ключи после проверки нужно отозвать. Если один компонент совмещает чтение всех данных и публикацию ответов без проверки роли, исправлять следует эту границу.
- Разделите права пользователей, приложений и модели
- Ограничьте доступ к данным до нужных записей
- Проверьте опубликованные порты и исходящие подключения
- Сверьте параметры изоляции с документацией конкретного продукта
Настройте наблюдение и порядок реагирования
Мониторинг должен помогать заметить сбой и расследовать подозрительный доступ, а не собирать в графиках содержимое личных запросов. Я отслеживаю доступность сервиса, задержки, ошибки, объём обращений и отказы в проверке прав. Для каждого события сохраняю безопасные метаданные и понятный идентификатор, чтобы связать журналы приложения и инфраструктуры. Prometheus или Zabbix могут собирать такие показатели, если экспортёр настроен без персональных значений. Метка с ФИО или адресом сотрудника — не безобидная метрика: она раздувает набор временных рядов и размножает чувствительные данные по хранилищам.
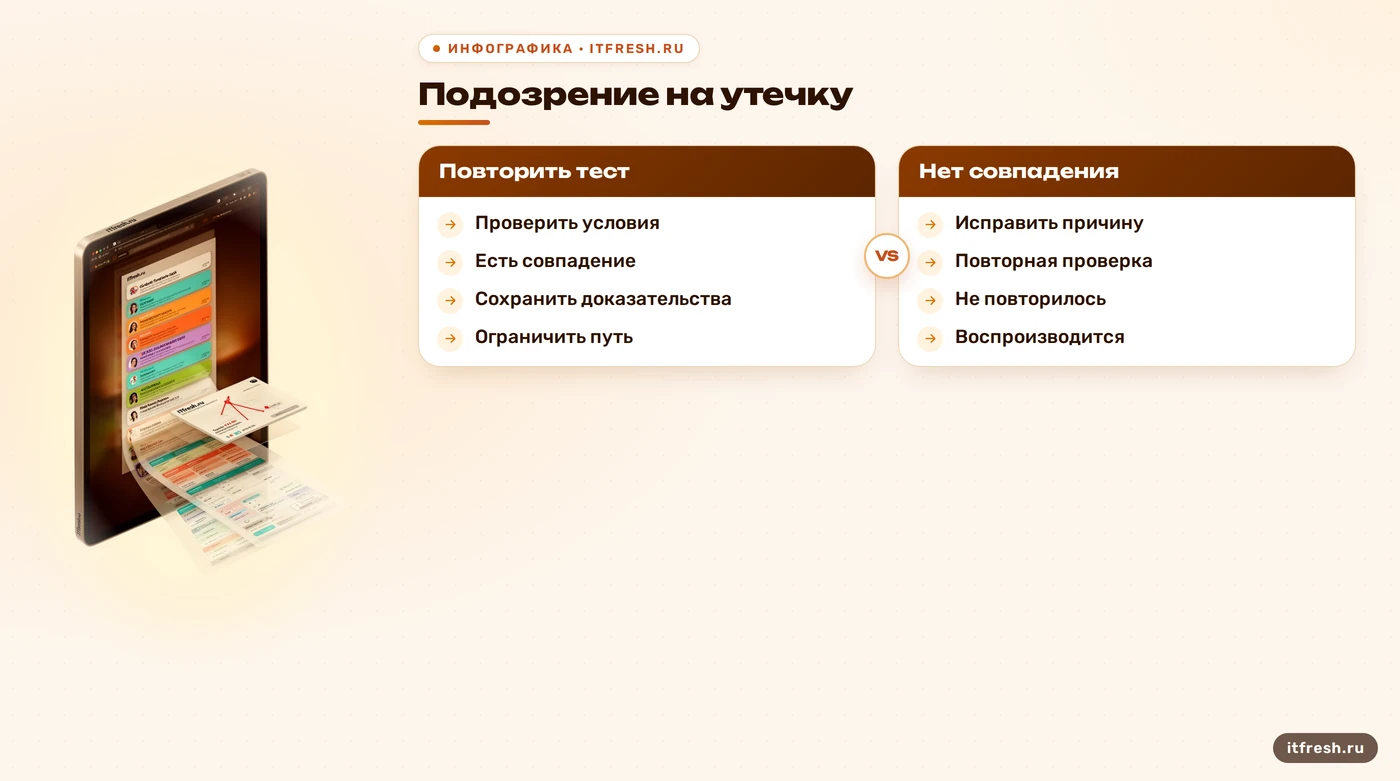
Заранее запишите, кто при подозрении ограничивает доступ, кто сохраняет журналы, кто проверяет копии данных и кто принимает решение о восстановлении сервиса. Не обязательно выключать всю модель при каждом совпадении: иногда достаточно заблокировать затронутую интеграцию или учётную запись, пока проверяется маршрут данных. Сначала сохраните нужные доказательства с контролем доступа, затем остановите дальнейшую передачу и устраните причину. После исправления повторите тест маркерами и проверьте, что журналы и резервные копии обрабатываются по тем же правилам. Проверенный сценарий реагирования полезнее автоматического алерта, который просто сообщает, что что-то случилось.
Для каждого сигнала задайте условия, при которых его действительно нужно разбирать: внезапный рост ошибок доступа, необычный объём обращений или попытка получить чужой объект. Само по себе количество запросов не говорит, какие сведения были раскрыты, поэтому не устанавливайте фиктивный порог по полю, которого ваш экспортёр вообще не передаёт. До учений запишите, где лежат журналы, кто имеет к ним доступ и как сохранить копию для расследования. При повторении теста сравнивайте исходные условия, права пользователя и конфигурацию приложения. Так команда отличит отказ доступа от сбоя сервиса и не будет принимать любое совпадение за подтверждённый инцидент.
- Следите за доступностью, ошибками и отказами доступа
- Не передавайте персональные значения в метки метрик
- Назначьте ответственных и порядок сохранения доказательств
- Проверьте исправление повторным тестом
Частые вопросы
Доказывает ли точное совпадение утечку из обучения модели?
Нет. Это сигнал проверить исходный запрос, контекст приложения, поиск, кэш и журналы; одно совпадение не устанавливает источник.
Безопасна ли локальная модель автоматически?
Нет. Локальный запуск сокращает передачу данных внешнему поставщику, но права, журналы, интеграции и резервные копии всё равно нужно проверять.
Можно ли тестировать на настоящих данных сотрудников?
Для первичной проверки используйте синтетические записи и уникальные маркеры. Реальные данные применяйте только при обоснованной необходимости и согласованных мерах доступа и хранения.
Нужно ли отключить все журналы запросов?
Нет. Сохраняйте безопасные метаданные для расследования, маскируйте чувствительные поля и ограничивайте доступ к журналам.
Как понять, где именно появилась утечка?
Повторите сценарий на чистой сессии и сопоставьте запрос, приложенный контекст, ответ, журналы и права пользователя по каждому этапу.
Источники
- Docker Docs: docker inspect — Проверено назначение команды и доступные сведения об объекте Docker: https://docs.docker.com/reference/cli/docker/inspect/
- Docker Docs: docker container logs — Проверено чтение журналов контейнера и зависимость вывода от настройки логирования: https://docs.docker.com/reference/cli/docker/container/logs/
- OWASP: Logging Cheat Sheet — Рекомендации по исключению чувствительных полей, ограничению доступа и хранению журналов: https://cheatsheetseries.owasp.org/cheatsheets/Logging_Cheat_Sheet.html
- OWASP Top 10 for LLM Applications 2025 — Проверены риски раскрытия чувствительной информации, prompt injection и избыточных полномочий приложения: https://owasp.org/www-project-top-10-for-large-language-model-applications/assets/PDF/OWASP-Top-10-for-LLMs-v2025.pdf
- Google Research: Extractable Memorization from First Principles — Исследование объясняет, почему буквальное совпадение само по себе не доказывает запоминание обучающей выборки: https://research.google/pubs/extractable-memorization-from-first-principles/
- systemd: journalctl — Проверено назначение фильтра -u/--unit=UNIT для чтения журнала конкретной службы: https://www.freedesktop.org/software/systemd/man/latest/journalctl.html