Asterisk на Proxmox или ESXi: откуда берутся хрипы, заикания и обрывы и что крутить в настройках виртуальной машины
Если Asterisk после переезда в виртуальную машину хрипит, почти всегда виноват не провайдер, а нехватка процессорного времени у ВМ (CPU steal). Проверьте vmstat и timing test, выделите 2 vCPU, тип host, отключите ballooning. Ниже команды и разбор по слоям.
Хрипит после переезда в виртуалку: виновата ли виртуализация
Звонок в пятницу вечером: «Мы перенесли АТС в виртуальную машину, и теперь музыка на удержании хрипит, как магнитофон с жёваной плёнкой. Сеть не трогали, коммутатор тот же». Через минуту следующая фраза, и я её могу произнести вместе с собеседником: «Значит, виноват провайдер». Провайдер, как правило, ни при чём, а вот про виртуальную машину стоит подумать, потому что именно она поменялась. Если вы строите телефонию внутри общего парка серверов и вам нужен IT-аутсорсинг для офиса, начинать диагностику надо с честного вопроса: кто и когда выдаёт процессорное время вашей АТС.
Голос в Asterisk устроен жёстче, чем кажется. Каждые 20 миллисекунд, то есть 50 раз в секунду, нужно прочитать пакет, при необходимости перекодировать, записать и отправить дальше. Опоздал на 30–40 мс, и в потоке образуется дырка, которую слушатель воспринимает как хрип, щелчок или «роботизированный» голос. Физический сервер с отдельным процессором опаздывает редко: ему никто не мешает. Виртуальная машина живёт иначе. Её ядра — это потоки гипервизора, а гипервизор имеет полное право посреди вашего 20-миллисекундного интервала отдать процессор соседу, например серверу 1С или резервному копированию.
Я разделяю причины на четыре слоя и проверяю их строго сверху вниз. Первый — внутренний таймер Asterisk: если он сломан или подменён неэффективным модулем, файлы играют рвано даже на пустой машине. Второй — планировщик гипервизора: нехватка процессорного времени (steal), ballooning памяти, неподходящий тип процессора. Третий — виртуальная сетевая карта и её аппаратные ускорения. Четвёртый — сеть офиса и оператора, о которой все вспоминают первой, а проверяют последней. Такой порядок экономит время: первые два слоя проверяются за пять минут двумя командами, и половина «проблем сети» заканчивается именно на них.
Самое полезное, что вы можете сделать до любых настроек, — определить, что именно хрипит. Музыка на удержании и объявления в очереди читаются с диска и проигрываются самим Asterisk, сеть в их генерации не участвует. Если хрипят они, виновата не сеть, а таймер или нехватка процессора. Если же внутренние звонки между телефонами чистые, а плохо слышно только собеседника из города, смотрите на транк и джиттер. Если рвутся и те и другие, значит, у вас несколько проблем сразу, и это тоже бывает чаще, чем хочется. Дальше я иду по слоям и по ходу показываю, как отличить один от другого командами, а не ощущениями.
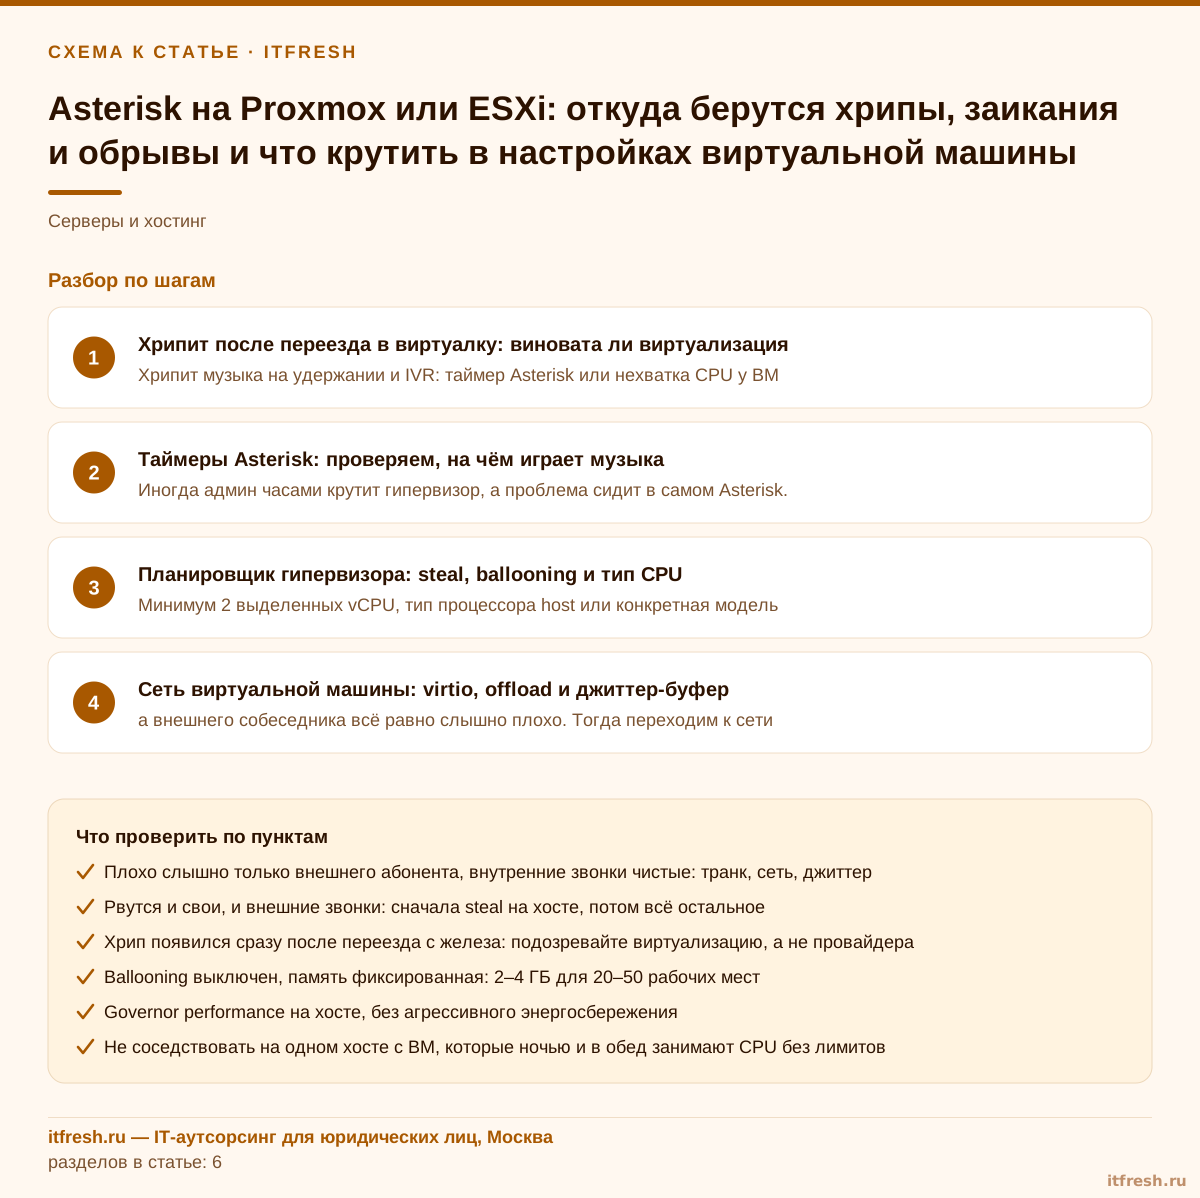
- Хрипит музыка на удержании и IVR: таймер Asterisk или нехватка CPU у ВМ
- Плохо слышно только внешнего абонента, внутренние звонки чистые: транк, сеть, джиттер
- Рвутся и свои, и внешние звонки: сначала steal на хосте, потом всё остальное
- Хрип появился сразу после переезда с железа: подозревайте виртуализацию, а не провайдера
Таймеры Asterisk: проверяем, на чём играет музыка
Иногда админ часами крутит гипервизор, а проблема сидит в самом Asterisk. Для воспроизведения файлов, то есть музыки на удержании и объявлений в очереди, а также для ConfBridge и IAX2-транкинга Asterisk нужен внутренний источник времени, и модулей таймера несколько. По документации они выбираются по приоритету: сначала res_timing_timerfd (встроен в ядро Linux, нужно ядро от 2.6.25 и glibc от 2.8, работает очень эффективно), затем res_timing_kqueue (для BSD и macOS, на Linux не собирается), res_timing_dahdi (если в машине есть DAHDI-железо) и в конце res_timing_pthread. Последний переносимый, но самый неэффективный, и под нагрузкой он теряет точность. Если по какой-то причине у вас загрузился именно он, хрип под нагрузкой вам обеспечен.
Проверка занимает минуту. Посмотрите, какие модули таймера загружены, и прогоните встроенный тест. Результат теста — число тиков за секунду: при здоровом таймере и интервале 20 мс ожидайте около 50 тиков, но формат вывода и точные значения проверьте в своей версии, они зависят от сборки.
asterisk -rx "module show like timing"
asterisk -rx "timing test"
В первом выводе должен значиться res_timing_timerfd со статусом Running. Если вместо него висит pthread, значит timerfd не загрузился: частая причина — самосборное ядро или контейнер без нужных возможностей. Если тест показывает заметно меньше 50 тиков или цифры скачут от запуска к запуску на простаивающей машине, дело уже не в Asterisk, а в том, что ему не дают процессор, и мы переходим к следующему слою.
Отдельная история — сломанный модуль таймера. Я видел АТС, где после обновления загружался модуль DAHDI-таймера без самого железа, и таймер вёл себя странно. Лечится это просто: запретить лишний модуль в modules.conf директивой noload либо удалить файл .so из каталога модулей (обычно /usr/lib/asterisk/modules, путь проверьте у себя). Перезагрузка Asterisk после этого обязательна, горячей подменой таймера никто не занимается. Эту правку я делаю только тогда, когда вижу в выводе module show нежелательный модуль; профилактически выкидывать модули не нужно, это та самая «оптимизация», после которой утром не звонит ничего.
Теперь про то, чего таймер не объясняет. В виртуалке с недостатком процессорного времени timerfd честно срабатывает вовремя, но сам процесс Asterisk просто не успевает получить процессор и обработать событие. С точки зрения слушателя разницы нет: хрип тот же. Поэтому «timing test» у меня служит лакмусовой бумажкой: если число тиков упало, идём смотреть на steal; если тиков ровно 50, а хрип остался, то с большой вероятностью дело в сети или в кодеках. Разделять эти две ситуации важно по одной причине: лечение у них противоположное, и перепутать их значит потратить неделю не на ту настройку.
Планировщик гипервизора: steal, ballooning и тип CPU
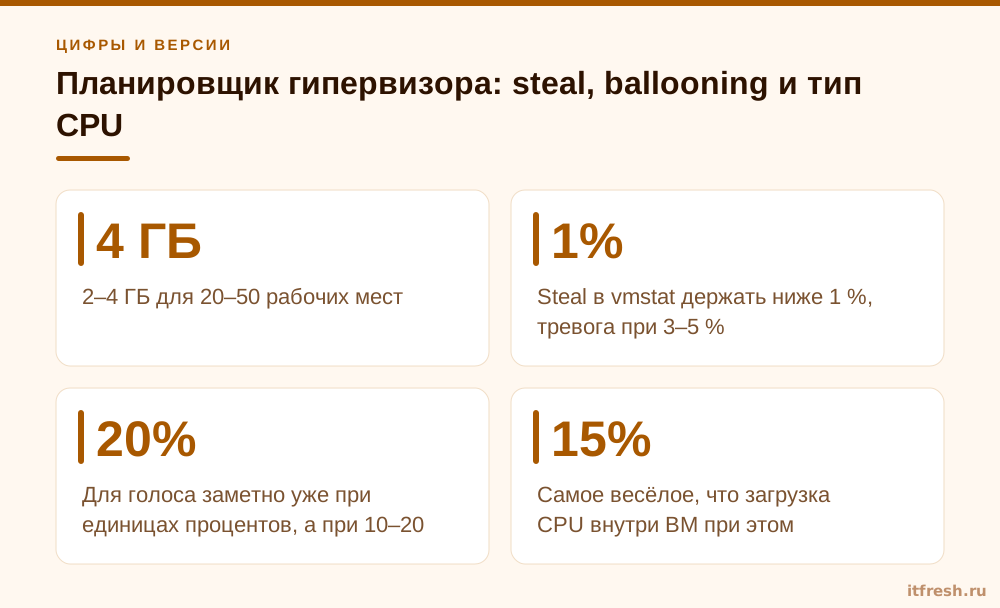
Вот здесь начинается самое неприятное. Скажем прямо: в 8 случаях из 10 «хрипящая виртуальная АТС» — это CPU steal. Это процент времени, который виртуальный процессор хотел работать, но гипервизор не дал, потому что физическое ядро было занято кем-то другим. В гостевой системе он виден как колонка st в vmstat и как значение st в строке %Cpu(s) в top. Для голоса заметно уже при единицах процентов, а при 10–20 % звук хрипит стабильно. Самое весёлое, что загрузка CPU внутри ВМ при этом выглядит благополучно: 15 % занято, 85 % свободно, а звонки рвутся. Админ смотрит на график, пожимает плечами и идёт ругать провайдера.
Смотреть надо так, и непременно в момент жалоб, а не в тихое утро:
vmstat 1 30
top -b -n 1 | head -5
В выводе vmstat последняя колонка st — это steal в процентах за секунду. Если на живой АТС вы видите устойчиво 3–5 % и всплески до 15–20 %, виртуализация уже виновата, и никакие джиттер-буферы это не исправят. На самом хосте Proxmox запустите обычный top и посмотрите, чем заняты ядра, пока ваша АТС хрипит: чаще всего в этот момент работает бэкап, регламентное задание 1С или распаковка архива в соседней ВМ. Отдельно проверьте режим энергосбережения процессора. Для хоста с голосом я советую governor performance: команда cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor покажет текущий, а менять его нужно в соответствии с политикой вашего сервера, на разных платформах это делается по-разному.
Вторая беда называется ballooning. Это механизм, который отбирает у гостя память, когда она нужна хосту или соседней ВМ. Для файлового сервера это терпимо, для АТС вредно: возврат страниц памяти даёт задержки в самый неподходящий момент, а Asterisk, у которого память вдруг ушла в своп, начинает опаздывать с пакетами. В Proxmox для ВМ с голосом устройство ballooning отключают (Hardware → Memory → Ballooning Device выключить) и ставят фиксированный объём, 2–4 ГБ для офиса на 20–50 рабочих мест хватает с запасом. Экономия нескольких гигабайт под видом «пусть гипервизор разберётся» обходится дороже, чем плата за лишнюю планку памяти.
Третье — тип процессора. По умолчанию ВМ в Proxmox получает универсальную модель процессора (в PVE 8 это x86-64-v2-AES, в старых версиях и у перенесённых машин часто kvm64), которая скрывает от гостя часть современных инструкций, например AVX. Для шифрования SRTP и перекодирования это лишняя нагрузка. Тип host передаёт гостю реальные возможности хоста; минус в том, что ВМ нельзя спокойно переносить на хост с другой моделью процессора без проверки, поэтому в кластерах с разным железом выбирают конкретную общую модель. Само число vCPU я не раздуваю: 2 выделенных vCPU для АТС на 20–50 рабочих мест лучше, чем 8, которые делят ядра с 1С. Чем больше vCPU у ВМ, тем сложнее планировщику найти свободные ядра одновременно. Подробнее о том, как считать нагрузку на АТС в одновременных звонках, у нас есть отдельная статья про планирование ёмкости по числу звонков, и там видно, что голосу нужно мало, но стабильно.
Чтобы не писать длинный реферат, вот настройка ВМ в Proxmox одной командой. Номер ВМ у вас свой, синтаксис и значения параметров проверьте по документации вашей версии Proxmox VE, прежде чем применять на боевой машине:
qm set 105 --cpu host --cores 2 --sockets 1 --balloon 0 --memory 4096
qm config 105 | grep -E "cpu|cores|balloon|memory"
Изменения вступят в силу после полного выключения и запуска ВМ; перезагрузка изнутри гостя тут не помогает, и это одна из самых частых причин «мы всё поменяли, а ничего не изменилось».
- Минимум 2 выделенных vCPU, тип процессора host или конкретная модель
- Ballooning выключен, память фиксированная: 2–4 ГБ для 20–50 рабочих мест
- Governor performance на хосте, без агрессивного энергосбережения
- Не соседствовать на одном хосте с ВМ, которые ночью и в обед занимают CPU без лимитов
- Steal в vmstat держать ниже 1 %, тревога при 3–5 %
Сеть виртуальной машины: virtio, offload и джиттер-буфер
Допустим, steal нулевой, таймер бодр, а внешнего собеседника всё равно слышно плохо. Тогда переходим к сети, но не к сети офиса, а сначала к виртуальной карте. Эмулируемая карта вроде e1000 тратит процессор на эмуляцию, а в нагруженном хосте это добавляет задержки. Для голоса я ставлю паравиртуальную virtio-net. Мастер Proxmox предлагает её по умолчанию, а вот у машин, перенесённых с другого гипервизора или собранных «как для Windows», внутри нередко остаётся e1000 — проверьте в настройках ВМ, а не на слово. Диск в этой связке — VirtIO SCSI, желательно с iothread: запись разговоров через MixMonitor и логи на медленном диске напрямую звук не ломают, но тормозят сам Asterisk, а ему и так нелегко.
Вторая тонкость — аппаратные ускорения сетевого стека: GRO, LRO, TSO и GSO. Они склеивают и режут пакеты в расчёте на большие потоки данных, а голос — это маленькие пакеты каждые 20 мс, и склейка в некоторых драйверах добавляет задержку или странности в статистике. Сначала посмотрите, что включено, потом попробуйте выключить на интерфейсе, который принимает RTP. Влияние зависит от драйвера и версии ядра, поэтому проверяйте эффект замером, а не верой:
ethtool -k eth0 | grep -E "generic-receive-offload|large-receive-offload|tcp-segmentation-offload|generic-segmentation-offload"
ethtool -K eth0 gro off lro off tso off gso off
После такой команды настройка живёт до перезагрузки интерфейса. Для постоянного эффекта её прописывают в конфигурации сети вашего дистрибутива (в Debian обычно через директиву post-up в описании интерфейса). Не пытайтесь «оптимизировать» заодно всё остальное: меняйте один параметр за раз и замеряйте.
Теперь про джиттер-буфер, потому что вокруг него больше всего мифов. Буфер сглаживает неравномерный приход пакетов из сети: пакеты пришли с интервалами 10, 35, 20, 5 мс, а в ядро Asterisk выходят ровно через 20. Это лечит сетевой джиттер, например на входящих транках от оператора. Он не лечит пропуски таймера из-за CPU steal, потому что стоит перед логикой Asterisk и ничего не знает о том, что процесс не получил процессор. Включается он функцией диалплана JITTERBUFFER, пишется функция только в режиме присваивания. Она допускает режимы fixed, adaptive и disabled; максимальный размер по умолчанию 200 мс, порог повторной синхронизации 1000 мс, а для adaptive есть ещё target_extra с умолчанием 40 мс. Для PJSIP это основной способ включить буфер: ставится на входящем канале транка до Queue или Dial.
[from-trunk]
exten => _X.,1,NoOp(Incoming from trunk)
 same => n,Set(JITTERBUFFER(adaptive)=default)
 same => n,Goto(queues,s,1)
Другие варианты записи по документации: Set(JITTERBUFFER(fixed)=default), Set(JITTERBUFFER(fixed)=200) и Set(JITTERBUFFER(adaptive)=200,,60), а выключается буфер так: Set(JITTERBUFFER(disabled)=). Если буфер задан и в драйвере канала, и функцией, приоритет у функции. Я начинаю с adaptive и значений по умолчанию, а fixed беру там, где нужна предсказуемая задержка. Сверьте контекст и имя точки входа со своим диалпланом: пример выше нужно подогнать, а не копировать. Если эхо и странные искажения идут не вместе с хрипом, а сами по себе, это другой разговор, и там нужны три настройки против эха в PJSIP, а не виртуальный процессор.
Как проверить, что джиттер вообще есть. В современных версиях Asterisk включите сбор статистики RTCP командой rtcp set stats on и смотрите pjsip show channelstats во время звонка: там видны потери и джиттер по каждому каналу. Для SIP-диалога удобен sngrep. Если сравнить вывод для внутреннего звонка и звонка через транк, картина обычно становится ясной за пять минут. Цифры считайте по своим наблюдениям: универсальных «хороших» значений джиттера я называть не буду, они зависят от кодека и оператора, а выдуманные пороги только вредят.
Разбор: клиника «Белый Квадрат» и хрип после переезда с железа
Стоматологическая клиника «Белый Квадрат»: 22 рабочих места, 4 администратора на телефоне, звонки пациентов — это деньги, потому что каждый недозвонившийся пациент записывается к соседям. Asterisk 20 жил на старом физическом сервере и не вспоминался годами. Потом железо решили списать, и АТС переехала в виртуальную машину Debian 12 на Proxmox VE 8. На том же хосте с двумя сокетами и 16 ядрами уже работали ВМ с 1С и файловый сервер. Сеть офиса не меняли: те же коммутатор, телефоны и транк. Через неделю пошли жалобы: музыка на удержании и в очереди хрипит, а пациенты говорят, что администраторов плохо слышно.
Первые подозрения, как водится, пали на провайдера и на сеть. Я попросил просто посмотреть vmstat в момент жалоб и сравнить с графиками 1С. Картина сложилась быстро. ВМ с Asterisk имела 2 vCPU, тип процессора kvm64 и включённый ballooning; ВМ с 1С получила вдвое больше vCPU, без лимитов, и ночью (резервные копии и регламентные задания) и в обед (отчёты бухгалтерии) забирала почти всё. В эти минуты steal на АТС доходил до 15–20 %, а в top внутри самой ВМ процессор казался почти свободным. Timing test показывал просадку тиков относительно 50, а в тихие часы всё было в порядке. Это и был диагноз: сеть чистая, виновата конкуренция за процессор.
Правки мы сделали за один рабочий день, вне часов приёма. Тип процессора сменили с kvm64 на host, зафиксировали 2 выделенных vCPU, отключили ballooning и задали фиксированные 4 ГБ памяти, а 1С-ВМ ограничили по количеству vCPU и приоритету. В настройках ВМ заменили эмулируемую карту e1000 на virtio-net, а внутри гостя на интерфейсе с RTP выключили GRO и LRO. На входящих транках включили JITTERBUFFER в режиме adaptive, как страховку от сетевого джиттера оператора. Governor на хосте переключили на performance. После перезапуска ВМ целиком (не перезагрузки из гостя) прогнали контрольные звонки по очереди из четырёх телефонов и сравнили с замерами «до».
Итог. Steal упал с 15–20 % до менее 1 % даже в обеденный пик 1С, timing test выдавал стабильные значения, хрип исчез и на удержании, и в очереди. Мы оставили неделю наблюдения: ежедневно смотрели статистику каналов и vmstat в часы нагрузки, и за семь дней жалоб не поступило. Общий срок: 1 рабочий день на работы плюс неделя наблюдения. Забавная деталь: пока шла диагностика, клиника уже обсуждала покупку нового коммутатора. Коммутатор экономит нервы и деньги, когда его не покупают без измерений. Такой кейс типичен для малого офиса, где вся ИТ-инфраструктура живёт на одном хосте, и надёжность этого хоста мы потом отдельно закрепили репликацией ВМ в Proxmox, чтобы падение железа не оставило администраторов без телефона.
- Хост: 2 сокета, 16 ядер, ВМ с Asterisk, 1С и файловым сервером
- Было: 2 vCPU, kvm64, ballooning включён, steal 15–20 %
- Стало: 2 выделенных vCPU, тип host, ballooning выключен, 4 ГБ, steal меньше 1 %
- Срок: 1 рабочий день работ и неделя наблюдения
Мониторинг и чек-лист: как не дать хрипу вернуться
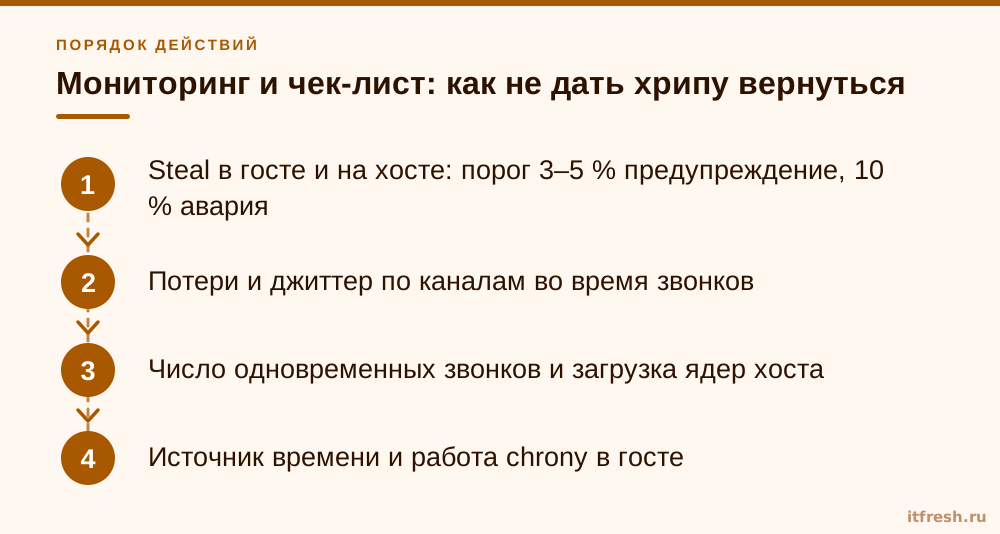
Проблема с виртуальной АТС в том, что она чинится один раз, а ломается по-тихому, при следующем изменении на хосте. Кто-то добавил ещё одну ВМ, кто-то включил бэкап в рабочее время, кто-то обновил гипервизор, и настройки поехали. Поэтому после правок я ставлю наблюдение именно за теми величинами, которые мы разбирали, а не за общим «ЦП загружен на 40 %». В мониторинге на Zabbix для такой ВМ достаточно четырёх вещей: steal внутри гостя, steal и загрузка ядер на хосте, число активных звонков и статистика джиттера и потерь по каналам.
Порог тревоги по steal я ставлю грубо: предупреждение при устойчивых 3–5 %, авария при 10 % и выше. Тонкая настройка не нужна, потому что нормальным для АТС значением является ноль. Отдельно следите за временем: ВМ с плывущими часами в итоге создают странные сбои регистраций и TLS, поэтому в госте стоит держать chrony, а источник времени проверять командой cat /sys/devices/system/clocksource/clocksource0/current_clocksource; для KVM-гостей обычно это kvm-clock. На разных версиях ядра картина отличается, и если у вас что-то иное, сначала выясните причину, а потом уже правьте.
Метрики качества самих звонков стоит собирать отдельно от метрик сервера. Какие показатели считать и как их вытаскивать из Asterisk, мы разобрали в статье про метрики качества звонков: там видно, как связать жалобу «плохо слышно» с конкретным каналом и временем. Связка простая. Жалоба пришла в 12:40, график steal в 12:40 показывает пик, значит, виноват хост; steal ровный, а потери на транке растут — значит, сеть или оператор. Без такой связки вы будете каждый раз спорить с пользователями о том, что им послышалось.
Итоговый чек-лист для ВМ с голосом, который я прикладываю к проектам: не менее 2 выделенных vCPU, тип процессора host или конкретная модель, ballooning выключен, 2–4 ГБ памяти для 20–50 рабочих мест, virtio-net и VirtIO SCSI, governor performance на хосте, GRO и LRO выключены на RTP-интерфейсе по результатам замера. И правило размещения: не ставьте АТС на один хост с ВМ, которые ночью и в обед занимают процессор без лимитов. Если такого хоста нет, ограничьте соседей. Голосу нужно немного ресурсов, но ровно в нужную миллисекунду, и обеспечить это дешевле, чем объяснять директору, почему недозвонились до клиентов.
- Steal в госте и на хосте: порог 3–5 % предупреждение, 10 % авария
- Потери и джиттер по каналам во время звонков
- Число одновременных звонков и загрузка ядер хоста
- Источник времени и работа chrony в госте
Частые вопросы
Как понять, что хрип из-за виртуализации, а не из-за сети?
Проверьте, что именно хрипит. Музыка на удержании и объявления в очереди проигрываются самим Asterisk без участия сети, поэтому их хрип указывает на таймер или нехватку CPU. Затем посмотрите колонку st в vmstat 1 во время жалоб: устойчивые единицы процентов и всплески до 10–20 % говорят о виртуализации.
Лечит ли джиттер-буфер хрип от CPU steal?
Нет. JITTERBUFFER выравнивает неравномерный приход пакетов из сети и стоит до логики Asterisk, а пропуски из-за нехватки процессорного времени возникают уже внутри процесса. Включайте его для сетевого джиттера на транках, а steal лечите настройками ВМ и размещением на хосте.
Сколько vCPU и памяти выделять виртуальной АТС на 20–50 рабочих мест?
Обычно достаточно 2 выделенных vCPU и 2–4 ГБ памяти при выключенном ballooning. Больше vCPU не значит лучше: планировщику сложнее найти сразу несколько свободных ядер, если хост нагружен. Точные цифры зависят от кодеков, записи разговоров и числа одновременных звонков.
Какой тип процессора выбрать в Proxmox для Asterisk?
Тип host передаёт гостю реальные возможности процессора хоста и снимает лишнюю нагрузку, которую создаёт универсальная модель kvm64. Если ВМ переносят между хостами с разным железом, выбирайте конкретную общую модель. Синтаксис qm set и допустимые значения проверьте в документации своей версии.
Нужно ли выключать GRO и LRO в госте?
Не всегда. Эффект зависит от драйвера и версии ядра, поэтому сначала посмотрите ethtool -k, затем выключайте на интерфейсе с RTP по одному параметру и сравнивайте статистику каналов до и после. Если разницы нет, возвращать настройки не обязательно, но и держать их выключенными без измерений смысла нет.
Источники
- Asterisk — Timing Interfaces — Проверены модули таймера res_timing_timerfd, kqueue, dahdi, pthread, порядок их приоритета, требования к ядру и glibc и список функций, которым нужен внутренний таймер: https://docs.asterisk.org/Configuration/Core-Configuration/Timing-Interfaces/
- Asterisk — Function JITTERBUFFER — Проверены режимы fixed, adaptive, disabled, значения по умолчанию, примеры записи и приоритет функции над настройкой драйвера: https://docs.asterisk.org/Latest_API/API_Documentation/Dialplan_Functions/JITTERBUFFER/
- Proxmox VE Administration Guide — Свериться с разделами о типе CPU, ballooning памяти и параметрах qm set для виртуальных машин: https://pve.proxmox.com/pve-docs/
- Proxmox VE — документация по qm — Справка по команде qm и параметрам конфигурации ВМ, в своей версии проверьте допустимые значения: https://pve.proxmox.com/pve-docs/qm.1.html
- ethtool(8) — Linux manual page — Описание опций -k и -K для просмотра и изменения offload-функций GRO, LRO, TSO, GSO: https://man7.org/linux/man-pages/man8/ethtool.8.html