
Звонок в очереди Asterisk оборвался: как найти виновный таймер
Обрыв ровно через 30 секунд — зацепка, но не диагноз: в Asterisk есть отдельные таймеры очереди, диалплана и SIP. Я покажу, как определить, кто завершил вызов, где искать событие в queue_log и какую настройку менять, чтобы не лечить очередь параметром от другого уровня.
Тридцать секунд — улика, не диагноз
Если вызов обрывается примерно через полминуты, это повод измерить, где именно заканчивается вызов, а не объявлять виноватым «таймаут очереди». В Asterisk одновременно работают несколько уровней: диалплан вызывает приложение Queue(), очередь звонит агентам, SIP-стек обменивается сигнализацией, а внешний оператор может завершить свой участок. Одинаковая длительность у разных вызовов наводит на мысль о таймере или сценарии, но сама по себе не доказывает причину. Я начинаю с временной шкалы: входящий вызов, вход в очередь, попытка дозвона агенту и момент отключения. Смотреть только на часы в интерфейсе — как ставить диагноз по секундной стрелке.
Важная поправка: в queues.conf нет глобального параметра defaulttimeout, который автоматически задаёт абоненту 30 секунд. Параметр timeout в настройках очереди ограничивает попытку дозвона участнику; он не равен общему времени ожидания звонящего. У приложения Queue() есть отдельный аргумент timeout: документация описывает его как предел, после которого Queue() завершится, проверяя его между циклами timeout и retry из queues.conf. Поэтому сначала выясните, передаётся ли этот аргумент из диалплана и что выполняется после возврата из Queue(). Смешать два разных таймера легко, исправить последствия такого смешения — уже сложнее.
Я не свожу все обрывы ровно на 30-й секунде к сети, но и не вычёркиваю сеть из списка причин. Сопоставьте вызовы: обрываются ли они на одном маршруте, с одним оператором, только до ответа или также во время разговора? Посмотрите, какой канал отключился первым и какой SIP-ответ пришёл. Если вызов завершает сценарий Asterisk, ищите след в диалплане и queue_log; если завершается SIP-диалог — исследуйте сигнализацию на обеих сторонах. Когда время одинаковое, это полезная зацепка. Когда доказательств нет, это всё ещё только зацепка.
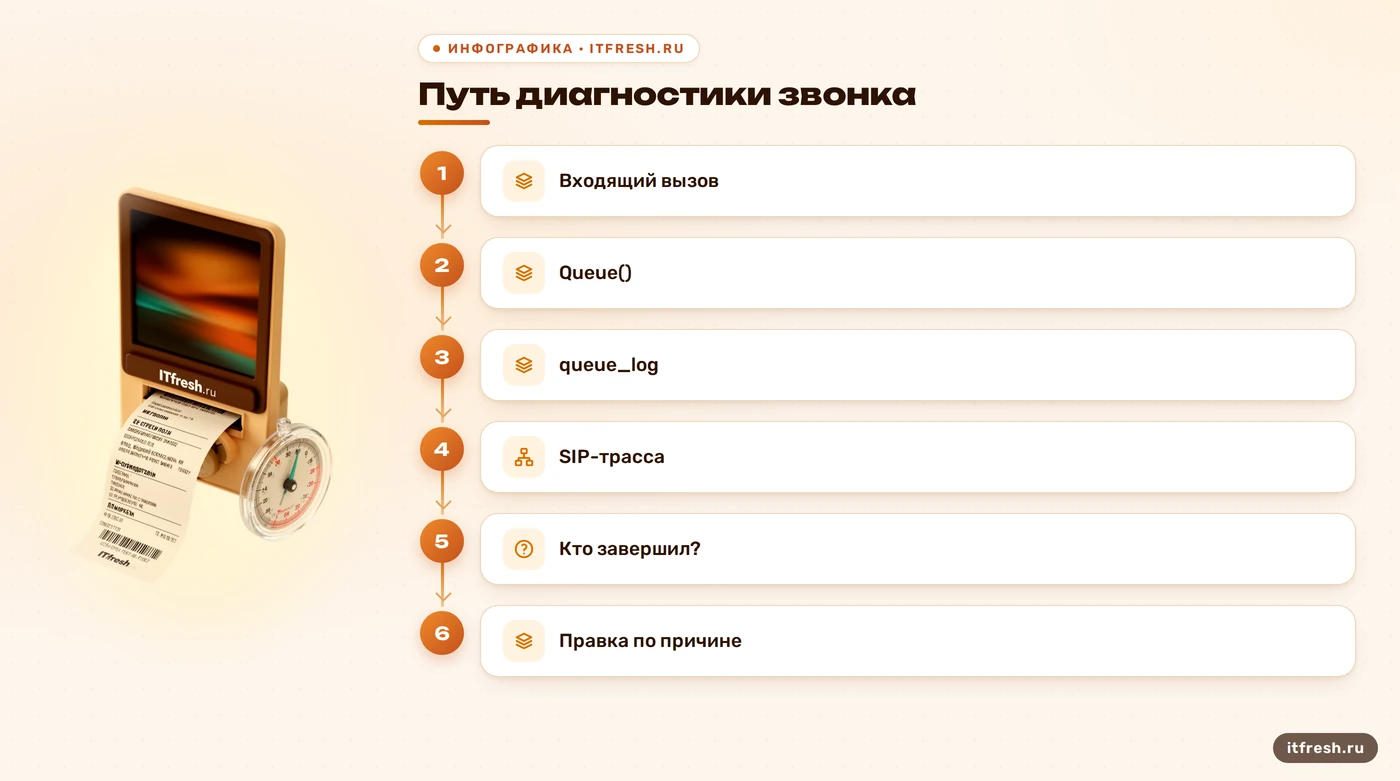
Сначала выясните, кто завершил вызов
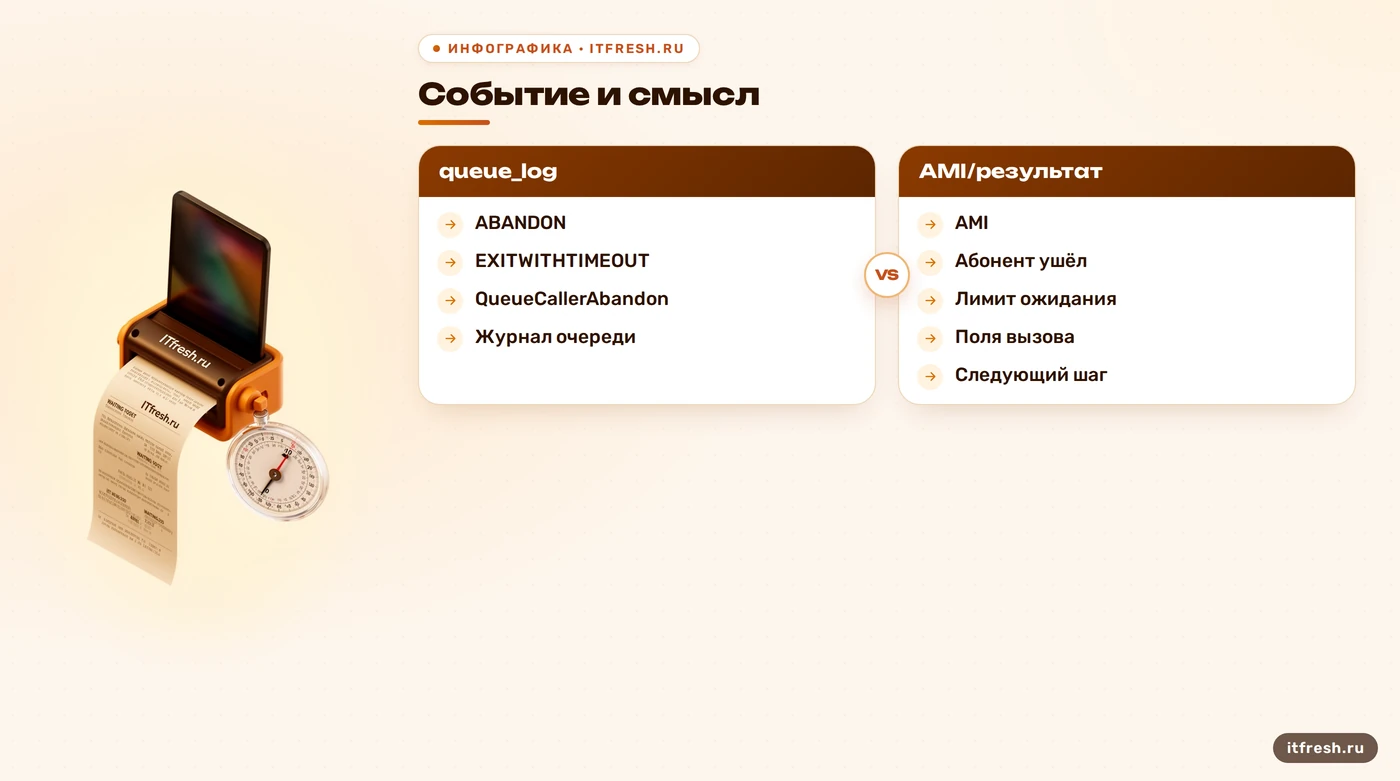
Начните с queue_log: стандартное расположение файла — /var/log/asterisk/queue_log. В нём ищите конкретный вызов по идентификатору канала и события вокруг момента отключения. ABANDON означает, что абонент сам покинул очередь; EXITWITHTIMEOUT означает, что истёк лимит ожидания очереди; RINGNOANSWER говорит, что попытка дозвона участнику закончилась без ответа. Это разные ситуации, и каждая ведёт к своему следующему шагу. Особенно полезно поле waittime у событий выхода: оно помогает сопоставить запись журнала с фактической длительностью ожидания. При сверке не ограничивайтесь последней строкой: журнал очереди записывает последовательность событий, и важен переход от входа к завершению. Сверьте идентификатор вызова и время с соседними системными записями, иначе можно приписать событие другому каналу. Если queue_log отключён или недоступен, сначала выясните, где в этой установке ведётся журналирование очередей; не делайте вывод об отсутствии события по пустому файлу.
Не ищите в штатном queue_log событие QueueTimeout: такого события там нет. В документации Asterisk перечислены имена событий журнала, и для истечения времени ожидания используется EXITWITHTIMEOUT. Если включён AMI, для ухода вызывающего есть событие QueueCallerAbandon; его поля включают очередь, позицию и HoldTime. Оно помогает понять, что звонящий оставил ожидание, но не объясняет само по себе, почему человек нажал отбой. Агрегат QueueStatus полезен для текущего состояния очереди, однако он не заменяет историю конкретного вызова и SIP-трассу.
Сравните очередь и диалплан с временной отметкой. Убедитесь, что вызов действительно вошёл в нужный Queue(), какие аргументы переданы и куда ведёт следующий приоритет, если приложение вернулось со статусом TIMEOUT. Проверьте также настройки очереди: timeout, retry и maxlen описывают разные ограничения; не меняйте их все сразу ради красивого эксперимента. Если есть CDR/CEL, сопоставьте их с queue_log и SIP-логом по времени и идентификатору канала. Несовпадающие часы серверов испортят эту картину, поэтому сначала проверьте синхронизацию времени.
Настройте именно тот предел, который нужен
Если выяснилось, что очередь действительно должна ждать дольше, определите ожидаемое поведение: сколько звонить одному агенту, как часто переходить к следующему и сколько в целом держать вызов в очереди. Для попытки дозвона используются параметры очереди в queues.conf, например timeout и retry. Чтобы ограничить общее пребывание в приложении Queue(), проверьте аргумент timeout в строке диалплана Queue(). Это не одно и то же. Конкретное значение берите из сценария обслуживания и расписания, а не из чужого примера с числом 90 или 120. Бездумно убрать предел — тоже решение, только обычно его автор обнаруживается в журнале жалоб.
После изменения очереди применяйте конфигурацию штатным способом для вашей версии и сборки Asterisk, затем проверьте результат в CLI командой queue show <имя_очереди>. Не обещаю «без простоя» одной магической командой: режим перезагрузки и влияние на активные вызовы зависят от того, что именно меняется и как собран сервис. Изменения диалплана и очередей сначала проверьте на тестовом вызове или в спокойное окно, а затем убедитесь, что активная очередь показывает ожидаемые параметры. Не редактируйте одновременно маршрутизацию, SIP-таймеры и правила выхода — иначе вы не узнаете, какая правка помогла.
Не добавляйте timers = yes в sip.conf или pjsip.conf как универсальное лекарство от вызова, покидающего очередь через 30 секунд. В PJSIP параметр timers относится к SIP session timers на endpoint; это отдельный механизм согласования длительности SIP-сессии. Сам факт наличия этой настройки не доказывает, что она управляет ожиданием внутри Queue(). При обрыве уже установленного разговора SIP session timers могут быть важны; для вызова, который ещё ждёт ответа оператора, сначала нужны данные о Queue(), очереди и завершившей стороне. В конфигурации нет строки, способной заменить диагностику.
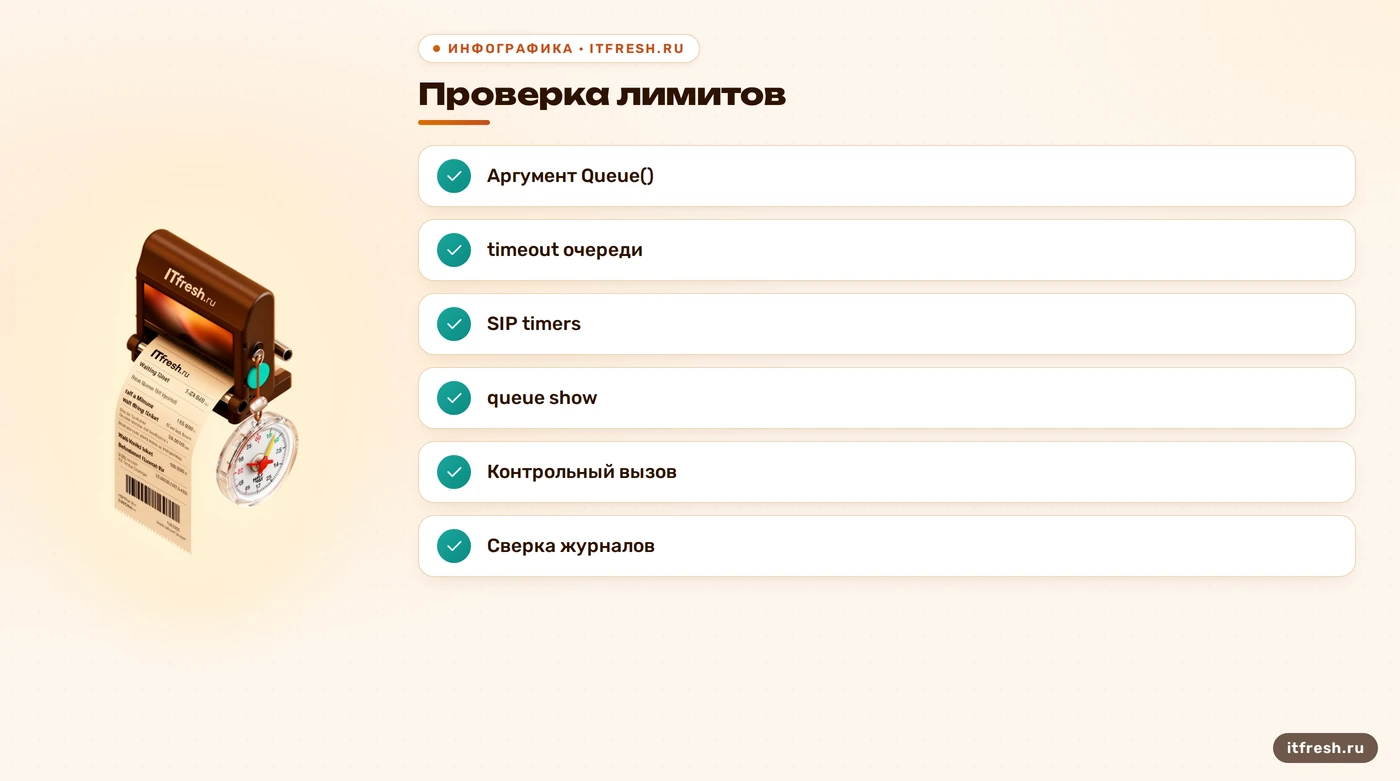
Проверьте исправление по журналам
После правки выполните контрольные звонки по каждому важному маршруту: дождитесь ответа, дождитесь перехода к следующему агенту и проверьте предусмотренный выход по лимиту. В CLI используйте queue show <имя_очереди>, чтобы увидеть текущее состояние очереди и участников. Для завершившегося вызова проверьте queue_log и, если используется AMI, сопоставьте событие очереди с состоянием канала. Команда показывает состояние сейчас; она не является доказательством, что вчерашний звонок завершился именно из-за этого параметра. Историю ищут в журнале, не в догадках. Я фиксирую базовые значения до изменения и повторяю одинаковый сценарий после него: один вызов с ожиданием ответа, один без ответа агента и один с контролируемым истечением лимита. Это не нагрузочный тест, но он быстро показывает, что путь возврата из Queue() и запись журнала соответствуют ожидаемому поведению. При нескольких очередях проверяйте каждую отдельно: общий шаблон конфигурации не гарантирует одинакового диалплана.
Если проблема повторяется, включите SIP-трассировку на ограниченное время и для конкретного сценария. Сравните сообщения INVITE, ответы и BYE, проверьте, кто отправил завершение, и свяжите это с журналом очереди. Не оставляйте подробный протокол включённым постоянно: он быстро разрастается, а полезный фрагмент среди шума искать труднее. Перед публикацией логов наружу удалите номера, адреса и учётные данные. Короткий диагностический сбор обычно полезнее архива на несколько гигабайт — редкий случай, когда меньше действительно информативнее.
Считайте исправление подтверждённым, когда повторные тесты дают ожидаемый результат, а журналы показывают соответствующий сценарий выхода. Не используйте «QueueTimeout исчез» как метрику: это неверное имя события, и отсутствие строки с таким названием ничего не доказывает. Для истечения общего ожидания проверяйте EXITWITHTIMEOUT; для ухода абонента — ABANDON в queue_log и при необходимости QueueCallerAbandon в AMI. Зафиксируйте тестовый номер вызова, время, маршрут и изменённый параметр. Так следующий администратор поймёт, что было проверено, и не вернёт сомнительную настройку из старого шаблона.
Сделайте повторный обрыв заметным
Минимальный мониторинг должен считать понятные события из queue_log: сколько вызовов вошло, сколько завершилось ответом, сколько абонентов оставили ожидание и сколько вышло по лимиту. ABANDON не равен сбою АТС: иногда человек действительно передумал ждать. EXITWITHTIMEOUT тоже не доказывает поломку — это сигнал, что заданный предел сработал. Сравнивайте доли и динамику по очередям и времени суток, а не только абсолютное число за час. Иначе рост нагрузки в понедельник утром будет выглядеть аварией, а реальная деградация тихо растворится в среднем за месяц.
В практическом мониторинге я связываю алерт с диагностическими данными: название очереди, временной интервал, доля выходов по лимиту и число доступных участников. Для детализации полезны queue_log и AMI, но не нужно придумывать событие QueueTimeout и строить на нём триггер. Если используются AMI-события, отдельно проверьте, какие события выдаёт ваша версия и включена ли нужная категория. Отчёт должен подсказывать следующий шаг, а не просто красить график в тревожный цвет. Красный график без имени очереди — это не мониторинг, это декорация.
Когда меняете маршрут, расписание или лимиты очереди, оставьте короткую запись: что изменили, зачем и каким тестовым вызовом проверили. Раз в плановый период сверяйте параметры очередей с реальным режимом работы: число операторов, график и ожидаемый путь после истечения времени. Не держите один таймаут «на всякий случай» во всех очередях, если у них разные процессы. И не перезапускайте всю АТС ради изменения, которое можно применить штатной перезагрузкой конфигурации. Любая такая операция должна иметь понятный план проверки и отката.
Частые вопросы
Почему вызов часто обрывается через 30 секунд?
Это повод проверить таймеры Queue(), сценарий диалплана и SIP-сигнализацию. Одной длительности недостаточно, чтобы назвать причину.
Что означает timeout в queues.conf?
Он задаёт длительность попытки дозвона участнику очереди. Это не общий лимит ожидания звонящего.
Как ограничить общее ожидание в Queue()?
Проверьте аргумент timeout приложения Queue() в диалплане: по документации он завершает приложение после заданного времени, проверяемого между циклами дозвона.
Какое событие queue_log означает истечение времени ожидания?
EXITWITHTIMEOUT. ABANDON означает, что абонент сам покинул очередь; это другое событие.
Поможет ли timers = yes?
Не как универсальное решение. В PJSIP timers на endpoint относится к SIP session timers, а не к лимиту ожидания в Queue().
Источники
- Asterisk: приложение Queue() — Параметры приложения, в том числе timeout и переменные результата: https://docs.asterisk.org/Asterisk_23_Documentation/API_Documentation/Dialplan_Applications/Queue/
- Asterisk: журнал очереди — Расположение queue_log и значения событий ABANDON, EXITWITHTIMEOUT и RINGNOANSWER: https://docs.asterisk.org/Operation/Logging/Queue-Logs/
- Asterisk: событие QueueCallerAbandon — Поля AMI-события при уходе вызывающего из очереди: https://docs.asterisk.org/Asterisk_24_Documentation/API_Documentation/AMI_Events/QueueCallerAbandon/
- Asterisk: параметры res_pjsip — Описание параметра timers для endpoint PJSIP: https://docs.asterisk.org/Asterisk_20_Documentation/API_Documentation/Module_Configuration/res_pjsip/