
Почему приложение ARI теряет темп при росте звонков
Если приложение на ARI тормозит при росте числа звонков, сначала измерьте задержку обработки событий и состояние самого WebSocket, а затем проверьте блокирующий код, внешние зависимости и ошибки переподключения. В статье показываю порядок диагностики, важные настройки Asterisk и способы не спутать симптомы приложения с проблемой телефонии.
Что именно ломается в связке Asterisk и ARI
В исходном черновике был описан якобы измеренный случай: конкретная компания, дата, порог в сотни звонков в час и результат после переделки. Подтверждений этим деталям в экспертной базе нет, поэтому выдавать их за историю клиента нельзя. Возьмём ООО «Кварта-М» только как условное имя из исходного материала и разберём сценарий без выдуманных замеров: CRM получает события Asterisk через приложение ARI, а часть операций пишет в базу. Это позволяет говорить о диагностике честно, не приписывая системе несуществующий рекорд нагрузки. Если нужен аудит такой интеграции телефонии, первым делом я попрошу журнал событий и временные отметки, а не обещание «всё падает на пике».
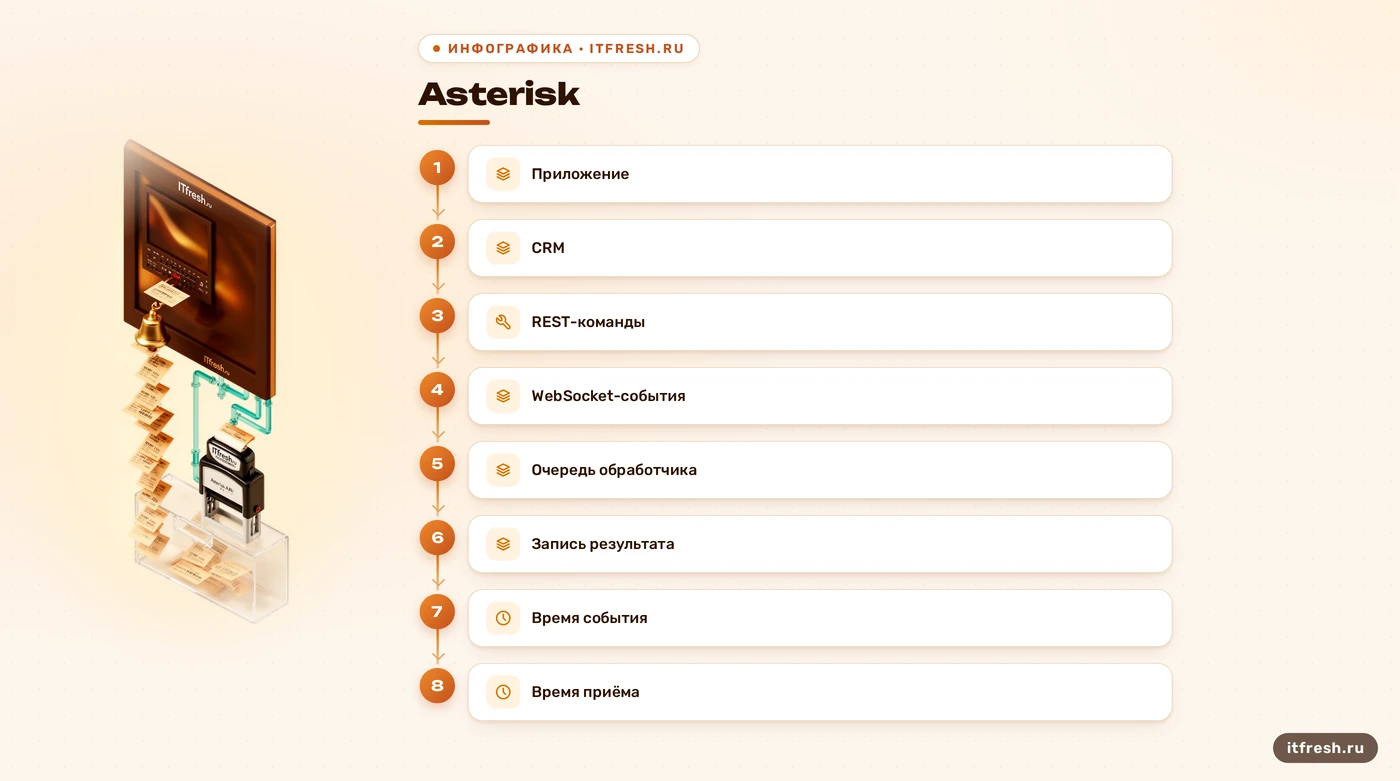
ARI — не отдельный транспорт, который сам по себе «держит все звонки». Это интерфейс управления Asterisk: команды идут через REST API, а асинхронные события приложение получает по WebSocket. Официальный пример Asterisk показывает события в формате JSON на /ari/events; вход звонка в приложение дополнительно связан с приложением диалплана Stasis(). Поэтому выражение «упал ARI» слишком расплывчато. Отдельно проверяются HTTP-запросы управления, WebSocket-сессия, очередь обработки событий в вашем коде, а также сам вызов и его маршрут. Если ломается только запись результата в CRM, перезапуск телефонной станции может оказаться самым дорогим способом ничего не выяснить.
При росте нагрузки симптомы похожи, но причины разные. Задержка события может появиться, когда обработчик занят медленным SQL-запросом; пропуск в прикладном журнале может быть следствием ошибки логирования, а не потери на стороне Asterisk; разрыв WebSocket может быть сетевым или прикладным. Слова «буфер переполнился» и «утечка памяти» звучат убедительно, но это диагнозы, а не объяснение по умолчанию. Я сопоставляю время события на стороне Asterisk, время получения приложением и момент завершения записи в CRM. Только разница между этими отметками показывает, в каком звене растёт ожидание.
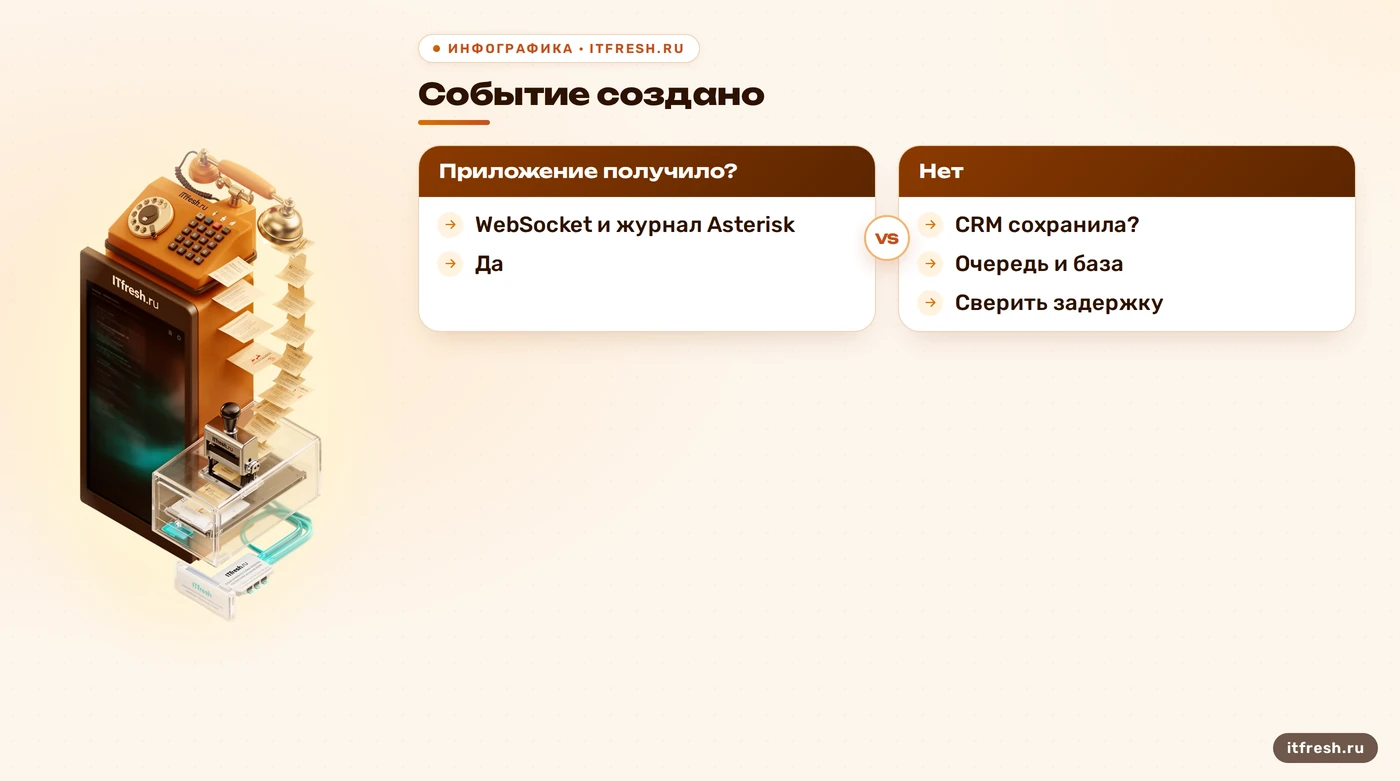
Для условного сценария фиксирую три контрольные точки: Asterisk создал или изменил канал, приложение приняло соответствующее сообщение, CRM сохранила итог. Для каждой нужны временная метка и идентификатор, позволяющий связать записи без публикации номера телефона или иных данных абонента. Если первая отметка есть, а второй нет, проверяем соединение и подписку приложения. Если вторая есть, а третьей нет, копаем обработчик и базу. Такой разбор скучнее, чем обвинить «пиковую нагрузку», зато он превращает спор в проверяемую последовательность.
- ARI: команды через REST API, события через WebSocket.
- Сверьте время события, получения и сохранения.
- Не называйте задержку утечкой без замера.
Как проверить приложение, WebSocket и события
Начните с процесса приложения: жив ли он, не растёт ли очередь задач, укладываются ли обработчики в обычное время и что происходит с ними при медленном ответе внешней системы. Отдельно учитывайте активные WebSocket-соединения и случаи закрытия сессии. Метрики «число звонков» недостаточно: оно ничего не говорит о скорости потребителя событий. Я смотрю на возраст самой старой необработанной задачи, длительность операций с базой, число повторных подключений и долю ошибок по типам. Если таких измерений пока нет, добавьте их до изменения архитектуры: иначе после релиза останется только субъективное «вроде стало легче».
Обработчик событий должен быстро принять сообщение и передать работу дальше, если дальнейшая операция медленная. Но очередь — не волшебный контейнер: ограничьте её размер, продумайте поведение при насыщении и не подтверждайте бизнес-операцию раньше, чем нужные данные надёжно сохранены. Слишком агрессивное повторение запросов способно создать второй пик поверх первого. Для повторов задайте понятную политику, разделяйте временные и постоянные ошибки и не повторяйте бездумно действие, которое может создать дубликат. Иначе приложение очень старательно запишет один звонок дважды.
Переподключение WebSocket нужно проверять как отдельное поведение приложения. Оно должно обнаружить закрытие, записать причину, попытаться восстановить соединение с паузой и вернуть обработчик в рабочее состояние. Нельзя обещать, что каждое событие, случившееся во время разрыва, автоматически будет доставлено повторно: способ восстановления зависит от механики конкретного приложения и того, какие данные оно сверяет после подключения. После переподключения сопоставьте состояние каналов с сохранёнными данными и предусмотрите обработку повторных уведомлений. Это аккуратнее, чем строить гарантию на одном лишь факте успешного открытия сокета.
Для первичной проверки полезны раздельные журналы приложения и Asterisk, а также временные отметки с единым часовым поясом. Если в logger.conf настроен канал full, он может содержать notice, warning, error, verbose и другие выбранные уровни; само имя файла не гарантирует, что нужная детализация включена. Каталог логов задаётся конфигурацией, хотя типичное расположение Asterisk — /var/log/asterisk. Уровень debug в рабочей системе включайте на время конкретного расследования: официальная документация предупреждает, что подробные записи быстро разрастаются. После сбора данных верните прежний уровень и проверьте ротацию.
AGI стоит разбирать отдельно от ARI. Классический AGI запускает внешний скрипт как новый процесс и общается с ним через stdin/stdout; путь по умолчанию берётся из astagidir в asterisk.conf, часто это /var/lib/asterisk/agi-bin. FastAGI подключается к серверу по TCP, а AsyncAGI управляет каналом через AMI. Это разные режимы с разной стоимостью запуска и моделью ожидания. На Linux стандартный путь может быть переопределён, поэтому сначала проверьте конфигурацию конкретной установки. Для временной отладки используйте CLI-команду agi set debug on, а после сбора данных выключите её через agi set debug off; команда есть в исходниках проекта Asterisk.
Какие настройки Asterisk действительно проверить
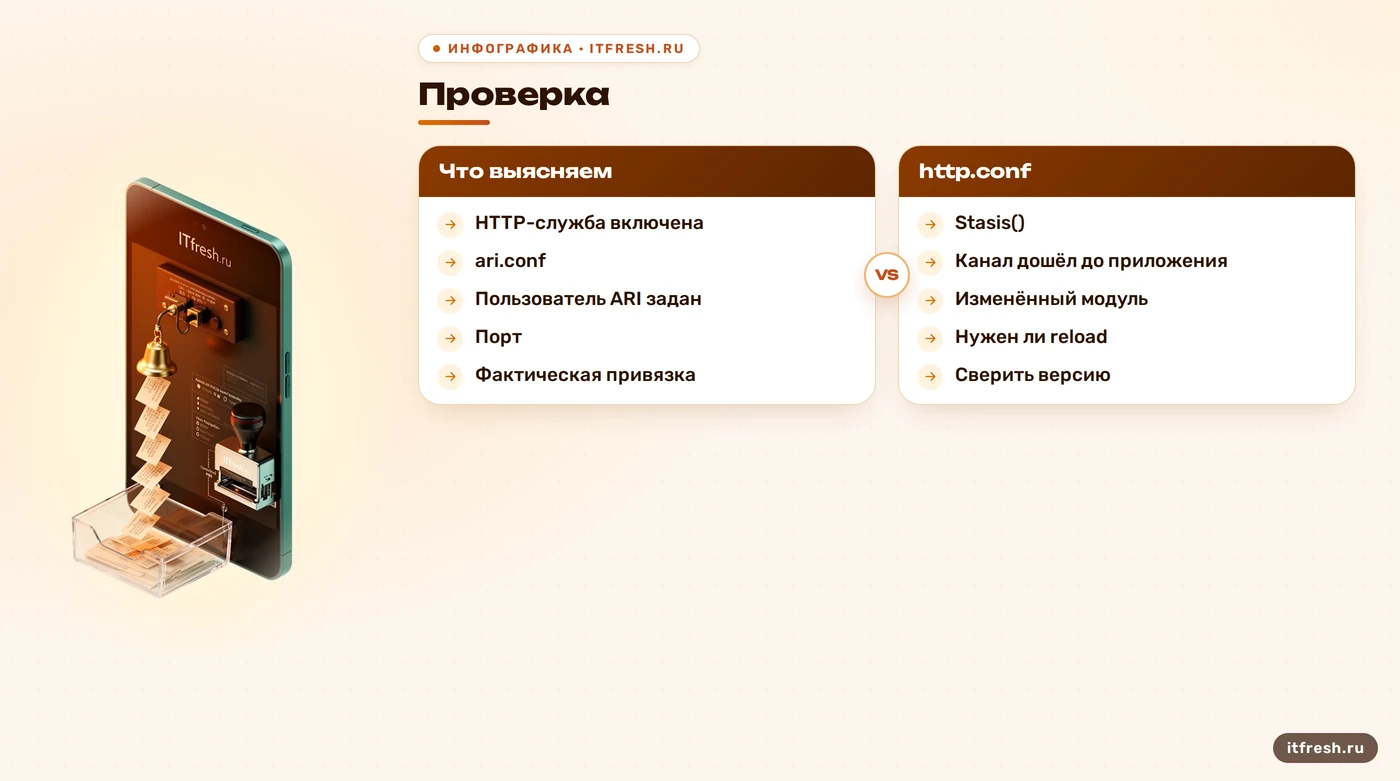
Для ARI должен быть включён HTTP-сервер Asterisk; настройки сервиса находятся в http.conf, а учётная запись ARI задаётся в ari.conf. В официальном учебном примере используется enabled = yes, адрес привязки 0.0.0.0 и подключение к стандартному порту 8088. Это пример, а не готовая безопасная конфигурация для любой сети: интерфейс привязки нужно выбирать под реальную схему доступа, а тестовый пароль из документации нельзя переносить в рабочую систему. Проверьте также, что приложение использует ожидаемые адрес, протокол и имя Stasis-приложения. Неверная точка подключения часто выглядит как «нестабильность под нагрузкой», хотя соединение вообще установлено не туда.
Не задавайте наугад «размер буферов» и «лимит одновременных соединений» по совету, в котором не указаны версия, модуль и наблюдаемая проблема. В исходной версии статьи такие настройки были предложены как универсальное лекарство, но ни конкретного параметра, ни подтверждённого ограничения там не было. Сначала посмотрите, что реально настроено в http.conf, проверьте сообщения HTTP/WebSocket и измерьте число подключённых клиентов. Если используете realtime-конфигурацию, сам факт её включения не доказывает, что именно она тормозит: нужен профиль времени запросов и сравнение с нагрузкой на базу.
Проверьте и путь вызова до Stasis. Если диалплан не отправляет нужный канал в приложение, события для этой логики не появятся. Для каждого нужного контекста посмотрите, какой extension срабатывает и где вызывается Stasis(имя_приложения). В корпоративной телефонии полезно сопоставить этот шаг с правилами диалплана Asterisk: переадресация, очередь или условие в контексте могут увести вызов по другой ветке. Так вы отделите отказ приложения от вполне исправного сценария, который просто не вызывает его.
И ещё одно: после каждого изменения не требуется безусловно перезапускать весь Asterisk. В зависимости от затронутого компонента доступна перезагрузка конфигурации или отдельного модуля; для части настроек понадобится более широкое применение изменений. Сверьтесь с документацией именно к изменённому компоненту, заранее оцените влияние на активные вызовы и фиксируйте команду, которой применили правку. В экспертной базе встречается module reload res_ari.so как вариант для конфигурации ARI, но перед выполнением его нужно сверить с установленной версией и текущим состоянием сервиса. «На всякий случай restart» в телефонии редко бывает нейтральным действием.
- Проверьте `http.conf` и `ari.conf` в своей установке.
- Сверьте адрес, порт и имя приложения.
- Измерьте HTTP/WebSocket отдельно от базы.
- Перед применением изменения проверьте влияние на вызовы.
Как выдержать пик без обещаний на глаз
Нагрузочное испытание должно отвечать на вопрос, что именно проверяется: новые каналы, частота событий, скорость ответов приложения, операции с CRM или всё вместе. Число звонков в час само по себе плохо описывает профиль: равномерные звонки и короткий всплеск с тем же итоговым количеством создают разную картину. Не копируйте в отчёт число из чужого кейса и не обещайте «любую нагрузку». Зафиксируйте сценарий, исходные ресурсы, длительность испытания, критерии успеха и отклонения от обычного режима. Если стенд не похож на производственную систему по коду и зависимости, его результат нельзя переносить на боевую среду как гарантию.
До испытания соберите базовую линию: задержку приёма событий, время обработки, число повторов, ошибки соединения, загрузку CPU и памяти процесса, а также показатели базы и сети. Во время испытания увеличивайте интенсивность постепенно и отмечайте момент, когда конкретная метрика выходит за согласованный порог. После этого повторите тот же профиль с одним изменением за раз. Так видно, помогла ли очередь, оптимизация запроса или увеличение ресурсов. Если одновременно поменять код, конфигурацию и сервер, результат будет примерно столь же научным, как «вчера было хуже».
Продумайте поведение после частичного отказа. Если CRM недоступна, приложение должно либо временно сохранять задачу локально, либо явно отправлять её в контролируемую очередь с ограничением хранения и правилами повтора. Если WebSocket оборвался, мониторинг должен показать время разрыва и восстановления. Если процесс завершился, служба запуска должна поднять его, но не спрятать причину: сохраняйте журналы завершения и алерт о рестарте. Резервирование полезно только вместе с проверкой того, что после переключения не теряются данные и не возникают дубликаты. Тут важнее согласованность действий, чем красивое слово «кластер».
Для сценариев с очередями телефонии сверьте отдельные показатели: число ожидающих вызовов, состояние операторов и время ответа. Это не метрики ARI сами по себе, но они помогут понять, деградирует ли весь маршрут вызова или только интеграция. В нашей базе есть отдельная статья про настройку очередей Asterisk; используйте её для проверки этой части схемы, а здесь сосредоточьтесь на обмене между Asterisk, приложением и CRM. Границы диагностики должны быть явными, иначе команда будет измерять одно, а чинить другое.
После каждого изменения повторите исходный сценарий и сравните одинаковые показатели. Зафиксируйте версию приложения, конфигурацию и изменения тестовой нагрузки, чтобы результат можно было воспроизвести. Тестируйте в согласованном окне и не запускайте интенсивный генератор вызовов на живую систему без оценки влияния на абонентов и операторов. Если обнаружили насыщение базы, оптимизируйте запрос или планируйте её производительность; если тормозит обработчик, исправляйте критический участок; если рвётся соединение — ищите сетевую причину и проверяйте восстановление. «Поставим сервер мощнее» оставьте как гипотезу, пока цифры не покажут ограничение именно ресурсов.
Что включить в постоянный контроль
Минимальный мониторинг приложения должен показывать доступность процесса, состояние WebSocket, время последнего события, возраст очереди задач и долю ошибок обработки. Отдельно наблюдайте за Asterisk: активными каналами, логами HTTP/WebSocket и системными ресурсами. Для CRM добавьте задержку и ошибки сохранения. Каждому сигналу назначьте понятное действие: кто получает уведомление, что проверяет первым и как подтверждает восстановление. Порог выбирайте по базовой линии конкретной системы и допустимой задержке бизнес-процесса; универсальное число без этих вводных создаёт шум и быстро приучает команду игнорировать алерты.
В качестве платформы можно использовать уже принятую у вас систему наблюдения; для Asterisk встречается связка Zabbix и Prometheus, но выбор инструмента не заменяет правильно выбранных метрик. В каталог опубликованных материалов входят мониторинг Asterisk через Zabbix и Prometheus и защита Asterisk от SIP-атак. Вторая тема нужна, когда проверяете доступность интерфейсов и внешние подключения; она не доказывает, что конкретный сбой ARI вызван атакой. Не превращайте каждую аномалию в инцидент безопасности без признаков этого.
Логирование и метрики должны помогать восстановить цепочку, но хранить только нужное. Уберите из журналов пароли, ключи авторизации, номера и содержимое разговоров, если они не требуются для задачи. Ограничьте доступ к журналам, задайте срок хранения и проверьте ротацию. Документация Asterisk позволяет назначать уровни для файловых каналов, а full — это имя настраиваемого канала, а не обязательный путь с неизменным содержимым. Это полезная конкретика: администратор смотрит не только «есть ли файл», но и какие уровни реально направлены в него.
После инцидента сохраните короткий разбор: какой симптом заметили, какая временная отметка была первой, где копилась задержка, какие изменения помогли и как проверили повторно. Не записывайте вывод «памяти стало больше — значит утечку устранили», если не измерили удержание объектов в коде и динамику памяти. Если причина осталась неясной, отметьте это и добавьте наблюдение, которое позволит поймать её в следующий раз. Хорошая эксплуатация не обещает отсутствие сбоев; она уменьшает время между первым симптомом, точным диагнозом и безопасным восстановлением.
В проекте я разделяю плановые улучшения и аварийные действия. Сначала возвращаю рабочую связь и сохраняю данные, затем убираю источник перегрузки и только после этого меняю архитектуру. Переподключение, очереди и метрики должны быть проверены на отказе зависимости, а не только в штатном прогоне. Если клиенту нужен независимый контроль, алерт можно отправлять по отдельному каналу от самого приложения. Иначе упавший процесс будет единственным наблюдателем собственной тишины — спорная кадровая политика.
- Состояние соединения и время последнего события.
- Возраст очереди и ошибки обработки.
- Задержка записи в CRM и ресурсы Asterisk.
- Ротация логов и проверка восстановления.
Частые вопросы
ARI — это WebSocket или HTTP API?
И то и другое: REST API используют для команд, WebSocket — для асинхронных событий.
С чего начать, если события задерживаются?
Сопоставить время события, получения приложением и сохранения результата в CRM; затем проверить очередь обработчика и внешние зависимости.
Какой порт обычно использует ARI?
В официальном примере Asterisk используется порт 8088. Проверьте фактическую привязку и порт в конфигурации своего сервера.
Нужно ли перезапускать Asterisk после любой правки?
Нет. Способ применения зависит от изменённого компонента: проверьте документацию и оцените влияние на активные вызовы.
Где искать AGI-скрипты и как включить отладку?
Путь по умолчанию задаёт astagidir в asterisk.conf, часто это /var/lib/asterisk/agi-bin. Для CLI-отладки AGI используется команда agi set debug on; сверяйте её с версией и средой.
Источники
- Asterisk Documentation — Getting Started with ARI — Проверены роли REST API и WebSocket, JSON-события, HTTP-служба, параметры примера и порт 8088: https://docs.asterisk.org/Configuration/Interfaces/Asterisk-REST-Interface-ARI/Getting-Started-with-ARI/
- Asterisk Documentation — Asterisk Configuration for ARI — Проверены базовые настройки ARI и необходимость HTTP-сервера: https://docs.asterisk.org/Configuration/Interfaces/Asterisk-REST-Interface-ARI/Asterisk-Configuration-for-ARI/
- Asterisk Documentation — Logging Configuration — Проверены настройка каналов logger.conf, состав примера full и предупреждение о debug в production: https://docs.asterisk.org/Configuration/Core-Configuration/Logging-Configuration/
- Asterisk Documentation — Directory and File Structure — Проверены параметры astagidir и astlogdir и их значения по умолчанию: https://docs.asterisk.org/Fundamentals/Directory-and-File-Structure/
- Asterisk Documentation — AGI application — Проверены различия классического AGI, FastAGI и AsyncAGI; команда agi set debug on сверена с CLI-командами в исходниках Asterisk: https://docs.asterisk.org/Asterisk_22_Documentation/API_Documentation/Dialplan_Applications/AGI/ и https://github.com/asterisk/asterisk/blob/master/contrib/scripts/ast_logescalator
- Asterisk Documentation — ARI Outbound Websockets — Проверены параметры переподключения для исходящих WebSocket и поведение при неудачном восстановлении: https://docs.asterisk.org/Configuration/Interfaces/Asterisk-REST-Interface-ARI/ARI-Outbound-Websockets/