
Как проверить данные 1С перед прогнозом спроса
Плохой прогноз часто начинается не с метода расчёта, а с истории продаж: пропущенной отгрузки, дубля документа или сменившегося кода товара. Я начинаю с проверки источника, единиц измерения и причин скачков. Ниже — порядок аудита, который помогает найти ошибки и не вычистить из истории настоящие события.
Сначала определите, что именно прогнозируете
Перед проверкой таблиц я задаю неприятный, но полезный вопрос: прогнозируем спрос, продажи, отгрузки или закупки? Это разные величины. Продажа показывает состоявшуюся операцию; отгрузка может запаздывать; заказ отражает намерение клиента; закупка зависит ещё и от правил пополнения запаса. Если смешать их в одном ряду, расхождение будет выглядеть как ошибка данных, хотя на деле сравниваются разные процессы. В 1С сначала фиксирую конкретный отчёт, регистр или документы, из которых берётся история, и сверяю их с тем, как компания принимает решение о запасе.
Для условной студии «Бриз-Плюс» я бы начал с короткого описания: товар, период, шаг прогноза, единица измерения и событие, которое считаем спросом. Затем отдельно отметил бы возвраты, отмены, скидочные акции, дефицит и дни, когда товар нельзя было купить. Продажи в период отсутствия товара не показывают весь неудовлетворённый спрос: ноль может означать как отсутствие покупателей, так и пустую полку. В экспертной базе отдельно отмечено, что при разреженном спросе полезно проверять агрегацию до категории товара. Это вариант анализа, который стоит сравнить с детализацией по артикулам, а не универсальная команда «сгруппировать всё». Для товаров с редкими продажами отдельно проверяю, не исчезает ли полезный сигнал на уровне артикула; сравнить детализацию помогает разумная сверка номенклатуры.
Выгрузка должна сохранять происхождение строк. Я записываю, какие документы и статусы вошли, какие склады и каналы продаж исключены, как учтены возвраты и отмены. Для проверки запасов и связей с учётной системой мы в «АйТи-Фреш» можем помочь с аудитом 1С, но решение о том, что бизнес считает спросом, принимает владелец процесса. Иначе технически аккуратный расчёт ответит на чужой вопрос.
- Выбрать прогнозируемую величину
- Зафиксировать период и шаг
- Указать единицы измерения
- Отметить дефицит и возвраты
- Сохранить правила отбора строк
Как найти пропуски, не подставляя среднее наугад
Я начинаю с обязательных полей: дата документа, товар, количество, единица измерения, склад или канал — только те, которые действительно нужны выбранному расчёту. В 1С можно отбирать пустые значения условием IS NULL; конкретные имена таблиц и полей зависят от конфигурации и отчёта. Проверяю не только пустые ячейки, но и отсутствующие периоды: календарь продаж должен показывать, где день без операций является настоящим нулём, а где выгрузка не содержит данных. Это разные ситуации, и сводить их к одному нулю — быстрый способ испортить ряд.
Исправление делаю только после выяснения причины. Если документ потерян из выгрузки, возвращаю его из учётного источника и сохраняю ссылку на исходную запись. Если поле не применимо, оставляю это явным правилом. Если причина неизвестна, помечаю пропуск и показываю его отдельно, а не заполняю средним за месяц. Среднее не знает, был ли склад закрыт, товар снят с продажи или произошла авария при обмене. Оно просто придаёт пробелу приличный вид.
В журнале аудита фиксирую исходную строку, основание корректировки, дату, автора и способ проверки. На копии данных сравниваю отчёт до и после: количество строк, сумму продаж и число уникальных документов. В экспертной базе отмечено, что пропуски ухудшают качество модели; практический вывод проще: не скрывать их и не выдавать догадку за восстановленную операцию. Если исправить первоисточник нельзя, прогноз должен видеть ограничение данных, а руководитель — понимать, где оно возникло.
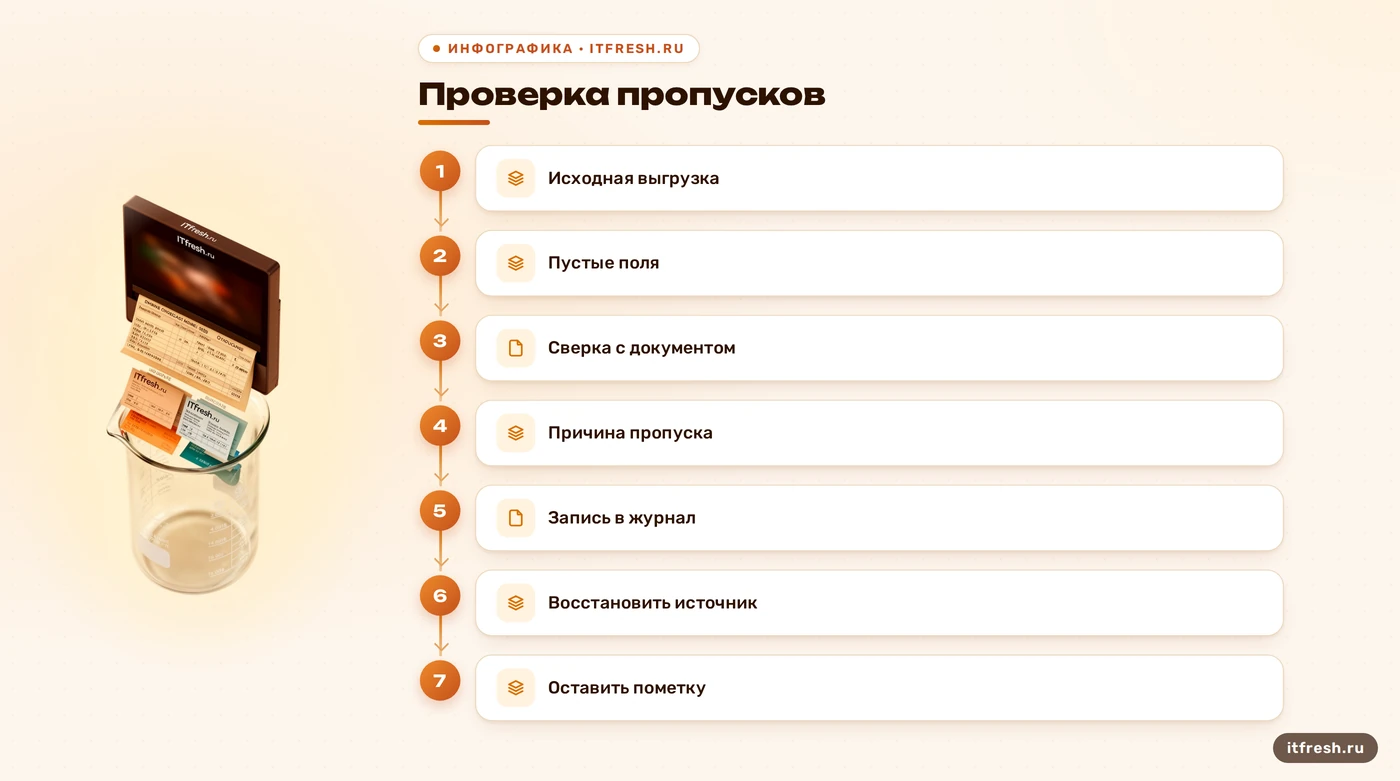
- Посчитать пустые значения по полям
- Сверить календарь с периодом выгрузки
- Проверить пропуски по первичным документам
- Записать основание каждой правки
Даты и числа: приведите к смыслу, потом к типу
Строки 2023/12/01, 01-12-2023 и N/A нельзя механически превратить в одну дату: первая запись может означать декабрь или январь в зависимости от правила разбора, вторая тоже двусмысленна, а третья вообще не дата. Я сначала устанавливаю формат источника и локаль, затем разбираю значения и сохраняю ошибки в отдельный список. В примере ниже pandas используется только для отдельной аналитической выгрузки: официальная документация описывает to_datetime(..., errors="coerce"), который преобразует неразбираемые значения в NaT. Это не исправление: строки с NaT всё равно нужно разобрать и объяснить.
import pandas as pd

df["date"] = pd.to_datetime(
    df["date_raw"], format="%Y-%m-%d", errors="coerce"
)
invalid = df[df["date"].isna()]
Формат %Y-%m-%d здесь только пример для источника, который уже гарантирует год-месяц-день. Если исходные даты смешаны, сначала разделяю форматы и задаю явные правила; угадывать порядок дня и месяца запрещаю. Для количества проверяю десятичный разделитель, пробелы, валюту и единицы. «1 200» и «1,2» могут быть корректными значениями в разных форматах, а не двумя проявлениями одной ошибки. Документация pandas подтверждает поведение преобразования, но выбор правильного формата определяется первичным источником.
В 1С не переношу вслепую синтаксис SQL или функцию из чужого языка. У платформы собственный язык запросов и типы метаданных; проверку строю на реальных полях конкретной конфигурации. После преобразования сравниваю исходные и новые значения, число строк, сумму количества и список неразобранных дат. Для дат дополнительно проверяю границы периода и часовой пояс, если обмен включает время. Такая сверка ловит случай, когда парсер не упал, но молча отправил запись в другой месяц.
- Зафиксировать формат источника
- Разбирать известные форматы отдельно
- Сохранить список ошибок преобразования
- Сверить итоги до и после
Дубли и выбросы требуют ручного смысла
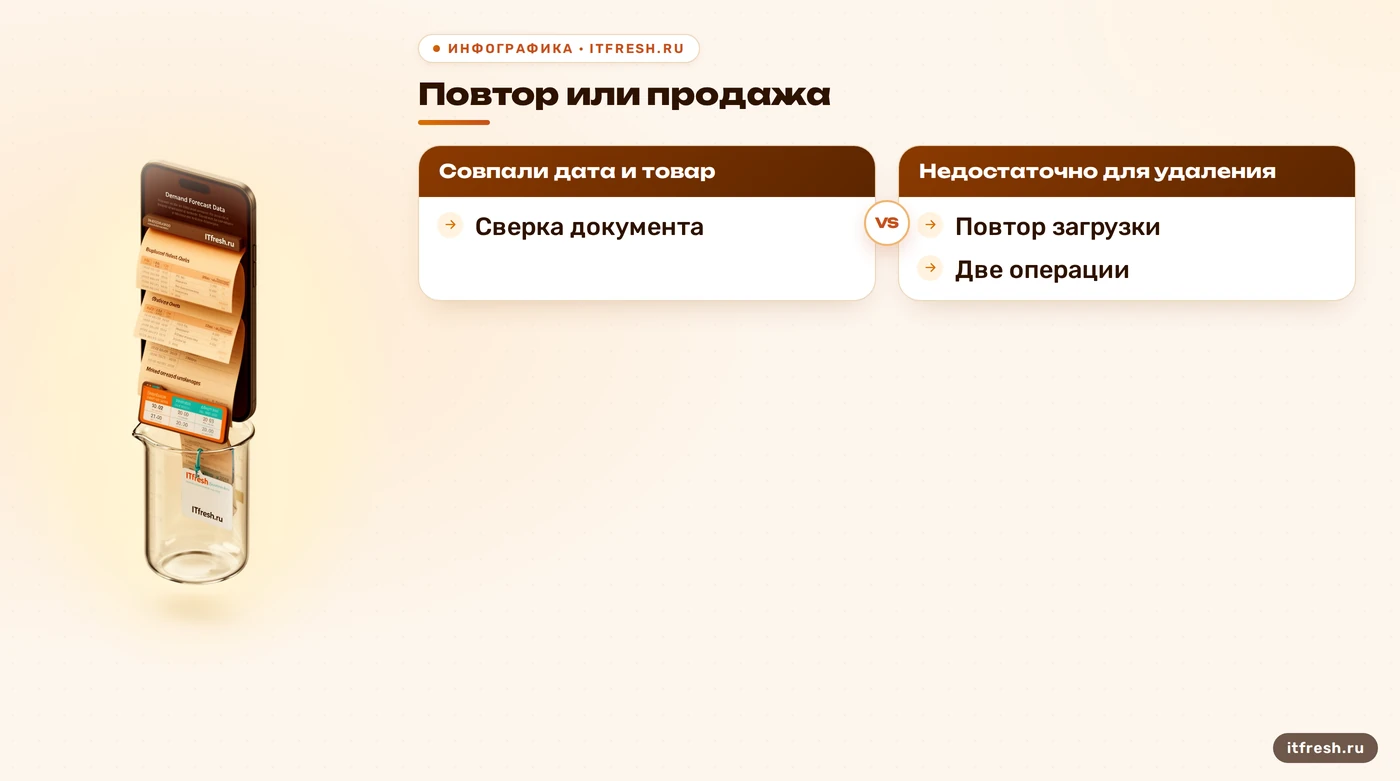
Две одинаковые строки не обязательно дубль. Два документа могут честно отражать повторную продажу; одна операция может повториться из-за повторной загрузки; одинаковый артикул может продаваться в разных единицах или на разных складах. Поэтому я сначала определяю зерно данных: что означает одна строка и какие поля однозначно описывают операцию. Затем ищу повторения по идентификатору первичного документа и строке табличной части, а не по сочетанию «дата + клиент + артикул». Такое сочетание может совпасть у двух реальных продаж.
В 1С запросы умеют группировать записи, но GROUP BY сам по себе не доказывает, что найденные строки надо удалить. Я группирую копию выгрузки по согласованному ключу, вывожу число повторов и сверяю спорные пары с документами-основаниями. Удаление делаю только после классификации: повторная загрузка, исправленный документ, возврат или самостоятельная операция. Оригинал сохраняю, а результат проверки записываю. Бухгалтерские документы не «чистят» ради красивой кривой.
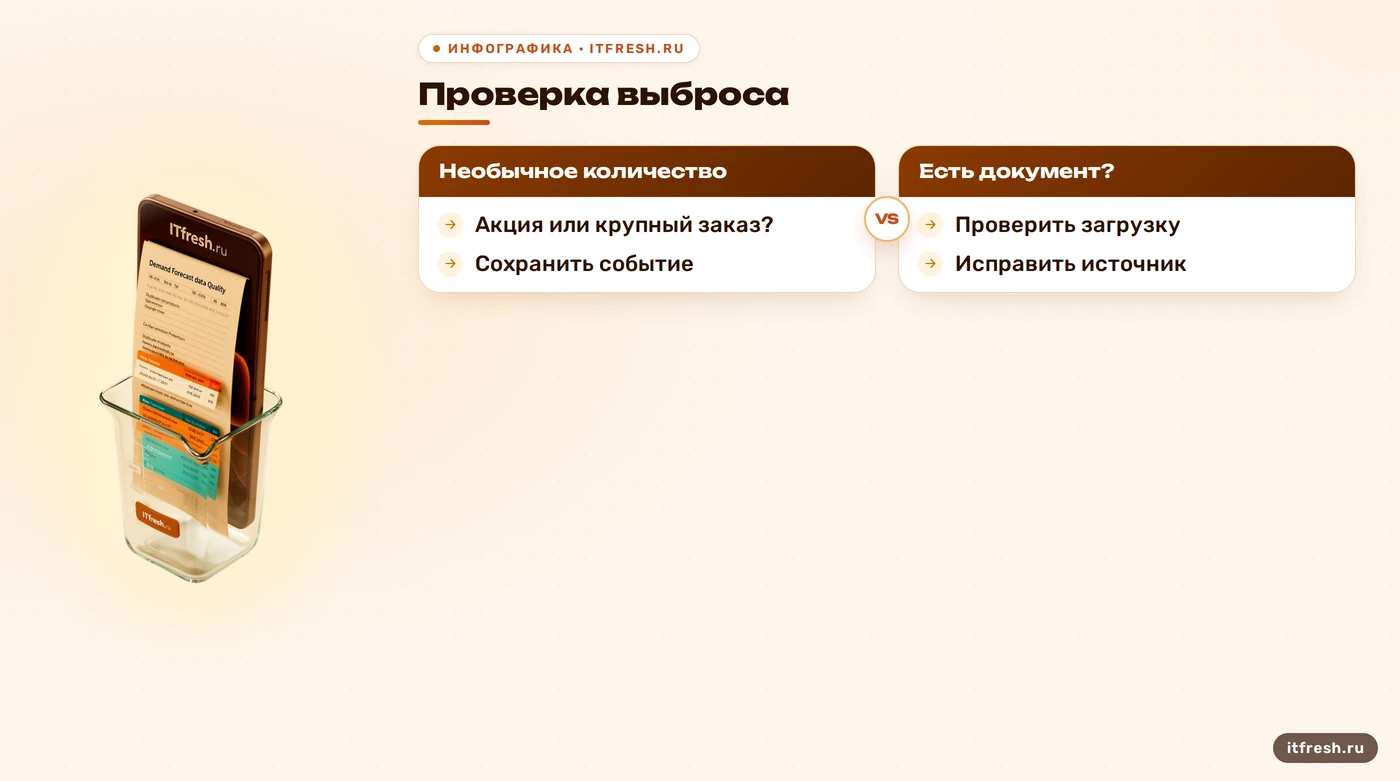
Для аномальных количеств использую график и проверку по ассортименту, периоду, складу, акции и единице измерения. Межквартильный размах помогает отметить наблюдения за границами Q1 − 1,5 × IQR и Q3 + 1,5 × IQR; NIST описывает эти границы как способ пометить потенциальные выбросы на диаграмме размаха. Это флаг для расследования, не приказ выкинуть строку. Продажа в десять раз выше обычной может быть опечаткой, крупным заказом или сезонным пиком. Математика умеет показать необычное значение; причину она не знает.
- Определить смысл одной строки
- Искать повторы по ключу операции
- Сверить каждый дубль с документом
- Помечать выбросы, не удаляя автоматически
Справочник товаров и правила меняются со временем
Если одному товару соответствуют несколько кодов, история дробится: часть продаж остаётся под старым артикулом, часть уходит под новый. Я строю таблицу соответствий с внутренним устойчивым идентификатором и периодом действия связи. Переименование, замена упаковки и настоящий новый товар — не одно событие. Перед объединением проверяю характеристики, единицы измерения, упаковку и дату перехода. Справочник «Номенклатура» помогает вести учёт, но одна лишь похожесть названий не даёт права склеивать товары. Та же дисциплина нужна не только складу: исторические данные для прогноза требуют проверки состава и смысла признаков.
Затем описываю изменения бизнес-правил рядом с данными: цена, скидка, налоговый режим, ассортимент, канал продаж, сроки поставки и ограничения наличия. Если история пересекает реформу, пометка периода важнее догадки алгоритма. В исходной статье ставка НДС 22 % называлась гипотетической; на дату этой проверки ФНС сообщает, что основная ставка изменилась с 20 % до 22 % с 1 января 2026 года. Для прогноза недостаточно просто добавить процент налога: нужно понять, менялись ли цена для покупателя, условия договора и поведение спроса. Налоговый факт не равен прогнозу продаж.
Для «Бриз-Плюс» я бы свёл коды и даты перехода в отдельную таблицу, а изменения цен и акций — в календарь событий. Дальше сравнил бы продажи до и после каждого события, не смешивая прежние и новые правила в одну необъяснённую историю. В базе знаний отдельно указан практичный состав входных данных для планирования: продажи, отгрузки и заказы с учётом периодов дефицита. Я использую этот список как вопросы для сверки, а не как требование обязательно сложить все показатели в одну колонку.
- Сопоставить старые и новые коды
- Проверить единицы и упаковку
- Записать даты изменения правил
- Отметить акции и дефицит
Порядок аудита перед запуском прогноза
Я провожу аудит в таком порядке: фиксирую вопрос бизнеса; сохраняю неизменяемую исходную выгрузку; описываю поля и единицы; проверяю покрытие периодов; ищу пропуски, повторы и спорные значения; сверяю коды товаров; добавляю календарь событий; только затем готовлю рабочий набор. Для каждого преобразования храню правило и число затронутых строк. Это позволяет повторить подготовку после следующей выгрузки и объяснить, почему конкретная цифра отличается от отчёта 1С.
Приёмка — это не один красивый показатель. Я сравниваю число операций, сумму продаж, количество возвратов, набор товаров и календарное покрытие между исходным отчётом и подготовленной таблицей. Несовпадения должны иметь объяснение и владельца. Потом беру несколько периодов, которые не участвовали в настройке, и сравниваю прогноз с фактом по выбранной метрике. Никакая чистка не гарантирует точность: спрос меняется, а история имеет предел. Цель аудита — убрать известные ошибки и сделать оставшиеся ограничения видимыми.
Для малой компании такой процесс обычно начинается с одной выгрузки и согласованного списка проверок, а не с отдельной платформы и тяжёлого конвейера обработки. По базе знаний прогнозы помогают планировать запасы и расходы на хранение; поэтому итог аудита должен быть понятен закупщику: какие товары и периоды сравнимы, где спрос мог быть ограничен, что нельзя автоматически объединять. Если после проверки остаются спорные строки, отправляю их на разбор владельцу учёта, а не прячу в формулу. Так меньше магии и больше решений, которые можно проверить.
- Сохранить исходную выгрузку
- Описать преобразования и причины
- Сверить контрольные итоги
- Проверить прогноз на отдельном периоде
- Согласовать спорные строки с владельцем учёта
Частые вопросы
Можно ли заполнить все пропуски средним значением?
Нет. Сначала выясните причину пропуска. Среднее допустимо только как осознанное правило для конкретного показателя, а не как замена отсутствующего документа.
Как искать пустые поля в 1С?
Отбор `IS NULL` поддерживается в языке запросов 1С. Подставьте реальные имена полей своей конфигурации и проверьте, означает ли пустое значение ошибку именно в этом поле.
Нужно ли удалять каждую строку за границей IQR?
Нет. Граница отмечает потенциальный выброс. Сверьте строку с документом, акцией, дефицитом и единицей измерения; удаляйте только подтверждённую ошибку.
Что считать дублем продажи?
Повтор одной и той же операции по согласованному ключу документа и его строки. Совпадение даты, клиента и товара недостаточно.
Гарантирует ли чистая выгрузка точный прогноз?
Нет. Аудит находит известные проблемы и делает ограничения видимыми; на спрос влияют события, которых нет в истории.
Источники
- 1C:Enterprise Developer Guide — язык запросов — Сверены условие IS NULL и устройство языка запросов 1С; состав полей зависит от конфигурации. https://1c-dn.com/download-trial/files/guides/developer_guide.pdf
- pandas — pandas.to_datetime — Проверен параметр errors="coerce" и его результат NaT для неразбираемых дат. https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.to_datetime.html
- NIST/SEMATECH — Box Plot — Проверены границы внутренних ограждений Q1 − 1,5 IQR и Q3 + 1,5 IQR для маркировки потенциальных выбросов. https://itl.nist.gov/div898/handbook/eda/section3/boxplot.htm
- ФНС России — НДС в 2026 году — Проверено изменение основной ставки НДС с 20 % до 22 % с 1 января 2026 года. https://www.nalog.gov.ru/new2026/