Как превратить записи разговоров Asterisk в текст на своём сервере и находить любой звонок за секунды
Записи звонков Asterisk превращаются в текст на вашем сервере так: MixMonitor пишет раздельные дорожки, очередь передаёт файлы в faster-whisper, а текст и метаданные уходят в PostgreSQL с полнотекстовым поиском. Ниже конфиги, код, железо и грабли.
Сотни записей на диске и ни одного ответа на вопрос «кто что обещал»
Классика жанра: клиент звонит директору и говорит, что менеджер обещал скидку десять процентов на вторую отгрузку. Менеджер уверяет, что ничего подобного не говорил. Запись разговора у вас есть, она лежит где-то среди 54 000 файлов за последний год. Найти её можно двумя способами: помнить точную дату и номер клиента или слушать подряд. Первое у людей получается плохо, второе занимает рабочий день, и никто его не отдаст. В итоге скидку дают, «чтобы не ссориться», а записи продолжают занимать место на диске и радовать аудиторов самим фактом существования.
Записи разговоров почти везде пишут, а вот пользы из них извлекают мало: аудио нельзя искать глазами. Если превратить его в текст, картина меняется. Фразу «обещали скидку» вы вводите в строку поиска и через секунду видите все разговоры, где она звучала, с датой, менеджером и кусочком текста вокруг. Так можно разбирать жалобы, проверять, говорят ли менеджеры по скрипту, и спорить с клиентами не на эмоциях. Если вы хотите собрать такой конвейер на собственном сервере и привлечь для этого внедрение открытых решений, то хорошая новость: все нужные компоненты бесплатные, а умеет это всё обычный Asterisk плюс Python и PostgreSQL.
Почему я принципиально не отдаю такие записи облачным сервисам распознавания. Первое: в разговоре звучат фамилии, телефоны, суммы, адреса доставки, иногда реквизиты. Это персональные данные, и отправка их стороннему сервису превращается в передачу третьему лицу с отдельным договором и вопросами к месту обработки. Второе: деньги. Облако считает минутами, а у компании, которая ведёт 180 разговоров в день, набегает около 720 минут ежедневно. Платить за них каждый день, пока собственная видеокарта простаивает ночью, мне не нравится. Третье: зависимость. Сервис поменял тариф или закрыл доступ из вашей страны, и поиск по звонкам перестаёт работать.
Дальше я разберу схему целиком, так как мы собираем её в «АйТи-Фреш» для компаний до 50 рабочих мест. Запись звонков в файлы делает Asterisk. Каждый файл ставится в очередь. Ночью воркер на faster-whisper превращает речь в текст, а текст вместе с метаданными уходит в PostgreSQL с полнотекстовым индексом. Утром директор вводит фразу и получает список звонков. Ничего из этого не покидает ваш сервер. Всё, что я пишу про железо и качество, — из практики; конкретные числа для вашей нагрузки вы получите после пробного прогона на ваших же записях.
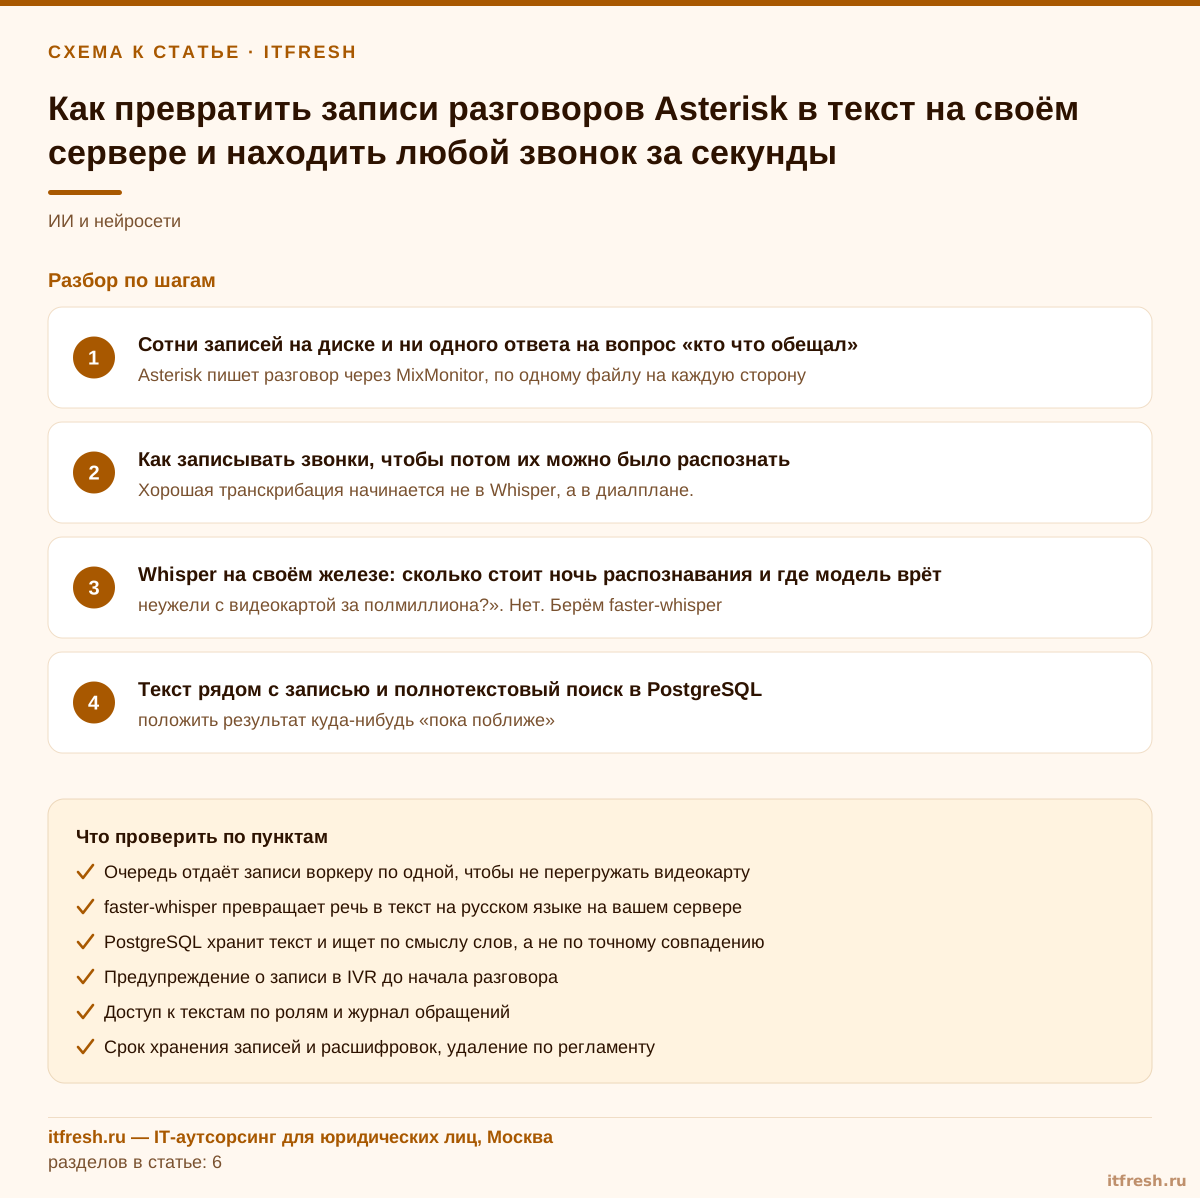
- Asterisk пишет разговор через MixMonitor, по одному файлу на каждую сторону
- Очередь отдаёт записи воркеру по одной, чтобы не перегружать видеокарту
- faster-whisper превращает речь в текст на русском языке на вашем сервере
- PostgreSQL хранит текст и ищет по смыслу слов, а не по точному совпадению
Как записывать звонки, чтобы потом их можно было распознать
Хорошая транскрибация начинается не в Whisper, а в диалплане. Я видел много установок, где записи пишутся одним смешанным файлом в формате GSM, а потом удивляются, что в распознанном тексте нельзя понять, где говорит менеджер, а где клиент. Основа всего — приложение MixMonitor. Его синтаксис такой: MixMonitor(filename.extension,[options,[command]]). Абсолютный путь в имени файла используется как есть, а относительный отсчитывается от каталога мониторинга из asterisk.conf, как правило /var/spool/asterisk/monitor. Расширение задаёт формат; для распознавания я выбираю wav. Реальное имя итогового файла после записи лежит в переменной MIXMONITOR_FILENAME.
Для распознавания я пишу каждое направление в отдельный файл. Опции r(file) и t(file) сохраняют принимаемое и передаваемое направления отдельно, а опция b ограничивает запись временем, пока канал находится в бридже, то есть без IVR и ожидания в очереди. Модель получает чистую речь каждой стороны, и кто говорил, понятно без диаризации, которая на телефонной записи работает так себе. Минус очевиден: файлов два, и текст потом нужно собрать по таймкодам, что решает word_timestamps. Опцию n, отключающую вставку тишины, я не включаю: именно эта тишина синхронизирует r- и t-файлы по времени.
Теперь про то место, ради которого всё затевалось. Третий аргумент MixMonitor — command: он выполняется, когда запись завершена. Именно сюда удобно поставить скрипт, который кладёт имя файла в очередь. Вариант из жизни:
; extensions.conf, фрагмент входящего маршрута
exten => _X.,1,NoOp(incoming)
 same => n,Set(CID=${FILTER(0-9,${CALLERID(num)})})
 same => n,Set(REC=${STRFTIME(${EPOCH},,%Y%m%d-%H%M%S)}-${CID}-${UNIQUEID})
 same => n,MixMonitor(${REC}.wav,br(${REC}-r.wav)t(${REC}-t.wav),/usr/local/bin/enqueue_call.sh ${REC})
 same => n,Dial(PJSIP/${EXTEN},30)
Обратите внимание на FILTER. В имя файла и в command нельзя подставлять сырые CALLERID(num) и CALLERID(name): звонящий сам решает, что у него в caller ID, и строка вида «;rm -rf» превращается в инъекцию команд на вашем сервере. FILTER(0-9,...) оставляет только цифры, и это самый дешёвый способ спать спокойно. Какой из файлов чей, определяется каналом, на котором стоит MixMonitor: r — это то, что Asterisk принимает от этого канала, t — то, что в него отдаёт. В примере выше запись висит на канале звонящего, значит r — голос клиента, t — голос менеджера; на исходящем звонке с канала менеджера будет наоборот. На первом тестовом звонке всё равно проверьте это ушами и зафиксируйте в скрипте: переставить две буквы дешевле, чем полгода читать расшифровки с перепутанными ролями.
Что делает enqueue_call.sh? Почти ничего: он атомарно кладёт маркер в каталог очереди, и всё. Ни распознавания, ни обращения к базе внутри обработчика Asterisk быть не должно: если скрипт зависнет, вы получите подвисшие каналы на АТС. Атомарность важна, чтобы воркер не подхватил полузаписанный файл: пишем под временным именем и переименовываем. Если вы хотите заодно навести порядок в самих файлах записей, у нас есть отдельные разборы где лежат файлы записей и сроков их хранения.
Отдельный вопрос — MixMonitor или другие способы записи. Если записи лежат на том же диске, что и система, а расписания чистки нет, транскрибация порядка не наведёт: сама по себе она диск не забьёт — текст рядом с каждым файлом прибавляет килобайты, а не мегабайты, — но и проблему переполнения не решит. Про разницу MixMonitor и AsyncRecord и то, как это влияет на диск, я писал отдельно: для нашей задачи достаточно MixMonitor, как и в большинстве типовых установок на 20–50 рабочих мест.
Whisper на своём железе: сколько стоит ночь распознавания и где модель врёт
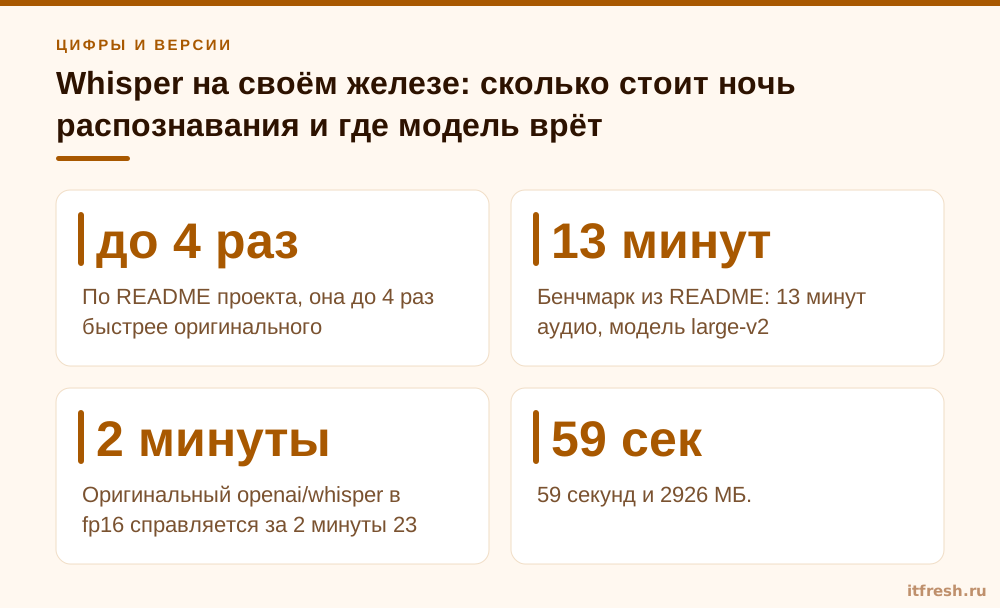
Типичный вопрос директора: «А сервер под это нужен какой, неужели с видеокартой за полмиллиона?». Нет. Берём faster-whisper — реализацию Whisper на CTranslate2. По README проекта, она до 4 раз быстрее оригинального openai/whisper при той же точности и расходует меньше памяти, а 8-битная квантизация работает и на CPU, и на GPU. Установка — pip install faster-whisper на Python не ниже 3.9. FFmpeg ставить не нужно, декодирование делает PyAV. Для видеокарты нужны CUDA 12 и cuDNN 9; для старых окружений в README описан пин более ранних версий ctranslate2, так что смотрите свой случай там, а не в моей памяти.
Цифры лучше брать из измерений, а не из рекламы. Бенчмарк из README: 13 минут аудио, модель large-v2, видеокарта RTX 3070 Ti на 8 ГБ, beam 5. Оригинальный openai/whisper в fp16 справляется за 2 минуты 23 секунды и занимает 4708 МБ видеопамяти. faster-whisper в fp16 — 1 минута 03 секунды и 4525 МБ. В int8 — 59 секунд и 2926 МБ. А в пакетном режиме с batch_size=8 в int8 — 16 секунд при 4500 МБ. На CPU картина скромнее: на i7-12700K с 8 потоками и моделью small оригинал в fp32 тратит 6 минут 58 секунд и 2335 МБ памяти, faster-whisper int8 — 1 минуту 42 секунды и 1477 МБ, а int8 с batch 8 — 51 секунду и 3608 МБ. Простая арифметика: если 13 минут аудио обрабатываются за 59 секунд, то 12 часов разговоров на видеокарте в int8 — это порядка часа, а с пакетным режимом ещё в несколько раз быстрее. Но это мои пересчёты по README, а не гарантия для вашего сервера: у вас другая карта, другой звук и другой процессор.
Рабочий код воркера выглядит так. Модель грузим один раз при старте, а не на каждый звонок, иначе половина ночи уйдёт на загрузку:
import json, logging
from faster_whisper import WhisperModel

logging.basicConfig()
logging.getLogger("faster_whisper").setLevel(logging.INFO)

model = WhisperModel("large-v3", device="cuda", compute_type="int8_float16")

def recognize(path, who):
    segments, info = model.transcribe(
        path, beam_size=5, language="ru",
        vad_filter=True,
        vad_parameters=dict(min_silence_duration_ms=500),
        word_timestamps=True)
    # segments - генератор: распознавание идёт при переборе
    return [{"who": who, "start": round(s.start, 2),
             "end": round(s.end, 2), "text": s.text.strip()}
            for s in segments]

def process(base):
    rows = recognize(base + "-r.wav", "сторона r") + recognize(base + "-t.wav", "сторона t")
    rows.sort(key=lambda r: r["start"])
    with open(base + ".json", "w", encoding="utf-8") as f:
        json.dump(rows, f, ensure_ascii=False)
    with open(base + ".txt", "w", encoding="utf-8") as f:
        f.write("\n".join(r["who"] + ": " + r["text"] for r in rows))
Обратите внимание: segments — генератор, и пока вы по нему не прошли, ничего не распознано. Это частая ловушка: человек вызывает transcribe, видит мгновенный результат и радуется, а работа делается позже, на первом же цикле. Для больших объёмов в библиотеке есть BatchedInferencePipeline: в примере там batch_size=16, и VAD в нём включён по умолчанию. Модели large-v3, turbo и distil-large-v3 скачиваются с Hugging Face автоматически при первом запуске, поэтому серверу нужен доступ к huggingface.co один раз. Если сервер живёт в закрытом контуре, скачайте модель заранее и положите в локальный каталог.
Теперь о том, где модель врёт. Первое — звук. Телефонный канал 8 кГц (G.711) — худший вход, какой можно придумать для распознавания. Если транк и телефоны отдают широкополосный кодек, пишите в формат wav16 (расширение .wav16, 16 кГц) — обычный .wav в Asterisk это 8 кГц; на узкой полосе готовьтесь к ошибкам в фамилиях, названиях и цифрах. Номера телефонов и суммы я всегда рекомендую перепроверять по аудио, а не принимать текст на веру: модель услышала «пятнадцать» там, где сказали «пятьдесят», и это ровно та ошибка, ради которой потом звонят директору. Второе — галлюцинации на тишине: модель может «досочинить» фразу в паузе. Лечит vad_filter. Учтите, что VAD по умолчанию консервативный и режет только тишину дольше 2 секунд, поэтому min_silence_duration_ms=500 я задаю явно.
Третье — выбор модели. По моему опыту, русский язык на large-v3 распознаётся заметно лучше, чем на small или medium; если слово «обещали» превращается в «общали», поиск вас подведёт. Одна карта на 12–24 ГБ тянет large-v3 с запасом. CPU-вариант годится для десятков звонков в день, а не сотен: сотни разговоров на процессоре превращаются в очередь, которая не успевает разгрестись за ночь. Сравнение для типового случая смотрите на схеме ниже.
Текст рядом с записью и полнотекстовый поиск в PostgreSQL
Вечный соблазн — положить результат куда-нибудь «пока поближе», например в таблицу CRM или в общую папку. Через полгода выясняется, что поиск по ней — это grep по тысячам файлов и десять минут ожидания. Я делаю по-другому. Рядом с записью лежит текст в том же пути с расширением .txt и .json — чтобы файлы переносились и архивировались вместе. А метаданные и сам текст дублируются в PostgreSQL: уникальный id звонка, номера, длительность, менеджер, время начала, путь к файлам. Файлы остаются источником истины, база — быстрым индексом, который при необходимости пересобирается из них.
Поиск делает штатный механизм PostgreSQL: тип tsvector, GIN-индекс и русский словарь 'russian'. Он приводит слова к основам, поэтому «обещали скидку», «обещал скидку» и «скидку обещали» находятся одним запросом. Для пользовательского ввода удобен websearch_to_tsquery: он понимает кавычки, слово «or» и минус, и им можно кормить строку поиска как есть. Таблица, индекс и запрос:
CREATE TABLE call_text (
    call_id     text PRIMARY KEY,
    started_at  timestamptz NOT NULL,
    src         text,
    dst         text,
    manager     text,
    duration_s  integer,
    txt_path    text,
    body        text NOT NULL,
    tsv         tsvector GENERATED ALWAYS AS (to_tsvector('russian', body)) STORED
);

CREATE INDEX call_text_tsv_idx ON call_text USING GIN (tsv);

SELECT call_id, started_at, manager,
       ts_headline('russian', body, q, 'MaxFragments=2') AS fragment
FROM call_text, websearch_to_tsquery('russian', 'обещали скидку') AS q
WHERE tsv @@ q
ORDER BY ts_rank(tsv, q) DESC
LIMIT 20;
Сгенерированный столбец требует PostgreSQL 12 или новее; на более старой версии tsvector придётся обновлять триггером. Проверьте в документации своей версии синтаксис и параметры ts_headline.
Теперь про то, что директор действительно увидит. Не psql, конечно. Хватает маленькой веб-страницы: строка поиска, фильтр по менеджеру и датам, результаты с фрагментом текста и кнопкой «послушать» на нужном таймкоде. Второй вариант — выгрузка в CRM по id звонка: тогда текст и ссылка появляются прямо в карточке клиента. Если у вас уже болит история, когда записи теряются на пути между АТС и CRM, как чинить пропажу записей в CRM мы разбирали отдельно, и всё, что там написано про общий id звонка, здесь пригодится как фундамент.
Два практических совета. Не индексируйте текст, пока распознавание не закончилось: частично заполненные записи ломают доверие к поиску, потому что директор не найдёт звонок и решит, что его не было. Пишите в базу в самом конце, одной транзакцией, а при сбое возвращайте файл в очередь. И второе: считайте объём заранее. Текст разговора на 4 минуты — это несколько килобайт, в пересчёте на 180 звонков в день вы набираете меньше мегабайта в сутки. Основной объём — аудио, а не текст, поэтому планируйте диск под записи, а не под базу.
152-ФЗ: запись и расшифровка тоже считаются обработкой персональных данных
Ситуация: проверяющий или недовольный клиент задаёт простой вопрос — «а на каком основании вы записываете разговоры и где они хранятся?». И выясняется, что в IVR нет ни слова о записи, к расшифровкам имеет доступ любой, кто знает адрес страницы, а удалять их никто не собирался. Расшифровка разговора — это такая же обработка персональных данных, как сама запись, только удобнее для поиска и потому опаснее при утечке. Требования 152-ФЗ к обработке ПД применимы к тексту так же, как к аудио.
Что нужно сделать, не вдаваясь в юридические дебри. Предупредить собеседника о записи в приветствии IVR. Разграничить доступ к текстам по ролям: менеджер видит свои разговоры, руководитель отдела — отдела, директор и ответственный за ПД — всё. Определить срок хранения и удалять записи и тексты по регламенту, а не «когда закончится диск». Вести журнал обращений к расшифровкам, чтобы понимать, кто и когда открывал спорный разговор. Если подробно интересует именно подготовка АТС к проверке, у нас есть чек-лист по подготовке Asterisk к проверке по 152-ФЗ, а здесь я добавлю только то, что относится к расшифровкам.
Теперь аргумент в пользу локальной схемы. Облачный сервис распознавания — это передача персональных данных третьему лицу: нужен отдельный договор, нужно понимать, где физически обрабатываются данные и кто имеет к ним доступ. Локальная обработка снимает вопрос трансграничной передачи и сокращает цепочку ответственных до вас и вашего администратора. Про выбор между своей АТС и облачной, с точки зрения требований закона и бюджета, мы писали в сравнении Asterisk или облачная АТС, а текущая тема — естественное продолжение: свои записи и свои расшифровки остаются у вас.
Остаётся техническая защита самого сервера: диск с записями и базой шифруется, доступ к страницам поиска идёт по HTTPS и через доменную учётку, резервные копии хранятся так же осторожно, как оригиналы. Это стандартные меры, и если вы хотите, чтобы их оформил и проверил специалист, к вашим услугам информационная безопасность и защита данных. Юридическую часть — формулировки согласий и политику обработки — всё равно согласуйте с вашим юристом: я пишу как администратор, а не как адвокат.
- Предупреждение о записи в IVR до начала разговора
- Доступ к текстам по ролям и журнал обращений
- Срок хранения записей и расшифровок, удаление по регламенту
- Локальная обработка без передачи третьему лицу
- Шифрование диска, HTTPS и резервные копии с теми же правилами доступа
Кейс: оптовая компания «Пятый Причал»
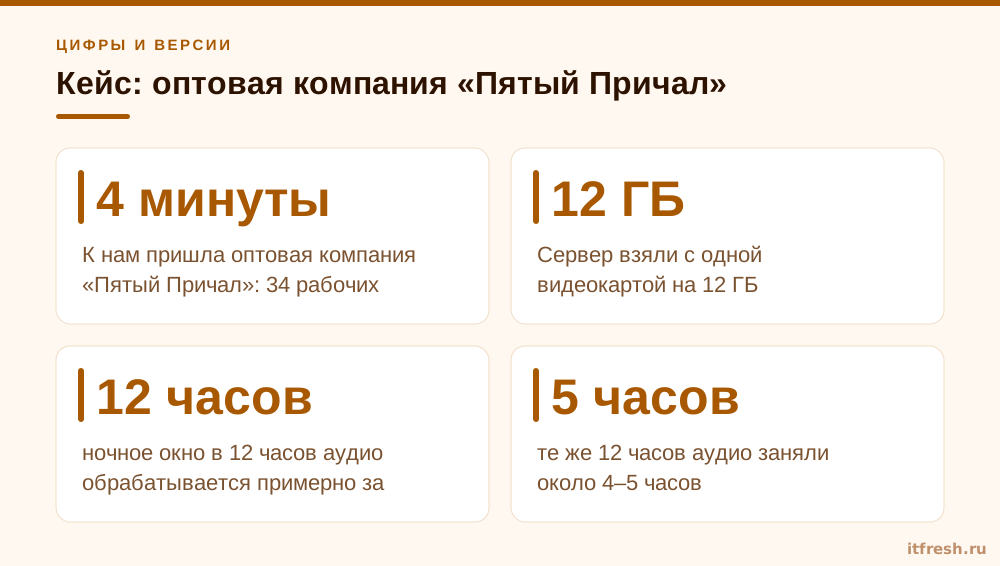
К нам пришла оптовая компания «Пятый Причал»: 34 рабочих места, 7 менеджеров продаж, Asterisk 20 и примерно 180 разговоров в день со средней длительностью 4 минуты, то есть около 12 часов аудио ежедневно. Запись давно шла в смешанном GSM-файле, всё лежало на одном диске с системой. Главная боль формулировалась ровно так, как я описывал в начале: клиенты ссылались на обещания, которых менеджеры «не помнили», а директор тратил на выяснение до часа на каждый спор. Облачное распознавание они уже пробовали и отказались: персональные данные, плюс счёт за 720 минут в день не вызвал энтузиазма.
Мы собрали схему из этой статьи. В диалплане включили MixMonitor с раздельными дорожками r и t, wav вместо GSM, FILTER на caller ID и постановку в очередь через command. Сервер взяли с одной видеокартой на 12 ГБ; под такую нагрузку хватило бы и карты попроще. Модель large-v3 в режиме int8_float16: ночное окно в 12 часов аудио обрабатывается примерно за 1–1,5 часа, то есть с огромным запасом. Мы проверили и CPU-вариант на старом Xeon клиента: восемь потоков, модель small в int8 — те же 12 часов аудио заняли около 4–5 часов, втрое дольше, чем обещает бенчмарк README на свежем i7: старые серверные процессоры без быстрых векторных инструкций считают нейросети заметно медленнее. Работает, но запаса почти нет: пара совещаний с длинными звонками, и очередь не успевает к утру. Поэтому оставили видеокарту, а CPU-вариант — как запасной.
Текст сохраняется рядом с записью, метаданные и tsvector — в PostgreSQL с GIN-индексом. Для директора мы сделали простую страницу поиска за доменной авторизацией с ролями. Весь проект занял 3 рабочих дня: первый день — запись и очередь, второй — воркер и тестовые прогоны на живых звонках, третий — база, страница поиска и регламент хранения. На пробном прогоне выяснилось несколько неприятных мелочей: в нескольких звонках путаница с цифрами в номерах заказов из-за 8 кГц у транка; с оператором договорились о широкополосном кодеке для части линий, а запись перевели в wav16.
Итог. Директор вводит «обещали скидку» и за секунды получает список разговоров с фрагментами и ссылкой на нужный момент записи. Спорные ситуации с клиентами разбираются сразу, без часа поисков, и случаев, когда приходится уступать «на слово», стало кратно меньше. Менеджеры поначалу напряглись, потом заметили, что запись защищает и их: когда клиент перекручивает слова, ответ находится одним поиском. Никаких внешних сервисов, облачных ключей и счетов за минуты. Серверу нужно только обслуживание — от 7 000 ₽/мес, если не хочется заниматься им самим.
Частые вопросы
Можно ли расшифровывать звонки Asterisk без облака?
Да. MixMonitor пишет записи в файлы, а faster-whisper на вашем сервере превращает их в текст. Для большой нагрузки нужна видеокарта, для десятков звонков в день хватит процессора.
Какая видеокарта нужна для large-v3?
По практике, одна карта на 12–24 ГБ тянет large-v3 с запасом. В README faster-whisper модель large-v2 в int8 занимает порядка 2926 МБ видеопамяти, но проверьте нагрузку на своих записях.
Как отделить речь менеджера от речи клиента?
Пишите стороны в отдельные файлы опциями r(file) и t(file) в MixMonitor. Тогда кто говорил, определяется по файлу, а диаризация не нужна. Какой файл чей, проверьте тестовым звонком.
Подходит ли узкополосная телефонная запись 8 кГц?
Подходит, но ошибок будет больше, особенно в фамилиях и цифрах. Если транк отдаёт широкополосный кодек, пишите в формат wav16 (16 кГц, обычный .wav в Asterisk — 8 кГц), а номера и суммы перепроверяйте по аудио.
Является ли расшифровка звонка персональными данными?
Да. Запись и расшифровка — обработка персональных данных, на неё распространяются требования 152-ФЗ: уведомление о записи, роли доступа, срок хранения и удаление по регламенту.
Источники
- Asterisk — MixMonitor — Проверены синтаксис, опции b, r, t, n, D, команда по завершению записи и переменная MIXMONITOR_FILENAME: https://docs.asterisk.org/Latest_API/API_Documentation/Dialplan_Applications/MixMonitor/
- faster-whisper — README — Проверены установка, compute_type, параметры transcribe, VAD и бенчмарки для GPU и CPU: https://github.com/SYSTRAN/faster-whisper
- PostgreSQL — Full Text Search — Проверены tsvector, GIN-индексы и словарь russian: https://www.postgresql.org/docs/current/textsearch.html
- PostgreSQL — Controlling Text Search — Проверены to_tsvector, websearch_to_tsquery, ts_rank и ts_headline: https://www.postgresql.org/docs/current/textsearch-controls.html