
Docker показывает unbound-mailcow healthy, а dig внутри контейнера не получает ответа: чему верить
Docker пишет unbound-mailcow healthy, а ручной dig +short домен @127.0.0.1 внутри того же контейнера виснет и уходит в таймаут. Верить статусу контейнера в этой ситуации нельзя — я разбирал похожий случай у книжного магазина «Полка чудес», где здоровый по Docker unbound больше года не делал ровно то, для чего его проверяли. Показываю, что реально тестирует healthcheck.sh, где он врёт и как проверять DNS без оглядки на статус контейнера.
Кейс «Полка чудес»: письма зависли в очереди, а unbound — healthy
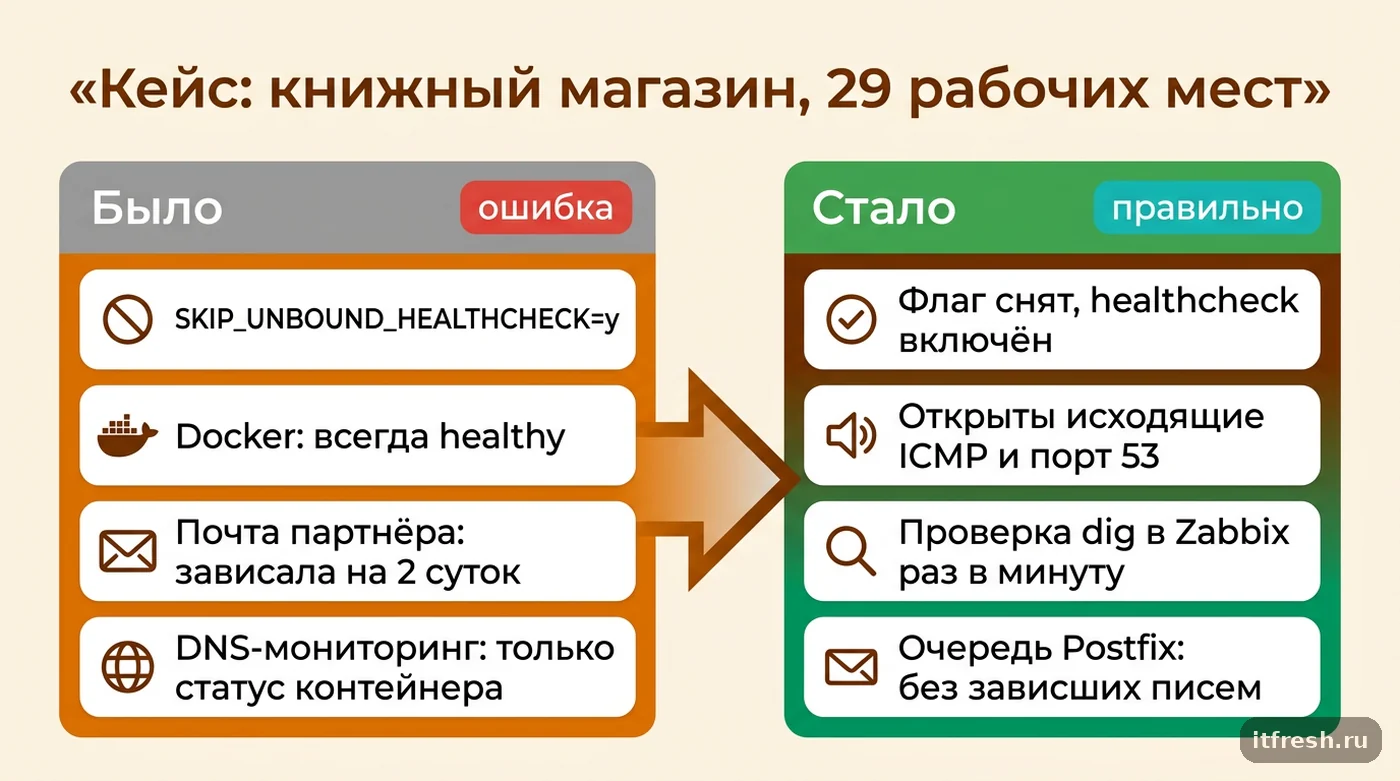
Книжный магазин «Полка чудес», 29 рабочих мест, держит почтовый сервер на mailcow для заказов от оптовых партнёров — на почту завязана интеграция с 1С, письма от поставщиков разбираются автоматически. Утром бухгалтер пожаловалась, что письма от одного из партнёров не приходят вторые сутки. Я первым делом посмотрел docker compose ps — все контейнеры зелёные, unbound-mailcow в статусе healthy, как и всегда. Дальше проверил postfix: в mailq копились исходящие письма с отметкой Host or domain name not found. Name service error ... type=MX, а входящие от партнёра, как потом выяснилось, наш сервер отбивал временной ошибкой, и они копились уже в очереди у отправителя.
Зашёл в контейнер и проверил DNS напрямую: docker compose exec unbound-mailcow dig +short partner-domain.example @127.0.0.1. Команда молчала пятнадцать секунд и уходила в таймаут. То есть DNS внутри mailcow реально не работал — а Docker при этом честно (по его собственным критериям) продолжал называть контейнер здоровым. Расхождение между «здоров по докеру» и «резолвит по факту» — это не глюк, а следствие того, что именно проверяет healthcheck-скрипт unbound и при каких условиях он вообще перестаёт что-либо проверять.
Два дня простоя для магазина с оптовыми поставками — это не абстрактная метрика, а реальные пропущенные заказы: пока письмо от партнёра висело в очереди, склад не знал, что нужно готовить отгрузку. При этом никто из сотрудников не мог пожаловаться раньше, чем через двое суток — мониторинга самого mailcow у клиента на тот момент не было вообще, а зелёный docker compose ps при случайной проверке ничего не говорил о проблеме.
Что реально проверяет healthcheck.sh: ping и dig по трём доменам
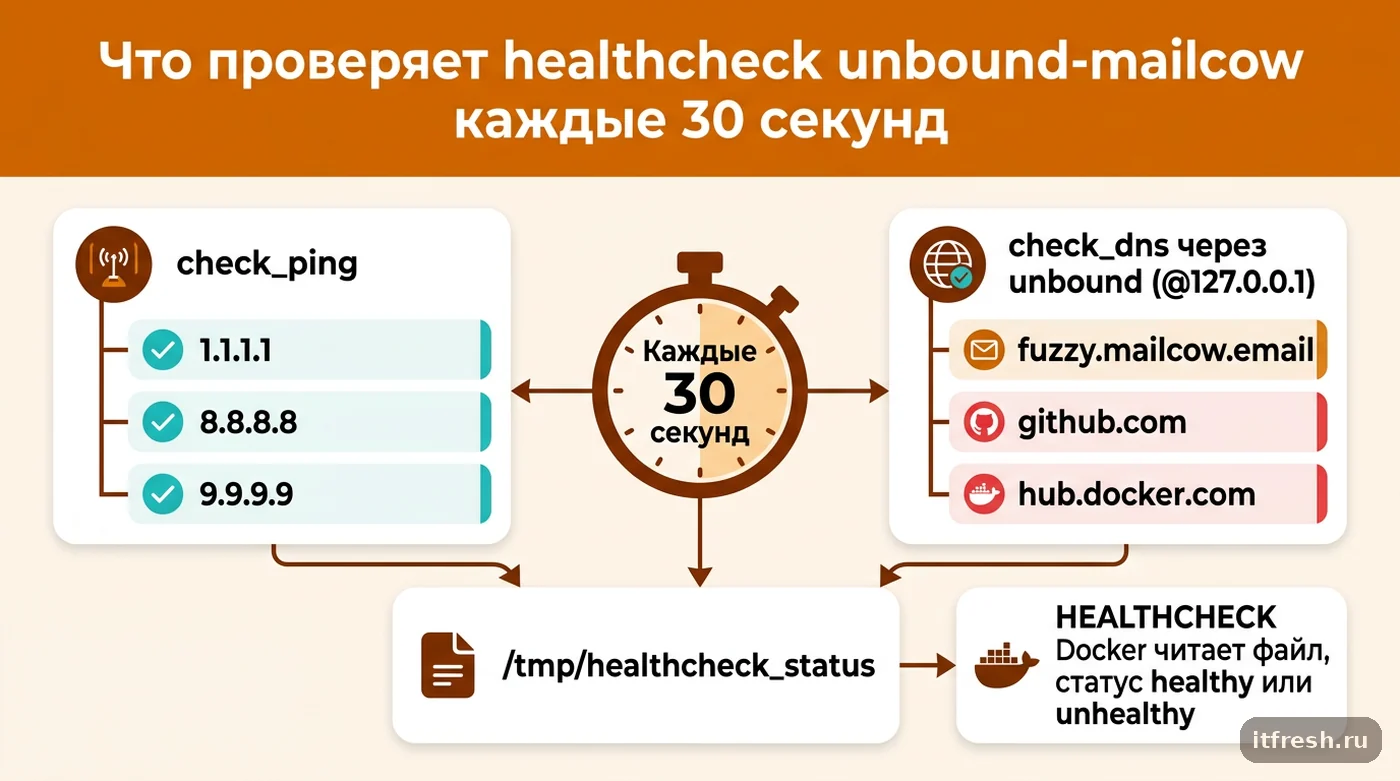
В официальном образе ghcr.io/mailcow/unbound healthcheck — это не однократная команда в HEALTHCHECK, а отдельный процесс, который крутится фоном через supervisor и раз в 30 секунд перезаписывает файл /tmp/healthcheck_status. Сам HEALTHCHECK в Dockerfile лишь читает этот файл: HEALTHCHECK --interval=30s --timeout=10s CMD sh -c '[ -f /tmp/healthcheck_status ] && [ "$(cat /tmp/healthcheck_status)" -eq 0 ] || exit 1'. Это важно: статус контейнера отражает не текущее состояние DNS в момент вашего запроса, а последний результат фонового цикла, которому может быть до 30 секунд.
Сам цикл в healthcheck.sh делает две проверки. check_ping пингует три адреса — 1.1.1.1, 8.8.8.8, 9.9.9.9 — по три попытки на каждый, и допускает не больше одного провала из трёх адресов. check_dns резолвит через сам unbound три домена — fuzzy.mailcow.email, github.com, hub.docker.com — командой dig +short +timeout=2 +tries=1 <домен> @127.0.0.1, тоже с тремя попытками на домен и допуском одного провала. Обе проверки должны пройти, чтобы в файл записался 0 и Docker увидел healthy.
Из этого следует неочевидная вещь, которую я регулярно вижу на VPS: healthcheck unbound зависит не только от DNS, но и от ICMP. Если провайдер режет исходящий ping, check_ping проваливает минимум два адреса из трёх, и контейнер уходит в unhealthy при полностью рабочем резолвере. А раз от unbound-mailcow с условием service_healthy зависят clamd-mailcow, postfix-mailcow, postfix-tlspol-mailcow и acme-mailcow, стек после перезапуска просто не поднимается целиком. Именно в этот момент у администратора появляется соблазн «выключить проверку» — и с этого начинается история «Полки чудес».
SKIP_UNBOUND_HEALTHCHECK: как один флаг превращает healthcheck в фикцию
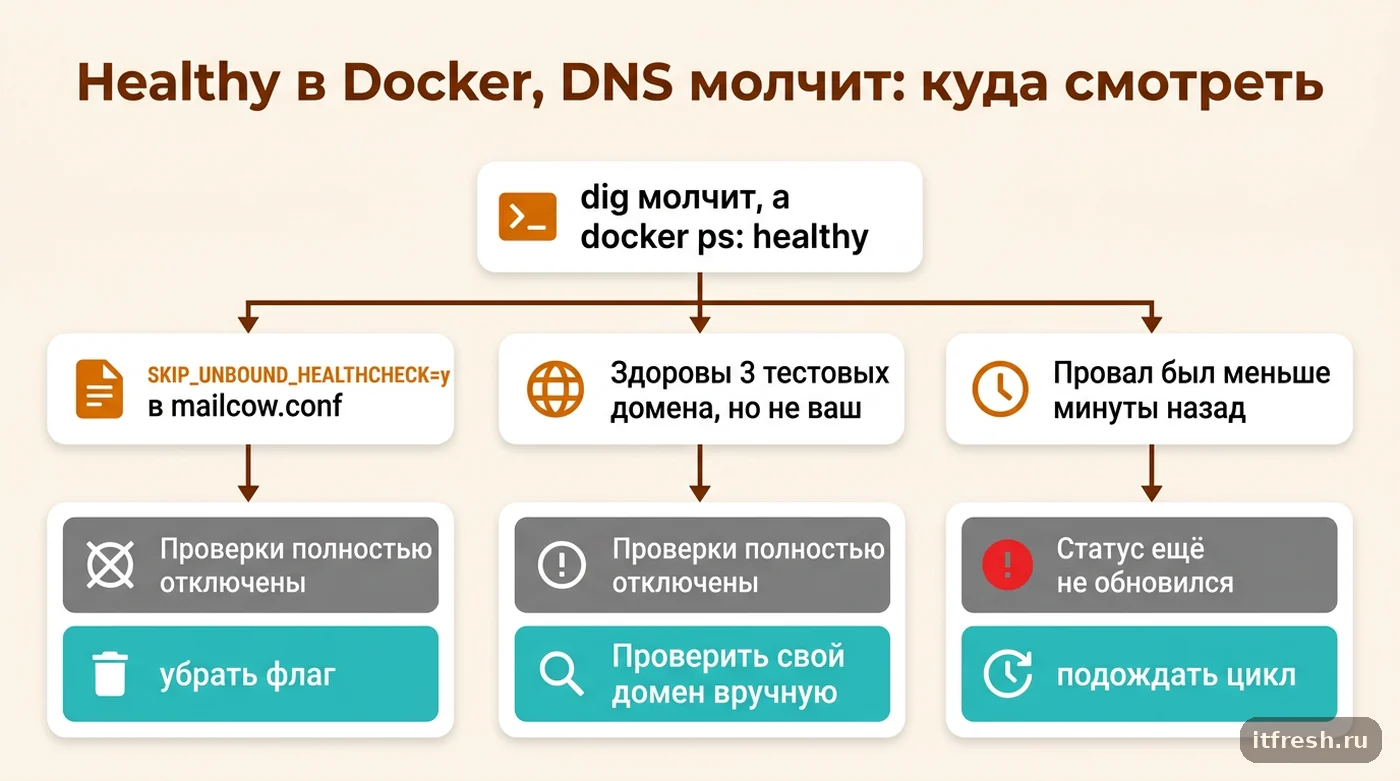
У «Полки чудес» причина расхождения оказалась не в тонкостях таймингов, а в одной переменной. В начале скрипта healthcheck.sh есть условие: если SKIP_UNBOUND_HEALTHCHECK равно y, скрипт один раз пишет в лог ALL CHECKS WERE SKIPPED! Unbound is healthy!, записывает в статус-файл 0 и уходит в sleep 365d — то есть засыпает на год, не проверяя вообще ничего. Именно этот текст — ALL CHECKS WERE SKIPPED — встречается и в открытых issue на GitHub у других администраторов mailcow с похожей жалобой: статус healthy, а DNS не работает.
В docker-compose.yml переменная объявлена как SKIP_UNBOUND_HEALTHCHECK=${SKIP_UNBOUND_HEALTHCHECK:-n} — по умолчанию n, то есть проверки должны идти. Но y можно выставить в mailcow.conf, и тогда значение подхватится при следующем docker compose up -d. У «Полки чудес» этот флаг стоял в mailcow.conf ещё с прошлого лета — судя по дате в git-истории конфига на сервере, его добавили во время миграции на новый VPS. Провайдер новой площадки резал исходящий ICMP, check_ping валился, unbound висел в unhealthy, postfix не стартовал — и предыдущий подрядчик просто отключил проверку вместо того, чтобы разобраться в причине. DNS при этом работал, и год всё было тихо. С тех пор Docker был обязан говорить healthy при любом реальном состоянии DNS — а за двое суток до жалобы провайдер ужесточил фильтрацию и начал резать исходящие запросы на порт 53 ко всем серверам, кроме своих резолверов. Unbound в mailcow — полноценный рекурсивный резолвер, он ходит к корневым и авторитативным серверам сам, так что резолв встал целиком, а сигнал об этом был выключен.
Это типичный пример того, как временный обходной путь превращается в постоянную дыру в наблюдаемости. Отключить проверку, чтобы стек перестал «краснеть» и заказчик не паниковал — самое простое решение в моменте, но оно снимает не проблему, а сигнал о ней. Я в своём регламенте установки mailcow отдельно фиксирую все нестандартные флаги, выставленные в mailcow.conf, именно чтобы через год не пришлось гадать, что и зачем отключил кто-то до меня.
Почему ручной dig и docker ps могут не совпадать даже без skip
Даже если SKIP_UNBOUND_HEALTHCHECK не выставлен, полное доверие статусу контейнера — плохая идея по двум более тонким причинам. Первая — частота: фоновый цикл в healthcheck.sh спит 30 секунд между итерациями, а сам HEALTHCHECK в Dockerfile ещё и не меняет статус контейнера на unhealthy после первого же провала — по умолчанию Docker требует три подряд неудачных вызова CMD (параметр retries, в Dockerfile образа он не переопределён), прежде чем помечает контейнер как unhealthy. Плюс сам цикл с повторами: три адреса по три попытки ping с таймаутом до 5 секунд каждая — это ещё до минуты на одну итерацию при сбое. Между реальным сбоем DNS и тем, что это увидит docker ps, может пройти больше минуты.
Вторая причина — набор проверяемых доменов и путь резолва. check_dns спрашивает три конкретных домена именно у localhost-порта самого unbound (@127.0.0.1) — это тест самого резолвера, а не внешней связности. Если проблема специфична для одного конкретного домена (например, у его серверов имён нестабильный ответ или проблема с DNSSEC-подписью именно этой зоны), healthcheck этого не увидит вообще: он проверяет github.com, hub.docker.com и fuzzy.mailcow.email, а не тот домен, который завис у вас в очереди Postfix. Здоровый по этим трём доменам unbound вполне может не резолвить четвёртый — тот, что реально нужен.
Тот же принцип — не доверять статусу контейнера как единственному источнику правды — я закладываю в любую инсталляцию на Docker, не только mailcow. В практиках эксплуатации Docker в продакшене отдельным пунктом идёт разделение healthcheck-сигнала контейнера и внешнего мониторинга сервиса: первый нужен самому Docker для перезапуска и зависимостей depends_on, второй — администратору, чтобы понимать, что происходит с бизнес-функцией, а не с процессом внутри контейнера.
Ещё одна ловушка: root hints и trust anchor обновляются при каждом старте
Отдельно стоит смотреть на логи самого старта контейнера, а не только на итоговый статус. docker-entrypoint.sh образа unbound при каждом запуске — не только при первой установке — выполняет unbound-anchor -a /etc/unbound/trusted-key.key для DNSSEC-якоря и подтягивает свежий файл корневых серверов: curl -#o /etc/unbound/root.hints https://www.internic.net/domain/named.cache. Всё это происходит до старта supervisord, то есть до того, как сам unbound и его healthcheck вообще запустятся.
Если на момент старта контейнера исходящий HTTPS до internic.net заблокирован — новым правилом файрвола, прокси, временным сетевым сбоем при миграции — curl в энтрипоинте уйдёт в таймаут и завершится с ошибкой, но скрипт не проверяет код возврата и продолжает выполнение: unbound всё равно стартует с тем файлом root.hints, что был собран в образ при сборке. Обычно это не критично — список корневых серверов меняется редко, — но в логах контейнера это выглядит как явная DNS-проблема на старте, хотя сам резолвер потом вполне может подняться и работать штатно. Не путайте одну ошибку curl при старте с постоянной неработоспособностью unbound — это разные вещи, и разбираться нужно именно с логами check_dns, а не с однократным сообщением про internic.net. Похожую путаницу «в логах есть ошибка, но сервис на самом деле жив» я регулярно вижу и в других частях почтового стека — например, когда очередь Postfix растёт в Zimbra из-за проблем с DNS у amavis, а не из-за самого Postfix. Правило одно и то же: сначала проверяю, что конкретно означает сообщение в логе и на каком этапе оно возникло, и только потом делаю вывод о работоспособности сервиса в целом.
Как проверить unbound по-настоящему, а не по статусу контейнера
Первым делом я смотрю, не стоит ли тот самый флаг:
docker compose exec unbound-mailcow env | grep SKIP_UNBOUND_HEALTHCHECK
grep SKIP_UNBOUND_HEALTHCHECK mailcow.conf
Если он равен y — это и есть причина, почему статус не отражает реальность, вне зависимости от того, что происходит с DNS на самом деле. Дальше проверяю резолв напрямую, тем же способом, что использует сам healthcheck, но своим доменом:
docker compose exec unbound-mailcow dig +short +timeout=2 +tries=1 partner-domain.example @127.0.0.1Если ответа нет — смотрю живые логи unbound, а не только финальный статус-файл: docker compose logs -f --tail=100 unbound-mailcow покажет строки Healthcheck: DNS Resolution Failed из самого скрипта, если проверки реально идут и реально проваливаются, или полное отсутствие таких строк, если они действительно отключены флагом.
Что я поменял у «Полки чудес» и как теперь мониторю DNS отдельно от Docker
Первым делом убрал SKIP_UNBOUND_HEALTHCHECK=y из mailcow.conf и поднял стек заново — check_dns и check_ping включились, а сам unbound после этого честно ушёл в unhealthy сразу по двум причинам: исходная, миграционная (режется ICMP), никуда не делась, просто была год спрятана под флагом, а к ней добавилась свежая — блокировка исходящего порта 53. В панели провайдера я открыл для VPS исходящие ICMP echo и DNS (53/udp и 53/tcp), после чего обе проверки healthcheck.sh стали проходить стабильно, очередь Postfix разошлась за полчаса, а письма партнёра дошли после очередной попытки с его стороны.
На будущее я не полагаюсь только на docker compose ps для DNS — в свой мониторинг через Zabbix добавил отдельную активную проверку: раз в минуту Zabbix-агент на самом хосте mailcow выполняет dig +short +timeout=2 +tries=1 partner-domain.example @172.22.1.254 — это адрес unbound-mailcow в сети mailcow по умолчанию (IPV4_NETWORK=172.22.1), наружу порт 53 контейнера не опубликован, а с хоста до бриджа Docker он доступен, и access-control в unbound.conf сеть 172.16.0.0/12 разрешает. Слежу за временем ответа, а не только за фактом ответа. Статус контейнера — полезный первый сигнал, но для DNS, от которого зависит вся доставка почты, я хочу видеть независимую проверку, которая не может быть выключена одной строкой в конфиге и не забудет об этом никто из будущих подрядчиков. Отдельно завёл алерт именно на сам факт присутствия SKIP_UNBOUND_HEALTHCHECK=y в конфиге — не жду, пока кто-то снова тихо включит этот флаг как быстрый способ погасить тревогу в мониторинге, а сразу вижу это в еженедельном отчёте по клиенту.
Частые вопросы
Почему Docker пишет unbound-mailcow healthy, если DNS реально не отвечает?
Либо в mailcow.conf стоит SKIP_UNBOUND_HEALTHCHECK=y — тогда проверки полностью отключены и статус всегда healthy независимо от реального состояния DNS. Либо здоровы именно три домена, которые тестирует healthcheck.sh (fuzzy.mailcow.email, github.com, hub.docker.com), а не тот домен, что завис у вас.
Что означает лог ALL CHECKS WERE SKIPPED в unbound-mailcow?
Это сообщение пишет healthcheck.sh, когда переменная SKIP_UNBOUND_HEALTHCHECK установлена в y — скрипт один раз отчитывается о пропуске всех проверок и засыпает на год, статус-файл раз и навсегда фиксируется как healthy.
Как вручную проверить, реально ли работает unbound внутри контейнера?
Командой docker compose exec unbound-mailcow dig +short +timeout=2 +tries=1 <домен> @127.0.0.1 — это тот же запрос, который использует сам healthcheck.sh, только с вашим доменом вместо трёх тестовых.
Связан ли watchdog mailcow с Docker healthcheck unbound?
Это два разных механизма. Docker HEALTHCHECK управляет статусом контейнера (healthy/unhealthy), и от него через condition: service_healthy зависят clamd-mailcow, postfix-mailcow, postfix-tlspol-mailcow и acme-mailcow. Watchdog-контейнер mailcow — отдельный процесс: он сам резолвит другой домен (stackoverflow.com) и проверяет DNSSEC, при превышении порога UNBOUND_THRESHOLD (по умолчанию 5) перезапускает unbound-mailcow и шлёт уведомление, не дожидаясь смены статуса Docker. SKIP_UNBOUND_HEALTHCHECK на watchdog не влияет.
Почему в логах старта unbound-mailcow есть ошибка curl к internic.net?
docker-entrypoint.sh при каждом запуске контейнера обновляет файл корневых DNS-серверов через curl к internic.net. Если исходящий HTTPS в момент старта недоступен, curl падает, но скрипт не проверяет код возврата — unbound всё равно стартует со старым root.hints из образа. Это не всегда означает, что сам резолвер не работает.
Источники
- healthcheck.sh, исходник unbound в mailcow-dockerized — Проверено дословно: логика check_ping (1.1.1.1/8.8.8.8/9.9.9.9), check_dns (dig +short +timeout=2 +tries=1 к fuzzy.mailcow.email/github.com/hub.docker.com @127.0.0.1), обработка SKIP_UNBOUND_HEALTHCHECK и лог ALL CHECKS WERE SKIPPED. https://github.com/mailcow/mailcow-dockerized/blob/master/data/Dockerfiles/unbound/healthcheck.sh
- Dockerfile образа unbound, mailcow-dockerized — Проверено: директива HEALTHCHECK --interval=30s --timeout=10s, чтение /tmp/healthcheck_status. https://github.com/mailcow/mailcow-dockerized/blob/master/data/Dockerfiles/unbound/Dockerfile
- docker-entrypoint.sh образа unbound, mailcow-dockerized — Проверено: unbound-anchor и curl к www.internic.net/domain/named.cache при каждом старте контейнера, до запуска supervisord. https://github.com/mailcow/mailcow-dockerized/blob/master/data/Dockerfiles/unbound/docker-entrypoint.sh
- docker-compose.yml, сервис unbound-mailcow — Проверено: образ ghcr.io/mailcow/unbound:1.26.1-1, переменная SKIP_UNBOUND_HEALTHCHECK=${SKIP_UNBOUND_HEALTHCHECK:-n}, depends_on unbound-mailcow condition service_healthy у clamd-mailcow, postfix-mailcow, postfix-tlspol-mailcow и acme-mailcow; IPv4 unbound ${IPV4_NETWORK:-172.22.1}.254, порты наружу не публикуются. https://github.com/mailcow/mailcow-dockerized/blob/master/docker-compose.yml
- Watchdog thresholds — mailcow: dockerized documentation — Проверено: таблица порогов, UNBOUND_THRESHOLD по умолчанию 5, описание watchdog как отдельного механизма перезапуска unbound. https://docs.mailcow.email/manual-guides/Watchdog/u_e-watchdog-thresholds/
- GitHub Issue #7309, mailcow-dockerized — Проверено: точные команды и ошибки (dig +short github.com @127.0.0.1 timeout, curl: (28) Failed to connect to www.internic.net port 443), версии в заголовке issue: mailcow 2026-06 / Unbound 1.25.1-1. https://github.com/mailcow/mailcow-dockerized/issues/7309
- watchdog.sh и unbound.conf, mailcow-dockerized — Проверено: unbound_checks резолвит stackoverflow.com и проверяет DNSSEC, при ошибке — перезапуск unbound-mailcow через com_pipe; access-control 10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16 allow. https://github.com/mailcow/mailcow-dockerized/blob/master/data/Dockerfiles/watchdog/watchdog.sh