
Что покажет технологический журнал 1С при зависании
Когда 1С зависает или выдаёт ошибку, технологический журнал помогает увидеть события платформы и связать их с сеансом, вызовом или ожиданием блокировки. Я покажу, где настраивать сбор через logcfg.xml, как сузить выборку по времени и событию и почему полный журнал нельзя бездумно оставлять включённым.
Что пишет технологический журнал 1С и где его включить
Технологический журнал — это подробная техническая запись о работе платформы 1С. Не путайте его с журналом регистрации: тот хранит прикладные события вроде действий пользователя, а технологический фиксирует работу процессов, вызовы, исключения и взаимодействие с СУБД. В расследовании он показывает последовательность событий и контекст вокруг сбоя. Это полезно, когда обычного сообщения «не удалось выполнить операцию» недостаточно, чтобы понять, где именно задержка или ошибка. Методические материалы 1С рекомендуют начинать анализ сложных проблем с правильно настроенного сбора, а не включать подряд всё на неопределённый срок.
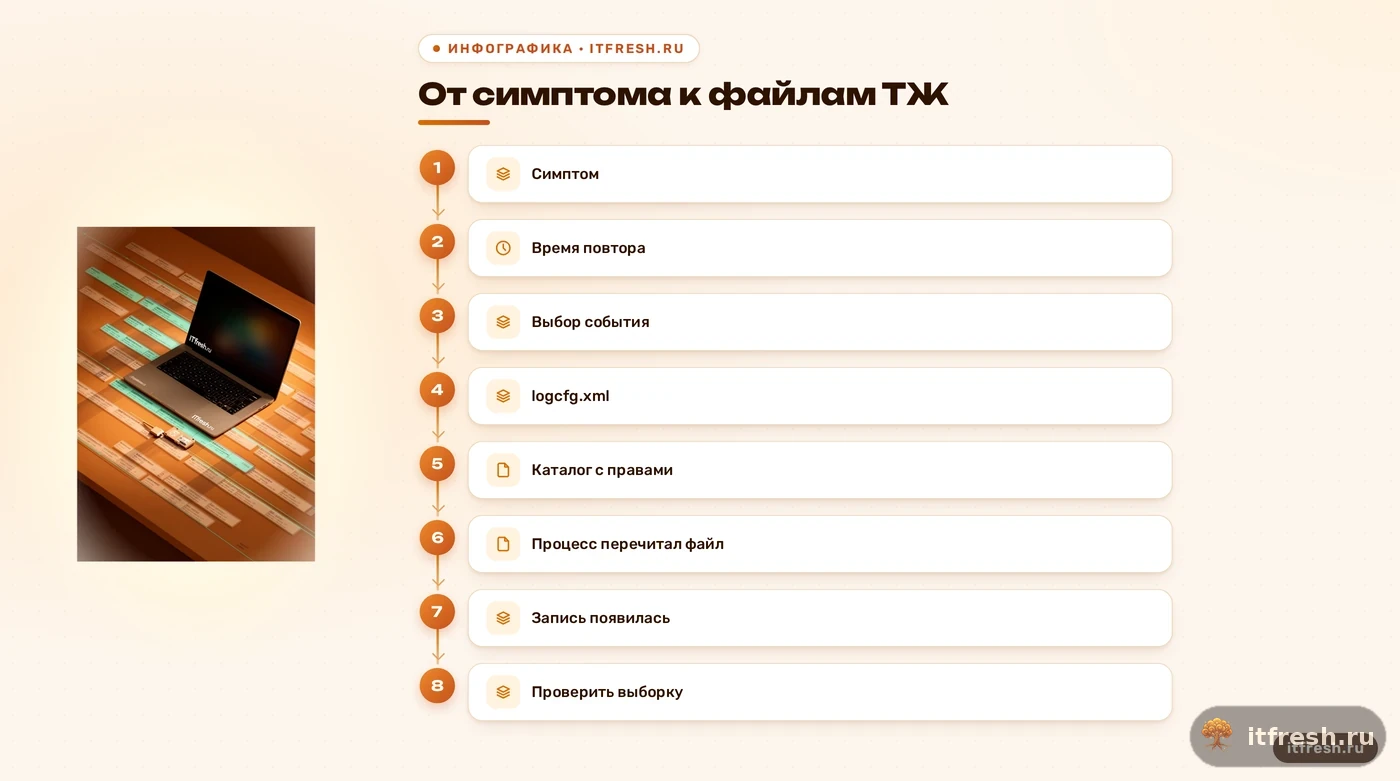
Настройки технологического журнала задаются в XML-файле logcfg.xml. Файлы 1cv8.cfg и 1cv8reg.cfg не заменяют конфигурацию ТЖ. В logcfg.xml задают, куда писать файлы, какие события собирать и какие свойства записывать. На Linux путь к конфигурации зависит от установленной версии платформы; в документации 1С приведён пример каталога /opt/1cv8/x86_64/<версия>/conf/. Не копируйте этот путь вслепую: сначала найдите каталог именно того серверного процесса и версии, которые обслуживают вашу базу. Если нужна помощь с серверной частью, я настраиваю среду 1С с учётом её фактической схемы.
Отдельно проверьте каталог, куда будут писаться логи. Он должен существовать, а учётная запись службы 1С — иметь право создавать в нём файлы. Для диагностики это важнее, чем запускать клиент «от имени администратора»: клиент и серверный процесс могут работать под разными учётными записями. Сначала выберите событие, которое поможет ответить на конкретный вопрос, затем укажите путь и поля. В logcfg.xml эти решения задаются вместе; универсального переключателя «показывать все ошибки» в форме клиента здесь нет.
После изменения файла не спешите перезапускать весь кластер. В методике 1С для настройки технологического журнала рекомендуется дать процессам время перечитать конфигурацию и затем проверить, что сбор идёт так, как задумано. Для рабочего расследования я заранее фиксирую точное время изменения настроек и время повторения симптома. Если записей нет, так проще отличить ошибку в пути или правах от ситуации, когда нужное событие вообще не возникло. Перезапуск службы оставляю на случай, когда проверка конфигурации и перечитывания не помогла, а не назначаю его ритуалом.
- Найдите `logcfg.xml` для нужной версии и узла кластера.
- Создайте каталог логов и проверьте права учётной записи службы.
- Выберите события под конкретный симптом.
- После изменения проверьте новые записи до перезапуска службы.
Как найти нужное событие, сеанс и процесс
Начинайте с временного окна. Запишите, когда пользователь запустил действие и когда увидел задержку или сообщение, затем попросите повторить операцию один раз. Не открывайте многосуточный набор файлов с надеждой, что строка сама прыгнет на экран. В журналах разных процессов записи идут параллельно; у событий есть время, тип и набор свойств. Сопоставление по времени помогает выделить участок, а дальше его нужно связать с сеансом, видом события и операцией. Если время сбоя никто не зафиксировал, сначала восстановите его по журналу регистрации или рассказу пользователя, а не подменяйте догадкой.
Для привязки к пользовательской операции полезен SessionID: в методике 1С описан поиск номера сеанса по журналу регистрации с последующей фильтрацией технологического журнала по сеансу и типу события. Поле clientID тоже встречается в записях, но это не синоним номера сеанса — не смешивайте идентификаторы. Для исключения смотрите событие EXCP и его описание; для подключения перед ним может оказаться полезным CONN. Одна строка редко объясняет всю причину: читайте записи до и после неё, сохраняя исходный порядок. Если вопрос касается ошибки входа, пригодится и отдельный разбор неопознанного пользователя 1С.
В исходной версии статьи был предложен фильтр Error в форме «Технологический журнал» клиентского приложения. Это смешивает разные инструменты и обещает несуществующую универсальную колонку с готовым диагнозом. Файл ТЖ можно открыть текстовым редактором, если он небольшой; большой набор удобнее разбирать фильтрами и скриптами. В методических материалах 1С описаны фильтрация по SessionID и типу события и расчёт длительности для выбранных записей. Значение имеет не красивый интерфейс, а сохранённые условия отбора: время, тип события, номер сеанса и сервер, где шёл процесс.
- Зафиксируйте начало и конец симптома.
- Найдите номер сеанса по журналу регистрации.
- Отберите события по `SessionID` и имени события.
- Читайте соседние записи, а не только строку ошибки.
Как разбирать блокировки и долгие операции
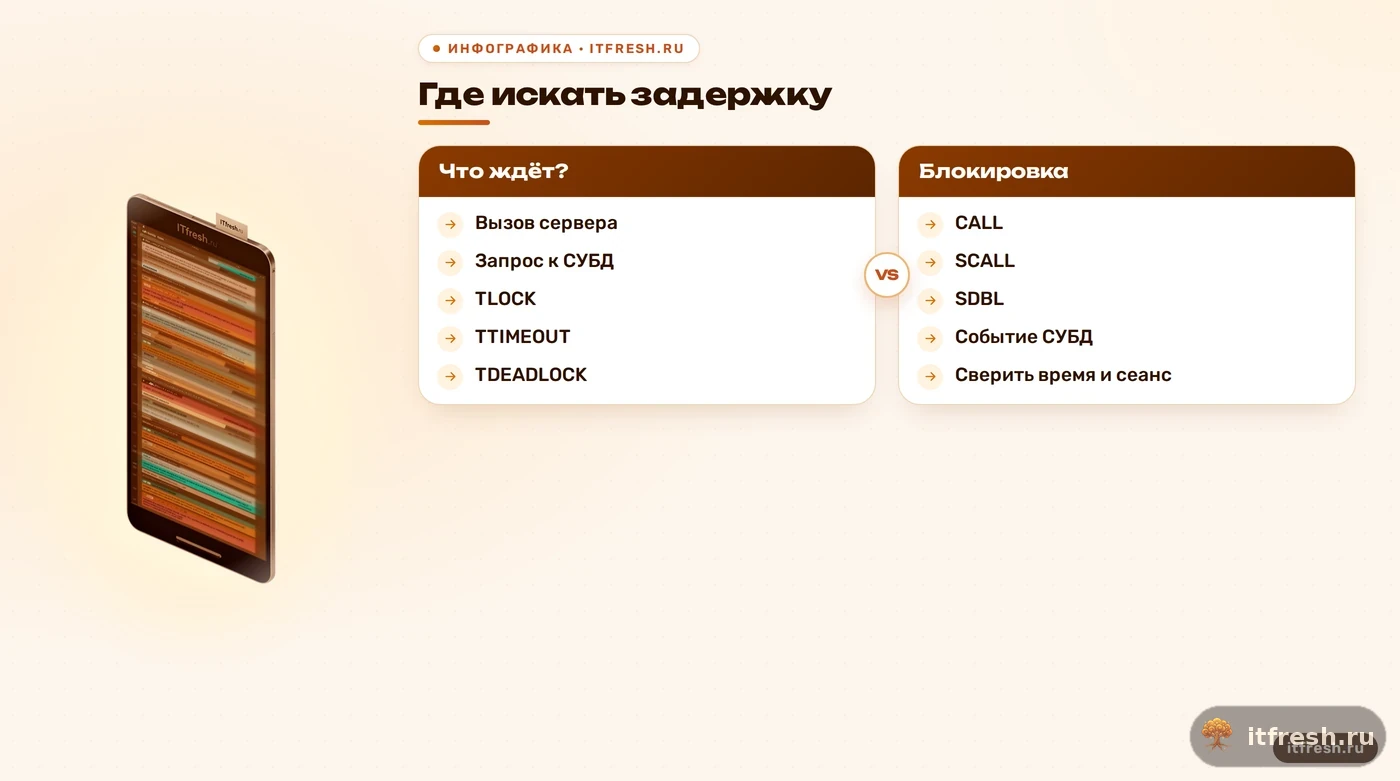
Для управляемых блокировок в технологическом журнале применяют события TLOCK, TTIMEOUT и TDEADLOCK. Первое помогает увидеть попытки и ожидания блокировки, второе связано с истечением времени ожидания, третье — с взаимоблокировкой. Собирать их нужно на тех рабочих серверах кластера, где обслуживается нужная база. Затем сопоставьте время, сеанс и соседние записи участников. Само наличие TLOCK ещё не доказывает, что именно блокировка объясняет жалобу: ищите ожидание, его продолжительность и совпадение с операцией пользователя. Официальные методики 1С отдельно предупреждают, что такие выборки могут быстро занимать диск.
Если зависает вызов, полезны CALL и SCALL; для анализа долгих запросов 1С описывает события SDBL и событие СУБД, например DBMSSQL для MS SQL. Для другой СУБД имя события будет другим — сверяйте его с документацией платформы и вашей конфигурацией. Сначала поймите, что именно долго: серверный вызов, запрос к базе или ожидание блокировки. Затем сравните длительности и контекст в том же сеансе. Иначе легко обвинить СУБД за медленный прикладной вызов или переписать код, хотя время ушло на внешнее ожидание.
В условном разборе для компании «Юнона Групп» я бы попросил сотрудника один раз повторить зависающую запись документа и зафиксировал точное время. Затем сопоставил бы сеанс в журнале регистрации с TLOCK и событиями вызова, а при признаках ожидания в СУБД — с SDBL/событием конкретной СУБД. На выходе должен быть проверяемый ответ: какой участок операции ждёт и какие записи это подтверждают. Формулировка «сервер тормозит» ответом не считается; цикл в коде или неисправность диска нельзя объявлять причиной, пока журнал и замеры этого не показали.
- Ожидание блокировки: `TLOCK` и соседние события.
- Истечение ожидания: проверьте `TTIMEOUT`.
- Взаимоблокировка: сопоставьте участников `TDEADLOCK`.
- Долгий вызов или запрос: `CALL`, `SCALL`, `SDBL`, событие СУБД.
Почему журнал пустой или внезапно разрастается
Если файлов нет, проверьте четыре вещи по порядку: тот ли logcfg.xml редактировали, тот ли каталог указан для записи, может ли учётная запись серверной службы туда писать и произошло ли событие из выбранного фильтра. Затем проверьте, перечитал ли конфигурацию нужный рабочий процесс. В кластере недостаточно смотреть на одну произвольную машину: собирать надо там, где обслуживалась база и выполнялась операция. Запустите воспроизведение ещё раз и отметьте время. Если нет записи, сначала исправляйте настройку сбора; запуск клиента с повышенными правами не меняет права службы на сервере.
Если файлы создаются, но не содержат ожидаемой строки, проверьте условия в <event>: исключающий фильтр или неверное имя события способны отсеять нужную запись. Сравните конфигурацию с официальным примером именно для вашей задачи, проверьте корректность XML и точное написание свойств. Не расширяйте фильтр до всех событий, пока не поняли, какая часть отбора ошибочна. Полезная контрольная проверка — включить только нужное событие, повторить один известный сценарий и убедиться, что запись появилась. Потом снова сузьте выборку, если для расследования не нужен такой объём.
Большой объём — ожидаемый риск подробного сбора, а не доказательство неисправности диска. Уровень детализации, число событий, количество процессов и срок хранения влияют на объём файлов. В настройках ТЖ можно задать срок хранения через history; в документации 1С указано, что записи старше заданного срока удаляются платформой. Это не повод полагаться на ротацию вслепую: следите за свободным местом и проверяйте результат на тестовом интервале. Не добавляйте в logcfg.xml неподтверждённые параметры ограничения размера и не отключайте защитное ПО наугад. Сначала подтвердите, что именно мешает созданию файла.
- Уточните узел, версию и фактический путь конфигурации.
- Проверьте владельца и права каталога логов.
- Сверьте фильтр событий и повторите известный сценарий.
- Контролируйте свободное место и срок хранения.
Как автоматизировать сбор и не утонуть в логах
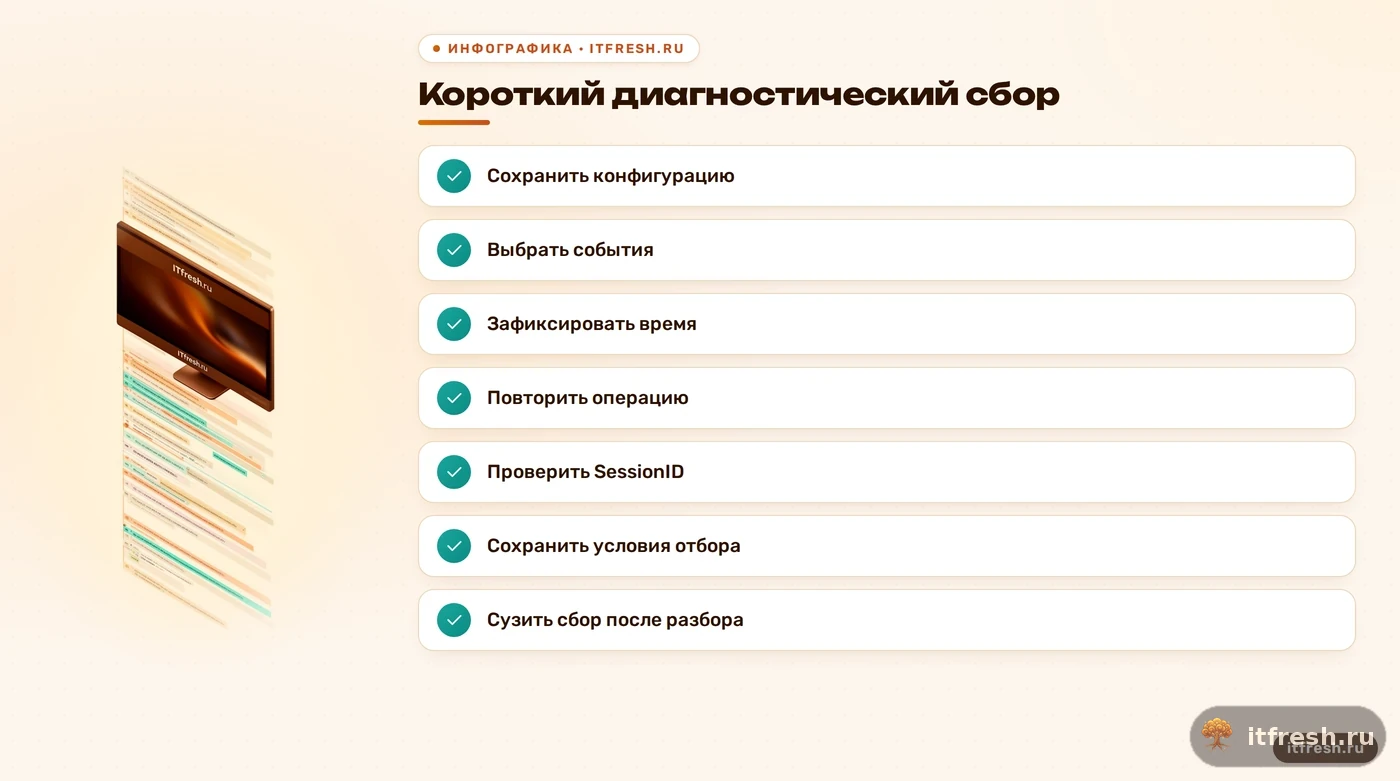
Автоматизация полезна, когда она сокращает повторяющуюся работу, а не просто собирает больше файлов. Для небольшого клиентского журнала достаточно текстового редактора; большой серверный набор разбирайте скриптом, фильтром или средствами ЦУП. В материалах 1С для анализа показан рабочий порядок: определить сеанс по журналу регистрации, отобрать нужный тип события, а затем подсчитать длительности вызовов или запросов. Это понятная задача для автоматизации: сохранить время, имя события, номер сеанса и длительность, чтобы не искать их руками при каждом повторе.
Я строю сценарий сбора вокруг конкретного симптома. Сначала сохраняю исходную конфигурацию, задаю ограниченный набор событий и короткое окно, затем прошу повторить операцию и проверяю, что нужные записи появились. После разбора сбор отключаю или возвращаю минимальный набор событий, а выборку храню в доступном специалистам месте с ограниченным доступом. Так журнал остаётся диагностическим инструментом, а не бесконечным архивом без владельца. Для постоянных показателей состояния сервера нужен отдельный мониторинг; мониторинг сервера 1С отвечает на другой вопрос, чем подробные записи технологического журнала.
Для условного кейса «Юнона Групп» автоматизация могла бы сохранить повтор операции, отобрать события по сеансу и собрать временную линию для разбора. Не обещаю «найти ошибку за секунды»: это зависит от полноты настроек, повторяемости симптома и того, какие процессы участвовали. Хороший сценарий выдаёт исходные записи и условия фильтра, а не только зелёный статус. Тогда администратор может перепроверить вывод, передать точную выборку разработчику и позже сравнить результат после исправления. Если причина изменилась, это тоже видно, а не теряется за усреднённым отчётом.
- Сохраните исходную конфигурацию перед изменением.
- Ограничьте сбор временем и типами событий.
- Сохраните условия фильтра вместе с выборкой.
- После расследования верните штатный объём сбора.
Частые вопросы
Какой файл включает технологический журнал 1С?
Настройки задаются в `logcfg.xml`: в нём указывают каталог, события и свойства для записи.
Нужно ли перезапускать службу после изменения `logcfg.xml`?
Не обязательно. Дайте серверным процессам перечитать конфигурацию и проверьте новые записи; методика 1С рекомендует выждать минуту. Если настройки не применились, проверьте путь и узел.
Как найти запись нужного пользователя?
Зафиксируйте время операции, найдите номер сеанса по журналу регистрации и отберите события ТЖ по `SessionID` и имени события.
Какие события смотреть при блокировке?
Для управляемых блокировок изучают `TLOCK`, `TTIMEOUT` и `TDEADLOCK`, сопоставляя их по времени и сеансу.
Почему технологический журнал занимает много места?
Подробный набор событий и длительный сбор увеличивают объём. Ограничьте события и срок, заданный в `history`, и следите за свободным местом.
Источники
- Методическая поддержка 1С: настройка технологического журнала — Файл `logcfg.xml`, выбор событий и свойств записи: https://its.1c.ru/db/content/metod8dev/src/developers/scalability/methods/i8105808.htm
- Методическая поддержка 1С: анализ производительности — Привязка к сеансу и анализ длительных вызовов и запросов по CALL, SCALL, SDBL и событию СУБД: https://its.1c.ru/db/content/metod8dev/src/developers/scalability/troubleshooting/i8105902.htm
- Методическая поддержка 1С: расследование блокировок — События TLOCK, TTIMEOUT, TDEADLOCK и срок хранения технологических журналов: https://its.1c.ru/db/content/metod8dev/src/developers/scalability/methods/i8105809.htm
- Методическая поддержка 1С: диагностика зависания процессов — Для поиска зависаний описан сбор CALL и SCALL без ограничений по длительности: https://its.1c.ru/db/content/metod8dev/src/developers/scalability/instructions/i8105943.htm
- Методическая поддержка 1С: журналирование и анализ — Пример расположения `logcfg.xml`, прав на каталог и передачи записей в систему поиска: https://its.1c.ru/db/content/metod8dev/src/developers/scalability/instructions/i8106019.htm