
Переезд десятков баз на SQL Server 2025: почему сервер тупит без аварии и при чём тут вторичные реплики
Да, причиной может быть функция persisted statistics для вторичных реплик: в SQL Server 2025 она включена по умолчанию и создаёт фоновый поток на каждую базу, которая переходит в online, даже без Always On. Ниже — как распознать это до аварии, почему флаг 15608 ставят до переезда и как переносить десятки баз партиями без потери отзывчивости.
Почему после переезда на SQL Server 2025 сервер тормозит, хотя реплик нет
Ситуация знакомая каждому, кто в 2026 году переезжал на новую версию. Сервер один, Always On нет и не планировалось, а после восстановления или подключения десятков баз он начинает отвечать с задержкой: SSMS думает по полминуты, подключения вылетают по таймауту, а диски и процессор при этом скучают. Мы в АйТи-Фреш обслуживаем SQL Server и 1С у компаний до 50 рабочих мест, и на SQL Server 2025 этот сценарий я уже видел не один раз. Первая мысль у всех одна: «дело в железе». Вторая: «Microsoft опять что-то сломал». Правда, как обычно, посередине.
Документация Microsoft по известным проблемам SQL Server 2025 описывает это прямо. Фича Persisted statistics for readable secondary replicas включена по умолчанию, и для неё на каждую базу создаётся фоновый рабочий поток. Он появляется в момент, когда база переходит в online, и может создать давление на рабочие потоки и снизить отзывчивость экземпляра. Ключевая фраза в документации: даже тогда, когда вторичные реплики не настроены. То есть название функции вводит в заблуждение: к Always On она привязана в описании, но не в поведении.
Почему она вообще включена, если реплик нет? Страница про саму функцию объясняет условия: она включена по умолчанию, пока у базы включена опция auto create statistics, а параметры уровня базы (database scoped configuration) READABLE_SECONDARY_TEMPORARY_STATS_AUTO_CREATE и READABLE_SECONDARY_TEMPORARY_STATS_AUTO_UPDATE включены, а включены они по умолчанию. Отдельного параметра уровня базы, который включал бы и выключал саму функцию, нет: об этом документация говорит прямо. Помогает ли выключение этих двух параметров против фоновых потоков, Microsoft не пишет, поэтому я на это не полагаюсь: документированный обходной путь один — стартовый флаг трассировки 15608, о нём ниже. Так что искать галочку в SSMS бесполезно, и вечер лучше потратить на что-нибудь приятнее.
Здесь легко перегнуть в другую сторону и записать на эту функцию всё подряд. Не надо. Документация Microsoft по max worker threads предупреждает: если вы подозреваете проблему с производительностью, то скорее всего дело не в доступности рабочих потоков, а в том, что их занимают и не отдают долгие запросы, блокировки, ожидания ввода-вывода. Поэтому порядок такой: сначала измерить, потом лечить. Диагноз «виновата функция реплик» ставится по цифрам, а не по настроению и не потому, что про это написали в блоге.
Тормоз или зависание: как выглядит потеря отзывчивости на практике
Начну с того, что в типичной жалобе «SQL Server зависает» слово «зависает» я бы заменил на «теряет отзывчивость». Это разные вещи, и разница важна для диагностики. При полном исчерпании рабочих потоков новые запросы встают в очередь и не получают воркера вообще: вы подключаетесь, а ответа нет. Но до этой стадии есть длинный период, когда потоков ещё хватает для простых запросов, а тяжёлые, параллельные и служебные уже начинают ждать. Пользователь видит только «что-то стало медленнее после переезда», и именно на этой стадии чаще всего ищут не там: в сети, в антивирусе, в дисках, в «кривых руках» того, кто переносил базы.
Типичная картина, по моим наблюдениям, выглядит так. Базы переводят в online партиями или одним скриптом на несколько десятков штук. Первые тридцать-сорок проходят без проблем, потом Object Explorer в SSMS начинает раскрываться по десять-двадцать секунд, свежие подключения иногда обрываются по таймауту, а на сервере при этом процессор загружен единицами процентов. Дальше либо всё само доползает до конца, либо инстанс встаёт, и помогает только перезапуск службы, после которого, кстати, история повторяется, потому что базы снова переходят в online при старте. Если у вас «после каждого перезапуска всё то же самое», это сильный признак.
Чтобы не гадать, я держу в голове короткую таблицу признаков. Она не заменяет замеры, но не даёт полезть лечить не то. | Что видите | Куда смотреть в первую очередь | |---|---| | Тормозит после массового online, CPU и диск простаивают | занятые рабочие потоки, функция реплик | | Тормозит под нагрузкой пользователей, CPU около 100 % | тяжёлые запросы, планы, индексы | | Одни запросы ждут другие, растёт blocking_session_id | блокировки, длинные транзакции | | Высокие задержки чтения и записи в счётчиках дисков | СХД, виртуализация, кэш | Обратите внимание на первую строку: простаивающие процессор и диск вместе с долгим откликом — классический маркер того, что ждут не ресурсы железа, а воркеры.
Отдельно скажу про самую частую отговорку: «у нас всего 20 пользователей, какие тут потоки». Потоки считаются не по пользователям. Базы, фоновые задачи, задания агента, сессии 1С, мониторинг и опросы по расписанию забирают воркеров вне зависимости от того, сколько людей сидит в зале ожидания. Для сервера с четырьмя логическими процессорами автоматический лимит по таблице из документации составляет 512 рабочих потоков (для восьми — 576). Звучит много, пока вы не переносите сотню баз, на каждую из которых приходится собственный фоновый поток.
Как доказать причину тремя замерами через DAC
Когда сервер отвечает через раз, обычное подключение для диагностики плохой помощник: оно само встаёт в очередь за воркером. Поэтому заходите через выделенное административное подключение (DAC). По документации оно доступно только членам роли sysadmin, по умолчанию принимает только локальные подключения (удалённые включаются опцией remote admin connections), и на экземпляр разрешено ровно одно такое подключение. Командная строка с префиксом admin: перед именем экземпляра, а база master указывается явно, чтобы не упереться в недоступную базу по умолчанию:
sqlcmd -S admin:SQL01 -E -d masterВ SSMS то же самое делается через admin:имя_сервера в окне подключения, но предварительно отключите IntelliSense в этом экземпляре SSMS: иначе он попытается открыть вторую связь на каждое окно запроса и получит отказ, потому что DAC один. Ещё момент, о котором все забывают: на DAC не стоит гонять тяжёлые запросы, ему гарантирован только скромный набор ресурсов.
Замер первый: сколько воркеров доступно и сколько занято. Лимит берём из sys.dm_os_sys_info, там колонка max_workers_count показывает максимальное число воркеров, которое может быть создано. Занятость и очередь берём из sys.dm_os_schedulers: active_workers_count считает активных воркеров, то есть имеющих задачу, а work_queue_count показывает задачи, которые ждут, пока их подхватит воркер. Условие scheduler_id < 255 отсекает скрытые планировщики, в том числе планировщик DAC. Для SQL Server 2022 и новее нужно разрешение VIEW SERVER PERFORMANCE STATE, но под DAC вы всё равно sysadmin.
SELECT max_workers_count, cpu_count FROM sys.dm_os_sys_info;

SELECT SUM(active_workers_count) AS active_workers,
       SUM(current_workers_count) AS current_workers,
       SUM(work_queue_count)      AS queued_tasks
FROM sys.dm_os_schedulers
WHERE scheduler_id < 255;
Если active_workers стоит рядом с max_workers_count, а queued_tasks больше нуля, перед вами нехватка потоков. Если же занято две трети лимита при нулевой пользовательской нагрузке, это ещё не авария, но уже диагноз «потоков слишком мало для следующего пика».
Замер второй: на чём именно ждут задачи. Группируем sys.dm_os_waiting_tasks по типу ожидания. Если в верхних строчках стоит THREADPOOL, задачи ждут воркера, и колонка resource_description у них будет начинаться с threadpool id=scheduler, как сказано в документации по этому представлению. Если же сверху блокировки (LCK_M_*) или ожидания ввода-вывода, у вас другая история, и флаг 15608 вас не спасёт.
SELECT wait_type,
       COUNT(*)              AS tasks,
       MAX(wait_duration_ms) AS max_wait_ms
FROM sys.dm_os_waiting_tasks
GROUP BY wait_type
ORDER BY tasks DESC;
Учтите, что это моментальный снимок: ожидания меняются каждую секунду, поэтому снимайте его трижды с интервалом в несколько секунд и сравнивайте. Один удачный замер без THREADPOOL ничего не доказывает, как и один неудачный.
Замер третий: что произошло с базами. Состояние баз покажет sys.databases, а временную связь между переводом в online и началом тормозов нужно искать не в уме, а в журнале: время запуска переноса, время первых жалоб, время старта службы. Простой запрос показывает, сколько баз сейчас в каком состоянии:
SELECT state_desc, COUNT(*) AS dbs
FROM sys.databases
GROUP BY state_desc;
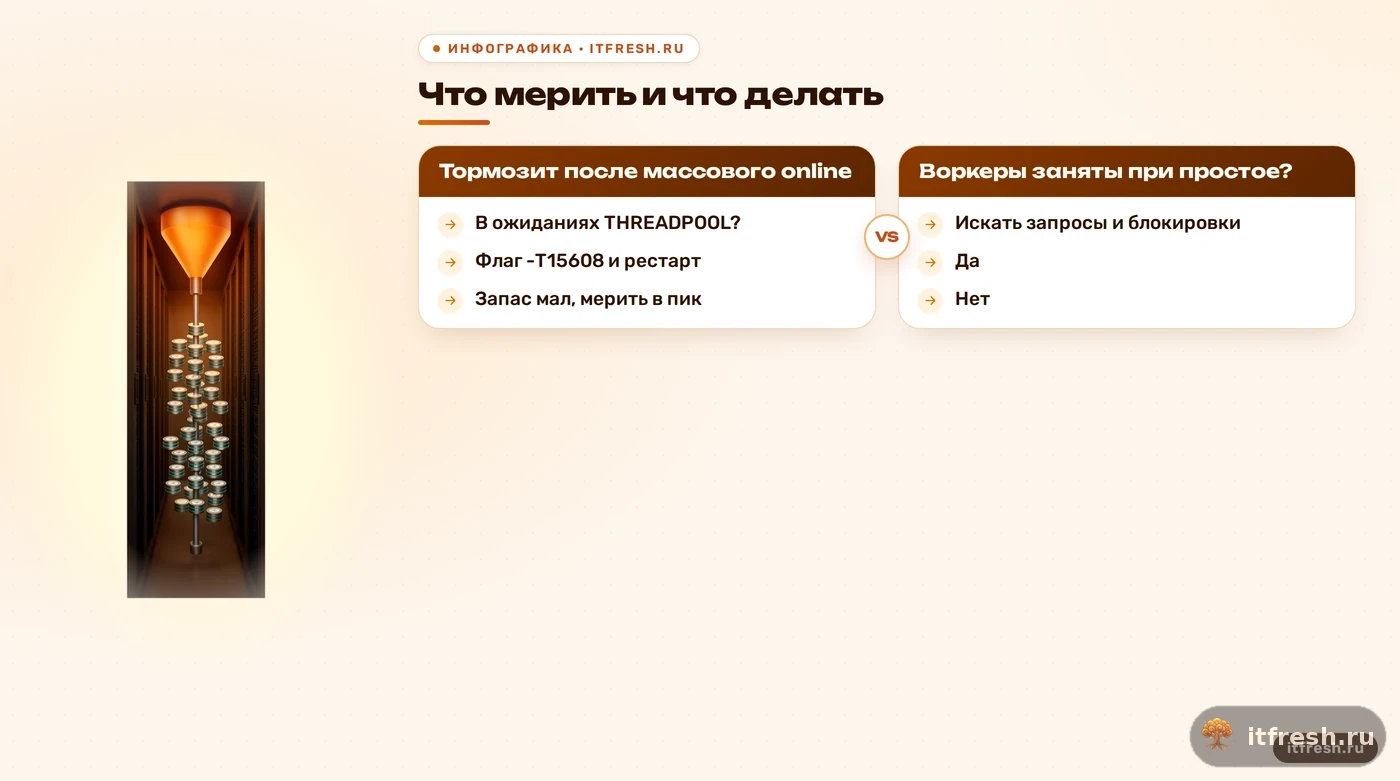
Складываем три картины. Много баз в ONLINE, воркеры заняты при простое, в ожиданиях THREADPOOL, а пользовательских запросов, которые могли бы столько держать, нет: это сильные косвенные улики в пользу фоновых потоков по одному на базу. Подчеркну слово «косвенные». Прямого счётчика «потоки функции persisted statistics» Microsoft не публикует, поэтому окончательное подтверждение даёт эксперимент: запуск с флагом 15608 и повторный замер. Если занятость воркеров при простое упала примерно на число баз, диагноз подтверждён.
Если вы уже всё поняли и не хотите возиться с ночными замерами сами, скажу прямо: это задача на один рабочий день. Мы подключаемся, снимаем эти три замера, решаем, флаг ли это или что-то другое, и готовим безопасное окно для перезапуска. Разбор того, как отличить данный случай от банальных длинных запросов, у меня описан в статье как доказать исчерпание workers, а здесь важнее другое: что делать, когда причина подтверждена.
Флаг трассировки 15608: как включить, проверить и не ошибиться
Единственное документированное временное решение — стартовый флаг трассировки 15608. В справочнике по флагам он описан так: отключает функцию Persisted statistics for readable secondary replicas, действует для SQL Server 2025 и новее, область действия Startup only. Для полного отключения там же сказано применять его на первичной реплике и на всех вторичных. Если у вас одиночный сервер, эта оговорка вас не касается, но если когда-нибудь появится группа доступности, запомните её. В известных проблемах Microsoft отдельно подчёркивает: включать надо при запуске и перезапускать SQL Server, а включение уже на работающем экземпляре не остановит потоки, которые уже созданы для баз, переведённых в online.
Из этого следует главный вывод, на котором ломаются чаще всего. Команда DBCC TRACEON (15608, -1) на живом сервере выглядит как лечение, и многим кажется, что всё сделано. Но по документации включение после запуска уже созданные потоки не остановит, а у самого флага область действия только запуск. Поэтому ставим флаг только как параметр запуска.
На Windows это делается в SQL Server Configuration Manager: Службы SQL Server, свойства службы экземпляра, вкладка «Параметры запуска» (Startup Parameters), добавить новый параметр и перезапустить службу. Сам параметр пишется так, заглавная T и номер без пробела:
-T15608Документация по параметрам запуска отдельно предупреждает: строчная t принимается сервером, но включает другие внутренние флаги, нужные только инженерам поддержки Microsoft. Опечатка в одну букву превращает лечение в эксперимент над продом, поэтому после правки глазами сверяйте параметр и в конфигурации, и после рестарта.
На Linux есть штатный путь через mssql-conf. Команда сохраняет флаг в настройках запуска, службу нужно перезапустить:
sudo /opt/mssql/bin/mssql-conf traceflag 15608 on
sudo systemctl restart mssql-server
Отключить обратно можно той же командой с параметром off, это тоже описано в документации по mssql-conf. Проверка результата одинакова на обеих платформах:
DBCC TRACESTATUS (15608, -1);В выводе нужна строка с флагом 15608, где Status равен 1 и Global равен 1. Если строки нет, флаг не подхватился, и все дальнейшие выводы бессмысленны.
Теперь о том, чего я не знаю, и вам не советую делать вид, что знаете. Документация перечисляет сообщения ERRORLOG, связанные с этой функцией, среди них 9131 с пометкой «функция отключена при запуске SQL». Однако прямой связи этого сообщения с флагом 15608 страница не утверждает, поэтому искать его в журнале после перезапуска можно, но как обязательный признак успеха я его не использую: мерой успеха для меня остаётся падение занятых воркеров при простое. Ещё одна оговорка: на 19 октября 2026 года статья известных проблем SQL Server 2025 называет исправление делом будущего выпуска. Поэтому после каждого накопительного обновления открывайте заметки к нему и страницу известных проблем: когда исправление появится, флаг надо будет снять, а не тащить по инерции годами. Временные костыли имеют обыкновение становиться постоянными, потому что про них забывают.
Как переносить десятки баз и не потерять отзывчивость: мой порядок
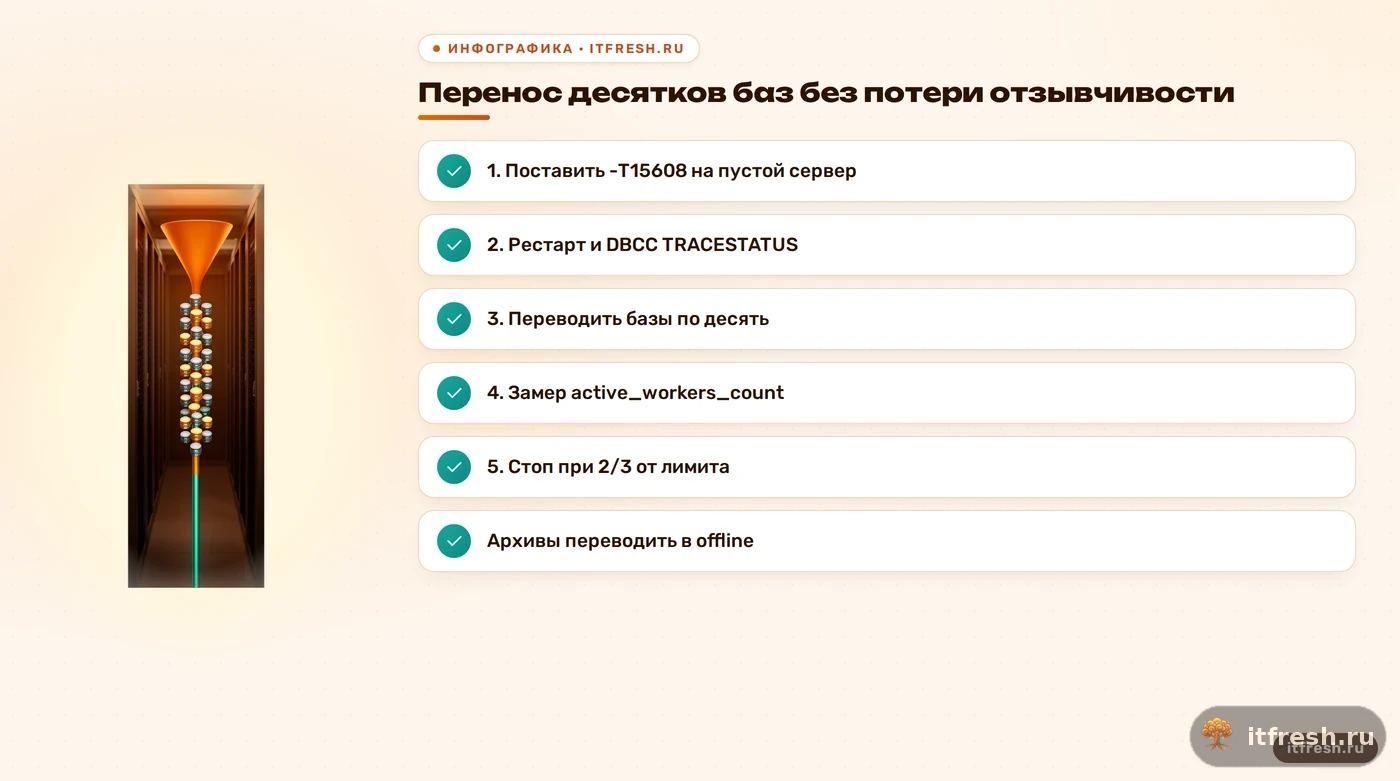
Теперь о главном для тех, кто только собирается переезжать. Правило, которое я привёл в порядок после нескольких неприятных выходных: флаг ставится до переноса, а не после того, как сервер начал тупить. Если вы знаете, что на экземпляре будет больше пары десятков баз, добавьте -T15608 сразу после установки, перезапустите службу один раз на пустом сервере, проверьте DBCC TRACESTATUS и только потом начинайте восстановление. Перезапуск пустого сервера стоит нуля рублей и двух минут. Перезапуск сервера с двумя сотнями баз посреди ночи стоит сна и нервов.
Дальше партии. Сразу честно: деление на партии само по себе не уменьшает итоговое число потоков, оно лишь даёт возможность остановиться и измерить, пока запас не кончился. Переводить базы в online можно из PowerShell через sqlcmd. Следующий скрипт берёт список баз из файла, переводит их по десять штук, после каждой партии печатает суммарную занятость воркеров и делает минутную паузу. Это мой рабочий шаблон, пороги в нём подбирайте под свой сервер:
$dbs = Get-Content .\dbs_to_online.txt
$batch = 10
for ($i = 0; $i -lt $dbs.Count; $i += $batch) {
    $last = [Math]::Min($i + $batch, $dbs.Count) - 1
    $dbs[$i..$last] | ForEach-Object {
        sqlcmd -S SQL01 -E -b -Q ('ALTER DATABASE [' + $_ + '] SET ONLINE')
    }
    $busy = sqlcmd -S SQL01 -E -h -1 -W -Q 'SET NOCOUNT ON; SELECT SUM(active_workers_count) FROM sys.dm_os_schedulers WHERE scheduler_id < 255'
    Write-Host ('Обработано ' + ($last + 1) + ' баз, занято воркеров: ' + $busy)
    Start-Sleep -Seconds 60
}
Синтаксис ALTER DATABASE ... SET ONLINE взят из документации; для перевода базы из offline в online нужно серверное разрешение ALTER ANY DATABASE. Важная оговорка: скрипт работает с базами в состоянии OFFLINE. База в состоянии RESTORING через SET ONLINE не переводится, она выходит в online сама по завершении RESTORE ... WITH RECOVERY, поэтому при переезде через бэкапы партиями делите сами восстановления, а замер воркеров ставьте между ними. Если база держится блокировкой, в команде можно использовать окончание WITH ROLLBACK IMMEDIATE, но применять его на чужой рабочей базе без согласования я не стал бы.
Пороги я ставлю такие, и это именно мои правила, а не цифры из документации: если занятых воркеров больше двух третей от max_workers_count, партии прекращаются, и я разбираюсь, что их держит. Если очередь work_queue_count показывает ненулевое значение дольше нескольких минут, останавливаюсь тем более. И никакой параллельной «заодно» проверки целостности всех баз в тот же вечер: полезная привычка, но не в окно, когда вы выясняете, хватит ли серверу потоков. Не смешивайте два эксперимента в одном окне.
И последнее, о чём спрашивают чаще всего: а нельзя ли просто поднять max worker threads? Можно, документация показывает синтаксис через sp_configure, и изменение вступает в силу сразу после RECONFIGURE, без перезапуска. Как аварийная мера, чтобы оживить зависший экземпляр, вполне годится. Но Microsoft называет это параметром для опытного специалиста, а потоки, которые вы добавили, тоже стоят памяти. Выглядит это как «починили» ровно до следующей сотни баз. Постоянное решение — флаг плюс уборка: не держите онлайн архивы, тестовые копии трёхлетней давности и базы «на всякий случай», которые никто не открывал со времён прошлого директора. Я не требую их удалять, я прошу перевести в offline: так они не расходуют воркеров.
Разбор: «Атлет-клуб», 168 баз и 340 занятых потоков при нуле пользователей
Условный клиент для этого разбора — фитнес-центр «Атлет-клуб», 20 рабочих мест в трёх клубах. Один физический сервер под виртуализацией: Windows Server 2022, SQL Server 2025, 4 виртуальных процессора, 32 ГБ памяти, max worker threads оставлен в значении 0, то есть по таблице документации для четырёх логических процессоров лимит равен 512 воркерам. Always On, зеркалирования и реплик нет. Задача была типичной: перенести на новый сервер сто шестьдесят восемь баз со старого, где стоял SQL Server 2019, через бэкапы и восстановление. Рабочие базы учёта и абонементов, ежегодные архивы, тестовые копии и «временные» базы, которые живут дольше самого старого сервера.
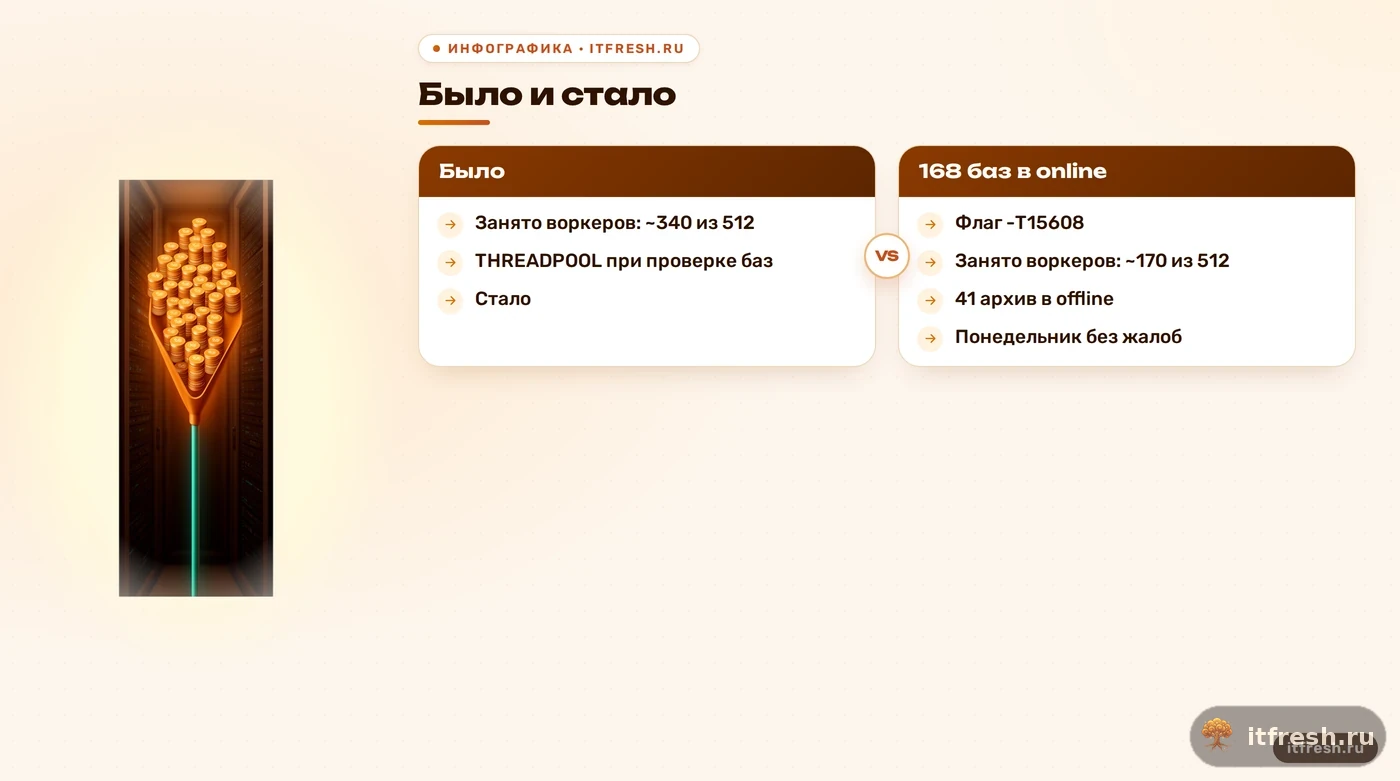
Перенос запускали в субботу вечером, скриптом, без партий. К сотой базе SSMS на самом сервере стал раскрывать дерево по полминуты, а у ночного администратора ресепшена периодически отваливалась проверка подключения. Диски и процессор спали, и первым подозреваемым назначили сеть. Это стандартная ошибка: сначала обвиняют то, что проще всего перепроверить, а не то, что надо. Утром в воскресенье я подключился через DAC и снял три замера. По sys.dm_os_sys_info лимит равнялся 512, по sys.dm_os_schedulers занято было около 340 воркеров при нулевой пользовательской нагрузке, очередь work_queue_count держалась около нуля, а в ожиданиях лидировали служебные задачи без блокировок.
Сам по себе THREADPOOL в этот момент в ожиданиях не стоял, и это важный урок: по цифрам аварии не было, был запас в сто семьдесят потоков. Но в понедельник к стойке регистрации, турникетам и кассе подключаются несколько десятков сессий, а утром ещё и отчёты. Я намеренно проверил этот сценарий в тестовом окне: запустил проверку целостности нескольких баз параллельно, и в ожиданиях появился THREADPOOL. Запас, который выглядел достаточным, исчез за минуты. Диагноз по трём замерам: десятки лишних воркеров, которых нет в списке пользовательских задач, их число близко к числу баз.
Решение заняло рабочий день. Во-первых, добавили параметр -T15608 в конфигурации службы, проверили написание заглавной T, перезапустили службу в согласованное окно (простой около пяти минут в воскресенье днём) и подтвердили флаг через DBCC TRACESTATUS (15608, -1). Во-вторых, повторили замер: занятых воркеров при простое стало около 170 вместо 340, то есть разница примерно равна числу баз. В-третьих, 41 архивную базу и старые тестовые копии перевели в offline по согласованию с владельцем, остальное оставили в online. Для следующих переездов (сеть открывает четвёртый клуб) договорились о партиях по десять баз с паузой и замером. Результат: понедельник прошёл без жалоб, THREADPOOL в ожиданиях не появлялся, а страница известных проблем и заметки к обновлениям вошли в ежемесячный чек-лист, чтобы флаг был снят, когда выйдет исправление.
Что я здесь НЕ утверждаю. Я не говорю, что каждый поток из 340 принадлежит функции реплик: часть воркеров всегда занимают сессии, агент, мониторинг и внутренние задачи. Мой вывод основан на разнице до и после флага, а не на красивой формуле. Если ваша разница будет другой, значит, у вас на сервере есть и другие потребители, и это повод искать дальше, а не повторять мои цифры. Близкий разбор с другой стороны, с арифметикой потоков и таблицей лимитов, есть в статье про THREADPOOL и флаг 15608, и там же вы найдёте другие номера лимитов.
Частые вопросы
Можно ли отключить persisted statistics для вторичных реплик штатной настройкой базы?
Нет. Документация прямо говорит, что отдельного параметра уровня базы для включения и выключения этой функции нет. Документированный обходной путь для проблемы с потоками — стартовый флаг трассировки 15608 с перезапуском SQL Server.
Поможет ли DBCC TRACEON (15608, -1) на работающем сервере?
Нет. Флаг имеет область действия Startup only, а включение после запуска, по словам Microsoft, не останавливает фоновые потоки, уже созданные для баз, которые вернулись в online. Добавляйте -T15608 в параметры запуска и перезапускайте службу.
Нужен ли флаг, если Always On и реплик у меня нет?
Нужен, если вы упёрлись в нехватку потоков. Microsoft указывает, что фоновый поток на базу создаётся даже без вторичных реплик, и флаг остаётся временной мерой и в этом случае.
Как написать флаг в параметрах запуска, чтобы не ошибиться?
Заглавная T и номер без пробела: -T15608. Строчная t сервер принимает, но она включает другие внутренние флаги для инженеров поддержки Microsoft, поэтому проверяйте написание и итог через DBCC TRACESTATUS (15608, -1).
Стоит ли просто увеличить max worker threads?
Как аварийная мера можно: изменение действует после RECONFIGURE без перезапуска. Но по документации это параметр для опытного администратора, и сначала нужно найти причину. Постоянным решением увеличение лимита не является.
Когда снимать флаг 15608?
Когда выйдет накопительное обновление с исправлением. На 19.10.2026 страница известных проблем SQL Server 2025 называет исправление делом будущего выпуска, поэтому проверяйте заметки к каждому CU и тестируйте поведение перед снятием флага.
Источники
- Microsoft Learn: SQL Server 2025 Known Issues — Раздел про замедление и потерю отзывчивости при создании или переводе в online большого числа баз: причина (фоновый поток на базу), обходной путь с флагом 15608 при запуске. https://learn.microsoft.com/en-us/sql/sql-server/sql-server-2025-known-issues?view=sql-server-ver17
- Microsoft Learn: Persisted Statistics for Readable Secondary Replicas — Условия включения по умолчанию, отсутствие отдельной настройки для отключения, расширенные события и сообщения ERRORLOG. https://learn.microsoft.com/en-us/sql/relational-databases/performance/persisted-stats-secondary-replicas?view=sql-server-ver17
- Microsoft Learn: DBCC TRACEON - Trace Flags — Описание флага 15608: отключает функцию, область действия Startup only, применять на первичной и вторичных репликах. https://learn.microsoft.com/en-us/sql/t-sql/database-console-commands/dbcc-traceon-trace-flags-transact-sql?view=sql-server-ver17
- Microsoft Learn: Database Engine Service Startup Options — Параметр -T, заглавная T без пробела, предупреждение про строчную t, настройка через SQL Server Configuration Manager. https://learn.microsoft.com/en-us/sql/database-engine/configure-windows/database-engine-service-startup-options?view=sql-server-ver17
- Microsoft Learn: max worker threads — Значение 0 по умолчанию, таблица автоматических лимитов, рекомендации, пример sp_configure. https://learn.microsoft.com/en-us/sql/database-engine/configure-windows/configure-the-max-worker-threads-server-configuration-option?view=sql-server-ver17
- Microsoft Learn: Diagnostic Connection for Database Administrators — Подключение DAC через sqlcmd -A и admin:, ограничения, один DAC на экземпляр. https://learn.microsoft.com/en-us/sql/database-engine/configure-windows/diagnostic-connection-for-database-administrators?view=sql-server-ver17