
SOGo пишет No child available, когда сотрудники подключают телефоны через ActiveSync: в чём причина
Если веб-почта SOGo в mailcow виснет после того, как сотрудники подключили почту на телефонах через ActiveSync, а в логах — «No child available» от WOWatchDog, дело не в CPU, а в том, что все workers SOGo заняты push-соединениями EAS. Разбираю, как считать WOWorkersCount по числу устройств, а не пользователей.
Симптом: веб-почта виснет именно после подключения телефонов
Садовый центр «СадГавань» — 36 рабочих мест, почта на mailcow, которую мы ведём на аутсорсе корпоративной почты с прошлой весны. Летом директор попросил подключить корпоративную почту менеджерам на личные телефоны через встроенный почтовый клиент — самый удобный способ для них — это ActiveSync (EAS), который в mailcow обслуживает SOGo. Подключили 14 телефонов за неделю — плюс ещё шесть руководителей к тому моменту уже работали в Outlook на ноутбуках через тот же ActiveSync, — и почти сразу веб-почта в браузере на компьютерах начала регулярно зависать на несколько минут, особенно в середине рабочего дня.
В логах docker compose logs sogo-mailcow --tail 100 — повторяющаяся строка от вотчдога процессов: [ERROR] <0x...[WOWatchDog]> No child available to handle incoming request!, а между ними — длинные запросы POST /SOGo/Microsoft-Server-ActiveSync?...&Cmd=Ping и Cmd=Sync от телефонов. При этом docker stats не показывал перегрузки CPU или памяти — контейнер SOGo просто не мог обслужить новый входящий запрос, потому что все worker-процессы были заняты долгими EAS-запросами.
Первым делом заподозрили саму миграцию почты — незадолго до этого мы переносили ящики «СадГавани» на mailcow с их прежнего сервиса через миграцию на mailcow без потери писем, и таймлайн совпадал почти день в день. Но при более внимательном сравнении логов оказалось, что имапсинк тут ни при чём: зависания начались не в момент миграции, а через два дня после неё — ровно тогда, когда менеджеры массово подключили почту на телефонах.
Что такое WOWorkersCount и почему это не про производительность CPU
WOWorkersCount — это не про многопоточность в привычном смысле, а буквально количество независимых процессов-экземпляров SOGo, которые параллельно принимают HTTP-запросы: веб-интерфейс, CalDAV/CardDAV, и ActiveSync. Согласно официальному руководству по установке SOGo, значение 3 — разумный дефолт для низкой нагрузки, а верхнюю границу диктуют CPU и I/O конкретной машины: завышенное значение само по себе снижает производительность под нагрузкой, а не наоборот.
Ключевая деталь именно для ActiveSync: устройство с включённым push держит HTTP-соединение открытым в командах Ping и Sync, и всё это время один worker занят им — не секунды обработки запроса, а до часа, если интервалы выставлены под настоящий push. Руководство SOGo прямо пишет, что по умолчанию SOGo не даёт EAS-клиентам долго держать соединения — именно чтобы телефоны не монополизировали все child-процессы и не оставили без ответа веб-интерфейс и DAV. Как только интервалы увеличивают ради мгновенных уведомлений, каждое такое устройство фактически закрепляет за собой worker, и свободных для браузера и CalDAV остаётся всё меньше.
Похожая логика встречается за пределами SOGo — в статье про банк-клиент в телефоне бухгалтера я разбирал другую сторону той же тенденции: как только корпоративные сервисы переезжают на личные телефоны сотрудников, у администратора появляется новый класс нагрузки и новый класс рисков, которые редко закладывают в план ещё на этапе «давайте просто подключим почту на телефон» — там про безопасность, здесь про ёмкость сервера, но исходная причина одна: мобильные клиенты ведут себя не так, как десктопные.
Сколько workers реально нужно — формула не по пользователям, а по устройствам
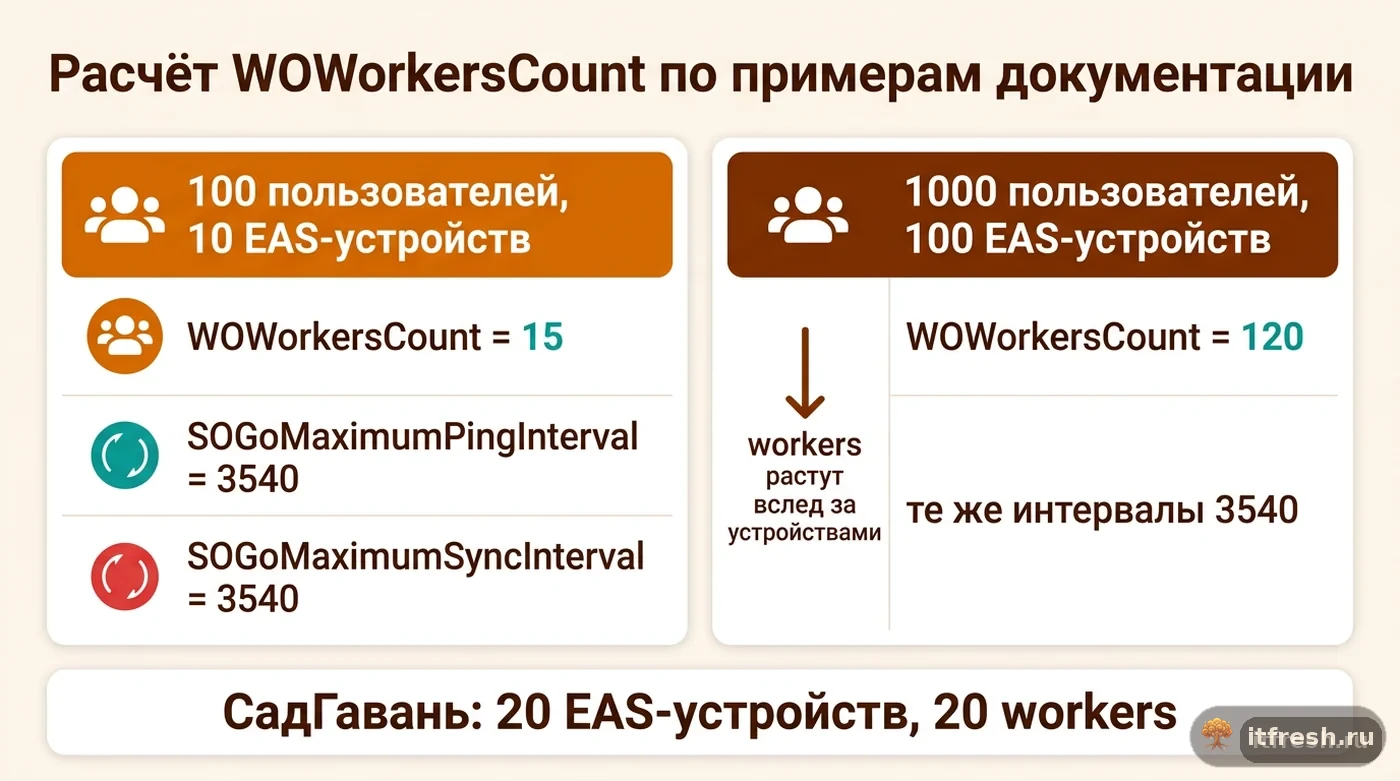
Официальное руководство SOGo формулирует правило прямо: на каждое EAS-устройство с push нужен минимум один child-процесс, и children должно быть больше, чем таких устройств, — чтобы оставалось чем обслуживать веб-интерфейс и DAV. Примеры из документации (во всех таймаут Apache — 3600 секунд, WOWatchDogRequestTimeout = 60 минут): для 100 пользователей и 10 EAS-устройств — WOWorkersCount = 15, SOGoMaximumPingInterval = 3540, SOGoMaximumSyncInterval = 3540, SOGoInternalSyncInterval = 30; для 1000 пользователей и 100 устройств — WOWorkersCount = 120 при тех же интервалах и SOGoInternalSyncInterval = 60. Это примеры конфигурации, а не норматив производительности, но пропорция показательна: workers растут вслед за числом push-устройств почти один к одному, с запасом 20–50 %.
У «СадГавани» 36 сотрудников, но считать нужно не их, а устройства: 14 телефонов плюс 6 Outlook-клиентов на ActiveSync — 20 постоянных EAS-подключений. Дефолт самого SOGo без явной настройки — один worker, но в mailcow в data/conf/sogo/sogo.conf из коробки стоит WOWorkersCount = "20"; и уже выставлены длинные интервалы: SOGoMaximumPingInterval = 3540, SOGoMaximumSyncInterval = 3540. Арифметика простая: 20 workers на 20 push-устройств — ноль свободных для браузера и CalDAV в тот момент, когда все устройства держат соединения. Пока телефонов было шесть, запас был; после волны подключений он кончился.
Отдельно уточню: документация SOGo не даёт единой формулы вида «workers = устройства × коэффициент» — это именно опорные точки для калибровки, а не таблица подстановки. Я использую эти два примера как верхнюю и нижнюю границу и интерполирую между ними по числу реальных EAS-устройств с push, добавляя отдельный запас под сами веб-сессии в браузере и синхронизацию календарей через CalDAV, которые тоже расходуют workers, просто на порядок короче по времени.
Похожие случаи в трекерах: не только мы наступили на эти грабли
В обсуждении на форуме сообщества mailcow алерт Watchdog ALERT: sogo-mailcow тоже связывают с нехваткой workers под нагрузкой. Показательнее issue #5655 репозитория mailcow-dockerized («EAS starves SOGo threads after a while», январь 2024): у автора три личных ящика, один iPhone и дефолтные 20 workers, а через 12–24 часа EAS-запросы съедали все процессы, лог заполнялся тем же No child available, и помогал только перезапуск контейнера — до следующего раза. Мейнтейнер ответил стандартно: не хватает workers, увеличьте WOWorkersCount в data/conf/sogo/sogo.conf. А автор закрыл тикет после того, как перезагрузил сам iPhone — запросов к серверу стало заметно меньше. Вывод: иногда worker-ы съедает не парк устройств, а одно устройство, которое засыпает сервер Ping/Sync, и это видно по DeviceId в логе.
В более старом issue #2266 с той же ошибкой — 280 почтовых ящиков и WOWorkersCount = "50", SOGoMaximumPingInterval = 3540, SOGoInternalSyncInterval = 45, SOGoMaximumSyncInterval = 60. Ответ разработчика: число workers надо увеличивать, начать со 100 и смотреть логи, всё зависит от интенсивности EAS. Там же он оценил цену: 100–120 EAS-workers требуют порядка 16–20 ГБ RAM, и на сервере с 4 ГБ и двумя CPU при 100 workers нагрузка ушла под 100. Главный вывод: единого «правильного» числа нет, WOWorkersCount пересчитывается при каждом заметном росте парка мобильных клиентов, и вместе с ним — память сервера.
Как менять WOWorkersCount конкретно в mailcow
В mailcow параметры SOGo лежат в файле data/conf/sogo/sogo.conf внутри установки — это не переменная в mailcow.conf, а прямая правка конфига SOGo в plist-подобном формате. Обратите внимание на кавычки: в штатном файле значение записано как WOWorkersCount = "20";. Смотрю текущее значение и заодно интервалы:
grep -nE 'WOWorkersCount|PingInterval|SyncInterval|WatchDogRequestTimeout|SxVMemLimit' /opt/mailcow-dockerized/data/conf/sogo/sogo.confМеняю на посчитанное под реальный парк устройств: для «СадГавани» — 20 EAS-устройств с push плюс запас на веб-интерфейс и CalDAV для остальных сотрудников и на рост штата. Взял 32. sed учитывает кавычки — без них шаблон просто не совпадёт, и вы решите, что правка применилась:
sed -i 's/WOWorkersCount = "[0-9]*";/WOWorkersCount = "32";/' /opt/mailcow-dockerized/data/conf/sogo/sogo.conf
grep -n WOWorkersCount /opt/mailcow-dockerized/data/conf/sogo/sogo.conf
После правки перезапускаю не только SOGo, но и Memcached — документация mailcow для изменений в конфигурации SOGo везде даёт одну и ту же пару контейнеров:
docker compose restart memcached-mailcow sogo-mailcowПосле этого шага «No child available» у «СадГавани» не повторялась две недели подряд под наблюдением — веб-почта в браузере перестала виснуть даже в пиковые часы, когда все 20 EAS-устройств держат push-сессии одновременно. Память контейнера SOGo по docker stats выросла с примерно 0,9 до 1,5 ГБ — на VPS с 8 ГБ это укладывается с запасом. Учтите: sogo.conf — файл из репозитория mailcow. update.sh перед обновлением коммитит локальные правки, а потом сливает апстрим с приоритетом его версии (git merge -Xtheirs), так что при конфликте в этих строках ваше значение может быть перезаписано. После каждого апдейта проверяю WOWorkersCount grep-ом.
На что ещё смотрю, если увеличение WOWorkersCount не помогло до конца
Если после увеличения WOWorkersCount алерты стали реже, но не исчезли — смотрю на интервалы. В mailcow SOGoMaximumPingInterval и SOGoMaximumSyncInterval уже стоят на 3540 секундах, как в примерах SOGo, — это настоящий push, но и максимальное время, на которое устройство удерживает worker. Уменьшив их, вы освобождаете процессы быстрее ценой менее мгновенных уведомлений: это рычаг на случай, когда добавить RAM под workers нельзя. Отдельно сверяю WOWatchDogRequestTimeout — он задаётся в минутах; в штатном конфиге mailcow стоит 30, а в примерах SOGo для push — 60. Если в логе много WOWatchDogChild ... has been hanging in the same request, а телефоны жалуются на обрывы push, поднимаю его до 60 — но осознанно, понимая, что так worker держится дольше.
Второе — прокси перед SOGo. Руководство SOGo требует, чтобы таймаут веб-сервера перед ним был не меньше интервала EAS (в примерах — 3600 секунд для Apache). В mailcow эту роль играет nginx-mailcow, и для location ^~ /Microsoft-Server-ActiveSync в штатном шаблоне уже стоят proxy_read_timeout 3600 и proxy_send_timeout 3600 — трогать их не нужно. А вот если перед mailcow есть ещё один обратный прокси или балансировщик с таймаутом 60 секунд, он будет рвать push-соединения, телефоны начнут переподключаться, и нагрузка на workers вырастет. Такой внешний прокси проверяю первым.
Третье — память. Каждый worker — отдельный процесс, и SxVMemLimit (в mailcow — 384 МБ, это же дефолт SOGo) задаёт потолок, после которого child перезапускается. На практике worker редко упирается в лимит, но умножать число workers на порядок, не посчитав RAM, опасно: вместо нехватки workers получите OOM Killer и падение SOGo целиком. Для 32 workers у «СадГавани» хватило штатной памяти VPS, а для масштабов из issue #2266 я ориентируюсь на оценку разработчика — 16–20 ГБ на 100–120 EAS-workers — и считаю память на этапе планирования, а не по факту первого падения.
Чек-лист: считаю workers перед подключением новых телефонов
Этот чек-лист я теперь прохожу перед каждым массовым подключением мобильных клиентов к почте на mailcow, а не только когда уже начались жалобы на зависшую веб-почту. Дешевле выставить workers с запасом заранее, чем разбирать логи вотчдога в разгар рабочего дня, пока бухгалтерия не может открыть письмо от банка.
И отдельно фиксирую дату и число подключённых устройств в заметке к серверу — при следующем росте штата и новой волне подключений телефонов сразу видно, от какой базы считать новое значение WOWorkersCount, а не запускать расчёт с нуля каждый раз заново.
Такой же принцип я применяю и к другим сервисам, которые массово переходят на мобильные устройства сотрудников: чем раньше администратор явно считает нагрузку по числу устройств, а не по интуиции «ну подключили же и подключили», тем меньше шансов получить аварийный простой в разгар рабочего дня. Это же справедливо и для параллельно растущего теневого IT в компании — новые устройства и сервисы появляются быстрее, чем администратор успевает их учесть, если не делать это регулярной практикой, а не разовой реакцией на инцидент.
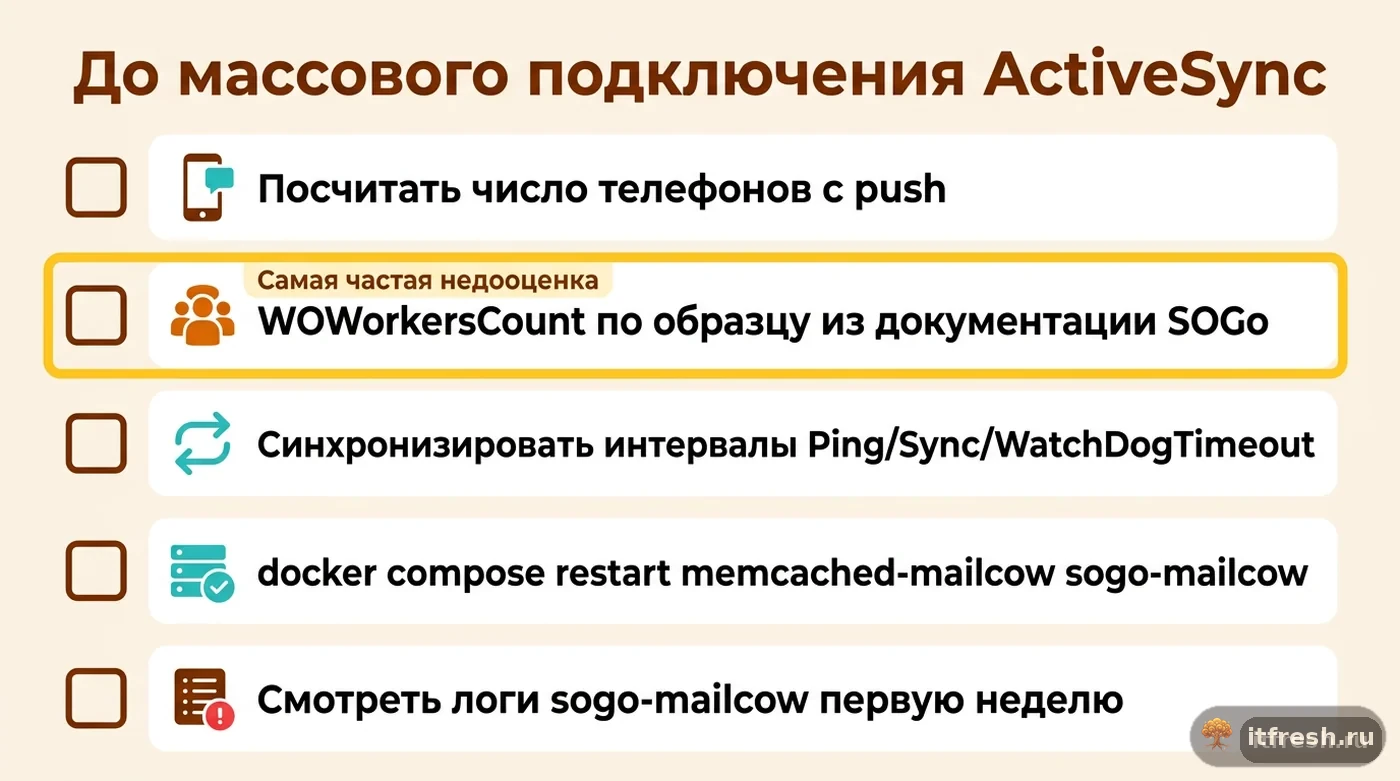
- Посчитать реальное число телефонов, которые подключат корпоративную почту через ActiveSync с включённым push
- Заложить запас минимум ×1,5 от числа EAS-устройств с push на веб-интерфейс, DAV и рост штата
- Выставить WOWorkersCount по образцу из официального руководства SOGo, а не по наитию
- Синхронизировать SOGoMaximumPingInterval / SOGoMaximumSyncInterval / WOWatchDogRequestTimeout между собой
- Перезапустить memcached-mailcow и sogo-mailcow после любой правки sogo.conf
- Наблюдать docker compose logs sogo-mailcow первую неделю после массового подключения новых телефонов
Частые вопросы
Почему ошибка появилась не сразу, а через несколько дней после подключения телефонов?
Push-соединения ActiveSync живут до часа, и worker-процессы занимаются постепенно, по мере того как устройства устанавливают долгие Ping/Sync-сессии. В issue #5655 mailcow-dockerized автор описывает, что workers заканчивались через 12–24 часа после старта, — поэтому проблема проявляется не в первый час.
Достаточно ли одного большого WOWorkersCount, чтобы забыть про проблему навсегда?
Нет. Даже конфигурация с WOWorkersCount = 50 на 280 ящиков (issue #2266) не гарантирует, что проблема не вернётся при дальнейшем росте числа EAS-устройств с push. Значение нужно пересматривать при каждом заметном росте парка мобильных клиентов.
Правка sogo.conf в mailcow делается через переменную окружения в mailcow.conf?
Нет, WOWorkersCount и связанные параметры правятся напрямую в файле data/conf/sogo/sogo.conf внутри установки mailcow, а не через переменные в mailcow.conf — это отдельный конфиг самого SOGo.
Нужно ли перезапускать весь mailcow целиком после правки WOWorkersCount?
Нет, достаточно перезапустить SOGo и Memcached: docker compose restart memcached-mailcow sogo-mailcow — так документация mailcow рекомендует применять изменения конфигурации SOGo. Postfix, Dovecot и Rspamd эта правка не затрагивает.
Что делать, если увеличение WOWorkersCount не помогает совсем?
Посмотреть в логе sogo-mailcow, не засыпает ли сервер одно устройство (по DeviceId) — в issue #5655 помогла перезагрузка iPhone. Затем проверить WOWatchDogRequestTimeout, интервалы Ping/Sync и таймаут внешнего прокси перед mailcow, если он есть.
Источники
- SOGo Installation and Configuration Guide — General Preferences / ActiveSync — Проверил: WOWorkersCount (3 — разумно для низкой нагрузки, без настройки — 1), WOWatchDogRequestTimeout в минутах (дефолт 10), SxVMemLimit 384 МБ, правило «минимум один child на push-устройство + запас», примеры 100/10 → 15 и 1000/100 → 120 с интервалами 3540, Apache timeout 3600, WOWatchDogRequestTimeout 60. https://www.sogo.nu/files/docs/SOGoInstallationGuide.html
- mailcow docs — SOGo — Проверил, что изменения конфигурации SOGo применяются командой docker compose restart memcached-mailcow sogo-mailcow. https://docs.mailcow.email/manual-guides/SOGo/u_e-sogo/
- GitHub issue #5655 — EAS starves SOGo threads after a while — Проверил: 3 ящика, один iPhone, дефолтные 20 workers, исчерпание через 12–24 часа, совет мейнтейнера увеличить WOWorkersCount в data/conf/sogo/sogo.conf, закрытие после перезагрузки iPhone. https://github.com/mailcow/mailcow-dockerized/issues/5655
- GitHub issue #2266 — No child available to handle incoming request! — Проверил конфигурацию на 280 ящиков (WOWorkersCount "50", интервалы 3540/45/60) и ответ разработчика: начать со 100 workers, 100–120 EAS-workers ≈ 16–20 ГБ RAM. https://github.com/mailcow/mailcow-dockerized/issues/2266
- mailcow community forum — Watchdog ALERT: sogo-mailcow timeouts — Проверил, что алерт watchdog по sogo-mailcow в обсуждениях сообщества связывают именно с нехваткой worker-процессов под нагрузку ActiveSync. https://community.mailcow.email/d/737-watchdog-alert-sogo-mailcow-timeouts
- mailcow-dockerized: data/conf/sogo/sogo.conf и sites-default.conf.j2 (master) — Сверил штатные значения mailcow: WOWorkersCount = "20", SOGoMaximumPingInterval/SyncInterval = 3540, SOGoInternalSyncInterval = 45, WOWatchDogRequestTimeout = 30, SxVMemLimit = 384; в nginx для /Microsoft-Server-ActiveSync proxy_read_timeout 3600. https://github.com/mailcow/mailcow-dockerized/blob/master/data/conf/sogo/sogo.conf