
Широковещательный шторм в офисной сети: как найти петлю и что настроить на коммутаторах
Широковещательный шторм почти всегда означает петлю: кадр ходит по кругу между коммутаторами и размножается, пока не забьёт каналы и процессоры. Вернуть сеть можно за минуты, если вытащить подозрительный кабель, а удержать — только настройкой STP, BPDU guard и storm control. Ниже — как искать виновника, какие команды дать и разбор офиса на 40 мест.
Почему одна лишняя патч-корда кладёт всю сеть
Если у вас в офисе внезапно «умерло всё сразу»: 1С не открывается, шара не отвечает, телефоны отваливаются, при этом Wi-Fi вроде светится — с большой вероятностью это петля. За пятнадцать с лишним лет работы с офисными сетями я видел её чаще, чем отказ любого другого узла. Причина почти всегда бытовая: кто-то воткнул кабель обоими концами в один и тот же коммутатор или соединил два порта разных коммутаторов, которые уже связаны между собой. Если вам нужна помощь с настройкой и обслуживанием офисной сети, начинаем именно с защиты от таких ситуаций, а не с поиска виноватого после аварии.
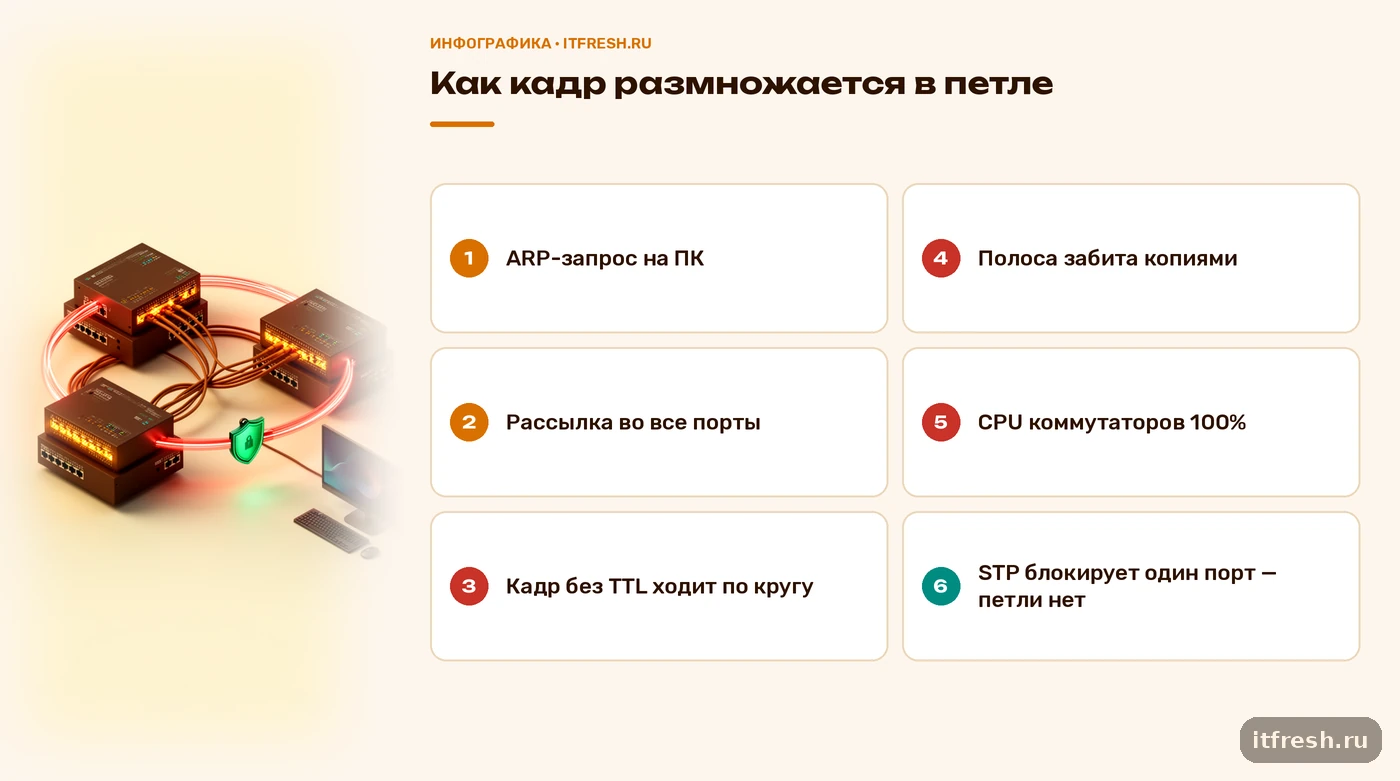
Механика простая. В кадре Ethernet нет поля «время жизни», как TTL в IP-пакете. Широковещательный кадр (например, ARP-запрос «кто имеет такой-то адрес») коммутатор отправляет во все порты, кроме того, откуда он пришёл. Если между двумя коммутаторами есть два пути, кадр уходит по обоим, возвращается и снова рассылается. Каждый круг умножает число копий, и за секунды они занимают всю полосу на затронутых портах. Это и есть широковещательный шторм. Полезный трафик просто не пролезает, а процессоры коммутаторов тратят все силы на обработку этих копий.
Отдельная неприятность: таблицы MAC-адресов начинают «прыгать». Один и тот же адрес источника коммутатор видит то на одном порту, то на другом, потому что копии кадров приходят с разных сторон. Из-за этого обычный unicast-трафик тоже уходит не туда. Поэтому шторм бьёт не только по широковещательным службам вроде DHCP и ARP, но и по всему остальному. Один кабель — и встала вся сеть в одном широковещательном домене.
Важно понимать, что защита от петли в Ethernet — это не опция и не «потом настроим». Протокол остовного дерева (STP) придуман ровно для этого: он оставляет в топологии только один активный путь, а лишние связи переводит в блокировку. Современный вариант — RSTP (IEEE 802.1w; он вошёл в 802.1D-2004, а сейчас описан в 802.1Q), он восстанавливается за секунды, а не за десятки секунд, как классический STP. Если коммутаторы в вашем офисе управляемые, STP должен быть включён и настроен осознанно. Если неуправляемые — о нём чаще всего можно забыть, и именно такие коммутаторы в переговорках и под столами порождают большинство историй с петлёй.
- Петля = два активных L2-пути между одними и теми же устройствами без работающего STP.
- Шторм = лавинообразное размножение широковещательных, многоадресных и неизвестных unicast-кадров.
- Симптом — недоступно всё сразу, а не одна служба.
Как понять, что это петля, а не вирус или сбой провайдера
Первое, что я делаю, когда мне звонят с жалобой «сеть лежит», — задаю три вопроса. Пропал ли интернет у всех или только у части? Открываются ли локальные ресурсы вообще? И светятся ли индикаторы активности на коммутаторах непрерывно, без пауз? Если интернет есть у кого-то на Wi-Fi через отдельную точку доступа в другом сегменте, а проводные пользователи теряют всё сразу, подозрение на петлю становится сильным. В документации Cisco по диагностике петель это прямо сформулировано: если у всех пользователей в одном домене сразу проблемы со связью, можно уже подозревать петлю моста.
Второй признак — загрузка каналов. Петля насыщает линки: в мониторинге вы увидите, что трафик на портах между коммутаторами упёрся в потолок, а счётчики пакетов растут аномально быстро. Cisco советует снять трафик с такого линка и посмотреть, нет ли в дампе множества одинаковых пакетов. Для этого достаточно Wireshark на порту зеркалирования; я описывал подход к такому анализу в разборе диагностики сети через Wireshark. Если в дампе одни и те же ARP или широковещательные кадры идут сотнями в секунду — это шторм, вирус тут не нужен.
Третий признак — поведение самих коммутаторов. Загрузка процессора под сто процентов, веб-интерфейс или SSH отвечают с огромной задержкой либо не отвечают вовсе. Это не значит, что коммутатор сломан. Он просто захлёбывается в служебной обработке копий. На оборудовании Cisco проверяется через show processes cpu, на других платформах — своими средствами, но смысл тот же.
Как отличить от других причин. Сбой провайдера не мешает работе локальных ресурсов: внутри офиса всё живо, не открываются только внешние сайты. Вирус или сканирование сети создают лишний трафик, но обычно не парализуют все порты одновременно и не приводят к «прыжкам» MAC-адресов. Сбой DHCP-сервера проявляется тем, что новые устройства не получают адрес, а старые работают. Если же не работает всё и сразу, а светодиоды мигают как на ёлке — ищите петлю.
Как найти петлю за 15 минут: порт-виновник и физический кабель
Порядок у меня всегда один. Сначала — вспомнить, что менялось: новый коммутатор, переставленный стол, новая розетка в переговорке, подключённый телефон с проходным портом. В трёх случаях из четырёх петля появляется в течение часа после чьих-то физических действий. Если известно, что именно меняли, просто верните как было — сеть оживёт сразу. Если нет, переходим к поиску по оборудованию.
Второй шаг — зайти на корневой или центральный коммутатор и посмотреть, на каких портах аномальная загрузка. Потому что петля чаще всего видна на порту, который ведёт к устройству, создавшему её. Если доступ по сети уже невозможен, подключайтесь консольным кабелем: он не зависит от штормящих портов. Дальше на Cisco смотрите счётчики и состояние STP. Cisco в своём документе по петлям называет полезными команды show spanning-tree vlan с ключом detail (он показывает, приходят ли BPDU на каждый интерфейс) и show interfaces (загрузка и счётчики ошибок).
Пример набора для Cisco. Подставьте номер своей VLAN:
show processes cpu
show interfaces
show spanning-tree vlan 10 detail
show interfaces status err-disabled
На что смотреть в выводе: порты с непропорционально большим числом принятых широковещательных пакетов, интерфейсы, на которых STP недавно менял состояние, и порты в состоянии err-disabled (последняя команда как раз их перечисляет). На оборудовании MikroTik с мостом полезно смотреть, какие порты моста в каком состоянии, и использовать встроенный мониторинг трафика на интерфейсах.
Третий шаг — физика. Найдя порт с аномалией, следуйте за кабелем. Если порт ведёт к неуправляемому коммутатору, отключите его кабель от стойки и подождите несколько секунд: шторм прекращается практически мгновенно. Затем подключайте ветки по одной, начиная с самых подозрительных (переговорка, склад, чьё-то рабочее место с «самодельным» удлинителем сети). Чтобы не потерять время, держите актуальную схему и соответствие «розетка — порт». Хорошо, когда оно ведётся в системе учёта, а не в голове у одного человека; мы для этого используем NetBox, но для 40 рабочих мест хватит и таблицы.
- Верните последнее физическое изменение: кабель, коммутатор, розетку.
- Подключитесь консолью к центральному коммутатору.
- Найдите порты с аномальной загрузкой и err-disabled.
- Отключите подозрительную ветку, дождитесь тишины в индикаторах.
- Возвращайте ветки по одной, пока не вернётся шторм.
Что настроить на коммутаторах: STP, PortFast и BPDU guard
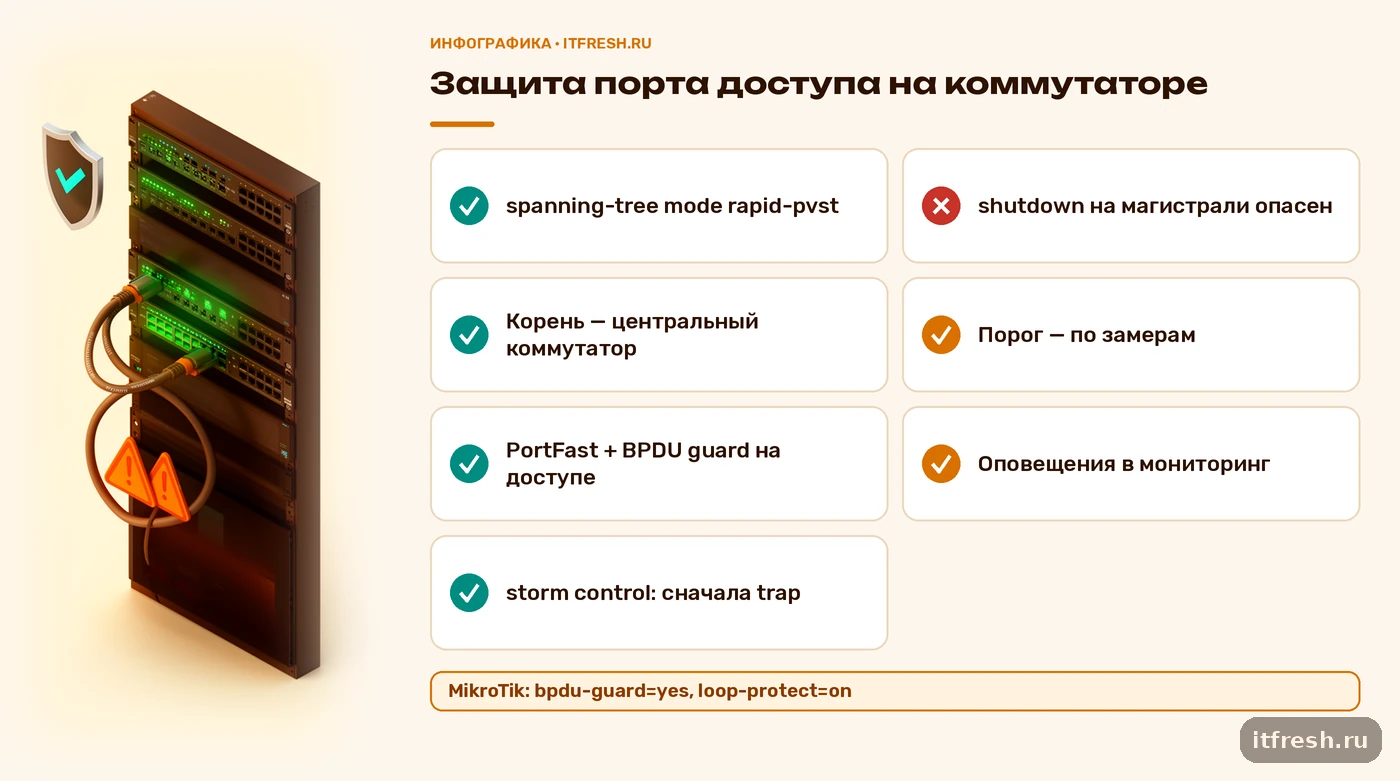
Первое, что нужно сделать на управляемых коммутаторах, — убедиться, что STP включён и работает в быстром режиме. На Catalyst 9300 режим по умолчанию — Rapid PVST+, и команда spanning-tree mode rapid-pvst нужна, только если его меняли; это следует из официальной документации Cisco. На MikroTik значение protocol-mode у моста по умолчанию rstp. Проверьте в своей модели и прошивке: на некоторых коммутаторах других вендоров STP по умолчанию выключен.
Второе — корень дерева должен быть там, где вы его хотите видеть. Если не задавать приоритет, корнем может стать случайный коммутатор, в худшем случае самый старый в углу. Задайте приоритет центральному коммутатору явно, чтобы он всегда выигрывал выборы. На MikroTik приоритет моста по умолчанию 32768, меньшее значение выигрывает.
Третье — защитить порты доступа. Для портов, куда подключаются компьютеры, принтеры и телефоны, включите PortFast (на MikroTik это edge) и BPDU guard. PortFast переводит порт сразу в пересылку, а BPDU guard отключает порт, если на нём вдруг появился BPDU, то есть к порту подключили коммутатор. Для Cisco это спрятано в документации по дополнительным функциям STP: команда spanning-tree portfast на интерфейсе, spanning-tree bpduguard enable для конкретного порта и spanning-tree portfast bpduguard default глобально, чтобы защита включалась на всех портах в состоянии PortFast. Как пример для офисного коммутатора доступа:
configure terminal
 spanning-tree mode rapid-pvst
 spanning-tree portfast bpduguard default
 interface range GigabitEthernet1/0/1 - 24
  switchport mode access
  spanning-tree portfast
  spanning-tree bpduguard enable
 end
show spanning-tree summary
На MikroTik то же делается на портах моста. Свойство edge по умолчанию auto, bpdu-guard по умолчанию no, поэтому включать защиту нужно явно:
/interface bridge port set [find interface=ether5] edge=yes bpdu-guard=yesПорт, получивший BPDU при включённом BPDU guard, отключается и сам уже не включится: на Cisco он переходит в err-disabled, на MikroTik его надо включить вручную. Это правильное поведение: лучше потерять один порт, чем всю сеть. Для Cisco можно настроить автоматическое восстановление командой errdisable recovery cause bpduguard; по умолчанию восстановление выключено, а интервал равен 300 секундам, его меняют командой errdisable recovery interval. Но автоматику я включаю неохотно: если неуправляемый коммутатор остался в сети, порт будет то подниматься, то снова падать. Для удалённых филиалов, куда приезжать долго, это разумный компромисс, для головного офиса я предпочитаю разобраться и вернуть порт руками.
Отдельно про Root Guard и Loop Guard. Root guard (spanning-tree guard root на интерфейсе) не даёт порту стать корневым и защищает от захвата роли корня чужим коммутатором; его включают на портах, смотрящих вниз, на downstream-коммутаторы. Loop guard защищает от петли при односторонней неисправности линка. Две функции на одном интерфейсе одновременно включить нельзя, документация Cisco об этом говорит прямо. Для офиса на 40 мест я обычно ограничиваюсь BPDU guard на доступе и корректным корнем, остальное — по необходимости.
Storm control и loop protect: страховка, когда STP не спасает
STP не всемогущ. Он не работает на неуправляемых коммутаторах, а такие в офисах встречаются повсеместно. Он может быть неправильно настроен или отключён по чьему-то совету. Поэтому вторая линия обороны — ограничение широковещательного трафика на уровне порта, storm control. Идея в том, что коммутатор считает долю широковещательных кадров на порту, и если она превышает порог, трафик такого типа блокируется. Тогда шторм не растёт бесконечно, а остаётся локальным.
Синтаксис на Catalyst 9300 (IOS XE 17.3) такой: storm-control broadcast level, где задаётся верхний порог в процентах от полосы и, по желанию, нижний, а также действие storm-control action с вариантами shutdown и trap. По умолчанию функция выключена, а при срабатывании без явного действия трафик фильтруется и ловушка не отправляется. Измеряется интервал в одну секунду. Документация честно предупреждает: из-за особенностей железа и разных размеров пакетов реальный порог может отличаться от заданного на несколько процентных пунктов. Показать настройки можно командой show storm-control.
interface GigabitEthernet1/0/1
 storm-control broadcast level 5.00 2.00
 storm-control action trap
end
show storm-control GigabitEthernet1/0/1 broadcast
Значение 5 процентов здесь — иллюстрация, а не рекомендация. Правильный порог выбирают по измерениям: посмотрите, сколько широковещательного трафика ваша сеть создаёт в обычный день (загрузка рабочих станций, принтеры, 1С-клиенты, камеры), и поставьте порог с запасом. Слишком низкий порог начнёт глушить нормальную работу, слишком высокий не поможет. Действие shutdown переводит порт в err-disabled, и это хорошо для порта доступа, но опасно на магистральных линках между коммутаторами: вы можете отключить сам аплинк. Поэтому на магистралях я сначала ставлю trap и смотрю на срабатывания несколько недель.
Для MikroTik есть своя страховка — loop protect. Он включается на интерфейсе (ethernet, vlan, eoip, vxlan) свойством loop-protect=on. Роутер сам отправляет проверочные кадры с EtherType 0x9003, и если получает обратно кадр со своим MAC-адресом источника, отключает интерфейс. По умолчанию кадры уходят раз в 5 секунд (loop-protect-send-interval), а выключенный интерфейс остаётся выключенным 5 минут (loop-protect-disable-time, значение 0 означает навсегда). Сам производитель при этом советует использовать (R/M)STP вместо loop protect, когда интерфейсы объединены в мост: у STP больше настроек и он совместим с большинством коммутаторов. Я воспринимаю loop protect как дополнение для портов, где STP почему-то нельзя, а не как замену.
/interface ethernet set ether5 loop-protect=onТеперь о том, чтобы вовремя узнавать о срабатываниях. Без наблюдения BPDU guard и storm control превращаются в тихо отключившийся порт, на который через два дня позвонит возмущённый сотрудник. Настройте отправку SNMP-ловушек и уведомлений, а состояния портов и загрузку выводите в мониторинг. О том, как опрашивать коммутаторы и что именно собирать, у меня есть отдельный материал про мониторинг сетевых устройств по SNMP.
- На портах доступа: PortFast/edge + BPDU guard + storm control (shutdown или trap).
- На магистралях между коммутаторами: STP с заданным корнем, storm control только с trap на старте.
- На MikroTik, где STP невозможен: loop protect как запасной вариант.
Разбор: офис на 40 мест, где петлю делали три раза за год
Условный клиент — компания, занимающаяся озеленением, «Природный контур», 40 рабочих мест. В офисе два управляемых коммутатора доступа и один центральный, плюс несколько неуправляемых пятипортовых коммутаторов, которые за годы расползлись по переговорным и кабинетам: сотрудники дополняли ими сеть, когда не хватало розеток. Обратились к нам после того, как за год сеть «падала целиком» три раза. Каждый раз всё заканчивалось перезагрузкой коммутаторов, и причина оставалась невыясненной.
Мы начали с инвентаризации: обошли офис, нашли все неуправляемые устройства, составили таблицу «розетка — порт — устройство» и нарисовали реальную схему подключений, а не ту, что была на бумаге. Параллельно проверили настройки STP на управляемом оборудовании. Выяснилось типичное: режим STP был включён, но корень никто не назначал, и центральный коммутатор не гарантированно оказывался корнем. BPDU guard не использовался нигде, storm control тоже. По умолчанию и BPDU guard, и storm control выключены, так что ожидать, что они появятся сами, не стоило.
В цифрах картина была такая. Три управляемых коммутатора на 24 и 48 портов, семь неуправляемых «пятипортовиков», из которых в документации не значился ни один, и около 90 розеток, из которых подписаны были меньше половины. Обход и составление таблицы заняли у двух инженеров один рабочий день, настройка — один вечер, замена двух коммутаторов в переговорных обошлась клиенту примерно в 25 тысяч рублей за оборудование. Последний из трёх простоев, по словам директора, стоил офису около четырёх часов работы всех 40 сотрудников, так что окупаемость здесь считать не нужно.
Дальше работа заняла один вечер без простоя для сотрудников. Мы задали приоритет центральному коммутатору, включили PortFast и BPDU guard на всех портах доступа, а на портах, где сидели неуправляемые коммутаторы, обсудили с директором два варианта: заменить их управляемыми или оставить, зная, что такие порты теперь будут отключаться при появлении BPDU и при петле. Выбрали замену двух самых проблемных коммутаторов (в переговорных) и оставили остальные, но закрыли каждый storm control на порту подключения с действием trap. Ловушки направили в мониторинг, и отдельный триггер сообщает о err-disabled на любом порту.
Итог за следующие месяцы: случаев, когда сеть падала целиком, не было. Один раз сработал storm control на порту в кабинете, и вместо общего простоя коллеги увидели в мониторинге порт и устройство. Конфигурации коммутаторов мы теперь сохраняем автоматически, как описано в материале про резервное копирование конфигураций сетевого оборудования, чтобы любое изменение можно было откатить.
Отдельно о сегментации. Если вы хотите заодно разделить сеть на сегменты, чтобы петля в одном из них не парализовала остальные, пригодится сегментация офиса по VLAN: у каждого VLAN свой широковещательный домен, и шторм ограничивается его пределами. Но VLAN не заменяют STP, это разные задачи.
Частые вопросы
Может ли широковещательный шторм возникнуть без петли?
Да, но редко: неисправная сетевая карта или программа может засыпать сеть широковещательными кадрами. Петля при этом — самая частая причина, потому что кадры размножаются сами. Если после отключения подозрительной ветки шторм прекратился, это была петля.
Как быстро остановить шторм, пока причина неизвестна?
Отключайте ветки сети от центрального коммутатора по одной, начиная с неуправляемых коммутаторов, и следите за индикаторами. Как только активность вернулась в норму, виновная ветка найдена. Перезагрузка коммутаторов не поможет, если петля физически осталась.
Что делает BPDU guard и чем он отличается от storm control?
BPDU guard отключает порт доступа, на котором появился служебный кадр STP, то есть к порту подключили коммутатор. Storm control ограничивает долю широковещательного трафика на порту и срабатывает, когда шторм уже начался. Они дополняют друг друга.
Работает ли STP на неуправляемых коммутаторах?
Как правило, нет. Такие устройства чаще всего не поддерживают STP, поэтому петля через них не блокируется. Защищайте порты, к которым они подключены: BPDU guard и storm control на управляемой стороне. Лучше заменить их управляемыми, где это возможно.
Нужно ли включать автоматическое восстановление err-disabled портов?
На Cisco оно по умолчанию выключено, включается командой errdisable recovery cause bpduguard, интервал по умолчанию 300 секунд. Если причина не устранена, порт будет снова падать. Для удалённых точек это допустимо, в основном офисе лучше разбираться вручную.
Источники
- Cisco: Configuring Spanning Tree Protocol (Catalyst 9300) — Проверено: режим spanning-tree mode rapid-pvst, Rapid PVST+ по умолчанию. https://www.cisco.com/c/en/us/td/docs/switches/lan/catalyst9300/software/release/16-12/configuration_guide/lyr2/b_1612_lyr2_9300_cg/configuring_spanning_tree_protocol.html
- Cisco: Configuring Optional Spanning-Tree Features — Проверено: spanning-tree portfast, portfast bpduguard default, bpduguard enable, guard root, loopguard default. https://www.cisco.com/c/en/us/td/docs/switches/lan/catalyst9300/software/release/16-12/configuration_guide/lyr2/b_1612_lyr2_9300_cg/configuring_optional_spanning_tree_features.html
- Cisco: Configuring Port-Based Traffic Control (storm control, IOS XE 17.3) — Проверено: синтаксис storm-control broadcast level, storm-control action, show storm-control, значения по умолчанию, интервал 1 с. https://www.cisco.com/c/en/us/td/docs/switches/lan/catalyst9300/software/release/17-3/configuration_guide/sec/b_173_sec_9300_cg/configuring_port_based_traffic_control.html
- Cisco: Errdisable Port State Recovery — Проверено: errdisable recovery cause bpduguard, интервал 300 с по умолчанию, show errdisable recovery. https://www.cisco.com/c/en/us/support/docs/lan-switching/spanning-tree-protocol/69980-errdisable-recovery.html
- Cisco: Troubleshooting STP Issues (bridging loops) — Проверено: признаки петли, команды show spanning-tree vlan detail, show interfaces, show processes cpu. https://www.cisco.com/c/en/us/support/docs/lan-switching/spanning-tree-protocol/10556-16.html
- MikroTik: Spanning Tree Protocol и Loop Protect — Проверено: protocol-mode rstp по умолчанию, bpdu-guard требует ручного включения порта; edge, priority 32768; loop-protect, интервалы, EtherType 0x9003. https://help.mikrotik.com/docs/spaces/ROS/pages/328068/Spanning+Tree+Protocol и https://manual.mikrotik.com/docs/bridging-and-switching/user-guides/loop-protect