
Почему REST API и GraphQL в NetBox отдают не все устройства: лимиты и правильная пагинация
Скрипт запросил список устройств в NetBox, получил 50 штук и решил, что это всё — а в инвентаре их триста. Причина не в сети: REST API отдаёт списки страницами по PAGINATE_COUNT = 50, а GraphQL с версии 4.5.5 тоже режет выдачу — по MAX_PAGE_SIZE. Показываю, как забрать весь список и что изменилось после апгрейда.
Симптом: интеграция видит только часть устройств
Жалоба обычно звучит так: «В NetBox триста с лишним устройств, а наш скрипт синхронизации с системой мониторинга видит пятьдесят и на этом останавливается». Первая мысль — сломался фильтр в запросе, но фильтр тут ни при чём: NetBox отдаёт списочные ответы страницами, и без явной обработки пагинации любой клиент REST API получит только первую страницу — по умолчанию 50 объектов, — и молча решит, что это весь список. Именно с этого я начинаю разбор интеграций, когда веду внедрение NetBox для клиента, у которого уже есть внешние системы, которые должны читать инвентарь.
Второй, менее очевидный вариант того же симптома — GraphQL-запрос, который раньше отдавал полный список, а после обновления NetBox стал внезапно усекать результат. Здесь причина другая: до определённой версии лимит страницы, который годами работал только для REST, на GraphQL не распространялся, а начиная с 4.5.5 распространяется. Разберу оба случая по очереди, потому что чинятся они разными приёмами.
REST API: PAGINATE_COUNT, MAX_PAGE_SIZE и как забрать всё
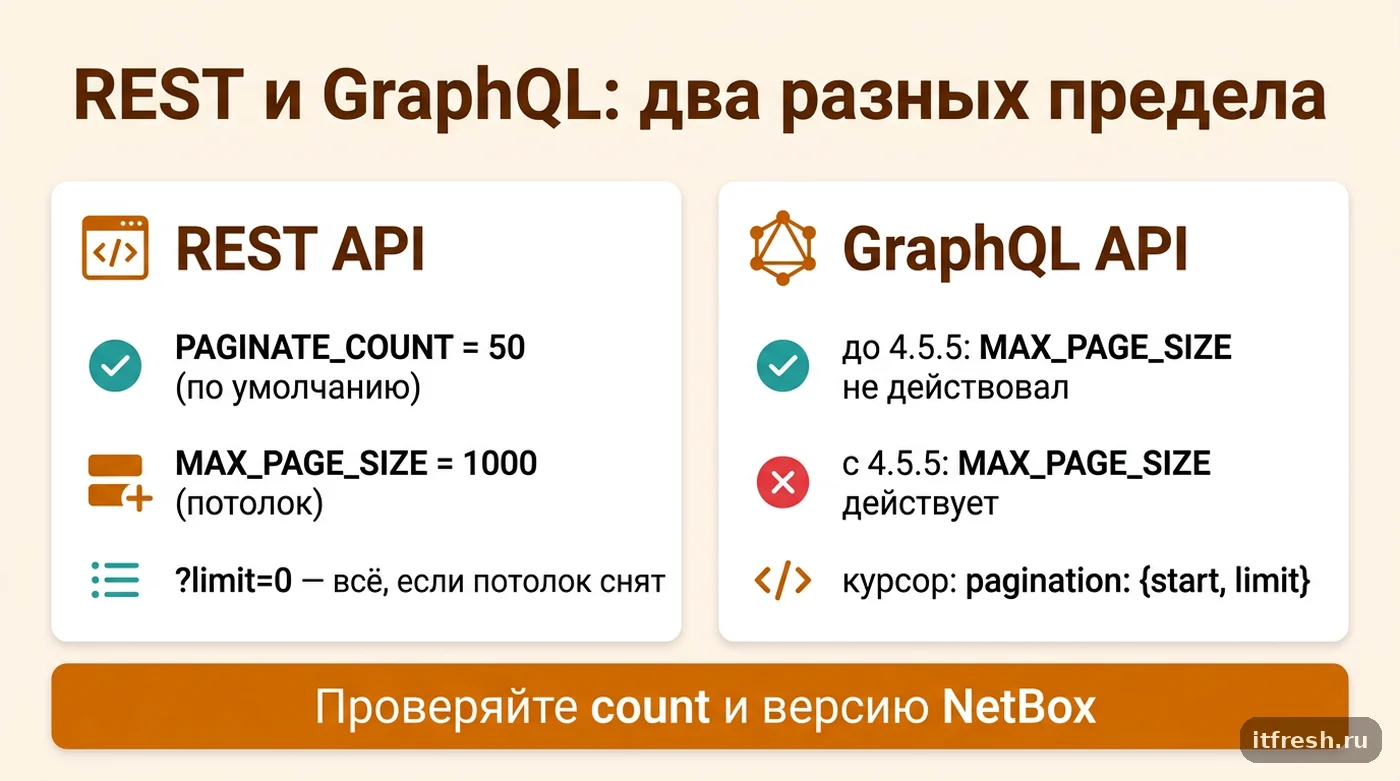
У REST API NetBox два разных параметра конфигурации, которые часто путают. PAGINATE_COUNT — это размер страницы по умолчанию, когда клиент не указал limit явно; по документации он равен 50. MAX_PAGE_SIZE — это верхний предел, больше которого сервер не отдаст объектов за один запрос, даже если клиент попросит больше; по умолчанию это 1000. Клиент может явно запросить ?limit=100, ?limit=500 — сервер отдаст ровно столько, но не больше значения MAX_PAGE_SIZE.
Списочный ответ REST API всегда содержит четыре поля: count — общее число объектов, удовлетворяющих запросу, next и previous — ссылки на соседние страницы (или null, если страницы нет), и results — сами объекты текущей страницы. Правильная интеграция должна либо идти по next, пока он не станет null, либо, если объём разумный, один раз запросить всё через ?limit=0 — документация прямо описывает это как способ получить все совпадающие объекты одним запросом.
Здесь важна оговорка: ?limit=0 работает только тогда, когда на сервере MAX_PAGE_SIZE не ограничивает выдачу — то есть значение параметра установлено в 0 или None в конфигурации NetBox. Если администратор сервера оставил MAX_PAGE_SIZE по умолчанию (1000), ?limit=0 не даст вам обойти этот потолок — вы получите не более 1000 объектов за запрос, и на инвентаре в несколько тысяч устройств всё равно понадобится пагинация через next, даже с limit=0 в URL. С NetBox 4.6.0 (5 мая 2026 года, задача #21363) у REST появился и курсорный режим: ?start=0&limit=1000 отдаёт объекты с id не меньше start, отсортированные по id, а ссылка next сама подставляет следующий start. Учтите две детали: start и offset в одном запросе несовместимы (сервер ответит 400), а count в курсорном режиме всегда null — общее число объектов для сверки придётся запрашивать отдельным обычным запросом.
Экономим трафик: fields, brief и omit
Отдельная, но смежная тема — объём данных на каждый объект. Если для синхронизации с внешней системой нужны только id, имя и статус устройства, а не полная вложенная структура со всеми связями, документация REST API даёт параметр ?fields=id,name,status — сервер вернёт только перечисленные поля вместо полного представления объекта. Для типового устройства это разница на порядок в объёме ответа, что особенно ощутимо при выгрузке нескольких тысяч записей постранично.
Есть и обратный параметр omit — исключить конкретные поля из полного представления, когда нужно почти всё, кроме одного тяжёлого блока. А для случаев, когда клиенту достаточно минимального краткого представления объекта, есть параметр brief=true. Комбинация постраничного обхода через next и урезанного набора полей через fields — это то, с чего я советую начинать любую интеграцию, которая читает инвентарь целиком на регулярной основе, а не разово.
GraphQL до и после NetBox 4.5.5: тихое изменение поведения
У GraphQL API своя механика и своя история. Долгое время параметр MAX_PAGE_SIZE, ограничивающий REST, попросту не действовал на GraphQL: сопровождающие NetBox завели это как баг #20385 ещё на версии 4.4.1 — при MAX_PAGE_SIZE = 10 запрос с pagination: {limit: 100} возвращал сто записей. Исправление вошло в 4.5.5 (17 марта 2026 года). Как сформулировано в последовавшем issue #21935: до 4.5.4 включительно базовые списочные запросы вида device_list { id name } были неограниченными, а начиная с 4.5.5 они режутся до MAX_PAGE_SIZE — даже без явной пагинации.
Для тех, кто обновлял NetBox поэтапно, это ощущается как тихая порча интеграции: запрос, который годами возвращал весь список устройств, после апгрейда до 4.5.5 или новее вдруг стал отдавать не больше значения MAX_PAGE_SIZE — по умолчанию 1000 объектов, — без единой ошибки в логах, просто усечённый результат. Формально это исправление бага, а не новая функция, поэтому в release notes оно заняло одну строку в списке багфиксов. При этом документация какое-то время описывала MAX_PAGE_SIZE только применительно к REST — это и зафиксировал issue #21935, закрытый правкой документации в milestone 4.5.9. Сейчас в описании параметра прямо сказано, что он действует на веб-интерфейс, REST и GraphQL.
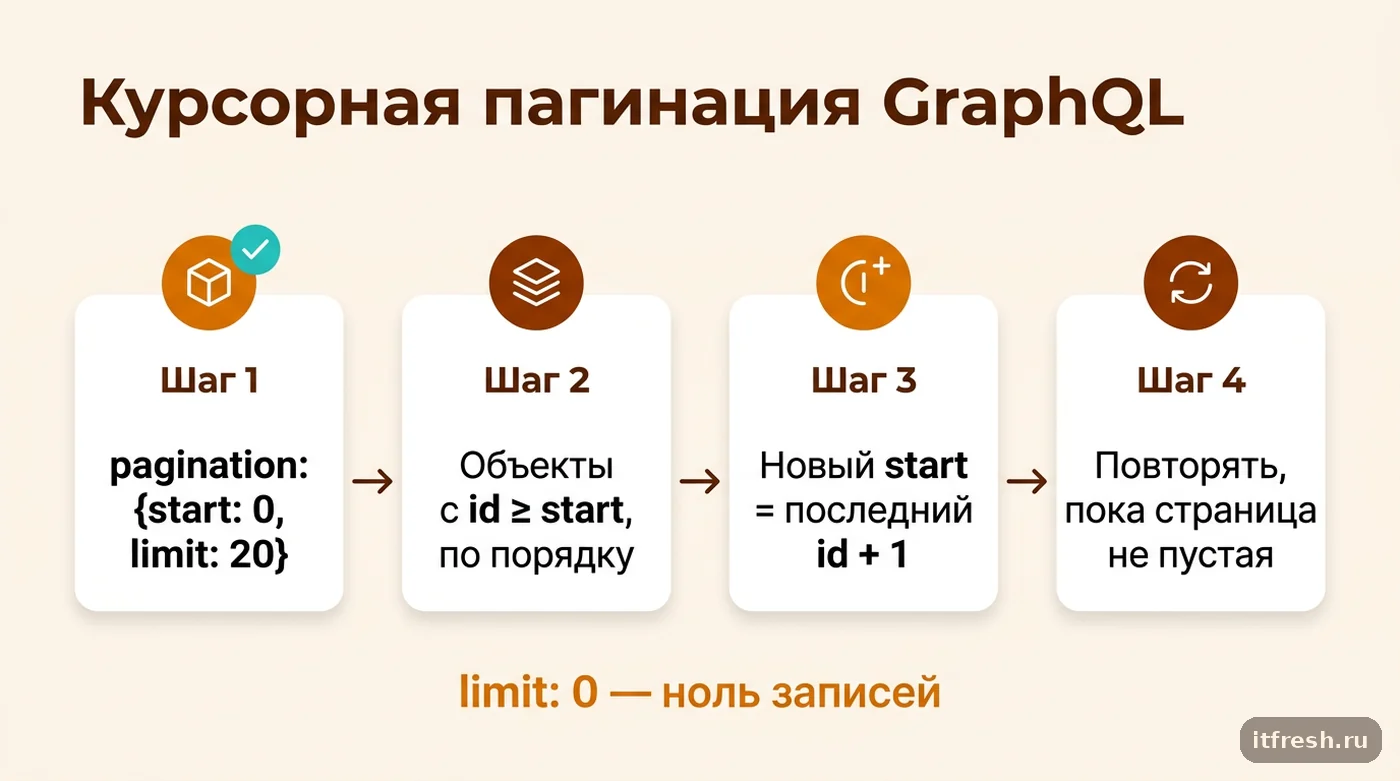
Правильный способ получить весь список через GraphQL при включённом MAX_PAGE_SIZE — курсорная пагинация по первичному ключу, которая появилась в NetBox 4.5.2 (3 февраля 2026 года, задача #21110). Синтаксис такой: device_list(pagination: {start: 0, limit: 20}) — сервер вернёт объекты с id не меньше указанного start, отсортированные по возрастанию первичного ключа, числом не больше limit. Чтобы получить следующую страницу, в качестве start берётся id последнего полученного объекта плюс один — и так до тех пор, пока страница не вернётся пустой.
Одна деталь, которая ломает автоматический обход GraphQL
Есть нюанс, который стоит проверить отдельно перед тем, как переписывать цикл обхода: поведение pagination: {limit: 0} в GraphQL отличается от ?limit=0 в REST. Если в конфигурации MAX_PAGE_SIZE снят (0 или None), запрос REST с ?limit=0 вернёт все объекты — а вот GraphQL-запрос с pagination: {limit: 0} в тех же условиях вернёт ноль записей. Это прямо противоположный REST результат при формально похожем параметре, и если код обхода писался по аналогии с REST, «оптимизация» через limit: 0 в GraphQL молча даст пустой ответ вместо полного.
Второй тонкий момент — что происходит, если лимит в GraphQL-запросе не указан. Пока MAX_PAGE_SIZE задан (по умолчанию 1000), запрос без limit получает до MAX_PAGE_SIZE записей — это и есть та самая «тихая» обрезка. Если же MAX_PAGE_SIZE снят (0 или None), поведение распадается на три случая: без аргумента pagination вообще сервер вернёт все записи; с pagination, но без limit, сработает умолчание библиотеки Strawberry Django, на которой построен GraphQL-слой NetBox, — 100 записей; а pagination: {limit: 0} вернёт ноль. То есть отсутствие пагинации в запросе — это не универсальный «дай всё», а поведение, зависящее от серверной конфигурации, которую вы, скорее всего, не контролируете, если работаете с чужим инстансом NetBox.
Кейс «Импульс медиа»: как это выглядело на практике
«Импульс медиа» — рекламное агентство, 31 рабочее место, у которого в NetBox заведена сеть офиса плюс стойка с презентационными серверами для клиентских демостендов — в сумме за полтора года набралось 132 устройства. Ко мне обратились с формулировкой «Zabbix не видит часть оборудования после обновления NetBox» — а скрипт автообнаружения незадолго до этого переписали с REST API на GraphQL, потому что так проще получать вложенные данные об интерфейсах одним запросом.
Быстро выяснилось: старый REST-скрипт честно обходил страницы через next и получал все объекты, а новый GraphQL-запрос device_list { id name interfaces { name } } писался без пагинации, пока NetBox стоял на 4.5.4, и тогда отдавал всё. Предыдущий подрядчик когда-то выставил MAX_PAGE_SIZE = 100, чтобы тяжёлые выгрузки из веб-интерфейса не клали маленькую виртуалку, — на REST-скрипт это не влияло, он просто делал больше запросов. После апгрейда до 4.6 тот же GraphQL-запрос начал упираться в эти 100 записей, и 32 устройства из 132 перестали долетать до мониторинга Zabbix через LLD. До того как это заметили, в мониторинге тихо не хватало примерно четверти устройств, включая один из презентационных серверов.
Исправление заняло меньше дня: переписал запрос на курсорную пагинацию pagination: {start, limit: 100} с циклом по возрастанию id, добавил сверку итогового количества с count, который отдельно запрашивается через REST, и вынес версию NetBox с датой апгрейда в комментарий к скрипту — чтобы следующий, кто будет трогать интеграцию, сразу видел, что GraphQL здесь без пагинации не работает начиная с определённой версии, а не полагался на память о том, как было раньше.
На практике таких интеграций у клиентов обычно две: экспорт в систему мониторинга (у кого-то это Zabbix, у кого-то — Uptime Kuma для простого self-hosted контроля доступности) и синхронизация с системой учёта или CMDB, похожая по логике на интеграцию Snipe-IT с Active Directory через REST API. Для REST-интеграций я всегда закладываю обход по next в самой первой версии кода синхронизации, даже если на момент внедрения устройств в NetBox меньше пятидесяти и проблема пагинации ещё не проявилась бы. Инвентарь растёт быстрее, чем кажется на старте проекта, и переписывать рабочий скрипт синхронизации, когда он молча недосчитался половины устройств на проде, — заметно дороже, чем сразу сделать правильно.
Для GraphQL я отдельно фиксирую версию NetBox, под которую написан код, и не полагаюсь на «запрос без пагинации вернёт всё» как на постоянное поведение — особенно если клиент когда-либо будет обновлять NetBox самостоятельно, без согласования со мной. Курсорная пагинация по id, появившаяся в 4.5.2, — единственный способ, который работает предсказуемо независимо от значения MAX_PAGE_SIZE на сервере, и именно её я закладываю в интеграции по умолчанию, а не полагаюсь на неограниченный ответ, который может исчезнуть после следующего апгрейда.
Чек-лист: как проверить, что вы получаете все объекты
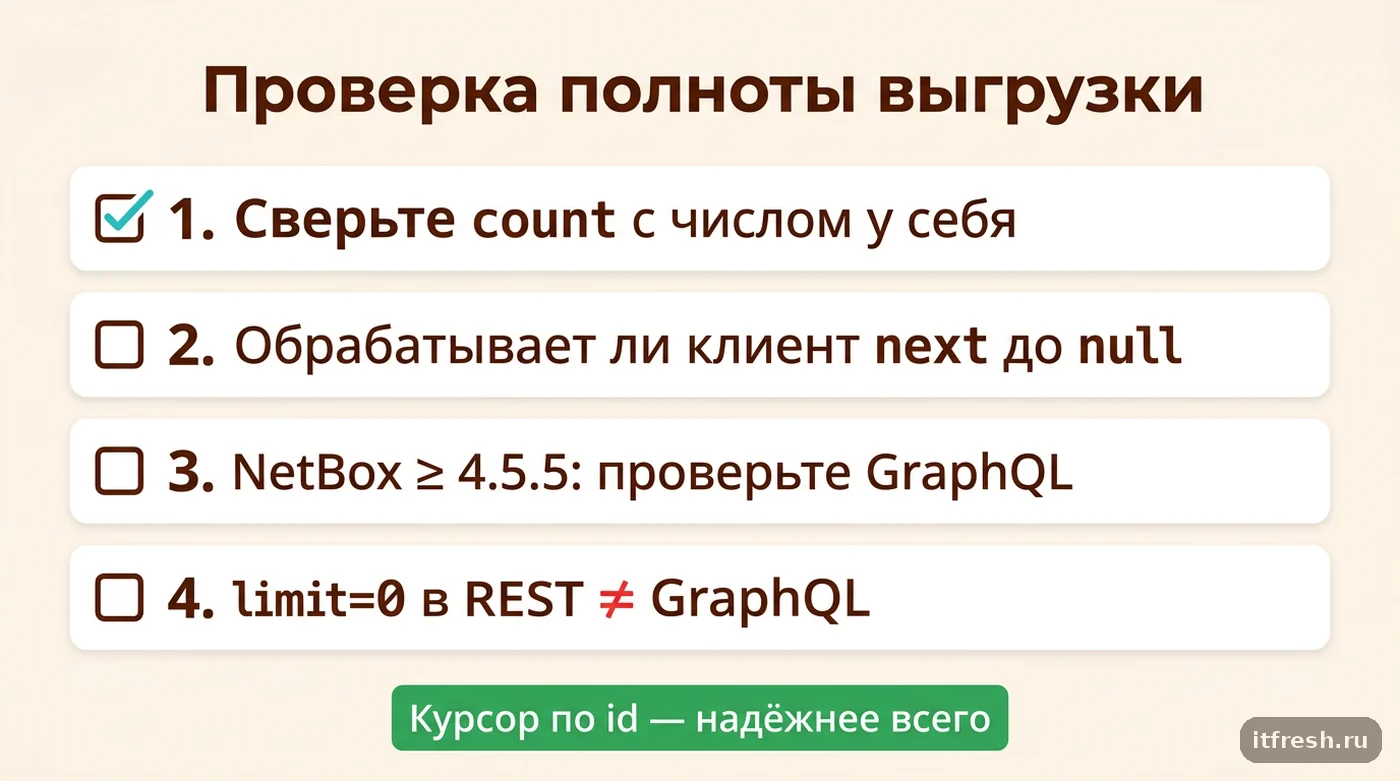
Если подозреваете, что интеграция читает не весь инвентарь, начните с прямого сравнения: запросите count из первого ответа REST API (или посчитайте объекты через веб-интерфейс NetBox) и сравните с тем, сколько объектов реально долетает до вашей внешней системы. Разница почти всегда означает, что клиент не обрабатывает next и останавливается на первой странице — чаще всего это 50 объектов, значение PAGINATE_COUNT по умолчанию, если администратор его не менял. Если скрипт уже работает в курсорном режиме REST (?start=), count там равен null — общее число берите обычным запросом вида ?limit=1.
Дальше проверьте, какая версия NetBox стоит на сервере — это видно в интерфейсе или в ответе GET /api/status/ (поле netbox-version) — и если она 4.5.5 или новее, отдельно протестируйте все GraphQL-запросы без явной пагинации: они больше не гарантируют полный список. И последнее — не переносите привычки REST на GraphQL вслепую: limit=0 в REST и pagination: {limit: 0} в GraphQL дают противоположный результат, и это стоит проверить один раз на тестовом окружении, а не выяснить на проде.
- REST: страница по умолчанию — PAGINATE_COUNT = 50; жёсткий потолок — MAX_PAGE_SIZE = 1000.
- REST: `?limit=0` отдаёт всё, только если MAX_PAGE_SIZE снят на сервере (0 или None).
- REST: используйте `?fields=` или `brief=true`, чтобы не тянуть лишние данные на каждой странице.
- GraphQL с 4.5.5: MAX_PAGE_SIZE действует и здесь, даже без явной пагинации в запросе.
- GraphQL: правильный обход — курсор по id, `pagination: {start, limit}`, появился в 4.5.2; в REST курсор `?start=` есть с 4.6.0.
- GraphQL: `pagination: {limit: 0}` — это ноль записей, а не «всё», в отличие от REST.
Частые вопросы
Почему скрипт получает только 50 устройств из NetBox?
Потому что REST API отдаёт списки страницами, и без явного увеличения limit или обработки next клиент видит только первую страницу — по умолчанию PAGINATE_COUNT равен 50 объектам.
Как получить сразу весь список через REST API?
Запросить `?limit=0` — но это сработает только если на сервере снят MAX_PAGE_SIZE (0 или None). Если MAX_PAGE_SIZE оставлен по умолчанию (1000), вы всё равно получите не больше 1000 объектов за один запрос и должны обходить остальные страницы через поле next.
Что изменилось в GraphQL с версии 4.5.5?
До 4.5.4 включительно MAX_PAGE_SIZE не действовал на списочные GraphQL-запросы (баг #20385) — они могли вернуть весь список без ограничений. С 4.5.5 MAX_PAGE_SIZE ограничивает и GraphQL, включая запросы без явной пагинации.
Как правильно обходить большой список через GraphQL после этого изменения?
Курсорной пагинацией по первичному ключу, появившейся в NetBox 4.5.2: pagination: {start: N, limit: M}. Для следующей страницы start берётся равным id последнего полученного объекта плюс один.
Чем pagination: {limit: 0} в GraphQL отличается от ?limit=0 в REST?
Прямо противоположным поведением: ?limit=0 в REST при снятом MAX_PAGE_SIZE отдаёт все объекты, а pagination: {limit: 0} в GraphQL в тех же условиях возвращает ноль записей.
Как уменьшить объём ответа, если нужны не все поля объекта?
В REST API — параметром ?fields=id,name,status для выбора конкретных полей, ?brief=true для краткого представления или omit для исключения отдельных тяжёлых полей из полного ответа.
Источники
- NetBox Labs Docs — REST API Overview — PAGINATE_COUNT = 50 по умолчанию, MAX_PAGE_SIZE = 1000 по умолчанию, поведение ?limit=0, структура ответа count/next/previous/results, параметры fields/brief/omit: https://netboxlabs.com/docs/netbox/integrations/rest-api/
- NetBox Labs Docs — GraphQL API Overview — Курсорная пагинация pagination: {start, limit} по первичному ключу, действие MAX_PAGE_SIZE (по умолчанию 1000) на GraphQL, поведение pagination: {limit: 0} и запроса без пагинации: https://netboxlabs.com/docs/netbox/integrations/graphql-api/
- GitHub Issues #20385 и #21935 — MAX_PAGE_SIZE и GraphQL — #20385 (bug, NetBox 4.4.1, milestone v4.5.5): MAX_PAGE_SIZE не применялся к GraphQL; #21935 (documentation, milestone v4.5.9, закрыт PR #21940): до 4.5.4 базовые list-запросы GraphQL неограничены, с 4.5.5 — режутся до MAX_PAGE_SIZE: https://github.com/netbox-community/netbox/issues/20385 , https://github.com/netbox-community/netbox/issues/21935
- NetBox Labs Blog — NetBox 4.5.2: Significant Performance Improvements for Scale — Появление курсорной пагинации в GraphQL в версии 4.5.2, обоснование перехода с offset-пагинации на курсорную по производительности: https://netboxlabs.com/blog/netbox-4-5-2-significant-performance-improvements-scale/
- NetBox Labs Docs — Release Notes, version 4.5 — v4.5.2 (2026-02-03) — #21110 курсорная пагинация в GraphQL; v4.5.5 (2026-03-17) — #20385 «Enforce MAX_PAGE_SIZE limit for GraphQL API requests»: https://netboxlabs.com/docs/netbox/release-notes/version-4.5/
- NetBox Release Notes — v4.6 — v4.6.0 (2026-05-05) — #21363 курсорная пагинация REST API через параметр start; актуальный релиз 4.6.10 (2026-09-01): https://netboxlabs.com/docs/netbox/release-notes/version-4.6/