
Карантин mailcow выдаёт Deadlock 1213 при обучении на спаме, хотя healthcheck зелёный
Если в карантине mailcow массовая операция «Toggle all → Learn as spam and delete» иногда обрывается ошибкой PDOException SQLSTATE[40001]: Deadlock found, а watchdog в это же время показывает MySQL/MariaDB здоровым на 100 %, — это не повод паниковать и разворачивать бэкап. Разбираю, что означает код 1213 в MariaDB, почему healthcheck и deadlock не противоречат друг другу, разбираю известный баг-репорт по этой ошибке и показываю, как посмотреть подробности конкретной взаимоблокировки через InnoDB.
Симптом: массовая очистка карантина падает с Deadlock, а watchdog зелёный
Ситуация чаще всего повторяется так: администратор открывает карантин в панели корпоративной почты на mailcow, выделяет через «Toggle all» разом десятки или сотни писем, помеченных как спам, и нажимает «Learn as spam and delete», чтобы одновременно обучить Rspamd и очистить карантин. Операция иногда падает с ошибкой вида PDOException: SQLSTATE[40001]: Serialization failure: 1213 Deadlock found when trying to get lock, при этом часть писем успевает удалиться, а часть — нет, и непонятно, что теперь в каком состоянии.
Первая реакция — проверить состояние базы через watchdog: в mailcow это отдельный контейнер, который постоянно следит за здоровьем сервисов и пишет статус в лог и в UI. И тут появляется второй, более пугающий симптом — watchdog в этот же момент показывает MySQL/MariaDB полностью здоровым, без единого предупреждения. Возникает ощущение, что ошибка какая-то «из ниоткуда»: мониторинг молчит, а операция в интерфейсе падает.
Почему healthcheck зелёный, а Deadlock всё равно происходит
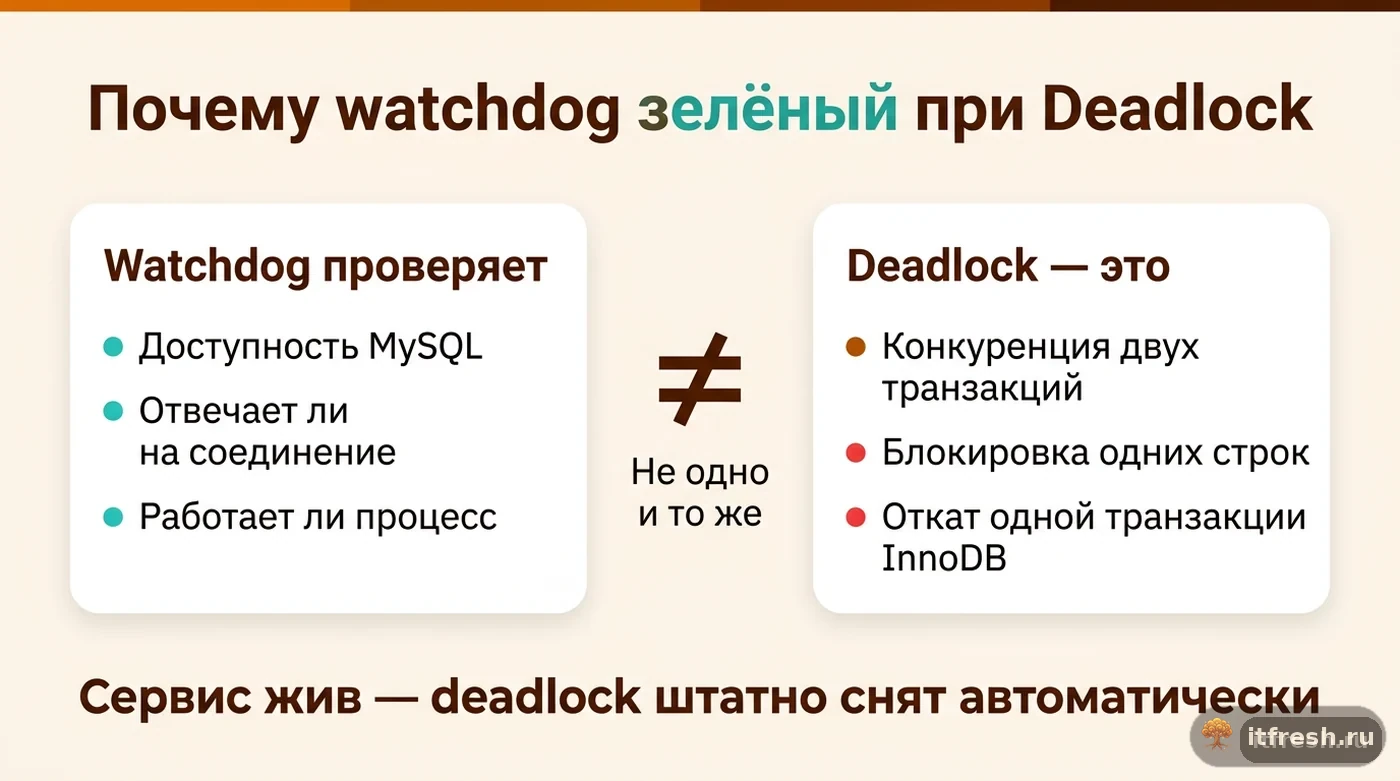
Формальное противоречие снимается, если понимать, что именно проверяет watchdog и что означает код 1213. Watchdog в mailcow проверяет доступность и общую работоспособность сервиса — отвечает ли MariaDB на соединение, принимает ли базовые запросы, не упал ли процесс. Deadlock — это не поломка сервиса и не недоступность базы, а штатный, предусмотренный механизм InnoDB: когда две транзакции одновременно пытаются заблокировать одни и те же строки в разном порядке и упираются друг в друга, InnoDB детектирует взаимную блокировку и принудительно откатывает одну из транзакций с ошибкой 1213, чтобы вторая могла продолжить работу. Сервис при этом полностью жив и здоров — просто одна из двух параллельных операций не смогла завершиться с первой попытки. Это принципиально другая ситуация, чем повреждение InnoDB после аварии сервера — там данные действительно требуют восстановления, а не просто повторной попытки той же операции.
Применительно к карантину mailcow это означает: при массовом «Toggle all → Learn as spam and delete» на десятках писем PHP-код панели (functions.quarantine.inc.php) удаляет записи из таблицы quarantine пачкой, а с этой же таблицей в фоне работают другие участники: скрипт уведомлений о карантине quarantine_notify.py в контейнере dovecot-mailcow, который по расписанию читает таблицу, и очистка старых записей сверх лимита на ящик. В обсуждении issue #6361 разработчик mailcow прямо предположил, что таблицу блокирует именно запрос скрипта уведомлений, а участники нашли медленные запросы: выборку по SHA2(CONCAT(id, qid), 256), которая пересчитывает хэш для всех строк, и DELETE … NOT IN (…) при очистке. Чем больше записей в карантине, тем дольше эти транзакции держат блокировки и тем выше шанс, что массовое удаление из панели упрётся в них, — тогда MariaDB честно откатывает одну из сторон. Это ожидаемое поведение реляционной базы под конкурентной нагрузкой, а не признак деградации сервиса — именно поэтому watchdog, который проверяет доступность, а не факт единичного отката транзакции, остаётся зелёным. Похожий механизм есть и у серийных сбоев транзакций в PostgreSQL — там ошибка называется иначе, но суть та же: конкурирующие транзакции, а не поломка базы.
Известный баг-репорт: issue #6361 на mailcow 2025-02
Эта ошибка задокументирована в официальном трекере mailcow-dockerized как issue #6361: пользователь на версии mailcow 2025-02 получал ровно SQLSTATE[40001]: Serialization failure: 1213 Deadlock found when trying to get lock именно при действии «Toggle all → Learn as spam and delete» в карантине. Ошибка воспроизводилась в файле /web/inc/functions.quarantine.inc.php — это тот самый код, который обрабатывает массовое действие над отмеченными письмами. Окружение автора репорта: Debian Bullseye, 64 ГБ RAM, 12 ядер, Docker 28.0.1, docker-compose 2.33.1, без ограничений SELinux/AppArmor — то есть не редкое, экзотическое окружение, а достаточно типичный сервер.
Issue помечен метками bug и unconfirmed, а в октябре 2025 года закрыт автоматически за неактивностью — без исправления в коде. Разработчик не смог воспроизвести ошибку у себя, зато в обсуждении нашлась закономерность: у всех пострадавших большие таблицы карантина — 20–30 тысяч записей на сервер. Участники сообщали, что ошибка ловится примерно в 3–5 % операций и не ушла после обновления до 2025-03b, а увеличение innodb_buffer_pool_size со штатных 24M (так он задан в data/conf/mysql/my.cnf mailcow) до 4G сделало её редкой, но не убрало совсем. Предложенный сообществом PR #6556 с отдельной колонкой qhash вместо пересчёта SHA2 закрыт без слияния. Автор репорта отметил важную практическую деталь: ошибка не блокирует операцию полностью — повторный запуск того же самого действия «Learn as spam and delete» в одну-две попытки обычно завершает удаление успешно. Это соответствует природе deadlock: откатывается конкретная транзакция в конкретный момент конкуренции за блокировку, а не сама возможность выполнить операцию.
Статус unconfirmed и закрытие за неактивностью стоит воспринимать не как «бага нет», а как «ошибку видели несколько администраторов на крупных инсталляциях, но команда mailcow не воспроизвела её в своём окружении и не локализовала конкретный код». Для администратора это на практике означает одно: ждать официального фикса в ближайшем релизе не стоит закладывать в план — разумнее сразу принять поведение «иногда повторить операцию» как рабочий процесс, а не как временную заглушку до патча.
Совпадение по времени с обновлением MariaDB 10.5 → 10.11
Релиз mailcow 2025-02, на котором зафиксирован баг-репорт, — тот же релиз, в котором вышло крупное обновление базы данных: MariaDB обновилась с 10.5 до 10.11 (LTS-ветка). В официальном анонсе релиза это обновление выделено отдельно и с двумя жёсткими предупреждениями: вручную менять версию MariaDB в docker-compose.yml нельзя — это может привести к повреждению базы, если код не адаптирован под нужную версию, а откат обратно на 10.5 после миграции на 10.11 в принципе невозможен. Формально issue #6361 напрямую не связывает Deadlock с этим обновлением, но совпадение версии релиза наводит на мысль, что стоит проверить именно это направление, если проблема появилась не сразу, а после апдейта.
Практический вывод для администратора: если Deadlock 1213 в карантине появился сразу после планового обновления mailcow, стоит зафиксировать в заметках, что это могло совпасть с переходом на MariaDB 10.11, и не пытаться откатить версию базы вручную — согласно предупреждению самого проекта, обратного пути после миграции нет, а ручное редактирование docker-compose.yml без понимания, что именно поменялось в схеме и движке, рискует данными куда сильнее, чем единичный deadlock при массовой операции.
Между мажорными версиями движка InnoDB нередко меняются внутренние детали планирования блокировок, даже если внешне таблицы и код приложения не изменились ни на строку, — это достаточно распространённая причина, почему поведение под конкурентной нагрузкой «вдруг» становится заметнее именно после апдейта СУБД, а не после изменений в самом mailcow. Я не стал бы тратить время на доказательство точной причинно-следственной связи между конкретной строчкой в changelog MariaDB и конкретным deadlock в карантине — для практической работы администратора достаточно знать сам факт совпадения по времени и относиться к нему как к поводу для наблюдения, а не как к точно установленной причине.
Как посмотреть детали конкретной взаимоблокировки через InnoDB
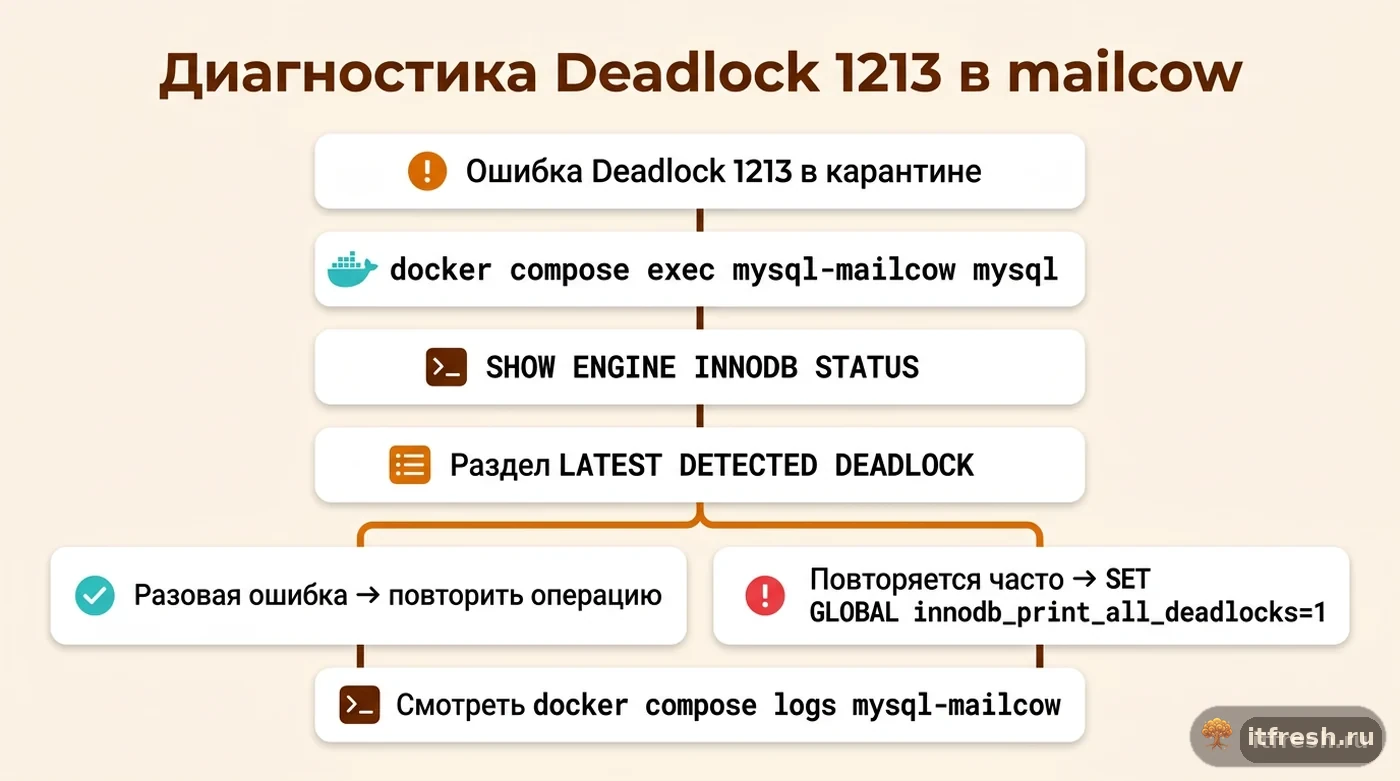
Если хочется не просто принять факт deadlock, а понять, какие именно транзакции столкнулись, в MariaDB есть штатная диагностика — команда SHOW ENGINE INNODB STATUS, выполненная сразу после ошибки (её данные не хранятся долго, старая информация о взаимоблокировке перезаписывается новой). Подключиться к базе mailcow из каталога mailcow-dockerized можно так (для SHOW ENGINE INNODB STATUS и SET GLOBAL нужны права, которых у пользователя DBUSER может не быть, поэтому я захожу под root с паролем DBROOT из mailcow.conf):
source mailcow.conf
docker compose exec mysql-mailcow mysql -uroot -p${DBROOT} ${DBNAME}
а внутри выполнить:
SHOW ENGINE INNODB STATUS\GВ выводе нужен раздел LATEST DETECTED DEADLOCK — согласно документации MariaDB, он показывается только если взаимоблокировка действительно была зафиксирована, и содержит участвовавшие транзакции, выполнявшиеся операторы, какие блокировки были удержаны и какие запрошены каждой стороной, а также какая именно транзакция была откачена для разрешения конфликта.
Проблема в том, что раздел LATEST DETECTED DEADLOCK хранит только самую последнюю взаимоблокировку — если между падением операции в панели и вашим подключением к базе произошёл ещё один deadlock (в том числе не связанный с карантином), нужные детали будут уже перезаписаны. Для системной диагностики, а не разовой проверки, в MariaDB есть системная переменная innodb_print_all_deadlocks — по умолчанию она выключена (0/OFF), а включённая заставляет сервер писать полную информацию о каждой обнаруженной взаимоблокировке в лог ошибок MariaDB, а не только хранить последнюю в памяти. Переменная динамическая, так что включить её можно без перезапуска: SET GLOBAL innodb_print_all_deadlocks=1; — и дальше искать deadlock не через SHOW ENGINE INNODB STATUS вручную после каждой жалобы, а в логе контейнера docker compose logs mysql-mailcow. Учтите две вещи: после перезапуска контейнера значение вернётся к 0 (для постоянного включения строку innodb_print_all_deadlocks = 1 добавляют в data/conf/mysql/my.cnf), а в штатном my.cnf mailcow стоит log-warnings = 0 — после включения сразу проверьте, что записи о взаимоблокировках действительно появляются в логе в вашей версии.
Кейс «Дебютный код»: восемь рабочих мест, но карантин рос быстрее, чем чистился
Клиент — компьютерная школа «Дебютный код», всего 8 рабочих мест, у которой mailcow развёрнут с нуля силами приглашённого администратора ещё до нашего подключения к проекту, но с активной рекламной рассылкой для родителей учеников, из-за которой в карантин ежедневно попадало по 30–60 писем, помеченных Rspamd как вероятный спам. Предыдущий администратор поднял лимит хранения карантина на ящик до максимума «чтобы ничего не терялось», и к моменту нашего подключения в таблице quarantine лежало около 9 тысяч записей — при штатных 24M буферного пула InnoDB. Администратор школы — по совместительству один из преподавателей — раз в несколько дней заходил и чистил карантин через «Toggle all → Learn as spam and delete» одним махом на все накопившиеся письма. Именно на этих массовых операциях, а не на единичном удалении одного письма, стабильно раз в одну-две недели появлялась ошибка Deadlock 1213, и часть писем оставалась висеть в карантине, вызывая у администратора устойчивое ощущение, что «карантин иногда глючит».
Разбор занял немного времени, потому что ситуация точно совпадала с описанием issue #6361: версия mailcow у клиента была обновлена как раз до 2025-02 незадолго до появления жалоб. Проверили здоровье сервиса через watchdog — зелёный, как и ожидалось; выполнили SHOW ENGINE INNODB STATUS сразу после воспроизведения ошибки и увидели в LATEST DETECTED DEADLOCK две конкурирующие транзакции на таблице карантина с пересекающимися блокировками строк — то есть подтвердили, что это классический конкурентный deadlock, а не повреждение данных. Решение было практическим, а не «патчем»: администратору дали инструкцию при ошибке просто повторить «Learn as spam and delete» ещё раз — по опыту issue и по собственной проверке, повтор почти всегда проходит без ошибки — и дополнительно предложили чистить карантин меньшими порциями по 10–15 писем, а не одним махом на полсотни, чтобы снизить саму вероятность конкуренции за блокировки. Вторым шагом вернули разумный лимит хранения карантина на ящик — таблица за две недели ужалась до полутора тысяч записей — и подняли innodb_buffer_pool_size в data/conf/mysql/my.cnf с 24M до 512M: памяти на сервере хватало с запасом. За следующие два месяца ошибка всплыла один раз и прошла со второго нажатия.
Чек-лист: что делать при Deadlock 1213 в карантине mailcow
Первое — не паниковать и не запускать восстановление из бэкапа: единичный deadlock не повреждает базу, это встроенный механизм разрешения конкуренции за блокировки в InnoDB. Второе — проверить статус MySQL/MariaDB через watchdog: если он зелёный, это ожидаемо и не противоречит факту deadlock, сервис жив, просто одна транзакция была откачена. Третье — повторить то же самое действие «Learn as spam and delete» ещё раз: по опыту issue #6361 и практике на клиентских инсталляциях, одна-две повторные попытки почти всегда завершаются успешно.
Если ошибка повторяется регулярно на одном и том же типе массовой операции, стоит подтвердить диагноз через SHOW ENGINE INNODB STATUS сразу после воспроизведения — найти раздел LATEST DETECTED DEADLOCK и убедиться, что участвуют именно ожидаемые таблицы карантина, а не что-то постороннее. Для систематического наблюдения имеет смысл временно включить innodb_print_all_deadlocks=1 и смотреть лог docker compose logs mysql-mailcow за период жалоб. И последнее — если Deadlock появился сразу после обновления mailcow, зафиксировать это в заметках на будущее: репорт по этой проблеме привязан к релизу 2025-02, который одновременно поднял MariaDB с 10.5 до 10.11, и это совпадение стоит иметь в виду при похожих жалобах после апдейта.
Частые вопросы
Что означает ошибка SQLSTATE[40001] Deadlock found в карантине mailcow?
Это штатный механизм InnoDB: когда две транзакции одновременно блокируют одни и те же строки в разном порядке, MariaDB детектирует взаимоблокировку и откатывает одну из транзакций с кодом 1213, чтобы вторая могла продолжить работу. Данные при этом не повреждаются.
Почему watchdog показывает MySQL здоровым, если возникла ошибка Deadlock?
Watchdog проверяет доступность и общую работоспособность сервиса, а не факт единичного отката транзакции. Deadlock — не сбой сервиса, а нормальная реакция на конкуренцию за блокировки, поэтому healthcheck остаётся зелёным.
Это известный баг mailcow?
Есть баг-репорт issue #6361 в трекере mailcow-dockerized на версии 2025-02, с тем же симптомом при действии Toggle all → Learn as spam and delete. Issue помечен как unconfirmed и в октябре 2025 года закрыт за неактивностью без исправления; в обсуждении ошибку связывают с большими таблицами карантина (20–30 тысяч записей).
Что делать сразу после ошибки Deadlock 1213 в карантине?
Повторить то же действие ещё раз. По опыту issue #6361 и практике, одна-две повторные попытки массового Learn as spam and delete почти всегда завершаются успешно — восстанавливать базу из бэкапа не требуется.
Как посмотреть подробности конкретной взаимоблокировки в MariaDB?
Сразу после ошибки выполнить SHOW ENGINE INNODB STATUS\G и найти раздел LATEST DETECTED DEADLOCK — там перечислены участвовавшие транзакции, выполнявшиеся операторы, удержанные и запрошенные блокировки. Раздел хранит только самую последнюю взаимоблокировку, старая информация перезаписывается.
Связан ли Deadlock 1213 с обновлением MariaDB 10.5 → 10.11 в релизе 2025-02?
Прямая связь не подтверждена: автор заметил ошибку после этого обновления, но разработчик не смог её воспроизвести, а участники обсуждения связали её скорее с размером таблицы карантина. Откатывать версию базы вручную нельзя — согласно анонсу mailcow, после миграции на 10.11 обратного пути на 10.5 нет.
Источники
- GitHub mailcow/mailcow-dockerized — Issue #6361 — Симптом SQLSTATE[40001] 1213 Deadlock при Toggle all → Learn as spam and delete на mailcow 2025-02, functions.quarantine.inc.php, окружение (Debian Bullseye, Docker 28.0.1, compose 2.33.1), метки bug/unconfirmed, закрыт 07.10.2025 за неактивностью; в комментариях — таблицы 20–30 тыс. записей, quarantine_notify.py, innodb_buffer_pool_size 24M→4G, PR #6556 (qhash, закрыт без слияния). https://github.com/mailcow/mailcow-dockerized/issues/6361
- mailcow.email — Release 2025-02 — Обновление MariaDB с 10.5 до 10.11 (LTS), предупреждение о запрете ручной правки версии в docker-compose.yml и о необратимости миграции. https://mailcow.email/posts/2025/release-2025-02/
- MariaDB Documentation — SHOW ENGINE INNODB STATUS — Раздел LATEST DETECTED DEADLOCK: состав информации (транзакции, операторы, блокировки, откат) и условие появления только при зафиксированной взаимоблокировке. https://mariadb.com/docs/server/reference/sql-statements/administrative-sql-statements/show/show-engine-innodb-status
- mailcow docs — Attach to a Container — Способ подключения к mysql-mailcow через docker compose exec с переменными из mailcow.conf (source mailcow.conf). https://docs.mailcow.email/troubleshooting/debug-attach_service/