
Как оценивать работу IT-подрядчика: метрики и отчёт, который стоит требовать раз в месяц
Хороший отчёт IT-аутсорсера умещается на двух страницах и содержит восемь цифр: заявки и просрочки, время реакции и решения, повторные обращения, доступность 1С и почты, бэкапы с тестовым восстановлением, патчи, антивирус и инциденты. Ниже — шаблон, способ проверить цифры самому и разбор живого отчёта.
Какие KPI IT аутсорсинга считать и что должно быть в ежемесячном отчёте
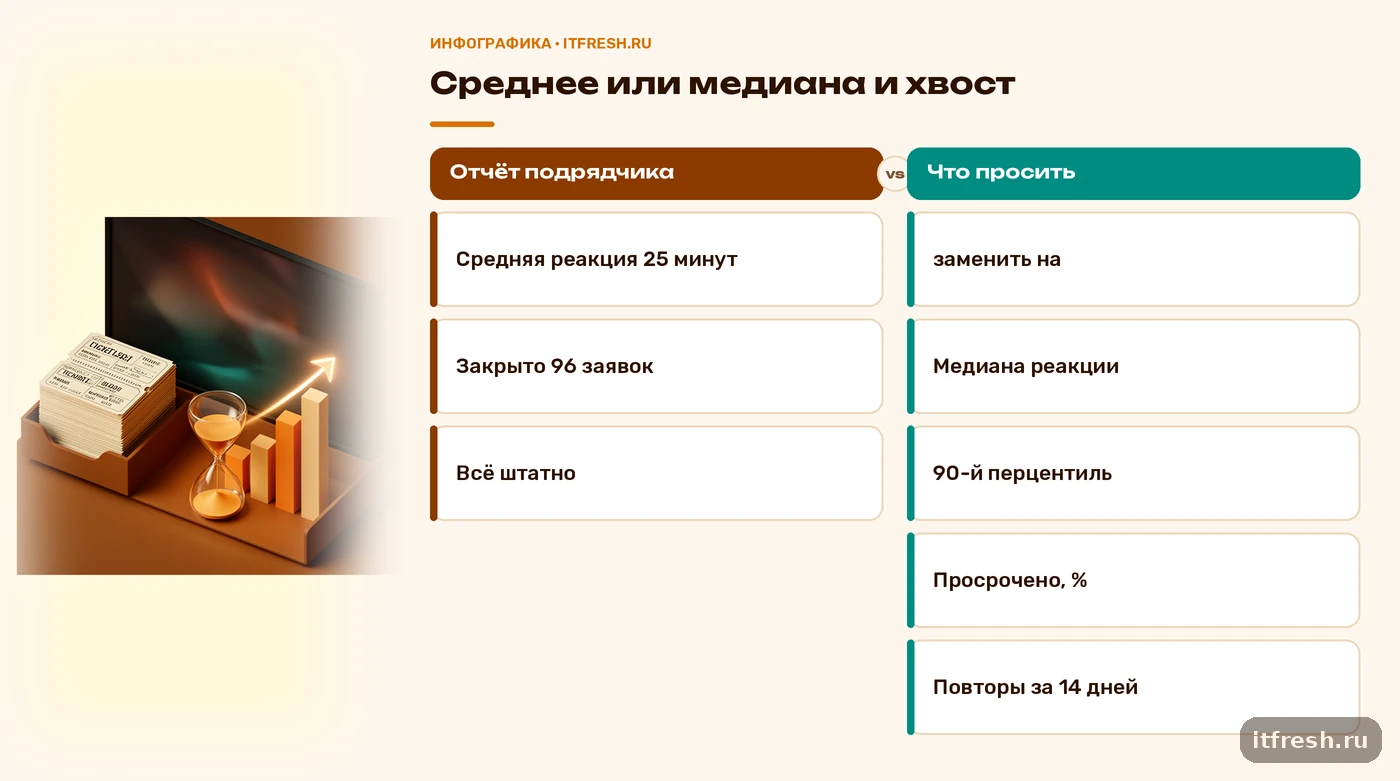
Начну с неприятного: большинство отчётов, которые я вижу у директоров, это одна фраза вроде «в сентябре закрыто 96 заявок, все системы работают штатно». Из неё нельзя понять ничего. Девяносто шесть заявок это много или мало для 42 рабочих мест? Сколько из них висело неделю? Что значит «штатно» и кто это измерял? Если вы платите за IT-аутсорсинг для компании до 50 рабочих мест ежемесячную абонентскую плату, вы вправе получать за неё не пересказ, а измерения.
Я требую от подрядчика (и сам отдаю клиентам) отчёт из восьми блоков. Первый: заявки — поступило, закрыто, осталось в работе, просрочено. Второй: время реакции и время решения по приоритетам. Третий: доля повторных обращений, то есть заявок, которые пришлось открывать заново. Четвёртый: доступность ключевых сервисов в процентах за месяц. Пятый: резервные копии — сколько заданий прошло успешно и когда последний раз проверяли восстановление. Шестой: обновления Windows. Седьмой: антивирус. Восьмой: инциденты с разбором причин и список плановых работ.
Что в этом списке сознательно отсутствует? Количество «обслуженных» компьютеров, часы, потраченные инженерами, и «индекс удовлетворённости», который подрядчик сам себе нарисовал. Часы показывают загрузку подрядчика, а не качество для вас. Если у вас фиксированный абонемент, они вообще ничего не говорят о результате. Опрос сотрудников полезен, но как дополнение раз в квартал, а не как главный KPI: на 42 человека одна обиженная бухгалтерша двигает оценку на несколько процентов.
- Заявки: поступило, закрыто, в работе, просрочено — цифрами и в процентах от поступивших.
- Реакция и решение: медиана и «хвост» (90-й перцентиль) отдельно по критичным и обычным заявкам.
- Повторные обращения: доля заявок, открытых заново или продублированных по той же причине.
- Доступность: 1С, почта, файловый сервер, интернет — в процентах к согласованному графику работы.
- Резервные копии: успешные задания, размер, дата последнего тестового восстановления.
- Патчи: сколько серверов и рабочих мест отстаёт от актуального состояния и на сколько дней.
- Антивирус: активная защита, свежесть сигнатур, найденные угрозы за месяц.
- Инциденты и плановые работы: что сломалось, почему, что сделано, чтобы не повторилось.
Заявки, время реакции и решения: как читать цифры подрядчика
Самая частая подмена в отчётах — среднее время. «Средняя реакция 25 минут» звучит отлично, пока вы не узнаете, что девять заявок из десяти закрыты за 10 минут (смена пароля, сброс принтера), а десятая — когда у кассира не работала касса — ждала три часа. Среднее прячет именно то, что вас волнует. Поэтому я прошу два числа: медиану (половина заявок быстрее этого значения) и 90-й перцентиль (девять из десяти заявок уложились в это время). Если разрыв между ними больше пяти-шести раз, у подрядчика проблема с очередью, а не со скоростью работы.
Второе правило: реакция и решение считаются отдельно и по приоритетам. Реакция — это когда инженер ответил и взял заявку, решение — когда проблема устранена. Подрядчик может отвечать за две минуты и решать заявку неделю, и это всё равно будет честная «реакция». Как прописывать приоритеты и сроки в самом договоре, я разбирал в статье про SLA с IT-аутсорсером. Здесь важно другое: отчёт должен показывать факт против этих договорных цифр, в одной таблице, чтобы вы не сравнивали руками.
Третий показатель, который почти никто не просит, а зря, — повторные обращения. Если у сотрудника в июне «пропал сетевой диск», в июле «пропал сетевой диск», а в августе «опять пропал», подрядчик закрыл три заявки и не решил ни одной проблемы. Закрытие по формальному признаку — главный способ улучшить статистику без улучшения работы. Я считаю долю заявок, по которым в течение 14 дней пришло обращение с тем же симптомом от того же пользователя. Здоровая цифра для небольшой компании — единицы процентов; когда она выходит за 10–15 %, пора разбирать причины, а не премировать за скорость.
- Просили среднее — просите медиану и 90-й перцентиль.
- Просили «закрыто» — просите «решено без повторов в течение 14 дней».
- Просили общую статистику — просите разбивку по приоритетам и по системам (1С, почта, рабочие места).
Доступность сервисов: как получить цифру из мониторинга, а не из слов
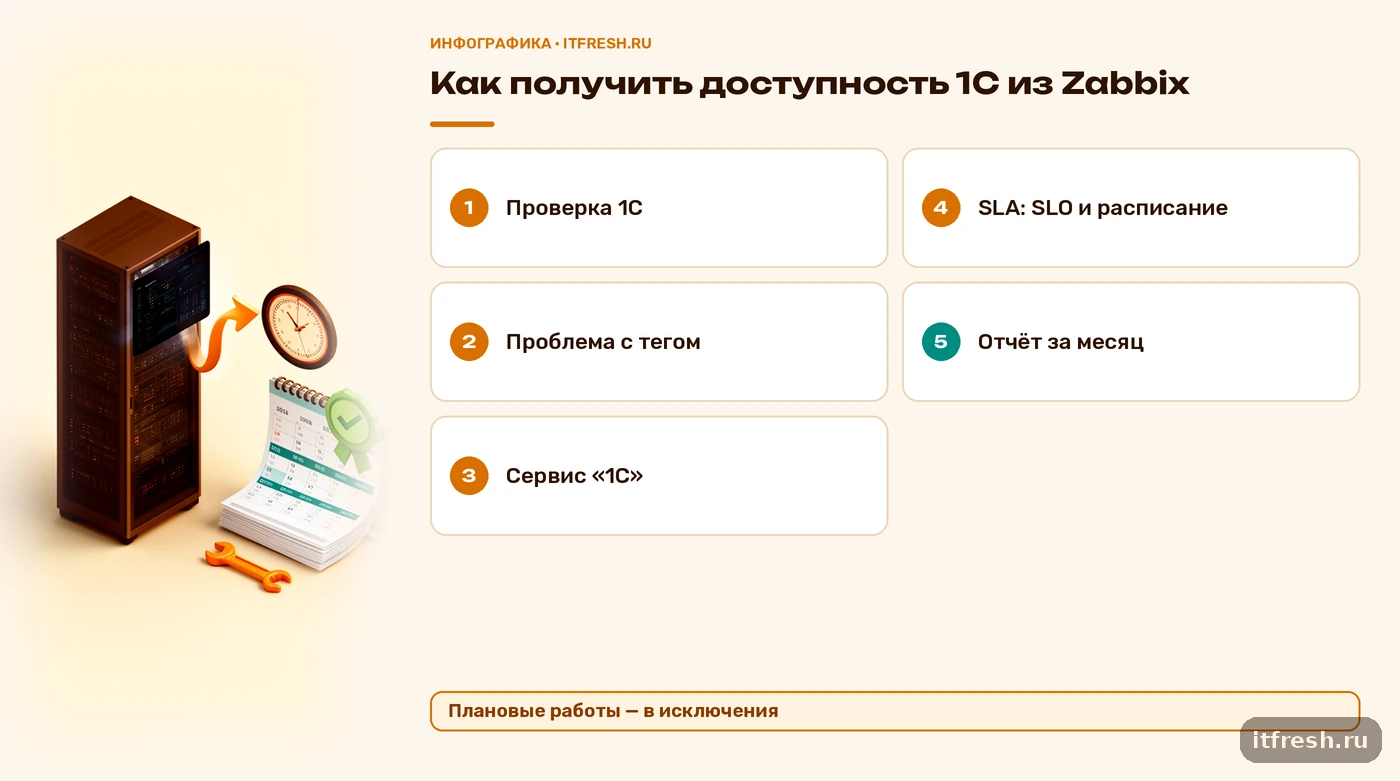
Фраза «серверы работали стабильно» не измеряется. Доступность в процентах — измеряется, но только если есть система мониторинга, которой подрядчик не может управлять в одиночку. Идеально, когда мониторинг стоит у вас или хотя бы у вас есть к нему просмотр. В Zabbix для этого есть готовый механизм: раздел Services, где сервисы получают статус из проблем (триггеров), привязанных тегами, и раздел SLA, который считает долю времени, когда сервис был в норме. Устройство тегов и дерева сервисов описано в документации Zabbix, а о регламенте самого мониторинга я писал в статье про эксплуатацию Zabbix.
Что настраивается в SLA в Zabbix по документации: целевое значение SLO в процентах, отчётный период (день, неделя, месяц, квартал или год), часовой пояс, расписание — круглосуточное или своё, например будни с 08:00 до 20:00, дата начала действия, теги сервисов и исключённые простои. Последнее важно для споров: плановые работы по согласованному окну вносятся в исключения и не портят цифру, а вот внеплановая перезагрузка в рабочее время портит. Результат можно вывести на дашборд виджетом SLA report: в нём выбирают SLA, сервис и период, а число показываемых периодов по умолчанию равно 20.
Теперь о подводных камнях. Доступность 99,5 % в месяц звучит солидно, но посчитайте в часах: в расписании «пн–пт, 8–20» (около 22 рабочих дней по 12 часов, 264 часа) это примерно 1,3 часа допустимого простоя в месяц, в расписании «ежедневно, 8–20» (360 часов) — около 1,8 часа, а в круглосуточном (720 часов) — около 3,6 часа. Считайте внутри того графика, который вам реально важен, и фиксируйте его в договоре. И ещё: сервис должен проверяться осмысленно. Пинг сервера 1С не равен доступности 1С; нужна проверка порта или самого приложения. Подрядчик, который показывает вам «uptime ОС 100 %», когда пользователи сидели без базы, не врёт, а измеряет не то.
- Сервис = то, что нужно бизнесу (1С, почта, файлы, интернет), а не отдельный сервер.
- Расписание SLA совпадает с рабочим временем компании, а не с календарным месяцем целиком.
- Плановые работы — в исключённых простоях и согласованы заранее, а не задним числом.
Бэкапы, патчи, антивирус: проверочные KPI, которые легко проверить самому
Эти три блока отчёта — про отсутствие проблем, поэтому именно их подрядчики любят писать одной строкой: «бэкап прошёл, обновления установлены, угроз не обнаружено». Мой принцип простой: цифру из отчёта вы должны уметь проверить за 10 минут без участия подрядчика. По бэкапам в отчёте нужны не «зелёные галочки», а три числа — сколько заданий прошло успешно из запланированных, размер копии (резкое падение размера — сигнал) и дата последнего тестового восстановления. Именно последний пункт отличает копию от иллюзии копии; как проводить такую проверку, я расписывал в статье про тест восстановления бэкапа.
Для патчей и антивируса есть сведения, которые снимаются со станций штатными средствами PowerShell. Ниже команды, которыми я сверяю отчёт подрядчика. Get-HotFix использует класс Win32_QuickFixEngineering и умеет опрашивать удалённые компьютеры через параметр -ComputerName. Но учтите оговорку из документации Microsoft: он возвращает только обновления, поставленные через Component Based Servicing, а установленные Windows Installer или с сайта Windows Update могут в выдачу не попасть. Поэтому дата последнего обновления из Get-HotFix — ориентир, а не окончательный вердикт; полную картину даёт консоль управления обновлениями.
# Последнее установленное исправление на локальной машине
(Get-HotFix | Sort-Object -Property InstalledOn)[-1]

# Есть ли конкретное исправление на списке серверов (замените KB и имена на свои)
Get-HotFix -Id KB0000000 -ComputerName srv-1c01, srv-file01
Для антивируса, если у вас Microsoft Defender, подходит Get-MpComputerStatus: он выдаёт состояние антивирусной защиты, в том числе AMServiceEnabled, RealTimeProtectionEnabled, AntivirusSignatureLastUpdated и AntivirusSignatureAge. Если стоит другой антивирус, берите те же четыре факта из его консоли: служба работает, защита в реальном времени включена, дата обновления баз, число угроз. Для свободного места на дисках (от него зависит и 1С, и бэкап) есть Get-Volume, который показывает HealthStatus, SizeRemaining и Size.
# Состояние Defender: служба, защита в реальном времени, свежесть сигнатур
Get-MpComputerStatus | Select-Object AMServiceEnabled, RealTimeProtectionEnabled, AntivirusSignatureLastUpdated, AntivirusSignatureAge

# Свободное место и состояние томов
Get-Volume | Select-Object DriveLetter, FileSystemLabel, HealthStatus, SizeRemaining, Size
Эти команды я не предлагаю делать каждый месяц руками вместо подрядчика. Смысл другой: раз в квартал выбрать два сервера и пять случайных компьютеров, сверить с отчётом и посмотреть, сходится ли. Если сходится три раза подряд, доверие вырастает, и проверок можно делать меньше. Если нет, вопрос не про технику, а про процесс. Для порогов договоритесь заранее: например, любое рабочее место без обновлений более 30 дней попадает в список отстающих, а сигнатуры старше нескольких дней считаются нарушением. Конкретные числа — предмет вашего договора, а не универсальная норма.
Разбор: отчёт подрядчика для магазина пряжи «Клубок и спицы» до и после
Условный пример из моей практики: магазин пряжи «Клубок и спицы», 42 рабочих места — офис, склад, пункт выдачи интернет-заказов и три торговых зала. Инфраструктура обычная: два Windows-сервера (1С и файлы), почта, интернет-канал, касса на базе 1С. Директор позвал меня как независимого консультанта оценить работу текущего подрядчика. Отчёт, который он получал, занимал полстраницы: «закрыто 96 заявок, серверы в норме, бэкапы выполняются». Жалобы при этом шли постоянно, и директор не мог ни подтвердить, ни опровергнуть, что виноват подрядчик.
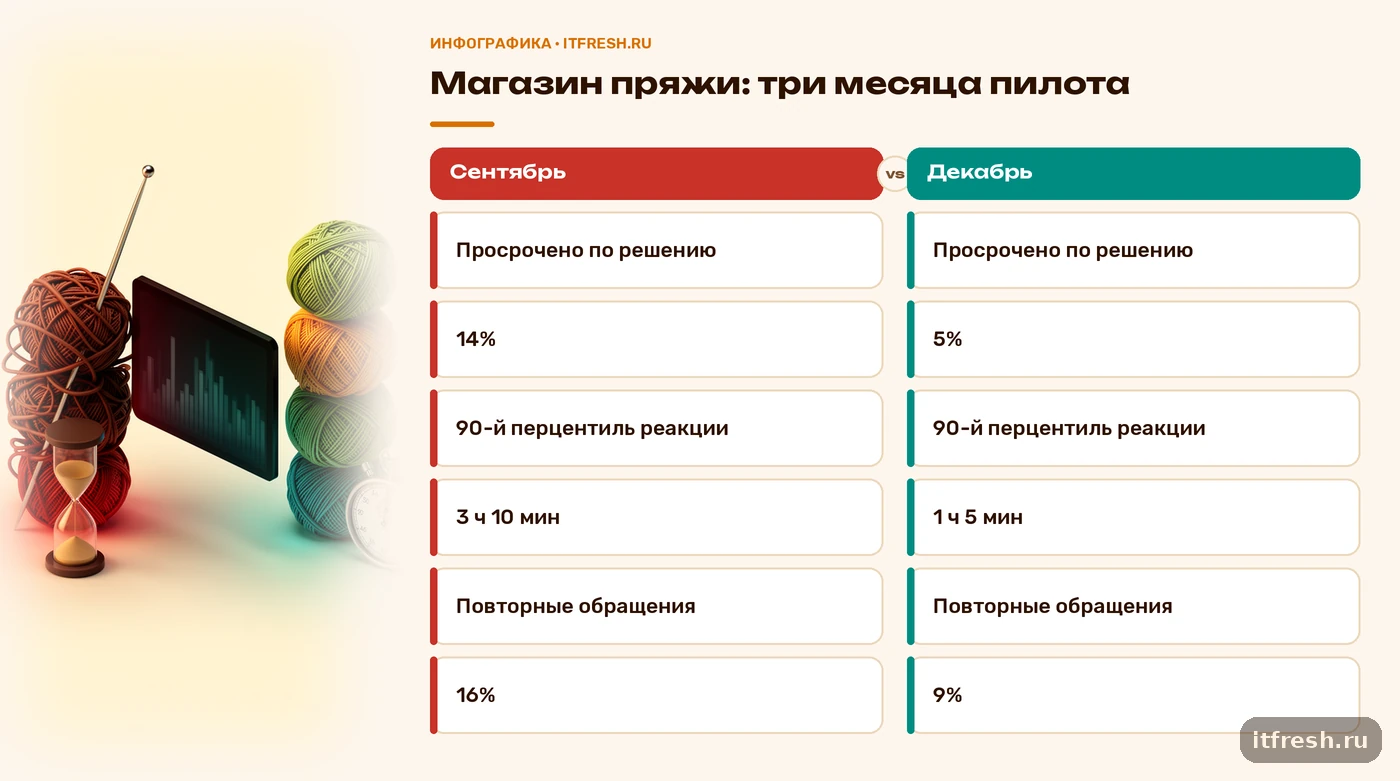
Мы договорились на пилот в три месяца и ввели шаблон из восьми блоков. Первый честный отчёт за сентябрь прошлого года показал: поступило 134 заявки, закрыто 127, просрочено по решению 18 (около 14 % от закрытых). Медиана реакции — 22 минуты, но 90-й перцентиль — 3 часа 10 минут. Повторных обращений — 21 (16 %). Доступность 1С в графике «пн–вс, 08:00–20:00» составила 99,2 % при целевых 99,5 %: за 360 рабочих часов набралось 2 часа 52 минуты простоя против допустимых 1 часа 48 минут. Причиной оказалась одна перезагрузка сервера после обновления в рабочее время, которую подрядчик раньше относил к «плановым работам». Резервные копии базы 1С проходили 30 из 30 ночей, но ни одного тестового восстановления за год не проводилось. И шесть рабочих мест не получали обновлений больше 30 дней.
Выводов было три, и ни один не требовал смены подрядчика. Во-первых, перенесли обновления серверов на окно после 21:00 и внесли его в согласованные плановые работы. Во-вторых, записали в регламент тестовое восстановление базы 1С раз в квартал (первое сделали в октябре). В-третьих, подключили для рабочих мест отчёт об отстающих обновлениях. Через три месяца просрочки по решению упали с 14 % до 5 %, 90-й перцентиль реакции — с 3 часов 10 минут до 1 часа 5 минут, доля повторов — с 16 % до 9 %. Доступность 1С вышла на целевой уровень. Абонентская плата не менялась: изменился не тариф, а то, что стало видно.
Как не дать подрядчику «нарисовать» KPI и что делать на встрече по отчёту
Любая метрика, к которой привязаны деньги или репутация, начинает подстраиваться. Если штрафуют за просрочку, заявки закрывают досрочно, а потом открывают новые; если премируют за количество закрытых — дробят одну проблему на пять. Это не обязательно злой умысел, чаще — реакция на систему стимулов. Поэтому я никогда не прошу один KPI, а связываю их парами: скорость решения — с долей повторов, количество закрытых заявок — с количеством просроченных, зелёные бэкапы — с датой тестового восстановления. Нарисовать одну цифру легко, согласованно нарисовать пару сложно.
Второй приём — источник данных. Системы заявок и мониторинга должны быть такими, чтобы вы могли самостоятельно зайти и посмотреть сырые данные хотя бы с правами чтения. Тогда отчёт становится не документом на доверии, а выжимкой из доступных вам данных. Если подрядчик отказывается дать доступ на просмотр, это аргумент при выборе или смене компании, и о таких признаках я писал в статье про красные флаги при выборе IT-аутсорсера. Нормальный подрядчик, наоборот, радуется прозрачности: меньше споров о том, что было.
И последнее — формат встречи. Раз в месяц, 30 минут, не больше. Подрядчик присылает отчёт за два дня до встречи, вы читаете его заранее. На встрече обсуждаются только три вещи: что в отчёте вышло за пределы договорных значений, что повторялось второй раз подряд и какие решения принимаем (что меняем, кто отвечает, к какому сроку). Протокол из трёх строк отправляется письмом в тот же день. Через полгода такой практики у вас будет история цифр, по которой видно, становится лучше или хуже, и любой разговор о продлении договора будет опираться на факты, а не на впечатления.
- Отчёт приходит за 2 дня до встречи, одним файлом, по одному и тому же шаблону каждый месяц.
- Встреча 30 минут: отклонения, повторы, решения с ответственным и сроком.
- Протокол из трёх строк в тот же день; в следующем отчёте первым блоком идёт выполнение прошлых решений.
Частые вопросы
Какие KPI должны быть у IT-аутсорсинга?
Минимальный набор: заявки и просрочки, время реакции и решения (медиана и 90-й перцентиль), доля повторных обращений, доступность ключевых сервисов, результаты бэкапов с датой тестового восстановления, состояние патчей и антивируса, инциденты с причинами.
Как часто нужно требовать отчёт от IT-подрядчика?
Раз в месяц, по одному шаблону и за два дня до встречи. Критичные события (авария, простой 1С) подрядчик описывает отдельно сразу, не дожидаясь месячного отчёта.
Как проверить, что подрядчик не приукрашивает цифры?
Попросите доступ на чтение к системе заявок и мониторингу, а раз в квартал сверяйте выборку: два сервера и несколько рабочих мест через PowerShell (Get-HotFix, Get-MpComputerStatus, Get-Volume) и дату последнего тестового восстановления.
Можно ли считать доступность 1С средствами Zabbix?
Да. В Zabbix есть разделы Services и SLA: сервису задают теги, целевой SLO, отчётный период и расписание, плановые работы вносят в исключённые простои. Важно, чтобы проверка отражала реальную работу 1С, а не только пинг сервера.
Нужны ли штрафы, если KPI не выполнены?
Штрафы или пересчёт платы работают, когда есть измеримые пороги и честный источник данных. Но сначала добейтесь прозрачного отчёта и разбора причин. Размеры санкций и процедуру фиксируйте в договоре, а не в отчёте.
Источники
- Документация Zabbix: SLA — Проверены параметры SLA: SLO, отчётный период, часовой пояс, расписание, дата начала действия, теги сервисов, исключённые простои. https://www.zabbix.com/documentation/current/en/manual/it_services/sla
- Документация Zabbix: виджет SLA report — Проверены параметры виджета: SLA, сервис, число показываемых периодов (по умолчанию 20, максимум 100), даты начала и конца. https://www.zabbix.com/documentation/current/en/manual/web_interface/frontend_sections/dashboards/widgets/sla_report
- Документация Zabbix: Services — Проверено, что статус сервиса определяется проблемами, сопоставленными через теги, и используется при расчёте SLA. https://www.zabbix.com/documentation/current/en/manual/it_services
- Microsoft Learn: Get-HotFix — Проверены синтаксис, параметры -Id и -ComputerName и оговорка: возвращаются только обновления CBS через Win32_QuickFixEngineering. https://learn.microsoft.com/en-us/powershell/module/microsoft.powershell.management/get-hotfix
- Microsoft Learn: Get-MpComputerStatus — Проверены имена свойств AMServiceEnabled, RealTimeProtectionEnabled, AntivirusSignatureLastUpdated, AntivirusSignatureAge. https://learn.microsoft.com/en-us/powershell/module/defender/get-mpcomputerstatus
- Microsoft Learn: Get-Volume — Проверены свойства DriveLetter, FileSystemLabel, HealthStatus, SizeRemaining, Size в выводе. https://learn.microsoft.com/en-us/powershell/module/storage/get-volume