
Как внедрить ИИ-агента и не отдать ему лишнее
ИИ-агента нельзя сразу пускать ко всем данным и операциям: сначала ограничьте одну задачу, проверьте данные и оставьте критические действия под подтверждением человека. Я разбираю три частые ошибки и показываю, как устроить пилот, контроль доступа и восстановление без обещаний, что техника никогда не ошибётся.
Ошибка 1. Запуск сразу на всю компанию
В условном сценарии со студией «Циркон-Сервис» команда хочет поручить агенту разбирать проектные файлы и обновлять записи. Это учебный пример, а не описание реального клиента или аварии. Опасность здесь не в самом слове «агент», а в сочетании широкой задачи, доступа к рабочим данным и возможности менять их без отдельного контроля.
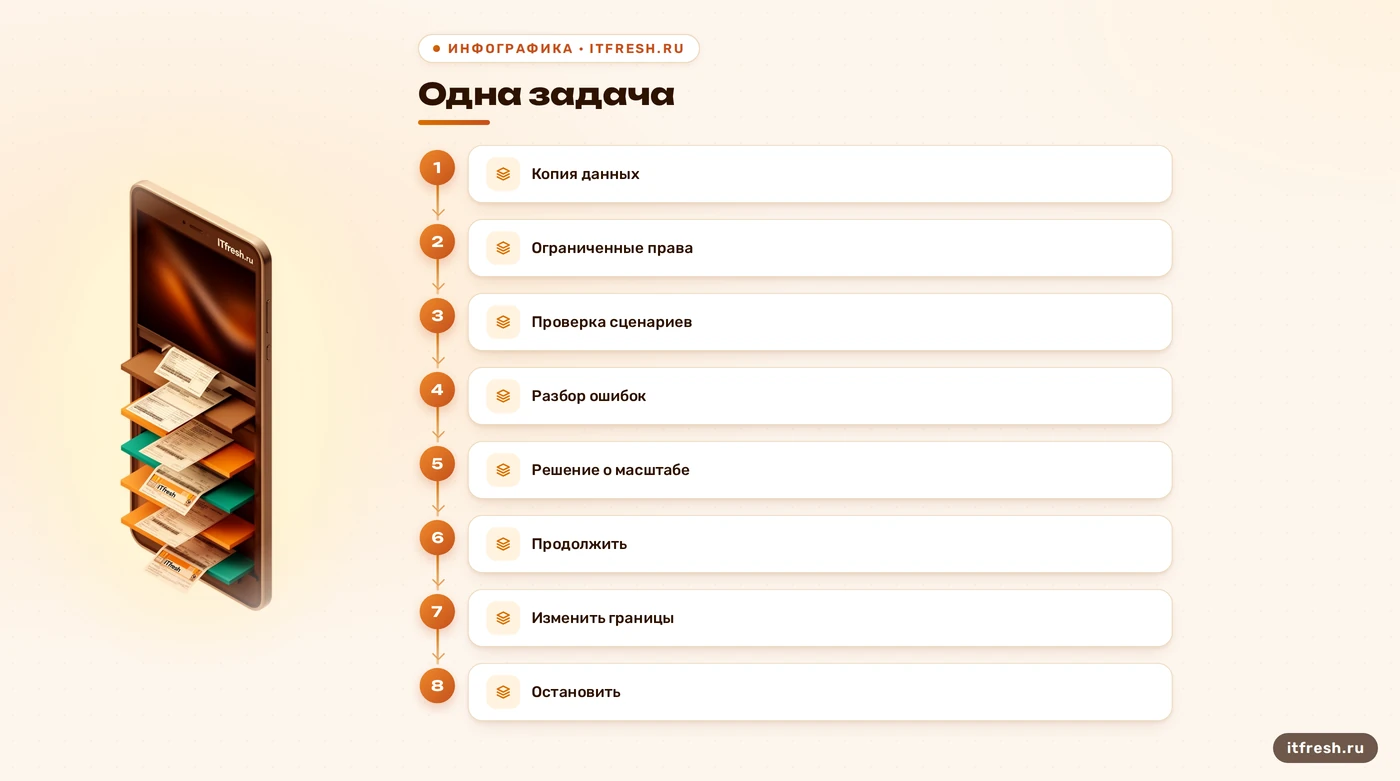
Когда один эксперимент сразу затрагивает несколько отделов, сложно понять, откуда пришла ошибка и кого она коснулась. Я начинаю с одного процесса, одного ответственного и понятного результата: например, подготовить черновик карточки или найти расхождения в справочнике. На первом этапе система читает копию данных, а результат сравнивают с обычной работой сотрудника. В базе знаний этот порядок описан прямо: начинать внедрение следует с пилотного участка и расширять применение после оценки результата. Для настройки корпоративной инфраструктуры у нас есть услуга ИТ-аутсорсинга.
До запуска фиксирую исходные показатели: сколько задач проходит вручную, какие типы ошибок уже встречаются, сколько времени занимает проверка. Затем собираю небольшой набор типовых и неудобных примеров. Успех пилота — не красивая демонстрация на одном удачном запросе, а повторяемый результат на сценариях, похожих на рабочие. Если система не справляется с исключениями, это повод сузить задачу, а не объявить исключения проблемой пользователя.
Заранее назначьте владельца пилота и условия остановки. Например: прекращаем тест, если агент начинает обращаться к нецелевым данным, выдаёт непроверяемые изменения или ломает привычный маршрут работы. Не нужно придумывать универсальный процент успешности: допустимый уровень ошибок зависит от цены конкретной ошибки.
- Выберите один процесс и владельца результата.
- Проверьте сценарии на копии данных.
- Сравните результат с ручной работой.
- Запишите условия остановки до старта.
Ошибка 2. Передача данных без проверки
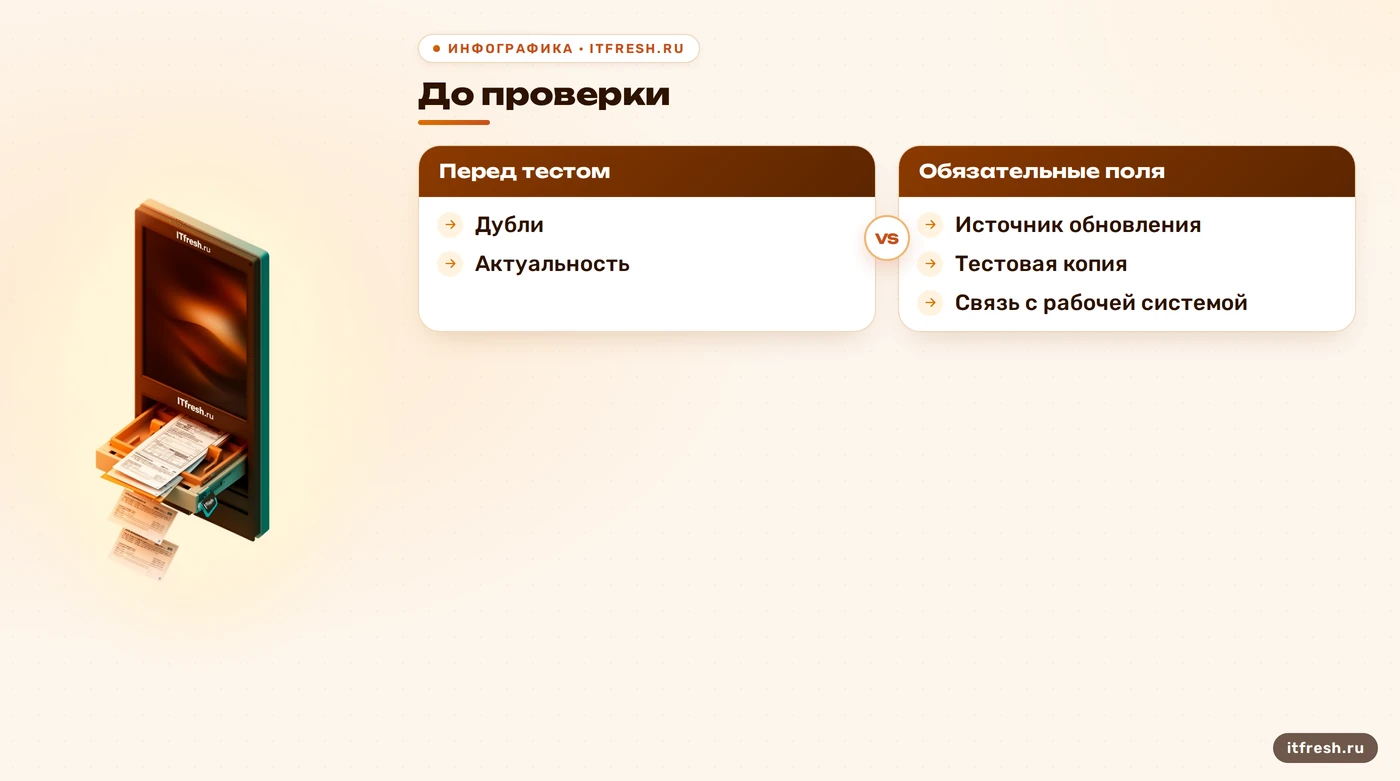
В исходном сценарии фигурировал устаревший справочник, но подтверждений реального инцидента нет. Оставляю здесь саму практическую проблему: если в источнике дубли, пропуски, старые статусы или несогласованные идентификаторы, автоматизация может воспроизвести эти ошибки в ответе или подготовленном изменении. Чистые данные не делают систему безошибочной; они убирают часть предсказуемых причин плохого результата.
Перед пилотом я проверяю, какие поля считаются обязательными, где хранится актуальный статус, кто отвечает за исправление карточек и как обнаруживаются дубли. Для каждого процесса нужны свои правила. В справочнике контрагентов важны идентификаторы и актуальность статуса, в архиве документов — дата, версия и источник. Универсальная команда «почистить базу» обычно заканчивается спором о том, что считать мусором.
Для проверки полезно собрать примеры нормальных записей, пограничных случаев и заведомо неполных данных. На них смотрят не только на корректность ответа, но и на поведение при нехватке сведений: система должна обозначить неопределённость или передать задачу человеку, а не уверенно заполнять пробел догадкой. База знаний отдельно отмечает, что объём без качества ценности не добавляет, а актуальность источников нужно поддерживать регулярным обновлением.
Не подключайте пилот к единственной рабочей копии, если действия могут менять данные. Подготовьте изолированную копию, уберите ненужные персональные сведения и проверьте, что тестовое изменение не уходит в рабочую систему через интеграцию. Копия должна быть достаточно похожа на реальную структуру, иначе тест покажет только то, что система умеет работать с игрушечным примером.
Здесь полезна простая таблица качества: поле, правило проверки, владелец и действие при нарушении. Её можно начать вести в обычном документе; дорогая платформа сама по себе не исправит спорные значения. Если данные меняются ежедневно, частоту сверки выбирают по скорости изменений процесса, а не по красивому слову «ежедневно».
- Проверьте обязательные поля и дубли.
- Назначьте владельца справочника.
- Тестируйте нормальные и пограничные записи.
- Изолируйте копию от рабочей системы.
Ошибка 3. Слишком широкая задача и лишние права
Фраза «оптимизировать любые процессы» не задаёт ни результата, ни допустимых действий. В статье это был «системный промпт» с якобы конкретными последствиями — удалением баз и запуском майнинга. Подтвердить такую историю нельзя, поэтому я не выдаю её за факт. Практический вывод остаётся: расплывчатая постановка задачи затрудняет проверку, а доступ, который не нужен для работы, увеличивает возможный ущерб при ошибке или неверной интеграции.
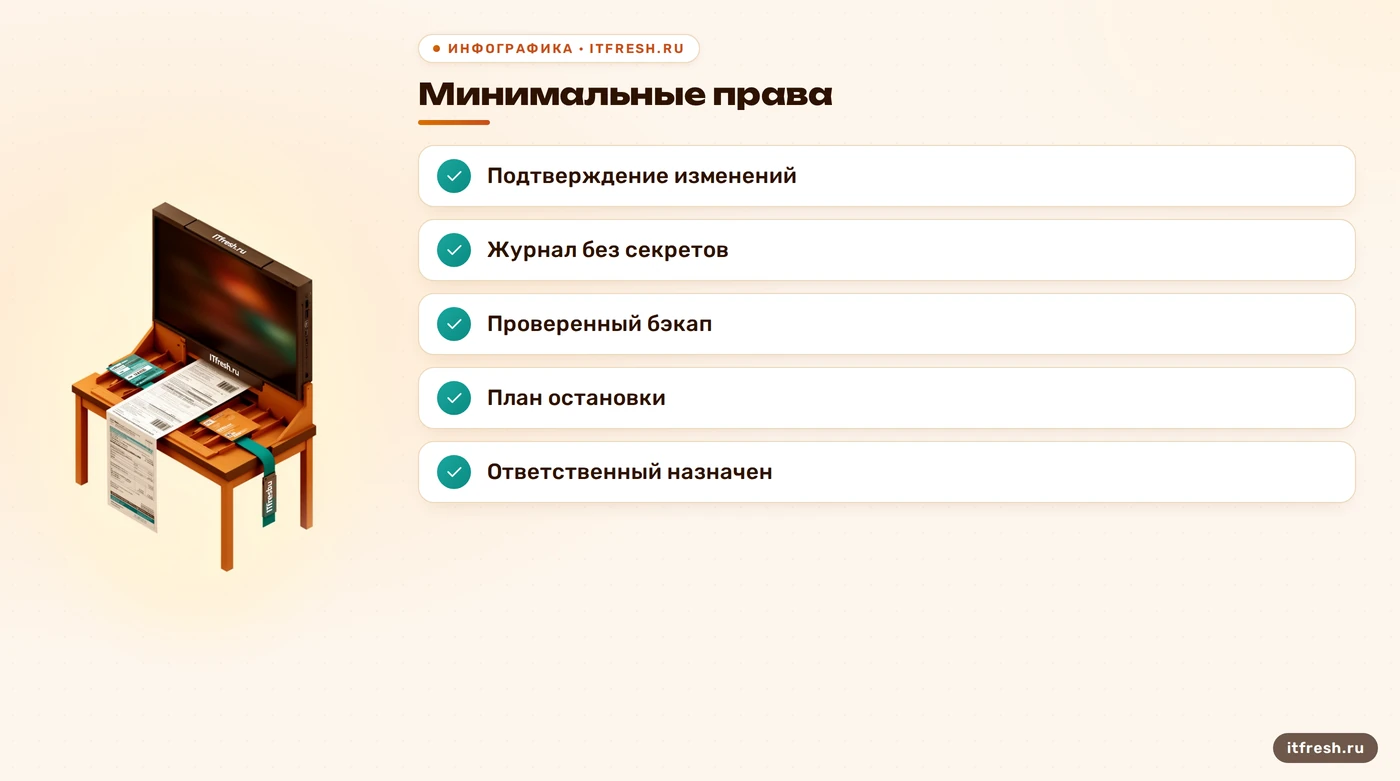
Составьте короткое описание задачи: входные данные, ожидаемый результат, запрещённые действия и ситуации передачи человеку. Отдельно перечислите доступные инструменты. Если задача — найти расхождения и подготовить список, не выдавайте право удалять записи. Если нужно создать черновик, не разрешайте отправлять его клиенту автоматически. Это принцип минимально необходимых полномочий; подробнее границы компонентов разобраны в статье об архитектуре ИИ-агентов для бизнеса.
Разделите чтение, подготовку изменений и применение изменений. Пока пилот не доказал стабильность на наборе сценариев, агенту достаточно читать тестовые данные и формировать предложение. Запись в рабочую систему должна идти через отдельный контролируемый шаг, где проверяется инициатор, набор изменений и возможность отмены. Не полагайтесь только на текстовую инструкцию: фактическое разрешение должно ограничиваться настройками интеграции и учётной записи.
OWASP описывает чрезмерные полномочия, слишком широкую функциональность и автономность как риск для приложений с агентными возможностями. В рекомендациях проекта — ограничивать инструменты и разрешения, отслеживать действия и сохранять подтверждение пользователя для существенных операций. Это не значит, что каждое безвредное чтение надо подтверждать вручную. Подтверждение ставят на действия с последствиями: удаление, массовую правку, отправку или изменение прав доступа.
Я отдельно проверяю, что происходит при ошибке интеграции: можно ли остановить очередь, отозвать токен, отключить запись и понять, какие именно изменения уже прошли. Не выдавайте единственную учётную запись с правами администратора «на всякий случай». Это удобство на пять минут и загадка для разбора на весь следующий день.
- Оставьте только необходимые инструменты.
- Разделите чтение и изменение данных.
- Подтверждайте значимые операции.
- Проверьте аварийное отключение доступа.
Как проверять действия и восстанавливаться
Для операций с заметными последствиями нужен независимый контроль: человек должен видеть, что именно предлагается изменить, и иметь возможность отказать. База знаний подтверждает необходимость проверки человеком критически важных решений. Ограничения доступа к рабочей среде также разобраны в статье правила для ИИ-агентов на серверах. Важно показывать не общий статус «готово», а конкретный перечень объектов, старые и новые значения, причину изменения и источник данных. Иначе подтверждение превращается в привычное нажатие кнопки, а не в проверку.
Логируйте запрос, вызванный инструмент, время, учётную запись, результат и решение проверяющего. Не складывайте туда пароли, ключи доступа и лишние персональные данные. Журнал должен помогать восстановить последовательность действий, а не становиться ещё одной базой чувствительной информации. Факт выполнения и итоговый результат сохраняйте отдельно, если по ним нужно разбирать ошибки или повторные операции.
Резервная копия нужна до того, как автоматизация получит возможность менять важные данные. Но само наличие файла бэкапа ничего не доказывает: проверьте восстановление на отдельной площадке и определите, за какой период допустима потеря изменений. В базе знаний рекомендуются резервирование до изменений и практическая проверка копии. Для файлов и баз могут понадобиться разные процедуры восстановления; не считайте снимок системы универсальным ответом на любой сценарий.
До запуска определите простую процедуру остановки: кто отключает интеграцию, где блокируется очередь заданий, кому сообщают об инциденте и кто принимает решение о восстановлении. После ошибки сначала ограничивают дальнейшие изменения и фиксируют журналы, затем оценивают затронутые данные. Массовое исправление поверх неизвестного состояния часто усложняет восстановление.
NIST предлагает строить управление рисками как непрерывную работу на всём жизненном цикле: определить контекст, измерять результат, управлять рисками и пересматривать меры. В материалах NIST отдельно говорится о документировании человеческого надзора и планах мониторинга после внедрения. Для небольшой компании это можно начать с журнала решений, списка ответственных и регулярной короткой проверки — без отдельного департамента и папки на сто регламентов.
- Показывайте проверяющему точный diff.
- Ведите журналы без секретов.
- Проверьте восстановление резервной копии.
- Заранее назначьте ответственного за остановку.
Что измерять после пилота
Сравнивайте не впечатление, а одинаковые задачи до и после запуска. Для выбранного процесса фиксируйте долю результатов, которые сотрудник принял без правки, число исправлений, время проверки и случаи передачи человеку. Отдельно учитывайте ошибки с разной ценой: неверный черновик и ошибочное удаление — не один показатель. Один общий процент скрывает разницу между мелкой неточностью и ущербом для учёта.
Заранее определите, кто размечает ошибки и как трактуются спорные примеры. Если один сотрудник считает ответ приемлемым, а другой — нет, сначала уточните критерий, а уже потом сравнивайте версии. Иначе график будет аккуратным, а решение о масштабировании — произвольным. Для пилота обычно достаточно небольшой выборки, если она включает обычные запросы, исключения и случаи с неполными данными.
Проверяйте не только качество результата, но и побочные эффекты: лишние вызовы интеграции, повторные операции, задержки, неуместный доступ и затраты времени на проверку. Если сотрудник тратит больше времени на контроль, чем раньше на выполнение задачи, автоматизация пока не принесла пользы. Не скрывайте такой итог за словом «оптимизация».
Решение после пилота может быть одним из трёх: остановить проект, изменить границы или продолжить на следующем участке. Условия выбирают до теста с учётом конкретного процесса. В NIST AI RMF мониторинг и периодический пересмотр предусмотрены как часть управления риском; это полезная дисциплина и для небольшого внедрения. После расширения контроль не исчезает: просто к нему добавляются новые источники, сценарии и ответственные. Условия ограничения инструментов подробнее собраны в статье о guardrails для агента.
- Считайте исправления и время проверки.
- Разделяйте ошибки по последствиям.
- Учитывайте побочные вызовы и задержки.
- Фиксируйте решение о следующем этапе.
План безопасного внедрения
Сначала опишите одну повторяемую задачу и то, что система не должна делать. Затем проверьте качество источников и подготовьте изолированную тестовую копию. Настройте минимальные права, журнал действий и подтверждение для операций с последствиями. До теста сохраните данные и проверьте восстановление. Такой порядок опирается на подтверждённые в экспертной базе практики: пилотный участок, ограниченный доступ, проверка результата человеком и тестирование на копии.
Проведите пилот на заранее выбранных сценариях, включая неудобные случаи. Соберите результаты и ошибки, пересмотрите правила, повторите проверку после изменений. Только потом решайте, можно ли расширять задачу. Если система не проходит проверку, оставьте её в режиме подготовки черновиков или вернитесь к ручному процессу. Остановить неподходящий пилот — нормальный результат, а не повод прятать цифры в презентации.
Не обещаю, что набор инструкций сделает автоматизацию безошибочной. Цель проще и полезнее: ограничить возможный ущерб, заметить отклонение и восстановить данные понятным способом. Заодно должно быть ясно, кто отвечает за источник, кто проверяет итог и кто может остановить интеграцию. Когда этих ответов нет, расширять доступ рано.
Если хотите поручить подготовку такого процесса нам, я помогу описать пилот, проверить доступы, журналы и порядок восстановления, а затем разобрать результаты перед масштабированием. Обслуживание сервера стоит от 7 000 ₽/мес; объём работ и применимость тарифа к вашей инфраструктуре согласуем после оценки.
- Опишите одну задачу и границы.
- Подготовьте копию и резервный план.
- Ограничьте права и проверьте журнал.
- Оцените пилот до расширения.
Частые вопросы
Можно ли сразу дать агенту доступ ко всем отделам?
Нет. Начните с одного процесса и ограниченного набора данных, затем оцените результат и риски перед расширением.
Как подготовить данные для пилота?
Проверьте обязательные поля, дубли и актуальность источника. Тестируйте на изолированной копии, не связанной с рабочими изменениями.
Нужно ли подтверждать человеком каждое действие?
Нет. Подтверждение особенно важно для изменений с последствиями: удаления, массовой правки, отправки и смены прав.
Что делать, если агент изменил важные данные?
Остановите дальнейшие операции, сохраните журналы, оцените затронутые записи и восстановите данные по проверенной процедуре.
Как понять, что пилот можно расширять?
Сравните качество и время на одинаковых сценариях, учтите цену ошибок и заранее установленные условия продолжения.
Источники
- NIST AI Risk Management Framework 1.0 — Официальная основа: функции Govern, Map, Measure и Manage, документирование человеческого надзора и жизненный цикл управления рисками. https://airc.nist.gov/airmf-resources/airmf/5-sec-core/
- NIST AI RMF Playbook: Manage — Рекомендации по мониторингу, планам реагирования и восстановлению для управления рисками ИИ-систем. https://airc.nist.gov/airmf-resources/playbook/manage/
- OWASP GenAI LLM Top 10 2026 — Риски чрезмерной функциональности, полномочий и автономности; меры ограничения инструментов, логирования и подтверждения действий. https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/