
Бэкап LXC в Proxmox зелёный, а после восстановления каталог приложения пуст: куда делся bind mount
Файлов нет, потому что они лежали в bind mount, а vzdump содержимое bind mount и device mount не копирует никогда: в архив попадает только строка mp0 из конфига контейнера. Флаг backup=1 этого не меняет. Ниже: как увидеть проблему за минуту, три способа её закрыть и как проверять восстановление, пока оно не стало настоящим.
Почему vzdump пишет «успешно», если данных приложения в архиве нет
Сценарий я видел столько раз, что перестал удивляться. Администратор настроил задание резервного копирования LXC-контейнера, каждую ночь в журнале зелёная галочка, архивы лежат на сетевом хранилище, размер вроде приличный. Потом контейнер приходится восстановить, система поднимается, служба стартует, а папка с вложениями, сканами или загрузками пуста. Для практики информационной безопасности и резервного копирования это классика: задание не упало, значит, всё хорошо. Только «не упало» и «сохранило всё нужное» — разные утверждения. Зелёная галочка бэкапа — это как стикер «проверено» на огнетушителе: приятно, но никто не пробовал им тушить.
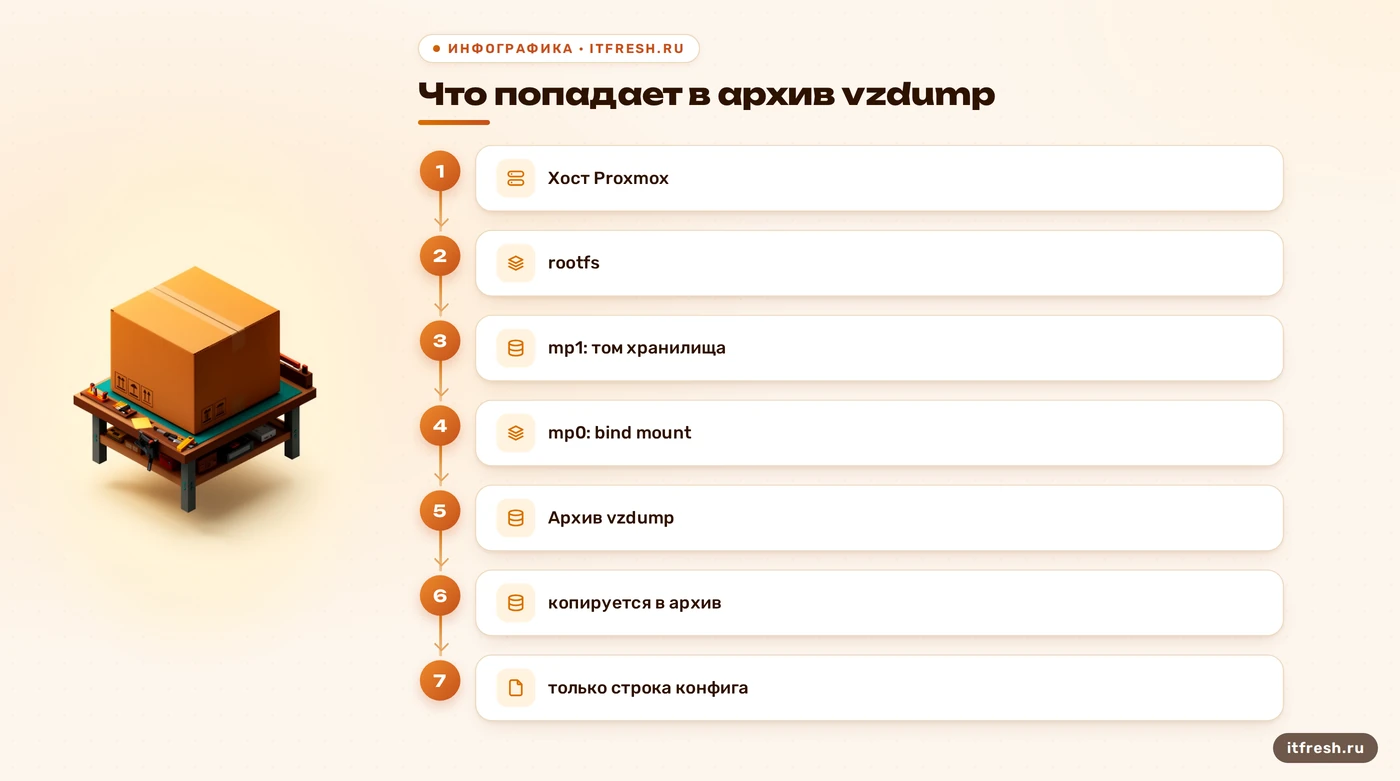
Причина в устройстве Proxmox VE. В документации по контейнерам описаны три типа точек монтирования: тома, управляемые подсистемой хранения (storage backed mount points), bind mount и device mount. Первые Proxmox создаёт и контролирует сам: он знает их размер, умеет делать снимки и включать в архив. Bind mount — это просто каталог хоста, который проброшен внутрь контейнера. В документации прямо сказано, что bind mount не управляются подсистемой хранения, поэтому снимки на них сделать нельзя. А на странице vzdump написано ещё жёстче: device и bind mount никогда не попадают в резервную копию, потому что их содержимое управляется вне библиотеки хранения Proxmox VE.
Отсюда ключевая мысль, ради которой я и пишу эту статью. Внутри контейнера каталог выглядит как самый обычный: ls показывает файлы, приложение пишет и читает, df показывает размер. Различия между «моим каталогом» и «каталогом хоста, подсунутым внутрь» изнутри не видно, и именно поэтому его считают частью контейнера, а значит, и частью копии. Это естественное, но неверное допущение. Копируется то, что Proxmox считает содержимым контейнера, а не то, что вы видите из-под шелла.
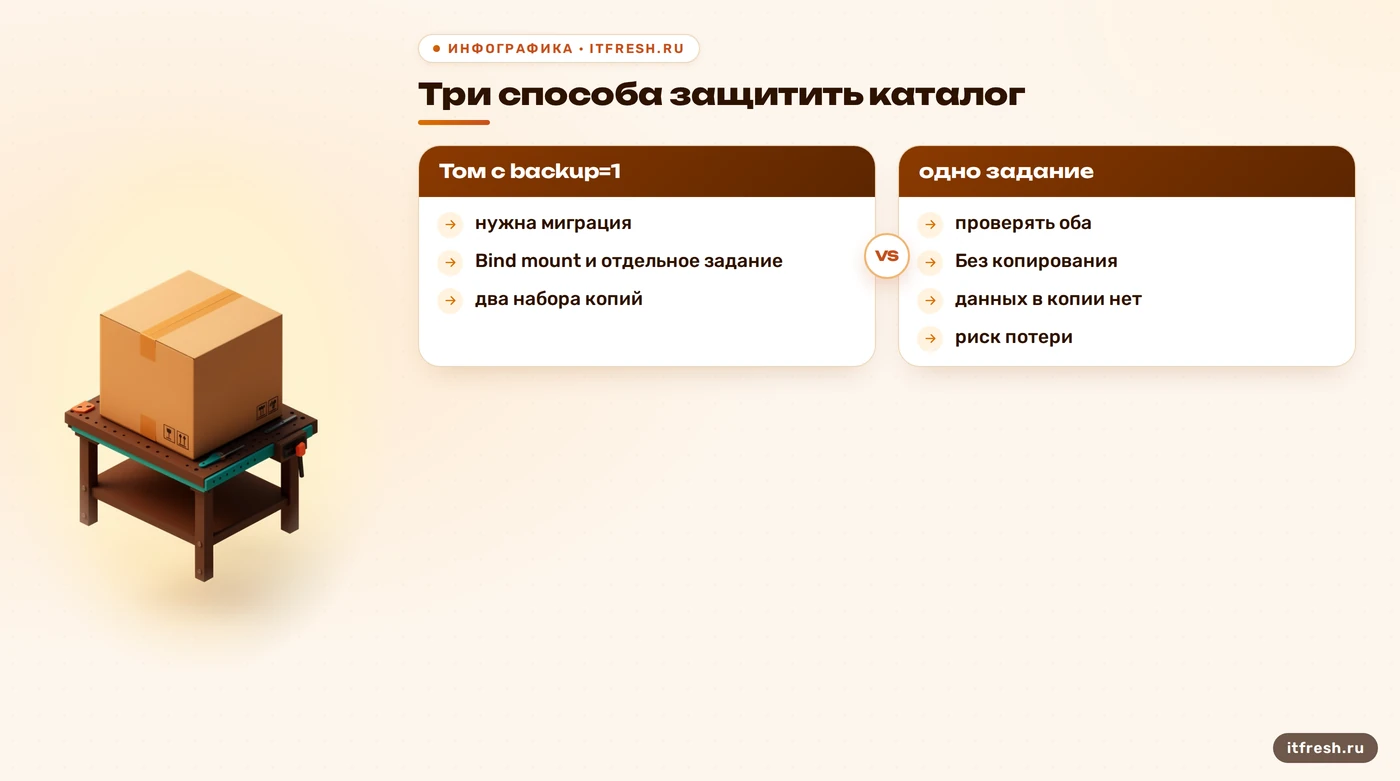
Вторая половина ловушки — флаг backup=1. Его нередко воспринимают как «включить в копию всё, что подключено к этой точке». На деле он описан в документации как параметр, который включает точку монтирования в резервные копии, и применяется только к томам (в справке к pct прямо сказано: только для volume mount points). Для каталога хоста он ничего не включает, потому что превратить каталог в управляемый том нельзя. Параметр можно написать, он не вызовет ошибки, и в этом главная подлость: ни предупреждения, ни красной строки.
Как проверить за минуту, что ваш каталог — bind mount, а не том контейнера
Проверка делается на хосте Proxmox, а не внутри контейнера. Нужно посмотреть конфигурацию контейнера и найти строки mp0, mp1 и так далее. Всего можно настроить до 256 дополнительных точек, от mp0 до mp255, а корневой диск описан отдельно в параметре rootfs. Для примера возьмём контейнер 114.
pct config 114В выводе смотрите на первое поле после двоеточия. Если там имя хранилища и имя тома, например local-lvm:vm-114-disk-1, это том под управлением Proxmox, и параметр backup=1 на нём работает. Если там абсолютный путь, начинающийся со слэша, например /tank/crm-files, это bind mount, и ни vzdump, ни снимки его содержимое не увидят. Пример из документации выглядит так: mp0: /mnt/bindmounts/shared,mp=/shared. Путь до запятой — каталог на хосте, mp= — место внутри контейнера.
Если в конфиге много строк, я не читаю глазами, а фильтрую. Одна команда покажет все точки монтирования, и сразу видно, какие из них начинаются со слэша.
pct config 114 | grep -E '^(rootfs|mp[0-9]+):'То же самое можно сделать для всех контейнеров узла в цикле по списку из pct list, но я бы начал с контейнеров, где крутится что-то, что хранит файлы пользователей: CRM, документооборот, wiki, файловый обменник. Для баз данных и кэшей ситуация обычно проще, они почти всегда лежат на rootfs.
Отдельно проверьте device mount: так называется точка монтирования, где в контейнер подключается блочное устройство хоста. Документация говорит, что их стоит использовать только в особых случаях, потому что обычно том под управлением хранилища даёт ту же производительность и намного больше возможностей. Содержимое device mount, как и bind mount, в vzdump не попадает. Если вы встретили такую точку, считайте её тем же риском.
Что на самом деле возвращает pct restore, когда вы восстанавливаете контейнер
Теперь про то, что происходит при восстановлении. Контейнер из архива поднимается командой pct restore, это же описано в документации vzdump. Пример оттуда: pct restore 600 /mnt/backup/vzdump-lxc-777.tar, где 600 — новый идентификатор. В реальной жизни файл будет называться vzdump-lxc-<ID>-<дата>.tar с суффиксом сжатия, если вы включили compress. Идентификатор нового контейнера я всегда беру свободный, а не старый: так можно сравнить результат с живым оригиналом.
Дальше начинается тонкость, которую в тексте про бэкапы почти никто не упоминает. По умолчанию pct restore старается восстановить как можно больше сохранённой конфигурации. Если не указывать параметры rootfs и mpX вручную, команда работает в простом режиме, и среди шагов есть такой: добавить bind и device mount points в восстановленную конфигурацию (это доступно только пользователю root). Документация сразу поясняет следствие: поскольку содержимое bind и device mount никогда не сохраняется, на последнем шаге никаких файлов не восстанавливается.
Вот поэтому картина выглядит так обидно. Контейнер восстановился, конфиг в порядке, точка монтирования mp0 на месте, путь внутри контейнера создан. Если на новом хосте нужного каталога нет совсем, контейнер обычно просто не стартует: pre-start хук ругается, что исходного каталога не существует, и администратор «чинит» это командой mkdir. После этого каталог есть, но пустой, и приложение видит пустую папку. Если каталог на хосте остался от прошлой жизни, приложение вообще может увидеть вчерашние данные и этого не заметить. Бэкап, который «возвращает строку из конфига», — это не бэкап данных, а резервная копия пути. Посмотреть, какой конфиг лежит в архиве, можно и без восстановления: в документации для этого указана команда pvesm extractconfig с идентификатором тома архива. Строки mpN со слэшем в начале там будут, а файлов за ними — нет.
Есть и расширенный режим: если указать rootfs и любые комбинации mpX, то pct restore полностью игнорирует соответствующие параметры из архива и использует ваши. Туда, в частности, можно восстанавливать на device и bind mount, опять же только от root. Это полезно, когда вы заранее подготовили хранилище и хотите вернуть корневой диск на конкретный том. Но данные, которых в архиве нет, расширенный режим тоже не создаст.
Разбор: 28 рабочих мест, CRM с вложениями и пустая папка uploads
Условный клиент для этого разбора — риэлторская компания «Домовладение Плюс», 28 рабочих мест. Внутренняя CRM с карточками объектов и сканами договоров живёт в LXC-контейнере с номером 114 на одном узле Proxmox. Приложение хранит базу внутри контейнера, а вложения, то есть сканы паспортов, договоры, выписки, лежат в каталоге на отдельном ZFS-датасете хоста. Исторически так сделали, чтобы место под вложения росло независимо от контейнера. Идея нормальная. Беда в том, что датасет пробросили как bind mount: в конфиге стояла строка mp0 с путём на хосте и mp= внутрь контейнера, а в конце приписали backup=1 «чтобы точно попало в копию».
Ночное задание vzdump в режиме snapshot отрабатывало ровно 6 минут и давало архив около 4 ГБ. Данных во вложениях при этом было порядка 310 ГБ. Любого человека, который хоть раз видел эти цифры рядом, это должно было насторожить, но на дашборде горела зелёная галочка, а размер архива никто не сравнивал с размером данных. Мы пришли на аудит после того, как у них отказал системный SSD в узле. Контейнер подняли из архива на запасном узле, и первым делом директор открыл карточку сделки: текст на месте, а прикреплённых файлов нет ни одного.
К счастью, вышел аудит, а не катастрофа: старый ZFS-пул с вложениями был жив и подключился к новому узлу. Мы подключили его, повторили строку mp0 в конфиге восстановленного контейнера, и всё заработало. Но, честное слово, это была удача, а не процесс. Если бы отказал пул, а не системный диск, компания потеряла бы все сканы договоров за несколько лет. И никакое «успешно» в журнале vzdump этого бы не спасло. Заметьте: ни один компонент не вёл себя неправильно. vzdump сделал ровно то, что написано в документации, а виноват, как обычно, подход «зелёное значит надёжное».
После этого мы перестроили схему. Первое: вложения перенесли в отдельный том, управляемый Proxmox, с backup=1, и включили задание с проверкой размера архива. Второе: добавили еженедельное тестовое восстановление в соседний идентификатор с автоматической сверкой количества файлов. Третье: настроили вынос копий на отдельное хранилище. Весь переезд занял два вечера без остановки работы офиса, кроме окна в 40 минут на копирование дельты. Если вам нужен такой же разбор по вашему узлу, мы делаем его за один выезд — напишите, посмотрим конфиги контейнеров и скажем, что именно не попадает в копию.
Три способа закрыть дыру: том с backup=1, отдельная копия каталога или честная запись в регламенте
Универсального ответа нет, зато есть понятный выбор. Если содержимое каталога — часть приложения, то самое правильное решение — сделать его томом, управляемым Proxmox. Тогда параметр backup=1 начинает работать, vzdump включает его в архив, и восстановление возвращает файлы. Вот в этом месте я никогда не экономлю: лишние минуты на миграцию дешевле, чем возможная потеря. Но нужно учитывать, что для режима snapshot требуется, чтобы все сохраняемые тома лежали на хранилище, поддерживающем снимки; тома, которые такого не умеют, можно исключить параметром backup=no (в справке по vzdump названо именно так).
Если каталог хоста должен остаться каталогом хоста, например потому что им пользуются сразу несколько контейнеров или он лежит на общем хранилище, его нужно копировать отдельным заданием, снаружи vzdump. Подойдёт любой инструмент резервного копирования на хосте: restic, borg, rsync с ротацией или клиент вашего сервера резервного копирования. Важно, чтобы это задание существовало, имело своё расписание, свой журнал и свою проверку восстановления. Про сервер резервного копирования от Proxmox есть отдельный разбор: настройка Proxmox Backup Server и его место в схеме.
Третий вариант — оставить всё как есть и честно записать в регламент: «содержимое mp0 в копию контейнера не входит». Он выглядит смешно, но я встречал клиентов, у которых такая запись спасала: люди хотя бы знали, что надо копировать каталог отдельно. Хуже всего, когда не знают. Сравним варианты в одном месте. | Вариант | Что попадает в vzdump | Плюсы | Минусы | |---|---|---|---| | Том хранилища, backup=1 | Всё содержимое тома | Одно задание, единое восстановление | Нужна миграция данных, нужно место на хранилище | | Bind mount + отдельное задание на хосте | Только строка mp0 | Каталог общий, гибкая настройка | Два набора копий, проверять надо оба | | Bind mount без копирования | Только строка mp0 | Ничего не менять | Данных в копии нет вообще |
Как перенести данные в управляемый том, если вы выбрали первый вариант. Останавливаем контейнер, создаём новый том на хранилище и копируем в него файлы. Сначала смотрим, что сейчас настроено, затем удаляем bind mount и добавляем том, например на 400 ГБ в хранилище local-lvm. Синтаксис STORAGE_ID:SIZE_IN_GB для автоматического выделения тома описан в документации, пример там же: pct set 100 -mp0 thin1:10,mp=/path/in/container. Подставьте свои значения и проверьте их на тестовом контейнере.
pct stop 114
pct set 114 --delete mp0
pct set 114 -mp0 local-lvm:400,mp=/var/www/crm/uploads,backup=1
pct start 114
Команду pct mount для копирования я не использую: она держит блокировку контейнера и, по документации, предназначена только для аварийного обслуживания. Данные я возвращаю штатно, запустив контейнер: rsync со старого каталога хоста через временный второй bind mount с другим путём внутри контейнера. Права владельца для непривилегированных контейнеров учитывайте отдельно, документация предупреждает о проблемах с правами из-за отображения пользователей. Подробнее об изоляции и о том, где LXC уместен, у нас есть отдельная статья: контейнеры LXC в Proxmox и лёгкая изоляция.
Как проверять восстановление, чтобы узнать правду до аварии
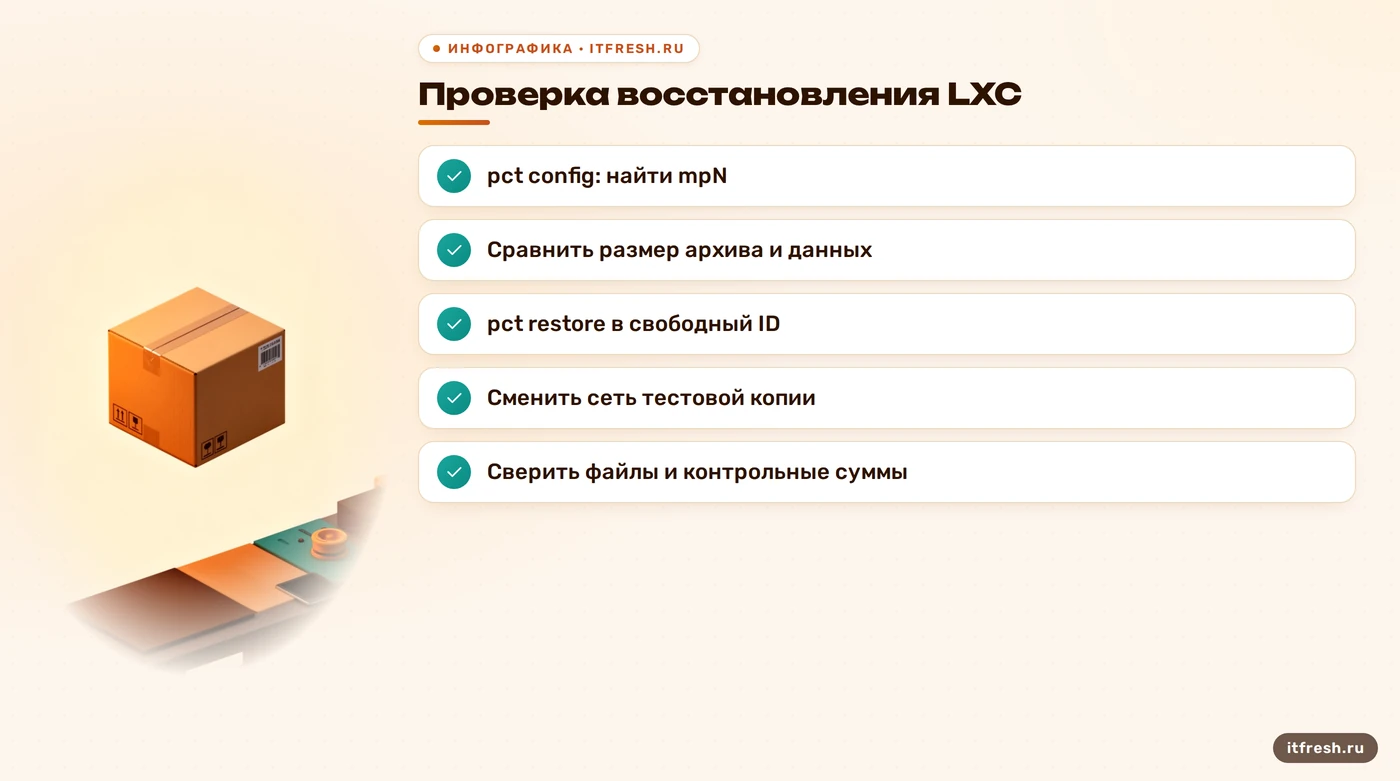
Метод у меня один и скучный: раз в месяц восстановить контейнер в свободный идентификатор и сравнить с рабочим. Не открыть в проводнике архив и сказать «ну вроде нормальный», а именно развернуть, запустить и сверить. Команда нужна простая. Хранилище для корня укажите явно, иначе подставится значение по умолчанию (в справке pct restore это local).
pct restore 914 /mnt/backup/dump/vzdump-lxc-114-2026_10_17-02_00_01.tar.zst --storage local-lvm
pct config 914 | grep -E '^(mp[0-9]+|net[0-9]+):'
pct start 914
pct enter 914
Имя файла в примере условное, у вас оно будет с вашей датой и вашим расширением. Только не включайте тестовый контейнер в той же сети с тем же IP, что у боевого, иначе получите два сервера с одним адресом. Сначала смените сетевые параметры. И вторая ловушка, похуже: в простом режиме восстановленная копия получает ту же строку mp0, то есть тестовый контейнер смонтирует тот же боевой каталог хоста. Вы увидите в нём все файлы, порадуетесь, что «бэкап полный», а заодно дадите тестовому приложению писать в живые данные. Перед pct start удалите или перенаправьте такие точки (pct set 914 --delete mp0), а файлы для сверки берите из своей отдельной копии каталога.
Что сверять. Первое — размер архива против размера данных: если у вас 300 ГБ вложений, а архив весит 4, это сигнал тревоги ещё до восстановления. Второе — наличие точек монтирования в восстановленном контейнере и пустота или заполненность целевых каталогов. Третье — реальный сценарий пользователя: открыть карточку, нажать на вложение, скачать файл, сравнить контрольную сумму с боевой копией. Это перекликается с подходом из нашей статьи про тест восстановления бэкапа, но там акцент на базах 1С, а здесь на том, что вообще не попало в архив.
Мой чек-лист на один лист. Для каждого контейнера на узле: выписать все mpN, для каждого определить, том это или каталог, для каждого каталога назвать задание, которое его копирует, и дату последнего успешного теста. Если хотя бы в одной клетке пусто, это дыра, и её лучше закрыть сегодня. Пустую клетку не получится закрыть смайликом в мессенджере. Остальное — рутина: задание vzdump с режимом snapshot и сжатием zstd, хранение на отдельном хранилище, оповещение о размере архива, а раз в квартал полноценные учебные восстановления из бэкапа со всеми участниками.
Если коротко: бэкап делают все, проверяет его почти никто, а про bind mount знают единицы. Когда вы нашли у себя mp0 со слэшем, у вас не катастрофа, а полезная находка: в этот момент у вас есть время всё исправить. Мы в АйТи-Фреш делаем именно это — проходим по узлам Proxmox, находим каталоги, которые не копируются, переводим их в управляемые тома или настраиваем отдельные задания и проверяем восстановление. Обслуживание сервера у нас от 7 000 ₽ в месяц, в него входит и контроль резервных копий; разовый аудит конфигураций контейнеров вместе с тестовым восстановлением занимает обычно один-два рабочих дня.
Частые вопросы
Включает ли backup=1 содержимое bind mount в бэкап LXC?
Нет. Параметр backup применяется только к томам, управляемым подсистемой хранения Proxmox. Содержимое bind mount и device mount vzdump не копирует независимо от значения этого параметра.
Что вернётся из архива, если в контейнере был bind mount?
Вернётся строка точки монтирования в конфигурации, но не файлы в ней. В простом режиме pct restore добавляет bind и device mount points в конфиг, а файлов на этом шаге не восстанавливает, потому что их в архиве нет.
Как быстро узнать, какие каталоги контейнера не попадут в копию?
Выполните на хосте pct config <ID>. Строки mpN, где вместо пары «хранилище:том» указан абсолютный путь, это bind mount. Их содержимое нужно копировать отдельным заданием или переносить в управляемый том.
Можно ли исключить том из копии, если снимки на нём не поддерживаются?
Да. Режим snapshot требует, чтобы все сохраняемые тома были на хранилище со снимками, а лишние тома можно исключить параметром точки монтирования backup (в справке vzdump он назван backup=no). Данные такого тома нужно защищать отдельно.
Как проверить, что в копии есть данные приложения?
Восстановите архив в свободный идентификатор через pct restore, запустите контейнер и сверьте объём и число файлов с боевым. Размер архива, сильно меньший объёма данных, уже тревожный признак.
Источники
- Proxmox VE: Linux Container (pct), раздел Mount Points — Три типа точек монтирования, bind mounts не управляются подсистемой хранения, параметр backup, поведение pct restore. Проверено по https://pve.proxmox.com/pve-docs/chapter-pct.html и исходнику https://raw.githubusercontent.com/proxmox/pve-docs/master/pct.adoc
- Proxmox VE: vzdump, резервное копирование — Режимы stop, suspend, snapshot, исключение томов, bind и device mounts не копируются, пример pct restore. Проверено по https://pve.proxmox.com/pve-docs/vzdump.1.html и https://raw.githubusercontent.com/proxmox/pve-docs/master/vzdump.adoc
- Proxmox VE: справочник команды pct — Синтаксис pct restore, свойства mp[n] (backup, mp, size, ro, acl, replicate, mountoptions), pct mount только для аварийного обслуживания. Проверено по https://pve.proxmox.com/pve-docs/pct.1.html