
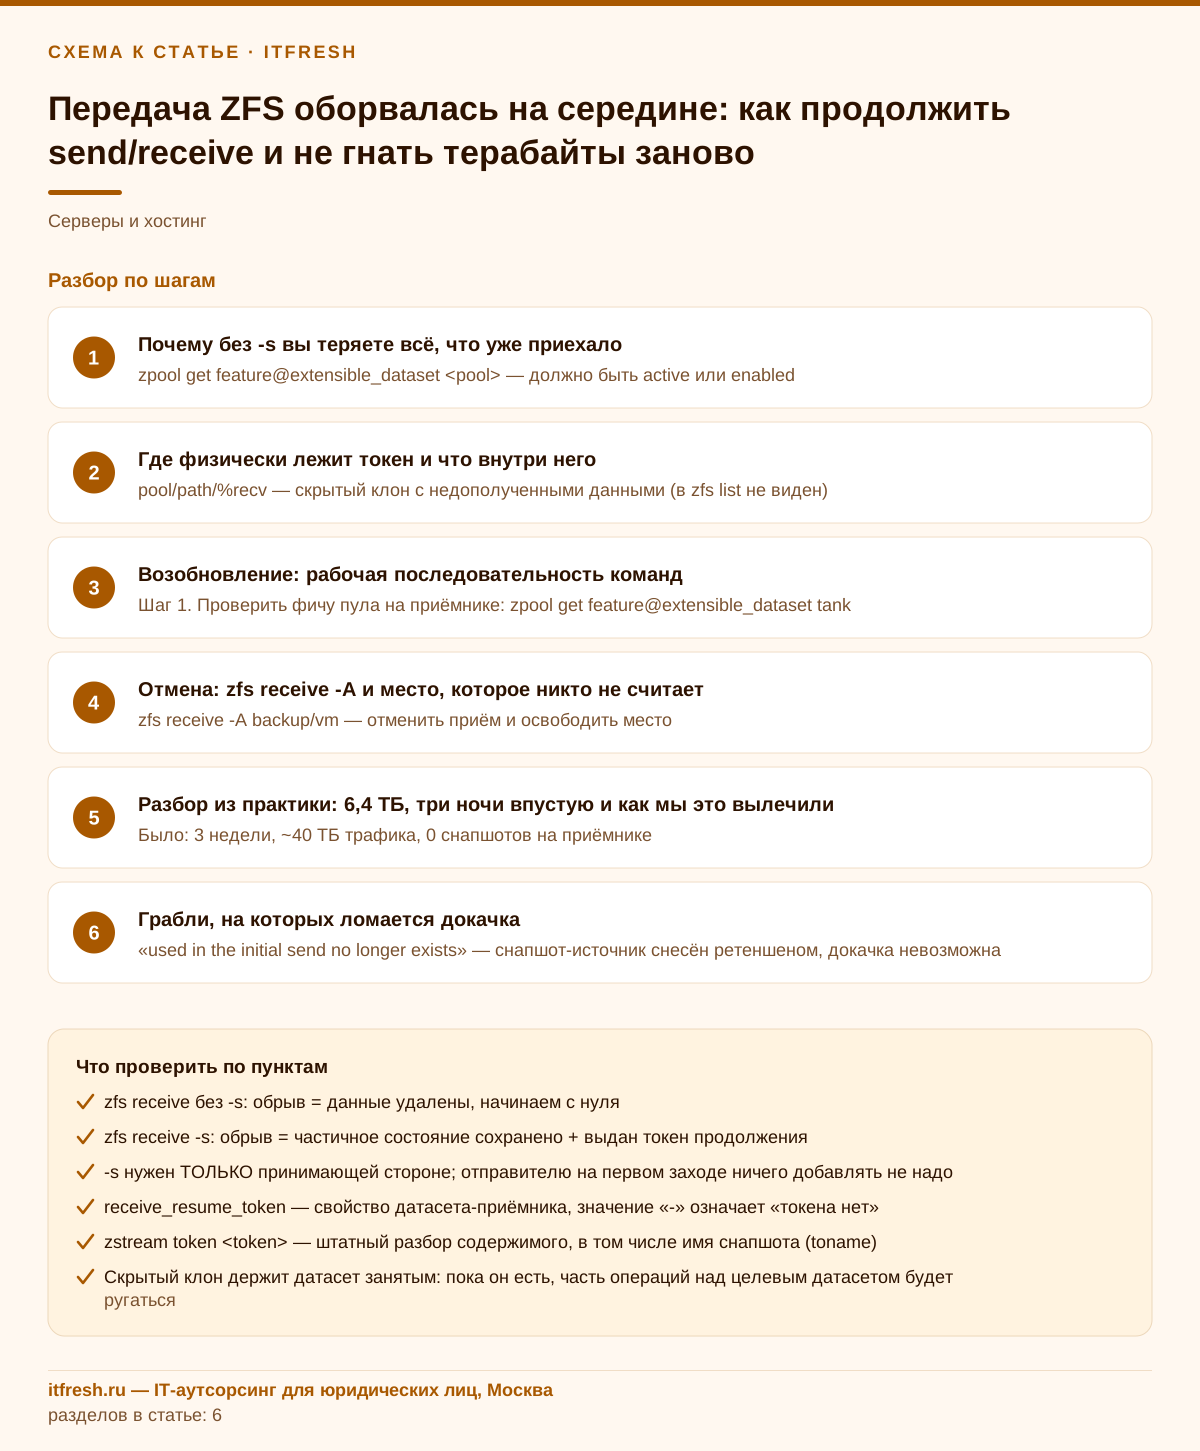
Передача ZFS оборвалась на середине: как продолжить send/receive и не гнать терабайты заново
Ночная репликация упала на 1,1 ТБ из 1,6, утром на приёмнике пусто, и админ запускает всё сначала — третью ночь подряд. Знакомо? В ZFS давно есть штатный механизм докачки: приёмник умеет сохранять недополученное состояние, отдавать токен продолжения, а отправитель — собирать по этому токену поток «с того места». Ниже — где именно живёт токен, какой стороне нужен ключ -s, как аккуратно отменить зависший приём и почему у половины людей это всё равно не работает. С командами, реальными цифрами и списком грабель, на которые я наступал сам.
Почему без -s вы теряете всё, что уже приехало
Поведение по умолчанию у zfs receive простое и беспощадное: если поток оборвался — недополученные данные выбрасываются. Не «складываются в уголок до лучших времён», а именно удаляются. Пул возвращается ровно в то состояние, в котором был до начала приёма. Это сделано осознанно: ZFS не хочет держать в пуле полудатасет, на который непонятно как ссылаться. Но для нас, кто гоняет первичную репликацию на несколько терабайт по офисному каналу, это означает одно — любой чих на линии обнуляет ночь работы.
Ключ -s у zfs receive меняет правило игры. В мануале OpenZFS формулировка дословная: «If the receive is interrupted, save the partially received state, rather than deleting it». То есть при обрыве потока, ошибке контрольной суммы, штатном завершении процесса receive или даже некорректном выключении принимающей машины частично полученное состояние остаётся на диске. Дальше его можно либо доехать, либо явно выкинуть — но это уже ваше решение, а не решение ZFS за вас.
Единственное требование к пулу-приёмнику — включённая фича extensible_dataset. На практике я за последние годы не встречал живого пула, где её нет: она появилась ещё в эпоху ZoL 0.6.x и включается на любом свежесозданном пуле автоматически. Проверяется одной командой, и если там active или enabled — вопрос закрыт. Реальный кандидат на disabled — только очень старый пул, который переехал с Solaris или ни разу не проходил zpool upgrade.
И сразу развею страх, который мне регулярно озвучивают: «а вдруг докачка склеит битые данные и я получу тихо испорченный бэкап». Нет. Поток продолжения — это тот же поток send с теми же контрольными суммами, приёмник проверяет их так же, как при обычном приёме. Снапшот на приёмнике появится только тогда, когда поток доедет полностью и корректно. Пока не доехал — снапшота нет, и никакая резервная копия «наполовину» вам не покажется.
- zpool get feature@extensible_dataset <pool> — должно быть active или enabled
- zfs receive без -s: обрыв = данные удалены, начинаем с нуля
- zfs receive -s: обрыв = частичное состояние сохранено + выдан токен продолжения
- -s нужен ТОЛЬКО принимающей стороне; отправителю на первом заходе ничего добавлять не надо
Где физически лежит токен и что внутри него
После обрыва приёма с -s на принимающей стороне появляется два артефакта. Первый — скрытый клон вида pool/path/%recv рядом с целевым датасетом. Обычный zfs list его не покажет, и это ровно то, что сбивает людей с толку: «команда упала, ничего не создалось, места не занято». Занято. Второй артефакт — свойство receive_resume_token на той файловой системе или томе, куда шёл приём. Это и есть ваш билет на докачку.
Достаётся токен одной строкой. Обратите внимание на -H -o value: без них вы получите таблицу с заголовками, и подставлять её в zfs send -t бесполезно. Если приёма не было — вернётся прочерк, и это нормальный ответ «тут докачивать нечего».
Токен — это не просто «номер байта». Внутри лежит nvlist: guid целевого снапшота, идентификатор объекта и смещение, на котором всё встало, сколько байт уже принято, а главное — параметры исходного потока: был ли он сжатым, raw (шифрованным), с large blocks, embedded data. Именно поэтому при возобновлении вам не нужно (и по большей части нельзя) заново перечислять флаги первого send: они уже зашиты в токен. Синопсис в мануале zfs-send дословно такой: zfs send [-PVenv] -t receive_resume_token — то есть рядом с -t допустимы только -P, -V, -e, -n и -v.
Если хочется посмотреть, что там внутри, не гадая, — есть штатный декодер: zstream token. Его добавили летом 2020 года (PR openzfs/zfs#10558), так что он есть начиная с OpenZFS 2.0 и во всех актуальных ветках. Показывает toname — имя снапшота, на котором прервались, и остальные поля nvlist. Мне это чаще всего нужно ровно для одного: понять, тот ли снапшот на источнике вообще ещё существует. Об этом — в разделе про грабли, там зарыта главная собака.
- pool/path/%recv — скрытый клон с недополученными данными (в zfs list не виден)
- receive_resume_token — свойство датасета-приёмника, значение «-» означает «токена нет»
- zstream token <token> — штатный разбор содержимого, в том числе имя снапшота (toname)
- Скрытый клон держит датасет занятым: пока он есть, часть операций над целевым датасетом будет ругаться
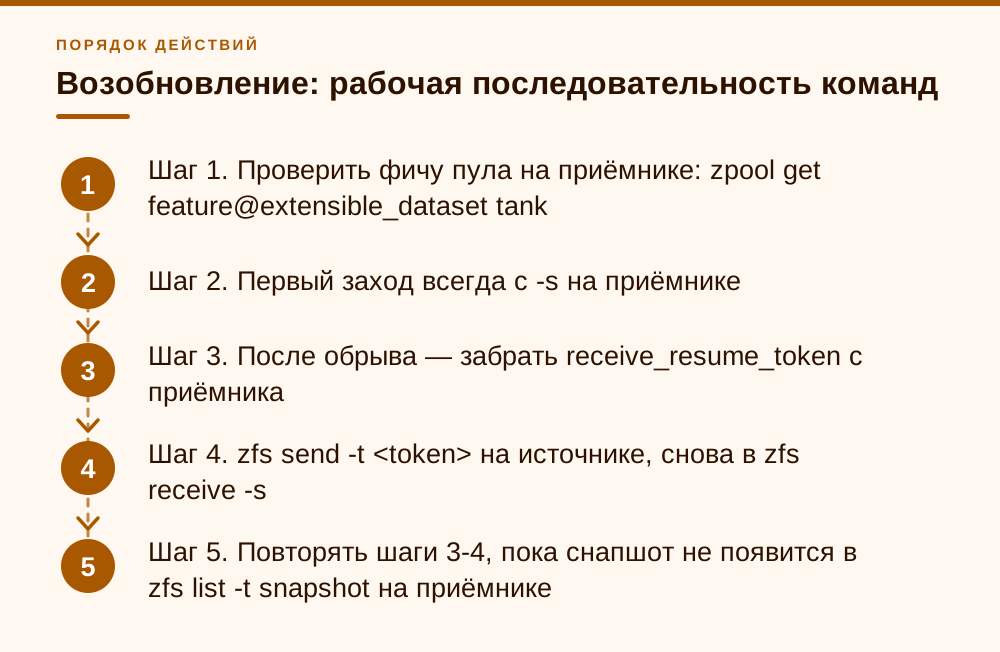
Возобновление: рабочая последовательность команд
Схема, которую я использую на всех стендах, где реплика едет по ненадёжному каналу. Отправитель — узел с боевым пулом, приёмник — узел с копией. Первый заход выглядит так (обратите внимание: -s стоит у receive, и он останется там навсегда — во всех последующих запусках тоже):
# ПЕРВЫЙ ЗАХОД (источник -> приёмник). -s стоит у receive!
zfs send -c -L -e -v tank/vm@2026-09-07 | \
  ssh backup 'zfs receive -s -u -F backup/vm'
Дальше канал падает. На приёмнике смотрим, есть ли что докачивать, и если токен непустой — собираем поток продолжения. Ключевой момент, который экономит нервы: -s указывается СНОВА. Иначе второй обрыв (а он будет, если канал уже показал характер) опять сотрёт всё, что доехало за эту сессию.
# ОБРЫВ. Забираем токен НА ПРИЁМНИКЕ
TOKEN=$(ssh backup "zfs get -H -o value receive_resume_token backup/vm")

# Оценка остатка: сухой прогон, ничего не передаёт
zfs send -nv -t "$TOKEN"

# ДОКАЧКА. -s указываем СНОВА, иначе следующий обрыв опять всё сотрёт
zfs send -v -t "$TOKEN" | \
  ssh backup 'zfs receive -s -u backup/vm'

# То же самое с буферизацией на длинном плече
zfs send -v -t "$TOKEN" | mbuffer -q -m 2G -s 1M | \
  ssh backup 'mbuffer -q -m 2G -s 1M | zfs receive -s -u backup/vm'
Полезная привычка перед докачкой — прикинуть остаток. zfs send -nv -t <token> делает сухой прогон и печатает оценку объёма. Если после четырёх часов передачи остаток почти не изменился — значит, вы не докачиваете, а каждый раз начинаете новую сессию, и где-то в скриптах теряется -s или токен.
Отдельно про транспорт. Голый ssh на длинных передачах — это боль: он однопоточный, чувствителен к RTT и любит вставать колом при флапах. Я ставлю в конвейер mbuffer с буфером в пару гигабайт с обеих сторон — это и сглаживает рывки диска, и даёт честную скорость на экране. Но помните: mbuffer лечит рывки, а не разрывы. Разрывы лечит именно -s.
- Шаг 1. Проверить фичу пула на приёмнике: zpool get feature@extensible_dataset tank
- Шаг 2. Первый заход всегда с -s на приёмнике
- Шаг 3. После обрыва — забрать receive_resume_token с приёмника
- Шаг 4. zfs send -t <token> на источнике, снова в zfs receive -s
- Шаг 5. Повторять шаги 3-4, пока снапшот не появится в zfs list -t snapshot на приёмнике
Отмена: zfs receive -A и место, которое никто не считает
Иногда докачка не нужна: передумали, поменяли схему датасетов, снапшот на источнике уехал по ретеншену. Тогда частичное состояние надо снести явно — само оно не рассосётся. Команда одна: zfs receive -A <fs|vol>. В мануале она описана как «Abort an interrupted zfs receive -s, deleting its saved partially received state». После неё receive_resume_token снова становится прочерком, скрытый %recv исчезает, место возвращается в пул.
И вот здесь — самая недооценённая проблема во всей теме. Недополученные данные занимают место, но их не видно привычными средствами. Человек смотрит zfs list, видит датасет на 200 ГБ, смотрит zpool list — а там съедено полтора терабайта, и начинается расследование про «утечку места в ZFS». Никакой утечки: это три забытых оборванных приёма за полгода, каждый по полтерабайта. Поэтому у меня в регламенте отдельным пунктом стоит еженедельный обход всех пулов-приёмников на предмет висящих токенов.
Обход делается рекурсивным zfs get: он показывает свойство по всему дереву, включая датасеты, которые вы уже забыли. Всё, что не прочерк, — кандидат на разбор: либо докачиваем, либо аборт. Правило простое: токену старше недели место в проде не место. За неделю или канал починился и вы доехали, или схема поменялась и токен протух вместе со снапшотом на источнике.
# Найти ВСЕ висящие недокачанные приёмы в дереве
zfs get -r -H -o name,value receive_resume_token backup | grep -v -P '\t-$'

# Отменить конкретный зависший приём и вернуть место в пул
zfs receive -A backup/vm

# Убедиться, что состояние снято: должен вернуться прочерк
zfs get -H -o value receive_resume_token backup/vm
Честно про подводный камень: команда -A не всесильна. В трекере OpenZFS есть issue #10439 (2020 год, сейчас закрыт): токен в свойстве виден, а receive -A отвечает «does not have any resumable receive state to abort». Ситуация редкая, встречалась на старых версиях и на давно протухшем состоянии. Если поймали — не бейтесь головой: проще снести целевой датасет-приёмник целиком и завести приём заново, чем воевать с рассинхроном внутреннего состояния. Да, это полная передача, но она хотя бы предсказуема по времени.
- zfs receive -A backup/vm — отменить приём и освободить место
- zfs get -r -H -o name,value receive_resume_token backup — найти ВСЕ висящие токены в дереве
- Прочерк в значении = чисто; любая длинная hex-строка = висит недополученное состояние
- Разница zpool list ALLOC против суммы zfs list USED — первый признак забытого %recv
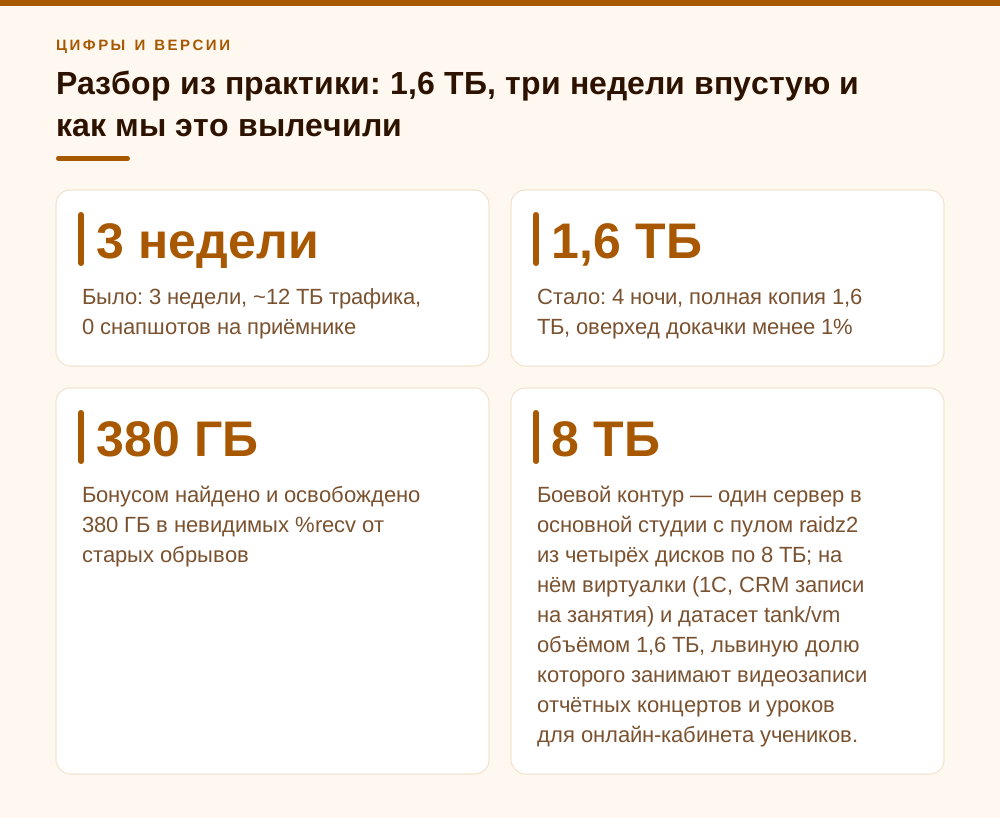
Разбор из практики: 1,6 ТБ, три недели впустую и как мы это вылечили
Школа танцев «Первый танец», 19 рабочих мест: администраторы на ресепшене, бухгалтерия, преподаватели. Боевой контур — один сервер в основной студии с пулом raidz2 из четырёх дисков по 8 ТБ; на нём виртуалки (1С, CRM записи на занятия) и датасет tank/vm объёмом 1,6 ТБ, львиную долю которого занимают видеозаписи отчётных концертов и уроков для онлайн-кабинета учеников. Копия должна была уехать на приёмник во втором филиале: Proxmox VE 9 с OpenZFS 2.3.x, канал между площадками — заявленные 300 Мбит/с, реально в ночном окне 150–200. На источнике Debian 12 с OpenZFS 2.1.11 из основного репозитория. Классика.
Пришли ко мне с формулировкой «репликация не работает третью неделю». Разобрали журналы: первичный send падал на 61 %, потом на 68 %, потом на 44 % — каждый раз обрыв ssh-сессии на переключении провайдерского плеча. Скрипт был написан честно и наивно: zfs send | ssh host zfs recv, без -s. То есть каждый обрыв выкидывал всё принятое, и утром скрипт бодро стартовал сначала. За три недели канал прожевал около 12 ТБ трафика и не создал ни одного снапшота на приёмнике. При этом на приёмнике «не было видно ничего» — что клиента и убеждало, что «ZFS не умеет докачку».
Что сделали. Добавили -s в receive и mbuffer 2 ГБ с обеих сторон. Поставили user hold на исходный снапшот, чтобы политика ретеншена не снесла его между попытками. Первый заход доехал до 47 % и упал — но теперь на приёмнике появился токен, и следующей ночью мы стартовали с 47 %, а не с нуля. Итого: четыре ночные сессии (из них две с обрывом), полная копия 1,6 ТБ на приёмнике на четвёртые сутки. Повторно передано сверх необходимого около 10 ГБ — хвосты недописанных записей на моменты обрывов, меньше 1 % объёма. Против 12 ТБ бесполезного трафика в прежней схеме.
Два побочных вывода из этого кейса. Первый: у клиента в пуле-приёмнике на тот момент уже болтались два недоделанных состояния от прошлых экспериментов админа — суммарно 380 ГБ, которые никто не считал и не видел. Снесли через receive -A. Второй: после перехода на инкременты (а они уже маленькие — несколько гигабайт свежих видео за день) ключ -s мы всё равно оставили. Он ничего не стоит, когда всё хорошо, и спасает, когда плохо. Убирать его «за ненадобностью» — экономия на спичках.
- Было: 3 недели, ~12 ТБ трафика, 0 снапшотов на приёмнике
- Стало: 4 ночи, полная копия 1,6 ТБ, оверхед докачки менее 1 %
- Бонусом найдено и освобождено 380 ГБ в невидимых %recv от старых обрывов
- Инкременты после первичной синхронизации — единицы ГБ за ночь, укладываются в окно с запасом
Грабли, на которых ломается докачка
Граблю номер один я считаю обязательной к заучиванию: токен привязан к конкретному снапшоту на источнике. Если этот снапшот между попытками уничтожен политикой ретеншена, докачка мертва. Ошибка выглядит дословно так: «cannot resume send: 'snapshot' used in the initial send no longer exists». Дальше выбора нет — только аборт приёма и полная передача заново. Лечится это на этапе проектирования: ставьте user hold на снапшот, который уехал в длинную передачу, и снимайте только после успешного завершения. Ключ -h у zfs send передаёт холды вместе с потоком, но защищает он снапшоты на приёмнике, а сторожить надо источник.
Вторая грабля — оркестраторы. Syncoid из пакета sanoid умеет докачку: по README, начиная с версии 1.4.18 он сам включает возобновляемые потоки, если их поддерживают источник и приёмник, а ключ --no-resume это отключает. Исторически у него был неприятный сценарий (issue sanoid#304, 2018 год): если снапшот с токеном на источнике удалён, syncoid не откатывался на полную передачу, а валился на этом датасете, пока не добавишь --no-resume руками. Issue закрыт, но ключ держу в памяти как аварийный откат на старых установках. По обзору Klara, znapzend и zxfer докачку не умеют вовсе — если у вас длинная первичка и один из этих инструментов, планируйте передачу как разовую операцию руками, а инструмент подключайте уже на инкрементах.
Отдельно про Proxmox и pve-zsync — его часто берут «потому что он уже в коробке». В исходнике pve-zsync приём собирается как zfs recv -F -- без ключа -s, receive_resume_token он не читает, в документации Proxmox про возобновление нет ни слова. То есть обрыв первичной синхронизации в pve-zsync — это ровно тот сценарий «всё сначала», с которого начиналась статья. Ключ --limit (ограничение полосы в КБ/с) спасает дневной канал, но не спасает от разрывов. Мой рецепт для ненадёжного канала: первичную заливку большого диска делать не через pve-zsync, либо сразу перейти на syncoid, который докачивает сам. Учтите, что pve-zsync опирается на собственные снапшоты вида rep_<имя задания>_<дата>, так что ручная заливка произвольного снапшота не станет для него базой инкремента автоматически.
Третья — шифрование и raw send. Комбинация zfs send -w плюс прерванная первичная передача исторически давала проблемы при возобновлении (характерная ошибка про «IV set guid missing»). Часть этих историй закрыта в актуальных ветках, часть всплывала снова. Единого мнения тут нет, и я не буду делать вид, что оно есть: если у вас raw-репликация зашифрованных датасетов, обязательно прогоните тест на своей версии до того, как поставите на это боевой бэкап. Проверяется за час на датасете в 20 ГБ с искусственным разрывом канала.
Четвёртая, бытовая: разные версии OpenZFS на плечах. Свежий отправитель может собрать поток с фичами, которых не понимает старый приёмник, и вы получите отказ уже на этапе receive — независимо от всякой докачки. Возобновляемый приём должны поддерживать обе стороны; любая поддерживаемая сейчас ветка OpenZFS это умеет. Точнее правило звучит так: если поток собран с -L, -c, -e или -w, на пуле-приёмнике должны быть включены соответствующие фичи (large_blocks, lz4_compress/zstd_compress, embedded_data, encryption), поэтому приёмник по версии OpenZFS не должен отставать от отправителя. На сентябрь 2026 актуальная стабильная ветка — OpenZFS 2.4.x (2.4.4 вышла 21 августа 2026), в дистрибутивах живут 2.2.x и 2.3.x. Проверяйте zfs version на обеих машинах, а не «ну там же везде ZFS».
- «used in the initial send no longer exists» — снапшот-источник снесён ретеншеном, докачка невозможна
- zfs hold keep tank/vm@snap перед длинной передачей, zfs release keep — после успеха
- syncoid ≥1.4.18 докачивает сам, --no-resume — аварийный откат; znapzend и zxfer докачку не умеют
- pve-zsync вызывает zfs recv -F без -s — докачки нет, первичную заливку по плохому каналу делайте иначе
- raw send (-w) зашифрованных датасетов — тестируйте возобновление на своей версии отдельно
- Приёмник не должен быть старше отправителя по версии OpenZFS
Что я делаю в проде: короткий регламент
Порядок приоритетов, если у вас сейчас всё горит и надо решить, за что хвататься. Первое — добавьте -s в receive во всех скриптах репликации. Это одна буква, откатывать нечего, риска нет, выигрыш появляется на первом же обрыве. Второе — поставьте hold на снапшоты, участвующие в длинных передачах. Третье — заведите еженедельную проверку висящих токенов, чтобы не терять место втихую. Всё остальное — тюнинг.
На что можно спокойно забить. Не надо переписывать транспорт на экзотику и городить самописные чанкеры поверх ZFS — механизм докачки штатный и работает. Не надо гнаться за минимальным оверхедом повторной передачи: доли процента, которые вы теряете на хвостах при обрыве, не стоят ни одной строчки дополнительного кода. И не надо бояться, что -s «испортит датасет»: пока поток не доехал, целевого снапшота просто не существует, а всё недополученное живёт в отдельном скрытом клоне и уничтожается одной командой.
И последнее, про мониторинг. Метрика, которую я снимаю с каждого приёмника, — количество непустых receive_resume_token и возраст самого старого из них. Растёт число — значит, канал деградировал или скрипт теряет токен между запусками. Растёт возраст — значит, кто-то бросил передачу и забыл, и у вас медленно утекает место. Обе ситуации ловятся одной строчкой в cron и уведомлением в мессенджер, и обе стоят дешевле, чем разбирательство «куда делся терабайт» через полгода.
#!/bin/bash
# /usr/local/sbin/zfs-stale-tokens.sh — в cron раз в неделю
POOL=backup
STALE=$(zfs get -r -H -o name,value receive_resume_token "$POOL" \
        | grep -v -P '\t-$' | awk '{print $1}')
if [ -n "$STALE" ]; then
  echo "Висят недокачанные приёмы на $POOL:"
  echo "$STALE"
  exit 1
fi- Сегодня: -s во все zfs receive, без исключений
- Сегодня: hold на снапшот перед первичной передачей больше 500 ГБ
- На неделе: cron-обход receive_resume_token по всем приёмникам с алертом
- На неделе: сверка zfs version на всех плечах репликации
- Когда дойдут руки: mbuffer в конвейер и тест возобновления для raw send
Частые вопросы
Какой стороне нужен ключ -s — отправителю или получателю?
Только получателю, и указывать его надо ЗАРАНЕЕ, при старте передачи: zfs receive -s. Отправитель на первом заходе про докачку ничего не знает. Ключ -t (поток продолжения) появляется у отправителя уже потом, когда токен получен с приёмника. И да, при каждой докачке -s у receive нужно указывать снова, иначе следующий обрыв опять всё сотрёт.
Где взять receive_resume_token, если zfs list не показывает никакого датасета?
Свойство читается с той файловой системы или тома, куда шёл приём, даже если полноценного датасета вы там не видите: zfs get -H -o value receive_resume_token backup/vm. Недополученные данные лежат в скрытом клоне вида backup/vm/%recv, который обычный zfs list не выводит. Прочерк в ответе означает, что докачивать нечего.
Можно ли докачать передачу, которая была запущена без -s?
Нет. Без -s недополученные данные удаляются в момент обрыва — восстанавливать уже нечего. Это самая частая причина, по которой людям кажется, что «в ZFS нет докачки». Решение только одно: добавить -s в скрипты сейчас, чтобы следующий обрыв был докачиваемым.
Что делать, если при возобновлении получаю «used in the initial send no longer exists»?
Снапшот, на котором прервалась передача, уничтожен на источнике — обычно политикой ретеншена между попытками. Токен стал бесполезен. Отменяйте приём через zfs receive -A и запускайте передачу заново, на этот раз поставив zfs hold на снапшот до окончания передачи.
Сколько места занимает недокачанное состояние и как его найти?
Ровно столько, сколько успело приехать: у меня был случай с 380 ГБ забытых остатков на пуле-приёмнике. В zfs list этого не видно, поэтому ищите рекурсивно по свойству: zfs get -r -H -o name,value receive_resume_token <pool>. Всё, что не прочерк, — либо докачиваем, либо сносим через receive -A.
Нужен ли zpool upgrade, чтобы включить возобновляемый приём?
Только если на пуле-приёмнике отключена фича extensible_dataset. Проверяется командой zpool get feature@extensible_dataset <pool>. На любом пуле, созданном за последние годы, она активна по умолчанию, так что в 99 % случаев ничего апгрейдить не нужно.
Умеет ли pve-zsync в Proxmox докачивать прерванную синхронизацию?
Нет. pve-zsync принимает поток командой zfs recv -F без -s и receive_resume_token не использует, поэтому обрыв первичной синхронизации означает передачу заново. Для больших первичных заливок по нестабильному каналу берите syncoid (докачивает сам с версии 1.4.18) или ручной zfs send | zfs receive -s, а ключом --limit у pve-zsync ограничивайте полосу, чтобы не забивать дневной канал.
Источники
- OpenZFS, zfs-receive(8) — Описание ключей -s («If the receive is interrupted, save the partially received state, rather than deleting it», требование фичи extensible_dataset) и -A («Abort an interrupted zfs receive -s, deleting its saved partially received state»), а также свойства receive_resume_token. Ветка master: https://openzfs.github.io/openzfs-docs/man/master/8/zfs-receive.8.html
- OpenZFS, zfs-send(8) — Ключ -t receive_resume_token («Creates a send stream which resumes an interrupted receive») и ключ -S/--saved для отправки частично принятого состояния дальше. https://openzfs.github.io/openzfs-docs/man/master/8/zfs-send.8.html
- OpenZFS Docs, Basic Concepts → Send and Receive — Раздел «Resuming an interrupted transfer»: получение токена через zfs get -H -o value receive_resume_token, возобновление через zfs send -t, отмена через zfs receive -A. https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Operations/Send%20and%20Receive.html
- OpenZFS, zstream(8) — Подкоманда zstream token — штатный разбор содержимого resume-токена (в том числе поле toname). Добавлена в PR openzfs/zfs#10558 (июль 2020, OpenZFS 2.0). https://openzfs.github.io/openzfs-docs/man/master/8/zstream.8.html
- Трекер OpenZFS и sanoid: известные ограничения — issue openzfs/zfs#10439 (2020, закрыт) — receive -A отвечал «does not have any resumable receive state to abort» при видимом токене; issue jimsalterjrs/sanoid#304 (2018, закрыт) — syncoid падал вместо отката на --no-resume, если снапшот с токеном удалён на источнике. https://github.com/openzfs/zfs/issues/10439 и https://github.com/jimsalterjrs/sanoid/issues/304
- Klara Systems, ZFS Orchestration Tools — Part 2: Replication — Сравнение оркестраторов: syncoid поддерживает возобновление прерванной передачи, znapzend и zxfer — нет. https://klarasystems.com/articles/zfs-orchestration-tools-part-2-replication/
- sanoid/syncoid, README — Автоматическое включение возобновляемых потоков с версии 1.4.18 при поддержке обеими сторонами; ключ --no-resume («tells syncoid to not use resumable zfs send/receive streams»). https://github.com/jimsalterjrs/sanoid/blob/master/README.md
- Proxmox VE Wiki, PVE-zsync — Ключи sync/create (--source, --dest, --maxsnap, --limit, --skip); механизма возобновления прерванной передачи нет, в исходнике приём — zfs recv -F. https://pve.proxmox.com/wiki/PVE-zsync
- OpenZFS, релиз zfs-2.4.4 — Актуальная стабильная ветка на сентябрь 2026, выпуск 21.08.2026 (одновременно 2.3.9 и 2.2.11). https://github.com/openzfs/zfs/releases/tag/zfs-2.4.4