
Resilver после замены диска завершён без ошибок. Что на самом деле проверено в пуле, а что нет
Знакомая картина: диск в пуле выпал, вы его заменили, к утру `zpool status` рапортует «resilvered, 0 errors» и «No known data errors», тикет закрывается. Проблема в том, что эта строчка — отчёт об операции восстановления, а не заключение о целостности пула. Разбираю по мануалу OpenZFS, чем resilver отличается от scrub, что именно он обошёл, а что нет, как читать вывод `zpool status` после проверки, зачем нужны флаги `-e` и `-C`, почему быстрый sequential resilver вообще не сверяет контрольные суммы, — и показываю выезд, где плановый scrub через три недели после «успешной» замены диска нашёл два неисправимых файла.
«Resilver закончился, ошибок нет» — и это почти ничего не говорит о пуле
Разговор, который у меня повторяется несколько раз в год. У клиента в RAIDZ2 деградировал диск, мы его меняем, ночью идёт resilver, утром в zpool status красивое scan: resilvered 4.31T in 19:40:12 with 0 errors и ниже errors: No known data errors. Админ на стороне клиента ставит галочку: пул проверен, всё цело, живём дальше. Через месяц выясняется, что на соседнем диске тихо копились ошибки контрольных сумм, и часть архива за позапрошлый год просто не читается.
Мануал OpenZFS формулирует разницу прямо, без вариантов толкования: resilvering only examines data that ZFS knows to be out of date, whereas scrubbing examines all data to discover silent errors due to hardware faults or disk failure. То есть resilver смотрит только те данные, которые ZFS считает устаревшими на конкретном устройстве. Scrub читает все выделенные блоки пула и сверяет каждый с его контрольной суммой.
Дальше начинается тонкость, которую редко проговаривают, и из-за неё спор «нужен ли scrub после resilver» тянется на форумах годами. Если вы заменили диск целиком на чистый новый, dirty time log для этого устройства покрывает всю историю пула — и healing-resilver фактически обойдёт все выделенные блоки того vdev, куда этот диск входит. По одному vdev проверка получается почти полной. Ключевое слово — «почти», и расходится оно ровно в четырёх местах.
Первое: resilver трогает только свой top-level vdev. Если пул собран из трёх групп RAIDZ2, то после замены диска в первой группе про вторую и третью вы не узнали ничего. Второе: если диск отсутствовал недолго — вылетел и вернулся, offline/online, отвалился по кабелю — DTL узкий, и resilver честно догонит только дельту за пропущенные транзакционные группы. Это тот самый случай, когда resilver отрабатывает за четыре минуты, а человек думает, что 40 ТБ проверены. Третье: sequential resilver вообще не сверяет контрольные суммы, про него отдельный раздел ниже. Четвёртое, самое обидное: resilver — это не scrub и в учёте проверок пула не участвует. Свойство last_scrubbed_txg по zpoolprops(7) описывает транзакционную группу, до которой дошёл последний scrub, а zpool status -v по мануалу печатает ошибки, накопленные с последнего завершённого scrub. Если scrub на пуле не запускали полгода, строка No known data errors после resilver говорит только о том, что за это время ZFS не наткнулась на неисправимый блок при обычных чтениях.
- resilver = только устаревшие данные на конкретном устройстве, только внутри своего top-level vdev
- scrub = все выделенные блоки всего пула, сверка каждого с контрольной суммой
- короткий простой диска → короткий DTL → resilver за минуты и почти нулевая проверка
- `last_scrubbed_txg` и список ошибок `zpool status -v` привязаны к scrub, а не к resilver — это не замена плановой проверки
Что делает scrub: мануал, флаги и одно жёсткое ограничение
Scrub обходит всё дерево блоков пула и для каждого выделенного блока читает данные и сверяет контрольную сумму. При наличии избыточности — mirror, RAIDZ, dRAID — найденное повреждение чинится автоматически, если исправных копий хватает на реконструкцию. Если избыточности нет (одиночный диск, полосатый stripe), scrub всё равно полезен: он не починит, но покажет, какие именно файлы уже мертвы, пока вы ещё можете достать их из бэкапа. Частичное исключение — датасеты с copies=2, там вторая копия даст шанс на автолечение даже на одном диске.
Две вещи, которые надо понимать про охват. Scrub читает только выделенные блоки — свободное место он не трогает, и это правильно, читать там нечего. И он проверяет состояние на момент старта: всё, что вы записали, пока проверка шла, попадёт уже в следующий проход. Никакой «непрерывной валидации» ZFS не делает, кроме обычной сверки при каждом чтении.
Жёсткое ограничение: на одном пуле scrub и resilver одновременно не запускаются. Мануал объясняет это нагрузкой — because scrubbing and resilvering are I/O-intensive operations, ZFS only allows one at a time. Отсюда самая типовая ошибка организационного плана: человек после замены диска сразу пробует zpool scrub tank, получает отказ, говорит «сделаю потом» — и не делает. У меня железное правило: как только стартовал resilver, я тут же ставлю задачу в календарь на дату предполагаемого окончания плюс сутки, и в ней уже команда на scrub. Не «после resilver», а конкретная дата.
Набор флагов в ветке 2.3 небольшой и весь рабочий. Отдельно отмечу -e: он перепроверяет только файлы, которые уже засветились в zpool status -v, и требует включённой фичи пула head_errlog. Это ровно то, что нужно, когда вы поменяли контроллер или кабель и хотите за минуты понять, ушла ли проблема, а не гонять 70 ТБ. И -C, который продолжает с сохранённой транзакционной группы (last_scrubbed_txg) вместо старта с нуля — спасение для больших пулов, где scrub не влезает в выходные.
- `zpool scrub tank` — начать или возобновить приостановленную проверку
- `-p` — пауза; состояние периодически пишется на диск и переживает ребут и export пула
- `-s` — остановить полностью (прогресс теряется)
- `-w` — не отдавать приглашение до конца проверки, удобно в скриптах
- `-e` — проверить только файлы с уже известными ошибками, требует `head_errlog`
- `-C` — продолжить с последней сохранённой txg, см. свойство пула `last_scrubbed_txg`
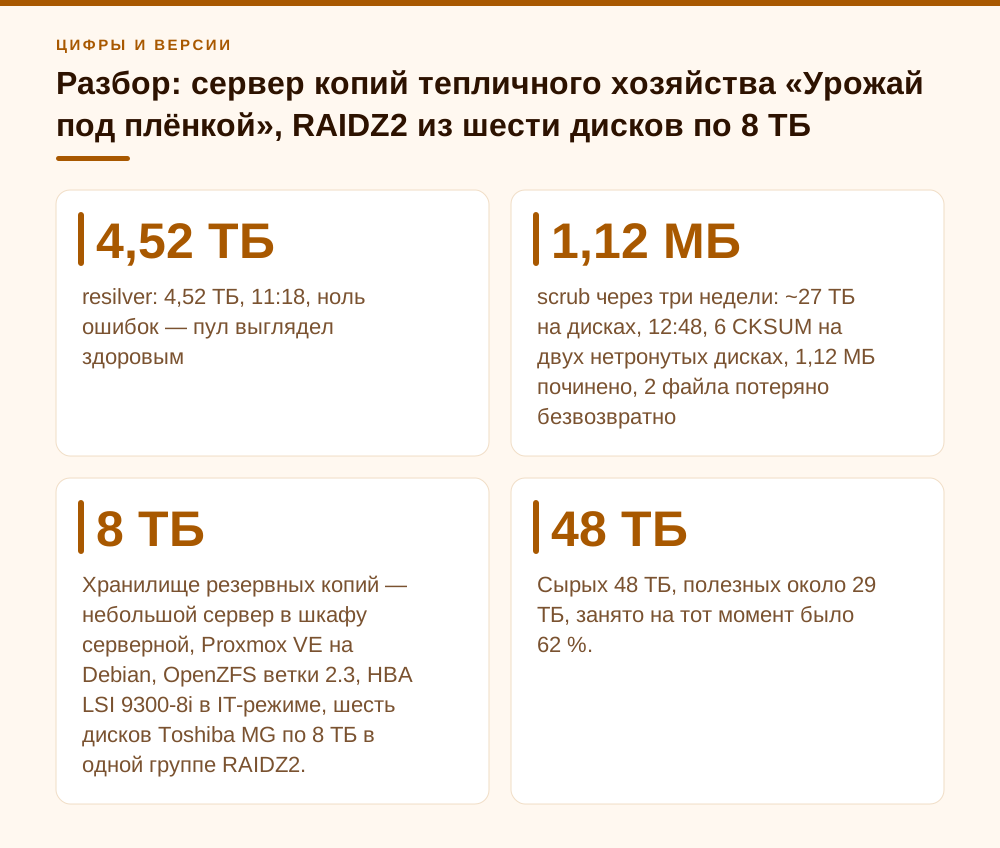
Разбор: сервер копий тепличного хозяйства «Урожай под плёнкой», RAIDZ2 из шести дисков по 8 ТБ
Тепличное хозяйство, 24 рабочих места: офис с бухгалтерией и агрономической службой плюс операторская тепличного комплекса. Хранилище резервных копий — небольшой сервер в шкафу серверной, Proxmox VE на Debian, OpenZFS ветки 2.3, HBA LSI 9300-8i в IT-режиме, шесть дисков Toshiba MG по 8 ТБ в одной группе RAIDZ2. Сырых 48 ТБ, полезных около 29 ТБ, занято на тот момент было 62 %. Туда льются копии виртуалок, дампы 1С, выгрузки журналов климат-контроллеров теплиц и файловая шара с фотоархивом агрономов — глубина хранения около полугода.
В понедельник утром прилетел алерт: пул в состоянии DEGRADED, диск sdf набрал WRITE-ошибок и был помечен FAULTED. Диск в гарантии, замена приехала на следующий день, поставили, запустили штатно:
zpool replace tank /dev/disk/by-id/wwn-0x5000039a1b2c3d4e /dev/disk/by-id/wwn-0x5000039a7f8e9d01
zpool status -v tank
Resilver отработал за 11 часов 18 минут и восстановил 4,52 ТБ. В выводе — ноль ошибок. Пул вернулся в ONLINE. Ровно на этом месте обычно всё и заканчивается: диск заменили, статус зелёный, задача закрыта.
Я поставил scrub на ближайшие выходные — по регламенту, а не потому что что-то подозревал. Проверка всех занятых блоков (около 27 ТБ на дисках вместе с чётностью) шла почти 13 часов со средней скоростью около 590 МБ/с, и вот что она принесла:
  pool: tank
 state: ONLINE
status: One or more devices has experienced an error resulting in data
        corruption.  Applications may be affected.
action: Restore the file in question if possible.  Otherwise restore the
        entire pool from backup.
  scan: scrub repaired 1.12M in 12:48:17 with 2 errors on Sun Aug 16 06:12:33 2026
config:

        NAME        STATE     READ WRITE CKSUM
        tank        ONLINE       0     0     0
          raidz2-0  ONLINE       0     0     0
            sdb     ONLINE       0     0     0
            sdc     ONLINE       0     0     4
            sdd     ONLINE       0     0     0
            sde     ONLINE       0     0     0
            sdf     ONLINE       0     0     0
            sdg     ONLINE       0     0     2

errors: 2 data errors, use '-v' for a list
Четыре ошибки контрольных сумм на sdc, две на sdg — на дисках, которые никто не менял и которые всё это время числились здоровыми. Часть повреждений RAIDZ2 починил сам (repaired 1.12M), но два блока восстановить не смог: в них к тому моменту сошлись повреждения на двух устройствах сразу. zpool status -v показал два файла — оба из фотоархива агрономов, оба датированы позапрошлым сезоном. То есть данные лежали битыми задолго до отказа sdf, и resilver их даже не открывал: он занимался только реконструкцией содержимого заменённого диска.
Дальше разбор причины. sdc и sdg сидели на одном кабеле SFF-8643 от HBA. Смотрели smartctl -a: у обоих дисков реаллокаций ноль, а вот dmesg за три месяца показывал редкие, раз в несколько суток, сообщения о сбросе фазы на этом порту. Перетянули и заменили кабель, обновили прошивку LSI 9300-8i до актуальной ветки, сбросили счётчики zpool clear tank. Контрольный zpool scrub -e tank по журналу известных ошибок отработал за 11 минут — новых не появилось. Полный scrub через неделю прошёл с нулём. Два битых файла восстановили из офлайн-копии на внешнем диске, который хозяйство раз в квартал увозит из серверной, — глубины хранения на самом сервере уже не хватало. Итог: заменённый диск был симптомом, а реальная проблема сидела на соседнем порту HBA — и без scrub мы бы её увидели только тогда, когда посыпался бы второй диск и RAIDZ2 не вытянул бы уже ничего.
- resilver: 4,52 ТБ, 11:18, ноль ошибок — пул выглядел здоровым
- scrub через три недели: ~27 ТБ на дисках, 12:48, 6 CKSUM на двух нетронутых дисках, 1,12 МБ починено, 2 файла потеряно безвозвратно
- корень — общий кабель SFF-8643 и старая прошивка HBA, а не диски
- `zpool scrub -e` дал контрольную проверку за 11 минут вместо 13 часов
Sequential resilver: быстро, но контрольные суммы там не сверяются вообще
У zpool replace есть флаг -s, который включает последовательную реконструкцию: новое устройство заполняется линейно, по порядку физических блоков, а не обходом дерева. На больших зеркалах это в разы быстрее, потому что диск читается и пишется последовательно, без случайных скачков головы. Мануал zpool-replace(8) формулирует ограничение так: sequential reconstruction is not supported for raidz configurations — то есть это режим для mirror и dRAID (у dRAID на нём же построено восстановление на распределённый spare). Учтите ещё одну строчку оттуда же: any in progress scrub will be canceled — zpool replace отменяет идущий scrub, и после замены его придётся запускать заново.
И вот ключевая фраза из мануала, которую надо прочитать целиком: checksums are not verified during sequential reconstruction so a scrub is started when the resilver completes. Никакой сверки контрольных сумм в процессе не происходит вообще — поэтому по завершении ZFS сама запускает scrub. То есть реальная проверка целостности в этом сценарии выполняется не resilver-ом, а тем scrub-ом, который стартует следом.
Практический вывод: если вы использовали zpool replace -s, ни в коем случае не гасите последующий scrub, чтобы «не грузить сервер в рабочее время», и следите, чтобы машина не ушла в перезагрузку сразу после окончания resilver. Иначе вы получите заполненный диск с восстановленной избыточностью, содержимое которого никто не проверял. Я на зеркалах -s использую охотно — экономия по времени на дисках по 18-20 ТБ измеряется часами, — но всегда через -w, чтобы точно дождаться конца, и с явным контролем, что scrub стартовал. Автозапуск этого scrub управляется параметром модуля zfs_rebuild_scrub_enabled (по умолчанию 1: scrub стартует, когда завершилась последняя активная последовательная реконструкция). Встречал его выставленным в 0 «для ускорения миграций» — проверьте cat /sys/module/zfs/parameters/zfs_rebuild_scrub_enabled. Скорость самой реконструкции ограничивают zfs_rebuild_vdev_limit (64 МиБ одновременно выданного I/O на листовое устройство) и zfs_rebuild_max_segment (1 МиБ на сегмент чтения).
Отдельная ловушка того же ряда — рестарт. zpool resilver запускает восстановление заново с самого начала, если оно уже идёт; накопленный прогресс не сохраняется. По мануалу zpool-resilver(8) диски, запланированные на отложенный resilver, добавляются в новый проход — это работа фичи пула resilver_defer: с ней замена второго диска во время идущего resilver не перезапускает текущий, а ставится в очередь. Параметр модуля zfs_resilver_disable_defer=1 эту фичу игнорирует, и любое событие, требующее resilver, сразу перезапускает идущий. На старых пулах, поднятых много лет назад и ни разу не апгрейженных, resilver_defer может быть выключена — проверьте zpool get feature@resilver_defer tank (нужно enabled или active) перед тем, как менять второй диск, не дождавшись окончания первого.
- `zpool replace -s` — mirror и dRAID, для raidz не поддерживается
- во время sequential-реконструкции контрольные суммы не проверяются
- по завершении ZFS сама стартует scrub — это и есть настоящая проверка, не гасите её
- `zpool resilver` перезапускает идущее восстановление с нуля; спасает фича `resilver_defer`
- размер нового устройства должен быть не меньше минимального размера дисков в группе
- `zpool replace` отменяет идущий scrub — после замены запускайте его заново
- `zfs_rebuild_scrub_enabled=1` (дефолт) — не выключать, иначе проверки после `-s` не будет
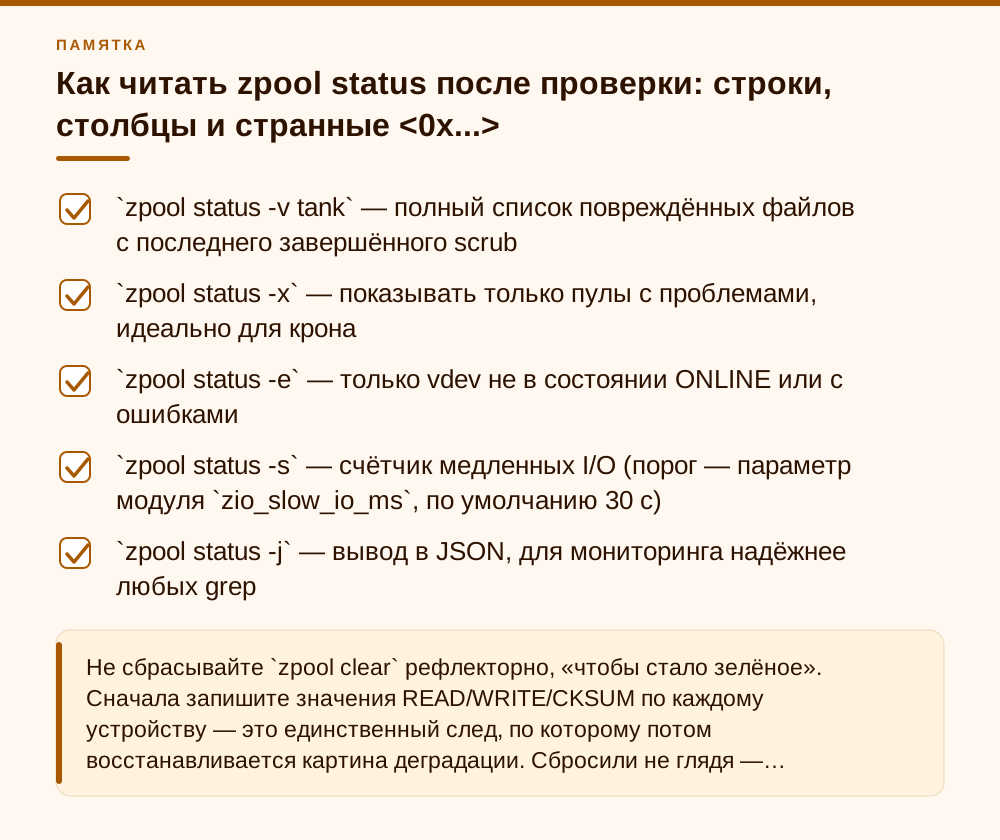
Как читать zpool status после проверки: строки, столбцы и странные <0x...>
Начинайте с блока scan:. Пока идёт проверка, zpool status показывает процент выполнения и оценку времени до конца — мануал честно предупреждает, что обе цифры приблизительные, и на практике оценка сильно врёт в первые часы, пока алгоритм не набрал статистику. После завершения строка фиксирует итог: сколько починено (repaired), сколько времени заняло и с каким числом ошибок закончилось. Отдельно смотрите дату — если там прошлый год, у вас нет проверки, у вас есть иллюзия.
Столбцы READ, WRITE и CKSUM в таблице устройств означают разное, и путать их нельзя. READ/WRITE — это ошибки ввода-вывода на уровне устройства: диск не отдал или не принял блок. Растущие READ/WRITE чаще указывают на кабель, бэкплейн, контроллер или питание, а не обязательно на сам диск. CKSUM — блок прочитался физически нормально, но контрольная сумма не сошлась. Это и есть тихое повреждение: то, ради чего scrub вообще существует. Ненулевой CKSUM на диске, который «в порядке» по SMART, — почти всегда тракт передачи, как было у тепличного хозяйства.
Строка errors: внизу — итог. No known data errors значит, что в журнале ошибок пула сейчас нет записей о неисправимых повреждениях. Если ошибки есть, zpool status -v печатает полный список всех выявленных повреждений с последнего завершённого scrub — обратите внимание на формулировку: именно с последнего полного scrub, а не с последнего resilver. Файлы там могут отображаться не именами, а конструкциями вида <0x1a2b>:<0x3c4d>. Это бывает в двух случаях: файл уже удалён, либо ZFS не может преобразовать идентификатор в имя.
Второй случай прямо касается шифрования, и это важный практический момент. Для scrub зашифрованных файловых систем загружать ключи не требуется — проверка контрольных сумм идёт на уровне блоков и в открытые данные не заглядывает. Но если ключи не загружены и при этом нашлась неисправимая ошибка, имя файла в подробный отчёт zpool status -v не попадёт: вы получите только шестнадцатеричный идентификатор и будете потом мучительно сопоставлять его с содержимым. Поэтому на серверах с нативным шифрованием ZFS я планирую scrub так, чтобы датасеты в этот момент были смонтированы и ключи загружены. Полезные ключи вывода на каждый день: -e — показать только нездоровые vdev, -s — счётчик медленных операций ввода-вывода, -p — числа в машинном виде, -j — JSON, который удобно скармливать Zabbix вместо парсинга текста регулярками.
- `zpool status -v tank` — полный список повреждённых файлов с последнего завершённого scrub
- `zpool status -x` — показывать только пулы с проблемами, идеально для крона
- `zpool status -e` — только vdev не в состоянии ONLINE или с ошибками
- `zpool status -s` — счётчик медленных I/O (порог — параметр модуля `zio_slow_io_ms`, по умолчанию 30 с)
- `zpool status -j` — вывод в JSON, для мониторинга надёжнее любых grep
- `zpool clear tank` — сбросить счётчики после устранения аппаратной причины
Регламент: как часто, в какое окно и как не уронить сервер проверкой
Общепринятого единого норматива нет, и надо это честно сказать. Индустриальная практика, которую разделяю и я: раз в месяц для пулов на механических дисках под активной нагрузкой и раз в квартал для больших архивных массивов, где данные меняются редко. Верхняя граница, за которую заходить не стоит ни при каких обстоятельствах, — четыре месяца. Для SSD-пулов месячный scrub тоже уместен, но там его стоимость по времени в разы ниже, так что спорить особо не о чем. Слепо копировать «еженедельно» с форумов не надо: на 100-терабайтном пуле недельный scrub просто не будет успевать завершаться, и вы получите бесконечную фоновую нагрузку вместо проверки.
Проверьте сначала, что уже настроено, — во многих дистрибутивах пакеты ZFS кладут готовые таймеры или cron-задание, и люди добавляют своё поверх, получая двойной scrub:
systemctl list-unit-files 'zfs-scrub*'
ls -l /etc/cron.d/ | grep -i zfs
zpool get last_scrubbed_txg tank
На Debian и Proxmox VE пакет zfsutils-linux кладёт файл /etc/cron.d/zfsutils-linux: в нём TRIM в первое воскресенье месяца и scrub во второе, в 00:24, через скрипт /usr/lib/zfs-linux/scrub, который проходит по импортированным пулам:
# Scrub the second Sunday of every month.
24 0 8-14 * * root if [ $(date +\%w) -eq 0 ] && [ -x /usr/lib/zfs-linux/scrub ]; then /usr/lib/zfs-linux/scrub; fi
Сам OpenZFS поставляет systemd-шаблоны zfs-scrub-weekly@.timer и zfs-scrub-monthly@.timer (OnCalendar=weekly/monthly, Persistent=true, RandomizedDelaySec=1h), которые вызывают zfs-scrub@.service. Сервис запускает zpool scrub -w, а если scrub уже идёт — просто ждёт его через zpool wait -t scrub; при остановке юнита проверка ставится на паузу (zpool scrub -p), а не обрывается. Включается на конкретный пул так:
systemctl enable --now zfs-scrub-monthly@tank.timer
systemctl list-timers 'zfs-scrub*'
Выбирайте что-то одно: либо cron из пакета, либо таймер. Если хочется свой день недели, я комментирую строку scrub в /etc/cron.d/zfsutils-linux и включаю таймер. Добавлять в юнит Nice= или IOSchedulingClass=idle бессмысленно: процесс zpool только отправляет команду в ядро, сам scrub выполняют потоки модуля ZFS, и приоритет пользовательского процесса на них не влияет — нагрузку регулируют параметрами модуля, о них ниже.
Если scrub заметно мешает продуктиву, крутить нужно правильные ручки. Дефолты в ветке 2.3 такие: zfs_scan_vdev_limit — 16 МиБ, максимальный объём одновременно выданных запросов scrub/resilver на одно листовое устройство; zfs_vdev_scrub_max_active — 2 активные операции на устройство; zfs_scrub_min_time_ms — 1000 мс, минимальное время, которое sync-поток тратит на scrub между сбросами транзакционных групп; zfs_resilver_min_time_ms — 3000 мс для resilver. Уменьшение zfs_vdev_scrub_max_active до 1 и zfs_scrub_min_time_ms до 500 даёт заметное облегчение продуктиву ценой удлинения прохода. Из семейства zfs_scan_* полезно знать ещё три: zfs_scan_mem_lim_fact — доля ОЗУ под сортировку I/O последовательным алгоритмом сканирования (по умолчанию 1/20); zfs_scan_checkpoint_intval — раз в 7200 секунд сканер останавливает обход метаданных и выдаёт накопленные проверки на диск, чтобы прогресс пережил перезагрузку; zfs_scan_legacy — возврат к старому алгоритму, когда I/O выдаётся сразу по мере обнаружения блоков, на современных версиях трогать незачем. Ещё один нюанс: zfs_scrub_after_expand по умолчанию равен 1, то есть после расширения группы RAIDZ пул сам уходит в scrub для проверки контрольных сумм всех блоков. Это правильное поведение, не отключайте его в момент миграции, когда «и так всё тормозит».
И то, чего делать нельзя ни при каких обстоятельствах. Параметр zfs_no_scrub_io отключает чтение данных: scrub превращается в обход метаданных и завершается быстро, с нулём ошибок и полной имитацией здорового пула. Параметр zfs_scan_suspend_progress замораживает проверку, не помечая её приостановленной. Оба существуют для отладки самой ZFS. В ту же компанию относится zfs_scan_ignore_errors: с ним по завершении scrub DTL удаляется даже при неисправимых ошибках, то есть пул перестаёт помнить, что с устройством что-то не так. Раз в пару лет я встречаю их прописанными в /etc/modprobe.d/zfs.conf на боевом сервере — кто-то когда-то «ускорил scrub» и забыл. Проверьте у себя: cat /sys/module/zfs/parameters/zfs_no_scrub_io должен показать 0.
- ежемесячно — активные пулы на HDD; ежеквартально — большие архивы; максимум 4 месяца
- окно — ночь выходного дня, с `RandomizedDelaySec` при нескольких серверах
- тормозит продуктив: `zfs_vdev_scrub_max_active=1`, `zfs_scrub_min_time_ms=500`
- не влезает в окно: `zpool scrub -p` на паузу (переживает ребут), потом `zpool scrub tank`
- не влезает совсем: `zpool scrub -C tank` — продолжать с сохранённой txg
- никогда: `zfs_no_scrub_io=1`, `zfs_scan_suspend_progress=1`, `zfs_scan_ignore_errors=1` — это отладочные, они рисуют фальшивое здоровье
- Debian/Proxmox: cron из `zfsutils-linux` (второе воскресенье) или `zfs-scrub-monthly@<пул>.timer` — не оба сразу
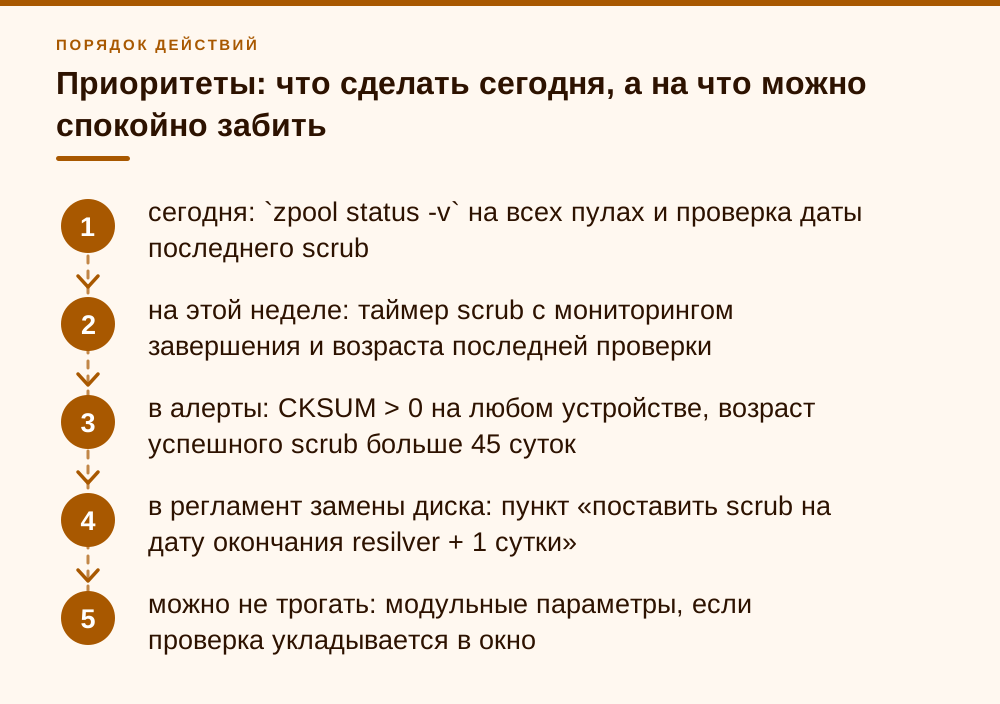
Приоритеты: что сделать сегодня, а на что можно спокойно забить
В первую очередь — регламентный scrub с контролем завершения. Это единственное, что вообще обнаруживает тихое повреждение данных; всё остальное вокруг ZFS без этого имеет ограниченный смысл. Второе по важности — алерт не на «пул DEGRADED», а на ненулевой CKSUM у любого устройства и на возраст последнего успешного scrub больше заданного порога. Пул может месяцами быть ONLINE и при этом медленно гнить. Третье — после каждой замены диска ставить scrub задачей с датой, а не намерением; за годы это правило спасло больше данных, чем любые тонкие настройки.
На что можно забить со спокойной совестью. На тюнинг модульных параметров, если scrub укладывается в окно и никто не жалуется на скорость, — дефолты OpenZFS адекватны, и лезть туда без измеренной проблемы незачем. На еженедельный scrub, если у вас не банк и не медицинский архив: месяц — рабочая частота. На панику из-за одиночного CKSUM после жёсткого выключения питания: посмотрите, повторится ли он на следующем проходе, и не спешите менять диск. И на споры о том, «портит ли scrub диски»: последовательное чтение — самая щадящая нагрузка, какую вообще можно дать механическому диску, и риск здесь несопоставим с риском обнаружить повреждение только во время восстановления после отказа.
И общая мысль, ради которой всё это писалось. ZFS даёт вам инструмент, которого нет у классических RAID-контроллеров: возможность точно знать, что каждый блок на месте и цел. Но это именно инструмент, а не автоматическое свойство файловой системы. Если scrub не запускается по расписанию и никто не смотрит на его результат, то от аппаратного RAID-5 c батарейкой вы отличаетесь только тем, что у вас есть неиспользуемая возможность узнать правду. Замена диска эту возможность не реализует — она только возвращает избыточность.
- сегодня: `zpool status -v` на всех пулах и проверка даты последнего scrub
- на этой неделе: таймер scrub с мониторингом завершения и возраста последней проверки
- в алерты: CKSUM > 0 на любом устройстве, возраст успешного scrub больше 45 суток
- в регламент замены диска: пункт «поставить scrub на дату окончания resilver + 1 сутки»
- можно не трогать: модульные параметры, если проверка укладывается в окно
Частые вопросы
Можно ли запустить scrub, пока идёт resilver?
Нет. ZFS разрешает на пуле только одну такую операцию за раз — и scrub, и resilver сильно нагружают ввод-вывод. Команда просто вернёт ошибку. Дождитесь окончания resilver и запускайте scrub после него; лучше сразу поставить задачу на конкретную дату, а не откладывать «на потом».
Если я заменил диск целиком, resilver ведь обошёл все данные — зачем ещё scrub?
Он обошёл все выделенные блоки только того top-level vdev, в который входит новый диск, и только под задачу реконструкции. Другие vdev пула не тронуты вообще. Плюс свойство last_scrubbed_txg и список ошибок zpool status -v по мануалу привязаны к последнему scrub, а не к resilver, так что формально проверенным пул после него не считается.
Нужно ли загружать ключи шифрования перед scrub?
Не требуется — проверка контрольных сумм идёт на уровне блоков. Но если ключи не загружены и найдётся неисправимая ошибка, имя файла не попадёт в отчёт zpool status -v: вы увидите только шестнадцатеричный идентификатор вида <0x1a2b>:<0x3c4d>. Поэтому проверку удобнее планировать на момент, когда датасеты смонтированы.
Как часто нужно делать scrub?
Единого норматива нет. Рабочая практика: раз в месяц для пулов на механических дисках под нагрузкой, раз в квартал для больших архивов, и не реже одного раза в четыре месяца в любом случае. На пулах в десятки терабайт еженедельный scrub бессмысленен — он просто не будет успевать завершаться.
Scrub не влезает в выходные, что делать?
Два штатных варианта. `zpool scrub -p` ставит проверку на паузу, состояние периодически сохраняется на диск и переживает перезагрузку и export пула — можно добивать по ночам несколько выходных подряд. Либо `zpool scrub -C`, который продолжает с сохранённой транзакционной группы (свойство last_scrubbed_txg) вместо старта с нуля.
Scrub нашёл ошибки контрольных сумм на диске, у которого SMART чистый. Менять диск?
Не спешите. Ненулевой CKSUM при чистом SMART чаще указывает на тракт передачи — кабель, бэкплейн, HBA или его прошивку, реже на память без ECC. Проверьте dmesg на сбросы шины, посмотрите, сидят ли пострадавшие диски на одном кабеле, обновите прошивку контроллера. И только если ошибки повторяются на изолированном устройстве — меняйте диск.
Чем полезен zpool scrub -e и что для него нужно?
Он проверяет только файлы, уже засветившиеся в zpool status -v, а не весь пул, и требует включённой фичи head_errlog. Идеален как контрольный прогон после устранения аппаратной причины: на пуле в три десятка терабайт такая проверка занимает минуты вместо полусуток. Полный scrub он не заменяет — свойство last_scrubbed_txg при error scrub не обновляется.
Где в Proxmox VE настроен автоматический scrub и как поменять расписание?
Proxmox VE использует пакет zfsutils-linux из Debian, а он кладёт /etc/cron.d/zfsutils-linux: scrub всех импортированных пулов во второе воскресенье месяца в 00:24. Чтобы сменить расписание, закомментируйте строку scrub и включите штатный таймер OpenZFS, например systemctl enable --now zfs-scrub-monthly@rpool.timer. Главное — не держать оба механизма включёнными, и мониторить не запуск, а дату последнего завершённого scrub в zpool status.
Источники
- OpenZFS 2.3 — zpool-scrub(8) — Раздел DESCRIPTION (разница scrub и resilver, автолечение при mirror/raidz/draid, запрет одновременного запуска, ключи и зашифрованные ФС) и OPTIONS (-s, -p, -w, -e, -C). https://openzfs.github.io/openzfs-docs/man/v2.3/8/zpool-scrub.8.html
- OpenZFS master — zpool-scrub(8), ревизия от 1 мая 2026 — Новые относительно 2.3 опции: -a (--all), -t (thorough scrub с расшифровкой и распаковкой блоков), -S/-E (диапазон дат), уточнённые ограничения совместимости -e. https://openzfs.github.io/openzfs-docs/man/master/8/zpool-scrub.8.html
- OpenZFS 2.3 — zpool-replace(8) — Опция -s: «The new-device is reconstructed sequentially... Checksums are not verified during sequential reconstruction so a scrub is started when the resilver completes»; ограничение по raidz, отмена идущего scrub, требования к размеру устройства. https://openzfs.github.io/openzfs-docs/man/v2.3/8/zpool-replace.8.html
- OpenZFS 2.3 — zpool-resilver(8) — Перезапуск идущего resilver с начала и поведение фичи пула resilver_defer. https://openzfs.github.io/openzfs-docs/man/v2.3/8/zpool-resilver.8.html
- OpenZFS 2.3 — zpool-status(8) — Опции -v, -x, -e, -s, -p, -j и оговорка о приблизительности процента выполнения и оценки времени для scrub/resilver. https://openzfs.github.io/openzfs-docs/man/v2.3/8/zpool-status.8.html
- OpenZFS 2.3 — zpoolprops(7), свойство last_scrubbed_txg — Транзакционная группа, до которой дошла последняя проверка; используется ключом zpool scrub -C и не обновляется при error scrub (-e). https://openzfs.github.io/openzfs-docs/man/v2.3/7/zpoolprops.7.html
- OpenZFS 2.3 — zfs(4), параметры модуля — Значения по умолчанию: zfs_scan_vdev_limit = 16777216 B, zfs_vdev_scrub_max_active = 2, zfs_scrub_min_time_ms = 1000, zfs_resilver_min_time_ms = 3000, zfs_scrub_after_expand = 1; zfs_scan_mem_lim_fact, zfs_scan_checkpoint_intval, zfs_rebuild_scrub_enabled = 1, zfs_rebuild_vdev_limit = 64 MiB, zfs_resilver_disable_defer, zio_slow_io_ms = 30 s; отладочные zfs_no_scrub_io, zfs_scan_suspend_progress, zfs_scan_ignore_errors. https://openzfs.github.io/openzfs-docs/man/v2.3/4/zfs.4.html
- Klara Systems — Understanding ZFS Scrubs and Data Integrity — Практика планирования: типовая частота — раз в месяц, интервал между проверками не должен превышать четырёх месяцев; разбор столбцов READ/WRITE/CKSUM и влияния scrub на полосу чтения. https://klarasystems.com/articles/understanding-zfs-scrubs-and-data-integrity/
- OpenZFS (ветка zfs-2.3-release) — etc/systemd/system: zfs-scrub@.service, zfs-scrub-monthly@.timer, zfs-scrub-weekly@.timer — Шаблоны юнитов: OnCalendar=monthly/weekly, Persistent=true, RandomizedDelaySec=1h; сервис вызывает zpool scrub -w или zpool wait -t scrub, при остановке — zpool scrub -p. https://github.com/openzfs/zfs/tree/zfs-2.3-release/etc/systemd/system
- OpenZFS — contrib/debian/zfsutils-linux.cron — Файл /etc/cron.d/zfsutils-linux пакета Debian/Proxmox: TRIM в первое воскресенье, scrub во второе воскресенье месяца через /usr/lib/zfs-linux/scrub. https://github.com/openzfs/zfs/blob/zfs-2.3-release/contrib/debian/zfsutils-linux.cron