
Заменили диски на 4К-секторы, а ZFS стал писать медленнее: что на самом деле делает ashift
Эта статья для тех, кто держит ZFS под файловый сервер, репозиторий резервных копий или гипервизор — и однажды поменял старые диски на новые, а получил не прирост, а просадку. Разберу, что такое ashift на пальцах, почему свойство пула ashift никогда не переделает уже созданный vdev, как за пять минут выяснить настоящую геометрию своих пулов и что делать дальше — с реальным выездом, цифрами и командами. И отдельно скажу, где паника оправдана, а где вам просто продали страшилку.
Купили диски побольше — получили сервер помедленнее
Классика жанра: пул собран лет восемь-десять назад на дисках по 2 ТБ, место кончилось, купили комплект по 8 ТБ. Меняем по одному через zpool replace, ресильвер отрабатывает, zpool status зелёный, места стало втрое больше. А ночной бэкап, который укладывался в сорок минут, теперь идёт два часа. Пользователи жалуются на «тормозит папка». И самое обидное — на старых дисках такого не было.
Дальше человек гуглит, натыкается на слово ashift, видит, что у него 9, а у новых дисков сектор 4 КиБ, и делает очевидное: zpool set ashift=12 tank. Перезагружает сервер. Ничего не меняется. Пробует ещё раз выдернуть диск и заменить его — уже «с правильным ashift». Опять ничего. На этом месте ко мне обычно и приходят.
Разберёмся, что вообще такое ashift. Это двоичный показатель размера сектора: значение 9 означает 2^9 = 512 байт, 12 — это 2^12 = 4096 байт, 13 — 8192 байта. По документации OpenZFS допустимы значения от 9 до 16 включительно, плюс 0 — значение по умолчанию: автоопределение по данным блочного уровня ядра и внутреннего списка исключений ZFS (туда занесены модели, которые заведомо врут о размере сектора). Ashift задаёт минимальную единицу размещения данных на vdev и выравнивание записи. Не размер блока файла (это recordsize) и не размер блока zvol (volblocksize), а именно «квант» физического ввода-вывода.
И вот ключевая механика, из-за которой всё ломается. Руководство OpenZFS по тюнингу формулирует это прямо: частичная запись сектора влечёт штраф — сектор сначала нужно прочитать в буфер, и только потом записать. Если пул считает, что сектор равен 512 байтам, а физически диск оперирует блоками по 4 КиБ, то каждая запись в 512 байт превращается в «прочитай 4 КиБ — измени 512 байт — запиши 4 КиБ обратно». На SSD это ещё и лишний цикл записи, на шпинделе — лишний оборот пластины, то есть 5–8 мс на ровном месте. На RAIDZ, где одна логическая запись раскладывается на все диски группы, штраф множится на число дисков.
- ashift=9 — сектор 512 байт, наследие дисков до 2010 года и SSD, которые врут о своей геометрии;
- ashift=12 — сектор 4 КиБ, рабочее значение по умолчанию для практически всего современного железа;
- ashift=13 — сектор 8 КиБ, для флеш-памяти с 8-килобайтной страницей;
- ashift=0 — автоопределение: OpenZFS берёт физический сектор, если он больше логического и не превышает zfs_vdev_max_auto_ashift (14), и не опускается ниже zfs_vdev_min_auto_ashift. Подводит оно тогда, когда накопитель или контроллер отдают 512/512.
Почему zpool set ashift=12 не чинит уже созданный пул
Открываем man zpoolprops(7) и читаем про ashift буквально: «Changing this value will not modify any existing vdev, not even on disk replacement» — изменение этого значения не модифицирует ни один существующий vdev, даже при замене диска. И следом: «When set, this property is used as the default hint value in subsequent vdev operations (add, attach and replace)» — оно используется как значение-подсказка по умолчанию для последующих операций add, attach и replace.
То есть свойство пула — это не настройка, а заготовка на будущее. Оно повлияет на новый top-level vdev, который вы добавите командой zpool add. Оно повлияет на новый диск, который вы прицепите в новое зеркало. А вот существующая группа дисков, созданная в 2016 году с ashift=9, останется с ashift=9 навсегда. Внутренний ashift верхнего vdev фиксируется в момент создания этого vdev, пишется в его метку на диске и не меняется никогда — ни скрабом, ни ресильвером, ни экспортом-импортом, ни обновлением ZFS.
Проверяется это тремя способами. Первый и самый честный — zdb, документация прямо рекомендует смотреть реальное значение именно им. Второй — свойства vdev: в vdevprops(7) есть read-only свойство ashift с описанием «The physical sector size of this vdev expressed as the power of two», то есть физический размер сектора vdev, выраженный как степень двойки. Третий — метка диска, zdb -l.
# фактический ashift каждого top-level vdev в пуле
zdb -C tank | grep -E 'ashift|children|type'

# то же самое через свойства vdev (read-only)
zpool get ashift tank raidz2-0

# что записано в метке конкретного диска
zdb -l /dev/disk/by-id/ata-TOSHIBA_MG08ADA800E_XXXXXXXX-part1 | grep ashift

# а это — всего лишь подсказка на будущее, не текущее состояние
zpool get ashift tank
Если zpool get ashift tank показывает 12, а zdb -C tank в описании vdev показывает ashift: 9 — поздравляю, вы нашли свою проблему. Свойство переставили, геометрию не тронули. И zpool replace -o ashift=12 тут тоже не поможет: да, в zpool-replace(8) опция -o property=value есть и там прямо сказано, что единственное поддерживаемое сейчас свойство — ashift, но диск встаёт в уже существующий vdev и обязан жить по его правилам. Подсказка применяется, когда создаётся новая геометрия, а не когда вы вставляете диск в старую. Зато текущие версии zpool status сами подсвечивают такую ситуацию: у каждого затронутого диска появляется пометка block size: 512B configured, 4096B native, а в шапке — «One or more devices are configured to use a non-native block size. Expect reduced performance.» с рекомендацией заменить устройства или мигрировать данные на правильно сконфигурированный пул.
- Логический и физический сектор диска ZFS получает от ядра: на Linux это `logical_block_size`/`physical_block_size` блочного устройства, на FreeBSD — sectorsize и stripesize провайдера GEOM;
- если физический сектор больше логического (типичный 512e: 512/4096), автодетект выбирает ashift по физическому, но не больше `zfs_vdev_max_auto_ashift` (по умолчанию 14);
- если диск честно или ошибочно отдаёт 512/512, получится ashift=9 — если только не поднят `zfs_vdev_min_auto_ashift` или модель не попала во внутренний список исключений;
- диск 4Kn (логический сектор 4096) в vdev с ashift=9 не встанет вообще: устройство не откроется, а `zpool replace` ответит «new device has a different optimal sector size; use the option '-o ashift=N' to override the optimal size» — и `-o ashift=9` здесь не спасёт, логический сектор меньше 4096 не сделать;
- 512e-диск в тот же vdev встанет молча — именно этот сценарий и даёт скрытую деградацию.
Разбор выезда: питомник собак на 13 рабочих мест
Условный клиент — питомник собак «Королевский двор»: тринадцать рабочих мест, администрация, ветеринарный кабинет, отдел продаж щенков. Один физический сервер на Debian с ZFS под всё сразу: общая SMB-шара с фото и видео выводков, сканами родословных и ветеринарных паспортов, файловая база 1С:Бухгалтерии и репозиторий резервных копий рабочих станций. Пул tank собирал ещё прошлый подрядчик в 2016 году: четыре диска по 2 ТБ в raidz2 за RAID-контроллером в режиме JBOD, никто ничего явно не указывал — zpool create tank raidz2 ... и всё. Контроллер отдавал системе диски как 512/512, хотя физически они были 512e с сектором 4 КиБ. Автодетект честно поверил и выбрал ashift=9.
Почти десять лет пул отработал без претензий. Весной 2026-го место кончилось (свободно 7 %), контроллер заменили на обычный HBA, закупили четыре диска по 8 ТБ и поменяли их по одному через zpool replace, с интервалом в сутки на ресильвер. Место выросло примерно с 3,5 до 14 ТиБ. А через неделю пришла заявка «ночной бэкап не успевает, а 1С по утрам тормозит». Смотрю: копирование станций раньше укладывалось в 40 минут, теперь 1 час 50 минут. Замер fio случайной записью блоком 16 КиБ с fsync показал 38 IOPS на четырёх шпинделях — примерно втрое ниже того, что такие диски дают на правильной геометрии.
zpool iostat -vl 5 показал красивую картину: очередь записи почти пустая, IOPS смешные, а средняя задержка записи (колонка write в блоке total_wait) — 12–13 мс при том, что диски свежие и smartctl чист. iostat -x 5 со стороны Linux дал %util под 100 при смешной полезной нагрузке: диски были заняты постоянно, но делали не то, что нужно. А zpool status всё это время показывал у каждого нового диска block size: 512B configured, 4096B native — просто туда никто не смотрел. Классическая картина read-modify-write: каждая запись тянет за собой чтение.
# то, ради чего всё затевалось
$ zdb -C tank | grep -w ashift
            ashift: 9

$ lsblk -o NAME,MODEL,LOG-SEC,PHY-SEC,ROTA /dev/sd{a..d}
NAME MODEL            LOG-SEC PHY-SEC ROTA
sda  TOSHIBA MG08ADA8     512    4096    1
...

$ zpool get ashift tank
NAME  PROPERTY  VALUE   SOURCE
tank  ashift    12      local     # кто-то уже пытался «починить»
Дальше была попытка выкрутиться малой кровью: добавить новый зеркальный vdev с ashift=12, перегнать данные и убрать старый через zpool remove. Не вышло, и не могло выйти. В zpool-remove(8) условия сформулированы жёстко: верхнеуровневые vdev можно удалить, только если в основном хранилище пула нет top-level raidz или draid vdev, все top-level vdev имеют одинаковый ashift и ключи всех зашифрованных датасетов загружены. У нас нарушены сразу два условия из трёх: raidz2 и разный ashift. Обратите внимание на второе — оно означает, что смешанный по ashift пул навсегда лишается механизма эвакуации vdev. Одна давняя ошибка автодетекта закрывает вам инструмент, который мог бы её же и исправить.
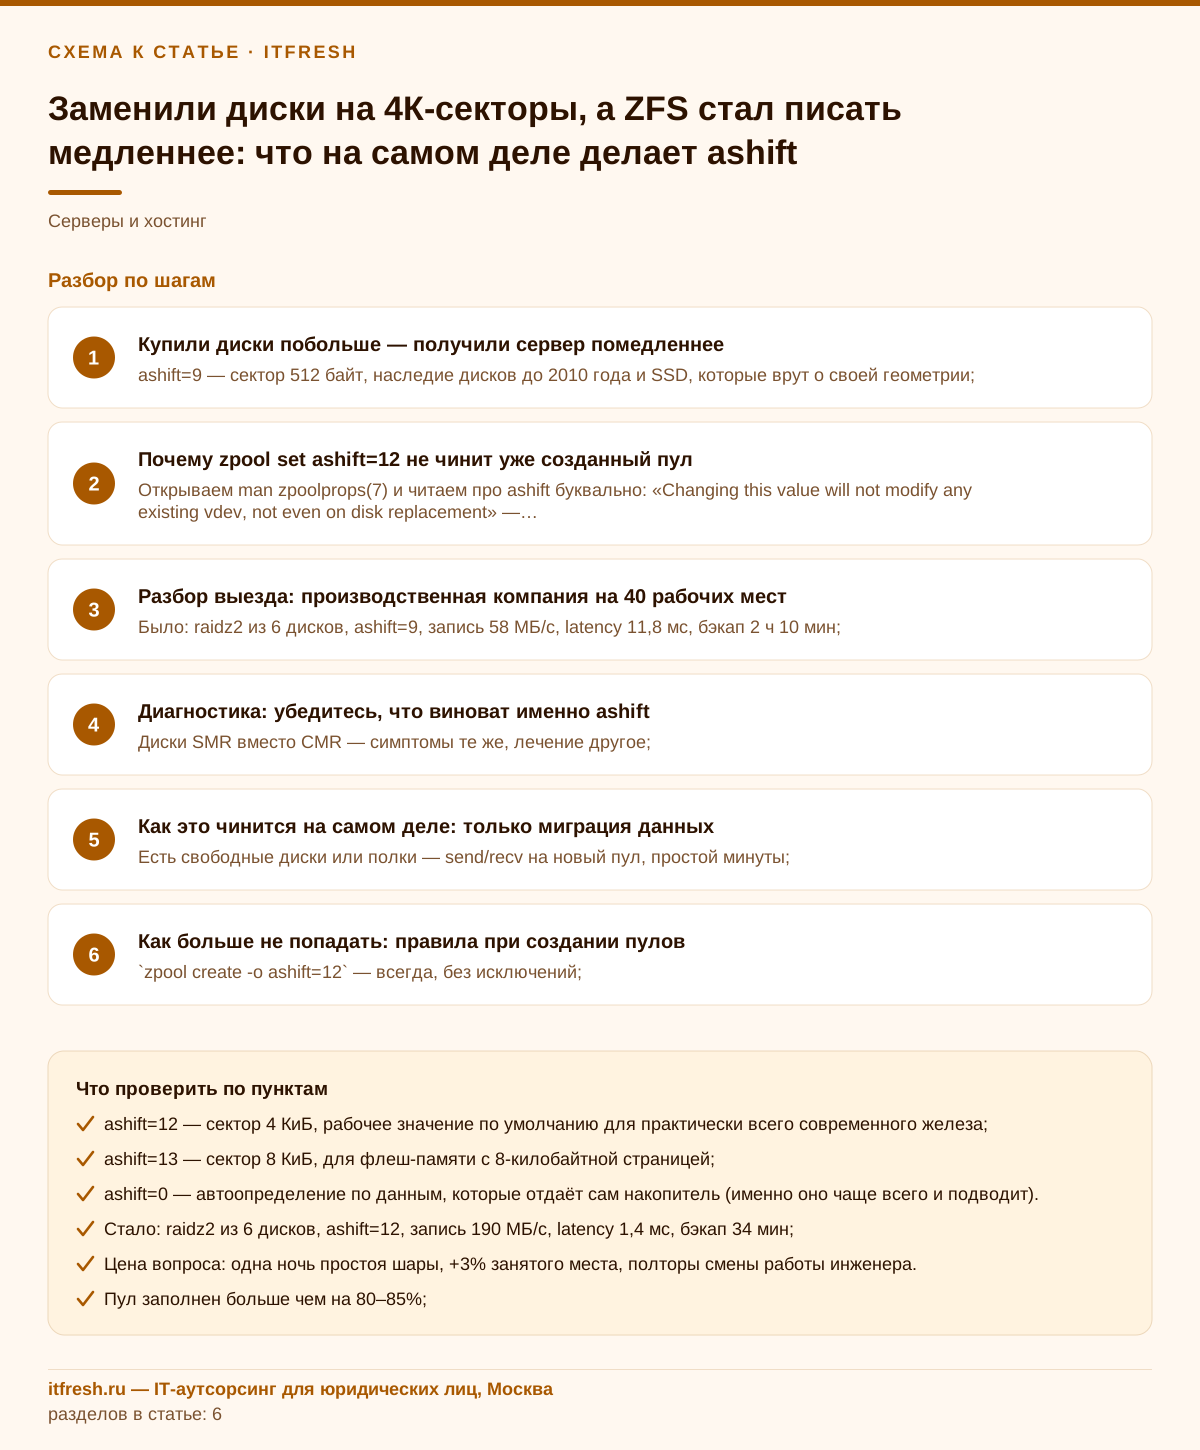
В итоге сделали единственно рабочее. На время миграции подключили два б/у диска по 8 ТБ и собрали на них временный зеркальный пул tmp с явным -o ashift=12; живых данных было около 2,4 ТиБ, так что влезло с запасом. Перелили через zfs send -R, ночью остановили шару и 1С, догнали инкрементом, уничтожили старый пул, собрали новый raidz2 из тех же четырёх дисков по 8 ТБ уже с -o ashift=12 и перелили обратно. Итог по цифрам: случайная запись 38 → 135 IOPS, средняя задержка записи 12,4 → 1,6 мс, ночной бэкап 1 ч 50 мин → 35 минут. Занятое место выросло примерно на 3 % — плата за более крупный квант выделения, и она того стоила.
- Было: raidz2 из 4 дисков, ashift=9, 38 IOPS на случайной записи, latency 12,4 мс, бэкап 1 ч 50 мин;
- Стало: raidz2 из 4 дисков, ashift=12, 135 IOPS, latency 1,6 мс, бэкап 35 мин;
- Цена вопроса: одна ночь простоя шары и 1С, два временных диска, +3 % занятого места, полторы смены работы инженера.
Диагностика: убедитесь, что виноват именно ashift
Прежде чем планировать миграцию на выходные, потратьте полчаса и исключите более простые причины. Я видел как минимум три случая, когда «это ashift» оказывалось совсем не ashift, а миграция всё равно проводилась — с нулевым эффектом и с потраченными выходными.
Начните с геометрии. lsblk -o NAME,MODEL,LOG-SEC,PHY-SEC,ROTA покажет, что диск сообщает системе. Сравните с zdb -C — если логический и физический сектор у дисков 4096, а ashift vdev равен 9, диагноз почти наверняка верный. Если же диски честные 512/512 (старые серверные SAS, некоторые enterprise SSD), то ashift=9 сам по себе беды не создаёт, ищите в другом месте.
Дальше — короткий чек-лист альтернативных подозреваемых. Самый частый — SMR-диски: черепичная запись даёт ровно те же симптомы, «сначала быстро, потом колом», и лечится только заменой дисков на CMR. Второй — заполненность пула: после 80–85 % растёт фрагментация свободного места, аллокатору всё дольше искать подходящие участки, а при почти заполненных метаслабах он переходит на медленный режим best-fit — и запись проседает независимо ни от какого ashift. Третий — синхронная запись без отдельного SLOG: NFS-датастор гипервизора или база данных заставляют ZFS честно ждать ZIL. Четвёртый — включённая дедупликация на пуле без запаса ОЗУ. Пятый — банально идущий скраб или ресильвер.
zpool list -o name,size,alloc,free,cap,frag,health   # cap выше 80% — вот вам и причина
zpool status -t                                       # идёт ли scrub/resilver, когда был trim
zpool status tank | grep -i "block size"              # 512B configured, 4096B native = ваш случай
zpool iostat -vl 5                                    # latency по каждому диску отдельно
iostat -x 5                                           # %util и await со стороны ядра
zfs get -r sync,recordsize,compression,dedup tank | grep -v default
cat /sys/block/sdX/queue/rotational                    # SMR отдельно проверяйте по модели
Отдельно про диагностику «в одну строчку»: если один диск в zpool iostat -vl показывает задержку в разы выше соседей — это не геометрия, это умирающий диск, и его надо менять до всяких миграций. ashift деградирует все диски vdev примерно одинаково, потому что штраф структурный, а не аппаратный.
- Диски SMR вместо CMR — симптомы те же, лечение другое;
- Пул заполнен больше чем на 80–85 %;
- Синхронная запись (NFS, БД, 1С) без SLOG-устройства;
- Дедупликация без соответствующего объёма ОЗУ;
- Фоновый scrub или незавершённый resilver;
- Один деградирующий диск, тянущий за собой весь vdev.
Как это чинится на самом деле: только миграция данных
Хорошая новость — рецепт один и он предсказуемый. Плохая — обойтись без переливки данных нельзя. Никакой команды «переформатировать vdev под другой ashift» в ZFS нет и, судя по архитектуре, не будет: ashift зашит в разметку пространства vdev, менять его на живых данных — это переписать весь пул, что эквивалентно миграции.
Мой рабочий сценарий такой. Собираем новый пул с явно указанным ashift, перегоняем данные через zfs send | zfs recv под нагрузкой, потом коротким окном догоняем инкрементом и переключаемся. Простой сокращается до времени последнего инкремента — обычно это минуты, а не часы.
# 1. Новый пул — ashift указываем ЯВНО, не надеясь на автодетект
zpool create -o ashift=12 -O compression=lz4 -O atime=off \
  -O xattr=sa -O acltype=posixacl tank2 raidz2 \
  /dev/disk/by-id/ata-DISK1 ... /dev/disk/by-id/ata-DISK6

# 2. Полный слепок под нагрузкой (шары продолжают работать)
zfs snapshot -r tank@mig1
zfs send -R -L -e -c tank@mig1 | zfs recv -F -u tank2

# 3. Окно простоя: гасим службы, догоняем инкрементом
systemctl stop smbd nfs-server
zfs snapshot -r tank@mig2
zfs send -R -L -e -c -I tank@mig1 tank@mig2 | zfs recv -F -u tank2

# 4. Переключение: старый пул убираем, новый импортируем под старым именем
zpool export tank
zpool export tank2 && zpool import tank2 tank
zfs mount -a && systemctl start smbd nfs-server
zdb -C tank | grep -w ashift        # убедиться, что теперь 12
Пояснения по флагам, потому что на них спотыкаются. -R отправляет весь набор датасетов с их свойствами и снапшотами. -L разрешает большие блоки — без него датасеты с recordsize=1M приедут порезанными на 128 КиБ, и вы потеряете часть выигрыша. -e включает embedded-блоки, -c — передачу уже сжатых данных без распаковки, это заметно ускоряет перегон. Для зашифрованных датасетов нужен -w (raw), иначе принимающая сторона потребует ключи. -u на приёме означает «не монтируй сразу» — обязательно, иначе новый пул попытается смонтироваться поверх работающего старого. И важная деталь: если полный поток шёл с -L -e -c, инкремент отправляйте с теми же флагами, иначе приём может отказать или блоки снова порежутся. Импорт tank2 под именем tank сохраняет пути для служб и скриптов бэкапа — не придётся переписывать конфиги Samba и заданий резервного копирования.
Чего делать не нужно и на что не стоит надеяться. zpool remove для эвакуации старого vdev не сработает: как я показал выше, он требует одинакового ashift у всех top-level vdev и отсутствия raidz/draid в основном хранилище. Расширение RAIDZ (feature raidz_expansion, оно про «attach a new device to a RAID-Z group, expanding the total amount usable space in the pool») добавляет диск в существующую группу — и новый диск наследует ashift этой группы, то есть проблему не решает, а консервирует. zpool attach в зеркало ведёт себя так же. И, повторюсь, zpool set ashift не делает ничего с существующей геометрией.
- Есть свободные диски или полки — send/recv на новый пул, простой минуты;
- Свободного железа нет, но пул зеркальный — можно временно разобрать зеркало, собрать новый пул на половине дисков и перелить (рискованно: период без избыточности);
- Ничего нет — полный бэкап, уничтожение пула, создание с `-o ashift=12`, восстановление. Проверьте бэкап дважды, это единственный сценарий без пути назад.
Как больше не попадать: правила при создании пулов
Правило первое и главное: всегда указывайте ashift явно. zpool create -o ashift=12 — это две секунды при создании и ноль сюрпризов через восемь лет. Автодетект полагается на то, что накопитель честно сообщает физический размер сектора, а огромный пласт железа — 512e-диски, потребительские SSD, диски за RAID-контроллером в режиме passthrough, iSCSI/виртуальные тома — сообщает 512 просто потому, что так безопаснее для совместимости со старыми ОС.
Правило второе: подстрахуйтесь на уровне модуля. У ZFS есть параметр zfs_vdev_min_auto_ashift со значением по умолчанию 9 (ASHIFT_MIN) — это минимальный ashift, используемый при создании новых top-level vdev. Поднимите его до 12, и даже коллега, забывший ключ -o, не создаст пул с 512-байтной геометрией. Парный параметр zfs_vdev_max_auto_ashift по умолчанию равен 14 и может быть увеличен до ASHIFT_MAX (16), но документация честно предупреждает, что это негативно скажется на эффективности использования пространства. На FreeBSD и TrueNAS CORE тот же параметр — это sysctl: в системах на OpenZFS (FreeBSD 13 и новее) он называется vfs.zfs.vdev.min_auto_ashift, в старых FreeBSD со встроенным ZFS — vfs.zfs.min_auto_ashift. Handbook FreeBSD прямо пишет, что значение 12 даёт тот же результат, что -o ashift=12, и для создания пула, и для последующих zpool add и zpool attach. Графическим мастерам пулов я не доверяю на слово: после создания всегда zdb -C.
# /etc/modprobe.d/zfs.conf
options zfs zfs_vdev_min_auto_ashift=12
# применить без перезагрузки (действует на СОЗДАВАЕМЫЕ vdev)
echo 12 > /sys/module/zfs/parameters/zfs_vdev_min_auto_ashift
update-initramfs -u # если корень на ZFS# FreeBSD / TrueNAS CORE (OpenZFS)
sysctl vfs.zfs.vdev.min_auto_ashift=12
echo 'vfs.zfs.vdev.min_auto_ashift=12' >> /etc/sysctl.confПравило третье: 12 или 13 — вопрос спорный, и я скажу честно. Документация OpenZFS для флеш-памяти допускает и 12 (4К), и 13 (8К), потому что современные SSD внутри работают страницами по 8 КиБ и больше. Но на практике на NVMe разница между ashift=12 и 13 у меня ни разу не вылезала за пределы погрешности измерения, а вот потери места на RAIDZ при ashift=13 вполне заметны. Я ставлю 12 везде по умолчанию и отступаю от этого, только если производитель прямо документирует страницу 8 КиБ и нагрузка того требует. Тот, кто говорит, что «правильный ответ один» — либо не мерил, либо мерил на одном стенде. Отдельный случай — NVMe с пространством имён, отформатированным в 4Kn: логический сектор 4096, поэтому автодетект даст минимум 12, а 9 невозможен в принципе. Формат LBA смотрится командой nvme id-ns /dev/nvme0n1 -H | grep "LBA Format" (активный помечен «in use»), а переключение через nvme format --lbaf=N уничтожает данные — делать только до создания пула. Для 13 на NVMe нужны основания вроде документированной страницы 8 КиБ и собственного замера.
Правило четвёртое, про которое забывают: на RAIDZ ashift работает в связке с размером блока. При ashift=12 минимальный аллокейт — 4 КиБ на диск, и если вы отдаёте zvol с volblocksize=8K под виртуалку на raidz2, то на выравнивание и чётность уходит непристойная доля ёмкости — на практике я видел двукратные потери. Для zvol на RAIDZ берите volblocksize от 32–64 КиБ, для файловых датасетов оставляйте recordsize=128K по умолчанию или поднимайте до 1M под бэкапы и медиа. Отдельные vdev — special, log, dedup — это тоже полноценные top-level vdev со своим ashift, и их геометрию тоже надо задавать осознанно: смешанный ashift в пуле, напомню, навсегда закрывает возможность zpool remove.
- `zpool create -o ashift=12` — всегда, без исключений;
- `zfs_vdev_min_auto_ashift=12` в modprobe.d — страховка от человеческого фактора;
- ashift пула записать в паспорт стенда рядом с моделью дисков и датой сборки;
- перед закупкой дисков на замену — сверить PHY-SEC новых дисков с ashift существующего vdev;
- volblocksize для zvol на RAIDZ — не меньше 32K.
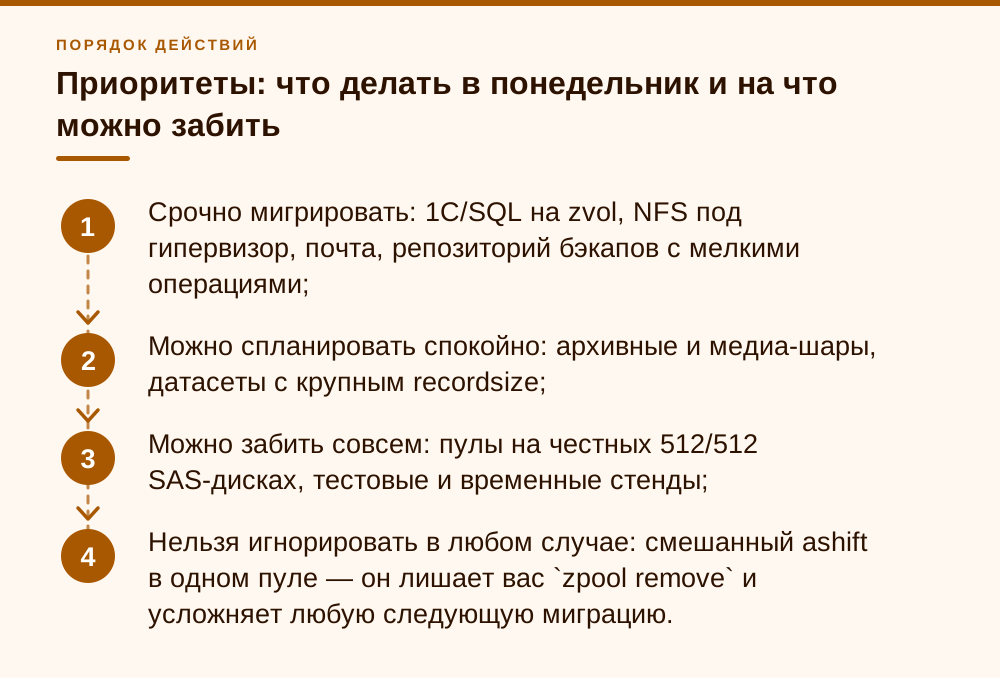
Приоритеты: что делать в понедельник и на что можно забить
Начну с успокоительного, потому что тему любят раздувать. Если у вас пул ashift=9 на 512e-дисках, а нагрузка — последовательное чтение-запись крупными блоками (архив, медиа, файловая свалка с recordsize=1M), то реальная деградация будет в районе 10–20 %, а не в разы. Такое можно спокойно дожить до планового обновления железа и мигрировать заодно. Ронять прод на выходных ради пятнадцати процентов на архивной шаре — плохая сделка.
А вот где деградация действительно кратная: синхронная запись мелкими блоками. Базы 1С и SQL на zvol, NFS-датастор гипервизора, репозиторий резервных копий с большим числом мелких транзакций, почтовый сервер с maildir. Там read-modify-write бьёт по каждой операции, и разница между ashift=9 и 12 на шпинделях вырастает в три-четыре раза — ровно как в разборе выше. Если ваш случай отсюда — планируйте миграцию, ждать нечего.
Порядок действий, который я рекомендую всем клиентам с ZFS. Первое — инвентаризация: прогоните zdb -C по всем пулам и запишите фактический ashift каждого vdev в паспорт стенда. Это полчаса на весь парк. Второе — зафиксируйте zfs_vdev_min_auto_ashift=12 на всех хостах, чтобы новые пулы гарантированно рождались правильными. Третье — для найденных пулов с ashift=9 определите класс нагрузки и поставьте миграцию в план, привязав её к ближайшему расширению или замене дисков: делать два простоя вместо одного бессмысленно. Четвёртое — никогда не меняйте свойство ashift на живом пуле в надежде, что что-то улучшится: не улучшится, а вы потеряете диагностический признак, потому что zpool get ashift начнёт показывать одно, а zdb -C — другое, и следующий инженер запутается.
И последнее, про закупки. Перед тем как заказывать диски на замену, посмотрите zdb -C и lsblk -o NAME,LOG-SEC,PHY-SEC вместе. Если у существующего vdev ashift=9, а новые диски — 4Kn (логический сектор 4096, а не 512e), ZFS их в этот vdev просто не примет: устройство с ashift больше, чем у верхнего vdev, не открывается, а zpool replace выдаёт «new device has a different optimal sector size». Опция -o ashift=9 не поможет — логический сектор диска меньше не станет. Лучше узнать об этом до оплаты счёта, а не в ночь замены: берите 512e-модели на дожитие старого пула или сразу планируйте новый.
- Срочно мигрировать: 1С/SQL на zvol, NFS под гипервизор, почта, репозиторий бэкапов с мелкими операциями;
- Можно спланировать спокойно: архивные и медиа-шары, датасеты с крупным recordsize;
- Можно забить совсем: пулы на честных 512/512 SAS-дисках, тестовые и временные стенды;
- Нельзя игнорировать в любом случае: смешанный ashift в одном пуле — он лишает вас `zpool remove` и усложняет любую следующую миграцию.
Частые вопросы
Можно ли изменить ashift существующего пула без переливки данных?
Нет. Внутренний ashift верхнего vdev фиксируется при его создании и не меняется никогда — ни при замене диска, ни при ресильвере, ни при обновлении версии ZFS. Документация zpoolprops(7) говорит об этом прямо: изменение свойства не модифицирует существующие vdev, даже при замене диска. Единственный рабочий путь — создать новый пул с нужным ashift и перегнать данные через zfs send/recv или восстановить из бэкапа.
Зачем тогда вообще нужно свойство ashift у пула?
Оно работает как значение-подсказка по умолчанию для последующих операций add, attach и replace. То есть влияет на новую геометрию, которую вы создаёте: новый top-level vdev через zpool add или новое зеркало. На уже существующий vdev оно не влияет никак.
Как посмотреть настоящий ashift моих пулов?
Командой `zdb -C имя_пула | grep -w ashift` — она показывает фактическое значение по каждому top-level vdev. Дополнительно можно посмотреть read-only свойство vdev: `zpool get ashift пул vdev-name`, и метку конкретного диска через `zdb -l /dev/disk/by-id/...`. Команда `zpool get ashift пул` показывает только подсказку для будущих операций, а не текущее состояние.
Что ставить — ashift=12 или ashift=13?
Единого мнения нет. Документация OpenZFS для флеш-памяти допускает оба значения, поскольку страница современной NAND — 8 КиБ и больше. На практике на NVMe разница обычно теряется в погрешности, а вот потери ёмкости на RAIDZ при ashift=13 заметны. Я по умолчанию ставлю 12 и отступаю от этого только при документированной 8-килобайтной странице и подходящем профиле нагрузки.
Насколько сильно на самом деле падает производительность при ashift=9 на 4К-дисках?
Зависит от нагрузки. На последовательных операциях крупными блоками — обычно 10–20 %, это терпимо и можно дожить до планового обновления. На синхронной записи мелкими блоками (базы 1С и SQL, NFS-датастор гипервизора, почта) деградация на шпинделях доходит до трёх-четырёх раз, потому что каждая запись превращается в чтение-модификацию-запись.
Поможет ли расширение RAIDZ или zpool remove, чтобы обойтись без миграции?
Нет. Расширение RAID-Z добавляет диск в существующую группу, и новый диск наследует ashift этой группы. А zpool remove требует, чтобы в пуле не было top-level raidz/draid и чтобы у всех top-level vdev был одинаковый ashift — то есть именно пул со смешанной геометрией эвакуировать vdev и не сможет.
Как защититься от повторения ошибки на новых серверах?
Два действия. Первое — всегда создавать пул с явным ключом: `zpool create -o ashift=12 ...`. Второе — поднять параметр модуля `zfs_vdev_min_auto_ashift` до 12 через /etc/modprobe.d/zfs.conf, чтобы даже пул, созданный без ключа, не получил 512-байтную геометрию. По умолчанию этот параметр равен 9.
Как задать ashift=12 по умолчанию на FreeBSD или TrueNAS CORE?
Через sysctl `vfs.zfs.vdev.min_auto_ashift=12` (в старых FreeBSD до перехода на OpenZFS — `vfs.zfs.min_auto_ashift`). По FreeBSD Handbook это действует на создание пула и на последующие `zpool add` и `zpool attach`. Уже существующие vdev параметр не трогает — проверяйте результат через `zdb -C`.
Можно ли вставить 4Kn-диск в старый пул с ashift=9?
Нет. У 4Kn логический сектор 4096 байт, а ZFS не открывает устройство, чей ashift больше ashift верхнего vdev: `zpool replace` завершится ошибкой «new device has a different optimal sector size». Для дожития такого пула нужны 512e-диски, а правильное решение — новый пул с ashift=12.
Источники
- OpenZFS zpoolprops(7), свойство ashift — Man-страница свойств пула, раздел ashift: допустимые значения 9–16 и 0 (по умолчанию — автоопределение через блочный уровень ядра и внутренний список исключений ZFS), формулировка «Changing this value will not modify any existing vdev, not even on disk replacement» и указание, что значение служит подсказкой для последующих add/attach/replace. https://openzfs.github.io/openzfs-docs/man/master/7/zpoolprops.7.html
- OpenZFS Performance and Tuning — Workload Tuning, раздел Alignment Shift (ashift) — Объяснение штрафа за частичную запись сектора («Partial sector writes incur a penalty where the sector must be read into a buffer before it can be written»), проблема накопителей, некорректно сообщающих размер сектора, рекомендации ashift 12/13 для флеш-памяти. https://openzfs.github.io/openzfs-docs/Performance%20and%20Tuning/Workload%20Tuning.html
- OpenZFS vdevprops(7) — Список свойств vdev; ashift описан как read-only статистика: «The physical sector size of this vdev expressed as the power of two». https://openzfs.github.io/openzfs-docs/man/master/7/vdevprops.7.html
- OpenZFS zpool-remove(8) — Условия удаления верхнеуровневого vdev: отсутствие top-level raidz/draid в основном хранилище, одинаковый ashift у всех top-level vdev, загруженные ключи шифрования. https://openzfs.github.io/openzfs-docs/man/master/8/zpool-remove.8.html
- OpenZFS zfs(4) — параметры модуля — zfs_vdev_min_auto_ashift (по умолчанию ASHIFT_MIN = 9) и zfs_vdev_max_auto_ashift (по умолчанию 14, максимум ASHIFT_MAX = 16 с оговоркой о потере эффективности использования пространства). https://openzfs.github.io/openzfs-docs/man/master/4/zfs.4.html
- OpenZFS zpool-replace(8) и zpool-features(7) — zpool-replace: опция -o property=value, «The only property supported at the moment is ashift». zpool-features: описание raidz_expansion («enables the zpool attach subcommand to attach a new device to a RAID-Z group») и device_removal. https://openzfs.github.io/openzfs-docs/man/master/8/zpool-replace.8.html
- FreeBSD Handbook, глава 22 «The Z File System (ZFS)» — Раздел о размере сектора: ashift — свойство vdev, фиксируется при создании и не меняется; `-o ashift=12` и sysctl `vfs.zfs.vdev.min_auto_ashift=12` для create/add/attach. https://docs.freebsd.org/en/books/handbook/zfs/
- Исходный код OpenZFS: cmd/zpool/zpool_main.c, module/zfs/vdev.c, lib/libzfs/libzfs_pool.c — Сообщения «block size: %dB configured, %dB native» и ZPOOL_STATUS_NON_NATIVE_ASHIFT, функция vdev_ashift_optimize() (выбор ashift по физическому сектору в пределах min/max_auto_ashift), ошибка EDOM «new device has a different optimal sector size». https://github.com/openzfs/zfs/blob/master/module/zfs/vdev.c