
Zabbix 7.4: ошибка «Only partial data received» — почему Timeout в zabbix_server.conf не помогает
Вы подняли Timeout в zabbix_server.conf с 3 до 30, перезапустили сервер, а в журнале по-прежнему сыплется «Only partial data received», и половина графиков по коммутаторам стоит пустая. Это не баг и не глюк агента: в Zabbix 7.4 асинхронные SNMP-элементы walk[] и get[] вообще не смотрят в конфиг сервера. Ниже — где на самом деле живёт их тайм-аут, почему один недобранный OID убивает сразу десяток зависимых метрик, при чём здесь max repetition count и почему галка «Use combined requests» тут вообще ни при чём. С разбором стенда фитнес-центра на 43 рабочих места и порядком действий.
Что на самом деле означает «Only partial data received»
Сначала уберём главное недоразумение. Эта ошибка не говорит «устройство недоступно» и не говорит «SNMP не отвечает». Она говорит ровно следующее: Zabbix отправил запрос на несколько OID, получил ответ по части из них, а по остальным — тайм-аут или отказ. И в этот момент элемент данных объявляется неподдерживаемым целиком. Документация формулирует это прямо: если данные получены частично (например, успешно собраны только по одному OID из нескольких), элемент становится unsupported с сообщением «Only partial data received». Никакого «сохраним что успели» нет. Ноль или всё.
Дальше начинается самое неприятное. Современная схема сбора SNMP в Zabbix 7.4 — это мастер-элемент walk[] на пол-таблицы и десятки зависимых элементов поверх него, которые вытаскивают конкретные значения предобработкой «SNMP walk value» или собирают JSON шагом «SNMP walk to JSON». Пока мастер живой — живы все потомки. Как только мастер ушёл в unsupported, зависимые элементы просто перестают получать значения. На дашборде это выглядит так, будто разом пропали трафик, ошибки, статусы портов и температура — на десятке хостов одновременно. Админ идёт искать сетевую аварию, а аварии нет.
Второй симптом — рост журнала. Zabbix пишет в лог строки вида «SNMP response from host 'gateway' does not contain all of the requested variable bindings», и это тот же самый сюжет с другой стороны: агент устройства вернул не все запрошенные variable bindings. Журнал пухнет, потому что каждая неудачная попытка — это ещё и повторы, о которых ниже. Так что «ошибка одна, а последствий три»: дырки в истории, лавина в логе и ложная тревога у дежурного.
- unsupported получает мастер-элемент walk[], а не отдельная метрика
- все зависимые элементы молча замолкают — своей ошибки у них нет
- в истории появляется дырка, а не нули: триггеры на nodata сработают позже, чем хотелось
- в zabbix_server.log параллельно идут строки про «does not contain all of the requested variable bindings»
Почему Timeout из zabbix_server.conf не действует на walk[] и get[]
А теперь причина, из-за которой люди правят конфиг по кругу и не понимают, почему ничего не меняется. В Zabbix 7.4 параметр Timeout в zabbix_server.conf описан так: он задаёт, сколько ждать при установлении соединения и обмене данными с прокси, агентом, веб-сервисом и для SNMP-проверок — за исключением элементов SNMP walk[OID] и get[OID]. Вот это «за исключением» и есть весь ответ. Старый синхронный формат элемента, где в ключе просто голый OID вроде 1.3.6.1.2.1.31.1.1.1.6.3, действительно берёт тайм-аут из конфига сервера. Асинхронные walk[] и get[] — не берут.
Их тайм-аут живёт в интерфейсе. Администрирование → Общие → Тайм-ауты, строка «SNMP agent», и рядом в скобках уточнение: только для элементов walk[OID] и get[OID]. Диапазон допустимых значений — от 1 до 600 секунд, значение по умолчанию 3 секунды. Если сервер работает через прокси, у прокси есть свой набор тайм-аутов, который перекрывает глобальный. И наконец, у самого элемента данных есть поле Timeout: пока стоит переключатель «глобальный», поле серое и показывает унаследованное значение, переключили на «переопределить» — задаёте своё, тот же диапазон 1–600 с, поддерживаются суффиксы вроде 30s и пользовательские макросы.
Отсюда практический вывод, который экономит вечер: правьте тайм-аут там, где его читает конкретный тип элемента. Для медленной железки, которая честно долго ходит по большой таблице, разумно поднять именно item-level Timeout на её мастер-элементе, а не глобальный и тем более не серверный. Глобальные 3 секунды пусть остаются для всех остальных: они дисциплинируют. Один тормозной коммутатор не должен заставлять весь мониторинг ждать по 30 секунд каждую железку.
Если у вас не 7.4, а 7.0 LTS, картина та же: асинхронные walk[] и get[], max repetition count на SNMP-интерфейсе и тайм-ауты на уровне элемента появились именно в 7.0. Разница в деталях: до пяти повторов для walk и get документация 7.0 указывает начиная с 7.0.14, а в более ранних сборках 7.0 повторов меньше. Поэтому перед тем как сравнивать своё поведение с этой статьёй, посмотрите точную минорную версию сервера и прокси — они должны совпадать.
# zabbix_server.conf — это НЕ про walk[] и get[]
# Timeout действует на прокси, агента, веб-сервис
# и на легаси-SNMP (голый OID в ключе)
Timeout=3

# Асинхронные SNMP-пуллеры: смотрите сюда, если очередь растёт
StartSNMPPollers=1
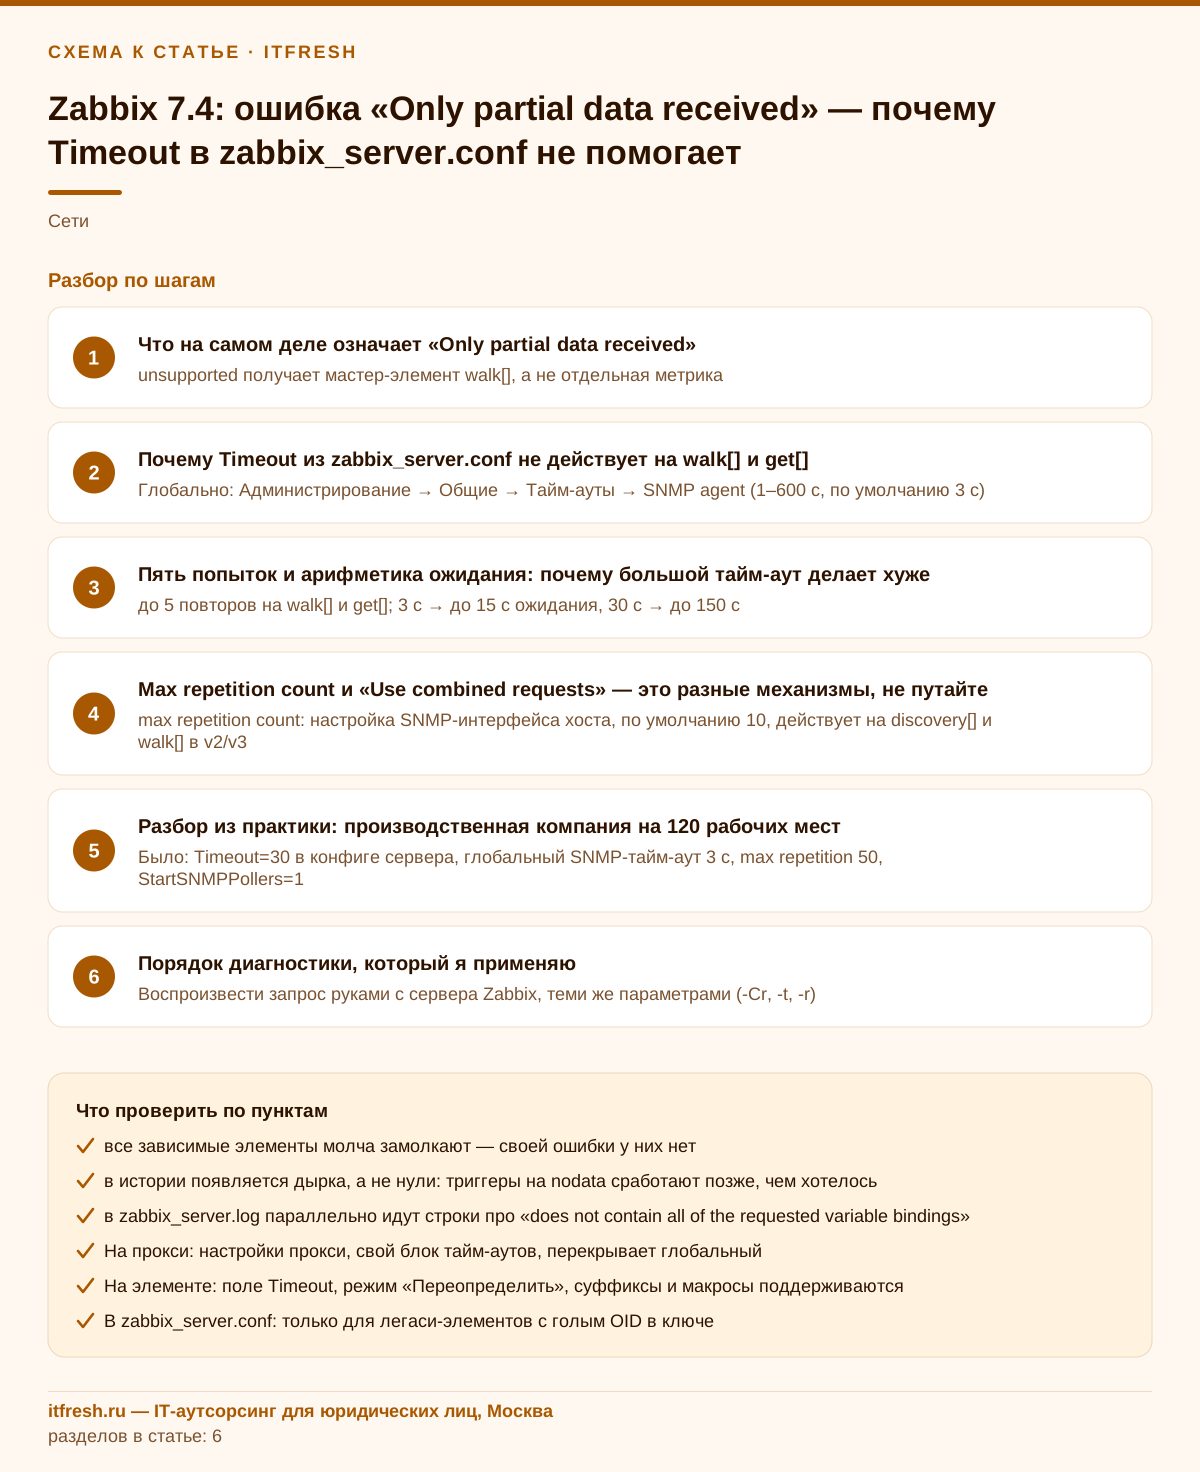
MaxConcurrentChecksPerPoller=1000- Глобально: Администрирование → Общие → Тайм-ауты → SNMP agent (1–600 с, по умолчанию 3 с)
- На прокси: настройки прокси, свой блок тайм-аутов, перекрывает глобальный
- На элементе: поле Timeout, режим «Переопределить», суффиксы и макросы поддерживаются
- В zabbix_server.conf: только для легаси-элементов с голым OID в ключе
Пять попыток и арифметика ожидания: почему большой тайм-аут делает хуже
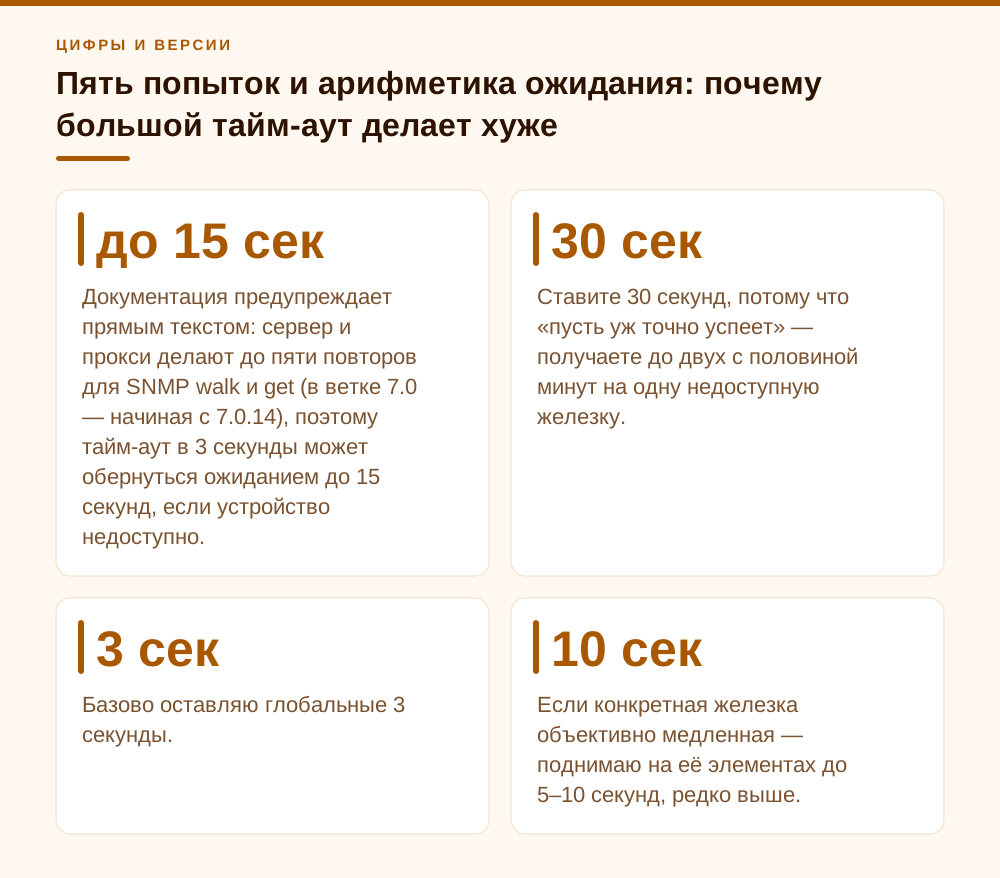
Прежде чем крутить значение вверх, посчитайте. Документация предупреждает прямым текстом: сервер и прокси делают до пяти повторов для SNMP walk и get (в ветке 7.0 — начиная с 7.0.14), поэтому тайм-аут в 3 секунды может обернуться ожиданием до 15 секунд, если устройство недоступно. Не «одна проверка — один тайм-аут», а пять. Ставите 30 секунд, потому что «пусть уж точно успеет» — получаете до двух с половиной минут на одну недоступную железку. Для сравнения: у легаси-проверок повтор как минимум один после неудачной попытки, там арифметика мягче.
Дальше это упирается в пуллеры. Асинхронные SNMP-проверки обслуживает StartSNMPPollers, а каждый такой пуллер тянет до MaxConcurrentChecksPerPoller одновременных проверок, максимум 1000. Звучит как «места навалом», и обычно так и есть, потому что асинхронный опрос не ждёт ответа на один запрос, чтобы начать другой, и DNS-резолвинг там тоже асинхронный. Но конкурентность не бесконечна, а зависшие проверки занимают слот всё время своего ожидания. Триста портов на стеке, умноженные на пять повторов по тридцать секунд, — и очередь у вас начинает расти на ровном месте.
Мой рабочий подход: тайм-аут держать маленьким и лечить причину, а не симптом. Базово оставляю глобальные 3 секунды. Если конкретная железка объективно медленная — поднимаю на её элементах до 5–10 секунд, редко выше. Всё, что требует больше десяти секунд на walk по одной таблице, — это не «настройка тайм-аута», это перегруженный CPU у самого устройства, потери на канале или слишком жирный запрос. Тайм-аутом такое лечится ровно до следующего раза.
Отдельно про очередь. Если после правок ошибки ушли, а «Администрирование → Очередь» показывает копящиеся SNMP-проверки, смотрите на пуллеры. По умолчанию StartSNMPPollers равен единице (диапазон 0–1000), а MaxConcurrentChecksPerPoller — 1000. Для пары десятков SNMP-хостов одного асинхронного пуллера обычно хватает, и очередь там растёт из-за зависших повторов, а не из-за нехватки процессов. На парке из сотни-другой хостов с короткими интервалами ставлю 2–4 и смотрю на внутренний элемент zabbix[process,snmp poller,avg,busy]: если он стабильно выше 75 %, добавляю ещё.
- до 5 повторов на walk[] и get[] (7.4; в 7.0 — с 7.0.14); 3 с → до 15 с ожидания, 30 с → до 150 с
- легаси-OID: минимум один повтор после неудачи
- StartSNMPPollers по умолчанию 1 (0–1000) — для малого парка хватает, для сотен хостов мало
- MaxConcurrentChecksPerPoller: по умолчанию и максимум 1000 одновременных проверок на пуллер
Max repetition count и «Use combined requests» — это разные механизмы, не путайте
Вторая по частоте ошибка в диагностике — дёргать галку «Use combined requests» в надежде починить walk. Не починит. В документации прямо сказано, что этот флажок разрешает объединённую обработку SNMP-запросов и не относится к нативным SNMP bulk-запросам walk и get. Это наследие старой синхронной схемы, когда Zabbix склеивал несколько отдельных OID-элементов в один запрос. К асинхронным walk[] и get[] он отношения не имеет вообще: снимете галку — на них ничего не изменится, кроме того, что легаси-элементы на том же хосте станут опрашиваться поштучно и медленнее.
А вот что действительно влияет на walk — это max repetition count в настройках SNMP-интерфейса хоста. Значение по умолчанию 10, и оно управляет нативными bulk-запросами (GetBulkRequest-PDU) для элементов discovery[] и walk[] в SNMPv2 и v3. Смысл простой: сколько строк таблицы устройство отдаёт в одном ответе. Больше значение — крупнее ответ и меньше пакетов, и документация тут же добавляет ключевое предупреждение: слишком высокое значение может привести к тайм-ауту SNMP-проверки. Именно на этом обычно и горят.
Механика такая. Вы поставили max repetition 50 или 100, чтобы «ускорить опрос». Устройство собирает здоровенный ответ, он не влезает в MTU пути, фрагментируется, часть фрагментов теряется на пути через туннель или на нагруженном аплинке — и Zabbix получает неполный набор variable bindings. Дальше по сценарию: Only partial data received. То же самое даёт слабый CPU у дешёвого коммутатора: он физически не успевает собрать ответ на 100 повторений за отведённые секунды и отдаёт что успел.
Поэтому при этой ошибке я всегда двигаю max repetition вниз, а не вверх. Дефолтные 10 — хорошая отправная точка; на проблемном железе спускаюсь до 5, иногда до 3. Опрос становится чуть болтливее по числу пакетов, но перестаёт разваливаться. И помните: bulk работает только на SNMPv2 и v3, на SNMPv1 используется GetNext, там max repetition просто не применяется.
- max repetition count: настройка SNMP-интерфейса хоста, по умолчанию 10, действует на discovery[] и walk[] в v2/v3
- Use combined requests: легаси-механизм, к нативным bulk walk/get не относится
- SNMPv1: bulk отсутствует, используется GetNext
- При Only partial data received max repetition уменьшают, а не увеличивают
Разбор из практики: фитнес-центр «ФитЛайн» на 43 рабочих места
Стенд, на котором я это разбирал последний раз: фитнес-центр «ФитЛайн», два клуба, 43 рабочих места (ресепшен, отдел продаж, бухгалтерия, тренерские), Zabbix 7.4 на Debian 12 с PostgreSQL, около 30 SNMP-хостов — коммутаторы доступа в обоих клубах, два маршрутизатора, ИБП в серверной и у ресепшена, контроллеры точек доступа Wi-Fi для гостевой сети и несколько сетевых МФУ. Zabbix стоит в первом клубе, второй клуб опрашивается через site-to-site IPsec. Шаблоны стандартные, «by SNMP», интерфейсы собираются мастер-элементом walk[] по ifXTable с зависимыми элементами и LLD портов. Жалоба классическая: «графики трафика по коммутаторам второго клуба рваные, в логе мусор, тайм-аут поднимали — не помогло».
Что нашлось. Первое: в zabbix_server.conf кто-то выставил Timeout=30 — и это ничего не давало, потому что все проблемные элементы были walk[]. Глобальный тайм-аут SNMP agent при этом оставался дефолтными 3 секундами. Второе: на SNMP-интерфейсах коммутаторов стоял max repetition count = 50, поставленный «для скорости» при внедрении. Третье: MTU туннеля между клубами — 1400, а ответы на bulk из 50 повторений по ifXTable заметно превышали этот размер и фрагментировались, часть фрагментов терялась на домашнем по сути канале второго клуба. Четвёртое: из-за пяти повторов с тайм-аутами в «Очереди» постоянно висели 40–70 просроченных SNMP-проверок, хотя сам пуллер был загружен слабо.
Порядок действий был такой. Сначала снизил max repetition count до 10 на всех коммутаторах второго клуба — ошибки на них упали примерно вчетверо за первые полчаса. Потом поднял глобальный SNMP-тайм-аут с 3 до 5 секунд, а на одном старом 48-портовом коммутаторе, у которого CPU при walk уходил под 80 %, переопределил тайм-аут на мастер-элементе до 10 секунд. StartSNMPPollers поднял до 2 — скорее с запасом на рост парка, чем по необходимости. Timeout=30 в zabbix_server.conf вернул на 3: для walk[]/get[] он бесполезен, а остальным типам проверок только мешал.
Итог за сутки наблюдения: строки Only partial data received в zabbix_server.log — с полутора сотен в час до единичных, и те по одному МФУ на ресепшене, который уходит в сон. Дырки в истории интерфейсов закрылись, очередь по SNMP опустела. Отдельно оговорюсь: 10 секунд тайм-аута на старом коммутаторе — компромисс, а не решение. Правильнее уменьшить сам объём опроса: убрать из шаблона ненужные OID и сузить фильтр LLD, чтобы не тащить сорок восемь портов, из которых реально заняты пятнадцать. Это стоит в плане вместе с заменой самой железки.
- Было: Timeout=30 в конфиге сервера, глобальный SNMP-тайм-аут 3 с, max repetition 50, в очереди 40–70 просроченных SNMP-проверок
- Стало: конфиг сервера 3 с, глобальный SNMP 5 с, точечные 10 с на одном хосте, max repetition 10, StartSNMPPollers=2
- Эффект: ошибки с ~150 в час до единиц, очередь SNMP — в ноль
- Остаточный риск: перегруженный CPU старого коммутатора — лечится сокращением объёма опроса и заменой, а не тайм-аутом
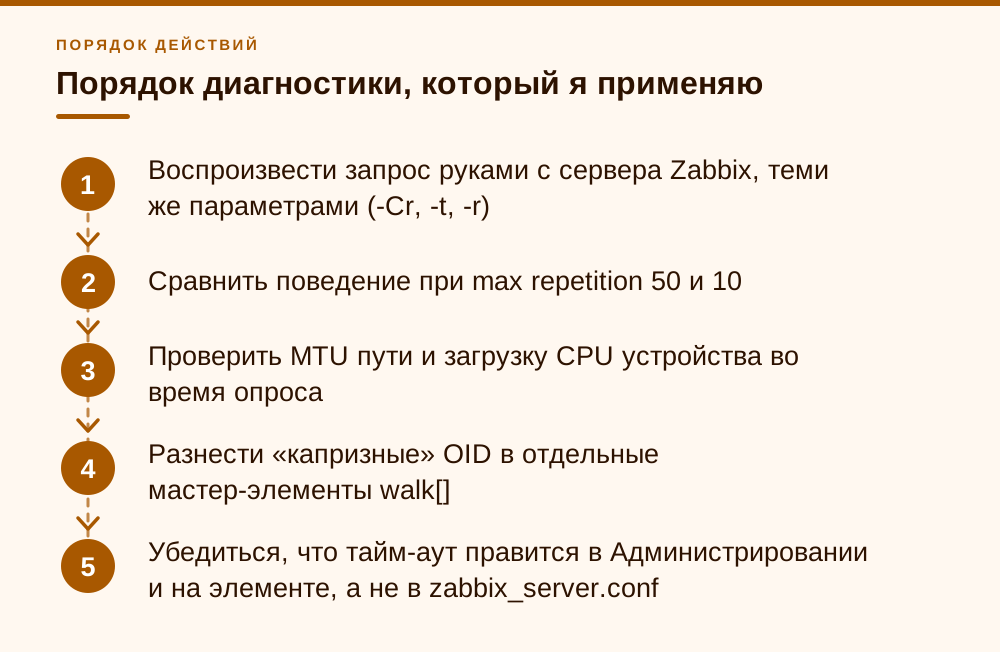
Порядок диагностики, который я применяю
Диагностику всегда начинаю не в веб-интерфейсе, а с той же машины, где стоит zabbix-server или прокси, — потому что важно воспроизвести именно тот путь, по которому ходит опрос. Ставлю snmp-утилиты и повторяю запрос руками, с теми же параметрами, что стоят в Zabbix: та же версия протокола, то же значение max repetition, тот же тайм-аут и число повторов. Учтите, что у утилит net-snmp свои умолчания: -t 1 секунда и -r 5 повторов (man snmpcmd), а -Cr по умолчанию 10 (man snmpbulkwalk). Если их не задать явно, ручная проверка будет вести себя иначе, чем Zabbix.
# Тот же bulk, что делает Zabbix: -Cr = max repetition, -t = таймаут, -r = повторы
snmpbulkwalk -v2c -c public -Cr10 -t 3 -r 0 10.10.10.5 ifXTable

# То же с задранным max repetition — так воспроизводится «частичный ответ»
snmpbulkwalk -v2c -c public -Cr50 -t 3 -r 0 10.10.10.5 ifXTable

# Проверка MTU пути до железки (без фрагментации, 1472 = 1500 - 28)
ping -M do -s 1472 -c 3 10.10.10.5

# Что реально сыплется в журнал
grep -c 'partial data received' /var/log/zabbix/zabbix_server.log
grep 'does not contain all of the requested' /var/log/zabbix/zabbix_server.log | tail -20
Если snmpbulkwalk с -Cr50 обрывается, а с -Cr10 проходит целиком — диагноз готов, дальше идём в настройки SNMP-интерфейса хоста. Если обрывается в обоих случаях — смотрим на само устройство: загрузка CPU в момент опроса, версия прошивки, не режет ли ACL часть таблицы. Если руками всё летает, а Zabbix ошибается — почти всегда виноват тайм-аут, применённый не туда, или голодание пуллеров. И не пытайтесь проверить max repetition на get[]: этот элемент забирает одно значение и bulk-запросы не использует, параметр действует только на walk[] и discovery[].
И последнее по порядку, но не по важности: посмотрите на состав walk[]. Ключ walk[] принимает несколько OID сразу, и это удобно, пока всё работает. Но правило «ноль или всё» означает, что один проблемный OID в списке гасит весь мастер-элемент. Если в одном walk[] у вас лежат ifXTable и какая-нибудь вендорская таблица температур, которую железка отдаёт через раз, — разнесите их на два мастер-элемента. Метрики интерфейсов перестанут падать из-за датчика.
- Воспроизвести запрос руками с сервера Zabbix, теми же параметрами (-Cr, -t, -r)
- Сравнить поведение при max repetition 50 и 10
- Проверить MTU пути и загрузку CPU устройства во время опроса
- Разнести «капризные» OID в отдельные мастер-элементы walk[]
- Убедиться, что тайм-аут правится в Администрировании и на элементе, а не в zabbix_server.conf
Что делать в первую очередь, а на что можно забить
Если совсем коротко, порядок приоритетов у меня такой. Первое — max repetition count: снизить до 10, это дёшево, безопасно и закрывает большинство случаев. Второе — тайм-аут в правильном месте: глобально 3–5 секунд, точечные переопределения только для конкретных медленных хостов. Третье — пуллеры: StartSNMPPollers по числу хостов, следить за очередью и внутренней утилизацией. Четвёртое — состав walk[] и фильтры LLD, чтобы не тащить лишнее. И только пятым пунктом — разговор с сетевиками про MTU и про здоровье самих железок.
На что можно забить. На галку «Use combined requests» — если у вас всё собрано на walk[] и get[], она не влияет ни на что, оставьте как есть. На попытки победить единичные ошибки по спящим МФУ и по ИБП, которые честно отвечают через раз: проще исключить их из чувствительных триггеров и жить дальше, чем героически чинить прошивку принтера. На идею «перейти обратно на легаси-OID, там работало» — работало оно медленнее и с теми же проблемами, просто ошибка выглядела иначе, а элементы падали поодиночке и потому были менее заметны.
Где я честно признаю неоднозначность. Единого «правильного» значения max repetition не существует: для мощного ядра сети 25 может быть отлично и сильно экономить пакеты, для дешёвого доступа даже 10 бывает много. Это подбирается на месте, руками, по конкретной модели. Точно так же нет универсального числа пуллеров — оно зависит от количества хостов, интервалов опроса и от того, есть ли прокси. Любой, кто называет вам «правильные цифры» не глядя на стенд, просто угадывает.
И стратегическая заметка на 2026 год. Zabbix 7.4 вышел 1 июля 2025 года, это стандартный релиз, у него ограниченный срок поддержки — до конца 2026 года, а следующий LTS, 8.0, по политике жизненного цикла запланирован на третий квартал 2026-го — проверьте на странице Zabbix, вышел ли он к моменту вашего чтения. Если вы сейчас разворачиваете мониторинг с нуля и не гонитесь за свежими фичами, разумнее либо остаться на 7.0 LTS (полная поддержка до 30 июня 2027 года), либо сразу планировать переход на 8.0 LTS. Асинхронная схема SNMP с walk[]/get[] и логика тайм-аутов, описанные выше, — это не временное явление 7.4, а текущая архитектура, так что разбираться в ней всё равно придётся.
- Сначала max repetition → потом тайм-аут в правильном месте → потом пуллеры → потом состав walk[]
- «Use combined requests» при современной схеме сбора не трогать
- Единичные ошибки по спящим устройствам — исключить из триггеров, а не чинить
- Планировать версию: 7.4 — стандартный релиз с ограниченной поддержкой до Q4 2026, целевые — 7.0 LTS или 8.0 LTS
Частые вопросы
Я поднял Timeout в zabbix_server.conf и перезапустил сервер — почему ошибка осталась?
Потому что этот параметр не действует на асинхронные элементы. В документации Zabbix 7.4 Timeout описан как тайм-аут для прокси, агента, веб-сервиса и SNMP-проверок, «кроме элементов SNMP walk[OID] и get[OID]». Для walk[] и get[] тайм-аут берётся из Администрирование → Общие → Тайм-ауты (строка SNMP agent), из настроек прокси или из поля Timeout самого элемента. Конфиг сервера в этой цепочке не участвует.
Почему при частичном ответе Zabbix не сохраняет хотя бы то, что получил?
Так устроена логика асинхронных SNMP-элементов: если данные получены частично — например, успешно собраны только по одному OID из нескольких, — элемент целиком становится неподдерживаемым с сообщением «Only partial data received». Частичный результат не считается валидным значением мастер-элемента, поэтому и зависимые элементы поверх него значений не получают.
Поможет ли отключение «Use combined requests»?
Для walk[] и get[] — нет. Документация прямо указывает, что эта галка разрешает объединённую обработку SNMP-запросов и не относится к нативным bulk-запросам walk и get. Это легаси-механизм для старых синхронных элементов с голым OID в ключе. Если ваш сбор построен на walk[]/get[], снятие галки на ошибку не повлияет.
Какое значение max repetition count ставить?
По умолчанию 10 — с него и начинайте. Параметр управляет нативными bulk-запросами (GetBulkRequest-PDU) только для элементов discovery[] и walk[] (get[] bulk не использует) в SNMPv2 и v3; документация предупреждает, что слишком высокое значение может привести к тайм-ауту SNMP-проверки. При ошибке «Only partial data received» значение снижают, а не повышают: на слабом железе и при малом MTU пути помогает 5, иногда 3. Универсального числа нет, подбирается по конкретной модели устройства.
Сколько на самом деле ждёт Zabbix при недоступной железке?
До пяти повторов на элемент walk[] и get[] (в 7.0 — начиная с 7.0.14). Документация приводит расчёт: при тайм-ауте 3 секунды ожидание может дойти до 15 секунд. Соответственно, тайм-аут 30 секунд превращается в две с половиной минуты на одну проверку, и всё это время занят слот пуллера. Поэтому большие тайм-ауты — плохая идея: они не убирают ошибку, а добавляют рост очереди.
Как понять, что виновата фрагментация, а не Zabbix?
Повторите запрос с самого сервера Zabbix: snmpbulkwalk -v2c -c public -Cr50 -t 3 -r 0 <ip> ifXTable и то же самое с -Cr10. Если с большим max repetition ответ обрывается, а с маленьким приходит целиком — почти наверняка крупные bulk-ответы не проходят по пути. Дополнительно проверьте MTU: ping -M do -s 1472 <ip>. Особенно актуально, если между сервером и устройством есть GRE, IPsec или WireGuard. Опции -t и -r задавайте явно: в net-snmp по умолчанию тайм-аут 1 секунда и 5 повторов.
Стоит ли вообще оставаться на Zabbix 7.4 в 2026 году?
7.4 — стандартный релиз от 1 июля 2025 года с ограниченным сроком поддержки до конца 2026 года. Если стабильность важнее свежих функций, целевые версии — 7.0 LTS (полная поддержка до 30 июня 2027-го) или 8.0 LTS, выход которого запланирован на третий квартал 2026-го. Описанная выше архитектура асинхронного SNMP-опроса при этом никуда не денется, так что разбираться в тайм-аутах walk[]/get[] придётся в любом случае.
Источники
- Zabbix 7.4 — SNMP agent — Официальная документация, раздел «SNMP agent»: синтаксис walk[]/get[], до 5 повторов, сообщение «Only partial data received», max repetition (по умолчанию 10) для discovery[] и walk[] в SNMPv2/v3, описание «Use combined requests» как механизма, не связанного с нативными bulk-запросами. https://www.zabbix.com/documentation/7.4/en/manual/config/items/itemtypes/snmp
- Zabbix 7.4 — параметры zabbix_server — Appendix «Zabbix server configuration file»: Timeout — «for SNMP checks (except SNMP walk[OID] and get[OID] items)», а также StartSNMPPollers и MaxConcurrentChecksPerPoller. https://www.zabbix.com/documentation/7.4/en/manual/appendix/config/zabbix_server
- Zabbix 7.4 — Администрирование → Общие → Тайм-ауты — Список типов элементов с настраиваемыми глобальными тайм-аутами: «SNMP agent (walk[OID] and get[OID] items only)», диапазон 1–600 с, значение по умолчанию 3 с (60 с для Browser). https://www.zabbix.com/documentation/7.4/en/manual/web_interface/frontend_sections/administration/general
- Zabbix 7.4 — конфигурация элемента данных — Раздел «Item»: поле Timeout, режимы «глобальный/переопределить», допустимый диапазон 1–600 с, поддержка суффиксов времени и пользовательских макросов. https://www.zabbix.com/documentation/7.4/en/manual/config/items/item
- Zabbix 7.4 — предобработка значений — Шаги предобработки «SNMP walk value», «SNMP walk to JSON», «SNMP get value» и их параметры форматирования (Unchanged, UTF-8 from hex-STRING, MAC from hex-STRING, Integer from BITS). https://www.zabbix.com/documentation/7.4/en/manual/config/items/preprocessing
- The Zabbix Book — SNMP Polling — Профильный разбор асинхронного SNMP-опроса: walk[]/get[] против легаси-OID, мастер-зависимые элементы, GetBulkRequest-PDU и рекомендация держать низкий тайм-аут из-за пяти повторов. https://www.thezabbixbook.com/ch04-zabbix-collecting-data/snmp-polling/
- Zabbix Life Cycle & Release Policy — Сроки поддержки: 7.4 выпущен 01.07.2025 (стандартный релиз, ограниченная поддержка до Q4 2026), 7.0 LTS — полная поддержка до 30.06.2027, 8.0 LTS запланирован на Q3 2026. https://www.zabbix.com/life_cycle_and_release_policy
- Zabbix 7.0 — SNMP agent — Документация LTS-ветки: walk[]/get[] на нативных GetBulkRequest-PDU, max repetition (по умолчанию 10), до 5 повторов для walk и get начиная с 7.0.14. https://www.zabbix.com/documentation/7.0/en/manual/config/items/itemtypes/snmp
- Net-SNMP — snmpbulkwalk(1) — Man-страница: опции -Cr<NUM> (max-repetitions в GETBULK PDU, по умолчанию 10) и -Cn<NUM> (non-repeaters, по умолчанию 0). http://www.net-snmp.org/docs/man/snmpbulkwalk.html
- Net-SNMP — snmpcmd(1) — Общие опции утилит: -t TIMEOUT (по умолчанию 1 с между повторами), -r RETRIES (по умолчанию 5). http://www.net-snmp.org/docs/man/snmpcmd.html