
Сайт отвечает 200, а войти в CRM нельзя: сценарий входа через Browser item в Zabbix 7.4
HTTP-проверка показывает, что отвечает веб-сервер, но не то, что сотрудник может войти. Реальный вход проверяет Browser item в Zabbix 7.4: настоящий Chrome через Selenium вводит логин, ждёт меню пользователя и возвращает JSON со скриншотом. Разбираю стенд, скрипт, таймауты, триггеры и цифры за квартал.
Почему HTTP-проверка врёт про «всё хорошо»
Классический сценарий: понедельник, 9:20, звонит администратор — «CRM не пускает, клиенты стоят у стойки». Открываю Zabbix: хост зелёный, HTTP-агент на https://crm.example.ru отдаёт 200, время ответа 180 мс, сертификат живой, триггеров нет. По приборам всё идеально, по факту люди не работают. Именно такие истории чаще всего приводят к нам клиентов, которым нужен мониторинг на Zabbix, измеряющий то, что важно бизнесу, а не то, что легко померить.
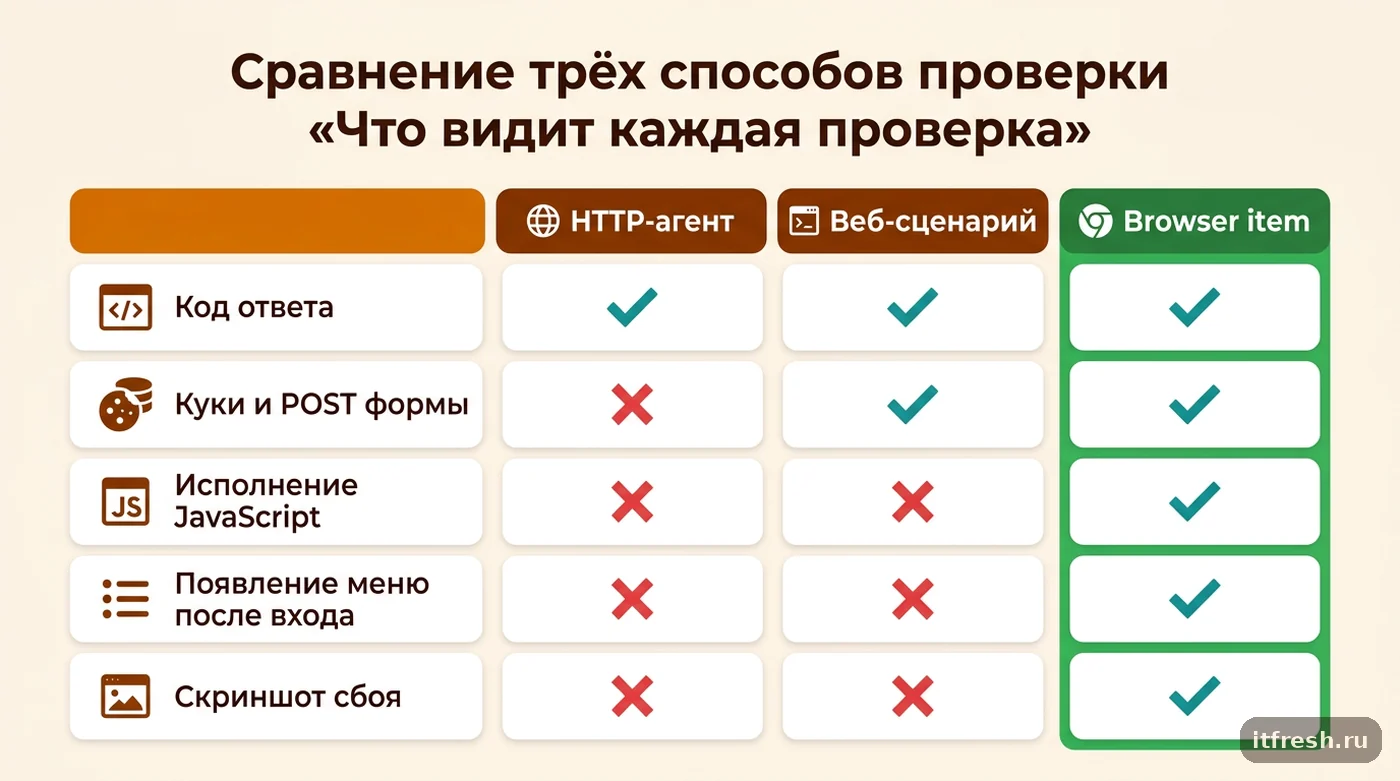
Причина простая. HTTP-агент забирает HTML и смотрит код ответа. Для одностраничного приложения этот HTML — пустая коробка: div с id=root и подключение бандла. Форма входа рисуется JavaScript'ом уже в браузере, токен приходит отдельным запросом, сессионная кука ставится после POST на /api/auth. Всё, что ломается в этой цепочке, для HTTP-агента невидимо. Веб-сценарии Zabbix умеют больше — держат куки, отправляют форму POST'ом, ищут строку в ответе, — но JavaScript не исполняют. Если приложение современное, веб-сценарий проверяет ту же пустую коробку, только в три шага.
Что я реально ловил при зелёном HTTP-мониторинге: протух секрет клиента OIDC у провайдера аутентификации — форма рисуется, кнопка «Войти» кидает на страницу ошибки; закончилось место под сессиями — POST /api/auth возвращает 500, а главная по-прежнему 200; после обновления фронта отвалился один JS-чанк, и форма просто не появилась; истёк пароль сервисной учётки, через которую CRM ходит в LDAP, — вход отбивается «неверный логин» у всех. Ни один из этих случаев HTTP-проверка не покажет, потому что она про транспорт, а не про сценарий. Похожая тихая авария — истёкший сертификат, про неё я писал в статье о мониторинге SSL-сертификатов сайта и почты.
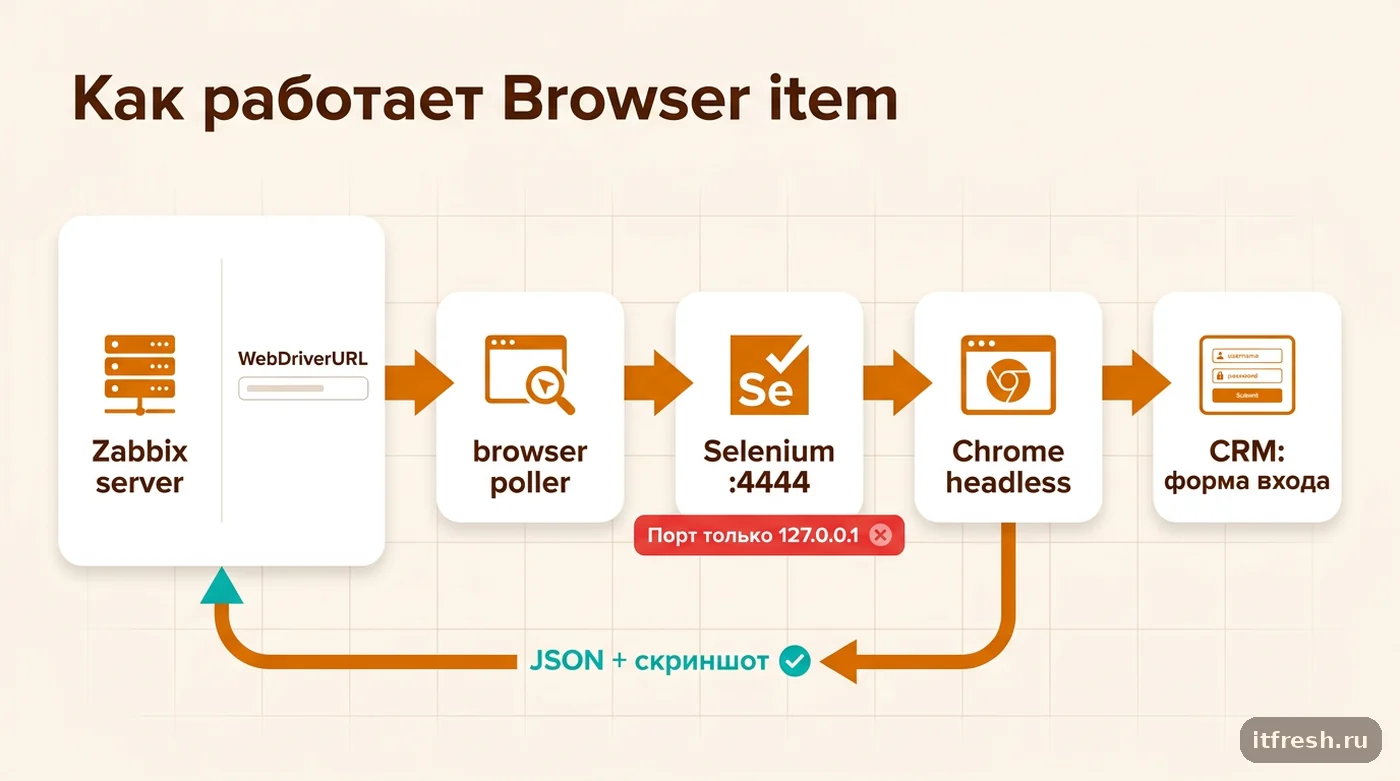
Browser item в Zabbix — это как раз про сценарий. Zabbix поднимает настоящий браузер через WebDriver, выполняет ваш JavaScript (открыть страницу, ввести логин, нажать кнопку, дождаться появления меню пользователя) и возвращает JSON с результатом, таймингами и скриншотом. Дальше это обычный элемент данных: зависимые элементы, триггеры, дашборд.
- HTTP-агент проверяет: жив ли сокет, какой код ответа, есть ли строка в HTML.
- Веб-сценарий проверяет: цепочку запросов с куками и редиректами, но без JavaScript.
- Browser item проверяет: реальный клик, реальный ввод, реальное появление элемента после логина.
Стенд: Selenium в контейнере и две строки в zabbix_server.conf
Browser item сам браузер не содержит. Ему нужна точка входа W3C WebDriver — Selenium Server или отдельный драйвер вроде ChromeDriver. Я беру Selenium Standalone Chrome в контейнере, как в официальном руководстве Zabbix: он самодостаточен, обновляется одной командой и приносит noVNC для отладки, что экономит часы. Ставлю его на тот же хост, где Zabbix-сервер, если проверок мало, и на отдельную виртуалку, если сценариев больше пяти. Тег latest в проде я бы закрепил на конкретной версии образа, чтобы обновление Chrome не случилось само посреди ночи.
Ключевой параметр — --shm-size=2g, его прямо указывает руководство Zabbix. По умолчанию Docker даёт контейнеру 64 МБ разделяемой памяти, и Chrome падает на мало-мальски тяжёлой странице с невнятной ошибкой сессии. Это первая причина, по которой у людей «Browser item работает через раз». Вторая беда — публикация порта 4444 наружу: WebDriver позволяет открыть любой URL и прочитать ответ, то есть это готовый прокси внутрь вашей сети. В руководстве для простоты порты проброшены на все интерфейсы, я же всегда привязываю их к 127.0.0.1 или внутреннему интерфейсу и закрываю фаерволом.
Со стороны Zabbix нужны две строки в /etc/zabbix/zabbix_server.conf. StartBrowserPollers по умолчанию равен 1 (допустимо 0–1000), поэтому один поллер уже есть — достаточно указать WebDriverURL. Если сценариев несколько и они долгие, поллеры увеличивают вместе с ёмкостью Selenium: один поллер — одна параллельная сессия браузера.
Со стороны Zabbix нужно ровно две строки в /etc/zabbix/zabbix_server.conf. StartBrowserPollers по умолчанию равен 1, то есть процессы уже есть, — вам достаточно указать адрес эндпоинта. Если сценариев несколько и они долгие, поллеры надо увеличивать вместе с ёмкостью Selenium: один поллер = одна параллельная сессия браузера.
### /etc/zabbix/zabbix_server.conf
# HTTP[S] URL интерфейса WebDriver
WebDriverURL=http://127.0.0.1:4444
# число преформированных browser-поллеров (по умолчанию 1)
StartBrowserPollers=3
systemctl restart zabbix-server
grep -E 'browser|webdriver' /var/log/zabbix/zabbix_server.log | tail -20- Один сеанс Chrome у меня на стендах занимает порядка 300–700 МБ RAM и заметно грузит CPU на 5–15 секунд.
- StartBrowserPollers держите не больше, чем Selenium способен обслужить параллельно, иначе получите очередь и таймауты.
- Порты 4444 и 7900 — только внутрь: наружу их публиковать нельзя ни при каких обстоятельствах.
- На проксях Zabbix параметр WebDriverURL тоже есть — сценарий можно исполнять из филиала, ближе к пользователю.
Скрипт входа целиком, с разбором
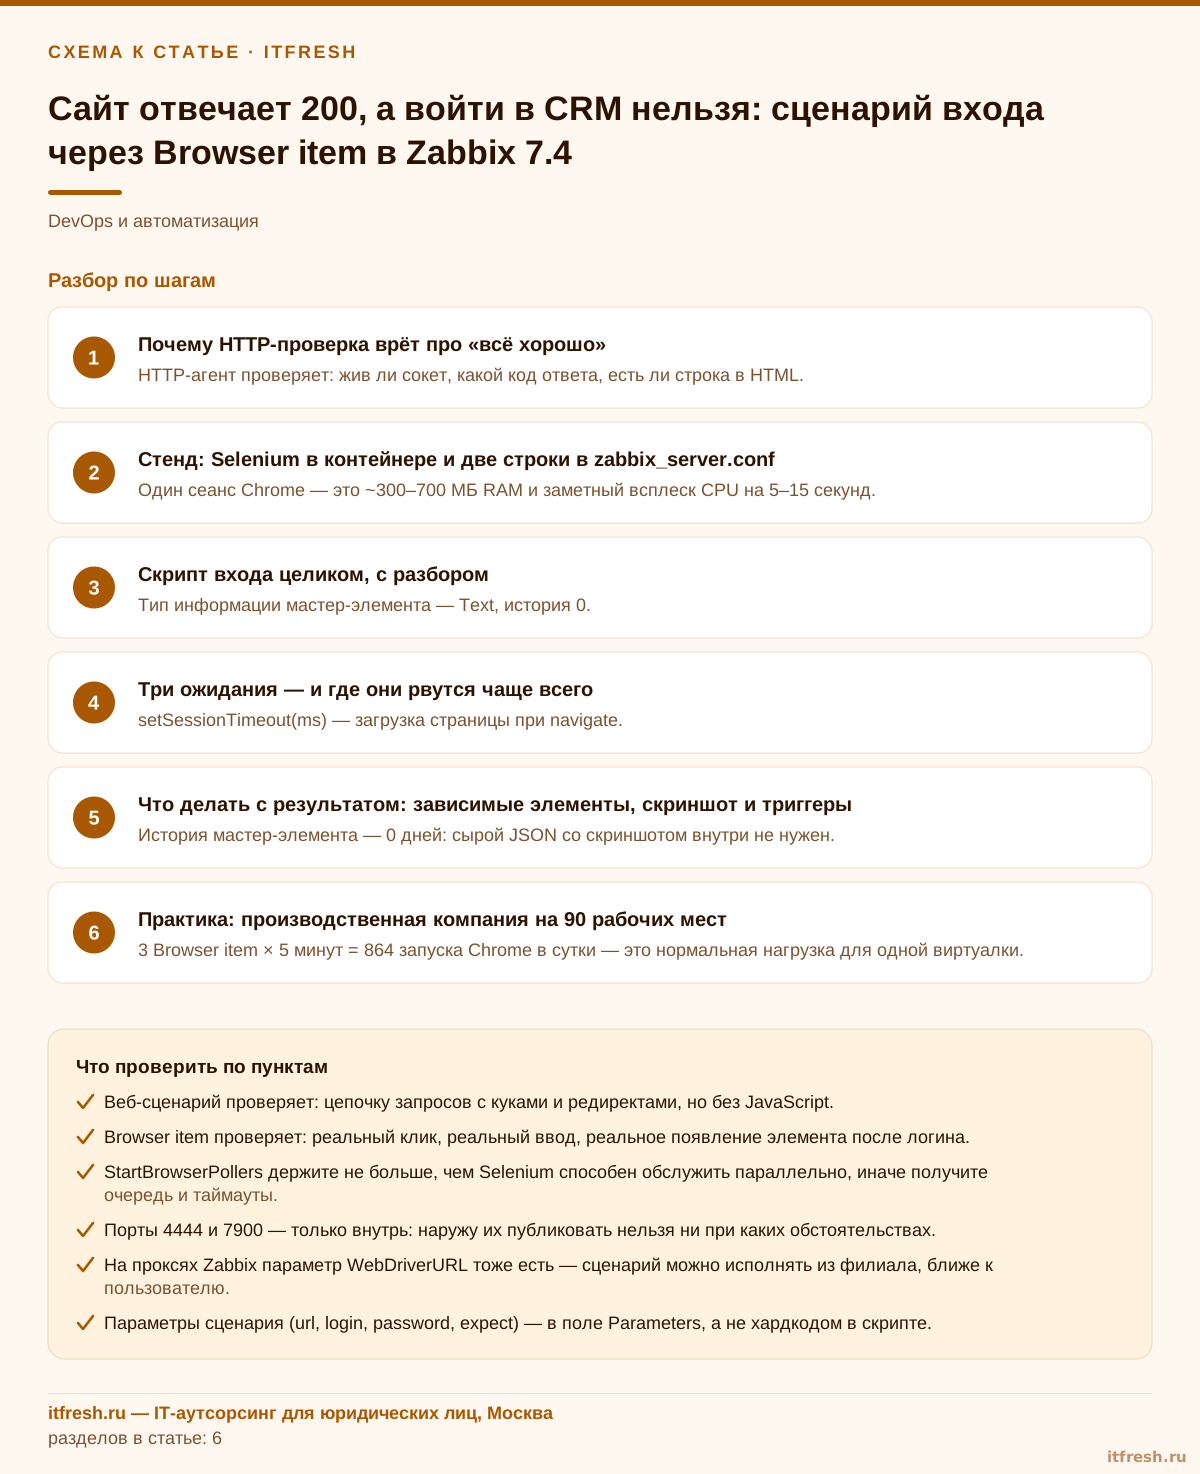
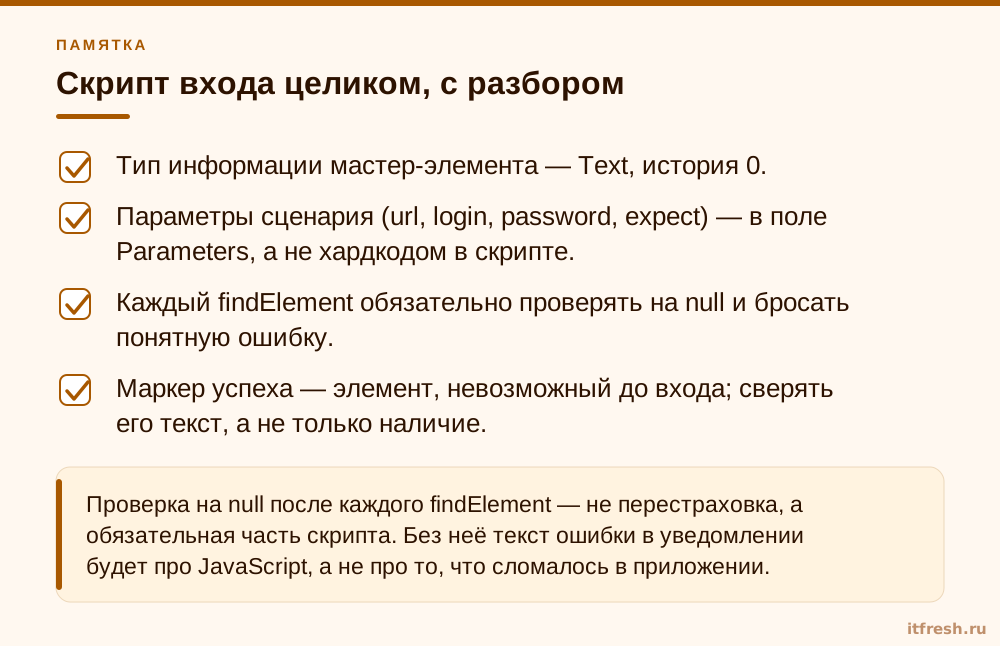
Тип элемента данных — Browser, ключ произвольный (я делаю login.check[crm]), тип информации Text, история 0 — сырой JSON хранить незачем, из него всё разложится по зависимым элементам (штатный шаблон делает так же). В поле Parameters складываю пары имя/значение, они приезжают в скрипт одной JSON-строкой в переменной value. Timeout — от 1 до 600 секунд; для сценария входа я ставлю 60s.
var params = JSON.parse(value);   // Parameters из карточки элемента
var ok = 0, browser, result;

var opts = Browser.chromeOptions();
opts.capabilities.alwaysMatch['goog:chromeOptions'].args = [
    '--headless=new', '--no-sandbox', '--disable-gpu', '--window-size=1600,900'
];

browser = new Browser(opts);
browser.setScreenSize(1600, 900);
browser.setSessionTimeout(30000);       // мс: загрузка страницы
browser.setScriptTimeout(20000);        // мс: выполнение JS на странице
browser.setElementWaitTimeout(10000);   // мс: неявное ожидание элемента

try {
    browser.navigate(params.url);
    browser.collectPerfEntries('login page');

    var user = browser.findElement('css selector', 'input[name=username]');
    if (user === null) { throw Error('нет поля логина на форме'); }
    user.sendKeys(params.login);

    var pass = browser.findElement('css selector', 'input[name=password]');
    if (pass === null) { throw Error('нет поля пароля на форме'); }
    pass.sendKeys(params.password);

    var btn = browser.findElement('css selector', 'button[type=submit]');
    if (btn === null) { throw Error('нет кнопки входа'); }
    btn.click();

    // главное: элемент, который существует ТОЛЬКО после успешного входа
    var marker = browser.findElement('css selector', '[data-test=user-menu]');
    if (marker === null) { throw Error('после отправки формы меню пользователя не появилось'); }

    var who = marker.getText();
    if (who.indexOf(params.expect) === -1) {
        throw Error('вошли не под тем пользователем: ' + who);
    }

    browser.collectPerfEntries('logged in');
    ok = 1;
}
catch (err) {
    browser.setError(err.message);
}

result = browser.getResult();
result.login_ok = ok;
result.screenshot = browser.getScreenshot();

return JSON.stringify(result);
Разбираю важные места. Browser.chromeOptions() возвращает готовые опции, по умолчанию в них уже есть --headless=new; я переопределяю массив args целиком, поэтому headless указываю явно. findElement принимает стратегию поиска — 'css selector', 'xpath', 'link text', 'partial link text' или 'tag name'. И главное, что ломает людям сценарии: если элемент не найден, findElement не бросает исключение, а возвращает null. Скрипт без проверки падает позже, в непонятном месте, с сообщением вида «cannot read property of null», и вы полчаса ищете, где именно. Я проверяю каждый элемент отдельной строкой с внятным текстом ошибки — это сообщение потом уедет в уведомление, и по нему сразу понятно, что случилось.
Второе — маркер успеха. Проверять факт отправки формы бессмысленно: она отправится всегда. Проверять надо элемент, который не может отрисоваться до успешной авторизации: меню пользователя, аватар, кнопку «Выход», имя сотрудника в шапке. И лучше не только наличие, а содержимое через getText(): я видел случай, когда после сбоя SSO приложение пускало всех в гостевой режим — элемент был, а пользователь не тот. Отсюда сравнение с params.expect.
Ещё пара нюансов. Один скрипт поддерживает до четырёх объектов Browser — хватает, чтобы в одном элементе проверить и вход, и, например, открытие карточки клиента. Zabbix.sleep(2000) существует и иногда спасает на анимациях, но каждый sleep — гарантированные две секунды из бюджета таймаута, поэтому я использую его только там, где без него никак. А collectPerfEntries('метка') — почти бесплатный способ получить тайминги по шагам: DNS, TCP, TLS, загрузку DOM и ресурсов. Эти цифры потом ложатся на график «вход стал медленнее» задолго до того, как он совсем сломается.
- Тип информации мастер-элемента — Text, история 0.
- Параметры сценария (url, login, password, expect) — в поле Parameters, а не хардкодом в скрипте.
- Каждый findElement обязательно проверять на null и бросать понятную ошибку.
- Маркер успеха — элемент, невозможный до входа; сверять его текст, а не только наличие.
Три ожидания — и где они рвутся чаще всего
У Browser item таймауты живут на нескольких уровнях, и путаница между ними — вторая по частоте причина мигающих триггеров. Внутри скрипта их три, и все принимают миллисекунды. setSessionTimeout — таймаут загрузки страницы. setScriptTimeout — таймаут выполнения скриптов на странице. setElementWaitTimeout — неявное ожидание при поиске элемента: если элемента ещё нет в DOM, findElement ждёт до этого предела и только потом возвращает null.
Сверху лежит четвёртый — Timeout самого элемента данных, 1–600 секунд. Он ограничивает выполнение всего скрипта. Правило простое: таймаут элемента должен быть заметно больше суммы худших случаев внутри скрипта, иначе вместо понятной ошибки «не появилось меню пользователя» вы получите бесполезный обрыв по таймауту. Мой рабочий набор для типового портала: session 30000, script 20000, elementWait 10000, item timeout 60s, интервал опроса 5m. Для тяжёлого веб-клиента 1С поднимаю session до 60000, а item timeout до 120s.
Отдельная ловушка — миллисекунды против секунд. Человек по привычке пишет setElementWaitTimeout(10) и получает ожидание в десять миллисекунд, то есть фактически его отсутствие. Дальше сценарий падает на каждой второй проверке, причём случайным образом, и всё выглядит как «Zabbix глючит». Проверяйте единицы измерения в первую очередь, если сценарий флапает.
И ещё: элемент, найденный в DOM, не всегда готов к клику. Модалка может ещё уезжать, кнопка — быть перекрыта оверлеем. Универсального ожидания «кликабельности» в API Browser item нет, поэтому я решаю это иначе: ищу не саму кнопку, а элемент, который появляется только после завершения анимации, либо проверяю через getAttribute('disabled'), либо, если совсем никак, ставлю короткий Zabbix.sleep. Но сначала всегда пробую подобрать более поздний селектор — это надёжнее любого sleep.
- setSessionTimeout(ms) — загрузка страницы при navigate.
- setScriptTimeout(ms) — выполнение JavaScript на странице.
- setElementWaitTimeout(ms) — неявное ожидание появления элемента в DOM.
- Timeout элемента данных (1–600 с) — общий предел на весь скрипт.
- Интервал опроса — я не ставлю чаще 3–5 минут: каждая проверка это полноценный запуск Chrome.
Что делать с результатом: зависимые элементы, скриншот и триггеры
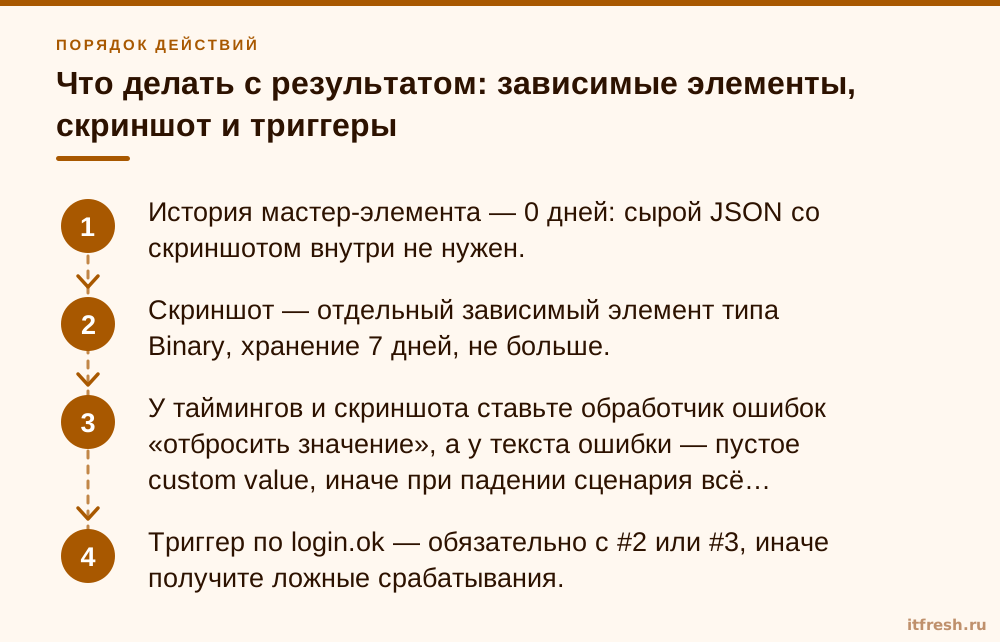
Мастер-элемент возвращает один JSON. Разбирать его надо не в триггерах, а зависимыми элементами с предобработкой JSONPath — так сделано в штатном шаблоне «Website by Browser», где на один browser-элемент приходится несколько десятков зависимых. Минимальный набор для сценария входа у меня такой: флаг успеха, текст ошибки, длительность сессии, пара таймингов навигации и скриншот. Поле duration в Result документация описывает как строку «от создания сессии до получения результата» — перед тем как вешать на него множитель, посмотрите на сырой JSON своей версии.
login.ok        DEPENDENT  Numeric(unsigned)  JSONPath: $.login_ok
login.error     DEPENDENT  Character          JSONPath: $.error.message   (error handler: Custom value "")
login.duration  DEPENDENT  Float, units s     JSONPath: $.duration        (единицы сверить по сырому JSON)
login.dns       DEPENDENT  Float, units s     JSONPath: $.performance_data.summary.navigation.dns_lookup_time
                                              + Custom multiplier 0.001
login.shot      DEPENDENT  Binary             JSONPath: $.screenshot      (error handler: Discard value)
Скриншот — отдельное удовольствие. getScreenshot() возвращает base64-строку с изображением области просмотра браузера, а с версии 7.0 в Zabbix есть тип информации Binary для зависимых элементов: такие значения хранятся в отдельной таблице истории и показываются миниатюрами в виджете «История элемента данных». В штатном шаблоне это сделано именно так: зависимый элемент website.screenshot с типом BINARY и единственным шагом JSONPath $.screenshot с обработчиком «отбросить значение». Практическая ценность огромная: когда в три часа ночи приходит алерт «вход не работает», вы открываете дашборд и видите, что было на экране. Баннер «идут технические работы», капча или 502 от балансировщика.
Триггеры делаю максимально скучные и с запасом на дребезг. Первый — на два подряд неуспешных прогона, а не на один: сеть моргнула, Chrome не поднялся, у Selenium был пик — единичная неудача не повод будить человека. Второй — на отсутствие данных, потому что молчащий сценарий это тоже авария, только тихая. Третий — на деградацию времени входа, он предупредительный.
# вход не работает (два прогона подряд)
min(/CRM by browser/login.ok,#2)=0

# сценарий вообще перестал отдавать данные
nodata(/CRM by browser/login.ok,15m)=1

# вход стал заметно медленнее (среднее за час)
avg(/CRM by browser/login.duration,1h)>15

# Event name первого триггера — с текстом ошибки через expression macro:
# Вход в CRM не работает: {?last(/CRM by browser/login.error)}
Текст ошибки я вывожу в имя события (Event name) через expression macro {?last(…)} по элементу login.error. Обычный {ITEM.LASTVALUE} тут не подойдёт: он берёт значение элемента из выражения триггера, а в выражении стоит login.ok. Тогда в уведомлении приходит не «Проблема: вход в CRM», а «Вход в CRM не работает: после отправки формы меню пользователя не появилось». Разница между «поехали разбираться» и «понятно, что чинить» — минут двадцать ночью.
- История мастер-элемента — 0 дней: сырой JSON со скриншотом внутри не нужен.
- Скриншот — отдельный зависимый элемент типа Binary, хранение 7 дней, не больше.
- У таймингов и скриншота ставьте обработчик ошибок «отбросить значение», а у текста ошибки — пустое custom value, иначе при падении сценария всё покраснеет разом.
- Триггер по login.ok — обязательно с #2 или #3, иначе получите ложные срабатывания.
Практика: салон «Розовый фламинго», 33 рабочих места
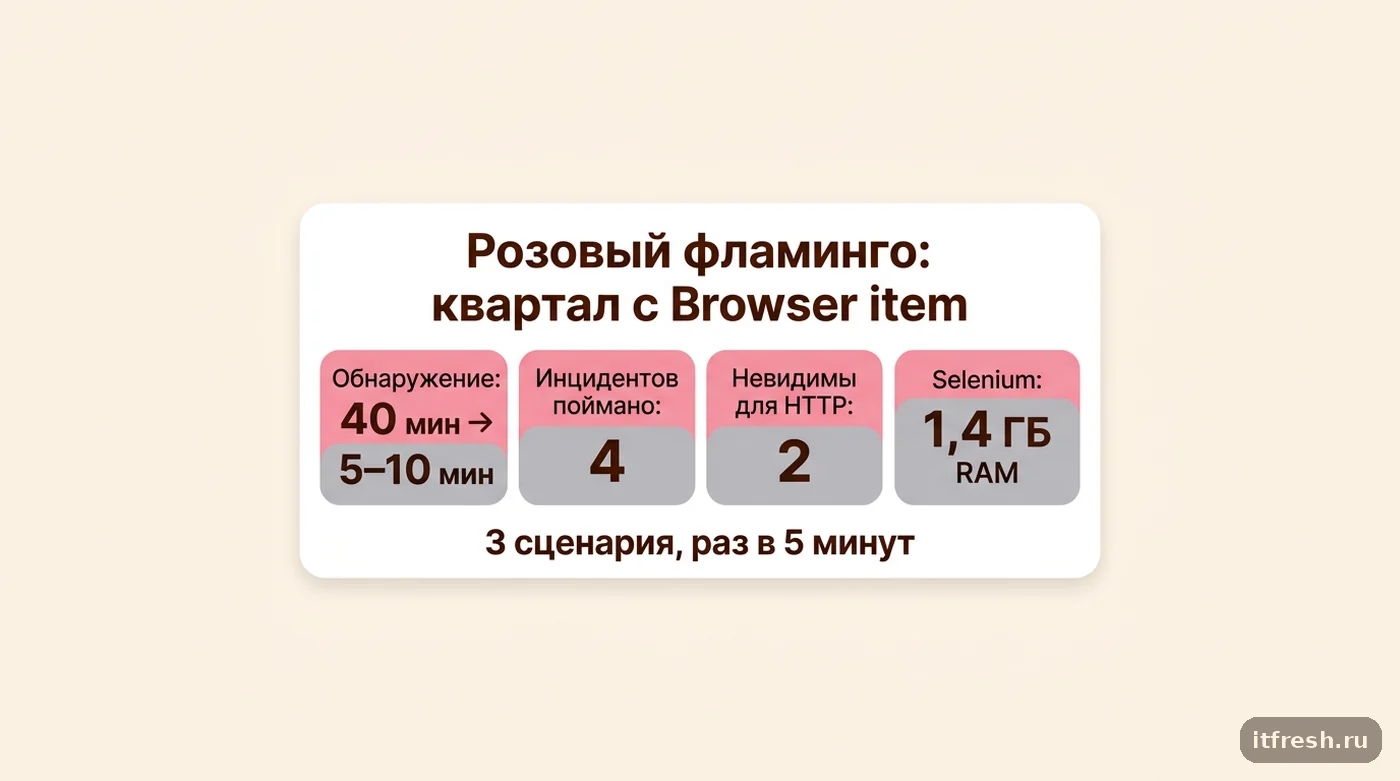
Салон красоты «Розовый фламинго» — 33 рабочих места: стойки администраторов, кабинеты управляющих, бухгалтерия, колл-центр записи. Три системы, без которых работа встаёт: веб-CRM записи клиентов на React, веб-клиент 1С и личный кабинет онлайн-записи на сайте. Мониторинг был, и он был бесполезный: HTTP-агенты на все три адреса, все зелёные, при этом за квартал набралось четыре простоя, о которых мы узнавали от администраторов. Среднее время от «перестало работать» до «мы узнали» — около 40 минут, потому что люди сначала минут двадцать думают, что это у них интернет.
Собрал так: Zabbix 7.4 на Debian 12, виртуалка 4 vCPU / 8 ГБ. Рядом контейнер selenium/standalone-chrome с --shm-size=2g, порты только на loopback. В zabbix_server.conf — WebDriverURL на 127.0.0.1:4444 и StartBrowserPollers=3. Три Browser item, по одному на систему, интервал 5 минут, item timeout 60s (у 1С — 120s, веб-клиент грузится долго). Пароли — в макросах уровня хоста типа «секретный текст», в скрипт приезжают через Parameters. Учётки отдельные, сервисные, с минимальными правами и понятным именем вроде svc_monitor, чтобы администраторы не пугались чужих сессий. Прежде чем включать проверки, прогнали сценарии на тестовом контуре — подход описан в статье про тестовый контур перед обновлением сайта или CRM.
Результат за первый квартал. Сценарии поймали четыре инцидента, два из которых HTTP-мониторинг не увидел бы никогда. Первый: у провайдера аутентификации CRM протух секрет клиента, форма входа рисовалась, кнопка кидала на страницу ошибки — HTTP-агент всё это время показывал 200. Второй: на сервере приложения кончилось место под сессиями, POST на /api/auth стал отдавать 500, главная осталась живой. Ещё два — банальные: упал сервер 1С и отвалилась LDAP-интеграция личного кабинета. Время обнаружения упало с ~40 минут до 5–10: интервал опроса плюс подтверждение вторым прогоном.
Цена по ресурсам оказалась ниже, чем я закладывал. Пиковое потребление контейнера Selenium — около 1,4 ГБ RAM при трёх параллельных сессиях, одна проверка занимает ядро на 8–12 секунд. История скриншотов при хранении 7 дней выросла до ~350 МБ и там стабилизировалась. Отдельно порадовали тайминги из collectPerfEntries: за две недели до падения LDAP-интеграции время входа в личный кабинет уже уползло с 3 до 9 секунд — предупредительный триггер сработал бы раньше аварийного, если бы я поставил его сразу, а не после.
Что не взлетело — честно. В CRM у управляющих включена двухфакторка, и автоматизировать её я не стал: обходить второй фактор ради мониторинга — ослаблять защиту ради красивого графика. Вместо этого сценарий идёт до второго фактора: проверяю, что логин с паролем принят и приложение дошло до экрана ввода кода. Это ловит большинство реальных отказов — упавший бэкенд, сломанный LDAP, протухший SSO — и не трогает безопасность. Сам сервис 2FA мониторится отдельно.
- 3 Browser item × раз в 5 минут = 864 запуска Chrome в сутки — нормальная нагрузка для одной виртуалки.
- Селекторы за квартал пришлось править дважды: оба раза после релиза фронтенда CRM.
- Договоритесь с разработчиками о стабильных атрибутах data-test — это снимает основную часть хрупкости сценариев.
Пароли, 2FA, SSO и чего я принципиально не делаю
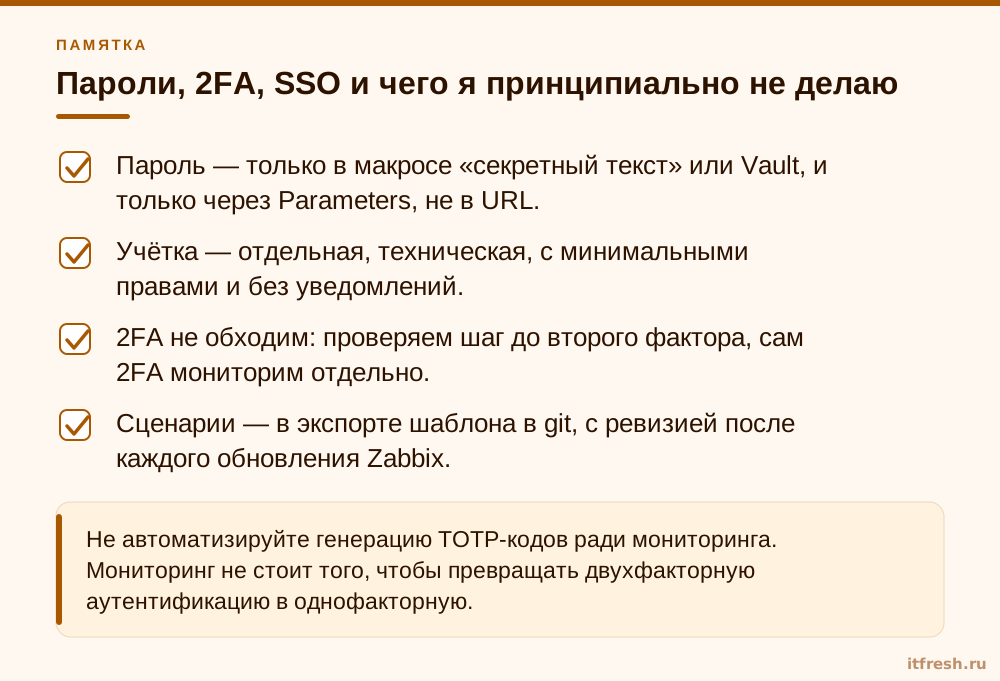
Пароль сервисной учётки открытым текстом в скрипте — самая частая ошибка, которую я вижу в чужих инсталляциях. Скрипт видят все, у кого есть доступ к конфигурации хоста, он уезжает в экспорт шаблона, в git, в бэкап. Правильно — макрос типа «секретный текст», значение которого маскируется, либо макрос Vault: значение лежит в HashiCorp Vault или CyberArk, и сервер забирает его при каждом обновлении кэша конфигурации. Ограничение из документации: URL с секретным макросом работать не будет, макрос там разрешится в «******». В Parameters — можно.
Учётка для мониторинга должна быть отдельной и минимально правной. Не «админ, потому что так проще», а пользователь без доступа к данным, желательно помеченный в системе как технический. Иначе через полгода кто-нибудь увидит в аудите вход админа каждые пять минут и начнётся веселье. Плюс отключите этой учётке всё, что генерирует шум: подписки, уведомления, рассылки, автоматические записи в журнал действий.
SSO и двухфакторка — та область, где единого мнения нет, и на форумах вокруг Browser item спорят до сих пор. Одни автоматизируют TOTP, генерируя код прямо в скрипте из секрета в Vault. Технически это работает. Моя позиция: так делать не надо — вы кладёте второй фактор в ту же систему, что и первый, и он перестаёт быть вторым. Я делаю проверку до второго фактора, а сам провайдер аутентификации мониторю отдельно, его собственными health-эндпоинтами. С капчей — то же самое: если на форме входа капча, сценарий делается либо с обходного URL, доступного только с IP мониторинга, либо не делается вовсе.
И про приоритеты, потому что времени всегда мало. В первую очередь ставьте сценарий на ту систему, простой которой дороже всего — обычно это CRM или учётная система, а не корпоративный сайт. Одна проверка, один шаг, интервал 5 минут, два триггера. На что можно спокойно забить на старте: полный E2E-сценарий с созданием документа, скриншоты каждой проверки, красивый дашборд с таймингами по всем ресурсам. Это всё приятно, но пользы даёт в разы меньше, чем один честный ответ на вопрос «а войти-то сейчас можно?».
Отдельно про экспериментальный статус. Документация 7.4 прямо пишет, что поддержка Browser items экспериментальная, и это стоит понимать буквально: API может измениться. При этом функция живёт с 7.0 LTS, на ней построен штатный шаблон вендора, и в проде она у меня работает стабильно. Практический компромисс: внедрять можно, но сценарии держите в экспорте шаблона в git и прогоняйте вручную после каждого мажорного обновления Zabbix.
- Пароль — только в макросе «секретный текст» или Vault, и только через Parameters, не в URL.
- Учётка — отдельная, техническая, с минимальными правами и без уведомлений.
- 2FA не обходим: проверяем шаг до второго фактора, сам 2FA мониторим отдельно.
- Сценарии — в экспорте шаблона в git, с ревизией после каждого обновления Zabbix.
Частые вопросы
Чем Browser item лучше обычного веб-сценария Zabbix?
Веб-сценарий выполняет последовательность HTTP-запросов с куками и редиректами, но не исполняет JavaScript. Для SPA (React, Vue, Angular) это означает, что он проверяет пустой HTML-каркас, а не саму форму входа. Browser item поднимает настоящий браузер через WebDriver, кликает, вводит текст и ждёт появления элементов, то есть проверяет ровно тот сценарий, который выполняет живой сотрудник. Если приложение классическое, серверного рендеринга, — веб-сценария вполне достаточно и городить Selenium не нужно.
Сколько ресурсов съедает такая проверка?
На моих стендах один сеанс Chrome — порядка 300–700 МБ RAM и 8–15 секунд активной работы ядра. С тремя сценариями раз в 5 минут контейнер Selenium держался в пределах 1,4 ГБ памяти, скриншоты при хранении 7 дней заняли около 350 МБ. Не ставьте интервал чаще 3 минут и не вешайте два десятка сценариев на одну виртуалку с Selenium.
Можно ли запускать Browser item с прокси Zabbix?
Да. Browser item выполняют browser-поллеры сервера или прокси, а WebDriverURL и StartBrowserPollers задаются и в конфигурации прокси. Это удобно, когда вход нужно проверять из филиала, с местным провайдером и DNS. Selenium тогда разворачивается рядом с прокси.
Как быть, если на входе двухфакторка или SSO?
Не обходить второй фактор. Я делаю сценарий до шага 2FA: проверяю, что логин с паролем принят и приложение дошло до экрана ввода кода. Это ловит подавляющее большинство реальных отказов — упавший бэкенд, сломанную LDAP-интеграцию, протухший секрет OIDC. Сам провайдер аутентификации мониторится отдельно, его собственными health-эндпоинтами. Генерировать TOTP-коды внутри скрипта технически можно, но это превращает двухфакторную аутентификацию в однофакторную.
Где хранить пароль сервисной учётки?
В пользовательском макросе типа «секретный текст» на уровне хоста, а лучше — в макросе Vault, когда значение лежит в HashiCorp Vault или CyberArk и подтягивается сервером при обновлении кэша конфигурации. В скрипт пароль должен приезжать через поле Parameters. Важное ограничение: секретные макросы нельзя подставлять в URL — там они резолвятся в ****** и сценарий сломается.
Почему сценарий падает через раз, хотя вручную вход работает?
Три типовые причины по частоте. Первая — контейнер Selenium запущен без --shm-size=2g, и Chrome падает на тяжёлых страницах. Вторая — таймауты заданы в секундах вместо миллисекунд: setElementWaitTimeout(10) это десять миллисекунд, а не десять секунд. Третья — результат findElement() не проверяется на null, и скрипт падает не там, где реальная проблема. Начинайте разбор именно с этих трёх пунктов.
Источники
- Zabbix 7.4 — Browser item — Экспериментальный статус («The support of Browser items is currently experimental»), поля элемента, Timeout 1–600 с, выполнение поллерами сервера или прокси. https://www.zabbix.com/documentation/7.4/en/manual/config/items/itemtypes/browser
- Zabbix 7.4 — Browser item JavaScript objects — Browser/Element: до четырёх объектов Browser на скрипт, findElement со стратегиями и возвратом null, таймауты в миллисекундах, getScreenshot (base64), collectPerfEntries, setError, структура Result (duration, error). https://www.zabbix.com/documentation/7.4/en/manual/config/items/preprocessing/javascript/browser_item_javascript_objects
- Zabbix 7.4 — Monitor websites with Browser items — Запуск selenium/standalone-chrome (порты 4444 и 7900, --shm-size=2g), параметры StartBrowserPollers и WebDriverURL, шаблон «Website by Browser». https://www.zabbix.com/documentation/7.4/en/manual/guides/monitor_browser
- Шаблон Zabbix «Website by Browser» (release/7.4) — Мастер-элемент website.get.data типа BROWSER (TEXT, history 0), зависимый website.screenshot типа BINARY с JSONPath $.screenshot и DISCARD_VALUE, тайминги с множителем 0.001. https://github.com/zabbix/zabbix/blob/release/7.4/templates/app/website_browser/template_app_website_browser.yaml
- Zabbix 7.4 — Secret user macros — Секретный текст и Vault-макросы; URL с секретным макросом не работает (разрешается в ******); Vault-значения забираются при обновлении конфигурации. https://www.zabbix.com/documentation/7.4/en/manual/config/macros/secret_macros
- Zabbix 7.4 — zabbix_server.conf — WebDriverURL (пример http://localhost:4444), StartBrowserPollers: диапазон 0–1000, по умолчанию 1. https://www.zabbix.com/documentation/7.4/en/manual/appendix/config/zabbix_server