
Veeam 13: SureBackup проходит heartbeat, но не может пропинговать ВМ в лаборатории
Вы навели порядок в сегментации, унесли сервер Veeam в management-VLAN — и SureBackup покраснел. ВМ поднимаются, heartbeat зелёный, proxy appliance пингуется, а ping test валится у всех машин подряд. Разбираю, почему ломается ровно один тест из трёх, как за пятнадцать минут доказать, что дело в маршруте к masquerade-сети, и какой из трёх способов починки я выбираю на боевых стендах.
Heartbeat зелёный, ping красный — это не «лаборатория сломалась»
Формулировка, с которой ко мне приходят чаще всего: «после переезда Veeam в отдельный VLAN SureBackup стал красным, но машины-то стартуют». Открываем статистику задания — Heartbeat: Success, Ping: Failed, Application test даже не начинается, потому что ждать нечего. И первая мысль почти у всех одна и та же: развалилась виртуальная лаборатория. Не развалилась. Отвалился ровно один канал — ICMP от backup server до masquerade-адреса восстановленной ВМ.
Тесты SureBackup устроены принципиально по-разному, и это половина ответа. Heartbeat в документации Veeam описан так: Veeam ждёт сигнал от VMware Tools внутри машины, чтобы понять, что гостевая ОС запустилась; если сигнал приходит регулярно с нужным интервалом — тест пройден. Обратите внимание: сигнал идёт от Tools к гипервизору и дальше в Veeam через vSphere API. Сети между вашим сервером Veeam и изолированной лабораторией здесь не нужно вообще. Хост может стоять хоть за тремя маршрутизаторами — heartbeat всё равно будет зелёным.
А ping test в той же документации сформулирован так: Veeam отправляет ping-запросы к машине с backup server и проверяет, отвечает ли она. Ключевые слова — «с backup server». Не с ESXi-хоста, не с proxy appliance, не с прокси резервного копирования. С той самой машины, которую вы только что унесли в другой VLAN. Отсюда и вся картина: два теста живут в разных плоскостях, и переезд бьёт по одному из них.
Практический вывод простой и неприятный: зелёный heartbeat не доказывает вообще ничего про сеть. Он доказывает, что образ из бэкапа смонтировался через vPower NFS, машина загрузилась и Tools в ней живы. Это тоже полезно, но если вы считали SureBackup проверкой «восстановление реально работает», то без ping и application test у вас осталась примерно треть ценности.
- Heartbeat test — сигнал VMware Tools через гипервизор, сеть между Veeam и лабораторией не участвует.
- Ping test — ICMP с backup server на masquerade-IP машины, нужен рабочий маршрут в обе стороны.
- Application test — Veeam ждёт старта приложения и запускает против него скрипт проверки (для контроллера домена, DNS и веб-сервера — проверка отклика порта, например 389), опять же с backup server.
Как на самом деле устроен masquerade и почему он такой хрупкий
Внутри виртуальной лаборатории ВМ сохраняет свой продуктивный IP-адрес — иначе половина приложений просто не заведётся. Чтобы в этот изолированный мир можно было постучаться снаружи, Veeam выдаёт каждой машине второй, masquerade-адрес, похожий на продуктивный. Документация даёт прозрачный пример: если у машины адрес 172.16.1.13, то masquerade-адрес может быть 172.18.1.13. Дальше пример из того же раздела: обращаясь к 172.18.10.10, Veeam отправляет запрос на следующий хоп — proxy appliance, тот подменяет masquerade-адрес на реальный 172.16.10.10 и передаёт пакет машине в изолированной сети.
Proxy appliance — это вспомогательная Linux-ВМ, которую Veeam разворачивает на том же ESXi-хосте, где создана лаборатория. Одной ногой она стоит в продуктивной сети, другой — в изолированной, по одному vNIC на каждую изолированную сеть, и работает NAT-шлюзом между двумя мирами. Важная деталь, которую пропускают при настройке: IP-адрес appliance в изолированной сети должен совпадать с адресом шлюза, который прописан у восстанавливаемых машин в продуктивной сети. Не совпал — машины не смогут ответить, даже если пакет до них дойдёт.
Третий элемент — маршрут. Veeam автоматически создаёт статический маршрут в таблице маршрутизации backup server в момент запуска лаборатории, шаг в логе называется Starting virtual lab routing engine. Маршрут непостоянный: выключили лабораторию — он исчез из таблицы. Именно поэтому его нельзя увидеть «потом»: диагностику надо делать при живой лаборатории, иначе вы будете смотреть в пустоту и делать неправильные выводы.
Выглядит это на Windows-сервере Veeam примерно так — три элемента в одной строке: masquerade-подсеть, маска и продуктивный адрес proxy appliance в роли шлюза.
- Masquerade-IP — «точка входа» в машину лаборатории со стороны продуктива, назначается автоматически при настройке vNIC, но его можно поменять руками.
- Proxy appliance — NAT между masquerade-адресом и реальным адресом ВМ в изоляции.
- Статический маршрут на backup server — непостоянный, живёт ровно столько, сколько запущена лаборатория.
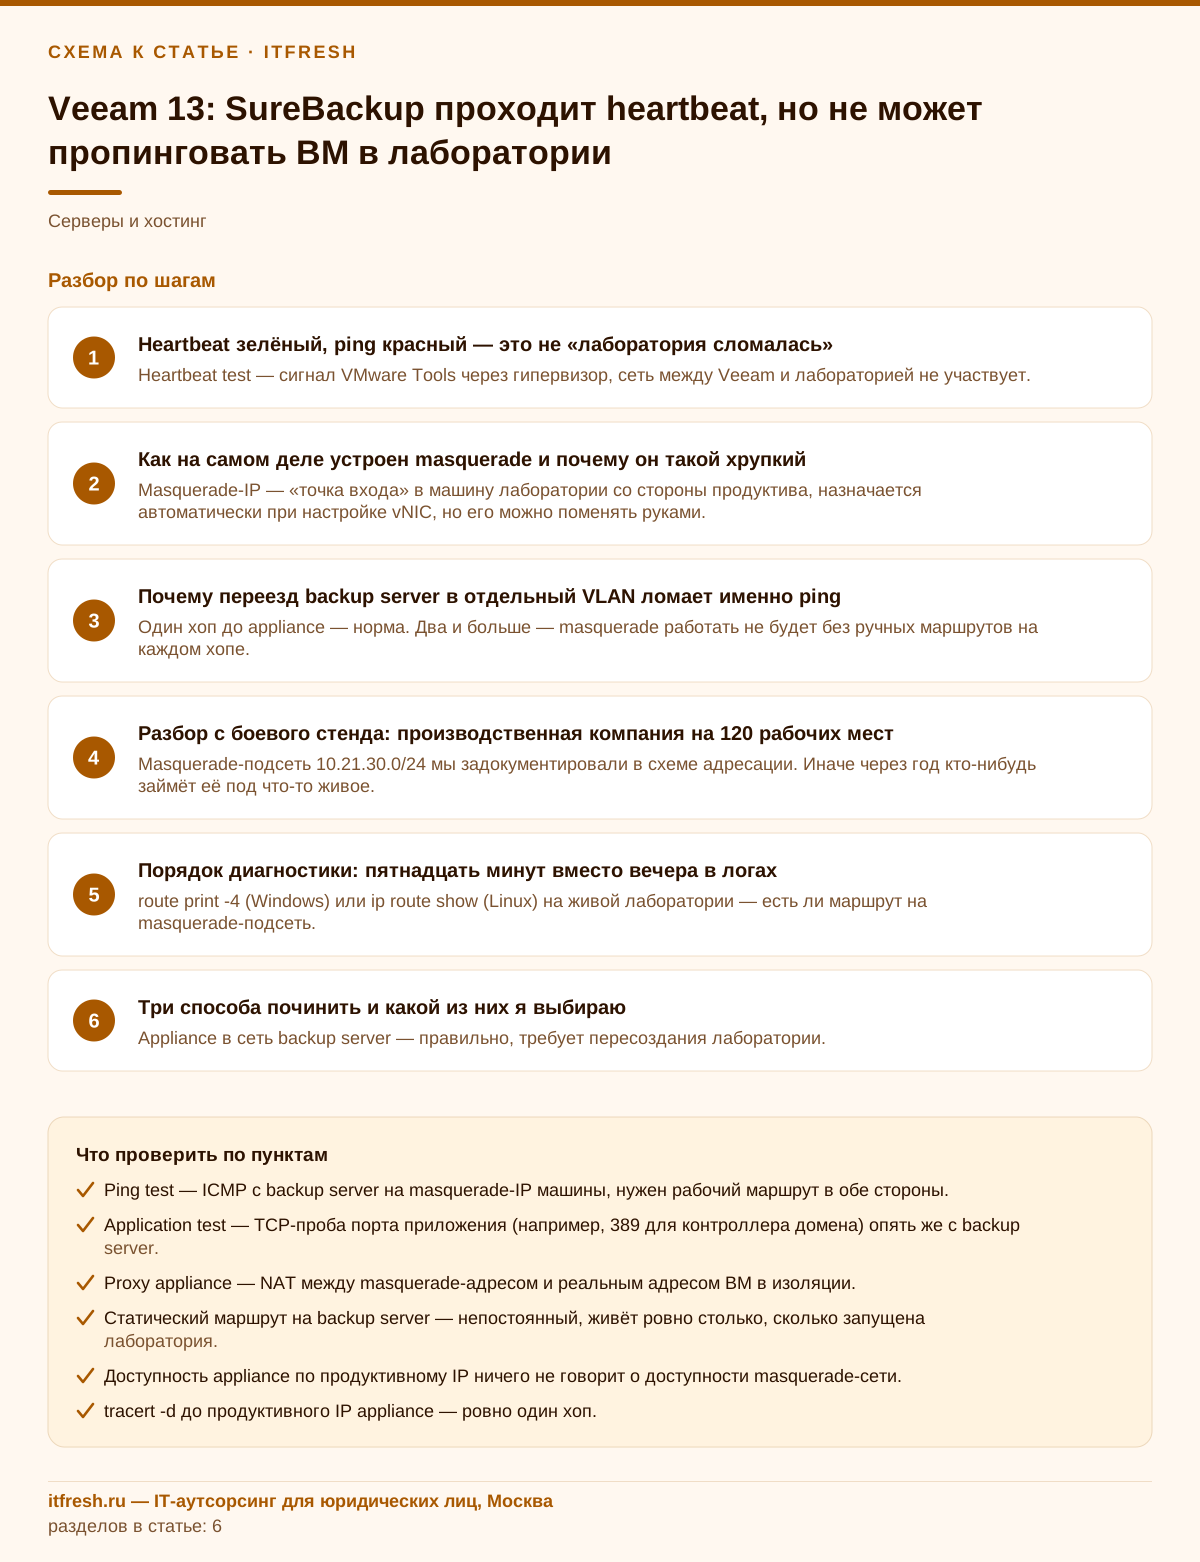
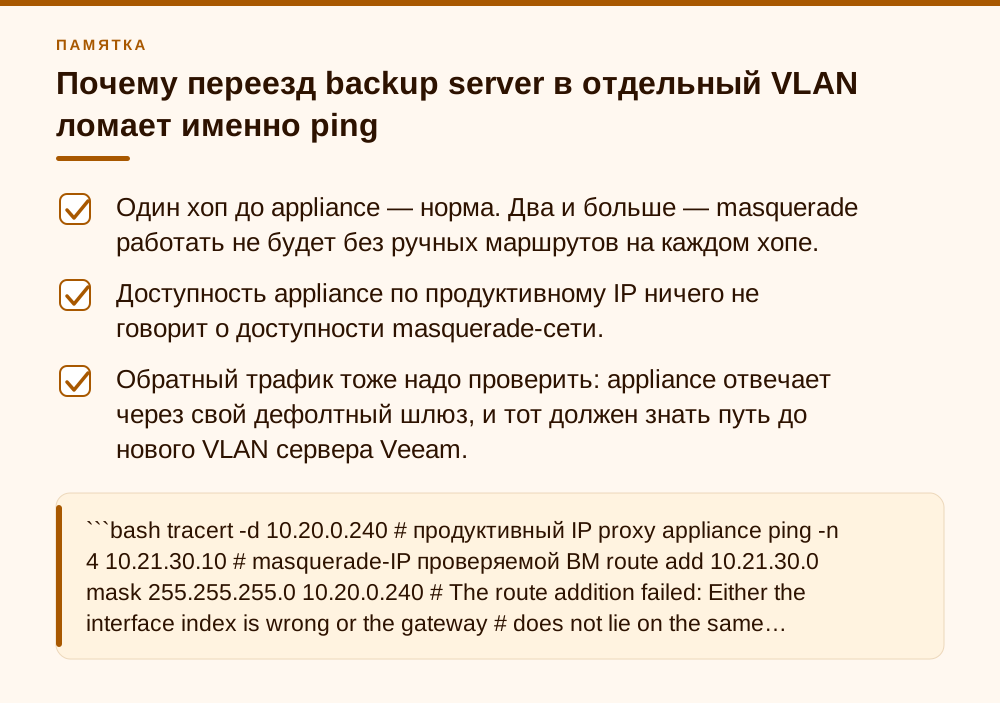
Почему переезд backup server в отдельный VLAN ломает именно ping
Вся конструкция держится на одном допущении: proxy appliance находится в той же сети, что и backup server. Veeam пишет это прямым текстом в шаге мастера Set Up Proxy Appliance: если назначить appliance адрес из той же сети, где находится backup server, маршрут в таблицу добавится автоматически; если адрес из другой сети — маршрут придётся добавлять вручную на маршрутизаторе продуктивной сети, а без этого тесты и скрипты приложений провалятся и доступа к машинам в изолированных сетях не будет.
Механика отказа зависит от того, что именно у вас разъехалось. Сценарий первый, самый частый: backup server уехал в новый VLAN, appliance остался со старым продуктивным адресом. Windows не может добавить маршрут, у которого шлюз не лежит on-link — то есть не принадлежит ни одной из подсетей на интерфейсах. Ручная попытка отвечает «The route addition failed: Either the interface index is wrong or the gateway does not lie on the same network as the interface», а в отчёте задания это никак не выделяется: лаборатория стартовала, шаг routing engine отработал, и глазами отказ не заметить. Маршрута нет, ICMP уходит в дефолтный шлюз, дефолтный шлюз про masquerade-подсеть слышит впервые и роняет пакет.
Сценарий второй, коварнее: маршрут встал (например, вы прописали его вручную через свой шлюз), пакеты дошли до L3-ядра, а на ядре про masquerade-сеть тоже никто не знает. KB1067 первым пунктом ставит ровно это: если между сервером Veeam и appliance есть маршрутизатор, пакеты к masquerade-адресам будут им отброшены. Проверка — банальный tracert до продуктивного адреса appliance: должен быть один хоп. Два и больше — вы уже нашли причину.
И отдельная ловушка, которая уводит диагностику в сторону. При старте лаборатории Veeam проверяет доступность proxy appliance обычным пингом на его продуктивный адрес. Этот пинг ходит по нормальной маршрутизации и из соседнего VLAN проходит прекрасно. Лаборатория поднимается, шаг «Starting virtual lab routing engine» зелёный, appliance доступен — и админ уверенно исключает сеть из подозреваемых. Хотя сломано именно то, чего этот пинг не проверяет: путь к masquerade-подсети.
- Один хоп до appliance — норма. Два и больше — masquerade работать не будет без ручных маршрутов на каждом хопе.
- Доступность appliance по продуктивному IP ничего не говорит о доступности masquerade-сети.
- Обратный трафик тоже надо проверить: appliance отвечает через свой дефолтный шлюз, и тот должен знать путь до нового VLAN сервера Veeam.
Разбор с боевого стенда: садовый центр «Дачный рай» на 18 рабочих мест
Клиент — садовый центр «Дачный рай»: торговый зал с кассами, склад рассады и офис, 18 рабочих мест. Инфраструктура компактная: два хоста vSphere 8.0 U3, Veeam Backup & Replication 13 на отдельном Windows-сервере. SureBackup-задание на 5 машин: контроллер домена в application group, за ним файловый сервер, сервер 1С с SQL, сервер кассовой системы и небольшой веб-сервер интернет-витрины. Задание крутилось по субботам полгода и было стабильно зелёным, прогон занимал около двадцати пяти минут.
Дальше мы делали сегментацию: вынесли всё управление инфраструктурой из плоской сети 10.20.0.0/24 в отдельный VLAN 90 — 10.20.90.0/24, туда же уехал и сервер Veeam. Изолированная сеть лаборатории маппилась на продуктивный VLAN 30 (10.20.30.0/24), masquerade-подсеть Veeam выбрал сам — 10.21.30.0/24. Первый же субботний прогон после переезда: 5 из 5 машин Heartbeat Success, 5 из 5 Ping Failed, application test не стартовал ни у одной. Задание — Failed, отчёт ушёл на общий ящик, который в разгар сезона рассады никто не читал. Хватились на третьей неделе.
Диагностика заняла минут двадцать, потому что мы сразу пошли не в логи, а в таблицу маршрутизации. Запустили задание, дождались строки Starting virtual lab routing engine, на живой лаборатории выполнили route print — маршрута на 10.21.30.0/24 нет ни одного. Ручное добавление через продуктивный адрес appliance 10.20.0.240 отвалилось с «the gateway does not lie on the same network as the interface»: шлюз не on-link, сервер теперь в 10.20.90.0/24. tracert до 10.20.0.240 показал два хопа, через 10.20.90.1. Диагноз закрыт: proxy appliance остался в старой сети, backup server уехал, автоматический маршрут поставить некуда.
Чинили в два приёма. Быстрый обход в ту же ночь: на сервере Veeam прописали маршрут через собственный шлюз, а на L3-ядре — маршрут на masquerade-подсеть в сторону appliance. Обратный трафик пошёл сам: appliance отвечает через свой дефолтный шлюз 10.20.0.1, а это то же ядро, которое про 10.20.90.0/24 прекрасно знает. Прогон в ту же ночь — 5 из 5 Success, 26 минут, ровно как до переезда. Нормальное решение сделали на плановом окне через неделю: пересоздали виртуальную лабораторию с продуктивной сетью в VLAN 90 и адресом appliance 10.20.90.240, после чего временные маршруты с ядра и с сервера сняли.
- Пересоздавать лабораторию пришлось не от хорошей жизни: продуктивную сеть у виртуальной лаборатории нельзя изменить после её создания — это ограничение мастера, а не наша лень.
- Отчёты SureBackup после этого случая ушли не на общий ящик, а в мониторинг с алертом: три недели незамеченных красных прогонов — это ровно то, ради чего SureBackup и заводят.
- Masquerade-подсеть 10.21.30.0/24 мы задокументировали в схеме адресации. Иначе через год кто-нибудь займёт её под что-то живое.
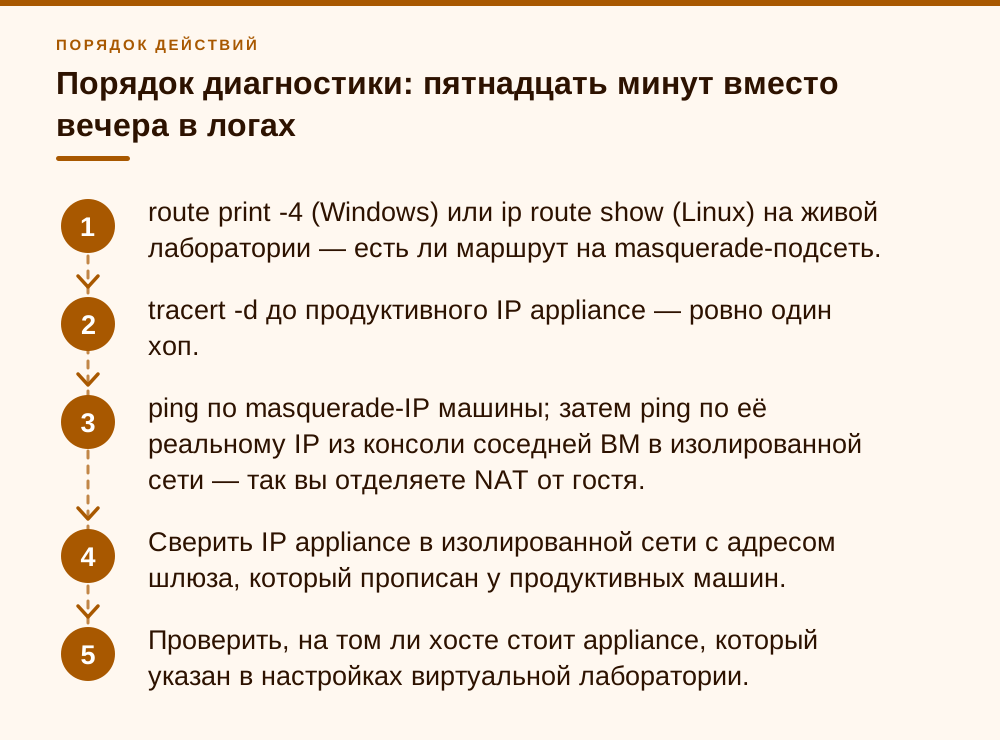
Порядок диагностики: пятнадцать минут вместо вечера в логах
Главное правило — всё проверяется на живой лаборатории. Маршрут непостоянный, и после остановки задания половину улик вы не увидите. Поэтому первым делом запускаем SureBackup и, если машина падает, поднимаем её в режиме troubleshooting: в VBR 13 в статистике задания правой кнопкой по упавшей машине — Start, и машина вместе с application group остаётся включённой, пока вы вручную не остановите сессию. Это даёт спокойное окно, чтобы поработать руками, а заодно проверить, не малы ли у вас Maximum allowed boot time и Application initialization timeout.
Дальше идём по списку сверху вниз и останавливаемся на первом же несовпадении. Порядок именно такой: сначала маршрут, потом хопы, потом NAT, и только в самом конце — гостевой firewall. Если начать с firewall (а начинают обычно с него), вы потратите час на машину, до которой пакет всё равно не долетает.
Если у вас Veeam 13 развёрнут не на Windows, а на Linux-апплаенсе, команды другие, а логика та же: смотрим таблицу маршрутизации и спрашиваем ядро, каким путём оно пойдёт к конкретному masquerade-адресу. Оговорюсь честно: доступ к шеллу апплаенса ограничен по дизайну, и часть проверок удобнее делать не с него, а с любой Linux-машины в том же VLAN — сетевая картина от этого не меняется.
И последняя проверка, которую все забывают: ARP. Если маршрут есть, хопов один, а пинг всё равно молчит — посмотрите, отвечает ли appliance на ARP-запрос по своему продуктивному адресу. Бывает, что appliance после DRS уехал на другой хост, где нужного портгруппы просто нет.
- route print -4 (Windows) или ip route show (Linux) на живой лаборатории — есть ли маршрут на masquerade-подсеть.
- tracert -d до продуктивного IP appliance — ровно один хоп.
- ping по masquerade-IP машины; затем ping по её реальному IP из консоли соседней ВМ в изолированной сети — так вы отделяете NAT от гостя.
- Сверить IP appliance в изолированной сети с адресом шлюза, который прописан у продуктивных машин.
- Проверить, на том ли хосте стоит appliance, который указан в настройках виртуальной лаборатории.
- И только теперь — гостевой firewall и профиль сети внутри проверяемой ВМ.
Три способа починить и какой из них я выбираю
Первый способ — привести proxy appliance в ту же сеть, где живёт backup server. Это то, что рекомендует сам Veeam, и это то, что я делаю по умолчанию. Плюс очевидный: конструкция снова работает автоматически, никаких маршрутов на сетевом оборудовании, ничего не сломается при замене ядра или переписывании ACL. Минус ровно один и его надо знать заранее: продуктивную сеть у существующей виртуальной лаборатории изменить нельзя, лабораторию придётся пересоздать. На практике это полчаса работы мастером, но лучше запланировать окно, чем узнать об ограничении в пятницу вечером.
Второй способ — оставить как есть и прописать маршруты руками. На backup server маршрут в masquerade-подсеть через собственный шлюз, на каждом L3-хопе между сервером и лабораторией — маршрут в ту же подсеть через продуктивный адрес appliance. Работает, проверено, но это долг, который вам обязательно предъявят: масштабируется плохо, при появлении второй лаборатории надо помнить про вторую masquerade-подсеть, а любой человек, который через год будет чистить статику на ядре, снесёт «непонятный маршрут в никуда». Я держу такой вариант как временный обход, а не как решение.
Третий способ — вообще не ходить через masquerade. Veeam умеет static IP mapping: вы резервируете свободный адрес из продуктивного пула, он назначается на vNIC appliance в продуктивной сети и маппится на конкретную машину в лаборатории. В документации пример прозрачный: машине с адресом 192.168.1.20 в изолированной сети сопоставляется свободный 192.168.1.99 из продуктива, и по нему машина доступна снаружи. Из соседнего VLAN такой адрес достижим обычной маршрутизацией — никаких экзотических подсетей. Ограничение честное: это ручная работа по одной машине, и годится она для точечных задач вроде выдачи пользователям доступа к поднятому из бэкапа почтовику, а не для автоматических тестов всех пяти ВМ.
Отдельно о том, чего делать не надо. Самое частое «решение» этой проблемы в природе — снять галку Ping test в настройках задания или application group. Задание позеленеет мгновенно. Ровно с этого момента вы проверяете только то, что ВМ загрузилась, и перестаёте проверять, что она доступна по сети и что её приложение отвечает. Application test, кстати, отвалится вместе с ping по той же причине — он тоже стучится с backup server, и его тоже захочется отключить. В сумме от полноценной проверки восстановления останется heartbeat, то есть почти ничего.
- Appliance в сеть backup server — правильно, требует пересоздания лаборатории.
- Ручные маршруты на всех хопах — работает, но это технический долг и временный обход.
- Static IP mapping — точечно и удобно для доступа людей, не заменяет автоматические тесты.
- Отключить ping test — не решение, а способ перестать видеть проблему.
Когда VLAN ни при чём: остальные причины красного ping
Если маршрут на месте и до appliance один хоп, а ping всё равно timed out — дальше по частоте идёт гостевой firewall. Машина, входящая в домен, при запуске в лаборатории без контроллера домена в application group не находит домен и переключает профиль сети на Public, а Public по умолчанию блокирует входящий ICMP. Лечится двумя способами: правильным — добавить в application group контроллер домена с ролью Domain Controller (Authoritative Restore), и грубым — включить в машине правило firewall на echo request. Учтите, что грубый способ требует нового бэкапа: правило должно попасть в резервную копию, иначе в лаборатории его снова не будет.
Вторая по популярности причина — неверно настроенный vNIC изолированной сети. Адрес appliance в изолированной сети обязан совпадать с адресом шлюза, который машины ожидают увидеть. Если у ВМ шлюз 10.0.8.1, то и vNIC должен быть 10.0.8.1. Плюс ограничения мастера, о которые спотыкаются на сложных стендах: на одну изолированную сеть нельзя повесить больше одного vNIC на протокол, адреса разных vNIC должны принадлежать разным сетям, всего изолированных сетей на лабораторию не больше девяти. И если хотите, чтобы машины в разных изолированных сетях видели друг друга, нужна галка Route network traffic between vNICs — без неё сегменты внутри лаборатории останутся глухими друг к другу.
Дальше — редкие, но живучие. Appliance уехал на другой хост: в настройках лаборатории указан один ESXi, фактически ВМ стоит на другом, портгруппы не совпали. Маршрут не создался из-за защитного ПО на самом сервере Veeam — Veeam прямо называет это среди причин, и у меня был случай, когда EDR блокировал модификацию таблицы маршрутизации службой. Дубликаты сетевых адаптеров с APIPA-адресами у старых гостевых ОС на VMXNET3 — это уже музейный экспонат, но на legacy-стендах встречается. И совсем прозаичное: NIC teaming в лаборатории не поддерживается, а если у продуктивной ВМ несколько адресов, тесты отработают только по одному из них.
Наконец, про сам смысл упражнения. Ложные красные прогоны опаснее, чем кажется: через две-три недели их перестают читать, потом отключают проверки, а потом выясняется, что в реальном восстановлении машина не поднимается по причине, которую SureBackup ловил бы каждую субботу. Если вы уже дошли до состояния «задание красное, но мы знаем, что это из-за сети» — почините сеть или временно уберите машину из задания явно, но не выключайте тест.
- Домен-машина без DC в application group → профиль Public → входящий ICMP заблокирован.
- IP appliance в изолированной сети должен равняться шлюзу продуктивной сети.
- Проверьте, что appliance физически на том хосте, который указан в настройках лаборатории.
- Защитное ПО на сервере Veeam умеет блокировать создание непостоянного маршрута.
- Нет VMware Tools — heartbeat и ping не выполняются, а не «падают».
Частые вопросы
Почему heartbeat проходит, а ping — нет? Разве это не одна и та же сеть?
Нет. Heartbeat — это сигнал VMware Tools изнутри гостевой ОС, который доходит до Veeam через гипервизор и vSphere API, сеть между сервером Veeam и изолированной лабораторией в нём не участвует. Ping test отправляется именно с backup server на masquerade-адрес машины и требует рабочего маршрута к masquerade-подсети через proxy appliance. Поэтому переезд сервера Veeam в другой VLAN ломает второй тест и никак не влияет на первый.
Можно ли просто прописать маршрут на L3-коммутаторе и не трогать лабораторию?
Можно, и это рабочий обход: маршрут в masquerade-подсеть через продуктивный адрес proxy appliance на каждом L3-хопе плюс маршрут на самом сервере Veeam через его шлюз. Veeam такой вариант допускает явно. Но это конструкция, которая не описана нигде, кроме вашей головы: при добавлении второй лаборатории появится вторая masquerade-подсеть, а при чистке статики на ядре маршрут снесут как мусорный. Я использую этот путь как временное решение до планового окна.
Почему нельзя просто поменять продуктивную сеть у существующей виртуальной лаборатории?
Потому что мастер этого не позволяет: продуктивная сеть фиксируется в момент создания лаборатории и после не редактируется. Единственный штатный путь — создать лабораторию заново с нужной продуктивной сетью и переключить на неё SureBackup-задание. Занимает это около получаса, но требует планового окна, поэтому лучше знать про ограничение до начала работ по сегментации.
Маршрут есть, один хоп до appliance, а ping всё равно timed out. Что дальше?
Дальше — гостевой firewall. Доменная машина, запущенная в лаборатории без контроллера домена в application group, не находит домен и переключает профиль сети на Public, где входящий ICMP заблокирован по умолчанию. Правильное лечение — добавить в application group контроллер домена с ролью Domain Controller (Authoritative Restore). Обходное — включить в гостевой ОС правило File and Printer Sharing (Echo Request - ICMPv4-In) и обязательно сделать новый бэкап, иначе правило в лабораторию не попадёт.
Как проверить маршрут, если задание уже завершилось?
Никак — маршрут непостоянный и удаляется при выключении лаборатории. Проверять нужно на живой лаборатории: запустить задание, дождаться шага Starting virtual lab routing engine и выполнить route print на Windows или ip route show на Linux. Если машина уже упала, поднимите её в режиме troubleshooting из статистики задания — она вместе с application group останется включённой, пока вы вручную не остановите сессию.
Стоит ли отключить ping test, если он мешает и мы знаем, что дело в сети?
Не стоит. Вместе с ping перестанет работать и application test, он тоже стучится с backup server, и от полноценной проверки восстановления останется только факт загрузки ОС. Если сеть починить прямо сейчас нельзя, честнее временно исключить конкретные машины из задания с записью в журнале работ, чем выключить тест и получить вечно зелёный отчёт, который ничего не проверяет.
Источники
- Veeam Backup & Replication 13 User Guide — IP Masquerading — Раздел SureBackup → IP Masquerading: пример 172.16.1.13 → 172.18.1.13, автоматическое создание непостоянного статического маршрута на backup server при старте лаборатории, роль proxy appliance как NAT. Страница обновлена 29.04.2025, контент применим к билду 13.1.1.18. https://helpcenter.veeam.com/docs/vbr/userguide/surebackup_ip_masquerading.html?ver=13
- Veeam Backup & Replication 13 User Guide — Step 5. Set Up Proxy Appliance — Прямое требование: при адресе appliance из сети backup server маршрут добавляется автоматически, при адресе из другой сети маршрут нужно прописывать на маршрутизаторе вручную, иначе тесты и скрипты провалятся; продуктивную сеть нельзя изменить после создания лаборатории. Обновлено 02.09.2025. https://helpcenter.veeam.com/docs/vbr/userguide/vlab_proxy_vm.html?ver=13
- Veeam Backup & Replication 13 User Guide — Step 8. Specify Network Settings — Настройка vNIC изолированных сетей, автоматический подбор masquerade-адреса и возможность его изменить, галка Route network traffic between vNICs, ограничения на адресацию vNIC и NIC teaming. Обновлено 02.06.2026. https://helpcenter.veeam.com/docs/vbr/userguide/vlab_net_settings_vm.html?ver=13
- Veeam KB1067 — SureBackup Ping Test Timed Out — Шесть типовых причин отказа ping test: маршрутизатор между сервером Veeam и лабораторией (проверка через tracert, ожидается один хоп), неверный vNIC изолированной сети, гостевой firewall и профиль Public, переезд appliance на другой хост, несозданный статический маршрут (проверка route print после шага Starting virtual lab routing engine), дубликаты VMXNET3. Опубликовано 19.07.2011, последняя правка 01.09.2026. https://www.veeam.com/kb1067
- Veeam Backup & Replication 13 User Guide — Predefined Tests / Static IP Mapping — Механика тестов: heartbeat через сигнал VMware Tools, ping-запросы отправляются с backup server, application test ждёт старта приложений и запускает скрипт проверки; без VMware Tools heartbeat и ping пропускаются; отдельно — static IP mapping с примером 192.168.1.20 → 192.168.1.99. https://helpcenter.veeam.com/docs/vbr/userguide/predefined_tests.html?ver=13 и https://helpcenter.veeam.com/docs/vbr/userguide/surebackup_ip_mapping.html?ver=13
- Veeam KB4353 — Error: "Virtual lab supports maximum of 9 networks." — Proxy appliance — ВМ с максимум 10 vNIC, один занят продуктивной сетью, поэтому на лабораторию не более 9 изолированных сетей; при нехватке — несколько лабораторий. Применимо к Veeam Backup & Replication 5.0–13.1. https://www.veeam.com/kb4353