
Свой раннер зелёный, а GitHub Actions не отдаёт ему job: как деплоить, когда лежит control plane
Self-hosted runner не делает ваш CI независимым: очередь, назначение job, секреты и токены остаются в облаке GitHub. Когда там сбой, свой раннер висит Idle, а откат стоит в Queued. Разбираю, что именно живёт у GitHub, как это выглядело в августе 2026 и как собрать аварийный путь деплоя.
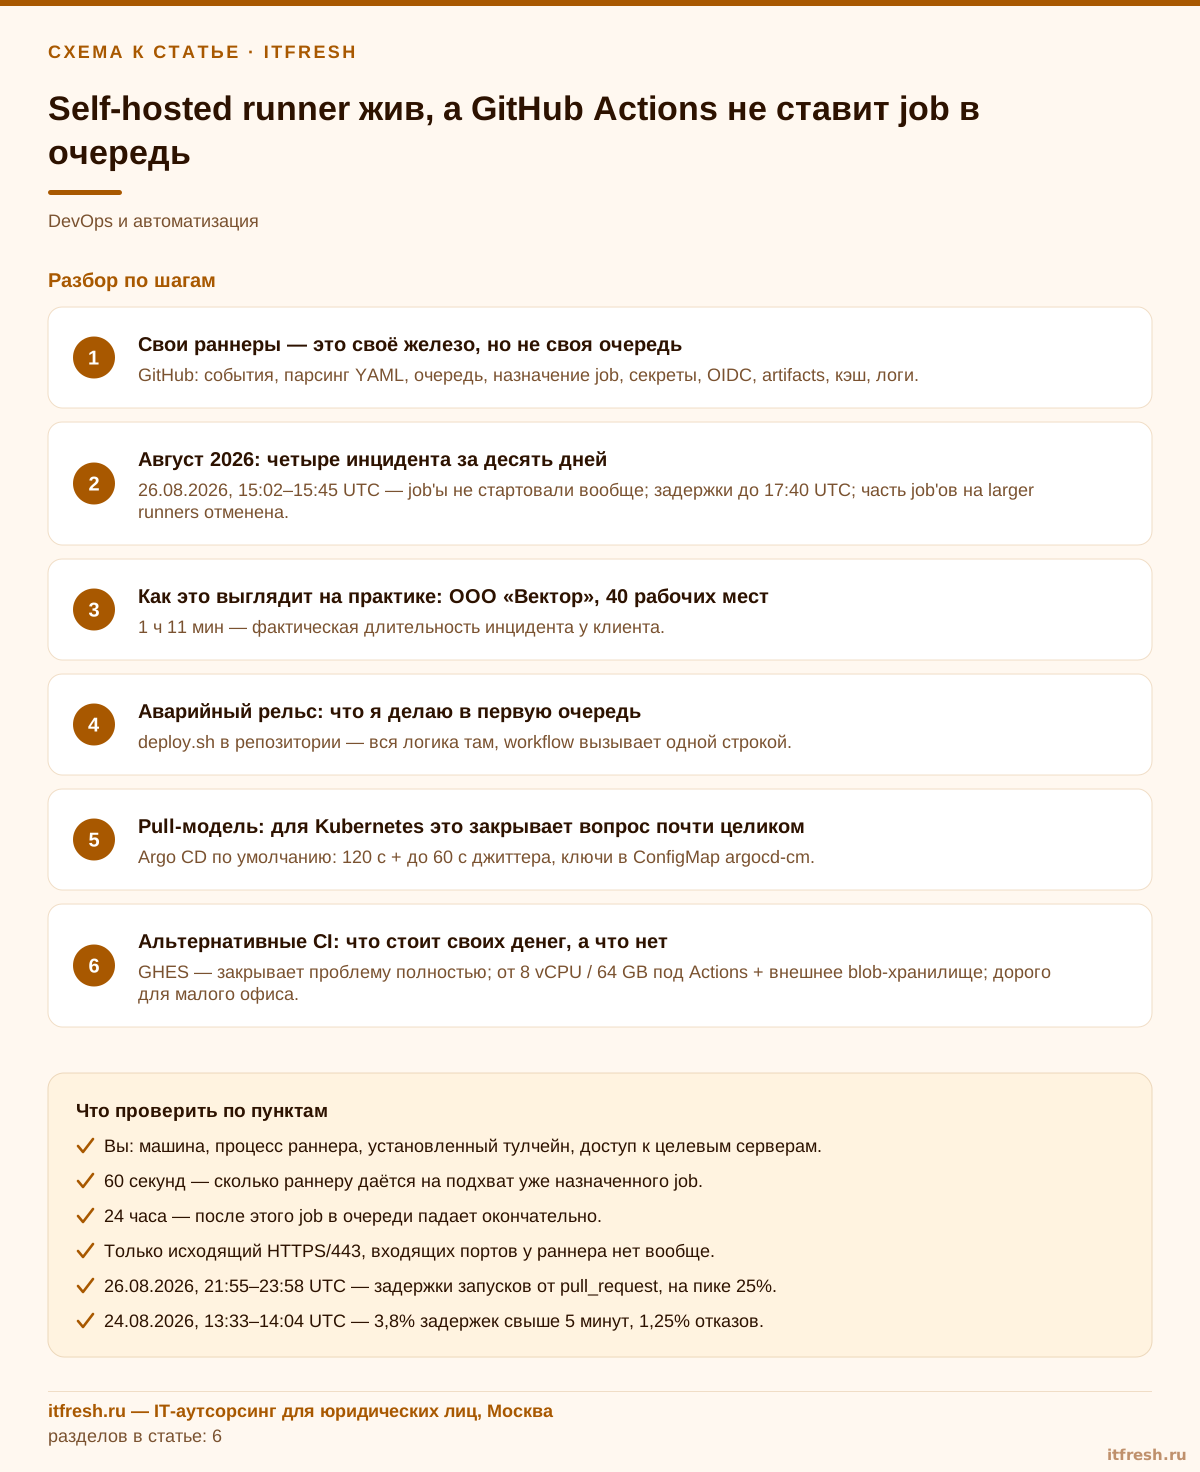
Свои раннеры — это своё железо, но не своя очередь
Когда мы в АйТи-Фреш берём на сопровождение CI/CD или занимаемся внедрением open-source инструментов разработки, первой приходится разбирать одну иллюзию. Звучит она так: «мы вынесли сборку на свои серверы, значит, от GitHub мы не зависим». Зависите, и сильнее, чем кажется. Раннер — это исполнитель, а не планировщик. Он не читает ваш репозиторий, не разбирает workflow-файл, не решает, какой job запустить и в каком порядке. Всё это делает control plane GitHub: он получает событие (push, pull_request, workflow_dispatch), разбирает YAML, строит граф job'ов, вычисляет матрицы и условия if, и только потом ищет свободного исполнителя.
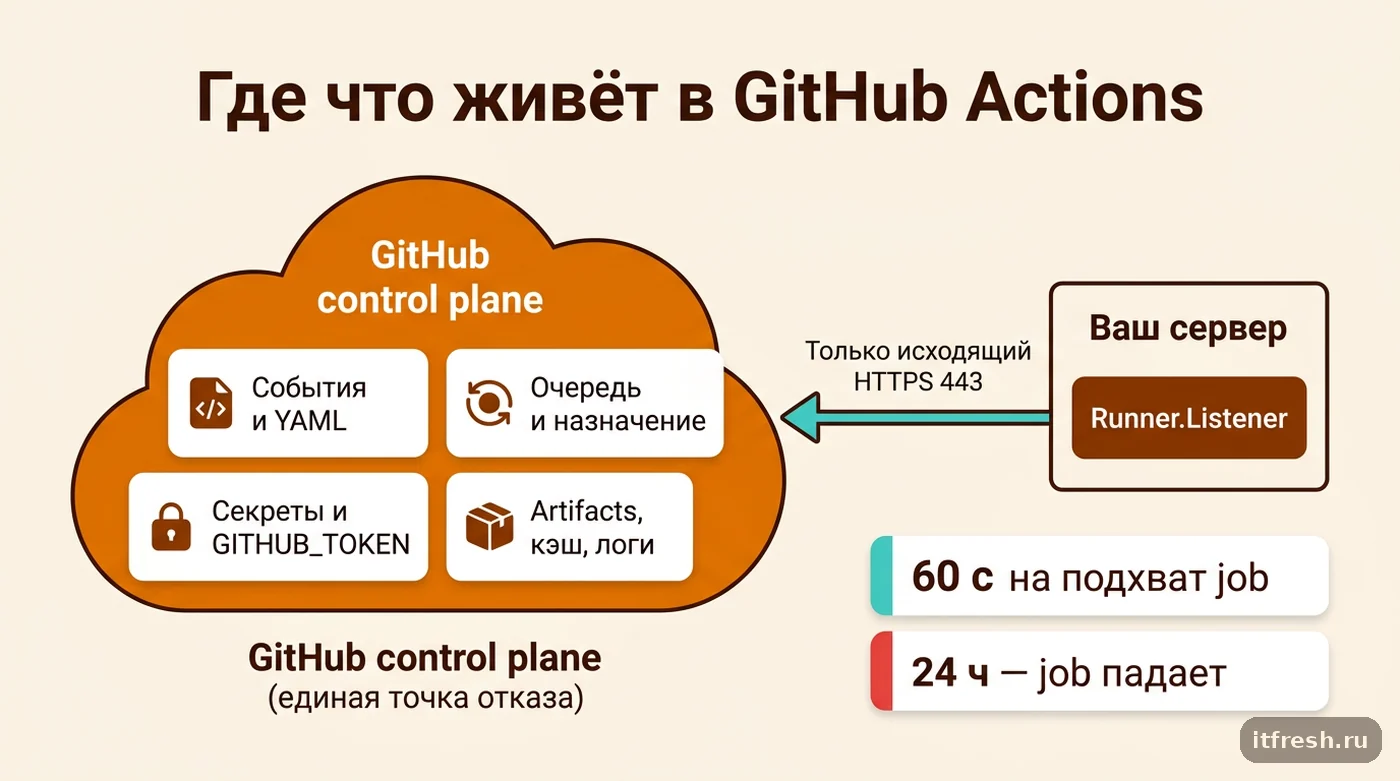
В справочнике по self-hosted-раннерам это описано без двусмысленностей. Раздел Routing precedence: «If GitHub finds an online and idle runner that matches the job's runs-on labels and groups, the job is then assigned and sent to the runner». Обратите внимание на направление: job назначается раннеру и отправляется ему. Дальше идут два числа, которые стоит запомнить наизусть. Первое: если раннер не подхватил назначенный job за 60 секунд, job возвращается в очередь и ищется новый исполнитель. Второе: если job провисел в очереди больше 24 часов, он падает. То есть у вашего аварийного деплоя есть жёсткий потолок ожидания, после которого он просто умрёт с ошибкой.
Сеть тоже односторонняя, и это добавляет хрупкости. Как раннер ставится и регистрируется, я подробно разбирал в статье про self-hosted runners для GitHub Actions, здесь важна именно связь. Требование в документации: «The host machine must be able to make outbound HTTPS connections over port 443». Никаких входящих портов у раннера нет — он сам держит исходящее соединение и ждёт назначения. Красиво с точки зрения безопасности, но означает, что вы физически не можете «подсунуть» раннеру задачу в обход GitHub: у него нет API, куда постучаться. Список доменов, без которых он не работает, длинный: github.com, api.github.com, *.actions.githubusercontent.com, codeload.github.com, results-receiver.actions.githubusercontent.com, *.blob.core.windows.net, objects.githubusercontent.com и дальше по функциям — пакеты, LFS, релиз-ассеты.
Разложите теперь, что у вас реально в облаке: приём событий, парсинг workflow, очередь, назначение job, выдача GITHUB_TOKEN, расшифровка секретов, OIDC-токены для облачных провайдеров, загрузка artifacts, кэш actions/cache, приём логов. Ваше — только CPU, диск и сеть машины, на которой крутится процесс Runner.Listener. Актуальная версия раннера на сентябрь 2026 — v2.337.0 от 26 августа. Она ничего в этой схеме не меняет и не может изменить: автономный режим в архитектуру не заложен.
- GitHub: события, парсинг YAML, очередь, назначение job, секреты, OIDC, artifacts, кэш, логи.
- Вы: машина, процесс раннера, установленный тулчейн, доступ к целевым серверам.
- 60 секунд — сколько раннеру даётся на подхват уже назначенного job.
- 24 часа — после этого job в очереди падает окончательно.
- Только исходящий HTTPS/443, входящих портов у раннера нет вообще.
Август 2026: что было с GitHub Actions
Когда я говорю клиентам, что control plane GitHub — единая точка отказа их деплоя, обычно слышу: «ну падает же раз в пятилетку». Открываем GitHub Status и официальный отчёт о доступности за август 2026 и считаем.
6 августа, начиная с 15:22 UTC, — самый длинный эпизод месяца: 10 часов 42 минуты деградации после выкатки в самих Actions, которая перегрузила service mesh. По данным GitHub, как минимум у 74 организаций workflow не запускались вовсе. 17 августа с 13:40 UTC больше семи с половиной часов проблемы на входе в платформу: по отчёту, 56,07 % запросов фронт-двери к затронутым сервисам завершались ошибкой или шли медленно — задело API, аутентификацию и связанные сервисы. 18 августа отдельно деградировали larger runners: клиенты не могли запускать на них job'ы.
26 августа с 15:02 до 15:45 UTC job'ы Actions не стартовали вообще. Формулировка на статус-странице: «Actions jobs failed to start». Ещё около двух часов, до 17:40 UTC, запуски задерживались больше чем на 5 минут, пока система разгребала накопившуюся нагрузку. Причина — насыщение записи в primary базы данных сервиса, который обрабатывает триггеры workflow; failover на реплику полностью не помог. В отчёте о доступности это сформулировано жёстко: в пике больше одного из пяти запусков в минуту падал или сильно задерживался. Поздно вечером того же дня был ещё один, более мелкий инцидент с задержками запусков.
Итого за месяц — четыре события, задевших Actions, два из них с полной остановкой запуска job'ов для части клиентов. Проценты выглядят мягко, пока это не ваш job. Если у вас три-четыре деплоя в неделю, вероятность попасть под окно невелика. Но окно, в которое вы попадёте, — это ровно тот момент, когда вы срочно чините другой инцидент и вам нужно выкатить фикс. Аварии любят совпадать: у меня это правило подтверждается годами.
- 06.08.2026, с 15:22 UTC — 10 ч 42 мин деградации, у 74+ организаций workflow не стартовали.
- 17.08.2026, с 13:40 UTC — 7 ч 35 мин, 56,07 % запросов к затронутым сервисам с ошибкой или медленно.
- 18.08.2026 — larger runners не запускали job'ы.
- 26.08.2026, 15:02–15:45 UTC — job'ы не стартовали вообще; задержки до 17:40 UTC.
Как это выглядит на практике: откат, который не уехал
Разбор из практики. Клиент — страховой брокер «СтрахКонсалт», 38 рабочих мест, свой личный кабинет для клиентов и агентов на PHP 8.3 (Laravel) в Docker. Инфраструктура: два хоста приложения и один хост БД в арендованной стойке, оркестрации нет, деплой — docker compose. CI на GitHub Actions: приватный репозиторий, два self-hosted раннера на Ubuntu 24.04 LTS (2 vCPU / 4 GB), сервис раннера через systemd, метки self-hosted, linux, x64, prod-deploy. Выкладка — вручную, через workflow_dispatch с выбором тега.
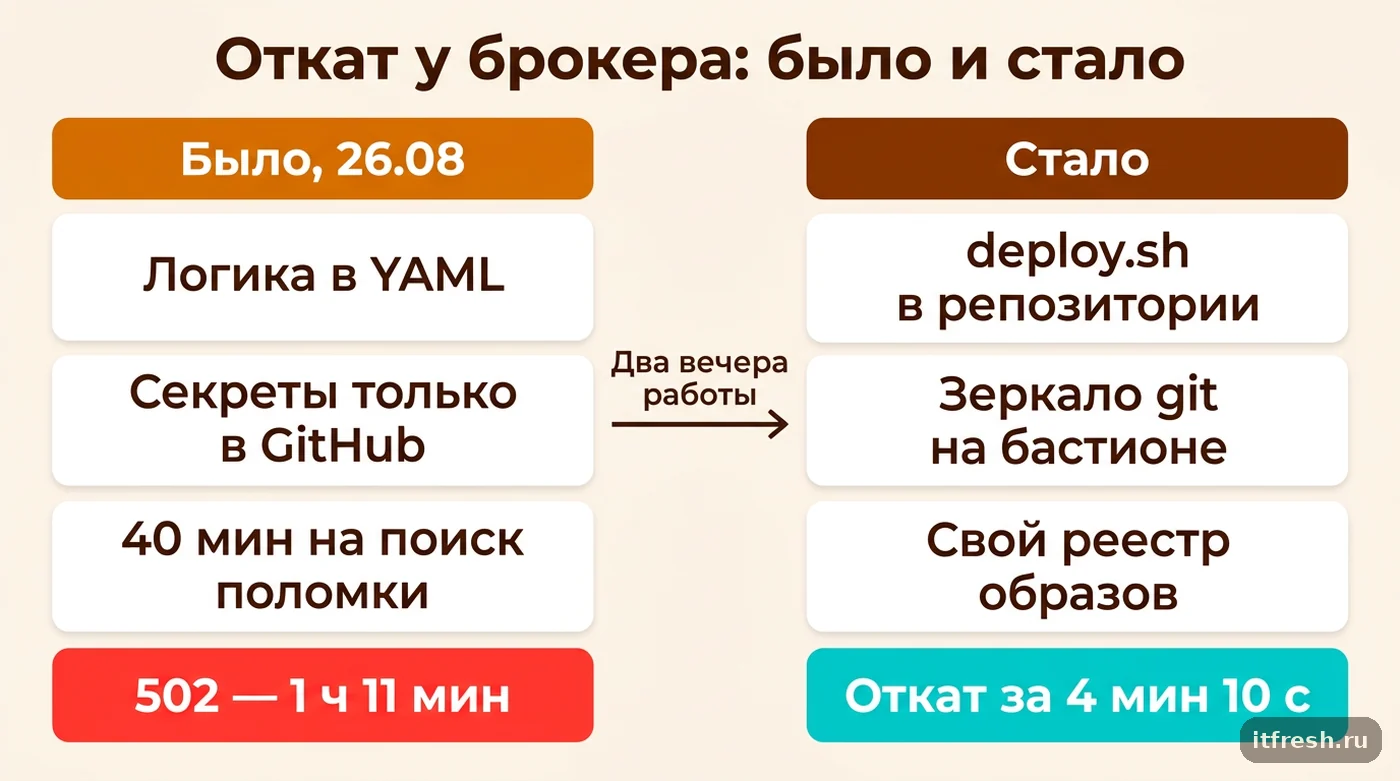
26 августа около 18:10 по Москве (15:10 UTC) миграция схемы БД в релизе положила расчёт полисов в личном кабинете: половина страниц отдавала 502. Дежурный делает то, что положено, — идёт в Actions и запускает deploy.yml с предыдущим тегом. Job уходит в Queued. Оба раннера в панели Idle. Метки совпадают, никто ничего не менял. Через пять минут в рабочем чате начинается классика: «перезапусти раннер», «может, метки слетели», «переустанови сервис». Раннер перезапустили дважды, что, разумеется, ничего не изменило — он и так был подключен. Первые сорок минут ушли не на восстановление, а на диагностику собственной инфраструктуры, которая была полностью исправна.
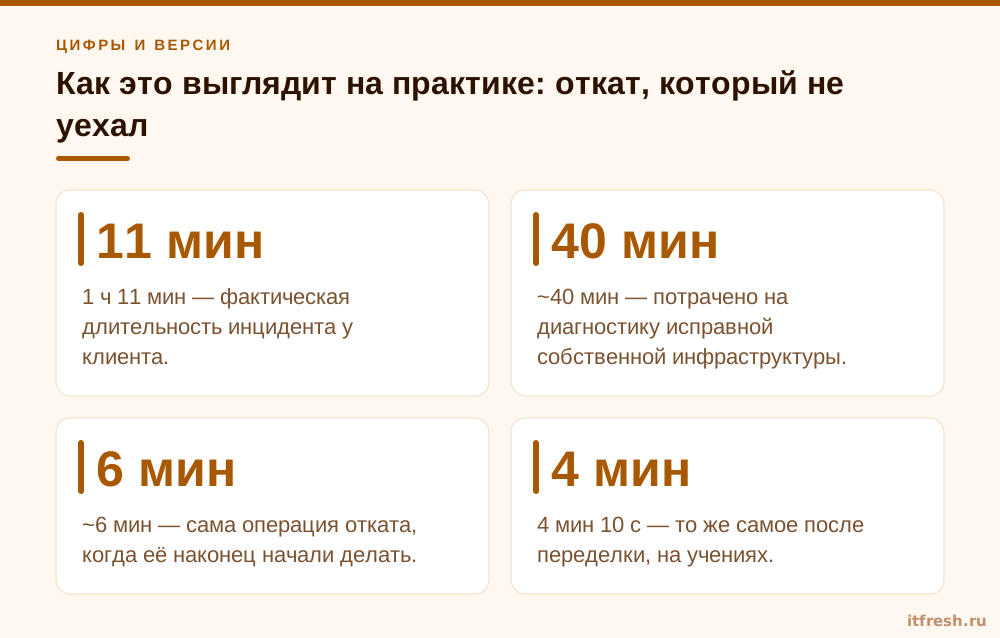
Что реально помогло: я открыл githubstatus.com, увидел активный инцидент по Actions и сказал коротко — CI сегодня не участвует, деплоим руками. Дальше выяснилось интересное. Скрипта деплоя как такового не существовало: вся логика жила в YAML — восемь шагов, docker login в ghcr.io через GITHUB_TOKEN, docker compose pull, миграции, health-check, уведомление в чат дежурных. Токен для ghcr выдаётся control plane'ом GitHub, то есть тем же самым, который лежал. Переменные окружения — в GitHub Secrets, а значит, тоже недоступны. Ручной откат в итоге занял ещё 27 минут: собирали команды глазами из YAML, вспоминали пароль от реестра, руками писали .env. Суммарно 502 отдавались 1 час 11 минут, из которых на собственно откат ушло около 6 минут. Остальное — «мы не знали, что делать без кнопки».
Дальше мы разбирали это спокойно и переделали контур за два вечера. Логику деплоя вынесли в bash-скрипт в самом репозитории, workflow стал тонкой обёрткой на три строки. Подняли зеркало репозитория на бастионе. Сделали offline-копию секретов. Написали runbook на одну страницу. Через две недели проверили учениями: тот же откат запасным путём — 4 минуты 10 секунд от команды в чате до health-check ОК, без единого обращения к GitHub.
- 1 ч 11 мин — фактическая длительность инцидента у клиента.
- ~40 мин — потрачено на диагностику исправной собственной инфраструктуры.
- ~6 мин — сама операция отката, когда её наконец начали делать.
- 4 мин 10 с — то же самое после переделки, на учениях.
- 0 руб. дополнительных лицензий: всё решилось скриптом, зеркалом и регламентом.
Аварийный рельс: что я делаю в первую очередь
Моя позиция простая и, наверное, скучная: не надо строить второй CI. Для компании до 50 рабочих мест второй полноценный пайплайн — это система, которую никто не сопровождает, и через полгода она протухнет ровно к моменту, когда понадобится. Вместо этого я делаю аварийный рельс — минимальный путь выкатки, который физически не может зависеть от GitHub. Он состоит из четырёх вещей, и по важности они идут именно в этом порядке.
Первое и главное — вся логика деплоя живёт в идемпотентном скрипте в репозитории, а workflow только его вызывает. Это правило окупается даже без всяких аварий: одна и та же команда работает из CI, с бастиона и с ноутбука инженера. Никаких многошаговых YAML с расползшейся по шагам логикой. Скелет, который я ставлю:
#!/usr/bin/env bash
# deploy.sh — единственная точка выкатки. Работает из CI и с бастиона.
set -Eeuo pipefail

TAG="${1:?usage: deploy.sh <tag>}"
ENV_FILE="${ENV_FILE:-/opt/portal/.env}"
COMPOSE="/opt/portal/docker-compose.yml"
REGISTRY="${REGISTRY:-registry.example.com}"

[[ -r "$ENV_FILE" ]] || { echo "нет $ENV_FILE"; exit 2; }

echo "[1/5] pull ${REGISTRY}/app:${TAG}"
docker pull "${REGISTRY}/app:${TAG}"

echo "[2/5] migrate"
docker run --rm --env-file "$ENV_FILE" "${REGISTRY}/app:${TAG}" php artisan migrate --force

echo "[3/5] up"
APP_TAG="$TAG" docker compose -f "$COMPOSE" --env-file "$ENV_FILE" up -d

echo "[4/5] health"
for i in {1..30}; do
  curl -fsS --max-time 3 http://127.0.0.1:8080/healthz && break
  sleep 2
  [[ $i -eq 30 ]] && { echo "health FAILED"; exit 3; }
done

echo "[5/5] ok: $TAG"
Второе — зеркало репозитория на своей стороне. Bare-зеркало на бастионе (один раз git clone --mirror, дальше обновление по таймеру) стоит ноль рублей и снимает зависимость от доступности github.com для самого кода. Раз в пять минут по таймеру — и на бастионе всегда лежит актуальный main с тегами. Третье — offline-копия секретов: не выгрузка из GitHub Secrets (её не существует, оттуда нельзя прочитать), а параллельно поддерживаемая запись в вашем хранилище паролей плюс подготовленный .env на бастионе с правами 0600 и владельцем deploy. Четвёртое — свой реестр образов: Harbor или простой registry:2, куда CI пушит копию каждого образа. Если ghcr.io и GITHUB_TOKEN недоступны, вам нужен образ, который лежит у вас.
# /etc/systemd/system/repo-mirror.service
[Unit]
Description=Mirror app repo from GitHub to bastion
After=network-online.target

[Service]
Type=oneshot
User=git
ExecStart=/usr/bin/git --git-dir=/srv/git/app.git remote update --prune

# /etc/systemd/system/repo-mirror.timer
[Unit]
Description=Repo mirror every 5 minutes

[Timer]
OnBootSec=2min
OnUnitActiveSec=5min
Persistent=true

[Install]
WantedBy=timers.target- deploy.sh в репозитории — вся логика там, workflow вызывает одной строкой.
- Bare-зеркало репозитория на бастионе, обновление по systemd-таймеру каждые 5 минут.
- Секреты продублированы в собственном хранилище + готовый .env на бастионе (0600).
- Свой реестр образов, куда CI пушит копию каждого тега.
- Runbook на одну страницу: как выкатить и как откатить без GitHub.
Pull-модель: для Kubernetes это закрывает вопрос почти целиком
Если у вас Kubernetes, есть решение красивее скриптов: перевернуть направление деплоя. В push-модели CI сам ходит в кластер и применяет манифесты — значит, без CI выкатки нет. В pull-модели кластер сам периодически смотрит в git и приводит себя к описанному состоянию. Argo CD (актуальная линейка 3.5.x) и Flux (2.9.x) работают именно так — подробнее о такой схеме я писал в разборе GitOps-доставки через FluxCD. Роль Actions сокращается до «собрать образ и поменять тег в манифесте», а собственно раскатку делает контроллер внутри вашего периметра.
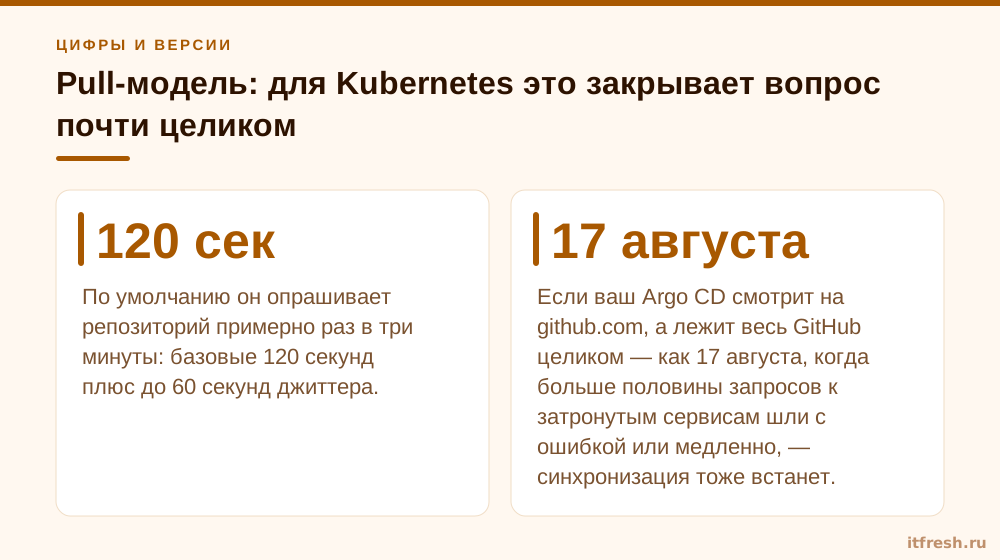
Практический эффект: если Actions лежит, вы собираете образ локально, пушите в свой реестр, делаете коммит с новым тегом в манифест — и Argo CD подхватывает изменение сам. По умолчанию он опрашивает репозиторий примерно раз в три минуты: базовые 120 секунд плюс до 60 секунд джиттера. Управляется это ключами timeout.reconciliation и timeout.reconciliation.jitter в ConfigMap argocd-cm. В аварийной ситуации можно не ждать — принудительный refresh через argocd app get --refresh или кнопку Sync в UI даёт результат сразу.
# аварийная выкатка при недоступном GitHub Actions
docker build -t registry.example.com/app:v1.42.3 .
docker push registry.example.com/app:v1.42.3

# правим тег в манифесте и коммитим в зеркало
yq -i '.spec.template.spec.containers[0].image = "registry.example.com/app:v1.42.3"' \
  deploy/app-deployment.yaml
git commit -am "hotfix: rollback to v1.42.3" && git push mirror main

# не ждём 3 минуты — дёргаем синхронизацию руками
argocd app get portal --refresh
argocd app sync portal --prune=false
И сразу честная оговорка, о которой любят умалчивать в статьях про GitOps. Pull-модель убирает зависимость от очереди Actions, но не от самого git-хостинга. Если ваш Argo CD смотрит на github.com, а лежит весь GitHub целиком — как 17 августа, когда больше половины запросов к затронутым сервисам шли с ошибкой или медленно, — синхронизация тоже встанет. Поэтому источником для аварийного контура должно быть ваше зеркало, а в Application либо второй remote, либо заранее подготовленная процедура переключения repoURL. Проверьте её на учениях: у половины команд, которым я это ставил, при первой попытке не хватало credentials на зеркало в argocd-repo-server.
- Argo CD по умолчанию: 120 с + до 60 с джиттера, ключи в ConfigMap argocd-cm.
- Принудительная синхронизация — argocd app get --refresh, ждать интервал не нужно.
- Flux 2.9.x — та же логика через interval в GitRepository/Kustomization.
- Источник для аварии — своё зеркало, не github.com напрямую.
- Credentials на зеркало должны быть заведены в контроллере заранее.
Альтернативные CI: что стоит своих денег, а что нет
Регулярно спрашивают: может, просто съехать с GitHub Actions или поднять запасной CI? Разберу варианты честно, с ценой владения, потому что для компании до 50 рабочих мест она решает всё.
GitHub Enterprise Server даёт собственный control plane внутри периметра — это единственный вариант, который закрывает проблему полностью и без компромиссов по совместимости. Цена вопроса: минимум 8 vCPU и 64 GB памяти только под Actions, обязательное внешнее blob-хранилище (Azure Blob, Amazon S3, Google Cloud Storage или S3-совместимый MinIO), причём одновременно поддерживается ровно один провайдер. Плюс лицензии и регулярные обновления инстанса. Для организации на 40 рабочих мест это несоразмерно: вы получите вторую инфраструктуру, которую надо администрировать, ради устранения нескольких часов простоя в квартал.
Forgejo (ветка 16.0.x) с forgejo-runner (13.x) и Gitea (1.27.x) реализуют почти совместимый синтаксис Actions и поднимаются на двух ядрах и паре гигабайт памяти. Как холодный резерв — рабочая идея, особенно если у вас простые workflow: собрать, протестировать, задеплоить. Оговорки существенные: совместимость не стопроцентная, часть actions/* ведёт себя иначе, ARC там нет, кэш и артефакты устроены по-своему. Держать такой резерв имеет смысл только если вы прогоняете через него сборку хотя бы раз в неделю — иначе он тихо разъедется с основным пайплайном. GitLab CE с gitlab-runner 19.x — полноценная альтернатива со своим control plane, но это переезд, а не резерв: другой синтаксис, другая экосистема, месяцы работы.
Отдельно про act (0.2.89), который часто предлагают как аварийный вариант. Не надо. Это инструмент локальной отладки workflow: он читает .github/workflows и гоняет шаги в Docker. Ни секретов из GitHub, ни OIDC, ни полной поддержки фич — в документации прямо есть раздел про неподдерживаемую функциональность. Проверить синтаксис перед пушем — отлично. Выкатывать прод в разгар аварии — категорически нет. Для совсем простых сборок есть и лёгкий self-hosted пайплайн на Drone CI, но и это переезд со своим синтаксисом, а не запасной путь. Мой практический вывод: для 20–50 рабочих мест правильный ответ не «второй CI», а скрипт, зеркало, свой реестр и регламент. Дёшево, не гниёт, работает в первый же раз.
- GHES — закрывает проблему полностью; от 8 vCPU / 64 GB под Actions + внешнее blob-хранилище; дорого для малого офиса.
- Forgejo 16.0.x / Gitea 1.27.x + forgejo-runner 13.x — дешёвый холодный резерв, совместимость неполная.
- GitLab CE + gitlab-runner 19.x — свой control plane, но это миграция, а не запасной путь.
- Woodpecker 3.18.x — лёгкий вариант, если вы готовы переписать пайплайны.
- act 0.2.89 — только локальная отладка, для аварийного деплоя не годится.
Учения и мониторинг: как проверить, что рельс живой
Любая аварийная схема, которую не проверяли, не работает. Это не пафос, это статистика: у меня ни разу не было, чтобы первые учения прошли без сюрприза. То ключа нет у дежурного, то .env устарел на три релиза, то доступ к своему реестру был выдан только сервисному аккаунту CI. Поэтому раз в квартал — game day, полчаса времени, реальная выкатка запасным путём.
Сценарий простой: на раннерах закрываем исходящий доступ к GitHub и пробуем выкатить релиз. Всё, что сломается, — это ваш список задач на следующую неделю. Скрипт ниже блокирует только текущие A-записи трёх доменов — для учений этого хватает; если нужна полная изоляция, берите диапазоны из https://api.github.com/meta. Замерьте время от команды в чате до health-check ОК, запишите в runbook, в следующий раз сравните.
# учения: раннер теряет control plane (nftables, Ubuntu 24.04)
sudo nft add table inet gameday
sudo nft add chain inet gameday out '{ type filter hook output priority 0; }'
for h in github.com api.github.com codeload.github.com; do
  for ip in $(getent ahostsv4 $h | awk '{print $1}' | sort -u); do
    sudo nft add rule inet gameday out ip daddr $ip drop
  done
done

# после учений
sudo nft delete table inet gameday
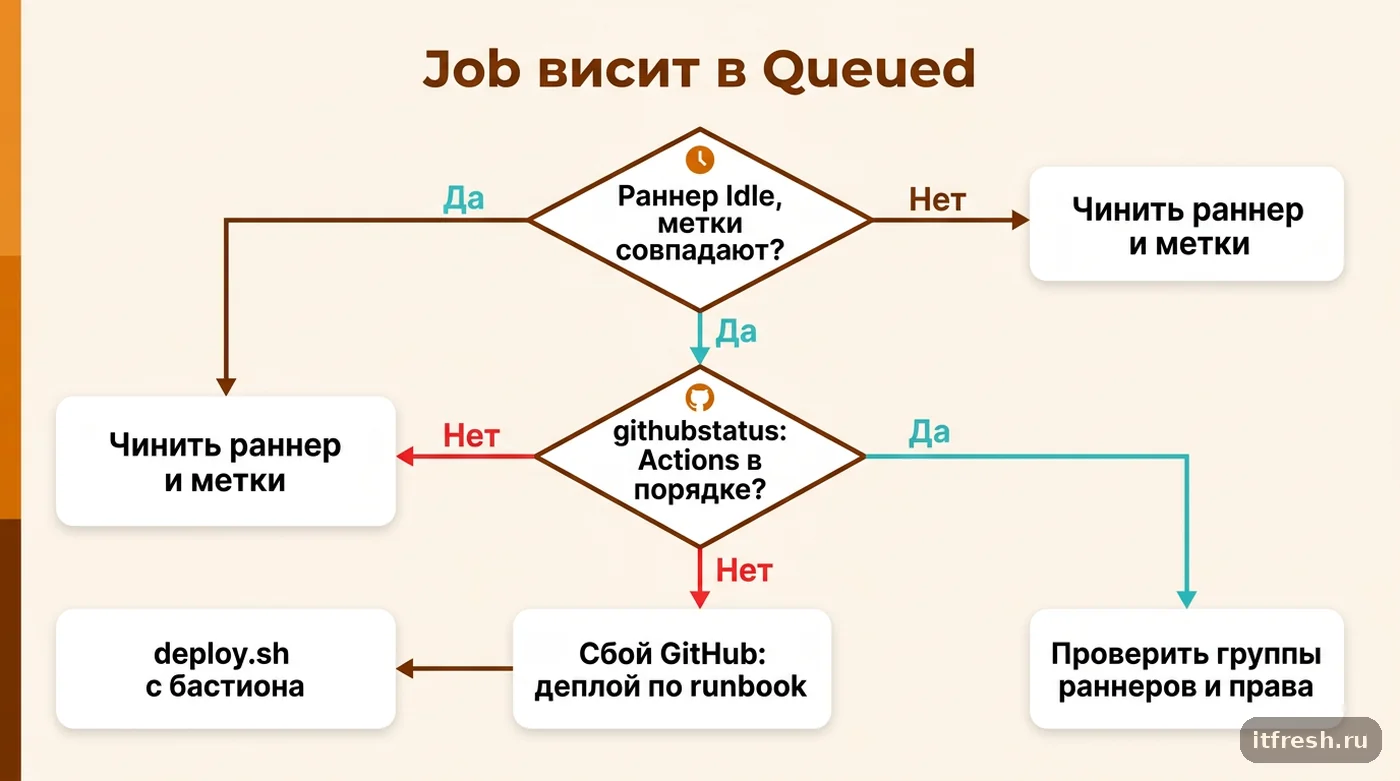
Второе — мониторинг, который отличает «сломались мы» от «сломался GitHub». Статус GitHub отдаётся машиночитаемо, простая проверка в Zabbix или скрипт по таймеру с алертом в чат дежурных закрывает вопрос за полчаса работы. Когда дежурный видит в чате «GitHub Actions: major outage» одновременно с зависшим job'ом, он не тратит сорок минут на перезапуск исправного раннера — как это было у «СтрахКонсалта».
#!/usr/bin/env bash
# github-status-check.sh — в cron каждые 5 минут
set -euo pipefail
J=$(curl -fsS --max-time 10 https://www.githubstatus.com/api/v2/components.json)
ST=$(printf '%s' "$J" | jq -r '.components[] | select(.name=="Actions") | .status')
if [[ "$ST" != "operational" ]]; then
  echo "GitHub Actions status: $ST"   # -> отправить алерт в чат дежурных / Zabbix
  exit 1
fi
И о том, на что можно спокойно забить. Не надо дублировать в аварийном контуре тесты, линтеры и сборку документации — при аварии вам нужно выкатить проверенный артефакт, а не пересобрать мир. Не надо поднимать GHES ради часа простоя в квартал. Не надо писать сложную автоматику переключения между CI: в момент аварии человек, читающий одностраничный runbook, надёжнее любого хитрого фолбэка, который никто не отлаживал.
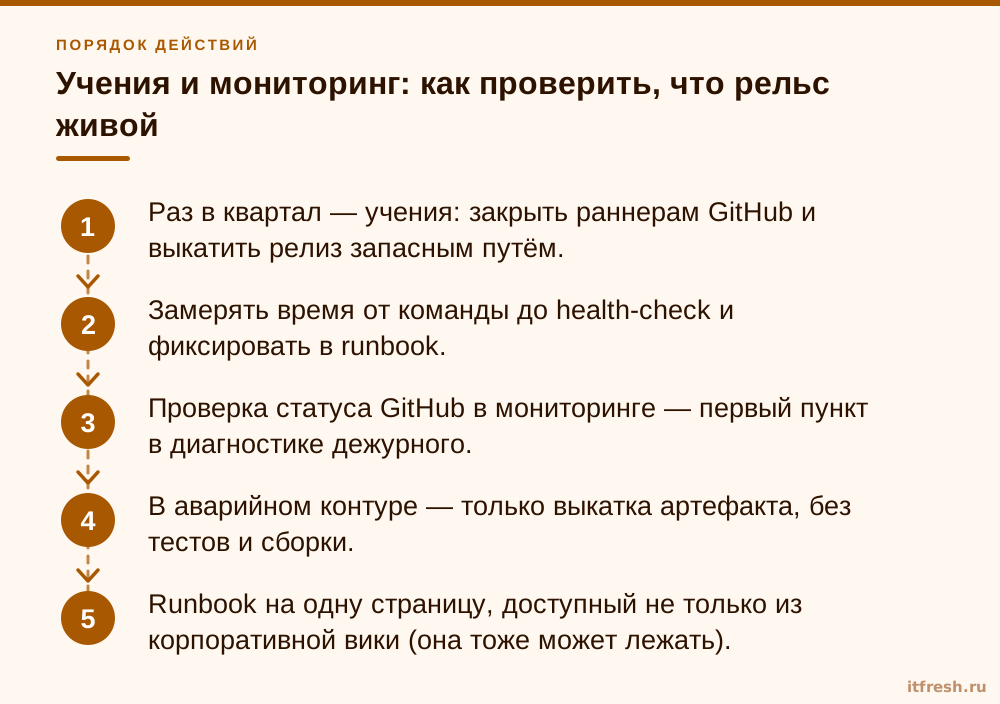
- Раз в квартал — учения: закрыть раннерам GitHub и выкатить релиз запасным путём.
- Замерять время от команды до health-check и фиксировать в runbook.
- Проверка статуса GitHub в мониторинге — первый пункт в диагностике дежурного.
- В аварийном контуре — только выкатка артефакта, без тестов и сборки.
- Runbook на одну страницу, доступный не только из корпоративной вики (она тоже может лежать).
Частые вопросы
Почему job висит в Queued, если раннер в панели Idle и метки совпадают?
Потому что решение о назначении принимает GitHub, а не раннер. Если сервис, отвечающий за обработку триггеров workflow и назначение раннеров, деградирует, job не будет отдан вашему исполнителю, каким бы свободным он ни был. Сначала проверьте githubstatus.com и только потом трогайте раннер. Помните про потолок: если job провисит в очереди больше 24 часов, он упадёт.
Поможет ли Actions Runner Controller или автомасштабирование?
Нет. Listener ARC сам обращается к GitHub за назначениями job'ов, поэтому при недоступном control plane он просто не получает, что масштабировать. ARC решает задачу эластичности под нагрузкой и утилизации ресурсов, а не задачу автономности от GitHub.
Можно ли как-то отдать задачу раннеру напрямую, минуя GitHub?
Штатных способов нет. Раннер работает только на исходящих HTTPS-соединениях по 443 и не слушает входящие порты — у него физически нет API, куда можно постучаться. Именно поэтому аварийный путь строится не «вокруг раннера», а параллельно ему: тот же скрипт деплоя, запущенный по SSH с бастиона.
Что дешевле для компании на 30–50 рабочих мест: GHES или запасной CI на Forgejo?
Ни то, ни другое, если задача — только пережить редкие сбои очереди. GHES требует минимум 8 vCPU и 64 GB под Actions плюс внешнее blob-хранилище, Forgejo дешевле, но неизбежно расходится с основным пайплайном, если через него не идёт регулярный трафик. Для этого масштаба дешевле и надёжнее: скрипт деплоя в репозитории, зеркало git, свой реестр образов и одностраничный runbook.
Как понять, что мы попали именно в сбой GitHub, а не сломали что-то у себя?
Поставьте в мониторинг проверку статуса компонента Actions через https://www.githubstatus.com/api/v2/components.json — пять строк на bash и cron раз в пять минут. Дежурный видит алерт одновременно с зависшим job'ом и не тратит время на перезапуск исправного раннера. Это единственная мера из всего списка, которую можно внедрить за полчаса.
GitOps через Argo CD полностью решает проблему?
Не полностью. Он снимает зависимость от очереди Actions: кластер сам тянет манифесты и синхронизируется каждые ~3 минуты. Но если Argo CD смотрит на github.com, а лежит GitHub целиком, синхронизация тоже встанет. Источником для аварийного контура должно быть собственное зеркало репозитория с заранее заведёнными credentials.
Источники
- GitHub Docs — Self-hosted runners reference — Routing precedence: job назначается и отправляется раннеру; 60 секунд на подхват, отказ после 24 часов в очереди; только исходящий HTTPS/443; список доменов. https://docs.github.com/en/actions/reference/runners/self-hosted-runners
- GitHub Blog — GitHub availability report: August 2026 — Инциденты 06.08 (10 ч 42 мин, 74+ организаций без запуска workflow), 17.08 (7 ч 35 мин, 56,07 % запросов), 26.08 (2 ч 50 мин, насыщение БД сервиса триггеров). https://github.blog/news-insights/company-news/github-availability-report-august-2026/
- actions/runner — релиз v2.337.0 — Версия и дата публикации (26.08.2026). https://github.com/actions/runner/releases/tag/v2.337.0
- GitHub Docs — Getting started with GitHub Actions for GitHub Enterprise Server — Минимум 8 vCPU и 64 GB под Actions, внешнее хранилище: Azure Blob, Amazon S3, Google Cloud Storage, S3-совместимый MinIO; одновременно только один провайдер. https://docs.github.com/en/enterprise-server@latest/admin/github-actions/getting-started-with-github-actions-for-your-enterprise/getting-started-with-github-actions-for-github-enterprise-server
- Argo CD — FAQ — Опрос git по умолчанию раз в ~3 минуты: 120 с + до 60 с джиттера, ключи timeout.reconciliation и timeout.reconciliation.jitter в argocd-cm. https://argo-cd.readthedocs.io/en/stable/faq/
- GitHub Status API — Машиночитаемый статус компонентов, включая Actions, для проверки в мониторинге. https://www.githubstatus.com/api/v2/components.json