
Как расширить память ESX 9.1 с помощью NVMe и пережить отказ SSD
Короткий ответ: для защищённого NVMe-уровня памяти в ESX 9.1 ставьте по два совместимых enterprise-SSD в каждый хост и включайте штатное программное зеркалирование — RAID-контроллер для этого не нужен. Но «дешёвой оперативки» из воздуха не будет: сначала надо измерить активную память, проверить, переживёт ли кластер вывод одного хоста, и подобрать действительно выносливые NVMe. Я, Евгений Семёнов, покажу расчёт, порядок включения в работающем кластере и результат на примере сервисного центра по ремонту телефонов «ТелефонСервис» на 36 рабочих мест — и честно скажу, когда малому бизнесу проще купить модули DDR.
Сразу отвечаю: нужны два NVMe на каждый хост
Если допустим отказ одного SSD, мой вариант — два NVMe одинаковой ёмкости на каждом ESX-хосте. Первый становится основным устройством Tier 1, второй — его программным зеркалом. Для типичного малого кластера из двух узлов потребуется четыре накопителя, а не два на весь кластер. Зеркало локальное: SSD одного сервера не страхует устройство соседнего. Ёмкости при этом не складываются: пара накопителей по 1,6 ТБ даёт максимум 1,6 ТБ защищённого пространства, а фактически используемый объём дополнительно ограничивает выбранное соотношение DRAM и NVMe.
Memory Tiering — не обычный swap и не datastore. ESX показывает виртуальным машинам объединённую логическую память: Tier 0 на DRAM и более медленный Tier 1 на локальном NVMe. Часто используемые страницы гипервизор старается держать в DRAM, холодные переносит на SSD и возвращает обратно при обращении. Память самого VMkernel остаётся в DRAM. Гостевой Windows или Linux ничего настраивать не нужно: он не знает, на каком уровне находится конкретная страница.
В ESX 9.1 я выбираю нативное программное зеркало, а NVMe отдаю гипервизору напрямую. В 9.0 Memory Tiering уже был полноценно поддерживаемой функцией (в 8.0 Update 3 он выходил как tech preview), но отказоустойчивость Tier 1 там можно было получить только аппаратным RAID — Tri-Mode-контроллером или Intel VROC. В 9.1, по официальному описанию VMware, зеркалирование выполняет сам гипервизор, а в профиле хоста указывается второй NVMe как mirror device. Поэтому отдельный RAID-контроллер ради Memory Tiering больше не оправдан. Это не запрет аппаратного RAID, а инженерный выбор: меньше драйверов, прошивок и промежуточных слоёв в самом чувствительном тракте.
Для компании на 30–50 рабочих мест вопрос стоит приземлённее, чем в презентациях про «в 4 раза больше памяти». Memory Tiering имеет смысл, если у вас уже есть два-три хоста на vSphere 9.1 под vCenter, слоты DIMM заняты, а расширение памяти означает замену всех модулей на более ёмкие. Если же сервер один и в нём есть свободные слоты, я почти всегда советую просто докупить DDR: это дешевле по трудозатратам, не требует enterprise-NVMe и не добавляет новый класс отказов.
- Один NVMe на хост — минимальная конфигурация без защиты от отказа устройства.
- Два NVMe на хост — основной и зеркальный накопители, защита от отказа одного SSD.
- Два хоста с зеркалом — четыре физических NVMe, три хоста — шесть.
- Полезная ёмкость зеркала равна ёмкости одного устройства, а не сумме пары.
- Один сервер со свободными слотами DIMM — обычно выгоднее добавить RAM, чем внедрять tiering.
Сначала считаю активную память, затем покупаю SSD
Я начинаю не с каталога накопителей, а с двухнедельной статистики Active Memory в часы пик. Сумма настроенной памяти виртуальных машин здесь почти бесполезна: ВМ с 32 ГБ может реально трогать 6 ГБ, а может непрерывно гонять все 32. В Performance Best Practices for vSphere 9.1 рекомендация такая: держать активную память не выше 50 % DRAM хоста; для части нагрузок производительность не страдает, пока показатель не подходит к 75 %, но проектировать на этой границе я не стану.
Рекомендуемое значение tier_size_pct — 100 %. Это означает Tier 1 объёмом до 100 % установленной DRAM: у хоста с 256 ГБ DRAM появляется ещё до 256 ГБ на NVMe, то есть около 512 ГБ логической памяти до учёта накладных расходов. В 9.0 тот же параметр задавался расширенной настройкой Mem.TierNvmePct: значение 25 означало NVMe-уровень в 25 % от DRAM, то есть соотношение DRAM:NVMe 4:1. Для зеркала нужны два SSD, каждый не меньше рассчитанного объёма. Накопители по 1,6 ТБ не превратят такой хост в систему с 1,8 ТБ памяти: избыточная ёмкость даёт запас по износу, но не отменяет установленное соотношение. Отдельно помню ограничение из документации: tier-раздел на устройстве не может быть больше 4 ТБ.
Считать надо и аварийный режим — для двух хостов он жёстче всего. Если два узла после включения дают около 1 ТБ логической памяти, при обслуживании одного остаётся примерно 512 ГБ. В этот объём с запасом должны помещаться все работающие ВМ, overhead гипервизора и резервации, а активная память всего кластера — укладываться в половину DRAM одного хоста. Отдельно проверяю CPU: Memory Tiering тратит процессорное время на классификацию и перемещение страниц. Кластер, который уже упирается одновременно в RAM и CPU, добавлением SSD не вылечить.
- Соберите `Active Memory` на обычных пиках, закрытии месяца, резервном копировании и пакетных заданиях.
- Проверьте максимум по каждому хосту после работы DRS, а не только среднее по кластеру; для двух узлов — суммарную активную память против DRAM одного хоста.
- При `tier_size_pct = 100` закладывайте NVMe Tier 1, равный объёму DRAM.
- Пересчитайте HA admission control и возможность полностью эвакуировать один узел.
- После включения стремитесь к задержке чтения NVMe ниже 200 мкс; около 400 мкс — граница, после которой производительность начинает страдать даже у терпимых нагрузок.
Какие накопители ставлю и почему не беру бытовые
Для Tier 1 я беру только enterprise NVMe, присутствующие в Broadcom Compatibility Guide для нужной модели сервера, версии ESX, драйвера и прошивки. Документация vSphere требует для Memory Tiering endurance class D (не менее 7300 TBW) и performance class F (100 000–349 999 операций записи в секунду) или G (от 350 000); Performance Best Practices формулирует это как не менее 100 000 записей в секунду и выносливость от 3 DWPD. Бытовой SSD может красиво показать пиковые IOPS, а после исчерпания SLC-кеша провалиться по задержке или быстро выработать ресурс. Для памяти такая экономия слишком рискованна.
Оба устройства пары должны быть эквивалентной ёмкости. Я также выравниваю модель и прошивку: формально зеркало может пережить разные накопители, но расследовать плавающие задержки у двух контроллеров с разными firmware — удовольствие сомнительное. Если платформа позволяет, развожу SSD по независимым PCIe-путям или корзинам. Перед закупкой проверяю число доступных линий PCIe, поддержку hot-plug у конкретного сервера и отсутствие совместного bottleneck на backplane.
NVMe должны быть выделены исключительно под Memory Tiering. Я не нарезаю на том же устройстве VMFS и не отдаю часть диска vSAN. В интерфейсе 9.1 выбранные накопители автоматически размечаются при remediation, поэтому любой существующий раздел и данные на них надо считать обречёнными. Серийные номера и device ID сверяю дважды — сначала в контроллере управления сервером, затем в vCenter. Ошибка выбора здесь уничтожает не абстрактный идентификатор, а реальный datastore.
Здесь есть ловушка для небольших конфигураций: класс D задан в TBW, а не в DWPD. Накопитель на 800 ГБ с 3 DWPD за пять лет гарантии даёт около 4380 TBW и под класс D не проходит, тогда как модель на 1,6 ТБ с теми же 3 DWPD — около 8760 TBW. Поэтому даже если по расчёту хватает 256 ГБ Tier 1, я смотрю в каталоге фактический класс устройства, а не только объём, и часто ставлю 1,6 ТБ ради ресурса.
- NVMe присутствует в Compatibility Guide для ESX 9.1 и конкретной серверной платформы.
- Endurance class D (от 7300 TBW) и performance class F или G; ориентир — от 3 DWPD и от 100 000 записей в секунду.
- В паре совпадают ёмкость, класс производительности и желательно модель с прошивкой.
- Устройство не содержит VMFS, vSAN disk group, загрузочных разделов или нужных данных.
- Для каждого SSD настроены аппаратные и vCenter-оповещения о ресурсе, температуре и ошибках.
Как включаю зеркало в работающем кластере
Сначала довожу vCenter и хосты до поддерживаемой ветки 9.1 и проверяю совместимость vendor add-on, драйвера и firmware. Нативного программного зеркала в 9.0 нет. Если хост уже работает с одним Tier 1, физически добавляю второй совместимый NVMe, выполняю rescan и убеждаюсь, что ESX видит устройство. Для сверки инвентаря достаточно read-only команд — они ничего не размечают:
esxcli storage core adapter device list
esxcli storage core device list | grep -i nvme
esxcli system tierdevice list
Последняя показывает уже созданные tier-разделы. Разделы в 9.1 я вручную не создаю: VMware прямо предупреждает, что CLI-команды в 9.1 отличаются от 9.0, а штатный путь для кластера — Configuration Profiles.
Дальше работаю через vSphere Configuration Profiles. Открываю кластер, затем Configure → vSphere Configuration Profiles, создаю новый draft и перехожу в memtier → nvme → Configure Settings. Ставлю enable = true, оставляю tier_size_pct = 100, после чего открываю View host-specific details. Для каждого хоста назначаю основной NVMe и отдельное второе устройство в поле зеркала. Это важно: профиль общий, а идентификаторы локальных дисков индивидуальны.
После сохранения draft просматриваю итоговую таблицу по всем хостам и запускаю Apply Changes, затем Remediate. ESX 9.1 поочерёдно переводит узлы в maintenance mode, мигрирует совместимые ВМ, автоматически создаёт разделы, применяет Memory Tiering с зеркалом и возвращает хост в кластер. Перезагрузка для этого изменения в 9.1 не требуется. Однако выражение «без простоя» относится к виртуальным машинам, а не к хостам: каждый сервер всё равно временно освобождается.
Автоматика не отменяет предварительную работу. DRS и vMotion должны быть исправны, общие datastore и сети доступны, а оставшиеся узлы — иметь запас. ВМ с PCI passthrough, локальными дисками или иными запретами vMotion остановят remediation. По статье Broadcom KB 398302, в 9.0 на хосте с tiering не включались ВМ с sched.cpu.latencySensitivity = high, SEV/SGX/TDX, FT, nested-виртуализацией и «монстры» больше 1 ТБ памяти и 128 vCPU; в 9.1 они запускаются, но в tiering не участвуют. Их память считаю как чистую DRAM. Ещё одно ограничение: на хосте с Memory Tiering не поддерживается suspend ВМ в память.
Для сравнения — как это делалось в 9.0 и почему инструкции оттуда нельзя копировать. Там хост переводился в maintenance mode, tier-раздел создавался вручную, функция включалась параметром ядра, соотношение задавалось Mem.TierNvmePct, после чего требовалась перезагрузка:
esxcli system maintenanceMode set --enable true
esxcli system tierdevice create -d /vmfs/devices/disks/<nvme-device>
# затем в Advanced System Settings: VMkernel.Boot.memoryTiering = true,
# Mem.TierNvmePct = 100, и перезагрузка хоста
В 9.1 эта последовательность заменена профилем, а перезагрузка не нужна. Держу эти команды в голове только чтобы распознать старую ручную настройку на унаследованном хосте.
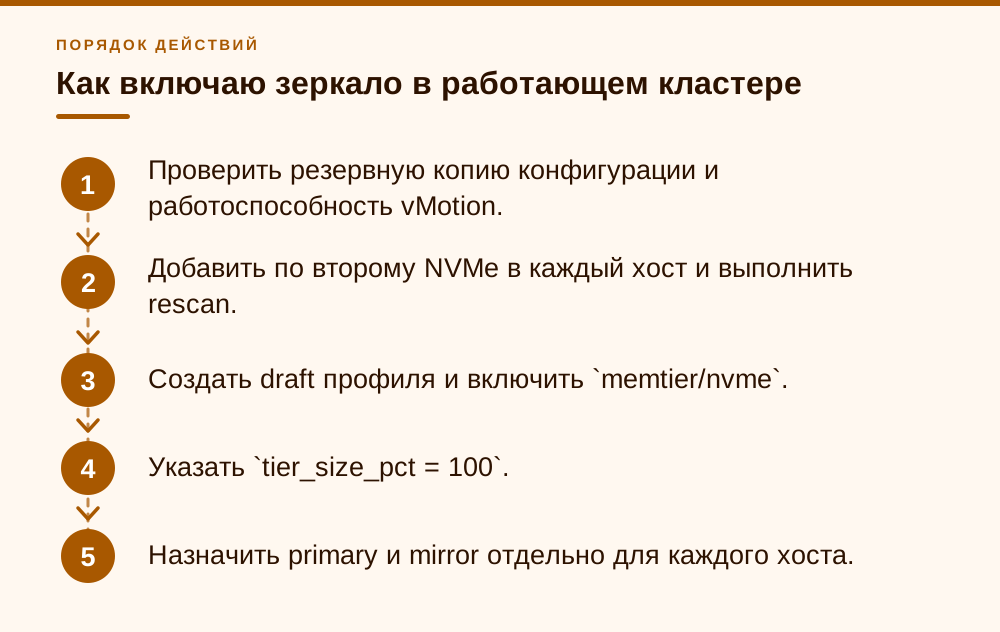
- Проверить резервную копию конфигурации и работоспособность vMotion.
- Добавить по второму NVMe в каждый хост и выполнить rescan.
- Создать draft профиля и включить `memtier/nvme`.
- Указать `tier_size_pct = 100`.
- Назначить primary и mirror отдельно для каждого хоста.
- Проверить pre-check remediation и список ВМ, которые нельзя мигрировать.
- Запустить последовательный `Remediate`, начиная с наименее загруженного периода.
- После каждого узла проверить состояние обоих устройств и объём Tier 0/Tier 1.
«ТелефонСервис»: четыре SSD вместо замены всей памяти
«ТелефонСервис» — сервисный центр по ремонту телефонов на 36 рабочих мест: приёмка, склад запчастей, мастера, бухгалтерия. Условный пример, собранный по типовой для такого бизнеса конфигурации. Два хоста виртуализации, в каждом один Xeon Silver и 256 ГБ DDR5 с занятыми слотами, общее хранилище по iSCSI, ESX 9.1 под vCenter 9.1. Работают 14 ВМ: 1С с сервисным учётом и складом, СУБД, два терминальных сервера, CRM приёмки, файловый сервер, контроллер домена и служебные машины. Настроено 360 ГБ гостевой памяти, пик Active Memory за 14 дней — 88 ГБ на весь кластер. Нужно было добавить третий терминальный сервер, тестовую копию 1С и сервер резервного копирования, доведя настройку примерно до 470 ГБ.
Главная проблема была не в среднем, а в N+1: при обслуживании одного хоста 360 ГБ настроенной памяти и так не помещались в 256 ГБ DRAM без балунинга и компрессии, а 470 ГБ — тем более. Альтернатива — заменить все модули на 64-гигабайтные в обоих серверах. Мы сравнили это с четырьмя NVMe и выбрали tiering: активная память маленькая, а объём настроенной памяти большой — ровно тот профиль, для которого функция задумана. Цены на DDR5 и enterprise-NVMe сейчас скачут, поэтому сравнение делайте в своих актуальных ценах, включая работу и окно.
В каждый сервер установили два U.2 NVMe по 1,6 ТБ класса Mixed Use, 3 DWPD, endurance class D; модель, firmware и драйвер сверили с Compatibility Guide. Аппаратного RAID в тракте нет. В профиле задали tier_size_pct = 100 и зеркало. Каждый хост получил 256 ГБ защищённого Tier 1 поверх 256 ГБ DRAM, кластер — около 1 ТБ логической памяти. Четыре SSD по 1,6 ТБ не стали 6,4 ТБ RAM, и это заранее проговорили с директором.
Профиль применяли вечером, по одному узлу. Эвакуация и настройка заняли 17 и 22 минуты, перезагрузок не было, ВМ переезжали через vMotion. Дольше разметки заняло старое правило affinity, державшее терминальный сервер на одном хосте. Через три недели настроенная память дошла до 465 ГБ, пик активной памяти кластера — до 104 ГБ, то есть даже при выводе одного хоста это около 41 % его DRAM. Задержка чтения Tier 1 держалась в диапазоне 110–160 мкс, редкие пики — до 240 мкс. В работе приёмки и 1С разницы не заметили; ночное резервное копирование стало дольше примерно на 5 %. Обещать «скорость как у DRAM» я бы не стал.
- 2 хоста × 256 ГБ DRAM, слоты DIMM заняты.
- 4 NVMe по 1,6 ТБ: основной и зеркало на каждом узле.
- `tier_size_pct = 100`, полезный Tier 1 — 256 ГБ на хост.
- Около 512 ГБ логической памяти на узел и около 1 ТБ на кластер.
- Пиковая активная память после расширения — 104 ГБ на весь кластер, меньше половины DRAM одного хоста.
Как проверяю отказ и что мониторю дальше
Защиту нельзя принимать на веру только потому, что профиль показывает два зелёных диска. После включения мы контролируемо вывели один NVMe из пары на сервисном узле во время тестовой нагрузки. Зеркало перешло в degraded-состояние, но ВМ не перезагрузились. Затем узел эвакуировали, вернули устройство и повторно проверили профиль. Такой тест выполняю только по процедуре производителя: случайно выдёргивать накопитель, не убедившись в поддержке hot-plug и правильном номере отсека, — плохая идея.
В эксплуатации ставлю оповещения на состояние primary и mirror, остаточный ресурс, media errors, температуру и задержку NVMe. На уровне памяти смотрю Active Memory, распределение Tier 0/Tier 1 и активность отдельных ВМ. Официальный хороший ориентир — чтение NVMe ниже 200 мкс и активная память не выше 50 % DRAM. Ещё нужен CPU headroom. Если задержка растёт только у одного хоста, первым делом проверяю firmware, температуру, PCIe link width и ошибки устройства, а не перенастраиваю алгоритм памяти.
Самые частые промахи повторяются: администратор считает два SSD на весь кластер вместо двух на каждый хост, покупает read-intensive или потребительскую модель, выбирает один NVMe в host-specific profile и думает, что зеркало включилось автоматически. Ещё хуже — забрать под Tiering диск с локальным datastore. Поэтому мой порядок жёсткий: измерение нагрузки, HCL, две одинаковые модели на хост, pre-check, поочерёдный remediation и контролируемая проверка отказа. Большие коэффициенты расширения оставляю лаборатории, пока обычный режим 1:1 не доказал свою стабильность.
3 сентября 2026 года VMware объявила общую доступность VCF 9.1.1. Программное зеркалирование появилось в 9.1, но перед внедрением всё равно выбираю поддерживаемый текущий build с учётом release notes, OEM add-on и матрицы firmware. Производственный кластер на свежую точечную версию только из-за номера не обновляю: сначала совместимость и тест, затем окно. А строить новую конфигурацию на 9.0 с аппаратным RAID ради Tier 1 теперь не вижу смысла. Отдельно проверяю у поставщика, входит ли Memory Tiering в вашу редакцию подписки: для малого бизнеса стоимость лицензий нередко важнее стоимости SSD.
- Ежедневно: состояние primary/mirror и аппаратные ошибки.
- Еженедельно: задержка NVMe, `Active Memory` и CPU headroom по хостам.
- После изменения состава ВМ: повторный расчёт N+1 и HA admission control.
- После firmware или ESX update: проверка профиля и короткий нагрузочный тест.
- При degraded mirror: немедленное оповещение, ограничение новых размещений и плановая замена устройства.
Частые вопросы
Сколько NVMe нужно для зеркального Memory Tiering?
По два накопителя на каждый ESX-хост: основной и зеркальный. Кластеру из двух хостов нужны четыре NVMe, из трёх — шесть. Полезная ёмкость пары равна объёму одного устройства.
Нужен ли аппаратный RAID-контроллер?
Для программного зеркалирования ESX 9.1 — нет. Я предпочитаю прямое подключение совместимых NVMe и штатный software mirror. Аппаратный RAID был вариантом защиты в 9.0 и остаётся отдельной архитектурой, если она сертифицирована для конкретной платформы.
Можно ли включить зеркало без остановки виртуальных машин?
Да, если ВМ поддерживают vMotion, а кластер способен эвакуировать один хост. Configuration Profiles выполняет rolling remediation без обязательной перезагрузки ESX 9.1. Каждый узел всё равно последовательно входит в maintenance mode.
Что произойдёт при отказе одного NVMe?
Исправный участник зеркала продолжит обслуживать Tier 1, а состояние станет degraded. ВМ не должны терять память из-за одиночного отказа устройства, но накопитель требуется заменить без затягивания: второго одновременного отказа зеркало не выдержит.
Можно ли добавить программное зеркало к ESX 9.0?
Нет. Сначала нужна поддерживаемая ветка ESX и vCenter 9.1. Не переносите вслепую `esxcli system tierdevice create` и настройку `Mem.TierNvmePct` из инструкций 9.0: в 9.1 CLI отличается, а штатный путь для кластера — vSphere Configuration Profiles.
Стоит ли внедрять Memory Tiering на одном сервере в небольшой компании?
Чаще нет. Если в сервере есть свободные слоты DIMM, добавить RAM проще и надёжнее. Tiering оправдан, когда слоты заняты, хостов два-три, активная память заметно меньше настроенной, а замена всех модулей дороже пары enterprise-NVMe на хост. На одиночном хосте без vMotion включение к тому же потребует остановки ВМ на время maintenance mode.
Какие NVMe подходят для Tier 1?
Только enterprise-накопители из Broadcom Compatibility Guide с endurance class D (от 7300 TBW) и performance class F или G. На практике это модели Mixed Use от 3 DWPD; у небольших накопителей проверяйте именно TBW — 800 ГБ при 3 DWPD под класс D не проходит.
Источники
- VMware by Broadcom — Performance Best Practices for VMware vSphere 9.1 — Разделы Memory Tiering Hardware (стр. 14: от 100 000 записей в секунду, от 3 DWPD) и Memory Tiering (стр. 38: активная память до 50 % DRAM, задержка чтения NVMe ниже 200 мкс). https://www.vmware.com/docs/vsphere-esxi-vcenter-server-9-1-performance-best-practices
- VMware Cloud Foundation Blog — More Memory, Less Effort: Configuring Memory Tiering in VCF 9.1 — Официальная инструкция от 19 мая 2026 года: Configuration Profiles, два NVMe на хост, software mirroring, tier_size_pct и remediation без перезагрузки. https://blogs.vmware.com/cloud-foundation/2026/05/19/more-memory-less-effort-configuring-memory-tiering-in-vcf-9-1/
- VMware Cloud Foundation Blog — Advanced Memory Tiering Enhancements in VMware Cloud Foundation 9.1 — Официальный обзор от 7 мая 2026 года: Software NVMe Mirroring вместо Tri-Mode RAID/Intel VROC, настройка без перезагрузки, поддержка nested и low-latency ВМ. https://blogs.vmware.com/cloud-foundation/2026/05/07/advanced-memory-tiering-enhancements-in-vmware-cloud-foundation-9-1/
- Broadcom Hardware Compatibility Guide — Каталог совместимых NVMe; фильтры endurance class D и performance class F/G. https://compatibilityguide.broadcom.com/search?activeDelta=20&activePage=1&column=partnerName&deviceType=%5BNVMe%5D&enduranceClass=%5BEndurance+Class+D+%3E%3D7300+TBW%5D&order=asc&performanceClass=%5BClass+F:+100,000-349,999+Writes+Per+Second%7C%7CClass+G:+350,000 %2B+Writes+Per+Second%5D&persona=live&program=ssd
- Broadcom TechDocs — vSphere 9.0 Resource Management: Memory Tiering over NVMe — Требования к NVMe (Class D ≥7300 TBW, Class F/G), лимит tier-раздела 4 ТБ, команды esxcli system tierdevice, Mem.TierNvmePct, планирование ёмкости. https://techdocs.broadcom.com/us/en/vmware-cis/vsphere/vsphere/9-0/vsphere-resource-management/memory-tiering-over-nvme.html
- Broadcom Knowledge Base — «This type of vm is not supported when software memory tiering is enabled» — Article ID 398302; поведение ESX 9.0 и 9.1 для Low Latency, Security (SEV/SGX/TDX), FT, Monster (>1 ТБ и 128 vCPU) и Nested ВМ. https://knowledge.broadcom.com/external/article/398302
- VMware Cloud Foundation Blog — Announcing General Availability of VCF 9.1.1 — Официальное сообщение от 3 сентября 2026 года о доступности VCF 9.1.1. https://blogs.vmware.com/cloud-foundation/2026/09/03/announcing-general-availability-of-vmware-cloud-foundation-9-1-1/