
На хостах загрузочные SSD по 120 ГБ: что с ними делать перед переходом на VMware ESX 9
Ситуация, которую я вижу раз за разом: админ ставит ESX 9 на тестовый хост со старым 120-гигабайтным SSD, установка проходит, хост поднимается, vCenter его видит — и в план обновления идёт строка «железо подходит, менять ничего не надо». А потом на этапе бюджета выясняется, что менять надо на каждом хосте, что это разборка сервера, окно обслуживания и закупка, которую никто не закладывал. Ниже — что именно требует Broadcom для загрузочного устройства ESX 9.x, почему цифра выросла с 32 до 128 ГБ, как за вечер снять реальную картину по своему парку и как я меняю загрузочные диски на боевых хостах без потери конфигурации.
«Установилось» и «поддерживается» — это два разных факта
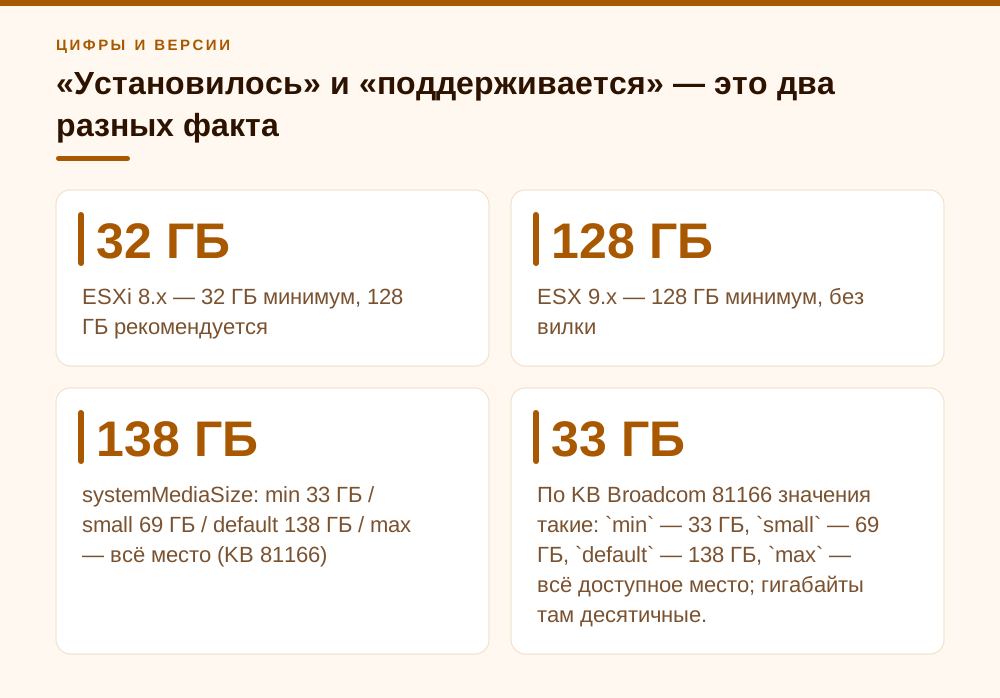
Начну с цифр, потому что вокруг них весь спор. В KB Broadcom по загрузочным устройствам (та самая статья про SD/USB) таблица требований выглядит так: для vSphere 8.x — 32 ГБ минимум и 128 ГБ рекомендуется, для vSphere 9.x — 128 ГБ минимум. Без вилки, без «рекомендуется». Плюс два параметра, о которых вспоминают ещё реже: ресурс устройства не ниже 128 TBW за пять лет и пропускная способность не ниже 100 МБ/с. Тип носителя тоже назван прямо — PCIe NVMe, SAS, SATA/SATADOM SSD или промышленная флеш-память, а не потребительская SD-карта в слоте.
Теперь про ловушку. Инсталлятор — не орган сертификации. Жёсткого запрета «меньше 128 ГБ — не ставлю» в нём может и не оказаться, и хост на таком диске поднимется и будет жить. Но требование написано в документации вендора, а не в инсталляторе. Когда через полгода вы откроете кейс по странному поведению хоста, инженер поддержки посмотрит в документ, а не на то, что у вас всё запустилось. И разговор закончится на словах «unsupported configuration» — ровно в тот момент, когда помощь нужна больше всего.
Полезно понимать, что происходит с самим диском. Размер системной области задаётся загрузочным параметром systemMediaSize — его вводят в инсталляторе по Shift+O или прописывают в строке kernelopt файла boot.cfg. По KB Broadcom 81166 значения такие: min — 33 ГБ, small — 69 ГБ, default — 138 ГБ, max — всё доступное место; гигабайты там десятичные. Сама статья описывает параметр для 7.0 U1c и 8.x — для девятки сверяйтесь с актуальной редакцией, прежде чем закладывать его в план. На SSD с маркировкой 120 ГБ стандартные 138 ГБ не помещаются физически, поэтому системные разделы занимают весь носитель, а локальный VMFS-датастор на нём не появляется. Уменьшить системную область через min или small технически можно, но это способ освободить место под датастор, а не способ пройти порог 128 ГБ: требование относится к устройству, а не к размеру разделов.
Поэтому моя позиция как человека, который обслуживает хосты и отвечает за них деньгами: пробная установка на 120-гигабайтный SSD доказывает ровно одно — что инсталлятор не упал. Она не доказывает ни соответствия требованиям, ни того, что через год этот диск не начнёт сыпаться под записью логов и коредампов. Планировать обновление по результату пробной установки — самый дорогой способ сэкономить две недели на инвентаризации.
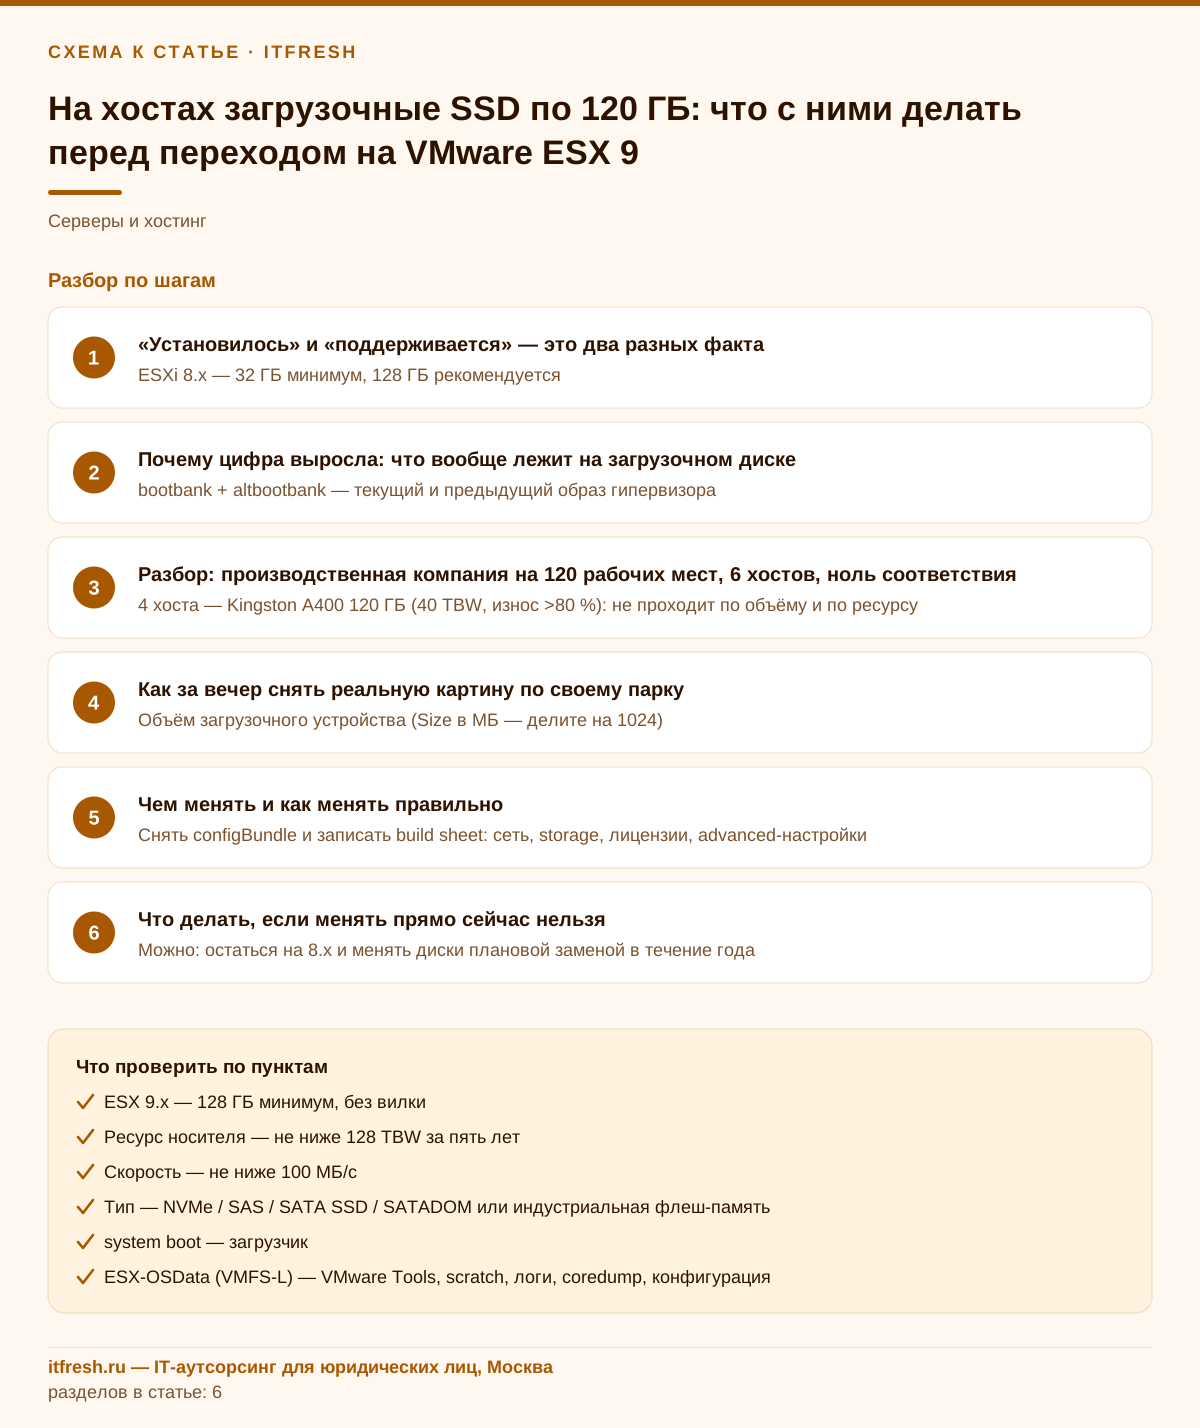
- ESXi 8.x — 32 ГБ минимум, 128 ГБ рекомендуется
- ESX 9.x — 128 ГБ минимум, без вилки
- Ресурс носителя — не ниже 128 TBW за пять лет
- Скорость — не ниже 100 МБ/с
- Тип — NVMe / SAS / SATA SSD / SATADOM или индустриальная флеш-память
- systemMediaSize: min 33 ГБ / small 69 ГБ / default 138 ГБ / max — всё место (KB 81166)
Почему цифра выросла: что вообще лежит на загрузочном диске
Разметка загрузочного устройства ESXi изменилась ещё в седьмой версии, и с тех пор она консолидированная: системный загрузочный раздел, два bootbank-а (рабочий и резервный, для отката после неудачного обновления) и большой раздел ESX-OSData. Вот последний и съедает объём. В OSData живут VMware Tools (тот самый productLocker), scratch с логами и диагностикой, конфигурационные дампы, место под core dump. Раньше часть этого спокойно уезжала на RAM-диск или на первый попавшийся VMFS, сейчас позиция Broadcom однозначная: OSData должен лежать на постоянном локальном носителе, а размещение на RAM-диске — аварийный режим, а не рабочая схема.
Дальше это только растёт. С каждым релизом платформа пишет на системный носитель больше: расширенная диагностика, пакеты VMware Tools под свежие гостевые ОС, временные файлы при обновлении образа через vLCM. Когда у вас под всё это 120 ГБ, из которых заметная часть уже занята, любое обновление образа кластера превращается в лотерею «хватит ли места распаковать». Я видел такие хосты: обновление падает на стадии staging, в логах — нехватка места, а человек час ищет проблему в самом vLCM.
Отдельно про SD и USB. В KB 317631 статус для 8.0 и 9.0 записан как «поддерживается, не рекомендуется», и там же сказано, что новые OEM-серверы с SD/USB в роли загрузочного устройства сертификацию не пройдут. Важная деталь: даже в допустимой схеме на SD/USB остаются только bootbank-и, а ESX-OSData обязан жить на постоянном локальном носителе. Хост, у которого SD-карта или флешка — единственное устройство и всё системное пишется на неё, — это неподдерживаемая конфигурация, а не «старая, но рабочая». Флешка в сервере, которая годами пишет логи, умирает не постепенно, а сразу и в неудобное время.
- system boot — загрузчик
- bootbank + altbootbank — текущий и предыдущий образ гипервизора
- ESX-OSData (VMFS-L) — VMware Tools, scratch, логи, coredump, конфигурация
Разбор: маркетплейс на 19 рабочих мест, три хоста, ноль соответствия
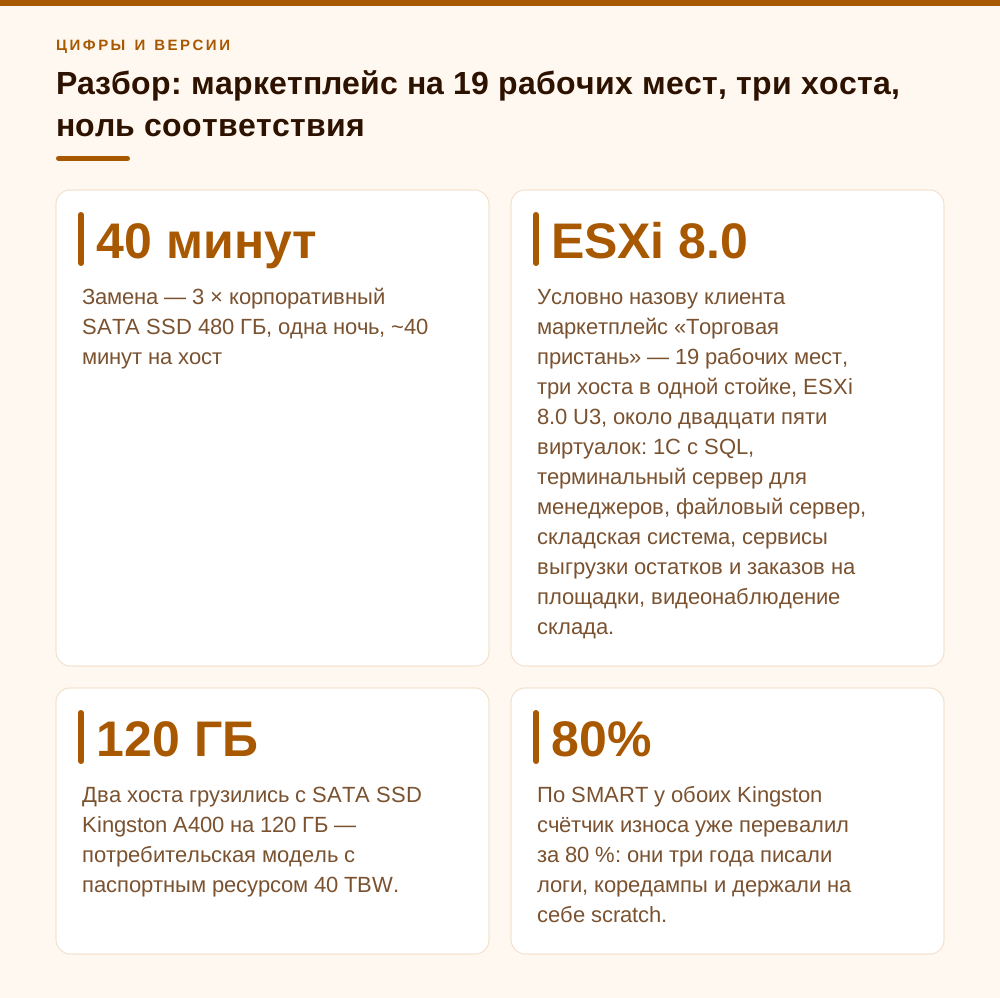
Условно назову клиента маркетплейс «Торговая пристань» — 19 рабочих мест, три хоста в одной стойке, ESXi 8.0 U3, около двадцати пяти виртуалок: 1С с SQL, терминальный сервер для менеджеров, файловый сервер, складская система, сервисы выгрузки остатков и заказов на площадки, видеонаблюдение склада. Задача от руководителя звучала буквально так: «мы решили в следующем году идти на девятку, оцени, что нужно докупить». Он ожидал разговора про лицензии и память. Разговор получился про загрузочные диски.
Инвентаризация заняла пару часов и дала такую картину. Два хоста грузились с SATA SSD Kingston A400 на 120 ГБ — потребительская модель с паспортным ресурсом 40 TBW. Это несоответствие сразу по двум параметрам: и по объёму (120 против 128), и по ресурсу (40 против требуемых 128 TBW за пять лет). Третий хост грузился с 32-гигабайтного SATADOM: под восьмёрку он формально проходил по минимуму, под девятку — нет вообще. На нём же scratch оказался на RAM-диске, о чём никто не знал; логов за все перезагрузки за три года просто не существовало.
Дальше самое интересное — состояние носителей. По SMART у обоих Kingston счётчик износа уже перевалил за 80 %: они три года писали логи, коредампы и держали на себе scratch. То есть вопрос был не «менять ли перед ESX 9», а «сколько ещё эти диски проживут на восьмёрке». Для маркетплейса, где простой в разгар сезона означает сорванные отгрузки и штрафы площадок, это был совсем другой разговор. Обновление платформы просто вскрыло проблему, которая созревала сама по себе.
Итог. Закупили три корпоративных SATA SSD на 480 ГБ (уровень Samsung PM893 или Kingston DC600M, около 1 DWPD — ресурс в сотнях TBW, с многократным запасом над 128 TBW), плюс переходник в отсек для хоста с SATADOM. Работы уложили в одну ночь с воскресенья на понедельник, когда заказов меньше всего: снять конфиг, эвакуировать виртуалки, поменять диск, поставить ESXi прежней сборки, вернуть конфигурацию, вернуть нагрузку. Чистого времени — около 40 минут на хост, из них минут 25 — ожидание vMotion. Бюджет по железу вышел меньше, чем стоит полдня простоя приёма заказов, и это был единственный аргумент, который руководителю понадобился.
- 2 хоста — Kingston A400 120 ГБ (40 TBW, износ >80 %): не проходит по объёму и по ресурсу
- 1 хост — SATADOM 32 ГБ: под 8.x впритык, под 9.x не проходит
- На том же хосте scratch на RAM-диске — логи терялись при каждой перезагрузке
- Замена — 3 × корпоративный SATA SSD 480 ГБ, одна ночь, ~40 минут на хост
Как за вечер снять реальную картину по своему парку
Не надо ничего разбирать и не надо ходить в BIOS. Всё снимается из SSH-сессии на живом хосте, без прерывания работы. Я начинаю с версии и с того, где вообще лежат bootbank-и и OSData:
vmware -vl
ls -ld /bootbank /altbootbank
esxcli storage filesystem list
esxcli storage core device list
esxcli system coredump partition get
esxcli system syslog config get
esxcli system settings advanced list -o /ScratchConfig/ConfiguredScratchLocation
esxcli system settings advanced list -o /UserVars/ProductLockerLocation
В выводе esxcli storage core device list смотрите на поле Size (оно в мегабайтах) и на Display Name — там видно вендора и модель. Дальше по модели ищете паспортный TBW на сайте производителя: это ровно 30 секунд и ровно тот параметр, который никто не проверяет. Если модель потребительская (A400, BX500, Green и им подобные) — считайте, что несоответствие уже есть, независимо от объёма. Состояние износа удобно снимать так:
esxcli storage core device smart get -d naa.5001b448b9xxxxxxИ последнее, что я всегда делаю на этом же заходе, — снимаю резервную копию конфигурации хоста. Она понадобится при замене диска, а заодно окажется полезной в любой аварии:
vim-cmd hostsvc/firmware/sync_config
vim-cmd hostsvc/firmware/backup_config
Результат сводите в простую таблицу: хост, модель загрузочного устройства, объём, паспортный TBW, износ по SMART, где лежит scratch и coredump. Три хоста — час работы. Двадцать хостов — вечер. Эта таблица и есть ваш аргумент в разговоре про бюджет обновления: не «надо бы обновить железо», а «два хоста из трёх не проходят по двум параметрам из четырёх, третий — по объёму, вот строки».
- Объём загрузочного устройства (Size в МБ — делите на 1024)
- Модель и класс носителя (корпоративный / потребительский / SATADOM / SD-USB)
- Паспортный TBW и текущий износ по SMART
- Где физически лежат ESX-OSData, scratch, coredump и productLocker
- Есть ли актуальный configBundle по каждому хосту
Чем менять и как менять правильно
По железу выбор простой, и я почти всегда иду одним из трёх путей. Первый и лучший — штатный boot-модуль вендора: у HPE это NS204i (пара M.2 NVMe в аппаратном зеркале), у Dell — BOSS с двумя M.2, у Lenovo — M.2 kit с зеркалом. Плюс в том, что вы получаете отказоустойчивость самого загрузочного диска и не тратите отсек под горячую замену. Второй путь — обычный корпоративный SATA/SAS SSD на 240–480 ГБ в отсеке. Дешевле, надёжнее старого хлама, но занимает слот. Третий — SATADOM подходящего объёма, если в шасси просто некуда воткнуть диск.
Про объём. Формально хватает 128 ГБ, но я беру 240 ГБ как минимум, а чаще 480. Разница в цене между корпоративными моделями на 240 и 480 ГБ — несколько тысяч рублей на хост, а запас закрывает и рост OSData в будущих релизах, и место под кеш образов vLCM, и нервы. Экономить на загрузочном диске сервера, на котором держатся все виртуалки компании, — это ровно та экономия, из-за которой потом появляется незапланированное ночное окно.
Теперь процедура, и здесь у меня жёсткая позиция: не клонируйте старый диск на новый. Блочная копия притащит за собой и старую разметку (которая для девятки уже неактуальна), и идентификаторы устройств, и накопленную порчу. Правильно — чистая установка на новый носитель и возврат конфигурации. Пошаговый порядок, которого я придерживаюсь, собран в списке ниже.
Отдельно предупрежу про два места, где обычно спотыкаются. Первое: при выборе диска в инсталляторе ориентируйтесь на серийный номер устройства, а не на подписанный объём — если в хосте два похожих SSD, шанс промахнуться реальный, а промах означает затёртый датастор. Второе: восстановление configBundle, по KB Broadcom 313510, требует совпадения номера сборки и UUID хоста. Нельзя снять конфиг с 8.0 U3 и залить его на свежепоставленный ESX 9 — при смене диска сначала ставьте ту же версию, что была, возвращайте конфиг, убеждайтесь, что хост в строю, и только потом отдельной операцией обновляйтесь до девятки через vLCM. Два шага вместо одного, зато без сюрпризов.
Сама пара команд для резервной копии и возврата выглядит так; архив, который вернёт backup_config, скачайте по выданной ссылке и храните вне хоста:
vim-cmd hostsvc/firmware/sync_config
vim-cmd hostsvc/firmware/backup_config
# после чистой установки той же сборки, файл загружен в /tmp/configBundle.tgz
vim-cmd hostsvc/maintenance_mode_enter
vim-cmd hostsvc/firmware/restore_config /tmp/configBundle.tgz
И третий подводный камень из той же KB: инвентарь виртуальных машин в configBundle не входит. После восстановления хост перезагрузится с прежней сетью и настройками, но виртуалки, которые жили на локальном датасторе, придётся зарегистрировать заново — заранее выгрузите список путей к .vmx.
- Снять configBundle и записать build sheet: сеть, storage, лицензии, advanced-настройки
- Перевести хост в maintenance mode, эвакуировать виртуалки через vMotion
- Погасить хост, заменить загрузочный носитель, записать серийный номер нового
- Поставить ESXi той же версии, что стояла; при наличии VMFS на целевом диске — только вариант с сохранением датастора
- Вернуть configBundle (та же сборка, тот же UUID), перерегистрировать ВМ с локальных датасторов, проверить scratch, syslog и coredump на постоянном хранилище
- Прогнать холодную перезагрузку, убедиться, что датасторы монтируются с прежними UUID
- Вывести из maintenance mode, вернуть нагрузку и только потом планировать апгрейд до ESX 9
Что делать, если менять прямо сейчас нельзя
Бывает, что бюджет закрыт, окна нет, а разговор про девятку идёт уже сейчас. Успокою: гореть не обязательно. ESXi 8.x поддерживается ещё не один год — точные даты сверяйте по матрице жизненного цикла продуктов Broadcom, она обновляется. То есть у вас есть законный сценарий «остаёмся на 8.x, меняем загрузочные диски плановой заменой в течение года, на девятку идём уже подготовленными». Это нормальный инженерный план, а не откладывание.
Но одно действие я всё-таки прошу сделать не откладывая — увести scratch, coredump и логи с ненадёжных носителей на постоянное хранилище. Даже без замены диска это снимает половину рисков: логи перестают теряться, флешка перестаёт истираться, а при следующем падении хоста у вас будет что читать. Настраивается это несколькими командами; scratch применяется после перезагрузки хоста:
esxcli system settings advanced set -o /ScratchConfig/ConfiguredScratchLocation -s /vmfs/volumes/<datastore>/.locker-<hostname>
esxcli system syslog config set --logdir=/vmfs/volumes/<datastore>/logs-<hostname>
esxcli system syslog reload
esxcli system coredump file add -d <datastore> -f coredump-<hostname>
esxcli system coredump file set --smart --enable true
esxcli system coredump file list
И честно про то, чего я делать не советую: сохранять «гибридную» схему, когда bootbank остаётся на умирающей SD-карте, а OSData переехал на диск. Broadcom такую схему допускает, но в той же KB 317631 помечает её как нерекомендуемую и не годную для новых серверов. Проблему умирающей флешки он не решает — просто отодвигает момент, когда хост не поднимется после перезагрузки. Если вы уже открыли сервер, ставьте нормальный SSD и закройте вопрос на пять лет.
- Можно: остаться на 8.x и менять диски плановой заменой в течение года
- Нужно сразу: увести scratch, syslog и coredump на постоянное хранилище
- Нужно сразу: закупить замену для хостов на SD/USB и на потребительских SSD с износом выше 70 %
- Не стоит: жить на гибридной схеме bootbank-на-флешке + OSData-на-диске дольше одного окна обслуживания
Приоритеты: с чего начать и на что можно забить
Если бы мне дали один день на весь этот вопрос, я потратил бы его так. Первые два часа — инвентаризация загрузочных устройств по всему парку теми командами, что выше, и сведение в таблицу. Следующий час — сверка моделей с паспортным TBW и снятие износа по SMART. Ещё час — вынос scratch и coredump на постоянное хранилище там, где они висят на RAM-диске или на флешке. Остаток дня — заявка на закупку с конкретными строками и черновик графика окон обслуживания. Всё, вопрос из категории «неизвестная угроза бюджету» переходит в категорию «известная задача с ценой».
На что можно забить. Не надо мучительно выбирать между 240 и 480 ГБ — разница в цене копеечная, берите 480 и забудьте. Не надо ловить точное значение «а вдруг 128-гигабайтный ровно подойдёт»: подойдёт, но зачем вам граничный случай на пять лет вперёд. Не надо переставлять хосты, у которых уже стоят вендорские boot-модули на 480 ГБ — они проходят по всем четырём параметрам, там делать нечего. И не надо паниковать из-за сроков: восьмёрка живёт, время на плановую замену есть.
На чём экономить нельзя. На классе носителя — только корпоративный, с внятным паспортным ресурсом. На резервной копии конфигурации перед заменой — снимайте всегда, даже если уверены, что помните все настройки наизусть (не помните). И на порядке действий: сначала замена диска на прежней версии, потом отдельно обновление до ESX 9. Совмещение этих двух операций в одну ночь — самая популярная причина того, что утром склад не может отгружать заказы.
И последнее наблюдение из практики. Почти всегда аудит загрузочных дисков вскрывает что-то ещё: у одного хоста нет актуального бэкапа конфигурации, у другого coredump уехал в никуда, у третьего в BIOS до сих пор старая прошивка HBA. Это нормально — так и должно быть, потому что загрузочный диск гипервизора обычно последнее место, куда кто-либо заглядывает. Считайте требование 128 ГБ поводом наконец туда заглянуть.
- Сегодня: инвентаризация + сверка TBW + вынос scratch/coredump на постоянное хранилище
- На этой неделе: заявка на закупку с конкретными моделями и объёмами
- В течение квартала: замена дисков плановыми окнами, по 2–3 хоста за ночь
- После этого: апгрейд до ESX 9 отдельной операцией через vLCM
Частые вопросы
ESX 9 действительно не установится на диск меньше 128 ГБ?
Жёсткой блокировки в инсталляторе может и не быть, но это не аргумент. В KB Broadcom 317631 для 9.x записано «128 GB minimum», и конфигурация на меньшем носителе считается неподдерживаемой, даже если технически работает. На 120-гигабайтном SSD стандартная системная область (systemMediaSize=default, 138 ГБ) не помещается, поэтому системные разделы займут весь диск и локального датастора на нём не будет. При обращении в поддержку размер загрузочного устройства — первое, обо что вы споткнётесь.
У нас загрузочные диски ровно на 128 ГБ. Проходят?
Формально да, требование выполняется. Практически я такие не ставлю: устройство с маркировкой 128 ГБ даёт около 119 GiB полезной ёмкости, и любой рост ESX-OSData в следующих релизах вы почувствуете первым. Разница в цене между 128 и 480 ГБ несущественная, запас — существенный.
Можно ли просто клонировать старый загрузочный диск на новый, больший?
Нет. Блочная копия переносит устаревшую разметку, идентификаторы устройств и уже накопленные проблемы, а нарастить разделы ESX-OSData обычными утилитами нельзя. Правильный путь — чистая установка на новый носитель и восстановление configBundle той же сборки.
Что важнее — объём диска или его ресурс TBW?
Оба параметра обязательные, но на практике первым убивает хосты именно ресурс. Требование Broadcom — 128 TBW за пять лет; у потребительских SSD на 120 ГБ паспортный ресурс бывает около 40 TBW, то есть втрое меньше. Такой диск не доживёт до конца жизненного цикла сервера независимо от того, на какой версии ESXi он работает.
У нас часть хостов грузится с SD-карт. Это ещё поддерживается?
По KB 317631 статус для 8.0 и 9.0 — «поддерживается, не рекомендуется», а новые OEM-серверы с такой схемой сертификацию не проходят. При этом на SD/USB допустимо держать только bootbank-и: ESX-OSData должен лежать на постоянном локальном носителе. SD-карта как единственное устройство, на которое пишется всё системное, — неподдерживаемая конфигурация. Практически это означает: планируйте замену, а не рассчитывайте на карту.
Можно ли совместить замену загрузочного диска и обновление до ESX 9 в одно окно?
Можно, но я так не делаю. Восстановление резервной копии конфигурации требует совпадения сборки, поэтому чистая последовательность такая: замена носителя с установкой прежней версии, возврат конфигурации, проверка, и уже отдельной операцией — апгрейд до девятки через vLCM. Два коротких окна вместо одного длинного и рискованного.
Поможет ли параметр systemMediaSize=min уложиться в требования на маленьком диске?
Нет. Параметр управляет размером системной области (по KB 81166: min — 33 ГБ, small — 69 ГБ, default — 138 ГБ, max — всё место) и нужен, чтобы освободить на диске место под локальный VMFS. Требование 128 ГБ для 9.x относится к самому загрузочному устройству, так что 120-гигабайтный SSD с любым значением параметра остаётся ниже порога.
Источники
- Broadcom KB 317631 — «SD card/USB boot device revised guidance» — таблица требований к загрузочному устройству: vSphere 8.x — 32 ГБ минимум / 128 ГБ рекомендуется, vSphere 9.x — 128 ГБ минимум, ресурс 128 TBW за 5 лет, пропускная способность не ниже 100 МБ/с, статус SD/USB. https://knowledge.broadcom.com/external/article/317631/sd-cardusb-boot-device-revised-guidance.html
- Broadcom KB 81166 — «Boot option to configure the size of ESXi system partitions» — параметр systemMediaSize (min 33 ГБ, small 69 ГБ, default 138 ГБ, max), ввод через Shift+O или kernelopt в boot.cfg; указан для ESXi 7.0 U1c и 8.x. https://knowledge.broadcom.com/external/article?legacyId=81166
- Broadcom KB 313510 — «How to back up and restore the ESXi host configuration» — vim-cmd hostsvc/firmware/sync_config, backup_config, restore_config; требование совпадения сборки и UUID хоста, инвентарь ВМ не восстанавливается. https://knowledge.broadcom.com/external/article/313510
- Broadcom KB: ESXi boot device partitioning / ESX-OSData — Изменения системного хранилища ESXi начиная с 7.0: system boot, bootbank/altbootbank, ESX-OSData (VMware Tools locker, scratch, coredump). https://knowledge.broadcom.com/external/article?legacyId=85685
- Lenovo Support HT517869 — «Installation Instructions for VMware ESX 9.x on ThinkSystem servers» — требования к постоянному загрузочному хранилищу для ESX 9.x и запрет на совместное использование одного загрузочного устройства несколькими хостами. https://support.lenovo.com/sg/en/solutions/ht517869
- Broadcom Product Lifecycle Matrix — Актуальные даты окончания общей и технической поддержки vSphere 8.x и 9.x — сверять перед планированием окна миграции. https://support.broadcom.com/group/ecx/productlifecycle