
Как заранее заметить отказ диска и сорванный бэкап
Зелёная галочка в задании резервного копирования ещё не означает, что данные можно восстановить. А надпись SMART PASSED не обещает диску долгую жизнь. Я покажу, какие сигналы действительно контролирую, как связываю их с Zabbix и что проверяю руками, чтобы руководитель небольшой организации узнал о проблеме раньше, чем встанет работа.
Контролировать нужно не задание, а восстановимость
Самая неприятная авария начинается со спокойной фразы: «Бэкапы вроде делались». Открываем папку — файлы свежие. Смотрим журнал планировщика — задача завершена успешно. Начинаем восстановление, и выясняется, что внутри архива пустая выгрузка, повреждённая база или копия недельной давности под новым именем. Я видел эту последовательность много раз. Причина почти всегда одна: контролировали запуск скрипта, а не прохождение всей цепочки.
Я считаю резервное копирование успешным только при выполнении пяти условий: источник сформировал согласованную копию, программа завершилась с правильным кодом, объём результата похож на нормальный, репозиторий прошёл проверку целостности, а тестовое восстановление действительно открылось. Первые три пункта проверяются после каждого запуска. Проверку репозитория можно распределить по дням, а полноценное восстановление критичной системы проводить ежемесячно или хотя бы ежеквартально.
SMART решает другую задачу. Он даёт шанс увидеть деградацию накопителя до окончательного отказа, но не заменяет RAID и тем более бэкап. Диск способен умереть внезапно при исправных вчера показателях. Поэтому я объединяю два контура: состояние физических носителей и качество резервных копий. Если наблюдать только что-то одно, остаётся слишком большая слепая зона.
- Возраст последней успешной копии, а не последнего запуска задания
- Код завершения каждого этапа: выгрузка базы, упаковка, передача и проверка
- Размер копии и длительность задания относительно обычного диапазона
- Целостность репозитория и наличие независимой копии
- Результат пробного восстановления с измеренным временем
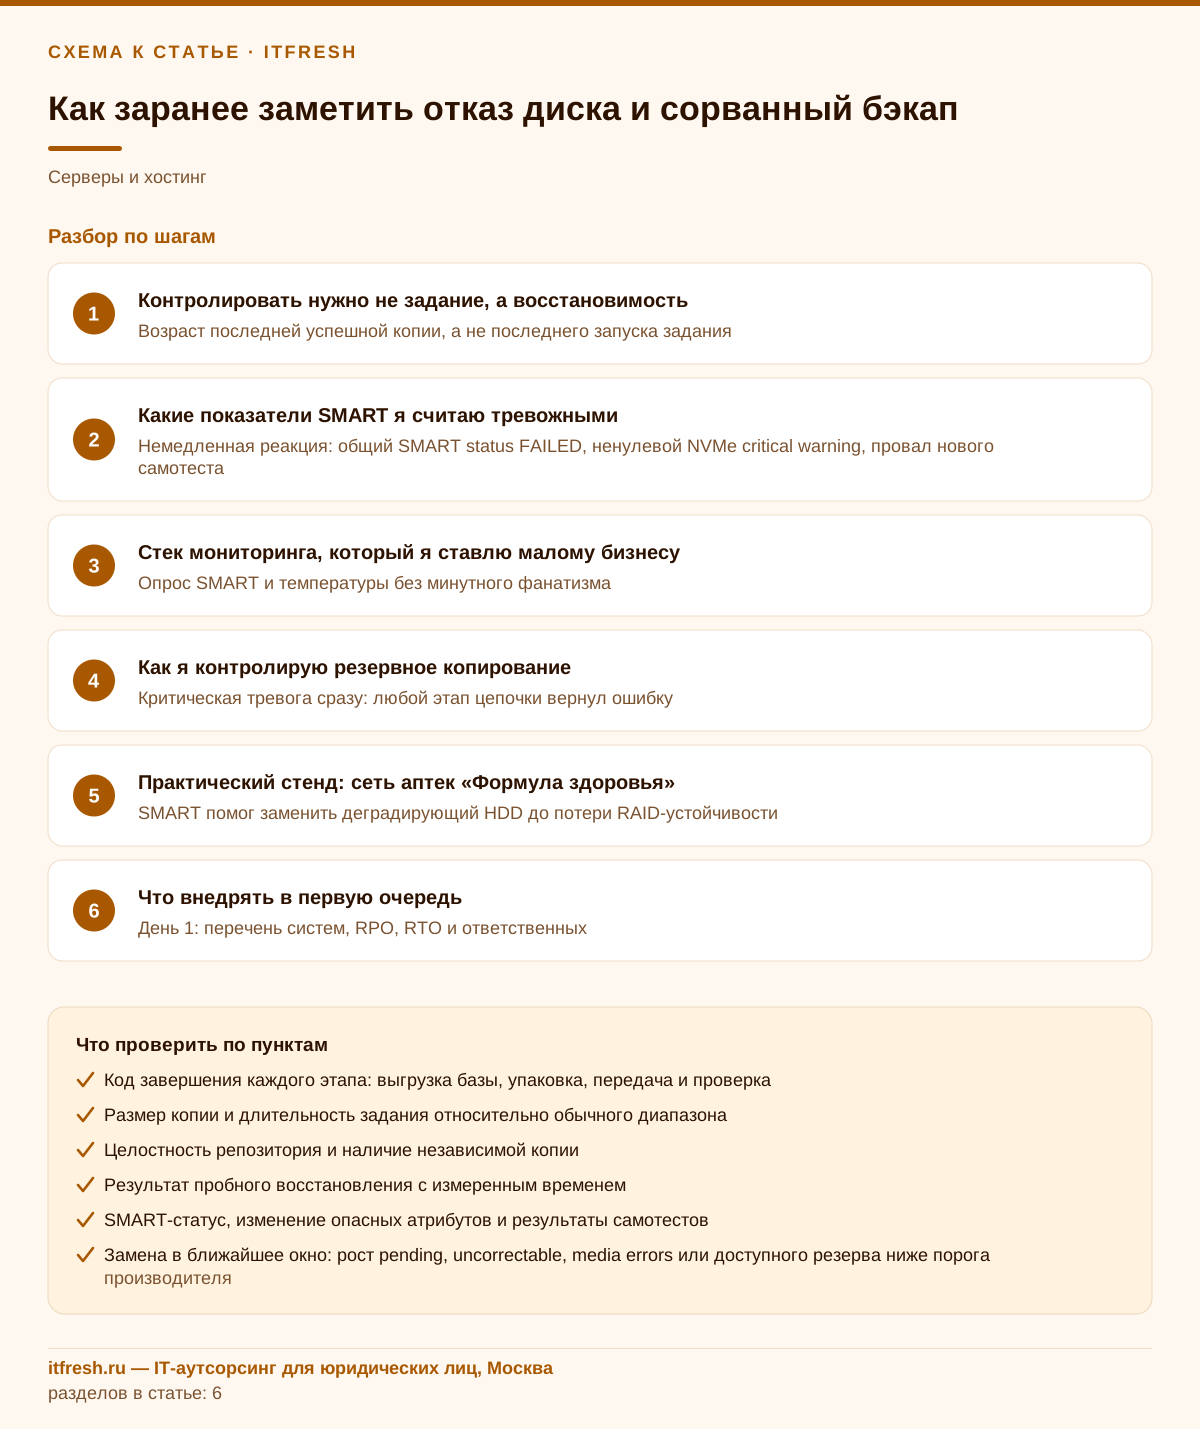
- SMART-статус, изменение опасных атрибутов и результаты самотестов
Какие показатели SMART я считаю тревожными
Команда smartctl -H показывает итоговую оценку производителя, но одного результата PASSED недостаточно. Для HDD я в первую очередь смотрю сырые значения Reallocated Sector Count, Reported Uncorrectable Errors, Current Pending Sector и Offline Uncorrectable — обычно это атрибуты 5, 187, 197 и 198. Атрибут 187 есть не у всех производителей, поэтому его отсутствие в выводе — не ошибка. Важнее не красивое нормализованное число, а появление и рост сырых счётчиков. Один перераспределённый сектор не всегда означает немедленную смерть диска. Но если Current Pending Sector вырос с нуля до восьми и продолжает расти, я не жду официального FAILED: готовлю замену и проверяю копии.
С атрибутом 199, UDMA CRC Error Count, другая история. Его рост чаще указывает на кабель, разъём, питание или корзину, а не на поверхность диска. Заменять накопитель вслепую здесь дорого и бессмысленно. У SSD названия и смысл vendor-specific атрибутов различаются, поэтому универсальные пороги из случайной таблицы применять нельзя. Для NVMe я контролирую critical_warning, available_spare, media_errors, температуру и percentage_used. Critical Warning — это битовое поле журнала SMART/Health Information: любой взведённый бит (исчерпан резерв, превышена температура, деградация надёжности, режим только чтения) smartd с директивой -H пишет в syslog с уровнем LOG_CRIT. Достижение 100 % расчётного ресурса не означает мгновенный отказ, но это уже плановая замена, а не повод ждать ещё год.
Кроме текущих показателей я запускаю короткий самотест раз в неделю, длинный — раз в месяц, со сдвигом по времени между дисками. smartctl -t long обычно лишь запускает внутренний тест и сообщает расчётное время окончания; результат нужно потом прочитать отдельно. На нагруженной системе тест сначала согласую с окном обслуживания, а во время rebuild или resilver не добавляю лишнюю нагрузку. Базовая ручная диагностика выглядит так:
sudo smartctl --scan-open
sudo smartctl -x -j /dev/sda
sudo smartctl -t short /dev/sda
sudo smartctl -l selftest /dev/sda
sudo smartctl -t long /dev/sda
У smartctl код выхода является битовой маской: ненулевое значение может сообщать как о текущем отказе, так и об исторической записи в журнале. Поэтому проверка вида «код не ноль — срочно менять диск» даёт шум. Я разбираю биты или использую готовый шаблон Zabbix, который делает это за меня.
Если Zabbix пока нет, первым контуром ставлю штатный демон smartd из того же пакета smartmontools. Директива -a включает проверку общего статуса, атрибутов, журналов ошибок и самотестов, а для ATA-дисков по умолчанию добавляет -C 197 -U 198, то есть отслеживание pending и offline uncorrectable секторов. Расписание тестов задаётся регулярным выражением формата T/MM/DD/d/HH. Минимальный /etc/smartd.conf для небольшого сервера у меня выглядит так:
# /etc/smartd.conf
# короткий тест ежедневно в 02:00, длинный — по субботам в 03:00
DEVICESCAN -a -o on -S on -n standby -R 5! -W 4,45,55 -s (S/../.././02|L/../../6/03) -m admin@example.org -M exec /usr/share/smartmontools/smartd-runner
Флаг -R 5! делает любое изменение сырого значения атрибута 5 критическим событием, -W 4,45,55 сообщает о скачке температуры на 4 градуса и о превышении 45 и 55 °C, а -n standby не будит спящие диски ради опроса. Строка DEVICESCAN должна быть последней осмысленной: всё, что ниже, smartd игнорирует. Путь к скрипту в -M exec зависит от дистрибутива, поэтому перед рестартом службы я один раз добавляю -M test и убеждаюсь, что тестовое письмо действительно дошло.
- Немедленная реакция: общий SMART status FAILED, ненулевой NVMe critical warning, провал нового самотеста
- Замена в ближайшее окно: рост pending, uncorrectable, media errors или доступного резерва ниже порога производителя
- Диагностика тракта: растёт CRC error count, но медиасчётчики стоят на месте
- Наблюдение: одиночное старое событие без дальнейшего роста и с успешно пройденным длинным тестом
Стек мониторинга, который я ставлю малому бизнесу
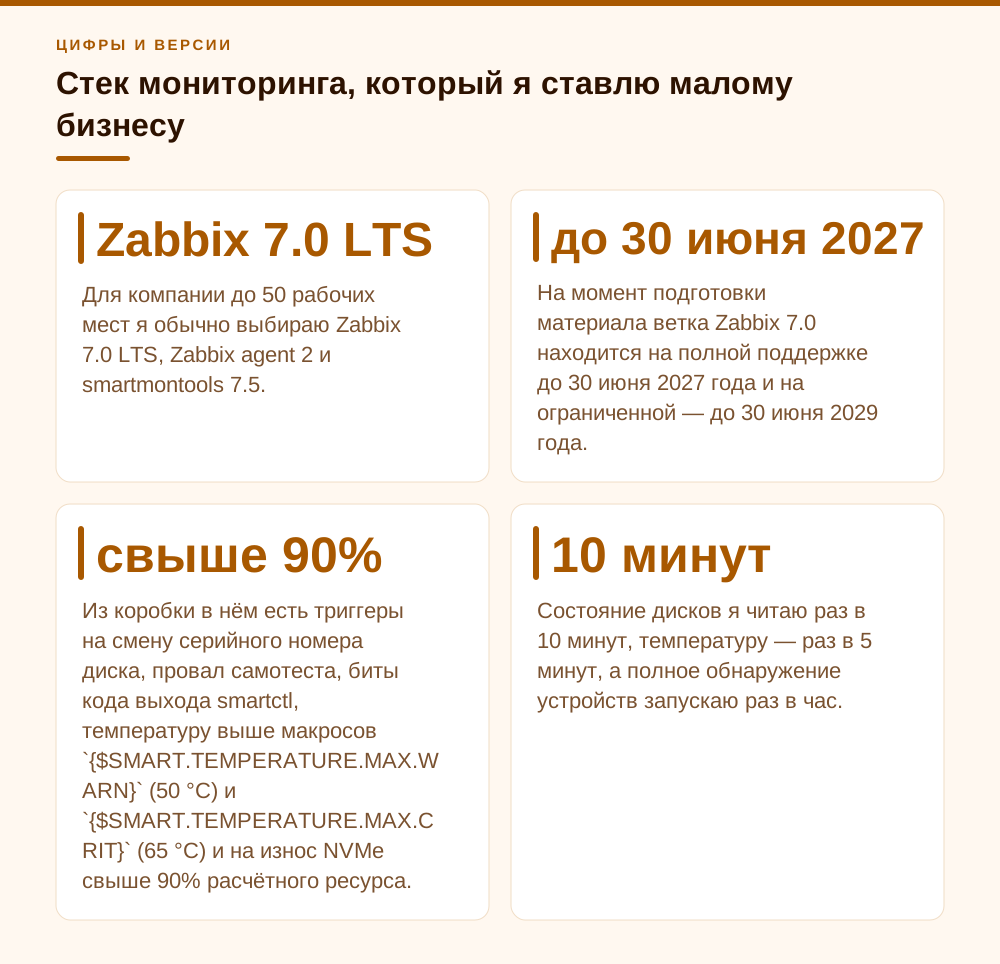
Для компании до 50 рабочих мест я обычно выбираю Zabbix 7.0 LTS, Zabbix agent 2 и smartmontools 7.5. На момент подготовки материала ветка Zabbix 7.0 находится на полной поддержке до 30 июня 2027 года и на ограниченной — до 30 июня 2029 года. Мне важнее предсказуемая LTS-ветка, чем функции очередного стандартного релиза; Zabbix 8.0 LTS производитель планирует на III квартал 2026 года, и переводить на неё рабочий мониторинг я буду не раньше первых патч-релизов. Встроенный шаблон SMART by Zabbix agent 2 работает через плагин smart агента, обнаруживает HDD, SSD и NVMe-диски и требует smartmontools не ниже 7.1. Из коробки в нём есть триггеры на смену серийного номера диска, провал самотеста, биты кода выхода smartctl, температуру выше макросов {$SMART.TEMPERATURE.MAX.WARN} (50 °C) и {$SMART.TEMPERATURE.MAX.CRIT} (65 °C) и на износ NVMe свыше 90 % расчётного ресурса.
Для библиотеки на 14 рабочих мест и даже для офиса в несколько десятков машин достаточно отдельной виртуальной машины с 2 vCPU, 4 Гбайт RAM и 40–60 Гбайт диска, если хранить подробную историю 30–90 дней и не опрашивать каждую метрику ежеминутно. Это моя практическая конфигурация, а не универсальное требование производителя. Итоговый размер зависит от количества метрик и срока хранения. Состояние дисков я читаю раз в 10 минут, температуру — раз в 5 минут, а полное обнаружение устройств запускаю раз в час.
На Linux агенту требуется право вызвать smartctl. Я не запускаю весь агент от root, а разрешаю конкретный исполняемый файл и проверяю конфигурацию от имени пользователя zabbix. Строка sudoers взята из официального описания интеграции; Plugins.Smart.Timeout допускает значения от 1 до 30 секунд. Файл конфигурации Zabbix должен быть в UTF-8 без BOM:
# /etc/zabbix/zabbix_agent2.d/plugins.d/smart.conf
Plugins.Smart.Path=/usr/sbin/smartctl
Plugins.Smart.Timeout=20

# /etc/sudoers.d/zabbix-smartctl
zabbix ALL=(ALL) NOPASSWD:/usr/sbin/smartctl
Правку sudoers делаю только через visudo -f /etc/sudoers.d/zabbix-smartctl, чтобы опечатка не лишила сервер sudo целиком. После этого выполняю sudo -u zabbix sudo -n /usr/sbin/smartctl --scan-open и привязываю официальный шаблон. На Windows sudo не нужен: агент работает как служба с правами администратора, достаточно указать путь к smartctl.exe. Если диски скрыты аппаратным RAID-контроллером, обычный /dev/sda покажет только логический том. Тогда нужен поддерживаемый интерфейс контроллера, например smartctl -x -d megaraid,0 /dev/sda, либо мониторинг через утилиту производителя. USB-корпуса тоже нередко блокируют часть SMART-команд — такой накопитель нельзя считать контролируемым только потому, что система видит его букву.
- Опрос SMART и температуры без минутного фанатизма
- Оповещение ответственному в мессенджер и дублирование по электронной почте
- Эскалация владельцу, если авария не подтверждена инженером за 30 минут
- Отдельная тревога при отсутствии данных от агента: молчащий мониторинг опаснее красного графика
Как я контролирую резервное копирование
Для файлового репозитория в этом классе проектов я использую restic 0.19.1: он шифрует данные, умеет проверять репозиторий и выдаёт пригодный для автоматизации JSON. Но программа не знает, получилась ли корректная выгрузка прикладной системы. Например, копировать работающие файлы MDF и LDF как обычные файлы нельзя. Для SQL Server сначала создаётся нативный BACKUP DATABASE с CHECKSUM, затем выполняется RESTORE VERIFYONLY, и только после этого файл попадает в restic.
У RESTORE VERIFYONLY есть честное ограничение: команда проверяет комплектность, читаемость и имеющиеся контрольные суммы, но не восстанавливает базу и не проверяет всю логическую структуру данных. Поэтому раз в месяц я поднимаю копию в изолированном экземпляре SQL Server, запускаю DBCC CHECKDB и открываю 1С тестовой учётной записью. Это дольше, зато после такой проверки можно говорить о восстановимости. На ежедневном задании запускаю sqlcmd с ключом -b: тогда любая ошибка с уровнем серьёзности выше 10 превращается в ненулевой код процесса. Ключ -V здесь не добавляю — он повышает порог, и ошибки уровней 11–15 перестали бы влиять на результат задания.
Само задание всегда отправляет в Zabbix статус и время последнего полного успеха. В Zabbix создаются trapper-метрики backup.chain.status, backup.chain.last_success, backup.bytes и backup.duration. Техническое имя в параметре -s должно точно совпадать с именем узла в Zabbix. Упрощённый PowerShell-каркас выглядит так:
$ErrorActionPreference = 'Stop'
$status = 1
$started = Get-Date
try {
    & sqlcmd.exe -S localhost -E -b -i 'C:/Backup/full-and-verify.sql'
    if ($LASTEXITCODE -ne 0) { throw "sqlcmd failed: $LASTEXITCODE" }

    & 'C:/Tools/restic.exe' backup 'D:/SQLDump' --host 'LIB-SRV01' --tag daily --json
    if ($LASTEXITCODE -ne 0) { throw "restic failed: $LASTEXITCODE" }
    $status = 0
}
catch {
    $_ | Out-File 'C:/Backup/last-error.log' -Encoding utf8
}
finally {
    & 'C:/Zabbix/zabbix_sender.exe' -c 'C:/Zabbix/zabbix_agent2.conf' -s 'LIB-SRV01' -k backup.chain.status -o $status
    if ($status -eq 0) {
        $epoch = [DateTimeOffset]::UtcNow.ToUnixTimeSeconds()
        & 'C:/Zabbix/zabbix_sender.exe' -c 'C:/Zabbix/zabbix_agent2.conf' -s 'LIB-SRV01' -k backup.chain.last_success -o $epoch
    }
}
exit $status
Пароль restic хранится в защищённом RESTIC_PASSWORD_FILE, а не в тексте сценария. В свойствах trapper-метрик заполняю поле «Allowed hosts», чтобы значения принимались только от сервера резервного копирования. Тревога срабатывает при статусе не ноль сразу и при отсутствии нового last_success дольше 26 часов для ежедневной копии.
Ключевой момент — триггер свежести строится именно по возрасту последнего успеха, а не по факту запуска. Если сценарий вообще не стартовал (выключен планировщик, истёк пароль служебной учётки, сервер перезагрузился в момент задания), статуса ошибки не будет, и тревога по коду выхода промолчит. Возраст же продолжит расти. В Zabbix 7.0 я задаю два триггера на один и тот же узел:
# Критический: ежедневной успешной копии нет больше 26 часов
now()-last(/LIB-SRV01/backup.chain.last_success)>26h

# Высокий: задание не присылало вообще никаких данных 26 часов
nodata(/LIB-SRV01/backup.chain.status,26h)=1
Функции now() и nodata() относятся к зависящим от времени, поэтому Zabbix пересчитывает такие триггеры периодически, а не только при поступлении нового значения. Запас в 26 часов вместо 24 оставлен на плавающую длительность ночного задания; для копий раз в четыре часа порог соответственно около пяти часов. Сразу после внедрения я один раз отправляю в last_success заведомо старое время и убеждаюсь, что тревога дошла до телефона дежурного.
Ежедневно я запускаю обычный restic check, а чтение данных распределяю командой restic check --read-data-subset=1/7 и последовательно меняю номер части от 1 до 7. Периодически всё равно нужен полный restic check --read-data. Неизвестный код завершения restic трактую как ошибку: документация прямо предупреждает, что набор кодов может расширяться. Отдельно контролирую объём: падение ниже 80 % медианы за 14 дней или двукратный рост длительности требует проверки, хотя задание формально завершилось успешно.
- Критическая тревога сразу: любой этап цепочки вернул ошибку
- Критическая тревога: возраст ежедневного бэкапа превысил 26 часов
- Предупреждение: размер отклонился более чем на 20 % от обычного диапазона
- Предупреждение: длительность выросла более чем вдвое
- Критическая тревога: проверка репозитория или тестовое восстановление завершились ошибкой
Практический стенд: городская библиотека «БиблиоГрад»
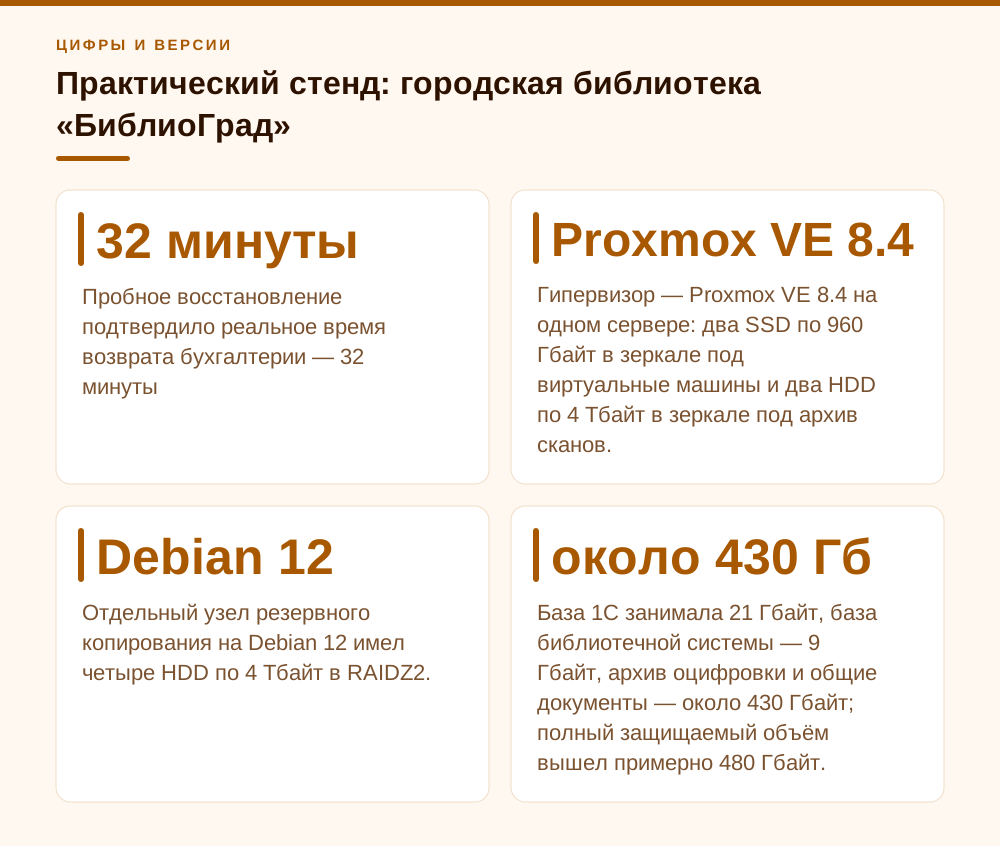
Название «БиблиоГрад» условное. Схема и проблемы собраны из моей практики, а показатели сведены в один обезличенный проект: городская библиотека с центральным зданием, двумя филиалами и 14 рабочими местами сотрудников. На сервере работали 1С:Бухгалтерия государственного учреждения на SQL Server 2022 Standard, база автоматизированной библиотечной системы с электронным каталогом и файловый архив оцифрованных краеведческих фондов. Гипервизор — Proxmox VE 8.4 на одном сервере: два SSD по 960 Гбайт в зеркале под виртуальные машины и два HDD по 4 Тбайт в зеркале под архив сканов. Отдельный узел резервного копирования на Debian 12 имел четыре HDD по 4 Тбайт в RAIDZ2.
База 1С занимала 21 Гбайт, база библиотечной системы — 9 Гбайт, архив оцифровки и общие документы — около 430 Гбайт; полный защищаемый объём вышел примерно 480 Гбайт. Полная копия SQL создавалась ночью, журналы транзакций — каждый час в рабочее время, файлы — дважды в сутки. Локальный restic-репозиторий за полгода вырос до 1,1 Тбайт; вторая зашифрованная копия уходила на отдельную площадку учётной записью без прав удаления старых объектов. Zabbix 7.0 LTS разместили на ВМ с 2 vCPU, 4 Гбайт RAM и 40 Гбайт системного диска — для полутора десятков узлов это с запасом.
Первый сюрприз нашли ещё до настройки SMART. Планировщик Windows девять ночей показывал успешное выполнение, но свежей полной копии базы 1С не было. В старом сценарии sqlcmd запускался без -b, ошибка нехватки места в промежуточной папке не превращалась в ошибку задания, а последняя команда сценария завершалась с нулём. Размер файла перестал меняться, но его никто не сравнивал с обычными 5,8–6,3 Гбайт после сжатия. Мы добавили строгую проверку кодов, CHECKSUM, RESTORE VERIFYONLY, контроль размера и отправку last_success. Теперь такая ситуация дала бы две тревоги: ненулевой статус сразу и просрочку через 26 часов.
Через 17 дней после запуска SMART-мониторинга у одного HDD узла резервного копирования Current Pending Sector вырос с 0 до 8, через 36 часов — до 31, а Offline Uncorrectable достиг 2. Общий SMART status ещё оставался PASSED. Длинный тест завершился ошибкой чтения, и диск заменили на следующий день, пока массив сохранял устойчивость к отказу ещё одного накопителя. За следующие 90 дней 89 ночных цепочек прошли с первой попытки; одна остановилась из-за заполненного staging-каталога, тревога пришла через три минуты, место освободили и задание перезапустили. Контрольное восстановление базы 1С объёмом 21 Гбайт заняло 9 минут, DBCC CHECKDB — ещё 4 минуты, а до входа бухгалтера в тестовую 1С прошло 32 минуты при целевом RTO в четыре часа. Именно эта цифра, а не число архивов в папке, стала для директора библиотеки понятным результатом.
- SMART помог заменить деградирующий HDD до потери устойчивости массива
- Контроль кода `sqlcmd` обнаружил ложный успех старого задания
- Сравнение размеров выявляет пустые и неполные выгрузки
- Пробное восстановление подтвердило реальное время возврата бухгалтерии — 32 минуты
- Независимая площадка сохранила копию вне основного контура администрирования
Что внедрять в первую очередь
Если бюджет ограничен, я начинаю не с большого дашборда. Сначала составляю список критичных данных и назначаю владельца каждой копии. Затем настраиваю тревогу по возрасту последнего успеха и проверяю одну ручную процедуру восстановления. Это закрывает самый опасный сценарий — месяцы ложного спокойствия. Следом подключаю SMART ко всем физическим дискам серверов и хранилищ, фиксирую серийные номера и проверяю, есть ли запасной накопитель подходящей модели.
Красивую визуализацию, прогнозирование температуры нейросетью и ежедневные отчёты руководству я откладываю на потом. Небольшой организации нужны три понятных события: «диск требует замены», «сегодняшней копии нет» и «копия не восстановилась». Для каждого события заранее записываю, кто получает сообщение, за сколько минут подтверждает его и что делает. Уведомление без ответственного быстро превращается в ещё один замьюченный чат.
Минимальный рабочий план укладывается в несколько дней: инвентаризация, Zabbix agent 2 со SMART-шаблоном, отправка результатов заданий через zabbix_sender, независимый репозиторий и первое тестовое восстановление. Через две недели корректируются пороги размера и длительности, через месяц проводится повторная учебная авария. После этого мониторинг становится процессом, а не установленной программой. И да, он иногда будет будить администратора зря. Это терпимые издержки. Молчаливый сорванный бэкап обходится значительно дороже.
- День 1: перечень систем, RPO, RTO и ответственных
- День 2: контроль возраста и кода завершения бэкапов
- День 3: SMART всех доступных физических накопителей
- День 4: проверка репозитория и независимой копии
- День 5: восстановление выбранной базы или папки в изолированный контур
- Через 14 дней: настройка порогов размера, температуры и длительности
- Ежемесячно: длинные SMART-тесты и контрольное восстановление
Частые вопросы
Можно ли доверять SMART status PASSED?
Только как одному из сигналов. Диск может отказать без предварительного предупреждения, а опасные сырые счётчики способны расти при ещё положительном общем статусе.
Нужно ли менять HDD после одного переназначенного сектора?
Не обязательно. Я проверяю динамику, журналы ошибок и длинный самотест. Рост pending или uncorrectable — уже веская причина готовить замену.
Достаточно ли команды RESTORE VERIFYONLY для SQL Server?
Нет. Она полезна для ежедневного контроля читаемости и checksum, но не заменяет периодическое реальное восстановление с DBCC CHECKDB и запуском приложения.
Как часто проверять репозиторий restic?
Метаданные — ежедневно, чтение данных можно распределить по дням. Полную проверку и пробное восстановление проводят по графику, согласованному с объёмом и доступным окном.
Что делать, если аппаратный RAID скрывает SMART?
Использовать поддерживаемый тип контроллера в smartctl или штатную утилиту производителя. Контроль только логического тома недостаточен.
Нужен ли отдельный сервер Zabbix небольшой компании?
Физический сервер обычно не нужен. Для десятков узлов достаточно небольшой отдельной ВМ, но её недоступность также должна контролироваться извне.
Почему тревога по возрасту бэкапа важнее тревоги по ошибке задания?
Если задание не запустилось совсем, ошибки не будет, а возраст последней успешной копии продолжит расти. Триггер now()-last(...)>26h ловит и сбой, и тихий пропуск запуска.
Хватит ли smartd без Zabbix?
Для одного-двух серверов да: DEVICESCAN с -a, расписанием самотестов и отправкой писем закрывает базовый контроль. Но проверьте доставку через -M test и помните, что сам smartd никто не контролирует на предмет молчания.
Источники
- smartmontools: smartctl manual и релиз 7.5 — smartctl(8): назначение SMART, параметры -H, -x, -j, -t, журналы самотестов, RAID-типы и битовая маска exit status. Версия 7.5. https://github.com/smartmontools/smartmontools/blob/main/src/smartctl.8.in ; релиз: https://github.com/smartmontools/smartmontools/releases/tag/RELEASE_7_5
- smartmontools: smartd.conf(5) — Справка по директивам smartd.conf: -a (включая -C 197 -U 198 для ATA), -o, -S, -n standby, -s T/MM/DD/d/HH, -R ID!, -W DIFF,INFO,CRIT, -m, -M exec/test, DEVICESCAN, -d megaraid,N, проверка NVMe Critical Warning через -H. https://github.com/smartmontools/smartmontools/blob/main/src/smartd.conf.5.in
- Zabbix: интеграция SMART — Официальный шаблон SMART by Zabbix agent 2: HDD, SSD и NVMe, smartmontools 7.1 или новее, строка sudoers zabbix ALL=(ALL) NOPASSWD:/usr/sbin/smartctl, макросы температуры 50/65 °C, триггер износа NVMe свыше 90 %. https://www.zabbix.com/integrations/smart
- Zabbix 7.0: плагин SMART агента 2 — Zabbix agent 2 plugins — SMART: параметры Plugins.Smart.Path и Plugins.Smart.Timeout (1–30 с), требование UTF-8 без BOM. https://www.zabbix.com/documentation/7.0/en/manual/appendix/config/zabbix_agent2_plugins/smart_plugin
- Zabbix 7.0 LTS: жизненный цикл — Zabbix Life Cycle and Release Policy: полная поддержка 7.0 LTS до 30.06.2027, ограниченная до 30.06.2029; 8.0 LTS запланирована на III квартал 2026. https://www.zabbix.com/life_cycle_and_release_policy
- Zabbix sender 7.0 — Официальное руководство Sender: ключи -z, -s, -k, -o, отправка данных в trapper item. https://www.zabbix.com/documentation/7.0/en/manual/concepts/sender
- restic 0.19.1: резервное копирование и коды возврата — Официальная документация, разделы Backing up и Scripting: планирование заданий, JSON и exit status. https://restic.readthedocs.io/en/stable/040_backup.html ; https://restic.readthedocs.io/en/stable/075_scripting.html — таблица кодов выхода и требование считать неизвестный код ошибкой.
- restic 0.19.1: проверка и восстановление — Официальная документация, разделы Working with repositories и Restoring from backup: check, --read-data, --read-data-subset и restore. https://restic.readthedocs.io/en/stable/045_working_with_repos.html ; https://restic.readthedocs.io/en/stable/050_restore.html
- Microsoft SQL Server: проверка резервной копии — RESTORE VERIFYONLY: проверяет комплектность и читаемость, но не структуру данных внутри backup volumes. https://learn.microsoft.com/en-us/sql/t-sql/statements/restore-statements-verifyonly-transact-sql?view=sql-server-ver17
- Microsoft SQL Server: контрольные суммы и sqlcmd — Enable or disable backup checksums и sqlcmd utility, параметр -b (ERRORLEVEL 1 при ошибке с severity выше 10) и -V (порог severity). https://learn.microsoft.com/en-us/sql/relational-databases/backup-restore/enable-or-disable-backup-checksums-during-backup-or-restore-sql-server?view=sql-server-ver17 ; https://learn.microsoft.com/en-us/sql/tools/sqlcmd/sqlcmd-utility?view=sql-server-ver17
- NIST: резервные копии должны проверяться — Protecting Data from Ransomware and Other Data Loss Events: рекомендации проводить, поддерживать и тестировать резервное копирование. https://csrc.nist.gov/pubs/other/2020/04/24/protecting-data-from-ransomware-and-other-data-los/final