
Двухузловой Hyper-V-кластер для офиса до 50 мест: как я его строю и проверяю отказами
Hyper-V Failover Cluster из двух узлов нужен, когда час простоя сервера стоит дороже второго хоста, коммутаторов и двухконтроллерной СХД. Он сокращает простой после отказа железа до минут, но не заменяет резервные копии. Ниже — моя схема для офиса до 50 рабочих мест, команды, расчёт памяти N+1 и протокол приёмки на разборе швейного производства.
Когда двухузловой Hyper-V-кластер оправдан, а когда хватит одного сервера
Failover Cluster решает ровно две задачи. При плановом обслуживании Live Migration переносит работающую виртуальную машину на второй узел практически без перерыва. При аварии узла кластер заново запускает его виртуальные машины на оставшемся сервере. Во втором случае короткий простой будет всегда: гостевой ОС нужно загрузиться, службам — стартовать. Это высокая доступность, а не отказоустойчивость без единой потерянной секунды, и я прямо говорю об этом директору до подписания сметы. Если вы выбираете, кому доверить такой проект вместе с последующим сопровождением, посмотрите, как у нас устроен ИТ-аутсорсинг для небольших компаний: кластер без регламента обслуживания деградирует за год.
Кластер не спасает от шифровальщика, повреждённой базы, случайно удалённой папки, пожара в серверной и отказа самой общей СХД. Человеческая ошибка в кластере вообще размножается идеально: удалённый файл исчезает сразу для обоих узлов. Поэтому я никогда не ставлю кластер в смету вместо резервного копирования. Порядок у меня один: сначала договариваемся о RPO и RTO, строим независимые резервные копии с проверенным восстановлением, и только потом сокращаем время восстановления после отказа железа.
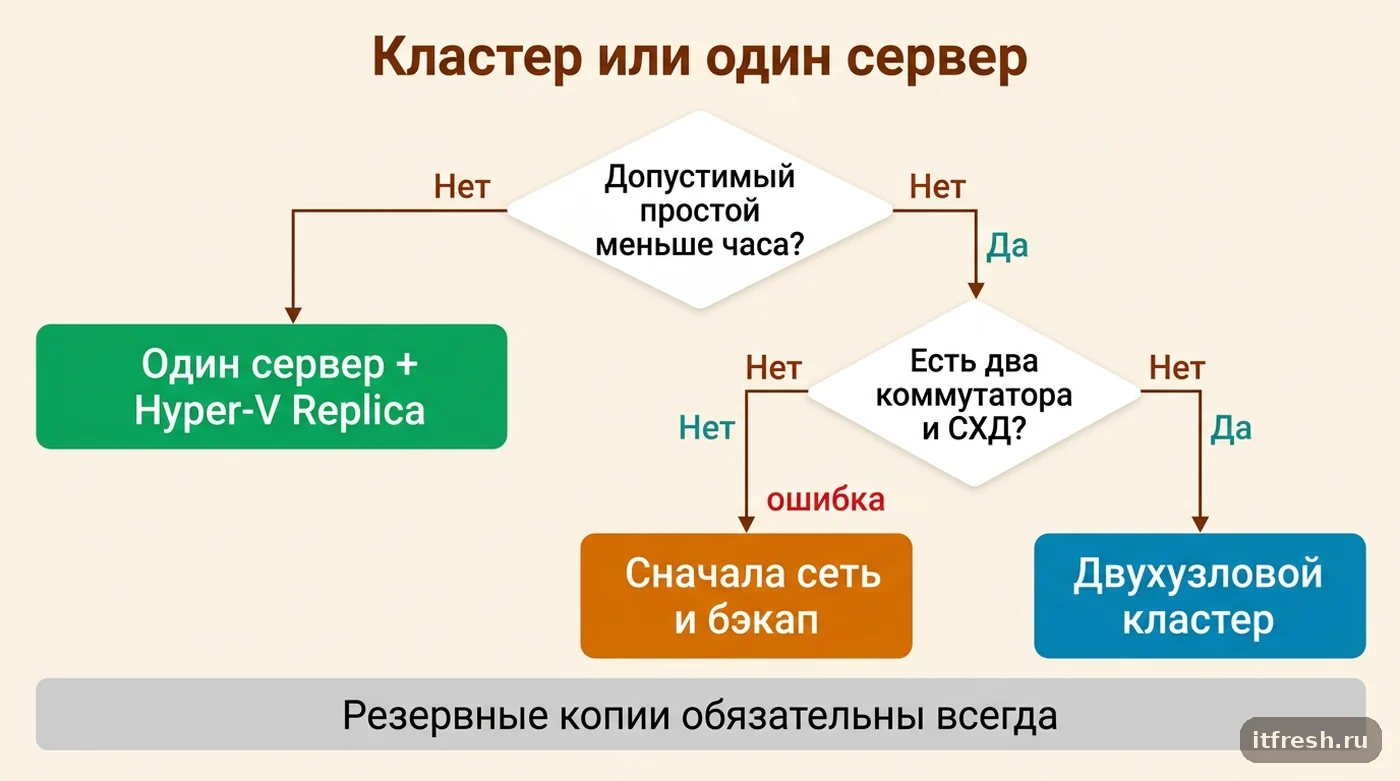
Решение о кластере я принимаю не по числу компьютеров, а по цене простоя. Если без сервера встают продажи, производство и склад, а допустимый простой измеряется минутами, два узла оправданы. Если бизнес переживёт четыре часа восстановления, я честно предлагаю один хороший сервер, отдельный репозиторий резервных копий и второй хост с Hyper-V Replica. Это заметно дешевле, хотя переключение реплики выполняется руками по регламенту. Сравнение с альтернативной платформой я разбирал отдельно в статье про кластер виртуализации Proxmox VE — для части офисов она проще и дешевле по лицензиям.
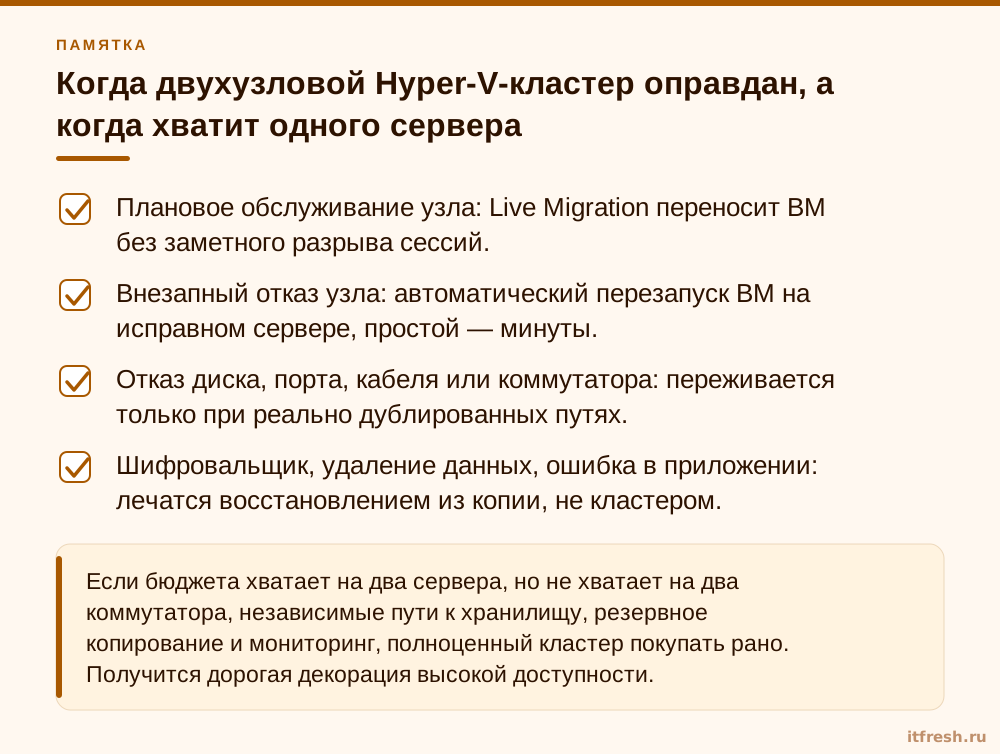
- Плановое обслуживание узла: Live Migration переносит ВМ без заметного разрыва сессий.
- Внезапный отказ узла: автоматический перезапуск ВМ на исправном сервере, простой — минуты.
- Отказ диска, порта, кабеля или коммутатора: переживается только при реально дублированных путях.
- Шифровальщик, удаление данных, ошибка в приложении: лечатся восстановлением из копии, не кластером.
Какую схему я выбираю: узлы, сеть, iSCSI и свидетель
Для нового проекта в 2026 году я беру Windows Server 2025, если поставщик прикладного ПО подтвердил совместимость. По официальному жизненному циклу основная поддержка этой версии действует до ноября 2029 года, расширенная — до ноября 2034-го. Узлы делаю одинаковыми: одна модель платформы и процессора, одинаковые версии BIOS, прошивок RAID-контроллеров и сетевых карт. В Windows Server 2025 появился динамический режим совместимости процессоров для ВМ с версией конфигурации 10.0 и выше: кластер сам вычисляет общий набор инструкций для всех узлов. Полезная функция, но я не использую её как оправдание для разнородного нового кластера — она нужна при расширении и замене железа.
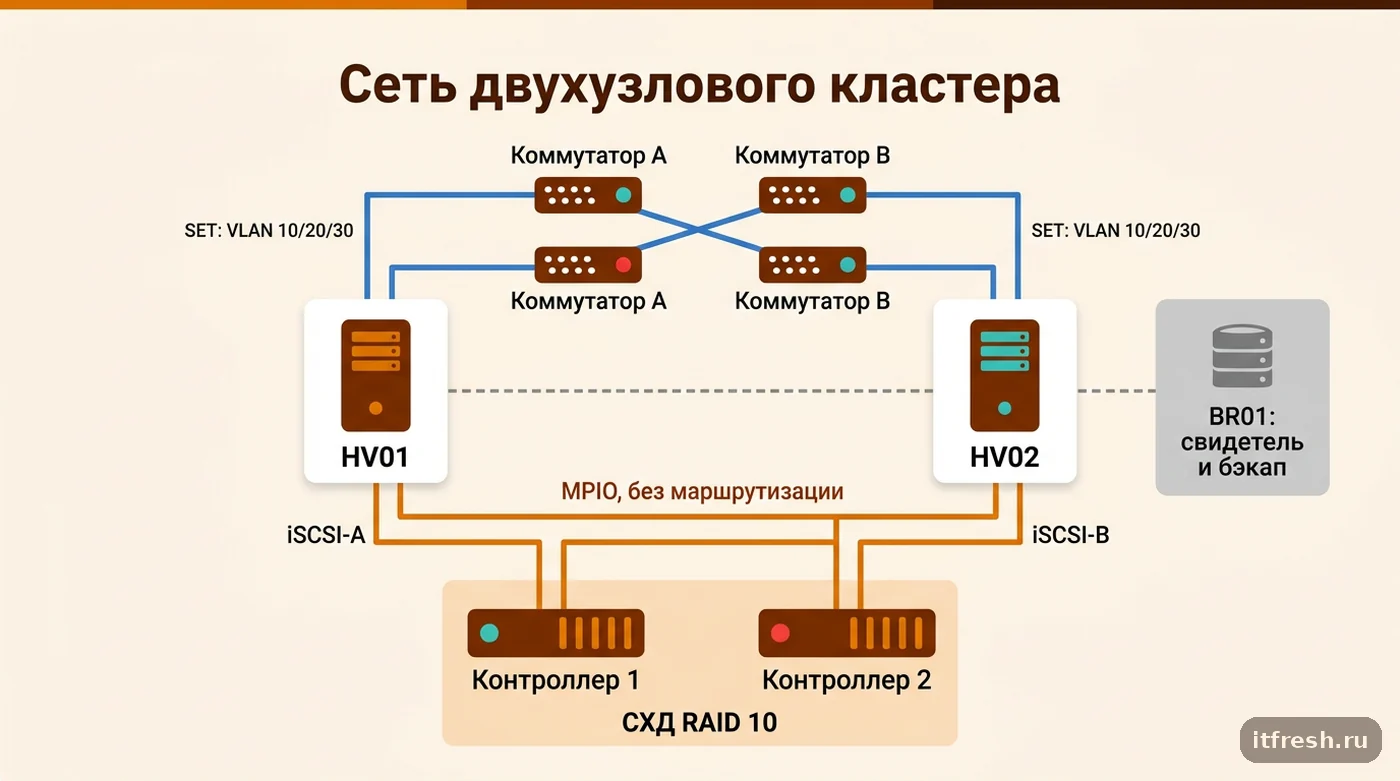
Базовая схема — два узла и двухконтроллерная iSCSI-СХД. У каждого узла два выделенных 10-гигабитных порта под iSCSI, разведённых через два физических коммутатора. Ещё два 10-гигабитных порта объединены в Switch Embedded Teaming (SET): поверх него в отдельных VLAN идут управление, Live Migration и трафик виртуальных машин. Порт BMC (iDRAC, iLO, XCC) подключён отдельно. Если ломается один контроллер СХД, порт, кабель или коммутатор, доступ к LUN сохраняется через MPIO по второму пути.
Сети iSCSI я не включаю в SET, не маршрутизирую и запрещаю на них кластерный трафик: Microsoft в обзоре CSV прямо рекомендует отключать iSCSI-сети для кластерного взаимодействия, чтобы по ним не пошёл трафик CSV. Для небольшого офиса я сознательно не тащу в проект RDMA, SR-IOV и Storage Spaces Direct: для полудюжины умеренных ВМ они добавят больше требований к железу и квалификации, чем пользы. Двухконтроллерная СХД остаётся общей точкой отказа на уровне устройства, но её поведение понятно небольшой службе эксплуатации, а отказ всей СХД закрывается резервным копированием на отдельный сервер.
Свидетель кворума для двух узлов обязателен. Варианты — диск-свидетель, файловый ресурс (File Share Witness) или Cloud Witness в Azure. В российских реалиях я почти всегда выбираю SMB-папку на отдельном физическом сервере — обычно на том же сервере резервного копирования, но с другим питанием и без пользовательских данных. Главное правило: свидетель не должен жить внутри того же кластера, иначе при проблеме с узлами он исчезнет вместе с ними.
- Management: VLAN 10, узлы 10.20.10.11 и 10.20.10.12, имя кластера — 10.20.10.20.
- Live Migration: VLAN 20, 10.20.20.11 и 10.20.20.12, без шлюза и без регистрации в DNS.
- Виртуальные машины: VLAN 30 и 40 через SET-коммутатор.
- iSCSI: сети 172.16.101.0/24 и 172.16.102.0/24, без шлюза, DNS и объединения портов, кластерный трафик запрещён.
- Кворум: SMB-папка \\BR01\HVC01-Witness на сервере резервного копирования, вне кластера.
Разбор проекта: швейное производство «ПошивГрад», 47 рабочих мест
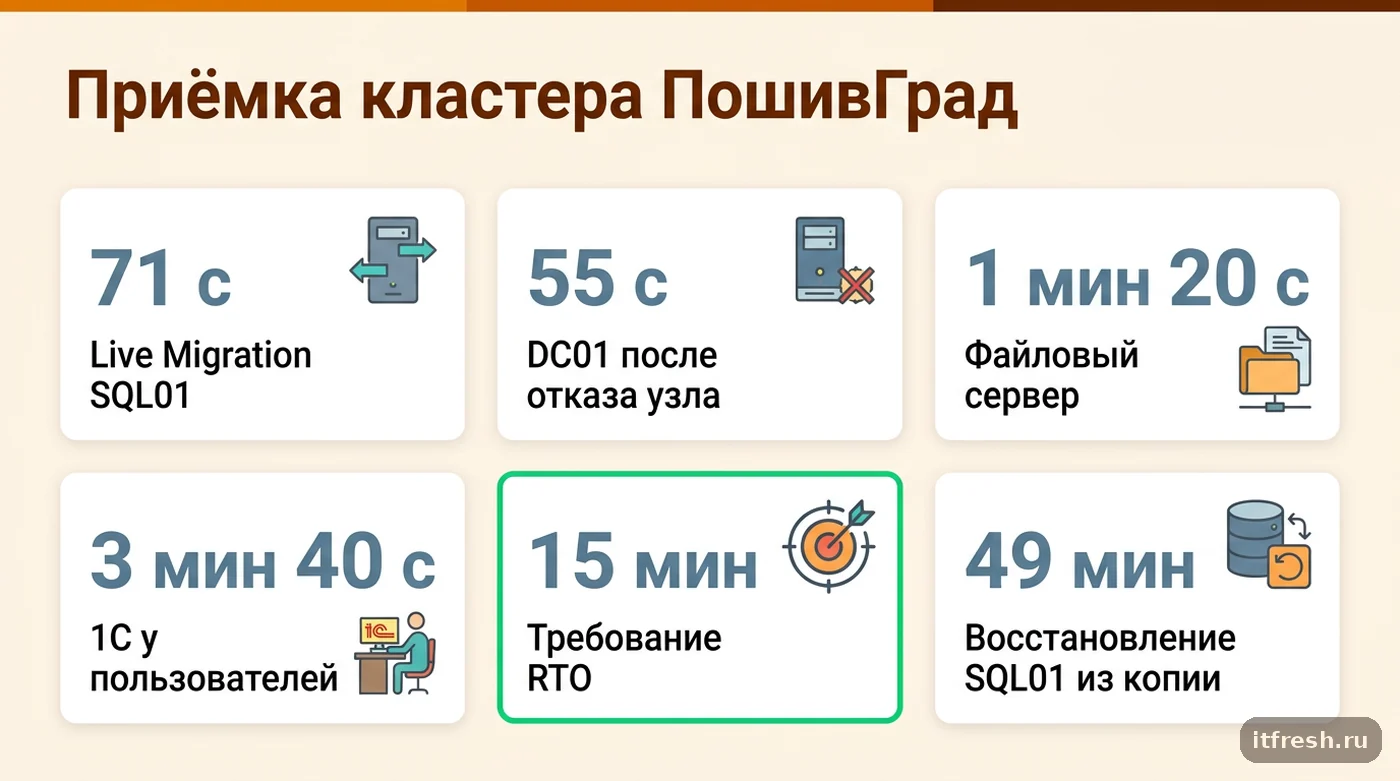
Условный клиент — пошивочное предприятие «ПошивГрад»: 47 рабочих мест, из них 12 — конструкторы и технологи с САПР лекал, остальные — офис, склад и мастера цехов. До модернизации шесть ВМ жили на одном хосте Windows Server 2016 с 96 ГБ RAM и SATA RAID 5. Обычная задержка диска держалась на 7–12 мс, во время ночного копирования доходила до 80 мс. Отказ хоста означал три-шесть часов восстановления, а однажды из-за сгоревшего блока питания цех раскроя простоял полдня без выгрузки заданий. После этого директор сформулировал требования сам: RTO 15 минут, RPO 4 часа.
Мы поставили два узла Windows Server 2025 Datacenter в варианте Server Core. В каждом — один Intel Xeon Silver 4510 (12 ядер, 24 потока), 256 ГБ ECC RAM, два SSD по 960 ГБ в RAID 1 под ОС и четыре порта 10GbE. Общая СХД — два контроллера и восемь enterprise SSD по 1,92 ТБ в RAID 10. Из 7,68 ТБ полезной ёмкости под CSV выделили 5,5 ТБ и отформатировали в NTFS. Для SAN-тома это принципиально: Microsoft предупреждает, что CSV с ReFS поверх SAN не использует Direct I/O и работает в перенаправленном режиме, то есть запись идёт через узел-координатор.
На кластере разместили шесть ВМ поколения 2: DC01 и DC02 по 2 vCPU и 4 ГБ, FILE01 с лекалами и архивом моделей — 4 vCPU и 16 ГБ, SQL01 под базы 1С — 8 vCPU и 48 ГБ статической памяти, APP1C01 с сервером 1С — 6 vCPU и 24 ГБ, RDS01 для удалённых технологов и склада — 8 vCPU и 32 ГБ. Итого 128 ГБ гостевой памяти. На одном узле остаётся около 110 ГБ сверх ВМ и нужд хоста, поэтому при отказе соседа все машины помещаются на оставшийся. Это принцип N+1: считать надо не нормальный режим, а худший.
Первый полный Test-Cluster показал предупреждения по сети: на серверах для iSCSI стоял MTU 9000, а один порт второго коммутатора остался на 1500. Гоняться за несколькими процентами производительности мы не стали и вернули весь тракт к 1500. После этого валидация прошла, задержка хранения под рабочей нагрузкой держалась в пределах 0,7–1,6 мс. Закрытие месяца в 1С ускорилось с 41 до 17 минут, но это заслуга новых процессоров и SSD, а не кластера как такового, и в отчёте директору я написал это отдельной строкой.
- Сервер резервного копирования BR01: 16 ТБ под копии и отдельная SMB-папка свидетеля.
- Данные на момент миграции — 1,4 ТБ, заполнение CSV после переноса — 2,3 ТБ.
- Копии ВМ каждые 4 часа, ежедневная зашифрованная копия вне серверной.
- Контрольное восстановление SQL01 в изолированную сеть — 49 минут.
- Срок проекта: 3 недели от закупки до приёмки, миграция — два выходных дня.
Как собрать и провалидировать кластер: команды PowerShell
На обоих узлах включаю роли Hyper-V, Failover Clustering и MPIO, ставлю одинаковые накопительные обновления, прошивки и драйверы, ввожу узлы в домен. Для Hyper-V нужны 64-разрядный процессор с SLAT, аппаратная виртуализация и DEP. Microsoft поддерживает кластерное решение, когда полный набор тестов валидации пройден на совместимом оборудовании, поэтому Test-Cluster я запускаю до создания кластера и после каждой значимой правки. Имена дисков перед добавлением сверяю вручную: слепой запуск таких команд на рабочем сервере недопустим.
Install-WindowsFeature -Name Hyper-V,Failover-Clustering,Multipath-IO -IncludeManagementTools -Restart
Enable-MSDSMAutomaticClaim -BusType iSCSI

Test-Cluster -Node HV01,HV02
New-Cluster -Name HVC01 -Node HV01,HV02 -StaticAddress 10.20.10.20 -NoStorage
Get-ClusterAvailableDisk | Add-ClusterDisk
Add-ClusterSharedVolume -Name "Cluster Disk 1"
Set-ClusterQuorum -Cluster HVC01 -FileShareWitness "\\BR01\HVC01-Witness"
(Get-ClusterNetwork -Cluster HVC01 -Name "iSCSI-A").Role = 0
(Get-ClusterNetwork -Cluster HVC01 -Name "iSCSI-B").Role = 0
Get-ClusterSharedVolumeState
Роль 0 у кластерной сети означает «не использовать для кластерного взаимодействия» — так iSCSI остаётся чистой сетью хранения. Get-ClusterSharedVolumeState показывает по каждому узлу, идёт ли ввод-вывод напрямую или через перенаправление; после приёмки там должно быть Direct.
SET на каждом узле создаю только при доступном BMC или локальной консоли: ошибка в имени адаптера немедленно отрезает управление. Для стенда основа выглядела так.
New-VMSwitch -Name "SET-Prod" -NetAdapterName "Prod01","Prod02" -EnableEmbeddedTeaming $true -AllowManagementOS $false
Add-VMNetworkAdapter -ManagementOS -Name "Mgmt" -SwitchName "SET-Prod"
Add-VMNetworkAdapter -ManagementOS -Name "LiveMigration" -SwitchName "SET-Prod"
Set-VMNetworkAdapterVlan -ManagementOS -VMNetworkAdapterName "Mgmt" -Access -VlanId 10
Set-VMNetworkAdapterVlan -ManagementOS -VMNetworkAdapterName "LiveMigration" -Access -VlanId 20
Set-DnsClient -InterfaceAlias "vEthernet (LiveMigration)" -RegisterThisConnectionsAddress $false
Set-VMHost -ComputerName HV01,HV02 -VirtualMachineMigrationPerformanceOption Compression
Для двух 10GbE-портов без RDMA я оставляю Compression: она проста и предсказуема. Вариант SMB выбираю, когда есть корректно настроенные SMB Multichannel и RDMA. Трафик миграции в настройках кластера разрешаю только по предназначенной для него сети.
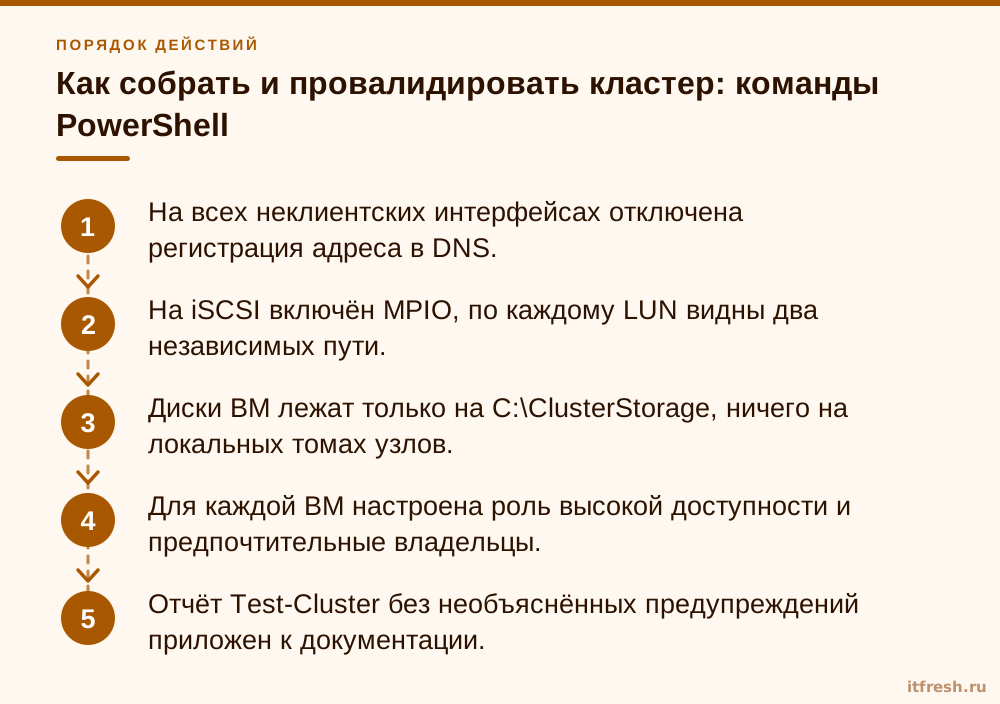
Финальный HTML-отчёт Test-Cluster сохраняю в исполнительную документацию. Жёлтый результат не считаю автоматически допустимым: каждое предупреждение получает письменное объяснение — почему оно безопасно или что исправлено. Отдельно проверяю MPIO: по каждому LUN должно быть по два активных сеанса, через разные коммутаторы и разные контроллеры СХД. Один сеанс при четырёх подключённых кабелях — самая частая скрытая мина, которую я нахожу у чужих кластеров.
- На всех неклиентских интерфейсах отключена регистрация адреса в DNS.
- На iSCSI включён MPIO, по каждому LUN видны два независимых пути.
- Диски ВМ лежат только на C:\ClusterStorage, ничего на локальных томах узлов.
- Для каждой ВМ настроена роль высокой доступности и предпочтительные владельцы.
- Отчёт Test-Cluster без необъяснённых предупреждений приложен к документации.
Где двухузловой кластер ломается чаще всего
Первая ошибка — купить два сервера, но оставить один коммутатор, один контроллер хранения и один ИБП. Я физически прослеживаю каждый путь: порт узла, кабель, коммутатор, порт СХД, контроллер, линия питания. Если два якобы независимых канала сходятся в одном устройстве, отказоустойчивости там нет, как бы красиво ни выглядела схема в Visio.
Вторая — заполнить оба узла на 70–80 процентов памяти. Пока узлы работают вместе, мониторинг зелёный. После отказа одного оставшийся не может запустить все ВМ, и кластер честно оставляет часть ролей выключенными. Я сначала раскладываю полную нагрузку на один узел и только остаток называю запасом. Динамическая память подходит не всем: серверу MS SQL под 1С я выделяю статическую память, иначе рискую получить непредсказуемое поведение кэша буферов. Про особенности резервирования центрального сервера и сервисов кластера 1С я писал отдельно — на уровне гипервизора эту задачу целиком не закрыть.
Третья — свидетель внутри того же кластера или его отсутствие. Для двух узлов без свидетеля потеря одного узла или связи между ними может остановить весь кластер. Четвёртая — автоматическая установка обновлений на обоих узлах с одновременной перезагрузкой. Я использую Cluster-Aware Updating либо ручной цикл: перевести узел в обслуживание с переносом ролей, обновить, перезагрузить, проверить, вернуть, и только потом трогать второй. Контрольная точка перед обновлением приложения допустима как краткоживущий откат, но даже production checkpoint не заменяет резервную копию.
Пятая — лицензирование, о котором вспоминают после покупки. Windows Server 2025 Standard при лицензировании по ядрам даёт права на две виртуальные ОС на полностью лицензированный сервер, минимум 16 ядер на сервер и 8 на процессор. Раз при отказе все ВМ могут оказаться на одном узле, каждый узел лицензируется под полный набор. Для шести ВМ «ПошивГрада» Standard пришлось бы брать трижды на каждый узел, поэтому мы посчитали и выбрали Datacenter. Окончательную схему всегда сверяйте с актуальным Licensing Guide и своим каналом закупки.
- Разные версии BIOS, драйверов и параметров разгрузки сетевых карт на узлах.
- Один iSCSI-сеанс, хотя кабелей подключено несколько.
- Шлюз или DNS-регистрация на интерфейсах iSCSI и Live Migration.
- Необъяснённые предупреждения Test-Cluster, оставленные «на потом».
- Резервные копии на том же CSV и ни одного пробного восстановления.
Как принять кластер: тесты отказов и регламент обслуживания
Приёмку я начинаю с плановой миграции каждой работающей ВМ между узлами. SQL01 с 48 ГБ памяти переехал за 71 секунду, сеансы 1С у пользователей не разорвались. Затем мы по очереди отключили каждый iSCSI-путь, один коммутатор и один контроллер СХД. LUN оставался доступным, CSV не уходил в перенаправление надолго, в MPIO сохранялись рабочие пути. Все тесты с временем и скриншотами идут в протокол, который подписывает заказчик.
После подтверждения свежей резервной копии провели аварийный тест: выключили питание активного HV01 без предварительного переноса ролей. Это уже не Live Migration, а перезапуск. Кластер обнаружил потерю узла и поднял ВМ на HV02. DC01 отвечал через 55 секунд, файловый сервер — через 1 минуту 20 секунд, 1С полностью открылась у пользователей через 3 минуты 40 секунд. Требование RTO 15 минут выполнено с запасом, и главное — теперь это измеренная цифра, а не обещание. Для сравнения похожий сценарий с другим клиентом я описывал в разборе отказоустойчивого кластера для бухгалтерской фирмы.
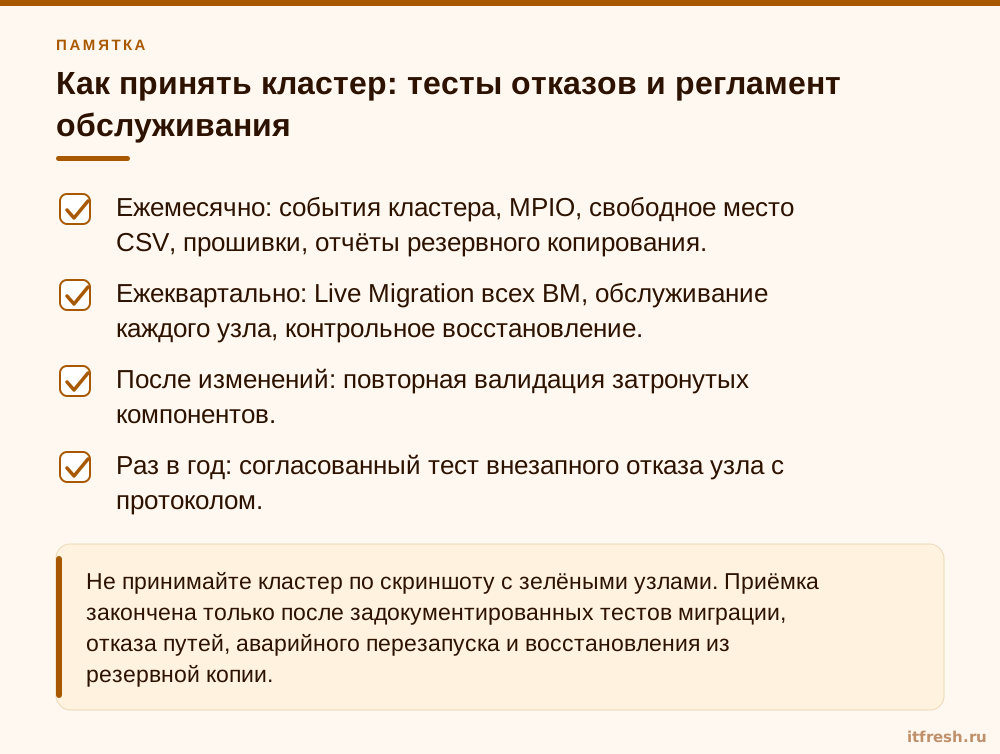
На этом работа не заканчивается. Ежемесячно мы проверяем события кластера, состояние узлов, CSV, MPIO, СХД, ИБП и заданий резервного копирования. Раз в квартал переносим все роли и восстанавливаем выбранную ВМ в изолированную сеть. После изменений сети, хранилища или прошивок запускаем соответствующие тесты Test-Cluster, а полный тест хранения на рабочем кластере планируем отдельно — он влияет на нагрузку. Базовые операции с машинами — создание, контрольные точки, миграцию — я собрал в статье про виртуальные машины Hyper-V на Windows Server.
Мой итог для «ПошивГрада»: двухузловой кластер оправдан, потому что полдня простоя цеха раскроя обходятся дороже дублированной инфраструктуры и её сопровождения. Но покупать кластер ради слова «кластер» не стоит. Главные вложения здесь не в мастер Failover Cluster Manager, а в N+1 по памяти, независимые пути, проверяемые резервные копии и регулярные аварийные учения.
- Ежемесячно: события кластера, MPIO, свободное место CSV, прошивки, отчёты резервного копирования.
- Ежеквартально: Live Migration всех ВМ, обслуживание каждого узла, контрольное восстановление.
- После изменений: повторная валидация затронутых компонентов.
- Раз в год: согласованный тест внезапного отказа узла с протоколом.
Частые вопросы
Можно ли собрать Hyper-V-кластер из двух обычных компьютеров?
Для лаборатории — да. Для бизнеса я так не делаю: нужны ECC-память, серверные накопители, резервирование питания и сети, удалённое управление через BMC, одинаковые прошивки и оборудование, которое проходит полный Test-Cluster.
Обязательно ли покупать общую СХД?
Нет. Есть Storage Spaces Direct, а для аварийного восстановления без общего хранилища — Hyper-V Replica. Но это другие архитектуры со своими требованиями. Для небольшого предсказуемого кластера я чаще выбираю двухконтроллерную iSCSI-СХД с MPIO.
Какой свидетель кворума выбрать для двух узлов?
Без свидетеля двухузловой кластер не ставлю. В российских офисах чаще всего это File Share Witness — SMB-папка на отдельном физическом сервере вне кластера, например на сервере резервного копирования. Cloud Witness требует подписки Azure.
Сколько лицензий Windows Server нужно на кластер?
Каждый узел лицензируется под все ВМ, которые могут на нём оказаться после отказа соседа. Standard даёт две виртуальные ОС на полностью лицензированный сервер (минимум 16 ядер), поэтому при пяти-шести ВМ обычно выгоднее Datacenter. Итог сверяйте с актуальным Licensing Guide.
Сколько длится переключение при отказе узла?
При плановой Live Migration пользователи перерыва обычно не замечают. После внезапного отказа ВМ запускаются заново, и реальное время — от одной до нескольких минут в зависимости от загрузки ОС и приложений. Его нужно измерить на приёмочных испытаниях.
Источники
- Microsoft Learn — Create a failover cluster — Порядок валидации (Test-Cluster) и создания кластера, New-Cluster: https://learn.microsoft.com/en-us/windows-server/failover-clustering/create-failover-cluster
- Microsoft Learn — Cluster Shared Volumes overview — NTFS для SAN-томов, ReFS на SAN — перенаправленный ввод-вывод без Direct I/O, отключение iSCSI-сетей для кластерного трафика, Get-ClusterSharedVolumeState: https://learn.microsoft.com/en-us/windows-server/failover-clustering/failover-cluster-csvs
- Microsoft Learn — Deploy a quorum witness — Типы свидетеля (диск, файловый ресурс, Cloud Witness) и Set-ClusterQuorum -FileShareWitness: https://learn.microsoft.com/en-us/windows-server/failover-clustering/deploy-quorum-witness
- Microsoft Learn — Processor compatibility for Hyper-V virtual machines — Динамический режим совместимости процессоров в Windows Server 2025 для ВМ с версией конфигурации 10.0 и выше: https://learn.microsoft.com/en-us/windows-server/virtualization/hyper-v/processor-compatibility-mode
- Microsoft Learn — Windows Server 2025 lifecycle — Даты поддержки: основная до 14.11.2029, расширенная до 15.11.2034: https://learn.microsoft.com/en-us/lifecycle/products/windows-server-2025
- Microsoft Learn — Cluster-Aware Updating requirements and best practices — Поочерёдное обновление узлов кластера: https://learn.microsoft.com/en-us/windows-server/failover-clustering/cluster-aware-updating-requirements