
Zabbix 7.4 перестал опрашивать по SNMPv3 после перезагрузки роутера, а snmpwalk работает: engineBoots и кэш SNMP
Роутер перезагрузили ночью по регламенту. Утром половина сетевых графиков — плоская линия. Хост пингуется, snmpwalk с того же самого сервера отдаёт всё дерево за полсекунды, логин, ключи и пароли никто не трогал. А штатный опрос не восстанавливается ни через час, ни через сутки. Это не авария сети и не ошибка в реквизитах — это состояние SNMPv3-сеанса, залипшее в памяти опрашивающего демона. Ниже — как отличить эту ситуацию от настоящего сбоя за десять минут, почему она лечится одной командой, а не перезапуском всего мониторинга, и что сделать, чтобы она не повторялась после каждого планового обновления прошивки.
«snmpwalk отвечает, Zabbix молчит» — значит, дело не в реквизитах и не в сети
Сценарий всегда один и тот же. Ночью обновили прошивку на маршрутизаторе или в серверной моргнуло питание. Утром в Zabbix по этому хосту — тайм-ауты, элементы данных валятся в unsupported, зависимые метрики пустые. Дежурный делает первое, что приходит в голову: заходит на сервер Zabbix и выполняет snmpwalk теми же самыми реквизитами, что прописаны в интерфейсе хоста. И snmpwalk проходит. Мгновенно, полностью, без единой ошибки. После этого рождается вывод «Zabbix глючит», сервис перезапускают — и всё действительно чинится. Так на объекте появляется поверье, что мониторинг «подтекает» и его надо рестартовать раз в неделю по расписанию.
На самом деле snmpwalk здесь — обманчивый тест, и вот почему. Каждый запуск snmpwalk — это новый процесс с абсолютно пустой локальной базой состояния (в терминах RFC 3414 — Local Configuration Datastore). Он с нуля делает discovery-обмен с устройством, узнаёт его engineID, engineBoots и engineTime и принимает их такими, какие они пришли. Ему нечего с чем сравнивать, поэтому он всегда прав. Zabbix-сервер и Zabbix-прокси — долгоживущие демоны. Они кэшируют состояние SNMP-сеанса и держат его в памяти между опросами. Как только кэшированные значения разошлись с реальностью в неправильную сторону, опрос ломается — навсегда, до очистки кэша.
Причём это не баг Zabbix, а прямое следствие того, как устроена модель безопасности USM. И в документации Zabbix это прописано открытым текстом: некоторые устройства не сохраняют значение engineBoots между перезагрузками, как того требует RFC 3414, из-за чего SNMP-сообщения после рестарта устройства начинают отбрасываться как устаревшие. Там же указан и штатный способ лечения — очистить SNMP-кэш параметром -R snmp_cache_reload либо перезапустить демон сервера или прокси. То есть производитель знает о проблеме и дал ручку. Просто про эту ручку почти никто не знает.
- хост доступен по ICMP, порт 161/UDP открыт, ACL не менялись
- snmpwalk и snmpget с того же самого хоста, где крутится опросчик, проходят штатно
- в Zabbix элементы данных именно этого хоста висят в тайм-ауте или в unsupported
- проблема началась ровно в момент рестарта устройства, а не постепенно
- перезапуск zabbix-server всё чинит — и это главная улика, а не решение
Что происходит внутри: engineBoots, окно 150 секунд и правило «только вверх»
SNMPv3 защищается от повторного проигрывания перехваченных пакетов не таймстампом с часов, а собственным счётчиком времени жизни устройства. Каждое устройство-«авторитет» (в нашем случае роутер или коммутатор) хранит три значения: snmpEngineID — свой уникальный идентификатор, snmpEngineBoots — сколько раз оно перезагружалось, и snmpEngineTime — сколько секунд прошло с последнего старта. Менеджер (Zabbix) при первом обращении узнаёт их и дальше подставляет в каждый запрос. RFC 3414, раздел 2.2.3, задаёт окно допустимого расхождения: ровно 150 секунд, одинаково для всех пользователей. Всё, что вне окна, молча выбрасывается.
Ключевое требование — раздел 2.2.2: «An authoritative SNMP engine is required to maintain the values of its snmpEngineID and snmpEngineBoots in non-volatile storage». Счётчик перезагрузок обязан пережить саму перезагрузку и увеличиться на единицу. Часть железа этого не делает: после ребута отдаёт engineBoots = 1 и engineTime, начинающий отсчёт с нуля. Для устройства это выглядит как «я родился заново», а для Zabbix — как откат назад во времени.
Дальше начинается тупик, и он симметричный. Zabbix из кэша шлёт запрос с msgAuthoritativeEngineBoots = 47 (значение до ребута). Устройство по шагу 7a раздела 3.2 считает сообщение вне окна, если полученное значение boots отличается от его локального — а у него теперь 1. Оно отбрасывает запрос и отвечает служебным Report-PDU, инкрементируя счётчик usmStatsNotInTimeWindows. Zabbix получает этот отчёт и по шагу 7b обновил бы своё представление — но только если пришедшее значение boots больше локального, либо равно ему и время больше ранее принятого. Пришла единица против сорока семи. Меньше. Значит, обновление запрещено, а сообщение отвергается как несвоевременное. Ни одна сторона не уступит. Опрос не восстановится сам никогда — ни через час, ни через неделю.
Отдельно стоит помнить про «залипание» на максимуме. RFC прямо описывает: если устройство не может определить своё последнее значение snmpEngineBoots, оно обязано выставить 2147483647, и с этого момента любое аутентифицированное сообщение всегда даёт ошибку notInTimeWindow. Из этого состояния выхода без ручного вмешательства нет. Встречается редко, но если вы видите в ответе именно это число — чистка кэша Zabbix не поможет, чинить надо устройство.
- engineBoots вырос — Zabbix примет новое значение и продолжит опрос сам
- engineBoots упал (типично после ребута дешёвой железки) — тупик до очистки кэша
- engineBoots равен, а engineTime отстал больше чем на 150 секунд — тоже отказ
- engineBoots = 2147483647 — устройство залипло, лечится только на самом устройстве
- два устройства с одинаковым engineID — вечный конфликт, метрики скачут у обоих
- устройство заменили на новое с тем же IP — другой engineID; без созданной учётки snmpget ответит «Unknown user name»
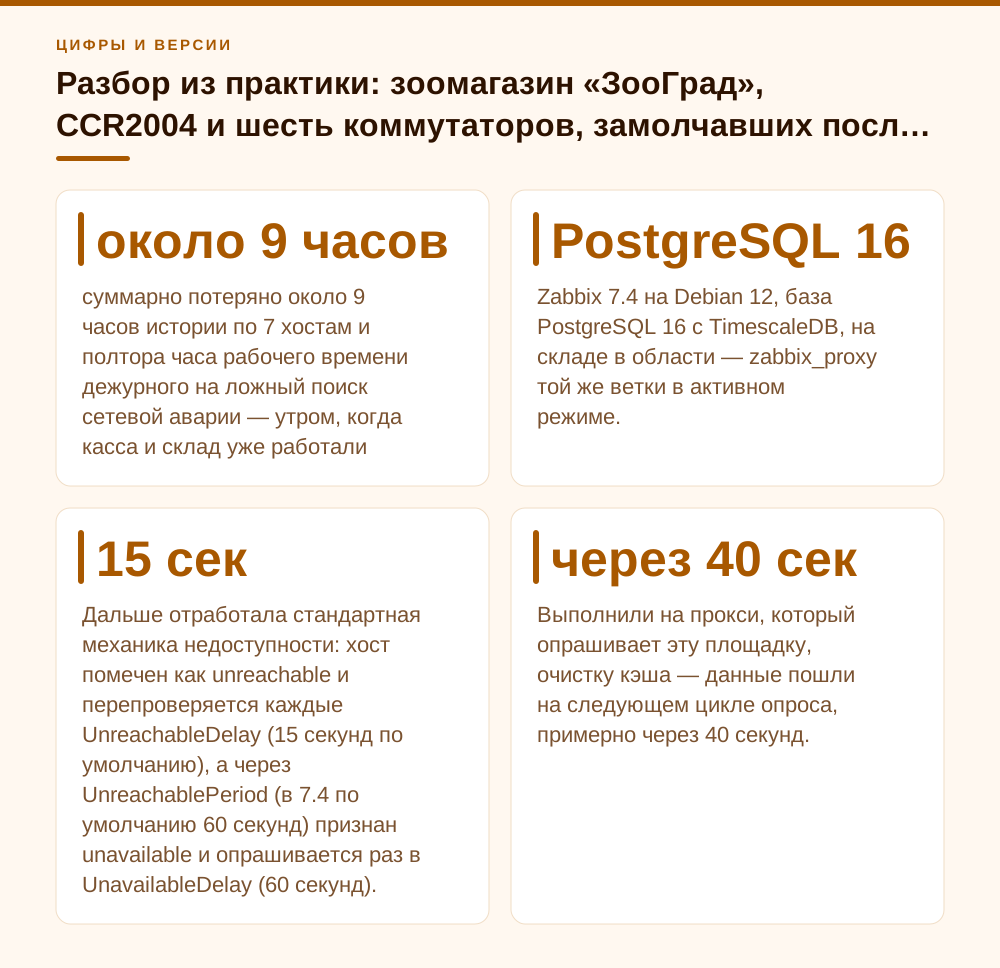
Разбор из практики: зоомагазин «ЗооГрад», CCR2004 и шесть коммутаторов, замолчавших после планового обновления
Стенд: зоомагазин «ЗооГрад», 46 рабочих мест — торговый зал с кассами, склад с терминалами сбора данных и небольшой офис. Zabbix 7.4 на Debian 12, база PostgreSQL 16 с TimescaleDB, на складе в области — zabbix_proxy той же ветки в активном режиме. Под SNMP заведено 22 хоста: пограничный MikroTik CCR2004, девять управляемых коммутаторов доступа, два ИБП, четыре сетевых МФУ, принтеры этикеток и датчики температуры в стойке. Опрос везде SNMPv3 authPriv, отдельная учётка zbxmon только на чтение, пароли в макросах уровня шаблона.
Первый инцидент. В 03:40 по регламенту обновили прошивку на CCR2004. В 03:44 роутер поднялся, ICMP-проверки зелёные, интерфейс управления доступен. А все SNMP-элементы хоста ушли в тайм-аут. Дальше отработала стандартная механика недоступности: хост помечен как unreachable и перепроверяется каждые UnreachableDelay (15 секунд по умолчанию), а через UnreachablePeriod (в 7.4 по умолчанию 60 секунд) признан unavailable и опрашивается раз в UnavailableDelay (60 секунд). То есть Zabbix продолжал стучаться, но получал только Report-PDU. Утром дежурный сделал snmpwalk с сервера — прошло. Сделал snmpget с самого прокси — тоже прошло. Полтора часа искали ACL, VLAN и «не слетел ли SNMP в конфиге роутера после апгрейда». Не слетел.
Раскрутилось на одной команде: сняли snmpEngineBoots.0 напрямую и увидели 1. А в чек-листе перед работами (мы фиксируем состояние железки до апгрейда) стояло 47. Дальше всё сложилось за минуту. Выполнили на прокси, который опрашивает эту площадку, очистку кэша — данные пошли на следующем цикле опроса, примерно через 40 секунд. Важная деталь, на которой в тот раз потеряли ещё десять минут: сначала команду выполнили на сервере Zabbix, и ничего не изменилось. Хост опрашивался прокси, а кэш живёт в памяти того процесса, который реально ходит к устройству.
Второй инцидент через неделю оказался интереснее. Отключилось питание в серверной, поднялись все девять коммутаторов доступа — и шесть из них после этого показывали рваные графики: данные то есть, то нет, элементы мигали между supported и unsupported. Сброс кэша давал эффект минут на десять. Причина была другая: у шести коммутаторов совпадал engineID. Их конфиги в своё время залили клонированием с одного эталона вместе с прописанным вручную идентификатором движка. Для Zabbix шесть физически разных железок выглядели как один SNMP-движок с шестью разными значениями boots и time, которые непрерывно перебивали друг друга в общем кэше. Развели engineID по устройствам — мигание прекратилось в тот же день и больше не возвращалось.
- инцидент 1: engineBoots упал 47 → 1 после обновления прошивки, лечение — сброс кэша на прокси
- инцидент 2: шесть коммутаторов с одинаковым engineID из клонированного конфига, лечение — уникальные идентификаторы
- суммарно потеряно около 9 часов истории по 7 хостам и полтора часа рабочего времени дежурного на ложный поиск сетевой аварии — утром, когда касса и склад уже работали
- после правок за полгода — ни одного повторения, хотя прошивки обновлялись трижды
Диагностика за десять минут: четыре проверки строго по порядку
Проверки делаются с той машины, где крутится опрашивающий демон — с сервера Zabbix или с прокси, за которым числится хост. Не с ноутбука админа: у вас другой маршрут, другой ACL и другой результат. Первое — снимаем текущие значения SNMP-движка устройства напрямую. Нужны три OID из SNMP-FRAMEWORK-MIB: engineID, engineBoots и engineTime.
# реквизиты один раз в переменную, чтобы не плодить строки
V3="-v3 -l authPriv -u zbxmon -a SHA-256 -A AuthPass -x AES -X PrivPass"

# 1.3.6.1.6.3.10.2.1.1.0 — snmpEngineID
# 1.3.6.1.6.3.10.2.1.2.0 — snmpEngineBoots
# 1.3.6.1.6.3.10.2.1.3.0 — snmpEngineTime
snmpget $V3 10.20.0.1 1.3.6.1.6.3.10.2.1.1.0 1.3.6.1.6.3.10.2.1.2.0 1.3.6.1.6.3.10.2.1.3.0
Обратите внимание на текст ошибки, если snmpget всё-таки падает. net-snmp различает причины, и они указывают в разные стороны. «Unknown user name» означает, что агент на устройстве не знает такого пользователя: учётку не создали на заменённой железке, её потеряли при сбросе к заводским настройкам или сменили engineID — на устройстве локализованные ключи пользователя привязаны к идентификатору движка, и после его смены пользователь фактически перестаёт существовать. «Not in time window» — это как раз история про engineBoots/engineTime. «Authentication failure» — неверный пароль или алгоритм аутентификации. А ошибку в privacy-пароле Zabbix, по документации, видит не как ошибку, а как TIMEOUT: это легко спутать с сетевой проблемой.
# принудительно указать ожидаемый engineID (hex) и посмотреть, что ответит устройство
snmpget $V3 -e 0x80003a8c04abcdef 10.20.0.1 1.3.6.1.6.3.10.2.1.2.0

# подробный разбор обмена, если ошибка непонятна
snmpget -d $V3 10.20.0.1 1.3.6.1.6.3.10.2.1.1.0
Если engineBoots вернулся маленьким (1, 2, 3) при том, что железка в проде третий год, — диагноз почти поставлен: устройство не сохраняет счётчик между перезагрузками. Если вернулось 2147483647 — движок залип, чините устройство, а не мониторинг. Второе — смотрим, растёт ли на устройстве счётчик отброшенных несвоевременных сообщений. Это самое надёжное доказательство того, что Zabbix стучится, а его посылают.
# usmStatsNotInTimeWindows
for i in 1 2 3; do
  date +%T
  snmpget $V3 10.20.0.1 1.3.6.1.6.3.15.1.1.2.0
  sleep 60
done
Растёт на несколько единиц за минуту, пока Zabbix долбится в хост, — это ровно наш случай. Не растёт вообще, а элементы всё равно в тайм-ауте — ищите обычную сетевую причину: потери, MTU, rate-limit на management-интерфейсе, ACL. Третье — убеждаемся, что engineID уникален в парке. Обойдите все SNMP-хосты одним циклом и посмотрите, нет ли дублей: это ловит вторую по частоте причину «мигающих» метрик.
# по списку адресов собираем engineID и печатаем только повторяющиеся
while read -r ip; do
  eid=$(snmpget -Ovq $V3 "$ip" 1.3.6.1.6.3.10.2.1.1.0 2>/dev/null | tr -d '" ')
  [ -n "$eid" ] && printf '%s\t%s\n' "$eid" "$ip"
done < hosts.txt | sort | awk -F'\t' '{n[$1]++; h[$1]=h[$1]" "$2} END {for (e in n) if (n[e]>1) print e":"h[e]}'
Четвёртое — поднимаем подробность лога у SNMP-пуллеров и смотрим, что именно они пишут по проблемному хосту. В Zabbix 7.x SNMP-опрос асинхронный, у него отдельный тип процесса, и накручивать DebugLevel глобально не нужно — можно точечно и без перезапуска.
zabbix_server -R log_level_increase="snmp poller"
tail -f /var/log/zabbix/zabbix_server.log | grep -i -E 'snmp|engine|timeout'
zabbix_server -R log_level_decrease="snmp poller"- engineBoots подозрительно мал или равен 2147483647 — проблема на стороне устройства
- «Unknown user name» от snmpget — учётки нет на устройстве или сменился engineID; кэш Zabbix тут вторичен
- usmStatsNotInTimeWindows растёт — Zabbix шлёт устаревшее состояние, нужен сброс кэша
- дубли engineID в парке — метрики будут мигать, сброс кэша даст лишь передышку
- счётчики неподвижны и лог чист — это не наша история, ищите обычную сетевую причину
Лечение: -R snmp_cache_reload вместо systemctl restart
Штатный инструмент есть и в сервере, и в прокси — это runtime-команда snmp_cache_reload. Появилась она в Zabbix 5.0 (задача ZBXNEXT-3940 в трекере вендора), так что на любой поддерживаемой ветке — 6.0, 7.0, 7.4 — она доступна. Команда сбрасывает кэшированное состояние SNMP-сеансов (engineID, engineBoots, engineTime), после чего опросчики заново проходят discovery и принимают актуальные значения. Демон при этом не останавливается: не рвутся соединения с базой, не теряется history-кэш, не встаёт колом весь остальной мониторинг.
# на сервере
sudo -u zabbix zabbix_server -c /etc/zabbix/zabbix_server.conf -R snmp_cache_reload

# на прокси (если хост числится за ним — команду надо давать именно здесь)
sudo -u zabbix zabbix_proxy -c /etc/zabbix/zabbix_proxy.conf -R snmp_cache_reload
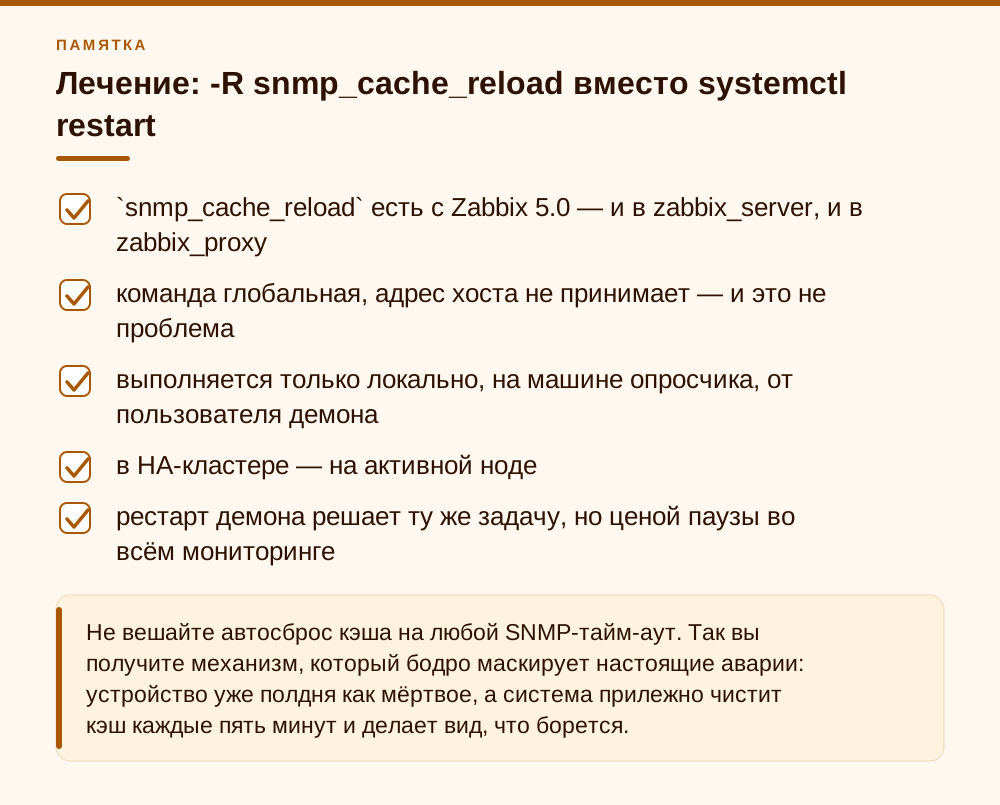
Три вещи, о которые спотыкаются чаще всего. Первая: команда не принимает адрес хоста — она глобальная, сбрасывает весь кэш целиком. Это нормально и дёшево: пуллеры просто заново познакомятся с движками, лишний обмен на пару пакетов на хост. Вторая: команда общается с локальным демоном через сокеты в SocketDir, а значит выполняется только на той машине, где этот демон работает, и от того же пользователя с тем же конфигом. Через API или из веб-интерфейса её не дёрнуть. Третья: в HA-кластере Zabbix выполнять надо на активной ноде — на standby опросчики не работают и сбрасывать там нечего.
Ещё одна деталь по версиям. Начиная с 7.0.18 и 7.4.2 (ZBXNEXT-9090) Zabbix сам перезагружает SNMP-кэш, когда в конфигурации меняются SNMPv3-реквизиты интерфейса. Раньше после правки пароля или протокола приходилось вручную давать -R snmp_cache_reload. Но это автоматика именно на изменение реквизитов в базе: если реквизиты не трогали, а устройство после ребута откатило engineBoots, кэш по-прежнему надо сбрасывать самим.
Почему я против «просто перезапустить сервис». В Zabbix 7.x SNMP-опрос асинхронный: количество процессов задаётся StartSNMPPollers, а сколько проверок каждый ведёт одновременно — MaxConcurrentChecksPerPoller. Один процесс держит сотни сессий сразу, и отдельно «перезапустить пуллер по одной железке» нельзя в принципе. Значит, выбор всегда между точечным сбросом кэша и остановкой всего опроса. Рестарт сервиса на живом парке — это провал в истории по всем хостам на время старта плюс всплеск нагрузки на базу после него. Ради одного роутера это несоразмерно.
Дальше автоматизация, и здесь я советую конкретную связку. В стандартных шаблонах сетевого оборудования есть триггер вида «host has been restarted» (по уменьшению sysUpTime). Вешаете на него действие с шагом задержки минуты в три — чтобы устройство успело подняться и стабилизировать SNMP, — а в операции скрипт типа «Script» с исполнением «Zabbix server (proxy)»: для хоста за прокси команда выполнится на прокси, для остальных — на сервере. Внутри одна строка: zabbix_server -R snmp_cache_reload или zabbix_proxy -R snmp_cache_reload соответственно. Демоны работают под пользователем zabbix, поэтому sudo не нужно. Две ловушки: в конфиге 7.x по умолчанию стоит EnableGlobalScripts=0, без явной единицы серверные скрипты не выполнятся; на прокси для исполнения скриптов нужен EnableRemoteCommands=1. И на старых ветках 5.0/6.0 запуск этой команды глобальным скриптом не показывал корректный результат в интерфейсе (ZBX-21454, исправлено в 5.0.28 и 6.0.9) — сброс при этом отрабатывал.
- `snmp_cache_reload` есть с Zabbix 5.0 — и в zabbix_server, и в zabbix_proxy
- команда глобальная, адрес хоста не принимает — и это не проблема
- выполняется только локально, на машине опросчика, от пользователя демона
- в HA-кластере — на активной ноде
- рестарт демона решает ту же задачу, но ценой паузы во всём мониторинге
- автоматизировать стоит по триггеру «устройство перезагрузилось», а не по каждому тайм-ауту
- для скриптов в действиях: EnableGlobalScripts=1 на сервере, EnableRemoteCommands=1 на прокси
Профилактика: уникальный engineID и отдельная история про клоны
Документация Zabbix ссылается на требование стандарта: msgAuthoritativeEngineID должен быть уникален для каждого устройства, и использование одного идентификатора на двух SNMPv3-устройствах это требование нарушает. Формально всё просто. На практике дубли появляются тремя путями, и все три — рукотворные. Первый: конфиг залили копированием с эталона, а идентификатор был прописан вручную. Второй: виртуалку с настроенным snmpd склонировали вместе с файлом состояния. Третий: дешёвое железо генерирует идентификатор из чего попало и на партии совпадает.
На Cisco IOS смотрите show snmp engineID и задавайте свой: snmp-server engineID local <hex>. Имейте в виду, что смена идентификатора делает недействительными ключи локальных SNMPv3-пользователей — их придётся создать заново, иначе опрос отвалится уже с «Unknown user name» или ошибкой аутентификации. На MikroTik текущие значения видно в /snmp print, а параметр engine-id в RouterOS задаёт не весь идентификатор, а только его суффикс: итоговый engineID получается как префикс 0x80003a8c04 плюс hex-представление суффикса. Для клонированных конфигов достаточно прописать разный суффикс на каждом устройстве, например по имени хоста.
Отдельно про Linux-хосты с net-snmp — это моя любимая ловушка на виртуальных стендах. Демон хранит постоянное состояние (engineBoots, oldEngineID и созданных пользователей) в файле snmpd.conf в persistent-каталоге: в сборке из исходников это /var/net-snmp/snmpd.conf, в Debian и Ubuntu — /var/lib/snmp/snmpd.conf, в RHEL-семействе — /var/lib/net-snmp/snmpd.conf. Клонировали виртуалку — получили два хоста с одним engineID, и мониторинг обоих начинает мигать без всякой видимой причины. Лечится удалением файла состояния, но осторожно: там же лежат учётки, созданные net-snmp-create-v3-user, их придётся завести заново. Правильный порядок — остановить демон, сохранить копию, удалить файл, создать пользователя и только потом запустить snmpd: утилита дописывает createUser в файл, который работающий демон перезапишет при остановке.
# Debian/Ubuntu; в RHEL-семействе путь /var/lib/net-snmp/snmpd.conf
systemctl stop snmpd
cp /var/lib/snmp/snmpd.conf /root/snmpd-persist.bak
rm /var/lib/snmp/snmpd.conf
net-snmp-create-v3-user -ro -A 'AuthPass' -a SHA-256 -X 'PrivPass' -x AES zbxmon
systemctl start snmpd
# после этого на опросчике Zabbix: zabbix_server -R snmp_cache_reload
И теперь честно про спорное. SNMPv3 — правильный выбор там, где трафик мониторинга идёт по неподконтрольным каналам, через филиальные линки или где этого требует аудит. Но если у вас девять коммутаторов в одной серверной, отдельный management-VLAN и ACL, разрешающий 161/UDP строго с адреса опросчика, то SNMPv2c даст ровно тот же результат при заметно меньшей эксплуатационной цене — ни engineBoots, ни залипших сеансов, ни расхождения времени. Я не призываю массово откатываться, но и внедрять v3 «для галочки» на изолированном сегменте не советую: вы покупаете класс отказов, от которого в этом сегменте не защищаетесь ни от чего реального.
- проверьте уникальность engineID по всему парку — это разовая работа на полчаса
- смена engineID на устройстве обнуляет привязку локальных SNMPv3-пользователей
- при клонировании образов с net-snmp чистите файл постоянного состояния (Debian — /var/lib/snmp, RHEL — /var/lib/net-snmp)
- внесите строку «после ребута сетевой железки — сброс SNMP-кэша» в раннбук работ
- фиксируйте engineBoots до плановых работ: сравнение «до/после» экономит час поиска
Приоритеты: что сделать сегодня, а на что можно забить
Первым делом — раннбук. Пункт «после перезагрузки сетевого устройства выполнить сброс SNMP-кэша на том опросчике, который это устройство ведёт» стоит ноль рублей и закрывает большинство случаев. Именно на этом чаще всего теряется утро: инцидент отработали ночью, а утром никто не связывает молчащие графики с плановыми работами шестичасовой давности. Вторым — разовая инвентаризация engineID по парку: скрипт из раздела диагностики отрабатывает за минуты и снимает вторую по частоте причину рваных метрик.
Третьим — автоматизация по триггеру перезагрузки. Она окупается на парке от десятка SNMP-устройств и на площадках, где вы физически не присутствуете. Только не путайте её с автосбросом по тайм-ауту: связка должна срабатывать на факт рестарта устройства, а не на факт отсутствия данных. Четвёртым, если у вас несколько площадок за прокси, — заранее решите, как вы будете выполнять команду на удалённом прокси, и проверьте это до инцидента, а не во время.
Теперь на что можно забить, и это не менее важно. Не надо ставить перезапуск zabbix-server в крон «на всякий случай» — вы получите регулярные дыры в истории и потеряете саму способность заметить проблему. Не надо крутить UnreachablePeriod, UnreachableDelay и UnavailableDelay: они управляют частотой попыток, а не разрешают конфликт состояния, и любая правка здесь только меняет форму симптома. Не надо массово мигрировать парк на SNMPv2c из-за одной капризной железки — вопрос решается точечно. И не надо подозревать баг платформы: описанное поведение — следствие стандарта, а не ошибка Zabbix.
И последнее наблюдение из практики. Хуже самой проблемы то, что она бесшумная. Хост зелёный, ICMP отвечает, дежурный видит доступность и спокоен, а метрик по трафику, ошибкам на портах и температуре в стойке нет уже вторые сутки. Если вы ведёте сеть, заведите себе отдельный контроль на «нет данных по SNMP при живом ICMP» — функция nodata() на ключевом элементе плюс условие доступности хоста. Это простая проверка, которая ловит не только историю с engineBoots, но и половину остальных тихих отказов мониторинга.
- сегодня: пункт в раннбук и инвентаризация engineID
- на этой неделе: триггер «устройство перезагрузилось» → сброс кэша, с задержкой в 3 минуты
- на этой неделе: контроль nodata() по SNMP при живом ICMP
- не делать: крон-рестарт сервера, правку таймингов недоступности, массовый откат на v2c
Частые вопросы
Почему snmpwalk с сервера Zabbix работает, а сам Zabbix получает тайм-аут?
Потому что snmpwalk — это одноразовый процесс с пустой локальной базой состояния: он заново узнаёт engineID, engineBoots и engineTime устройства и принимает их как есть. Zabbix-сервер и прокси — долгоживущие демоны, они кэшируют состояние SNMPv3-сеанса между опросами. Если устройство после перезагрузки отдало engineBoots меньше кэшированного, менеджер по правилам RFC 3414 обязан отвергнуть такое сообщение как несвоевременное и не имеет права обновить своё представление вниз. Отсюда и расхождение: у snmpwalk кэша нет, у Zabbix есть.
Можно ли сбросить SNMP-кэш только по одному хосту?
Нет. Команда `-R snmp_cache_reload` документирована без параметров и сбрасывает кэш целиком; запрос на сброс по отдельному хосту в трекере Zabbix закрыли именно глобальной командой. Практически это не проблема: пуллеры просто заново пройдут discovery по всем SNMP-хостам, лишний обмен составляет пару пакетов на устройство. Гораздо важнее выполнить команду на правильной машине — на том сервере или прокси, который реально опрашивает проблемный хост.
Чем сброс кэша лучше обычного перезапуска zabbix-server?
Тем, что не останавливает мониторинг. При рестарте вы получаете паузу в опросе всех хостов, разрыв соединений с базой и всплеск нагрузки после старта, когда одновременно просыпаются регламентные процессы. Сброс кэша решает ровно ту задачу, ради которой обычно и делают рестарт, но точечно и без простоя. Документация Zabbix перечисляет оба способа как равнозначные по результату — разница только в цене.
Как понять, что проблема именно в engineBoots, а не в сети или ACL?
Снимите с устройства два значения: snmpEngineBoots (OID 1.3.6.1.6.3.10.2.1.2.0) и usmStatsNotInTimeWindows (OID 1.3.6.1.6.3.15.1.1.2.0). Если счётчик перезагрузок подозрительно мал для давно работающей железки, а счётчик отброшенных несвоевременных сообщений растёт на несколько единиц в минуту, пока Zabbix стучится в хост, — это наш случай. Если второй счётчик неподвижен, ищите обычную сетевую причину: потери, ACL, rate-limit на management-интерфейсе.
Что делать, если устройство отдаёт engineBoots = 2147483647?
Сброс кэша Zabbix здесь не поможет. По RFC 3414 движок, потерявший своё последнее значение snmpEngineBoots, обязан выставить именно это число, и после этого любое аутентифицированное сообщение всегда даёт ошибку notInTimeWindow — состояние защёлкивается. Выход только через вмешательство на самом устройстве: перезапуск SNMP-агента, пересоздание SNMPv3-движка и пользователей, а на серверах с net-snmp — чистка файла постоянного состояния. После этого сбрасываете кэш на опросчике.
Стоит ли автоматизировать сброс кэша по расписанию?
По расписанию — нет, по событию — да. Крон, который чистит кэш каждые пятнадцать минут, отлично маскирует настоящие аварии: устройство может быть мёртвым полдня, а система прилежно делает вид, что борется. Правильная связка — триггер «устройство было перезагружено» (по отрицательному изменению sysUptime) с задержкой в две-три минуты, а в действии скрипт, выполняющий `-R snmp_cache_reload` на нужном опросчике.
С какой версии Zabbix есть snmp_cache_reload?
Runtime-команда `snmp_cache_reload` появилась в Zabbix 5.0 (ZBXNEXT-3940) и работает и в zabbix_server, и в zabbix_proxy. На 4.x и старше единственный способ сбросить состояние SNMPv3 — перезапуск демона. В 7.0.18 и 7.4.2 добавили автоматический сброс кэша при изменении SNMPv3-реквизитов в конфигурации (ZBXNEXT-9090), но от откатившегося после ребута engineBoots это не спасает — там по-прежнему нужна ручная команда или автоматизация по триггеру.
После замены коммутатора snmpget пишет «Unknown user name». Это тоже кэш?
Чаще всего нет. Эта ошибка приходит, когда агент на устройстве не знает пользователя: на новой железке учётку не создали, её снёс сброс к заводским настройкам, или на устройстве сменили engineID и локализованные ключи пользователя стали недействительны. Сначала создайте SNMPv3-пользователя на устройстве и добейтесь успешного snmpget с машины опросчика, затем выполните `-R snmp_cache_reload` на сервере или прокси, чтобы Zabbix забыл engineID старого устройства.
Источники
- Zabbix 7.4 — SNMP agent — Официальная документация, раздел «SNMP agent», подраздел про SNMPv3: требование уникального msgAuthoritativeEngineID для каждого устройства со ссылкой на RFC 2571; предупреждение о том, что часть устройств не сохраняет engineBoots вопреки RFC 3414 и после перезапуска их SNMP-сообщения отбрасываются как устаревшие; рекомендованное лечение — очистка SNMP-кэша через `-R snmp_cache_reload` либо перезапуск сервера/прокси. https://www.zabbix.com/documentation/7.4/en/manual/config/items/itemtypes/snmp
- RFC 3414 — User-based Security Model (USM) for SNMPv3 — Раздел 2.2.2: «An authoritative SNMP engine is required to maintain the values of its snmpEngineID and snmpEngineBoots in non-volatile storage», а также поведение при значении 2147483647 (защёлкивание и постоянная ошибка notInTimeWindow). Раздел 2.2.3: окно времени 150 секунд для всех пользователей. Раздел 3.2, шаги 7a и 7b: условия, при которых сообщение считается вне окна, и правила обновления локального представления только «вверх». https://datatracker.ietf.org/doc/html/rfc3414
- Zabbix 7.4 — man-страница zabbix_server — Раздел runtime control: параметр `snmp_cache_reload` («Reload SNMP cache») наряду с `config_cache_reload`, `diaginfo`, `log_level_increase[=target]`, `ha_status`. Синтаксис вызова `zabbix_server [-c config-file] -R runtime-option`. https://www.zabbix.com/documentation/7.4/en/manpages/zabbix_server
- Zabbix 7.4 — man-страница zabbix_proxy — Подтверждение того, что `-R snmp_cache_reload` поддерживается и прокси: `zabbix_proxy [-c config-file] -R runtime-option`. Важно для конфигураций с распределённым опросом, где кэш живёт в памяти прокси, а не сервера. https://www.zabbix.com/documentation/7.4/en/manpages/zabbix_proxy
- Zabbix Support — ZBXNEXT-3940 и ZBXNEXT-9090 — ZBXNEXT-3940 «Provide a way to flush SNMP cache for a host or all hosts» — реализовано в 5.0.0alpha3 в виде runtime-команды snmp_cache_reload: https://support.zabbix.com/browse/ZBXNEXT-3940 . ZBXNEXT-9090 «Reload SNMP cache when SNMPv3 credentials are updated» — исправлено в 7.0.18rc1, 7.4.2rc1, 8.0.0alpha1: https://support.zabbix.com/browse/ZBXNEXT-9090
- Zabbix 7.4 — конфигурация zabbix_server — Appendix «Zabbix server configuration file»: StartSNMPPollers («The number of pre-forked instances of asynchronous SNMP pollers»), MaxConcurrentChecksPerPoller, UnreachablePeriod (по умолчанию 60), UnreachableDelay (15), UnavailableDelay (60), EnableGlobalScripts. https://www.zabbix.com/documentation/7.4/en/manual/appendix/config/zabbix_server
- Zabbix Blog — Zabbix SNMP: What You Need to Know and How to Configure It — Обзорная статья вендорского блога по настройке SNMP-мониторинга в Zabbix: типы элементов, особенности SNMPv3, практические рекомендации по опросу сетевого оборудования. https://blog.zabbix.com/zabbix-snmp-what-you-need-to-know-and-how-to-configure-it/10345/
- MikroTik RouterOS — SNMP — Документация RouterOS, раздел SNMP settings: параметр engine-id задаёт суффикс идентификатора, итоговый engineID = префикс 0x80003a8c04 + hex суффикса. https://help.mikrotik.com/docs/spaces/ROS/pages/8978519/SNMP
- net-snmp — net-snmp-create-v3-user(1) — Man-страница: синтаксис net-snmp-create-v3-user [-ro] [-A authpass] [-a MD5|SHA|SHA-512|SHA-384|SHA-256|SHA-224] [-X privpass] [-x DES|AES|AES128] [username]; пользователь записывается в persistent snmpd.conf. https://manpages.debian.org/bullseye/snmpd/net-snmp-create-v3-user.1.en.html