
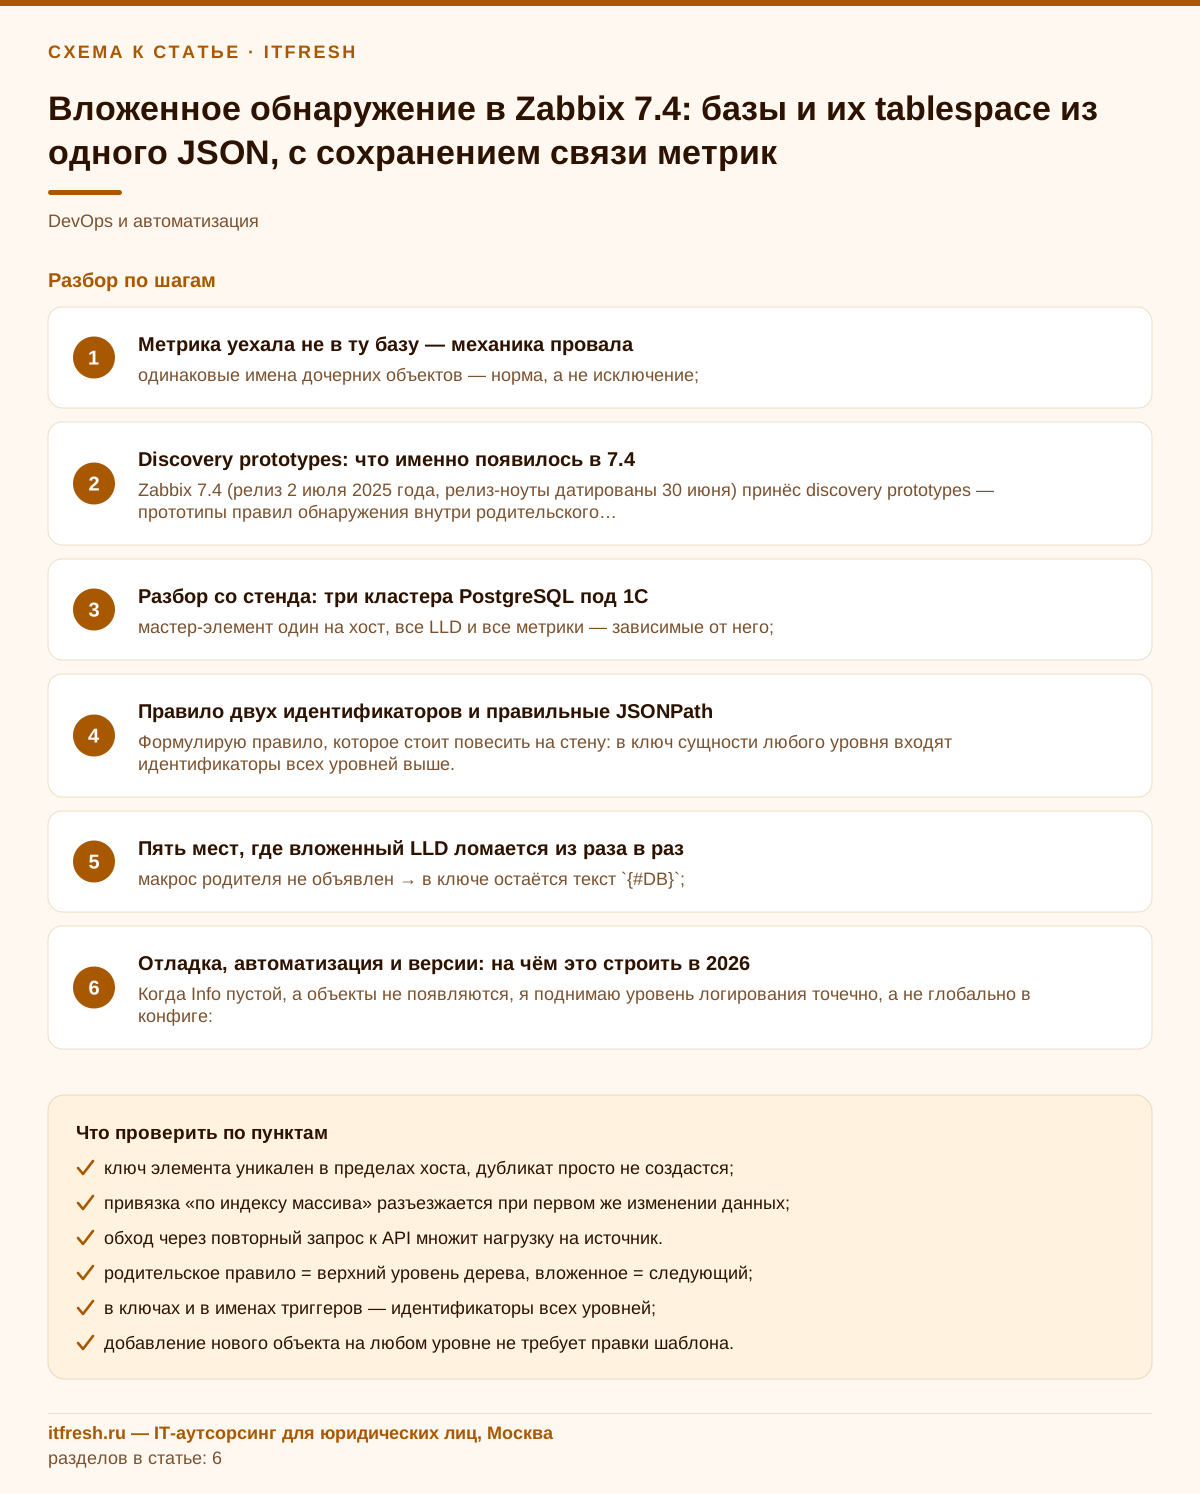
Вложенное обнаружение в Zabbix 7.4: базы и их tablespace из одного JSON, с сохранением связи метрик
Ночью прилетает «tablespace ts2 заполнен на 94 %». Инженер лезет в первую попавшуюся базу, а горит третья — потому что в ключе метрики нет имени базы. Это не редкость и не экзотика: любое вложенное API отдаёт дочерние объекты с одинаковыми именами, и родительский контекст в стандартном LLD теряется на раз. В Zabbix 7.4 появились discovery prototypes — вложенные правила обнаружения, которые берут тот же JSON, что и родитель, и умеют строить ключи из идентификаторов обоих уровней. Ниже — как я это собираю руками, какой конфиг реально работает, где оно ломается из раза в раз и что делать в первую очередь.
Метрика уехала не в ту базу — механика провала
Возьмите любой источник данных, который отдаёт дерево: кластеры → базы, гипервизоры → виртуалки, шасси → блейды, storage pool → тома. У дочерних объектов имена почти всегда переиспользуются. В двух кластерах PostgreSQL под 1С у вас две базы postgres, две template1 и, если повезло с фантазией предыдущего админа, две buh. У каждой базы — свои табличные пространства ts1, ts2, ts3. Никакой уникальности на нижнем уровне нет и не будет.
Дальше начинается арифметика Zabbix. Ключ элемента данных должен быть уникален в пределах хоста — это жёсткое ограничение, не рекомендация. Если прототип элемента написан как db.ts.size[{#TSNAME}], то первое обнаруженное табличное пространство ts1 займёт ключ, а остальные ts1 из соседних баз просто не создадутся. Правило обнаружения загорится красным, в колонке Info появится классика жанра: «Cannot create item: item with the same key ... already exists». Это ещё хороший сценарий — вы хотя бы видите ошибку.
Плохой сценарий — когда уникальность формально есть, но она держится на порядке элементов в массиве или на индексе. Данные приехали в другом порядке, СУБД переименовали, добавили базу в середину списка — и метрика, которая вчера показывала db1, сегодня показывает db3. Триггер сработал, дежурный пошёл разбирать не тот объект, потерял двадцать минут. Ошибочная привязка метрик не просто мусорит в мониторинге — она уводит инженера от реальной проблемы.
До 7.4 это лечили обходом. Прототипов правил обнаружения не существовало вовсе, поэтому второй уровень приходилось делать через прототип хоста (каждая база — отдельный хост) либо через отдельное правило, которое повторно ходило в API за данными по каждой базе. Шесть баз — шесть обращений к источнику каждые пять минут. На боевом сервере СУБД это заметно.
- одинаковые имена дочерних объектов — норма, а не исключение;
- ключ элемента уникален в пределах хоста, дубликат просто не создастся;
- привязка «по индексу массива» разъезжается при первом же изменении данных;
- обход через повторный запрос к API множит нагрузку на источник.
Discovery prototypes: что именно появилось в 7.4
Zabbix 7.4 (стандартный релиз, по странице Life Cycle — 1 июля 2025 года) принёс discovery prototypes — прототипы правил обнаружения внутри родительского правила. В What's new 7.4 это описано прямо: вложенные правила обнаружения внутри «родительского» правила, у каждого уровня — собственные прототипы элементов данных, триггеров, графиков, хостов и — да — собственные прототипы правил обнаружения. Документация отдельно оговаривает: «The levels of nesting for discovery prototypes are unlimited». То есть цепочка «инстанс → база → табличное пространство → сегмент» строится штатно, без прототипов хостов и без костылей.
Ключевая вещь для нашей боли — тип Nested (в объекте API discoveryruleprototype это type: 23, интервал delay для него не задаётся). Правило такого типа не ходит никуда за данными: по документации оно формируется из JSON-объекта того же значения, которое получило родительское правило, применяет к нему свою предобработку и вытаскивает нужный «срез». Активируется оно одновременно с родительским правилом. Никакого второго обращения к API, никакого второго подключения к СУБД. Это ровно то, чего не хватало в предыдущих версиях.
Второй ключевой момент: макросы родительского LLD доступны дочернему правилу. {#DB}, объявленный на родителе, виден и в ключе вложенного правила, и в прототипах элементов внутри него. Именно это позволяет собрать ключ из идентификаторов обоих уровней и закрыть проблему коллизий раз и навсегда.
Пример из документации (раздел Discovery prototypes, случай 1) выглядит так — родительское правило получает массив баз, у каждой внутри массив табличных пространств:
[
  {
    "database": "db1",
    "created_at": "2024-02-01T12:30:00Z",
    "encoding": "UTF8",
    "tablespaces": [
      { "name": "ts1", "max_size": "10GB" },
      { "name": "ts2", "max_size": "20GB" },
      { "name": "ts3", "max_size": "15GB" }
    ]
  },
  {
    "database": "db2",
    "created_at": "2023-11-15T08:45:00Z",
    "encoding": "UTF16",
    "tablespaces": [
      { "name": "ts1", "max_size": "5GB" },
      { "name": "ts2", "max_size": "25GB" },
      { "name": "ts3", "max_size": "30GB" }
    ]
  }
]
Конфигурация раскладывается на четыре шага. На родительском правиле во вкладке LLD macros объявляем {#DB} = $.database (в документации там же создаётся прототип элемента db.connections[{#DB}]). Внутри правила создаём прототип правила обнаружения: имя Discover tablespaces for {#DB}, тип Nested, ключ с макросом родителя, например db.tablespace.discovery[{#DB}] (API требует хотя бы один LLD-макрос в ключе прототипа), шаг предобработки JSONPath = $.tablespaces, и уже на его вкладке LLD macros — {#TSNAME} = $.name. Внутри вложенного правила прототип элемента получает ключ db.ts.size[{#DB},{#TSNAME}]. На выходе — db.ts.size[db1,ts1], db.ts.size[db1,ts2], db.ts.size[db2,ts1] и так далее, каждая метрика намертво привязана к своей паре.
- тип `Nested` (API: `type` = 23) — данные берутся из JSON родительского правила, без отдельного опроса;
- у вложенного правила свои предобработка, LLD macros, фильтры и прототипы (элементы, триггеры, графики, хосты, discovery);
- макросы родительского правила доступны во вложенном правиле и его прототипах;
- уровни вложенности документация не ограничивает;
- на 7.0 LTS и более ранних версиях discovery prototypes нет — функциональность появилась в 7.4.0.
Разбор со стенда: два кластера PostgreSQL под 1С в рекламном агентстве
Собирали это в рекламном агентстве «Медиа Сигнал» на 16 рабочих мест. Бухгалтерия, зарплата и учёт проектов клиентов живут в 1С на PostgreSQL: один сервер СУБД, два кластера — боевой на порту 5432 и тестовый на 5433, куда подрядчик по 1С регулярно разворачивает копии перед обновлениями. Всего 11 баз, и имена между кластерами совпадают: unf, buh, zup есть и в бою, и в тесте. Старый шаблон был написан по принципу «одно правило на кластер»: два LLD-правила, два отдельных вызова скрипта, каждые пять минут два подключения к СУБД, а при появлении третьего кластера под архив — ручное клонирование правила. Плюс регулярные вопросы «алерт про базу unf, а какая именно unf — боевая или тестовая?».
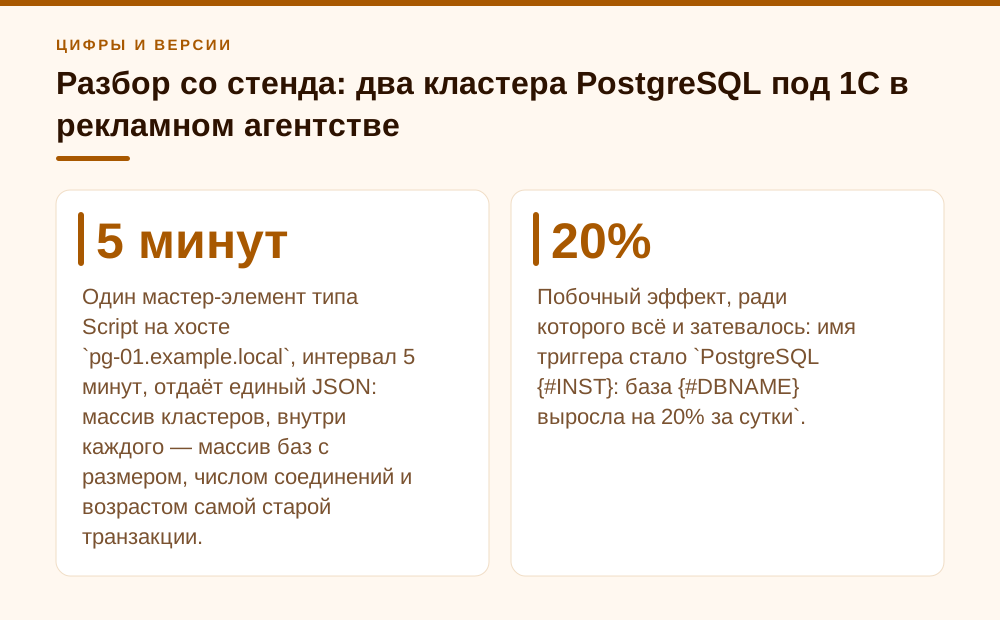
Переделал так. Один мастер-элемент типа Script на хосте pg-01.example.local, интервал 5 минут, отдаёт единый JSON: массив кластеров, внутри каждого — массив баз с размером, числом соединений и возрастом самой старой транзакции. Родительское LLD-правило — зависимый элемент от мастера, макрос {#INST} = $.instance. Внутри него прототип правила типа Nested с ключом pg.db.discovery[{#INST}], предобработка $.databases, макрос {#DBNAME} = $.name. Прототипы элементов внутри — тоже зависимые от того же мастера, с ключами вида pg.db.size[{#INST},{#DBNAME}].
[
  {
    "instance": "prod-5432",
    "version": "16.4",
    "databases": [
      { "name": "unf",  "size": 412536729600, "conn": 63, "xact_age_s": 12 },
      { "name": "buh",  "size": 88214732800,  "conn": 11, "xact_age_s": 3  }
    ]
  },
  {
    "instance": "test-5433",
    "version": "16.4",
    "databases": [
      { "name": "unf",  "size": 39822131200,  "conn": 2,  "xact_age_s": 0  }
    ]
  }
]
Итог по цифрам. Было: 2 правила обнаружения, 2 запуска скрипта, 2 подключения к СУБД каждые 5 минут, и каждый новый кластер означал копирование набора прототипов. Стало: 1 мастер-элемент, 1 родительское правило, 1 прототип вложенного правила, 4 прототипа элементов — на выходе 44 элемента данных по 11 базам, все зависимые, все с уникальными и читаемыми ключами. Подключений от мониторинга к серверу СУБД стало вдвое меньше просто потому, что опрос теперь один. Когда подрядчик поднял третий кластер под архив, шаблон трогать не пришлось: скрипт увидел новый порт — Zabbix создал ветку.
Побочный эффект, ради которого всё и затевалось: имя триггера стало PostgreSQL {#INST}: база {#DBNAME} выросла на 20% за сутки. Дежурный видит test-5433 / unf и не бежит на боевой. Среднее время до понимания «где горит» на этом классе инцидентов упало с пятнадцати минут до пары минут — и, что важнее для агентства без штатного админа, бухгалтер перестал получать тревожные письма про тестовую копию.
- мастер-элемент один на хост, все LLD и все метрики — зависимые от него;
- родительское правило = верхний уровень дерева, вложенное = следующий;
- в ключах и в именах триггеров — идентификаторы всех уровней;
- добавление нового объекта на любом уровне не требует правки шаблона.
Правило двух идентификаторов и правильные JSONPath
Формулирую правило, которое стоит повесить на стену: в ключ сущности любого уровня входят идентификаторы всех уровней выше. Не «для красоты», а потому что иначе Zabbix физически не сможет их различить. Это касается ключа вложенного правила обнаружения, ключа прототипа элемента, а в человекочитаемом виде — имени элемента, имени триггера и имени графика. Экономия символов здесь ничего не даёт, а стоит потом дорого.
Второе место, где всё разъезжается, — предобработка зависимых элементов внутри вложенного правила. Элемент зависит от общего мастера, значит на входе он получает весь исходный JSON целиком и должен сам найти в нём свою ветку. Фильтр обязан отработать по обоим макросам:
JSONPath: $[?(@.instance == "{#INST}")].databases[?(@.name == "{#DBNAME}")].size.first()Здесь легко ошибиться с кавычками, и ошибка молчаливая — элемент просто становится неподдерживаемым с ошибкой разбора JSONPath. Документация Zabbix по экранированию LLD-макросов в JSONPath говорит вещь конкретную: при подстановке значения макроса экранируются только обратный слэш и двойная кавычка. Поэтому макрос в выражении фильтра всегда берётся в двойные кавычки — в нотации документации $.[@.value == "{#MACRO}"], а не $.[@.value == {#MACRO}]. А если макрос используется как элемент пути, его надо оборачивать в квадратные скобки и двойные кавычки: $.["{#MACRO}"].value, а не $.{#MACRO}.value.
Отдельно про предобработку самого вложенного правила. $.tablespaces в примере документации работает потому, что вложенное правило формируется из JSON-объекта родительского уровня — той самой базы, — а не из всего исходного массива. Это интуитивно не очевидно: люди пишут туда $[*].tablespaces или $..tablespaces по привычке и получают либо пустоту, либо все табличные пространства всех баз в каждой ветке. Если сомневаетесь — начните с шага JSONPath $ и посмотрите в тесте, что именно приезжает.
- в ключе вложенного правила и прототипов — идентификаторы всех родительских уровней;
- в имена элементов, триггеров и графиков — те же идентификаторы в читаемом виде;
- макрос в фильтре JSONPath — в двойных кавычках: `@.name == "{#DBNAME}"`;
- макрос как элемент пути — только `["{#MACRO}"]`, никогда не `.{#MACRO}`;
- предобработка вложенного правила пишется от объекта родителя (`$.tablespaces`), а не от корня массива.
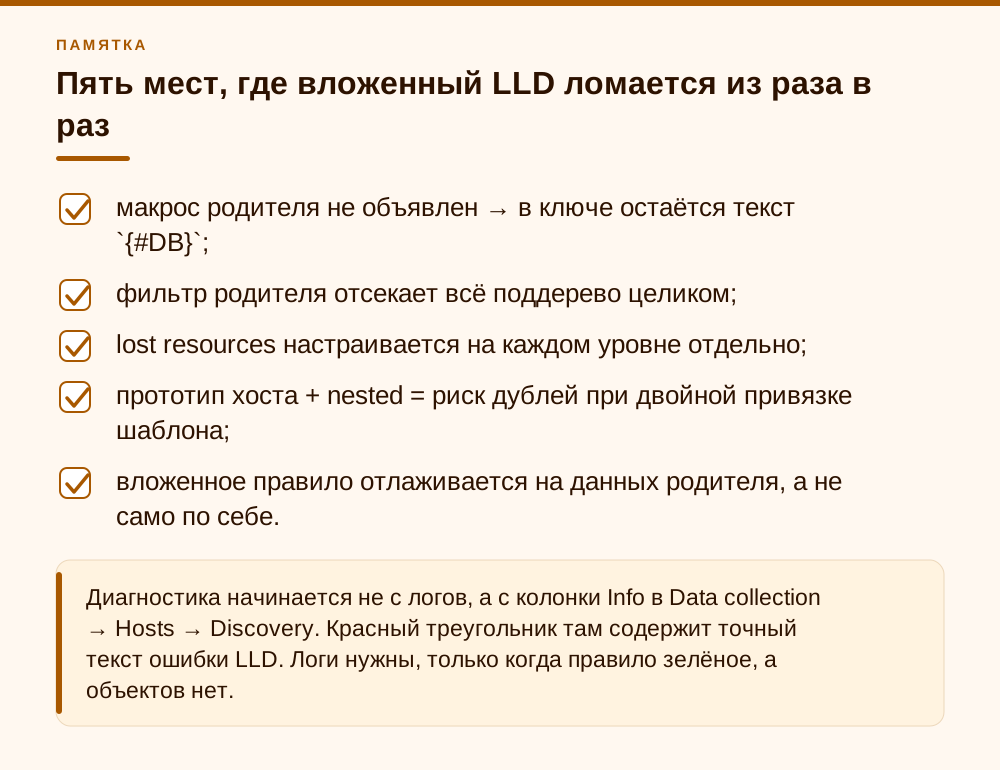
Пять мест, где вложенный LLD ломается из раза в раз
Первое и самое частое: макрос родительского уровня не объявлен. Люди читают «макросы родителя доступны дочернему правилу» и думают, что доступны любые поля родительского JSON. Нет. Доступен тот макрос, который родительское правило реально создало — либо потому что источник отдал его в формате LLD, либо потому что вы прописали его на вкладке LLD macros родителя. Если {#DB} нигде не объявлен, он не резолвится и уезжает в ключ буквально, строкой {#DB}. Выглядит это как «правило отработало, а элементы странные».
Второе: фильтры. На практике фильтр на родительском правиле отсекает не только сам объект, но и всё его поддерево: объект не обнаружен — значит, и вложенное правило для него не создано. Это логичное поведение, но о нём забывают и потом ищут, «почему у одной базы нет tablespace». Фильтры на вложенном правиле работают только внутри своей ветки. Проверять надо оба уровня.
Третье: жизненный цикл потерянных объектов. Настройки «Delete lost resources» и «Disable lost resources» (они есть с 7.0) задаются в каждом правиле отдельно, в том числе во вложенном. Пропала база из выдачи — вместе с ней по цепочке уходят в «потерянные» её табличные пространства, их элементы, триггеры и история. Я на боевых контурах никогда не ставлю немедленное удаление: недельный «Delete lost resources: after 7d» плюс «Disable lost resources: immediately» даёт время заметить, что вы просто сломали скрипт-мастер, а не что базу удалили. Автоматически отключённые объекты, кстати, включатся сами при повторном обнаружении, а отключённые руками — нет.
Четвёртое: связка с прототипами хостов. Обнаруженные хосты и раньше умели через шаблоны обнаруживать другие хосты, а в 7.4 документация discovery prototypes отдельно оговаривает: если на обнаруженном хосте есть правило типа Nested, то JSON-объект, из которого этот хост был создан, отправляется всем nested-правилам на этом хосте, а макросы правила, создавшего хост, доступны вложенным правилам. Это мощно (гипервизор → ВМ → контейнеры), но легко словить дубли, если один и тот же шаблон навешан и на родителя, и на потомка. Пятое — отладка: вложенное правило само за данными не ходит, поэтому проверять его в отрыве от родителя бессмысленно. Я тестирую предобработку родительского правила, копирую один объект из результата и уже на нём прогоняю JSONPath вложенного уровня.
- макрос родителя не объявлен → в ключе остаётся текст `{#DB}`;
- фильтр родителя отсекает всё поддерево целиком;
- lost resources настраивается на каждом уровне отдельно;
- прототип хоста + nested = риск дублей при двойной привязке шаблона;
- вложенное правило отлаживается на данных родителя, а не само по себе.
Отладка, автоматизация и версии: на чём это строить в 2026
Когда Info пустой, а объекты не появляются, я поднимаю уровень логирования точечно, по типу процесса, а не глобально в конфиге. Синтаксис runtime control из документации:
# поднять детализацию только у LLD-воркеров
zabbix_server -R log_level_increase="lld worker"
tail -f /var/log/zabbix/zabbix_server.log | grep -iE 'lld|discovery'
# вернуть обратно, не забудьте — на большом сервере лог растёт быстро
zabbix_server -R log_level_decrease="lld worker"
Конфигурацию я держу в git в виде YAML-экспорта шаблона, а массовые правки делаю через API. Прототипы правил обнаружения получили собственные методы, и это заметно упрощает жизнь тем, кто раскатывает один шаблон на десятки хостов. Тип 23 в примере ниже — это как раз Nested, поэтому delay не передаётся; обязательны ruleid родительского правила, hostid, name, key_ с LLD-макросом и type. Идентификаторы в примере условные:
{
  "jsonrpc": "2.0",
  "method": "discoveryruleprototype.create",
  "params": {
    "name": "Discover tablespaces for {#DB}",
    "key_": "db.tablespace.discovery[{#DB}]",
    "hostid": "10084",
    "ruleid": "47251",
    "type": 23
  },
  "id": 1
}
Теперь неприятная часть, о которой надо говорить честно. Zabbix 7.4 — не LTS, а стандартный релиз. По официальной политике жизненного цикла полная поддержка 7.4 длится до выхода 8.0 LTS, а ограниченная (только критические исправления) заканчивается в IV квартале 2026 года. На 7.0 LTS вложенного обнаружения нет вообще, никакими настройками его туда не принести. Версия 8.0 LTS по той же странице заявлена на III квартал 2026 года с полной поддержкой до III квартала 2029-го и ограниченной — до III квартала 2031-го; на момент написания в документации уже есть ветка 8.0. Отсюда моя позиция: новые стенды с вложенным LLD имеет смысл планировать сразу под 8.0 LTS, а тем, кто уже сидит на 7.4, — заложить апгрейд до конца года, иначе в 2027 году вы окажетесь на версии без обновлений безопасности.
Спорный момент, и я его не буду сглаживать: свежий LTS в первые месяцы — всё ещё свежий LTS. Боевые контуры клиентов я обычно перевожу не раньше третьего-четвёртого минорного релиза, то есть реалистично — зима. Пока 7.4 в ограниченной поддержке, сидеть на ней нормально, но это уже отсчёт последних месяцев. Единственное, чего делать не стоит, — строить новую большую схему мониторинга на 7.4 в расчёте «поживёт года три».
- `zabbix_server -R log_level_increase="lld worker"` — детальный лог только LLD-воркеров, потом обязательно `log_level_decrease`;
- шаблоны — в git как YAML-экспорт, правки через API (`discoveryruleprototype.create/update/get/delete`);
- для `type` = 23 (Nested) и 18 (Dependent item) интервал `delay` не задаётся;
- 7.4 — стандартный релиз: ограниченная поддержка до IV квартала 2026;
- новые долгоживущие стенды — под 8.0 LTS, миграцию боевых контуров — после нескольких минорных релизов.
Что делать первым, а на что можно забить
Приоритет номер один — уникальность ключей. Пройдитесь по шаблонам, найдите прототипы элементов, где в ключе один макрос, а сущность в источнике вложенная, и добавьте туда родительский идентификатор. Это делается за час и закрывает сам класс проблемы «метрика уехала не в ту базу». Даже если вы пока не трогаете архитектуру шаблона — сделайте это.
Приоритет номер два — один мастер-элемент на дерево. Если ваш скрипт или HTTP-агент дёргает источник по разу на каждый объект верхнего уровня, вы платите за это подключениями к боевой СУБД или запросами к API гипервизора. Схлопнуть всё в один JSON и раздать зависимыми элементами — самая большая по эффекту переделка, и вложенный LLD её просто делает возможной. Приоритет номер три — фильтры и настройки потерянных объектов: сначала «disable immediately», удаление — с задержкой в неделю.
На что можно забить с чистой совестью. Не гонитесь за третьим и четвёртым уровнем вложенности только потому, что документация говорит «уровни не ограничены» — реальная польза почти всегда исчерпывается двумя, максимум тремя. Не переписывайте работающие шаблоны из коробки Zabbix: если типовой шаблон PostgreSQL или MySQL вас устраивает и не создаёт нагрузки, вложенный LLD там не нужен. И не начинайте с графиков и дашбордов по вложенным сущностям — сначала пусть метрики стабильно приезжают на правильные объекты, красота потом.
Резюмируя по существу вопроса: базы и их tablespace из одного JSON в Zabbix 7.4 обнаруживаются штатно — родительское правило плюс прототип правила типа Nested с предобработкой $.tablespaces. Связь с нужной базой держится ровно на одном: родительский макрос присутствует в ключе вложенного правила и в ключах всех его прототипов. Всё остальное — детали реализации.
- час работы: добавить родительские макросы в ключи прототипов;
- день работы: схлопнуть источник в один мастер-элемент и перевести LLD на зависимые;
- неделя наблюдения: настроить фильтры и политику потерянных объектов;
- потом (или никогда): третий уровень вложенности, графики, дашборды.
Частые вопросы
Обязательно ли вставлять родительский макрос в ключ самого вложенного правила обнаружения?
Да. Правило обнаружения — это тоже элемент данных, и его ключ должен быть уникален в пределах хоста. Если ключ вложенного правила написан как db.tablespace.discovery без параметров, оно создастся ровно один раз — для первой обнаруженной базы, а для остальных Zabbix сообщит о дубликате ключа. Правильный вариант — db.tablespace.discovery[{#DB}].
Делает ли вложенное правило повторный запрос к API или к базе?
Нет, если у него тип Nested. Такое правило работает с JSON-объектом, который уже получило родительское правило, применяет к нему свою предобработку и активируется одновременно с родителем; интервал опроса у него не задаётся. Именно поэтому переход на вложенный LLD обычно снижает нагрузку на источник данных: вместо N обращений остаётся одно.
Почему во вложенном правиле не резолвится макрос {#DB} и он попадает в ключ как есть?
Потому что родительское правило его не создало. Доступны только те макросы, которые родитель реально сформировал: либо источник отдал данные в LLD-формате, либо макрос прописан на вкладке LLD macros родительского правила с JSONPath вида $.database. Проверьте вкладку LLD macros на родителе — в 90 % случаев дело в ней.
Можно ли получить вложенное обнаружение на Zabbix 7.0 LTS?
Нет. Discovery prototypes появились в 7.4 и никакими настройками в 7.0 не включаются. Обходной путь на 7.0 — прототипы хостов (каждый объект верхнего уровня становится отдельным хостом со своим правилом обнаружения) либо второе независимое правило с повторным запросом к источнику. Оба варианта работают, но стоят дороже в поддержке.
Сколько уровней вложенности имеет смысл делать?
Формально ограничения нет, практически — два, максимум три. Каждый уровень добавляет макросы в ключи, усложняет отладку и увеличивает число объектов на хосте. Если вам кажется, что нужен четвёртый уровень, чаще всего проблема в структуре данных источника, а не в возможностях Zabbix.
Что выбрать в 2026 году — 7.4 или ждать 8.0 LTS?
Если стенд новый и рассчитан надолго — планируйте сразу под 8.0 LTS: по политике жизненного цикла полная поддержка 7.4 заканчивается с выходом 8.0 LTS, а ограниченная — в IV квартале 2026 года. Если вы уже на 7.4 и всё работает, закладывайте апгрейд в план до конца года. Переезжать на свежий LTS в первые месяцы после релиза я боевым контурам обычно не советую — жду нескольких минорных релизов.
Источники
- Zabbix 7.4 — Discovery prototypes — Официальный мануал, Low-level discovery → Discovery prototypes: тип Nested, неограниченная вложенность, пример с базами и tablespace ({#DB}=$.database, $.tablespaces, {#TSNAME}=$.name, db.ts.size[{#DB}, {#TSNAME}]), передача JSON обнаруженного хоста nested-правилам. https://www.zabbix.com/documentation/7.4/en/manual/discovery/low_level_discovery/discovery_prototypes
- Zabbix 7.4 — What's new in Zabbix 7.4.0 — Introduction → What's new: многоуровневое обнаружение через discovery prototypes, собственные прототипы элементов, триггеров, графиков, хостов и discovery на каждом уровне. https://www.zabbix.com/documentation/7.4/en/manual/introduction/whatsnew
- Zabbix — Escaping special characters from LLD macro values in JSONPath — Мануал, раздел Item value preprocessing → JSONPath functionality: экранируются только \ и «; макрос в выражении — в двойных кавычках, в пути — в [»{#MACRO}"]. https://www.zabbix.com/documentation/7.4/en/manual/config/items/preprocessing/jsonpath_functionality/escaping_lld_macros
- Zabbix API 7.4 — LLD rule prototype object — Справочник API discoveryruleprototype: методы create/get/update/delete, значения type (23 — Nested), обязательные ruleid/hostid/name/key_/type, delay не требуется для типов 18 и 23. https://www.zabbix.com/documentation/7.4/en/manual/api/reference/discoveryruleprototype/object
- Zabbix — Life Cycle and Release Policy — Официальная политика релизов: 7.4 — стандартный релиз от 1 июля 2025, полная поддержка до выхода 8.0 LTS, ограниченная — до Q4 2026; 8.0 LTS — Q3 2026, полная поддержка до Q3 2029, ограниченная до Q3 2031. https://www.zabbix.com/life_cycle_and_release_policy
- Release Notes for Zabbix 7.4.0 — Официальные релиз-ноуты версии 7.4.0 — состав изменений, включая discovery prototypes. https://www.zabbix.com/rn/rn7.4.0
- Zabbix 7.4 — Server: runtime control — Синтаксис zabbix_server -R log_level_increase="lld worker" для точечного повышения уровня логирования по типу процесса. https://www.zabbix.com/documentation/7.4/en/manual/concepts/server