
Zabbix 7.0+ переключился на резервный узел, а веб-интерфейс пишет «Zabbix server is not running»
Ночью упал основной сервер мониторинга, кластер честно переключился на резервный, данные пишутся, триггеры срабатывают — а утром дежурный открывает веб-интерфейс и видит красную плашку «Zabbix server is not running» и строку «Connection to Zabbix server "localhost:10051" refused». Кнопка «Выполнить сейчас» не работает, очередь не показывается, тест элемента данных падает. Это не сеть и не фаервол. Это два параметра, про которые забывают при сборке HA-пары. Разберу, как frontend вообще ищет активный узел, что писать в NodeAddress и в zabbix.conf.php, какие грабли вылезают следом на агентах и прокси — и покажу разбор из практики: архитектурно-проектная мастерская «Линия фасада» на 15 рабочих мест, где после переключения молча встали 11 хостов — включая NAS с проектами и рендер-станции.
Симптом читается по адресу в кавычках
Связка «Zabbix server is not running» + «Connection to Zabbix server "..." refused» пугает людей больше, чем заслуживает. В нём уже есть ответ: адрес, по которому frontend пытался достучаться до сервера, написан прямо в тексте. Не поленитесь его прочитать — дальше диагностика занимает минуту, а не полдня с tcpdump.
Вариант первый, самый частый: в кавычках стоит localhost:10051. Значит frontend спросил у базы, кто сейчас активный узел, получил ответ — и полез на localhost. А localhost для веб-морды — это та машина, где крутится PHP, и на ней активного сервера сейчас нет. Причина: на узлах не задан параметр NodeAddress, и каждый сервер зарегистрировал сам себя в кластере под дефолтным адресом. Вариант второй: в кавычках стоит IP того узла, который как раз и лежит. Значит адрес зафиксирован в конфиге фронтенда, и никакое переключение его не поменяет.
Важно понимать масштаб бедствия, чтобы не паниковать и не откатывать кластер в панике. Сбор данных при этом работает. Активный узел собирает метрики, считает триггеры, шлёт оповещения — всё это идёт через базу и от фронтенда не зависит вообще. Ломается ровно то, для чего веб-интерфейсу нужен прямой TCP-коннект на порт трапера: «Выполнить сейчас», просмотр очереди, тест элемента данных, запуск скриптов с сервера и индикатор «Zabbix server is running» в Reports → System information. Неприятно, но не катастрофа: у дежурного пропадает не мониторинг, а управление мониторингом. Именно поэтому проблему обычно замечают не в момент отказа, а через несколько часов, когда кому-то понадобилось нажать «Выполнить сейчас».
Zabbix server is not running: the information displayed may not be current.
Connection to Zabbix server "localhost:10051" refused.- localhost:10051 в кавычках — NodeAddress не задан ни на одном узле;
- IP упавшего узла — в conf/zabbix.conf.php жёстко прописан $ZBX_SERVER;
- правильный IP живого узла, но всё равно refused — вот тут уже смотрим фаервол, SELinux (httpd_can_connect_zabbix) и ListenIP на сервере.
Как frontend на самом деле находит активный узел
Никакого магического обнаружения в Zabbix нет — всё через базу. Каждый сервер, у которого в zabbix_server.conf задан HANodeName, при старте регистрируется в таблице ha_node: имя узла, адрес, порт, время последнего доступа и статус. Статусы в API hanode.get пронумерованы так: 0 — standby, 1 — stopped, 2 — unavailable, 3 — active. Frontend при каждом обращении к серверу читает строку со статусом 3 и берёт оттуда пару address:port. То есть адрес, по которому веб-морда стучится, сервер сообщает о себе сам.
И вот тут ключевое. Что именно сервер о себе запишет, определяет параметр NodeAddress. Если его не задать, работает цепочка подстановок, прямо описанная в поставляемом zabbix_server.conf (ветки 7.0 и новее): адрес берётся из ListenIP, а если и ListenIP не задан — подставляется localhost; порт берётся из ListenPort, а если его нет — 10051. В типовой установке из пакетов ни ListenIP, ни NodeAddress не трогают. Результат: оба узла кластера честно записывают в общую базу «я живу по адресу localhost:10051». Пока активен тот сервер, на котором стоит и веб-интерфейс, всё работает и никто ничего не подозревает. После первого же failover — refused.
### Option: NodeAddress
#	IP or hostname with optional port to specify how frontend should connect to
#	the server.
#	Format: <address>[:<port>]
#
#	If IP or hostname is not set, then ListenIP value will be used. In case
#	ListenIP is not set, localhost will be used.
#	If port is not set, then ListenPort value will be used. In case ListenPort
#	is not set, 10051 will be used.
#	This option can be overridden by address specified in frontend configuration.
#
# Mandatory: no
# Default:
# NodeAddress=localhost:10051
Обратите внимание на предпоследнюю строку комментария: «This option can be overridden by address specified in frontend configuration». Это вторая типовая ошибка. Если в conf/zabbix.conf.php заданы $ZBX_SERVER и $ZBX_SERVER_PORT, frontend вообще не пойдёт смотреть в таблицу ha_node — он будет молотиться в прописанный адрес независимо от того, кто там сейчас активен. Мастер установки эти строки заполняет, и в 99 % инсталляций они остаются. Для одиночного сервера это норма. Для HA — гарантированный отказ управления после переключения.
- HANodeName задан → сервер работает как узел кластера и пишется в ha_node;
- HANodeName пуст → standalone-режим (узел с пустым именем всё равно регистрирует адрес для фронтенда);
- NodeAddress → что именно узел сообщит о себе фронтенду;
- $ZBX_SERVER в zabbix.conf.php → перекрывает всё вышеперечисленное.
Правильная конфигурация пары узлов
Собираю всегда одинаково. Два узла, у каждого — уникальное HANodeName и NodeAddress со своим реальным адресом, по которому фронтенд физически может открыть TCP-сессию. Не VIP, не имя кластера, не localhost — именно адрес конкретной машины. Имя узла берите осмысленное: оно потом светится в Reports → System information, в логах и в выводе ha_status, и «node1 / node2» через полгода никому ничего не скажут.
# /etc/zabbix/zabbix_server.conf на zbx-01
HANodeName=zbx-01-dc
NodeAddress=10.20.30.11:10051
ListenPort=10051

# /etc/zabbix/zabbix_server.conf на zbx-02
HANodeName=zbx-02-office
NodeAddress=10.20.30.12:10051
ListenPort=10051
Дальше — фронтенд. В conf/zabbix.conf.php две строки должны быть закомментированы или отсутствовать: $ZBX_SERVER и $ZBX_SERVER_PORT. А вот $ZBX_SERVER_NAME трогать не нужно — это просто подпись в правом верхнем углу интерфейса, к подключению она отношения не имеет. Я эту подпись, наоборот, всегда заполняю: когда фронтендов два, полезно с первого взгляда понимать, на какой из них ты сейчас смотришь.
<?php
// /etc/zabbix/web/zabbix.conf.php
$DB['TYPE'] = 'POSTGRESQL';
$DB['SERVER'] = '10.20.30.20';
$DB['PORT'] = '5432';
$DB['DATABASE'] = 'zabbix';

// В HA-режиме адрес сервера НЕ задаём — frontend возьмёт
// активный узел из таблицы ha_node.
// $ZBX_SERVER      = '127.0.0.1';
// $ZBX_SERVER_PORT = '10051';
$ZBX_SERVER_NAME = 'LF monitoring';
Проверяю результат тремя способами, и все три стоит прогнать сразу после рестарта. Первый — рантайм-команда ha_status. Учтите нюанс, на котором спотыкаются: она не печатает таблицу в stdout, она пишет её в лог сервера, так что смотреть надо в zabbix_server.log. Второй — Reports → System information в веб-интерфейсе: там есть блок со списком узлов кластера, их статусами и адресами. Третий, самый честный для скриптов и проверок — API hanode.get, он возвращает ровно то, что лежит в базе. Нюанс: метод доступен только пользователю типа Super admin, так что для проверок заведите отдельный API-токен с этой ролью, а не светите в скриптах пароль Admin.
- HANodeName — уникальное осмысленное имя на каждом узле;
- NodeAddress — реальный IP/FQDN этого узла с портом трапера;
- $ZBX_SERVER и $ZBX_SERVER_PORT во фронтенде — закомментировать;
- $ZBX_SERVER_NAME — оставить, это только подпись.
Разбор из практики: «Линия фасада», два узла и 11 молча вставших хостов
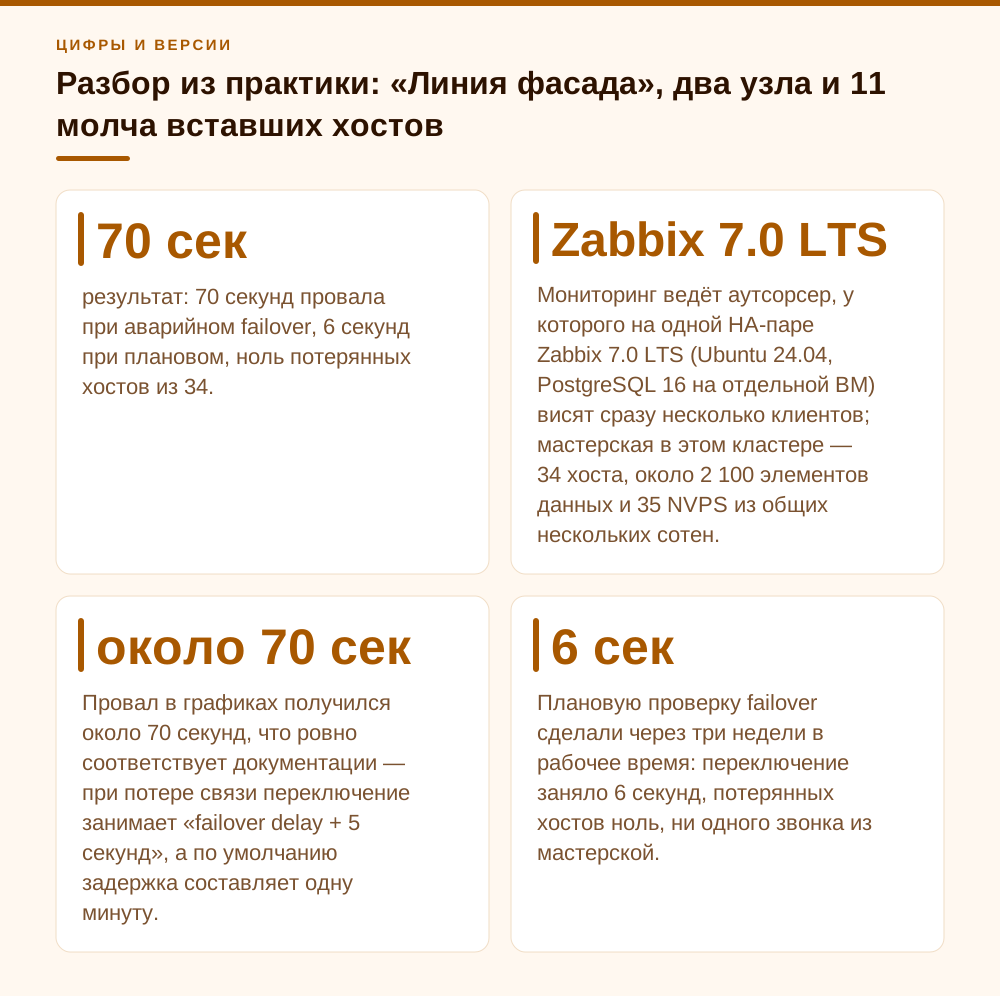
Архитектурно-проектная мастерская «Линия фасада», 15 рабочих мест: архитекторы в Revit и ArchiCAD, четыре рендер-станции, NAS с архивом проектов, плоттер, пара ИБП и коммутаторы. Сама по себе такая контора HA-кластер Zabbix не заслуживает — и держит его не она. Мониторинг ведёт аутсорсер, у которого на одной HA-паре Zabbix 7.0 LTS (Ubuntu 24.04, PostgreSQL 16 на отдельной ВМ) висят сразу несколько клиентов; мастерская в этом кластере — 34 хоста, около 2 100 элементов данных и 35 NVPS из общих нескольких сотен. Для бюро цена вопроса понятная: ночью упавший NAS или остановившийся рендер означает сорванную сдачу комплекта на экспертизу. HA-пару изначально собирал предыдущий подрядчик по статье из интернета: HANodeName прописали, NodeAddress пропустили. Кластер собрался, ha_status показывал active/standby, все были довольны.
Проверка боем случилась в 03:14 — узел zbx-01 ушёл в перезагрузку после автообновления ядра. Кластер отработал штатно: в 03:15:22 zbx-02 перешёл в active. Провал в графиках получился около 70 секунд, что ровно соответствует документации — при потере связи переключение занимает «failover delay + 5 секунд», а по умолчанию задержка составляет одну минуту. Дальше начались нюансы. Утром дежурный получил «Zabbix server is not running» с адресом localhost:10051, а к обеду главный архитектор позвонил сам: ночной рендер встал, а алерта не было. Выяснилось, что 11 хостов мастерской молчат с ночи — рендер-станции, NAS и оба ИБП.
Второе оказалось интереснее первого — и неприятнее для клиента. У агентов в zabbix_agent2.conf в параметре Server был прописан один адрес — старого активного узла. Агент принимает пассивные проверки только от перечисленных там адресов, поэтому подключения с zbx-02 он вежливо отбивал. В логах агента — строки вида «failed to accept an incoming connection: connection from "10.20.30.12" rejected, allowed hosts: "10.20.30.11"». Ни один триггер по этому поводу не сработал, потому что хосты просто ушли в nodata, а nodata-триггеры на них никто не вешал. Классика: HA сделали, а обвязку под HA не переделали.
Чинили по порядку. Прописали NodeAddress на обоих узлах и перезапустили сначала standby, потом active — так переключение проходит контролируемо, за пять секунд, потому что уходящий узел корректно сообщает о завершении работы. Из zabbix.conf.php убрали $ZBX_SERVER = '127.0.0.1', оставшийся от мастера установки. Агентам на рабочих станциях и рендер-нодах через GPO, а на NAS вручную разложили Server=10.20.30.11,10.20.30.12 и ServerActive=10.20.30.11;10.20.30.12 — обратите внимание на разделители, в Server запятая, в ServerActive точка с запятой, это не опечатка: в ServerActive запятая означает два независимых сервера, и агент слал бы активные проверки в оба, а точка с запятой — узлы одного кластера. На фронтендах открыли 10051 в обе стороны. Плановую проверку failover сделали через три недели в рабочее время: переключение заняло 6 секунд, потерянных хостов ноль, ни одного звонка из мастерской.
- было: HANodeName есть, NodeAddress нет, $ZBX_SERVER='127.0.0.1', Server= с одним адресом;
- стало: NodeAddress на обоих узлах, фронтенд без фиксированного адреса, оба адреса у агентов;
- результат: 70 секунд провала при аварийном failover, 6 секунд при плановом, ноль потерянных хостов из 34.
Что ещё вылезает после первого переключения
NodeAddress — только вход в тему. После того как фронтенд перестал ругаться, я прохожу по списку вещей, которые в HA-паре обязаны быть одинаковыми или знать про оба узла. Проверять это надо не после аварии, а до неё: плановое переключение в рабочее время стоит полчаса и экономит утро дежурного.
Агенты и прокси. В Server у агентов (пассивные проверки) и у пассивных прокси перечисляем оба узла через запятую, в ServerActive агентов — через точку с запятой. У активного прокси адрес сервера задаётся в параметре Server, и узлы кластера там, по документации, тоже разделяются точкой с запятой: Server=zbx-01-dc;zbx-02-office. Фаервол: с каждого фронтенда должен быть доступен порт 10051 на обоих узлах, и с обоих узлов — порты агентов. На RHEL-семействе не забудьте про SELinux, иначе PHP не сможет открыть исходящий коннект к серверу: нужен булев httpd_can_connect_zabbix, а при удалённой СУБД ещё и httpd_can_network_connect_db. Скрипты: содержимое AlertScriptsPath и ExternalScripts живёт на файловой системе конкретного узла — если разложили только на первый, после failover оповещения через вебхук-скрипт молча перестанут уходить. Синхронизируйте каталоги, у меня это обычный rsync по расписанию плюс проверка контрольных сумм.
Узлы-призраки. Когда старый сервер выводят из эксплуатации, его строка остаётся в таблице ha_node навсегда и висит в System information со статусом unavailable, отравляя картину. Удаляется рантайм-командой по имени или по идентификатору — но только если узел в статусе stopped или unavailable: active и standby удалить нельзя. И отдельно про задержку переключения: она хранится не в конфиге, а в базе, задаётся рантайм-командой и применяется ко всему кластеру сразу. Допустимый диапазон — от 10 секунд до 15 минут, по умолчанию минута. Занижать до 10 секунд я не советую: короткая сетевая просадка между площадками — и у вас начинается пинг-понг активной роли.
# статус кластера (смотреть в логе!)
zabbix_server -R ha_status
tail -n 30 /var/log/zabbix/zabbix_server.log

# убрать выведенный из эксплуатации узел
zabbix_server -R ha_remove_node=zbx-old

# задержка переключения: от 10s до 15m, хранится в базе
zabbix_server -R ha_set_failover_delay=60s

# то же самое через API
curl -s -X POST -H 'Content-Type: application/json-rpc' \
  -H "Authorization: Bearer $ZBX_API_TOKEN" \
  -d '{"jsonrpc":"2.0","method":"hanode.get","params":{"output":"extend"},"id":1}' \
http://zabbix.example.ru/api_jsonrpc.php- агенты: Server= — оба адреса через запятую, ServerActive= — через точку с запятой; активные прокси: Server= через точку с запятой;
- порт 10051 открыт с фронтендов на оба узла;
- SELinux: setsebool -P httpd_can_connect_zabbix on (и httpd_can_network_connect_db on при удалённой БД);
- AlertScriptsPath и ExternalScripts синхронизированы между узлами;
- старые узлы вычищены через ha_remove_node.
Чего HA в Zabbix не делает — говорю прямо
Встроенный HA закрывает ровно одну задачу: отказ процесса zabbix_server. Всё остальное надо решать отдельно, и здесь я предпочитаю честность вместо красивых схем на слайде. База данных не резервируется никак: оба узла работают с одной и той же СУБД, и если она ляжет, кластер серверов вам не поможет. Хотите настоящую отказоустойчивость — это отдельный проект: Patroni для PostgreSQL, репликация, балансировщик. Для мастерской на 15 рабочих мест это, по-честному, оверкилл, да и HA-пара сервера ей самой была бы не нужна — она оправдана только тем, что кластер общий у аутсорсера на несколько клиентов. Там гораздо больше пользы принесут нормальные ежедневные дампы базы, проверенное восстановление и второй узел сервера — а СУБД пусть будет одна, но на надёжном железе со снапшотами.
Frontend тоже не кластеризуется сам по себе. Zabbix обеспечивает только то, что любой фронтенд найдёт активный сервер; сделать так, чтобы сам веб-интерфейс был доступен при падении машины, — ваша задача. Варианта два: поднять nginx с upstream или VIP через keepalived, либо просто держать вторую закладку в браузере и знать про неё. Второй вариант выглядит колхозно, но для небольшой конторы он рабочий и не требует поддержки — я его предлагаю без стеснения, если у клиента нет отдельного человека на инфраструктуру.
Standby-узел не помогает с нагрузкой. Он поднимает ровно один процесс — HA manager, не собирает данные, не считает триггеры и вообще не слушает порты. Ждать от него разгрузки основного сервера бессмысленно: горизонтальное масштабирование в Zabbix делается прокси, а не вторым сервером. И ещё: версии узлов должны совпадать. Обновление кластера по документации идёт так: останавливают все узлы, делают полный бэкап базы, на одном узле комментируют HANodeName и запускают его в standalone для апгрейда схемы, затем возвращают HA-режим и обновляют остальные узлы.
Про сами версии. Кластер в разборе — на 7.0 LTS (выпуск 4 июня 2024 года, полная поддержка до 30 июня 2027-го). Zabbix 7.4 вышел 1 июля 2025 года как стандартный релиз с ограниченной поддержкой до IV квартала 2026-го, а 8.0 LTS по официальному плану выпуска приходится на III квартал 2026 года. Если вы собираете мониторинг под долгую жизнь и не гонитесь за свежими фичами, ставьте LTS-ветку. Механика HA, о которой идёт речь в статье, одинакова начиная с 6.0 и во всех ветках 7.x — параметры HANodeName/NodeAddress и рантайм-команды те же.
- СУБД — единая точка отказа, Zabbix её не резервирует;
- доступность фронтенда — на вас: VIP/балансировщик или вторая закладка;
- standby не разгружает активный узел, для нагрузки — прокси;
- версии узлов кластера обязаны совпадать.
Порядок действий: что чинить сейчас, а на что можно забить
Если у вас прямо сейчас горит Connection refused, порядок такой. Смотрим адрес в сообщении. Идём в базу или в hanode.get и сверяем, что записано в строке активного узла. Дописываем NodeAddress на всех узлах, вычищаем $ZBX_SERVER из zabbix.conf.php, перезапускаем сначала standby, потом active. Пять минут работы, если знать, куда смотреть.
Дальше — то, что делают в тот же день, но уже без спешки: раскладка обоих адресов агентам и прокси, открытие 10051 с фронтендов на оба узла, синхронизация каталогов со скриптами, чистка мёртвых узлов из ha_node. И обязательно — плановая проверка переключения в рабочее время: остановили активный узел, засекли, посмотрели, что именно отвалилось. Пока вы не сделали такую проверку своими руками, у вас не HA-кластер, а гипотеза о нём.
На что можно спокойно забить. Тюнинг failover delay — дефолтная минута нормальна для подавляющего большинства площадок. Погоня за самой свежей версией — если работает 7.0 LTS, переползать на 7.4 ради HA смысла нет, механика та же. Кластеризация фронтенда через keepalived для мастерской на 15 рабочих мест — приятно, но не первое, на что я потрачу день клиента. А вот nodata-триггеры на ключевых хостах и оповещение о смене активного узла поставьте сразу: именно они превращают HA из декорации в работающий механизм.
- сейчас: NodeAddress на узлах + убрать $ZBX_SERVER + рестарт standby → active;
- сегодня: агенты, прокси, фаервол, скрипты, чистка ha_node;
- на неделе: плановая проверка failover и nodata-триггеры;
- потом или никогда: тюнинг задержки, VIP для фронтенда, отдельный кластер СУБД.
Частые вопросы
Что писать в NodeAddress — VIP кластера или адрес самой машины?
Адрес самой машины. NodeAddress — это то, как фронтенд должен достучаться до конкретного узла, а не до кластера в целом. Frontend сам выбирает строку активного узла из таблицы ha_node и берёт адрес оттуда. Если прописать общий VIP на обоих узлах, вы получите ровно ту же неопределённость, от которой уходили.
Можно ли оставить $ZBX_SERVER в zabbix.conf.php, если указать там VIP?
Технически будет работать, пока VIP переезжает вместе с активной ролью сервера. Но это уже два независимых механизма переключения, которые надо синхронизировать руками, и рано или поздно они разъедутся. Штатный путь один: убрать адрес из фронтенда и дать ему читать активный узел из базы.
Почему zabbix_server -R ha_status ничего не выводит?
Она и не должна выводить в консоль. Рантайм-команда просит работающий сервер напечатать состояние кластера в свой лог. Смотрите zabbix_server.log сразу после запуска команды — таблица с именами узлов, адресами, статусами и временем последнего доступа будет там.
После вывода старого сервера в System information висит узел со статусом unavailable. Это опасно?
Не опасно, но мешает: строка остаётся в базе навсегда и портит картину дежурному. Удаляется командой zabbix_server -R ha_remove_node=<имя или идентификатор>. Удалить можно только узел в статусе stopped или unavailable — active и standby команда не тронет.
Насколько снижать failover delay?
Допустимый диапазон — от 10 секунд до 15 минут, по умолчанию минута, и её обычно менять не надо. Заниженная задержка на разнесённых площадках приводит к перебросам активной роли при коротких сетевых просадках, а каждое переключение — это пауза в сборе данных. Если узлы стоят в одной стойке, 30 секунд допустимы.
Standby-узел можно нагрузить сбором данных, чтобы железо не простаивало?
Нет. Standby поднимает единственный процесс — HA manager, ничего не собирает и не слушает порты. Для распределения нагрузки в Zabbix используются прокси, а не второй сервер кластера.
Источники
- Zabbix 7.0 — High availability cluster — Официальная документация: HANodeName, NodeAddress, автоопределение активного узла фронтендом при отсутствии $ZBX_SERVER/$ZBX_SERVER_PORT, failover delay (10 с – 15 мин, по умолчанию 1 мин), ha_status / ha_set_failover_delay / ha_remove_node, процедура обновления кластера, Server=node1;node2 у активного прокси. https://www.zabbix.com/documentation/7.0/en/manual/concepts/server/ha
- zabbix_server.conf, ветка release/7.0 — Комментарии к HANodeName и NodeAddress: цепочка подстановки ListenIP → localhost, порт ListenPort → 10051, «This option can be overridden by address specified in frontend configuration». https://raw.githubusercontent.com/zabbix/zabbix/release/7.0/conf/zabbix_server.conf
- Zabbix API 7.0 — hanode.get — Свойства объекта hanode и коды статусов: 0 — standby, 1 — stopped, 2 — unavailable, 3 — active; метод доступен только Super admin. https://www.zabbix.com/documentation/7.0/en/manual/api/reference/hanode/get
- zabbix_agentd.conf, ветка release/7.0 — Server — адреса через запятую; ServerActive — узлы кластера через точку с запятой (пример ServerActive=zabbix.cluster.node1;zabbix.cluster.node2:20051). https://raw.githubusercontent.com/zabbix/zabbix/release/7.0/conf/zabbix_agentd.conf
- Zabbix 7.0 — Reports → System information — Таблица узлов HA-кластера (Name, Address, Last access, Status) и требование работающего сервера с trapper-процессом для отображения данных. https://www.zabbix.com/documentation/7.0/en/manual/web_interface/frontend_sections/reports/status_of_zabbix
- Zabbix — Life cycle & release policy — 7.0 LTS — 4 июня 2024, полная поддержка до 30.06.2027; 7.4 — 1 июля 2025, ограниченная поддержка до IV кв. 2026; 8.0 LTS запланирована на III кв. 2026. https://www.zabbix.com/life_cycle_and_release_policy
- Zabbix Blog — Handy Tips #24: Preventing downtimes with the Zabbix HA cluster — Обзор вендора: HANodeName и NodeAddress на узлах, комментирование $ZBX_SERVER и $ZBX_SERVER_PORT в zabbix.conf.php. https://blog.zabbix.com/handy-tips-24-preventing-downtimes-with-the-zabbix-ha-cluster/19712/