📈 Мониторинг📅 31.03.2026⏱️ 25 мин чтения✍️ АйТи Фреш
Серверы падали незаметно: внедрение Zabbix 7 для розничной сети из 12 магазинов
Задача клиента: розничная сеть без мониторинга
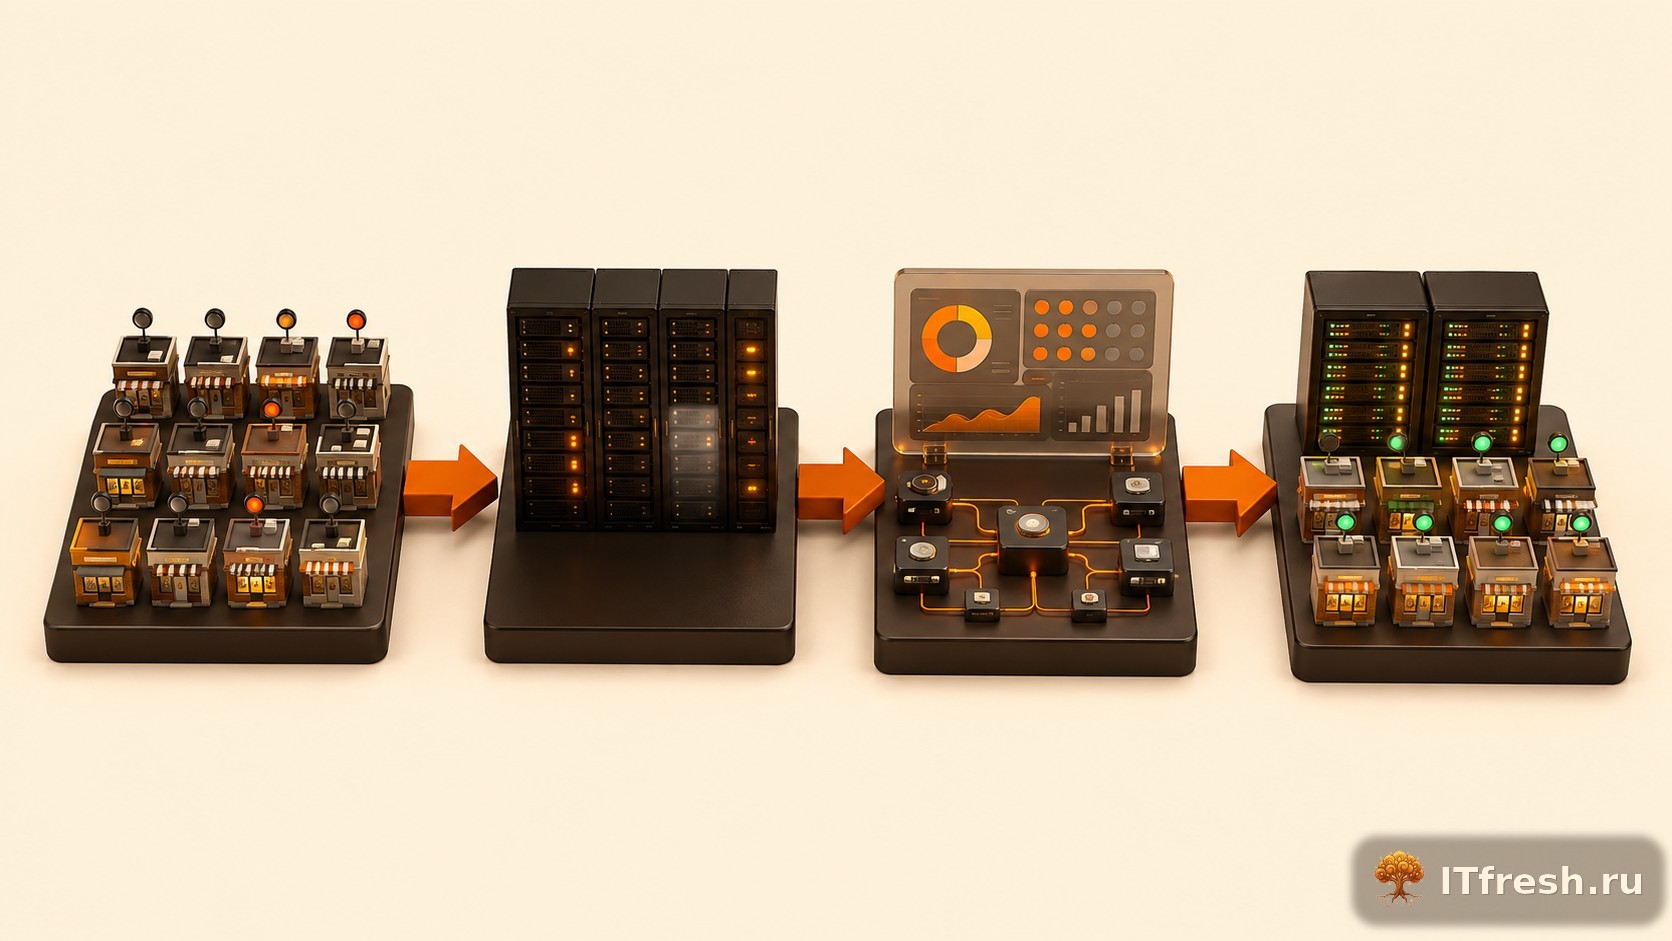
К нам обратился владелец розничной сети «ПродМаркет» — 12 продуктовых магазинов в Московской области. Боль была типичная, но от этого не менее разрушительная: серверы и кассовые узлы падали, а единственный IT-специалист узнавал об этом только когда раздражённые продавцы сами брали трубку. Простой мог растянуться на несколько часов — касса молчит, очередь расходится, деньги уходят к конкурентам.
Ситуация на момент обращения:
12 магазинов с локальными серверами (кассовое ПО, 1С, Wi-Fi контроллеры)
Центральный офис с основным сервером баз данных и бухгалтерии
Мониторинга — ноль. IT-специалист узнавал о сбоях исключительно по звонкам из магазинов
Среднее время реакции на инцидент — 2-3 часа
Потери от простоев — по оценке самого клиента, до 150 000 рублей в месяц
Задача была сформулирована чётко: хотим видеть всю инфраструктуру на одном экране, получать оповещения мгновенно и — в идеале — ловить проблемы до того, как они вообще дойдут до кассы.
Проведённый аудит и предложенное решение
Прежде чем что-то предлагать, мы съездили в три магазина, руками пощупали серверное железо, разобрались с каналами связи между точками и посмотрели, чем вообще управляется эта инфраструктура. Картина была предсказуемой. По итогам аудита остановились на Zabbix 7 — пожалуй, самой зрелой open-source системе мониторинга из тех, с которыми мы работаем.
Седьмая версия вышла в 2024 году и реально ощутимо прибавила в производительности и автоматизации — это не маркетинг, мы сами сравнивали с предыдущими версиями в боевых условиях. Для этого проекта особенно пригодились несколько новшеств:
Переработанный веб-интерфейс — дашборды грузятся быстро, навигация стала логичнее, плюс тёмная тема (мелочь, но айтишники оценят)
Улучшенный механизм Proxy — поддержка пассивных и активных прокси-групп для балансировки нагрузки
Новые типы элементов данных — расширенная поддержка Prometheus-метрик и браузерного мониторинга
Оптимизация работы с БД — история данных при использовании TimescaleDB обрабатывается заметно быстрее, особенно на больших объёмах
Расширенный API — новые методы для управления конфигурацией через автоматизацию
В ходе аудита выяснилось, что в каждом магазине крутится по 2-4 устройства: кассовый сервер на Debian Linux, коммутатор, Wi-Fi точка и иногда IP-камера. В голове — основной сервер БД, файловый сервер, маршрутизатор. Итого около 50 устройств, за которыми никто толком не следил. И вот что нас насторожило больше всего: VPN-каналы между магазинами и офисом регулярно моргали — пропадали на 5-15 минут несколько раз в день. Это сразу определило архитектуру: без локальных Proxy-серверов в каждой точке мониторинг будет постоянно терять данные именно тогда, когда они нужнее всего.
Спроектированная архитектура: компоненты и их взаимодействие
С учётом распределённой структуры сети мы спроектировали многоуровневую архитектуру мониторинга — вот как она выглядит:
Zabbix Server — центральный процесс в головном офисе, собирающий данные, обрабатывающий триггеры и отправляющий оповещения
Zabbix Frontend — веб-интерфейс на PHP для управления и визуализации, доступный IT-отделу
PostgreSQL Database — хранилище конфигурации и исторических данных
Zabbix Agent 2 — лёгкий агент, установленный на каждом сервере в магазине и офисе
Zabbix Proxy — промежуточные серверы в каждом магазине: буферизируют данные и не теряют их даже когда VPN-канал временно падает
Схема работает так: агенты на серверах собирают метрики — CPU, RAM, диски, сеть — и отдают их на локальный Proxy прямо в магазине. Proxy накапливает данные и при наличии связи передаёт на центральный Zabbix Server в офисе. Тот обрабатывает триггеры и, если что-то пошло не так, бьёт в Telegram. Для 50 хостов одного центрального сервера хватает с запасом.
Планирование ресурсов
Ресурсы планировали с запасом на рост — клиент уже думал о двух новых магазинах:
Параметр
До 100 хостов
100-500 хостов
500+ хостов
CPU
2 ядра
4 ядра
8+ ядер
RAM
4 ГБ
8 ГБ
16+ ГБ
Диск
50 ГБ SSD
200 ГБ SSD
500+ ГБ NVMe
База данных
PostgreSQL 15
PostgreSQL 15
PostgreSQL 15 + TimescaleDB
Центральный Zabbix Server мы подняли на уже имеющемся офисном сервере — 4 ядра, 8 ГБ RAM, SSD. Отдельно покупать ничего не пришлось. В качестве СУБД выбрали PostgreSQL: она стабильно обгоняет MySQL на таких нагрузках и поддерживает TimescaleDB, что критично для сжатия истории метрик.
Вот наше решение: установка Zabbix 7 на Debian 12
Разворачивали всё на чистом Debian 12 (Bookworm). Связка — Zabbix Server + PostgreSQL + Nginx. Проверенный стек, никаких сюрпризов.
Подготовка системы и подключение репозитория
Первым делом обновили систему и поставили нужные пакеты:
# Запуск и включение служб
systemctl enable --now zabbix-server zabbix-agent2 nginx php8.2-fpm

# Проверка статуса
systemctl status zabbix-server
systemctl status nginx
Прошли мастер первоначальной настройки, сразу сменили дефолтный пароль — оставлять его даже на день не стоит — и завели отдельные учётки для каждого IT-специалиста клиента.
Подключение хостов и настройка шаблонов мониторинга
Когда центральный сервер заработал, взялись за подключение всего зоопарка устройств: магазинные серверы, офисное железо, сетевые коммутаторы и маршрутизаторы — всё это нужно было втянуть в мониторинг.
Честно говоря, этот этап отнял больше всего времени. 12 магазинов, часть из которых — за 40-50 километров от офиса. Физически ехать на каждую точку никто не собирался, поэтому мы написали скрипт автоматической установки агента: IT-специалист клиента заходил по SSH на сервер, запускал его — и через 15-20 минут магазин уже светился зелёным в Zabbix. Установка, регистрация хоста, привязка шаблонов, проверка метрик. За два рабочих дня все 12 точек были в мониторинге.
Установка Zabbix Agent 2 на серверы в магазинах
На серверы в магазинах поставили Zabbix Agent 2 — это переписанная на Go версия с поддержкой плагинов, работает заметно шустрее старого агента:
# IP-адрес Zabbix сервера
Server=192.168.1.10

# Для активных проверок
ServerActive=192.168.1.10

# Уникальное имя хоста (должно совпадать с именем в веб-интерфейсе)
Hostname=web-server-01

# Разрешаем удалённые команды (опционально)
AllowKey=system.run[*]

# Таймаут выполнения проверок
Timeout=10
На Windows-машинах в офисе использовали MSI-установщик — те же параметры, только конфиг лежит по пути C:\Program Files\Zabbix Agent 2\zabbix_agent2.conf.
Добавление хостов и привязка шаблонов
Для каждого хоста настроили мониторинг через Data collection → Hosts → Create host:
Host name — один в один совпадает с Hostname в конфиге агента
Visible name — «Магазин №3 — Кассовый сервер»
Groups — группы по магазинам и типам устройств
Interfaces — Agent interface с IP-адресом и портом 10050
Шаблоны для Linux-серверов подключили такие:
Linux by Zabbix agent — CPU, память, диски, сеть, процессы
Zabbix agent — состояние самого агента
Nginx by Zabbix agent — на серверах с Nginx
PostgreSQL by Zabbix agent 2 — там, где крутится PostgreSQL
Пользовательские шаблоны для кассового ПО
Стандартных шаблонов не хватило. Клиенту нужен был мониторинг кассового ПО — специфическая вещь, под которую готового шаблона в природе не существует. Пришлось сделать свой:
Template name: Custom Web Application
Groups: Templates/Applications
Добавили элемент данных — время отклика кассового приложения:
Name: Application response time
Type: HTTP agent
Key: app.response.time
URL: http://localhost:8080/health
Type of information: Numeric (float)
Update interval: 30s
Специфические метрики, которые HTTP-агент не умеет собирать, вытащили через UserParameter:
# В zabbix_agent2.conf или в /etc/zabbix/zabbix_agent2.d/custom.conf
UserParameter=app.connections,ss -tn state established | grep :8080 | wc -l
UserParameter=app.queue.length,redis-cli llen task_queue 2>/dev/null || echo 0
UserParameter=app.disk.usage[*],df -P $1 | tail -1 | awk '{print $5}' | tr -d '%'
Главное требование клиента звучало просто: знать о проблеме раньше, чем позвонит кассир. И видеть всю сеть — все 12 магазинов — на одном экране, без переключений. Мы выстроили многоуровневую систему триггеров, собрали дашборды и настроили Telegram-оповещения.
Со стандартными триггерами на CPU и диски всё понятно — там Zabbix справляется из коробки. Интереснее была бизнес-логика. Мы добавили мониторинг доступности кассового ПО, контроль VPN-туннелей между магазинами и офисом, слежение за UPS. И отдельно настроили корреляцию событий — это важная вещь на практике. Если VPN-туннель до магазина падает, Zabbix не начинает спамить десятками алертов по каждому хосту внутри этого магазина. Вместо этого создаётся одна проблема: «Магазин N недоступен» — с агрегированной информацией. Дежурный видит причину, а не симптомы.
Триггеры, адаптированные под бизнес клиента
Триггеры заточили под то, что реально критично в рознице:
# Высокая загрузка CPU (более 90% в течение 5 минут)
Name: CPU utilization is too high on {HOST.NAME}
Severity: High
Expression: min(/Linux by Zabbix agent/system.cpu.util,5m)>90

# Диск заполнен более чем на 90%
Name: Disk space is critically low on {HOST.NAME}
Severity: Disaster
Expression: last(/Linux by Zabbix agent/vfs.fs.size[/,pused])>90

# Сервис не отвечает
Name: {HOST.NAME} is unreachable
Severity: Disaster
Expression: max(/Linux by Zabbix agent/agent.ping,3m)=0

# Мало свободной памяти (менее 10%)
Name: Lack of free memory on {HOST.NAME}
Severity: Warning
Expression: last(/Linux by Zabbix agent/vm.memory.util)>90

# Высокая нагрузка на диск (iowait)
Name: High disk IO wait on {HOST.NAME}
Severity: Warning
Expression: avg(/Linux by Zabbix agent/system.cpu.util[,iowait],10m)>30
Уровни серьёзности расставили по приоритетам клиента. Disaster — касса встала — это немедленный звонок, без вариантов. High — Telegram-сообщение с требованием реакции в течение 15 минут. Warning — всё, что можно решить в плановом режиме.
Дашборд «Обзор сети магазинов»
Собрали дашборд, на котором все 12 магазинов видно одним взглядом:
Problems — текущие проблемы с фильтрацией по уровню серьёзности
Host availability — карта доступности хостов в разрезе магазинов
Graph (classic) — графики CPU и памяти по кассовым серверам
Top hosts — топ хостов по потреблению ресурсов
Map — топологическая карта сети с расположением магазинов
Отдельно в Monitoring → Maps сделали топологическую карту: все магазины, офис, связи между ними. Состояние каждой точки сразу видно по цвету иконки — зелёный, жёлтый, красный. Никаких таблиц, всё интуитивно.
Telegram-бот и email-оповещения
Email настроили через SMTP Яндекса (Alerts → Media types → Email), плюс подняли Telegram-бота — чтобы IT-отдел получал оповещения мгновенно, а не ждал звонка:
Теперь специалист видит проблему в Telegram через несколько секунд. Не через час, не после звонка из магазина — сразу.
Автообнаружение сети и SNMP-мониторинг оборудования
Серверами дело не ограничивалось. В каждом магазине стояли коммутаторы, Wi-Fi точки и куча всякого оборудования — всё это тоже нужно было взять под контроль. Настроили автоматическое обнаружение устройств.
На практике эта функция оказалась настоящей находкой. В магазине №9 сгорел коммутатор — поставили новый, и Zabbix сам подхватил его через Network Discovery и начал мониторинг. Никто ничего руками не добавлял.
Автообнаружение хостов в сети
Для каждой подсети прописали правила обнаружения через Data collection → Discovery:
IP range: 192.168.1.1-254
Update interval: 1h
Checks: Zabbix agent, SNMP, ICMP ping
Обнаруженные хосты автоматически падают в группу «Discovered hosts» и получают шаблон. Принесли в магазин новый свич — через час он уже в мониторинге.
Для облачных сред Zabbix 7 умеет обнаруживать устройства через API: VMware vCenter, AWS CloudWatch, Azure Monitor — всё это работает из коробки.
Мониторинг коммутаторов и Wi-Fi через SNMP
Сетевое оборудование подключили по SNMP:
apt install -y snmp snmp-mibs-downloader

# Проверка доступности SNMP на устройстве
snmpwalk -v2c -c public 192.168.1.1 sysDescr
На каждое устройство завели хост с SNMP-интерфейсом и прицепили нужный шаблон:
Cisco IOS by SNMP — для Cisco
MikroTik by SNMP — для RouterOS
Generic by SNMP — универсальный шаблон
HP Enterprise Switch by SNMP — для HP/Aruba
Шаблоны сами нашли все интерфейсы и развернули метрики по каждому порту: трафик, ошибки, состояние, скорость. Руками прописывать ничего не пришлось.
Распределённый мониторинг через Zabbix Proxy
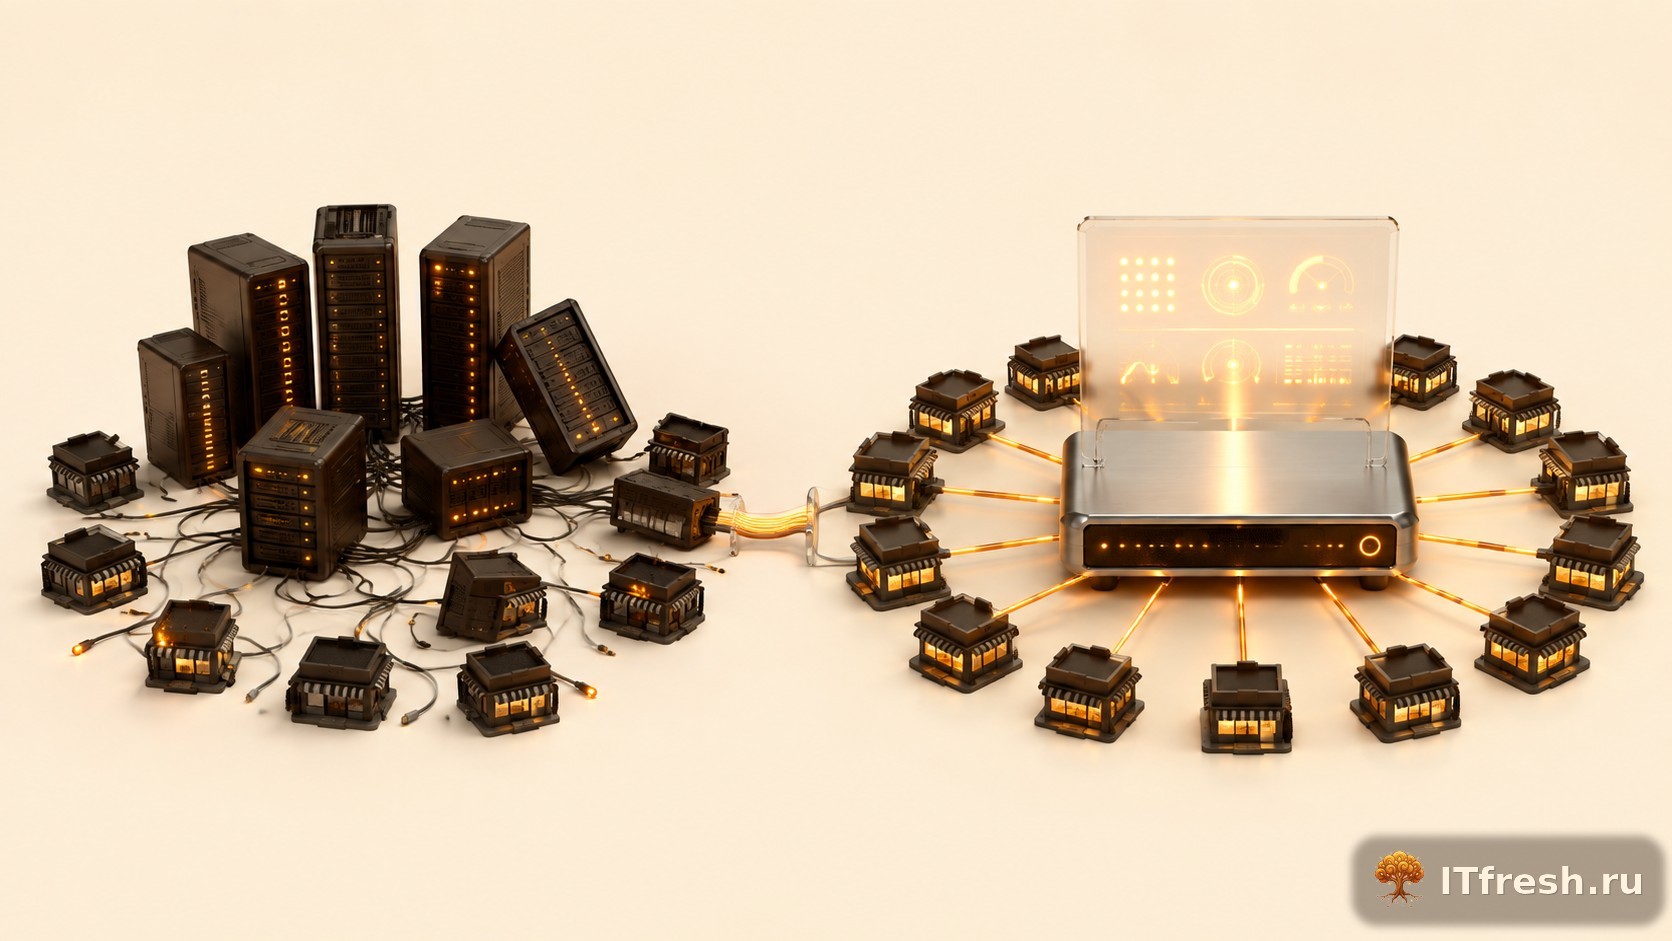
Для 12 магазинов мы развернули Zabbix Proxy в каждой точке. VPN-каналы между магазинами и офисом — штука ненадёжная, а Proxy буферизирует данные локально и ничего не теряет, даже если связь легла.
Что это значит на практике — показал случай уже через неделю после запуска. Один из магазинов потерял VPN на 4 часа — провайдер чудил. Proxy спокойно писал метрики в локальный буфер, а когда канал поднялся, всё автоматически ушло на центральный сервер. Ни одна точка данных не пропала. IT-специалист увидел полную картину, включая сам период недоступности — как будто ничего и не было.
Установка Proxy в магазинах
На сервере каждого магазина поставили Proxy с SQLite:
# Установка
apt install -y zabbix-proxy-sqlite3

# Конфигурация
nano /etc/zabbix/zabbix_proxy.conf
Мы применили следующую конфигурацию:
# Режим работы: 0 — активный
ProxyMode=0

# Адрес Zabbix сервера
Server=zabbix.example.com

# Уникальное имя прокси
Hostname=proxy-office-spb

# Путь к базе данных SQLite
DBName=/var/lib/zabbix/proxy.db

# Частота отправки данных
DataSenderFrequency=5

# Буферы
ProxyLocalBuffer=2
ProxyOfflineBuffer=24

# Процессы сбора данных
StartPollers=10
StartPollersUnreachable=3
systemctl enable --now zabbix-proxy
Оптимизация производительности и бэкапы
Чтобы система нормально работала год, два, пять — сделали несколько оптимизаций:
Housekeeper — чистит устаревшие данные и не даёт базе разрастись до неприличных размеров:
# В zabbix_server.conf
HousekeepingFrequency=1
MaxHousekeeperDelete=10000
Весь проект — от аудита до работающей системы — занял 2 недели. Вот что получилось в цифрах:
Время реакции на инциденты сократилось с 2-3 часов до 5-10 минут — за счёт Telegram-оповещений и дашбордов
Под мониторингом — 48 хостов: серверы, коммутаторы, Wi-Fi точки во всех 12 магазинах и офисе
Предотвращённые инциденты — за первый же месяц триггеры поймали 3 заполняющихся диска и 2 проблемы с памятью до того, как что-то реально упало
Потери от простоев — упали со 150 000 до менее 20 000 рублей в месяц
Распределённая архитектура — Zabbix Proxy в каждом магазине держит сбор данных даже при нестабильных каналах
Автообнаружение — новое железо в сети подхватывается само, без заявок в IT
Окупаемость — меньше месяца, если считать предотвращённые простои
Показательная история — через 10 дней после запуска. Триггер «Disk space critically low» сработал на кассовом сервере в магазине №7: диск заполнен на 92%. Специалист увидел Telegram-уведомление, зашёл удалённо и обнаружил, что логи кассового ПО росли бесконтрольно — никто за этим просто не следил. На устранение ушло 15 минут. Касса не упала, продажи не встали. Клиент потом сказал просто: «Раньше мы тушили пожары, теперь предотвращаем их» — лучше и не скажешь.
IT-специалист типографии получил полный комплект документации и два дня плотной работы с нашими инженерами. Результат? Через две недели он самостоятельно подключил новый магазин к мониторингу за полчаса: поставил агент, развернул Proxy, прописал хосты в веб-интерфейсе. Без звонков нам, без согласований. Типовые операции — его зона ответственности.
Часто задаваемые вопросы
Цифры, которые нас самих удивили на первых проектах. Один нормально настроенный Zabbix-сервер с PostgreSQL на железе 8 ядер / 16 ГБ RAM / NVMe SSD тянет 5 000–10 000 метрик в секунду (NVPS) — это реальные 3 000–5 000 хостов со стандартными шаблонами. Подключаете TimescaleDB и Zabbix Proxy — потолок уходит в десятки тысяч хостов. Для большинства наших клиентов запас более чем достаточный.
На все новые установки ставим PostgreSQL 15+, и вот почему. На больших объёмах он выигрывает у MySQL по скорости заметно, плюс поддерживает TimescaleDB — а это автоматическое сжатие истории и партицирование таблиц из коробки. MySQL и MariaDB? Допустимы, но только если хостов до 500 и перспективы роста туманны.
Zabbix Agent 2 написан на Go — в отличие от классического агента на C. Что это даёт на практике: параллельное выполнение проверок вместо последовательного, подключаемые плагины, встроенный мониторинг Docker, PostgreSQL, MySQL и ещё кучи сервисов без единого внешнего скрипта. Ставьте Agent 2. Без вариантов.
Если агент за NAT или файрволом — переходите на режим активных проверок (Active checks). Агент сам лезет на сервер, никаких входящих соединений. В конфиге прописываете ServerActive, проверяете, что агент достучится до порта 10051 сервера — и всё. Порт 10050 можно вообще не открывать. Эта схема работает даже в самых закрытых сетях.
Облако мониторить тоже можно — в Zabbix 7 шаблоны для AWS CloudWatch, Azure Monitor и Google Cloud идут из коробки. Там, где агент не поставить, работают HTTP agent, Script items и встроенные коннекторы. Kubernetes мониторится через Prometheus-эндпоинты. В нашей практике такая связка закрывает 90% запросов по гибридной инфраструктуре.
Столкнулись с похожей задачей? Обращайтесь — решим
Если у вас происходит что-то из описанного в этой статье — или любая другая проблема с ИТ-инфраструктурой, — обращайтесь в любое время. Мои специалисты и я лично разберём ситуацию, найдём настоящую причину и доведём до решения.
Возьмёмся и за разовую задачу, и за постоянное обслуживание. Первичная консультация — бесплатно и без обязательств.
С уважением, Семёнов Евгений Сергеевич, директор «АйТи Фреш» — IT-аутсорсинг для компаний до 50 рабочих мест, 15+ лет практики
Подпишитесь на рассылку ITfresh
Каждую неделю мы выпускаем практические гайды для руководителей IT и системных администраторов. Это не просто теория! Здесь вы найдёте всё: безопасность, 1С, миграции, резервные копии и проверенные лайфхаки из наших реальных проектов.
Реквизиты оператора персональных данных
ООО «АЙТИ-ФРЕШ», ИНН 7719418495, КПП 771901001. Юридический адрес: 105523, г. Москва, Щёлковское шоссе, д. 92, корп. 7. Контакт: info@itfresh.ru, +7 903 729-62-41. Оператор обрабатывает e-mail подписчика в целях рассылки информационных и рекламных материалов до момента отзыва согласия.